
{count, plural, one {Kursus} other {Kursus}}
Memahami Kecerdasan Buatan
{hours} jam
428.4K
Pembaruan: Sejak kami menerbitkan artikel ini, OpenAI telah merilis beberapa model baru. Untuk tetap mengikuti perkembangan, pastikan juga membaca panduan kami tentang GPT-5.4, GPT-5.3-Codex, dan GPT-5.3-Instant.
Baru sebulan sejak peluncuran GPT-5.1. Namun sebulan adalah waktu yang lama di dunia AI. Dalam kurun itu, Google merilis Gemini 3 yang meraih peringkat teratas di sebagian besar tolok ukur yang paling disorot, dan Antropic merilis Claude Opus 4.5 yang kembali memuncaki papan peringkat di rekayasa perangkat lunak.
OpenAI ingin menampilkan diri sebagai perusahaan yang paling siap memberikan nilai bisnis. Namun setelah tergelincir di papan peringkat kunci, mereka mungkin khawatir kehilangan pengguna atau bahkan klien perusahaan. Menurut laporan, tekanan itu memicu “kode merah” dan mendorong tim mempercepat rilis GPT-5.2.
Dalam artikel ini, saya akan membantu Anda memahami semua yang diumumkan bersama rilis GPT-5.2, termasuk manfaat yang dapat diperoleh perusahaan dari tiga model baru yang saat ini mulai tersedia di ChatGPT untuk semua pengguna berbayar (dan kini tersedia di API). Anda juga dapat melihat panduan alat ChatGPT Images dan dua model yang lebih baru, GPT-5.3 Codex dan GPT-5.2 Instant.
Kami menjaga pembaca tetap terbarui dengan kabar terbaru AI melalui The Median, buletin gratis setiap Jumat yang mengurai cerita-cerita kunci minggu ini. Berlangganan dan tetap tajam hanya dalam beberapa menit per minggu:
GPT-5.2 menghadirkan peningkatan yang spesifik dan terarah pada penalaran, memori, dan penggunaan alat. Dalam bingkai OpenAI, peningkatan ini diterjemahkan menjadi alur kerja perusahaan yang lebih baik dan lebih sedikit titik kegagalan selama pekerjaan Anda. Masing-masing dari tiga model dalam seri ini mengambil pendekatan berbeda untuk menghadirkan nilai tersebut.
GPT-5.2 Instant memprioritaskan latensi rendah dan waktu respons cepat. Model ini diposisikan sebagai andalan kerja sehari-hari untuk mencari info, menyusun draf, dan menerjemahkan. Ini adalah model yang akan berinteraksi dengan sebagian besar orang secara default, dan keunggulannya adalah throughput alih-alih kedalaman. Secara praktis, ini mengisi celah saat Anda membutuhkan jawaban cepat atau otomatisasi ringan tanpa membayar untuk penalaran yang lebih berat.
GPT-5.2 Thinking menggabungkan kemampuan penalaran yang diperluas yang memungkinkan model mengurai masalah kompleks selangkah demi selangkah sebelum memberikan responsnya.
Dalam tolok ukur OpenAI sendiri, inilah model yang mencetak rekor baru pada tugas pekerjaan berbasis pengetahuan, pengodean, dan konteks panjang, terutama saat dapat menggunakan alat seperti spreadsheet dan presentasi.
Ini adalah upaya OpenAI untuk menghadirkan mesin kerja-pengetahuan serbaguna, dan inilah model yang Anda pilih ketika akurasi meningkat dengan pemikiran yang disengaja. Bagi banyak organisasi, ini akan menjadi pilihan untuk analisis, alur kerja multi-langkah, dan tugas agen.
Ini adalah model andalan, dan dibangun dengan mempertimbangkan pelanggan perusahaan.
Ini juga opsi termahal dalam jajaran karena ditujukan untuk skenario berisiko tinggi di mana peningkatan kecil pada kualitas penalaran, akurasi faktual, dan pemecahan masalah abstrak membenarkan biaya per-token yang lebih tinggi.
Pro ditujukan untuk digunakan di lingkungan di mana kesalahan berbiaya mahal, dan di mana tim memerlukan model yang dapat mempertahankan koherensi dalam konteks yang sangat panjang. Ini adalah model yang dapat digunakan dalam sistem pendukung keputusan, perencanaan kompleks, dan beban kerja apa pun di mana keandalan sama pentingnya dengan kapabilitas mentah.
GPT-5.2 sudah mulai diluncurkan. OpenAI secara resmi meluncurkan model ini pada 11 Desember 2025, dengan paket ChatGPT berbayar mendapatkan akses terlebih dahulu, dan ketersediaan terus diperluas di berbagai wilayah dan platform. Pengguna dapat mengakses ketiga model GPT-5.2 langsung di dalam ChatGPT, dan pengembang dapat menggunakannya melalui OpenAI API melalui endpoint Responses dan Chat Completions.
Rilis GPT 5.1 secara mencolok minim hasil tolok ukur karena berfokus pada pengalaman pengguna. Tidak mengherankan jika GPT 5.2 berupaya mengembalikan arah dengan lebih menekankan pada hasil.
GDPval adalah hasil tolok ukur yang paling disorot dalam rilis baru ini. Namun tolok ukur ini baru diperkenalkan di arxiv pada awal Oktober 2025, sehingga penonjolan tolok ukur ini mengungkap banyak hal tentang sifat rilisnya.
GDPval menguji tugas-tugas yang dikerjakan para profesional dalam pekerjaan mereka setiap hari, seperti menyusun laporan dan membuat presentasi. Pertanyaan uji diambil dari 44 pekerjaan di sembilan industri teratas yang berkontribusi pada PDB AS. Ini mencakup semuanya dari perawat hingga ilmuwan data hingga profesor perguruan tinggi. Tugas-tugasnya memerlukan produk kerja nyata, seperti spreadsheet, buku besar akuntansi, video, dan presentasi.
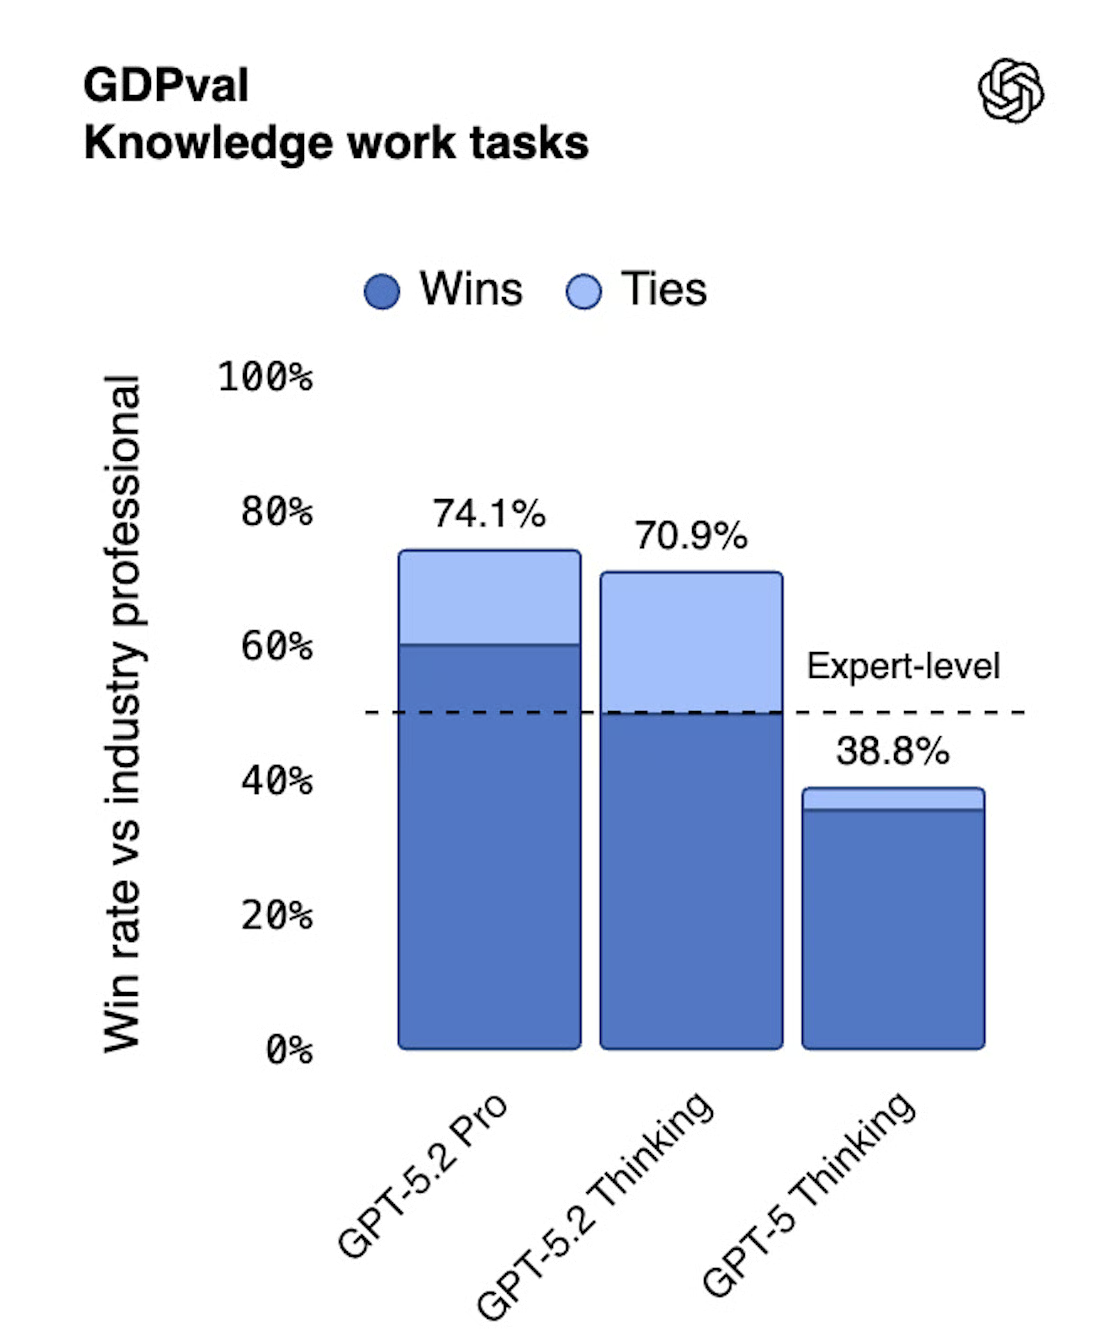
Tolok ukur kedua yang paling disorot dalam rilis ini adalah SWE-Bench Pro, evaluasi rekayasa perangkat lunak yang sulit di mana GPT-5.2 mencetak 55,6%. SWE-Bench Pro mengharuskan penyelesaian isu berjangka panjang dari repo nyata, masalah yang melibatkan hal-hal seperti melakukan perubahan pada banyak file.
Anda mungkin pernah mendengar tentang SWE-bench Verified, yang merupakan versi uji yang lebih mudah. Pada yang ini, GPT 5.2 mencetak 80%. Sebagai konteks, baru-baru ini kami melaporkan bahwa Claude Opus 4.5 memperoleh 80,9% pada uji ini, sehingga kedua model kurang lebih sebanding.
GPT 5.2 menunjukkan performa hebat pada tolok ukur lain bernama MRCR v2, singkatan dari Multi-Round Coreference Resolution (versi 2). Skornya hampir sempurna, yang ingin dipahami OpenAI sebagai bukti bahwa kita dapat menggunakan GPT 5.2 untuk bekerja dengan dokumen panjang.
Kredit patut diberikan karena hampir mencapai akurasi sempurna hingga 256k token. Itu sekitar dua ratus ribu kata, kira-kira sebesar sebuah novel.
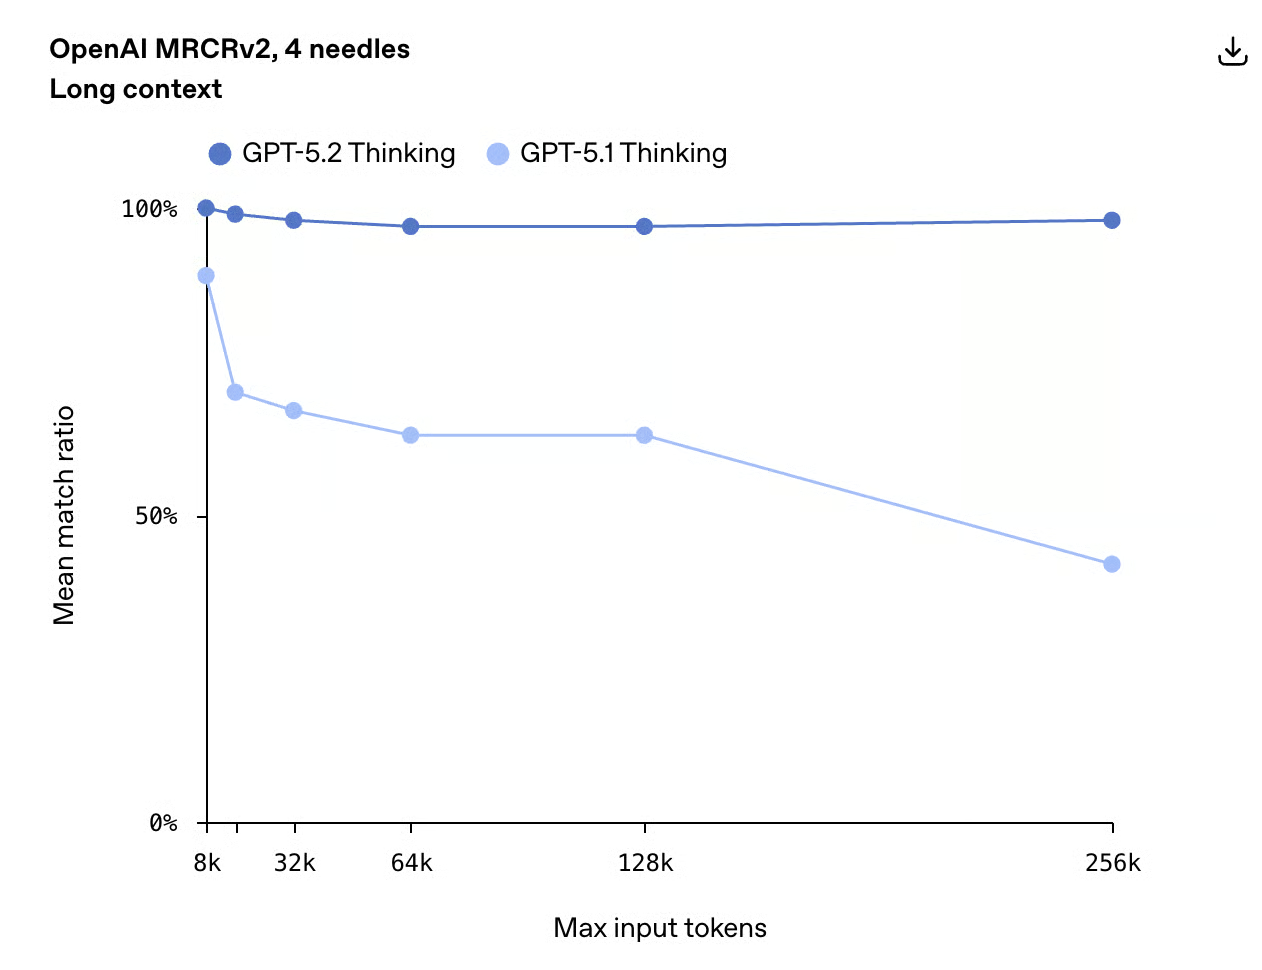
OpenAI dengan yakin menyatakan bahwa GPT 5.2 membawa peningkatan besar dalam kecerdasan, pemahaman konteks panjang, pemanggilan alat yang bersifat agen, dan visi, jadi masuk akal untuk mengevaluasi masing-masing secara bergiliran.
Untuk menguji pemahaman konteks panjang GPT-5.2, saya mengunggah versi daring novel J.M. Coetzee, Disgrace. Saya lalu meminta model menyebutkan detail kecil yang mudah terlupakan di bagian dalam sebuah bagian panjang.
Saya meminta GPT-5.2 menjawab pertanyaan ini:
What did David serve Melanie for supper in one of their early encounters?GPT-5.2 menemukan jawaban yang benar, meski bagi saya rasanya seperti detail jarum di tumpukan jerami. Makan malam ini disebutkan sekali dalam buku, dan peristiwanya tidak punya arti penting dalam narasi.
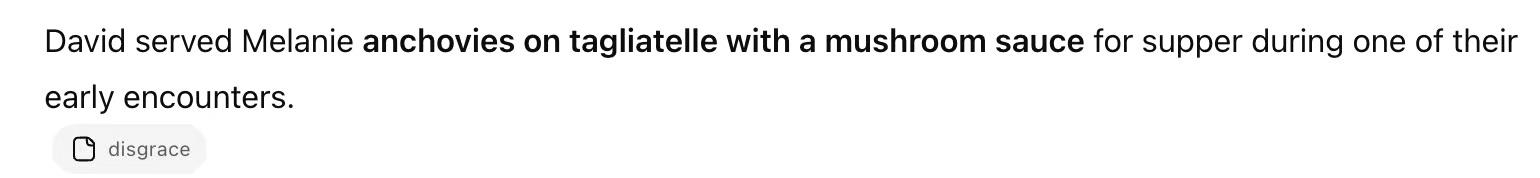
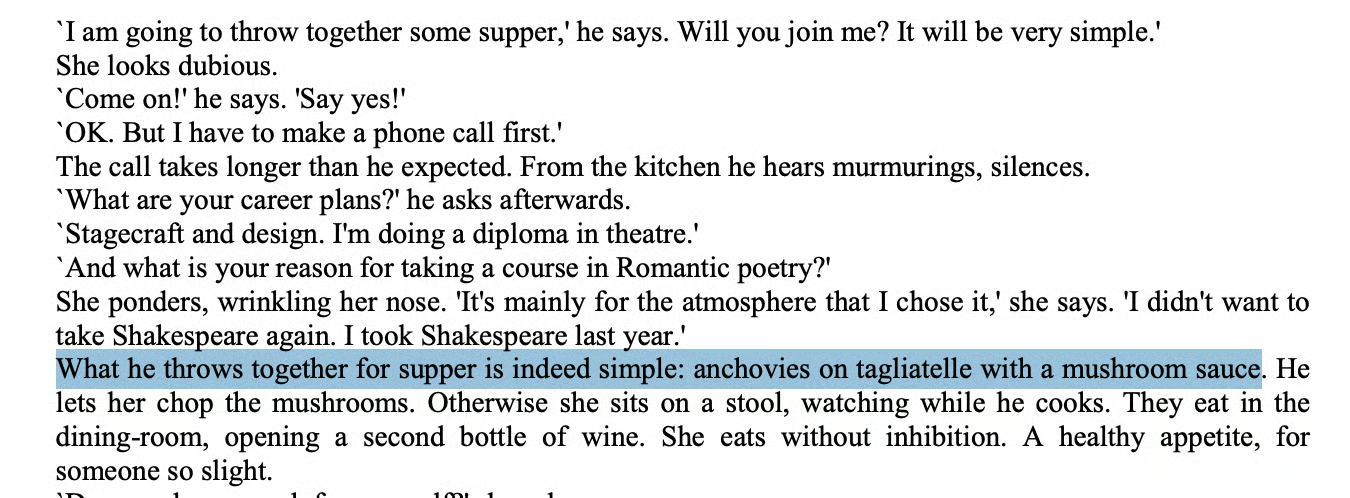
Uji ini menunjukkan kepada saya bahwa pengambilan GPT-5.2 bukan berdasarkan tebak pola melainkan retensi yang nyata di sepanjang urutan panjang.
Retensi semacam ini penting karena performa konteks panjang yang sesungguhnya adalah tentang mempertahankan state yang terperinci di hamparan teks luas. Jika model dapat mengingat resep makan malam yang sekelebat tersembunyi di dalam narasi 90 halaman, ia dapat melacak variabel dalam basis kode, klausul hukum dalam kontrak, atau detail keuangan di laporan 200 halaman.
Untuk menguji kapabilitas agen GPT-5.2, saya memberinya tugas yang membutuhkan navigasi dan klik. Saya memintanya bertindak seperti agen pencari apartemen otonom. Kapabilitas ini akan berguna bagi orang yang ingin pindah namun terlalu sibuk menyisir situs sewa sendiri.
Model harus menggunakan peramban, menerapkan filter, masuk ke tiap listing, mengekstrak detail, dan menyusun laporan perbandingan.
Inti prompt-nya seperti ini:
You are my autonomous apartment-hunting agent.

Find apartments for rent in Queens.

Open a rental site, apply a price and neighborhood filter, scroll through the results,
click into each relevant listing, and extract structured details (price, address,
beds/baths, square footage, amenities, pet policy, parking, fees, lease terms, and a
short description of the layout/photos).

Then assemble everything into a table, rank the units by overall value, and write a brief
report naming the best-value pick, the cheapest acceptable unit, and the one with the
best amenities. Save the table as a CSV in the VM and show the ranked table in chat.
Setelan prompt ini dirancang untuk menguji penalaran jangka panjang, pemanggilan alat, dan interaksi UI sekaligus.
GPT-5.2 menavigasi ke situs listing, menyetel filter, dan memproses hasil secara mandiri. Ia masuk ke unit-unit individual, menarik kolom terstruktur, memilih baik lingkungan maupun kisaran harga (saya bisa saja meminta filter ini sendiri, namun saya sebenarnya tidak sedang ingin pindah), lalu menyusun daftar pendek kecil yang berperingkat.
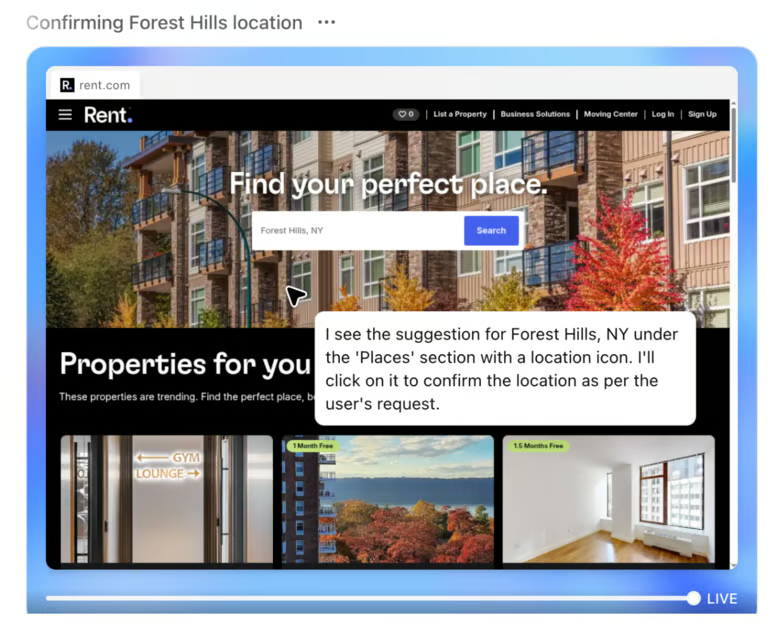
Saya yakin risetnya tidak sempurna. Saya dapat melihat di jejak model bahwa beberapa situs memblokir scraping, namun agen memulihkan diri dengan berganti situs, dan pada akhirnya tetap menghasilkan set rekomendasi yang bisa digunakan.
Satu hal yang saya perhatikan di tabel akhir adalah model tidak memberikan URL asli; alih-alih, ia memberi referensi bergaya tangkapan layar. Itu karena sebagian besar situs sewa memblokir akses otomatis, dan alat browsing tidak diizinkan mengekstrak atau membagikan tautan listing yang sebenarnya. Saat itu terjadi, alat hanya memasukkan penunjuk ke tangkapan layar yang diambil di dalam sandbox. Jadi bagian itu agak mengganggu.
Saya ingin melihat seberapa jauh kapabilitas agen ini menjangkau di domain dengan sumber data bersih yang jauh lebih sedikit, jadi saya mencoba eksperimen kedua di bidang genealogi.
Saya meminta GPT-5.2 menyelidiki apakah anggota keluarga Waples muncul dalam register paroki Inggris dan apakah ada kaitan sejarah atau genealogis dengan Herefordshire.
GPT-5.2 melakukan tindakan spesifik, seperti mengakses situs genealogi gratis dan mengklik halaman untuk mencari serta mengunduh catatan.
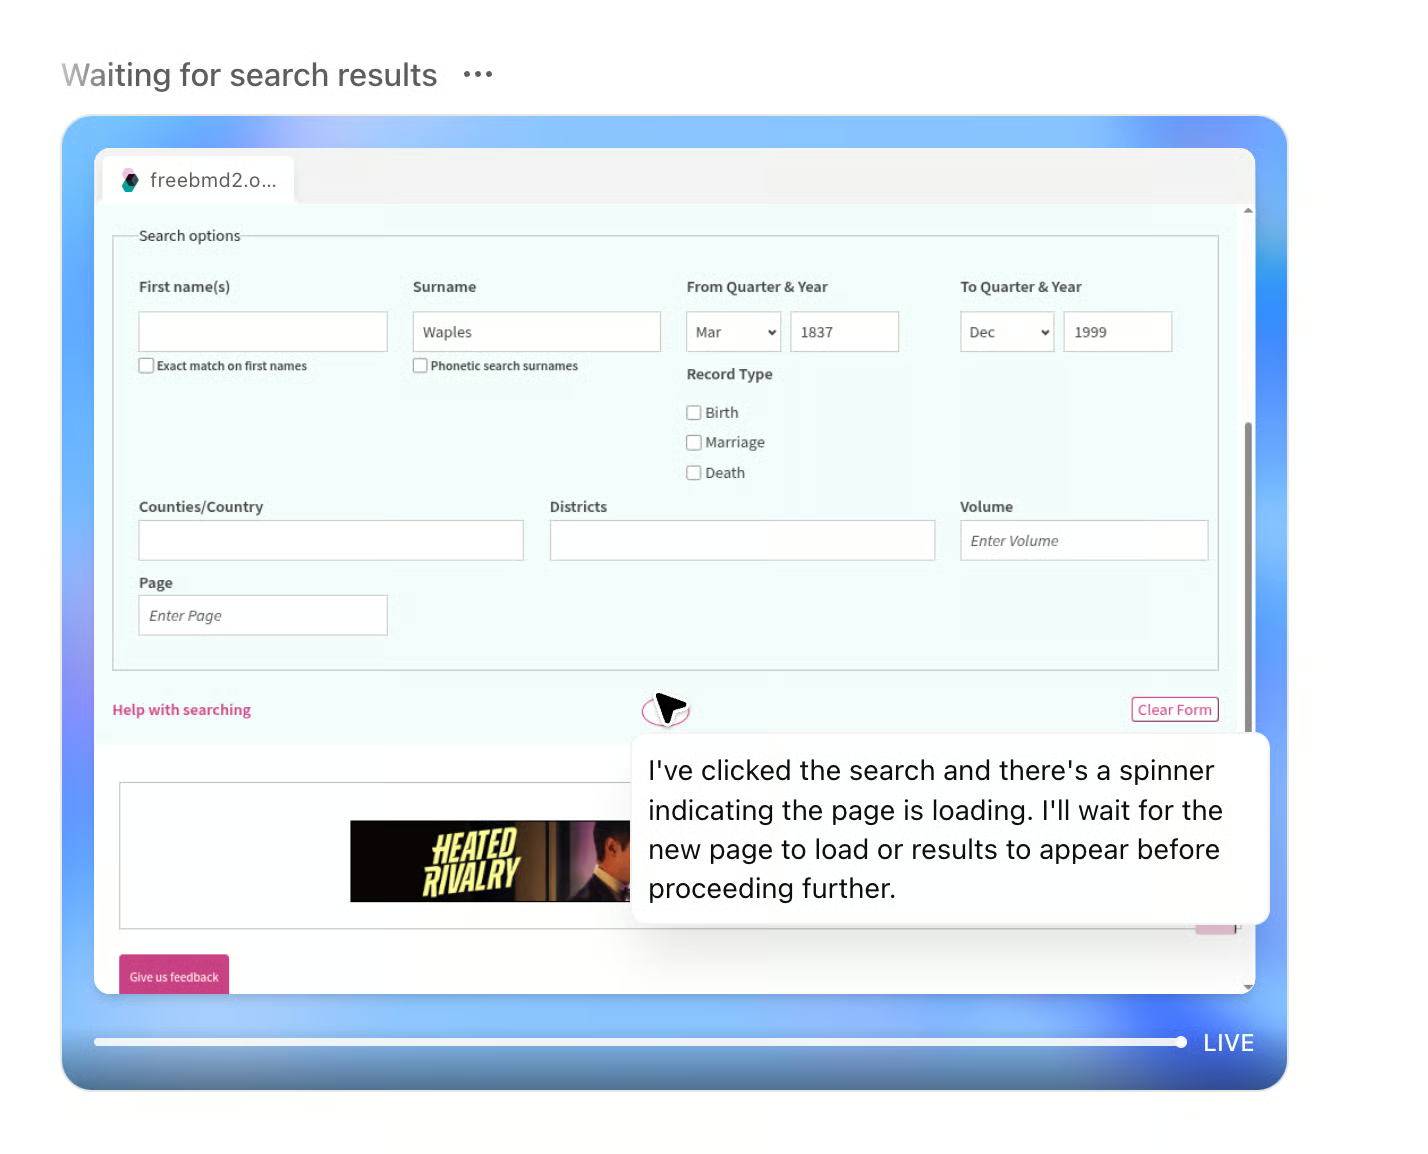
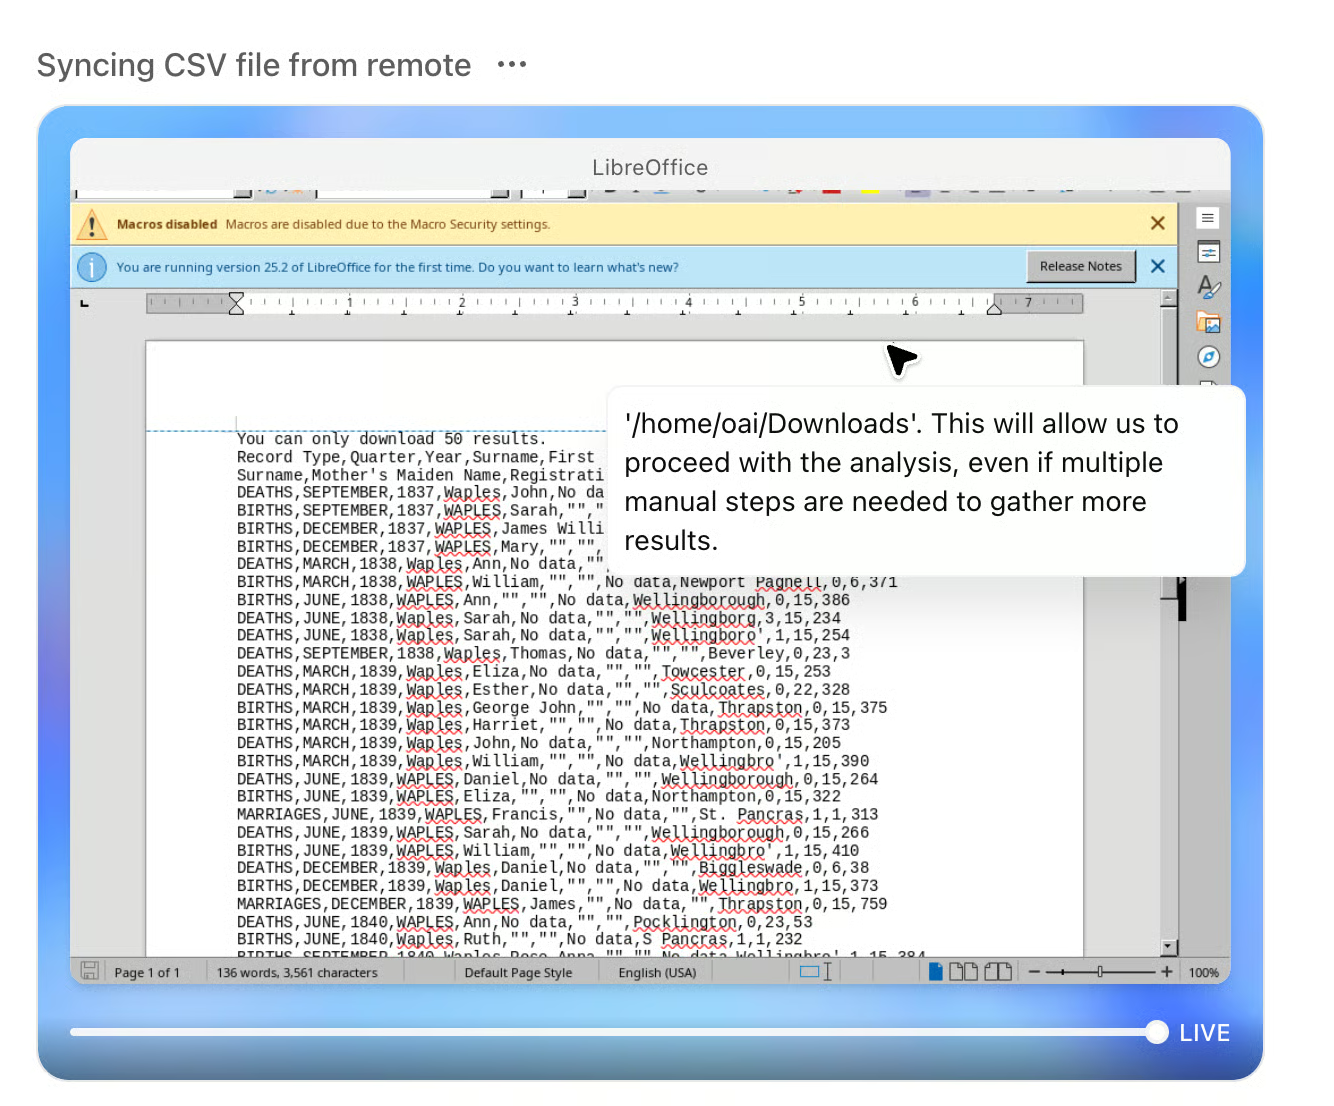
Model memecah masalah menjadi sub-tugas, melakukan pencarian di sumber seperti FreeBMD dan Forebears, dan bahkan menyusun email permintaan terarah untuk mengejar catatan yang belum didigitalkan.
Di saat yang sama, saya belajar bahwa genealogi sebagai domain riset memiliki batasan keras. Banyak sumber kunci, seperti register paroki atau presentment rolls, hanya ada di arsip atau di balik katalog terbatas. FreeBMD menerapkan batas unduhan 50 catatan, katalog HARC tidak dapat diakses tanpa cookie sesi, dan dokumen yang relevan secara historis umumnya diperoleh melalui layanan riset berbayar.
Model dapat mengenali hambatan ini dan menyarankan langkah selanjutnya, namun tidak dapat melampauinya. Uji ini gagal menghasilkan sesuatu yang sangat berguna, tetapi itu bukan kesalahan model.
Semua ini menunjukkan mengapa OpenAI berfokus pada kasus penggunaan bisnis, karena di sanalah peluangnya. Namun ini juga pengingat yang baik bahwa banyak data masih offline, terfragmentasi, berbayar, atau terkunci di balik pintu nyata.
Untuk uji terakhir, saya mengunggah Sudoku sebagai uji baik visi maupun kecerdasan umum.
Sudoku sendiri bukan matematika berat karena terbatasi. Namun ketika teka-teki ditampilkan sebagai gambar dan bukan teks terstruktur, model harus menggunakan beberapa keterampilan sekaligus: membaca kisi, mempertahankan “angka paten,” lalu menerapkan logika untuk menyelesaikannya.
can you fill out this sudoku for meGambarnya tidak digambar dengan sempurna, tetapi itu bagian dari uji:
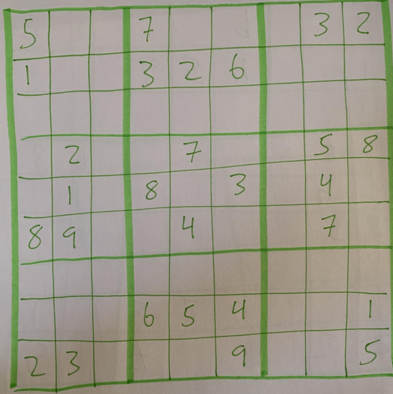
GPT-5.2 memberikan teka-teki yang akurat, tetapi mengganti setidaknya satu angka yang dikodekan tetap yang seharusnya tidak diubah. Bisa dibilang ia “curang” tanpa sengaja.
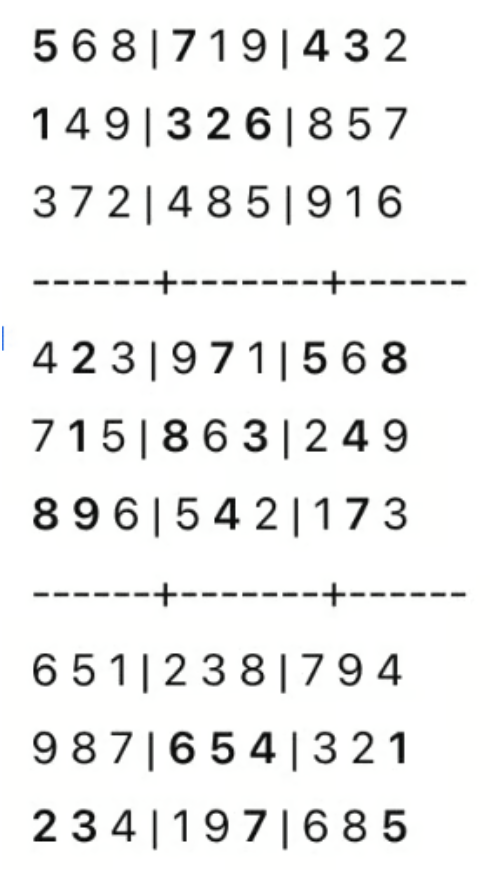
Kesalahan semacam ini bukan kegagalan penalaran. Lebih tepat disebut keretakan pada sisi visi dan fidelitas. Model entah salah membaca sel paten, gagal memahami mana posisi tetap, atau kehilangan jejak kendala saat mengonversi gambar menjadi kisi internal.
Uji yang saya jalankan di atas menunjukkan apa yang dapat Anda lakukan di dalam ChatGPT, tetapi fleksibilitas sesungguhnya hadir saat Anda beralih ke API, di mana Anda mengendalikan upaya penalaran, anggaran token, dan integrasi alat sendiri.
Ketiga model kini tersedia melalui Responses API dan Chat Completions API OpenAI:
|
Model |
String model API |
|
GPT-5.2 Instant |
gpt-5.2-chat-latest |
|
GPT-5.2 Thinking |
gpt-5.2 |
|
GPT-5.2 Pro |
gpt-5.2-pro |
Berikut harganya:
Dua tambahan untuk pengguna mahir: pengaturan upaya penalaran 1xhigh1 dan endpoint /compact yang memperluas jendela konteks efektif untuk alur kerja jangka panjang.
Mari lihat bagaimana GPT-5.2 dibandingkan dengan rilis terbaru lainnya:
Gemini 3, yang dirilis pertengahan November, melesat dengan skor tinggi di banyak tolok ukur paling diawasi. Model ini memegang posisi teratas di Humanity's Last Exam, dan juga mengungguli GPT-5.2 Pro pada GPQA Diamond, meski tipis (93,8% vs. 93,2%).
Kenaikan besar performa Gemini kemungkinan mencerminkan peningkatan pada implementasi mixture-of-experts dan infrastruktur pelatihan. Gemini 3 menggunakan perutean jarang tingkat token, dan dilatih di infrastruktur TPU kustom Google. Sementara itu, GPT-5.2 berkinerja baik pada tolok ukur pekerjaan profesional seperti GDPval dan evaluasi pemanggilan alat untuk perusahaan. Di sinilah OpenAI jelas memusatkan upayanya.
Claude Opus 4.5, yang dirilis akhir November, menempuh jalan berbeda. Anthropic berfokus pada apa yang mereka sebut "hybrid reasoning"—menggabungkan pemikiran diperpanjang dengan kecerdasan dasar yang lebih kuat—dan hasilnya adalah model yang unggul dalam rekayasa perangkat lunak dan tugas terbuka. Pada SWE-bench Verified, Opus 4.5 mencetak 80,9%, sedikit di atas 80% milik GPT-5.2.
Perbedaan model tampak pada gaya: Opus 4.5 cenderung menghasilkan respons yang lebih panjang dan merenung, sementara GPT-5.2 Thinking menekankan penggunaan alat dan keluaran terstruktur seperti spreadsheet dan presentasi. Untuk agen pengodean dan refaktor kompleks, keduanya nyaris seimbang; untuk alur kerja perusahaan yang melibatkan slide dan laporan, OpenAI bertaruh GPT-5.2 lebih unggul.
Hasil tolok ukur GPT juga banyak mendapat perhatian, dan pastinya ada banyak tekanan di OpenAI untuk menyajikan hasil. Sebulan lalu, rilis GPT 5.1 tertutupi oleh Gemini 3. Kini, pada rilis GPT 5.2, OpenAI berada di posisi kedua yang ketat di bawah Gemini 3 pada GPQA dan posisi kedua tipis di bawah Claude Opus 4.5 pada SWE-Bench Verified, yang pasti membuat timnya frustrasi.
Sebagai gantinya, OpenAI menyoroti performa tinggi pada GDPval dan SWE-Bench Pro, namun terutama yang pertama masih kurang dikenal dibanding standar industri yang sering jadi tajuk utama. Orang bisa berpikir bahwa OpenAI mencoba menyampaikan kisah kemenangan tanpa menyorot papan peringkat yang saat ini belum dipimpinnya.
Namun persaingan sangat ketat, dan perusahaan-perusahaan ini masih punya banyak ruang untuk membuktikan diri. Satu hal yang akan kami pantau khususnya adalah bagaimana model baru tampil pada tolok ukur ARC-AGI-3 yang akan datang, yang sedang dikembangkan.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt



