Chỉ hai ngày sau khi ra mắt GPT-5.5 Instant, OpenAI tiếp tục công bố tin lớn với một bản phát hành mới tập trung vào ba yếu tố cùng lúc:
- một mô hình giọng nói có thể suy luận trong khi đang nói: đó là GPT‑Realtime‑2
- dịch trực tiếp hơn 70 ngôn ngữ: GPT‑Realtime‑Translate
- và cuối cùng, chuyển âm dạng phát trực tuyến bắt kịp hội thoại thực: GPT‑Realtime‑Whisper
Bài viết này sẽ giúp bạn nắm bắt nhanh tin tức về ba mô hình này.
Nếu bạn quan tâm đến một mô hình cạnh tranh tập trung vào tương tác trực tiếp, hãy xem hướng dẫn của chúng tôi về TML-Interaction-Small của Thinking Machines Lab.
GPT-Realtime-2 là gì?
GPT-Realtime-2 là mô hình giọng nói thời gian thực mới trong API của OpenAI, và là mô hình giọng nói đầu tiên được OpenAI mô tả là có "năng lực suy luận đẳng cấp GPT-5".
Mô hình này được xây dựng cho tương tác giọng nói trực tiếp; tức là người dùng nói vào, không phải gõ.
Mô hình được thiết kế để giữ cuộc trò chuyện tiếp diễn trong khi suy luận về yêu cầu, gọi công cụ và xử lý hiệu chỉnh. Nói cách khác, nó phản hồi theo cách phù hợp với khoảnh khắc.
Dưới đây là một số điểm đáng chú ý so với mô hình trước, GPT-Realtime-1.5:
- cửa sổ ngữ cảnh tăng từ 32K lên 128K
- nhà phát triển giờ có thể điều chỉnh mức độ nỗ lực suy luận
- những chi tiết nhỏ như câu dạo đầu giúp tác nhân giọng nói bớt máy móc
GPT-Realtime-Translate là gì?
GPT-Realtime-Translate là mô hình dịch giọng nói trực tiếp mới của OpenAI, hỗ trợ hơn 70 ngôn ngữ đầu vào và 13 ngôn ngữ đầu ra.
Mô hình này dành cho kịch bản voice-to-voice: mỗi người nói bằng ngôn ngữ ưa thích, và mô hình dịch theo thời gian thực. Nó được kỳ vọng giữ vững ý nghĩa khi người nói chuyển ngữ cảnh, dùng cách phát âm vùng miền, hoặc chèn thuật ngữ chuyên ngành.
GPT-Realtime-Whisper là gì?
GPT-Realtime-Whisper là mô hình chuyển giọng nói thành văn bản dạng phát trực tuyến mới của OpenAI, được xây dựng cho chuyển âm độ trễ thấp trong khi người nói vẫn đang nói.
Whisper bản gốc được thiết kế cho các đoạn âm thanh đã hoàn chỉnh. Với phiên bản phát trực tuyến mới, chúng ta có một mô hình hữu ích hơn cho phụ đề phát sóng trực tiếp và các tác nhân giọng nói cần hiểu người dùng liên tục thay vì theo lượt.
Nếu bạn còn bối rối, cấu trúc là như sau:
- GPT-Realtime-2 = một tác nhân hội thoại giọng nói đầy đủ. Lắng nghe, suy luận, gọi công cụ, phản hồi bằng giọng. Dùng khi bạn muốn đầu vào và đầu ra đều là giọng nói.
- GPT-Realtime-Translate = một đường ống dịch thuật. Lời nói bằng ngôn ngữ A → lời nói bằng ngôn ngữ B. Nó không trò chuyện với ai; nó chuyển đổi một luồng thành luồng khác.
- GPT-Realtime-Whisper = một đường ống chuyển âm. Lời nói vào → văn bản ra. Không suy luận, không phản hồi bằng giọng. Dùng cho phụ đề trực tiếp, v.v.
Tính năng chính của GPT-Realtime-2
Các tính năng sau áp dụng riêng cho GPT-Realtime-2.
Câu dạo đầu
Nhà phát triển có thể để mô hình nói các cụm từ đệm ngắn như "để tôi kiểm tra" hoặc "xin chờ một lát trong khi tôi xem" trước câu trả lời chính.
Đây là một tính năng lớn vì con người thường thiếu kiên nhẫn hoặc khó chịu với khoảng lặng gượng gạo. Kiểu lấp chỗ trống theo phong cách con người là một trong những điều khiến tác nhân có vẻ thành thạo.
Gọi công cụ song song kèm thuyết minh âm thanh
GPT-Realtime-2 có thể gọi nhiều công cụ cùng lúc và vừa làm vừa thuyết minh những gì nó đang làm. Thay vì im lặng trong nhiệm vụ nhiều bước, người dùng sẽ nhận được phần bình luận liên tục. Chủ yếu là cải thiện trải nghiệm người dùng.
Khả năng phục hồi mạnh mẽ hơn
Khi có sự cố, như công cụ hỏng hoặc yêu cầu mơ hồ, mô hình có thể nói kiểu như "hiện tôi đang gặp trục trặc với việc đó" thay vì im lặng hoặc bịa thông tin.
Cửa sổ ngữ cảnh: 32K → 128K
Bản nâng cấp tăng gấp bốn lượng lịch sử hội thoại và ngữ cảnh mà mô hình có thể xử lý trong một phiên, từ 32.000 token lên 128.000 token. Điều này giúp mô hình phù hợp với các cuộc trò chuyện dài hơn mà không bị trôi nghĩa.
Điều chỉnh mức nỗ lực suy luận
Nhà phát triển giờ có thể chọn các mức suy luận: minimal, low, medium, high và xhigh.
Mặc định là low để giảm độ trễ cho trao đổi đơn giản, với các tùy chọn thận trọng hơn khi yêu cầu khó hơn.
Hiểu biết chuyên ngành và kiểm soát giọng điệu tốt hơn
Mô hình giờ giữ thuật ngữ chuyên môn tốt hơn, như thuật ngữ y tế hay biệt ngữ tài chính. Nó cũng có thể điều chỉnh cách thể hiện: điềm tĩnh khi xử lý sự cố, thấu cảm khi người dùng bực bội, phấn khởi khi xác nhận hành động thành công.
Kết quả benchmark của GPT-Realtime-2
Hãy xem các benchmark. OpenAI so sánh với GPT-Realtime-1.5, tạo nên bức tranh so sánh theo năm rõ ràng:
- Big Bench Audio (trí tuệ âm thanh): 81,4% → 96,6% — tăng 15,2 điểm.
- Audio MultiChallenge (tuân thủ hướng dẫn trong hội thoại nói): 34,7% → 48,5% — tăng 13,8 điểm.
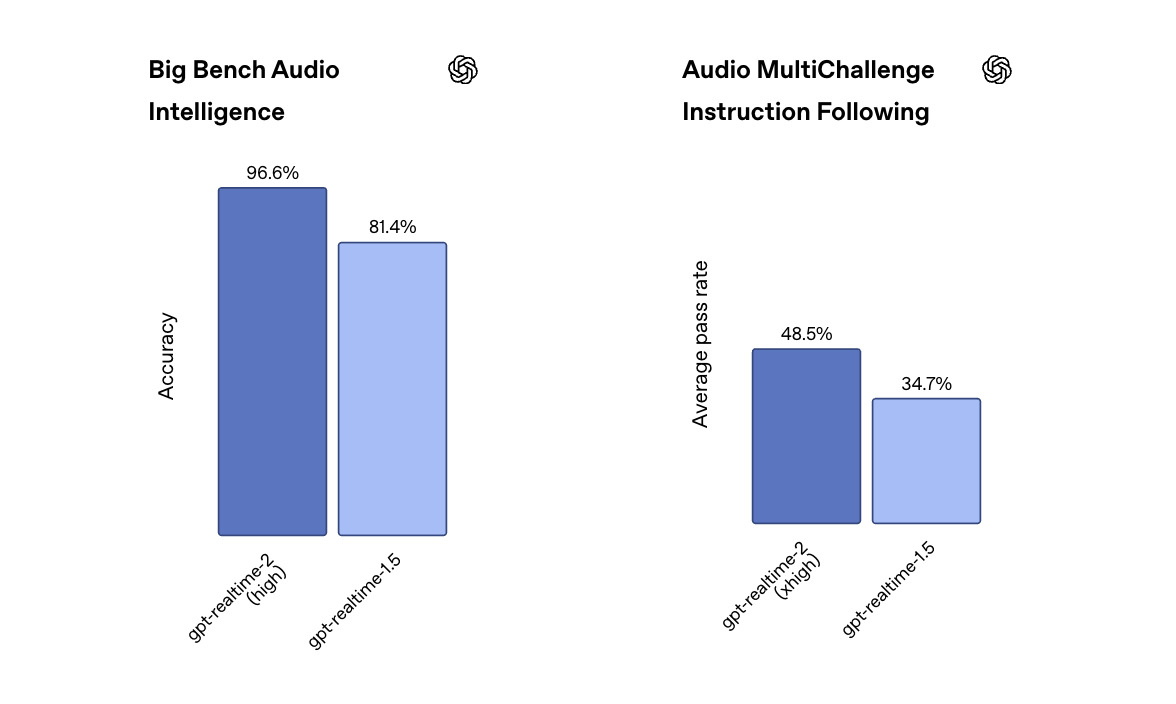
Con số Big Bench Audio khá đáng chú ý. 96,6% cho thấy benchmark đang tiến gần mức bão hòa. Ngược lại, Audio MultiChallenge vẫn dưới 50%, vì vậy kết quả thứ hai là một phép thử thực tế hữu ích. "Tốt hơn mô hình giọng nói năm ngoái" và "sẵn sàng dùng trong sản xuất không giám sát" là hai ngưỡng khác nhau.
Cần lưu ý: các con số này chạy ở mức suy luận "high" và "xhigh". Mặc định trong sản xuất sẽ là "low" vì lý do độ trễ, nên người dùng có thể trải nghiệm khác so với kỳ vọng dựa trên kết quả benchmark tiêu đề.
Tôi có thể truy cập GPT-Realtime-2 bằng cách nào?
Cả ba mô hình âm thanh hiện có sẵn trong Realtime API:
- GPT-Realtime-2: $32 cho mỗi 1M token âm thanh đầu vào ($0,40 cho đầu vào được lưu đệm), $64 cho mỗi 1M token âm thanh đầu ra.
- GPT-Realtime-Translate: $0,034 mỗi phút.
- GPT-Realtime-Whisper: $0,017 mỗi phút.
Hai mô hình tính phí theo phút dễ dự trù ngân sách hơn nhiều. Đơn giá theo token âm thanh khó quy đổi thành "mỗi cuộc gọi sẽ tốn bao nhiêu?" nếu không đo đếm thực tế. Vì vậy nhà phát triển nên dành chút thời gian mô phỏng chi phí kỳ vọng trước khi triển khai hoặc cam kết điều gì đó.
May mắn là bạn có thể thử GPT-Realtime-2 trong Playground, và OpenAI đang hướng nhà phát triển tới Codex (chúng tôi đã viết rất nhiều về Codex) với một prompt khởi đầu để thêm nó vào ứng dụng hiện có.
GPT-Realtime-2 và vấn đề an toàn
Về an toàn, OpenAI cho biết các bộ phân loại chủ động có thể dừng các phiên vi phạm nguyên tắc nội dung gây hại, và nhà phát triển có thể bổ sung rào chắn qua Agents SDK, mà chúng tôi cũng đã viết về.
Lưu ý: Giọng nói mang đến những rủi ro rất đặc thù. Đáng để bàn đến:
- Kích hoạt nhầm: Hệ thống bắt đầu lắng nghe hoặc phản hồi khi không ai có ý định tương tác.
- Thu âm môi trường: Một khi micro bật, nó thu mọi âm thanh trong phòng, không chỉ người dùng. Hội thoại nền, trẻ em, đồng nghiệp, TV, cuộc họp mật ở phòng bên, v.v.
- Lo ngại về giả giọng: Giọng nói là dữ liệu sinh trắc. Giọng nói tổng hợp giống người thật có thể bị dùng để mạo danh, lừa đảo, hoặc vượt qua hệ thống xác thực bằng giọng. Đây là mối lo ở cả đầu ra lẫn đầu vào.
Lời kết
OpenAI đang gói ghém những yếu tố khiến tác nhân giọng nói trông thành thạo — câu đệm, thuyết minh khi gọi công cụ, phục hồi duyên dáng, cửa sổ ngữ cảnh lớn, núm điều chỉnh suy luận thực thụ — vào một mô hình cũng thật sự biết suy luận. Điều này mang lại cho người dùng: ít khoảng lặng gượng gạo hơn và các cuộc trò chuyện ít có khả năng chệch hướng. Đó là một bước tiến lớn.


Chỉ hai ngày sau khi ra mắt GPT-5.5 Instant, OpenAI tiếp tục công bố tin lớn với một bản phát hành mới tập trung vào ba yếu tố cùng lúc:
Bài viết này sẽ giúp bạn nắm bắt nhanh tin tức về ba mô hình này.
Nếu bạn quan tâm đến một mô hình cạnh tranh tập trung vào tương tác trực tiếp, hãy xem hướng dẫn của chúng tôi về TML-Interaction-Small của Thinking Machines Lab.
GPT-Realtime-2 là gì?
GPT-Realtime-2 là mô hình giọng nói thời gian thực mới trong API của OpenAI, và là mô hình giọng nói đầu tiên được OpenAI mô tả là có "năng lực suy luận đẳng cấp GPT-5".
Mô hình này được xây dựng cho tương tác giọng nói trực tiếp; tức là người dùng nói vào, không phải gõ.
Mô hình được thiết kế để giữ cuộc trò chuyện tiếp diễn trong khi suy luận về yêu cầu, gọi công cụ và xử lý hiệu chỉnh. Nói cách khác, nó phản hồi theo cách phù hợp với khoảnh khắc.
Dưới đây là một số điểm đáng chú ý so với mô hình trước, GPT-Realtime-1.5:
GPT-Realtime-Translate là gì?
GPT-Realtime-Translate là mô hình dịch giọng nói trực tiếp mới của OpenAI, hỗ trợ hơn 70 ngôn ngữ đầu vào và 13 ngôn ngữ đầu ra.
Mô hình này dành cho kịch bản voice-to-voice: mỗi người nói bằng ngôn ngữ ưa thích, và mô hình dịch theo thời gian thực. Nó được kỳ vọng giữ vững ý nghĩa khi người nói chuyển ngữ cảnh, dùng cách phát âm vùng miền, hoặc chèn thuật ngữ chuyên ngành.
GPT-Realtime-Whisper là gì?
GPT-Realtime-Whisper là mô hình chuyển giọng nói thành văn bản dạng phát trực tuyến mới của OpenAI, được xây dựng cho chuyển âm độ trễ thấp trong khi người nói vẫn đang nói.
Whisper bản gốc được thiết kế cho các đoạn âm thanh đã hoàn chỉnh. Với phiên bản phát trực tuyến mới, chúng ta có một mô hình hữu ích hơn cho phụ đề phát sóng trực tiếp và các tác nhân giọng nói cần hiểu người dùng liên tục thay vì theo lượt.
Nếu bạn còn bối rối, cấu trúc là như sau:
Tính năng chính của GPT-Realtime-2
Các tính năng sau áp dụng riêng cho GPT-Realtime-2.
Câu dạo đầu
Nhà phát triển có thể để mô hình nói các cụm từ đệm ngắn như "để tôi kiểm tra" hoặc "xin chờ một lát trong khi tôi xem" trước câu trả lời chính.
Đây là một tính năng lớn vì con người thường thiếu kiên nhẫn hoặc khó chịu với khoảng lặng gượng gạo. Kiểu lấp chỗ trống theo phong cách con người là một trong những điều khiến tác nhân có vẻ thành thạo.
Gọi công cụ song song kèm thuyết minh âm thanh
GPT-Realtime-2 có thể gọi nhiều công cụ cùng lúc và vừa làm vừa thuyết minh những gì nó đang làm. Thay vì im lặng trong nhiệm vụ nhiều bước, người dùng sẽ nhận được phần bình luận liên tục. Chủ yếu là cải thiện trải nghiệm người dùng.
Khả năng phục hồi mạnh mẽ hơn
Khi có sự cố, như công cụ hỏng hoặc yêu cầu mơ hồ, mô hình có thể nói kiểu như "hiện tôi đang gặp trục trặc với việc đó" thay vì im lặng hoặc bịa thông tin.
Cửa sổ ngữ cảnh: 32K → 128K
Bản nâng cấp tăng gấp bốn lượng lịch sử hội thoại và ngữ cảnh mà mô hình có thể xử lý trong một phiên, từ 32.000 token lên 128.000 token. Điều này giúp mô hình phù hợp với các cuộc trò chuyện dài hơn mà không bị trôi nghĩa.
Điều chỉnh mức nỗ lực suy luận
Nhà phát triển giờ có thể chọn các mức suy luận: minimal, low, medium, high và xhigh.
Mặc định là low để giảm độ trễ cho trao đổi đơn giản, với các tùy chọn thận trọng hơn khi yêu cầu khó hơn.
Hiểu biết chuyên ngành và kiểm soát giọng điệu tốt hơn
Mô hình giờ giữ thuật ngữ chuyên môn tốt hơn, như thuật ngữ y tế hay biệt ngữ tài chính. Nó cũng có thể điều chỉnh cách thể hiện: điềm tĩnh khi xử lý sự cố, thấu cảm khi người dùng bực bội, phấn khởi khi xác nhận hành động thành công.
Kết quả benchmark của GPT-Realtime-2
Hãy xem các benchmark. OpenAI so sánh với GPT-Realtime-1.5, tạo nên bức tranh so sánh theo năm rõ ràng:
Con số Big Bench Audio khá đáng chú ý. 96,6% cho thấy benchmark đang tiến gần mức bão hòa. Ngược lại, Audio MultiChallenge vẫn dưới 50%, vì vậy kết quả thứ hai là một phép thử thực tế hữu ích. "Tốt hơn mô hình giọng nói năm ngoái" và "sẵn sàng dùng trong sản xuất không giám sát" là hai ngưỡng khác nhau.
Cần lưu ý: các con số này chạy ở mức suy luận "high" và "xhigh". Mặc định trong sản xuất sẽ là "low" vì lý do độ trễ, nên người dùng có thể trải nghiệm khác so với kỳ vọng dựa trên kết quả benchmark tiêu đề.
Tôi có thể truy cập GPT-Realtime-2 bằng cách nào?
Cả ba mô hình âm thanh hiện có sẵn trong Realtime API:
Hai mô hình tính phí theo phút dễ dự trù ngân sách hơn nhiều. Đơn giá theo token âm thanh khó quy đổi thành "mỗi cuộc gọi sẽ tốn bao nhiêu?" nếu không đo đếm thực tế. Vì vậy nhà phát triển nên dành chút thời gian mô phỏng chi phí kỳ vọng trước khi triển khai hoặc cam kết điều gì đó.
May mắn là bạn có thể thử GPT-Realtime-2 trong Playground, và OpenAI đang hướng nhà phát triển tới Codex (chúng tôi đã viết rất nhiều về Codex) với một prompt khởi đầu để thêm nó vào ứng dụng hiện có.
GPT-Realtime-2 và vấn đề an toàn
Về an toàn, OpenAI cho biết các bộ phân loại chủ động có thể dừng các phiên vi phạm nguyên tắc nội dung gây hại, và nhà phát triển có thể bổ sung rào chắn qua Agents SDK, mà chúng tôi cũng đã viết về.
Lưu ý: Giọng nói mang đến những rủi ro rất đặc thù. Đáng để bàn đến:
Lời kết
OpenAI đang gói ghém những yếu tố khiến tác nhân giọng nói trông thành thạo — câu đệm, thuyết minh khi gọi công cụ, phục hồi duyên dáng, cửa sổ ngữ cảnh lớn, núm điều chỉnh suy luận thực thụ — vào một mô hình cũng thật sự biết suy luận. Điều này mang lại cho người dùng: ít khoảng lặng gượng gạo hơn và các cuộc trò chuyện ít có khả năng chệch hướng. Đó là một bước tiến lớn.