Kursus
Natural Language Processing (NLP) telah ada selama lebih dari tujuh dekade. Ia bermula dari metode linguistik sederhana dan secara bertahap meluas ke bidang seperti kecerdasan buatan dan ilmu data, yang menunjukkan bahwa teknologi machine learning (ML) ini telah berkembang pesat.
Kepentingannya melonjak pada 2011 dengan peluncuran Siri, asisten sukses yang didukung NLP. NLP menjadi inti dari banyak aplikasi AI, seperti chatbot, analisis sentimen, penerjemahan mesin, dan lainnya.
Dalam artikel ini, saya akan menjelaskan bagaimana Anda dapat mempelajari NLP dan bagaimana hal itu dapat bermanfaat bagi Anda sebagai praktisi data. Saya juga akan menguraikan ceruk yang lebih luas ini menjadi konsep yang mudah dipahami dan menyediakan rencana belajar agar Anda bisa mulai dari nol.
Mengapa Belajar NLP?
Pasar NLP menembus $23 miliar pada 2023 dan diperkirakan melampaui $60 miliar pada 2030. Namun, tahukah Anda mengapa lonjakan ini diprediksi? NLP menjembatani kesenjangan komunikasi antara teknologi dan manusia. Organisasi mengandalkannya untuk memproses data tidak terstruktur dalam waktu lebih singkat guna membuat keputusan yang lebih baik.
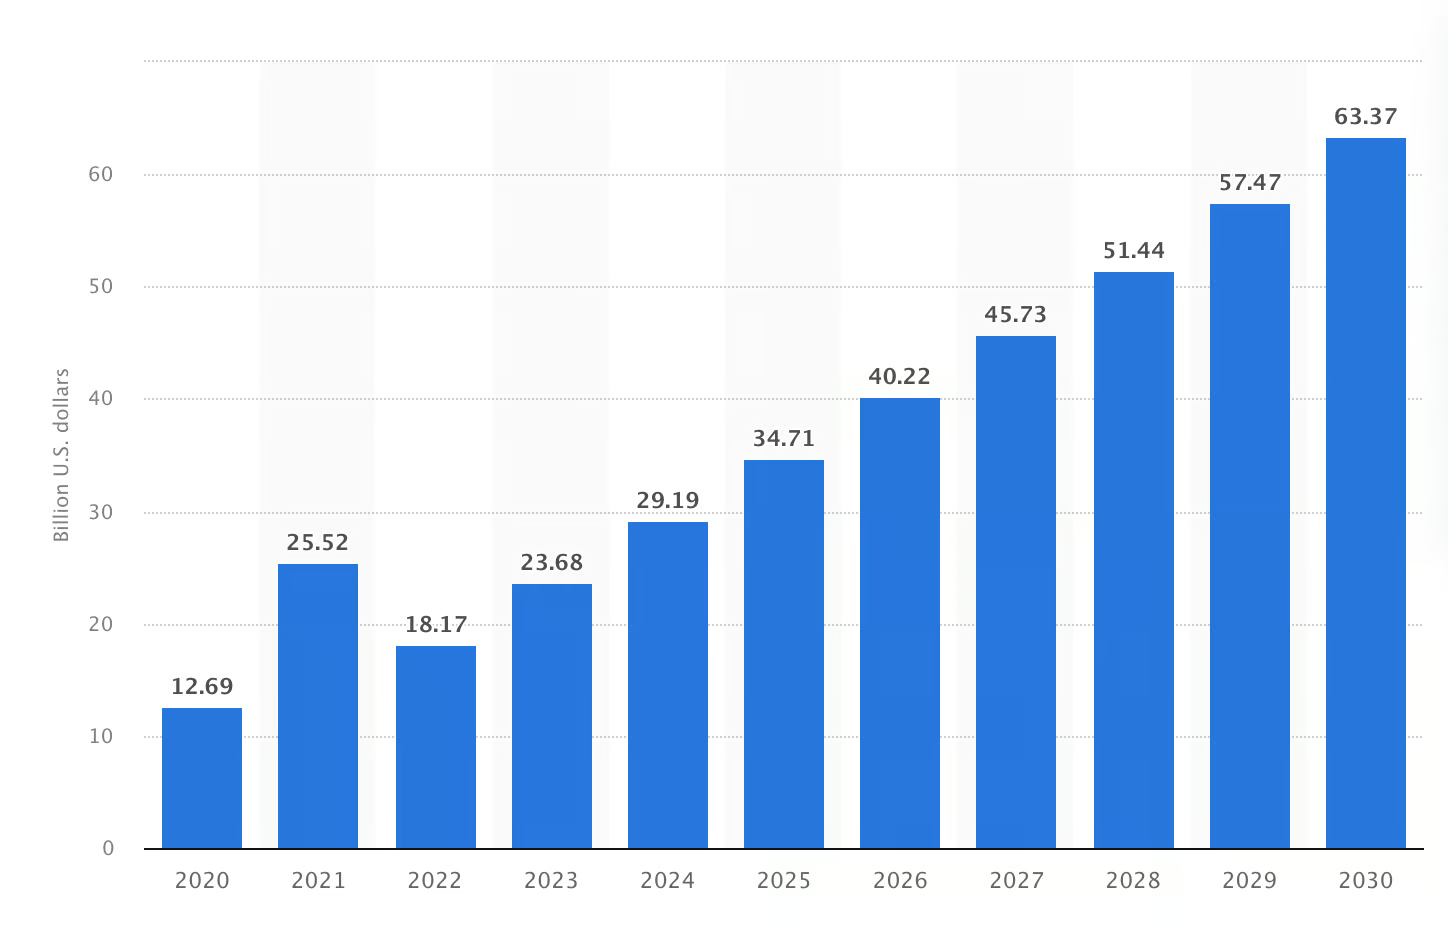
Perkiraan ukuran pasar NLP di seluruh dunia dari 2020 hingga 2030 (dalam miliar dolar AS). Sumber gambar: Statista
Kini, NLP digunakan dalam berbagai aplikasi dunia nyata:
- Anda dapat menganalisis rekam medis di sektor kesehatan atau memahami tren pasar di bidang keuangan.
- Enam dari sepuluh konsumen AS menyatakan bahwa chatbot berbasis NLP menghemat waktu mereka saat menelusuri produk eCommerce.
- Analisis sentimen adalah aplikasi kunci lainnya dari NLP — ia menafsirkan emosi di balik komentar media sosial.
Ini menunjukkan NLP digunakan di hampir semua bidang, dari kesehatan dan keuangan hingga eCommerce dan pemasaran. Jadi, mempelajarinya dapat memperluas pilihan karier Anda, terutama di ilmu data, AI, dan pengembangan perangkat lunak.
Seiring AI menjadi lebih umum, permintaan akan pakar NLP untuk menangani tugas kompleks yang tidak bisa diselesaikan model umum juga meningkat setiap tahun. Singkatnya, dengan mempelajari NLP, Anda dapat menyiapkan diri untuk karier dengan banyak peluang dan relevansi jangka panjang.
Konsep Inti yang Perlu Dipahami dalam NLP
Jika Anda benar-benar pemula di NLP dan belum mengetahui topik dasar maupun lanjutan yang terlibat, berikut beberapa konsep inti NLP yang perlu Anda pelajari. Tujuannya agar Anda mendapat gambaran seperti apa bekerja di NLP.
Praproses teks
Praproses teks mengubah data mentah menjadi format yang sesuai agar model komputer dapat memahami dan memproses data tersebut. Ia memproses semua data sambil mempertahankan makna dan konteks bahasa manusia dalam bentuk angka. Praproses ini dilakukan dalam beberapa langkah, tetapi jumlah langkah dapat bervariasi tergantung sifat teks dan tujuan yang ingin Anda capai dengan NLP.
Langkah yang paling umum meliputi:
- Tokenization: Memecah teks menjadi unit yang lebih kecil yang disebut token. Token ini dapat berupa kata, karakter, atau tanda baca. Misalnya, kalimat “I want to learn NLP.” akan di-tokenisasi menjadi:
I,want,to,learn,NLP,.. - Penghapusan stopword: Stopword adalah kata-kata tanpa makna penting dalam teks, seperti “is”, “the”, dan “and”. Menghapus kata-kata ini memudahkan fokus pada kata-kata yang bermakna.
- Stemming: Stemming menghapus akhiran dan mengurangi kata ke bentuk dasarnya. Misalnya, “going” akan direduksi menjadi “go”.
- Lemmatization: Lemmatization mereduksi kata menjadi lemma yang selalu bermakna. Proses ini memakan waktu dengan algoritme yang lebih kompleks daripada stemming.
Bag-of-words (BoW) dan TF-IDF
Baik bag-of-words maupun TF-IDF adalah konsep penting dalam NLP untuk temu kembali informasi. Berikut gambaran keduanya:
- Bag-of-words adalah representasi dokumen berisi kumpulan kata. Pendekatan ini membuat fitur yang mewakili setiap kata dari korpus (kumpulan dataset yang terorganisasi). Kemudian, ia menetapkan nilai pada setiap fitur berdasarkan frekuensi kemunculan kata dalam teks. Anda dapat menggunakannya untuk menangkap kemunculan kata pada data berjumlah besar.
- TF-IDF dibangun di atas model BoW. Namun, ia memberikan bobot lebih pada kata-kata yang sering muncul di seluruh korpus. Anda dapat menggunakan model ini untuk menonjolkan kata-kata penting dalam konten sebuah dokumen.
Word embeddings
Word embeddings adalah representasi kata dalam ruang vektor kontinu. Model machine learning mengandalkannya untuk memahami dan bekerja dengan data teks. Tiga teknik embedding yang umum digunakan meliputi Word2Vec, GloVe, dan FasText. Mari lihat apa yang membedakan mereka:
- Word2Vec menggunakan kata-kata di sekitarnya untuk memahami konteks dan menangkap makna semantik. Namun, ia kesulitan dengan kata-kata di luar kosakata (OOV) dan hanya mempelajari embedding untuk kata-kata yang ditemukan dalam data pelatihan.
- GloVe membangun matriks ko-kemunculan untuk mencatat seberapa sering suatu kata muncul dalam dataset. Dengan menempatkan kata-kata serupa pada satu tempat, ia dapat menangkap hubungan semantik antar kata tersebut.
- FastText memecah kata menjadi sub-kata dan mempelajari embedding untuk bagian-bagian lebih kecil ini, yang memungkinkannya mempertahankan makna semantik.
Model bahasa
Setiap tugas NLP — generasi teks atau pengenalan ucapan — harus terlebih dahulu memprediksi kemungkinan urutan kata. Di sinilah model bahasa membantu. Mereka menetapkan probabilitas pada urutan kata dan membuat komputer memahami bahasa manusia. Dua model bahasa umum meliputi:
- Model N-Gram tradisional: Model ini menggunakan N-Gram, yaitu probabilitas sebuah kata berdasarkan kata-kata sebelumnya dalam sebuah urutan. Karena mengandalkan penghitungan urutan kata dari dataset besar, mereka menghadapi tantangan kelangkaan data.
- Model modern berbasis deep learning: Deep learning berubah total dengan diperkenalkannya Word2Vec dan GloVe. Model berbasis neural ini membuat embedding kata yang menangkap hubungan semantik namun tidak dapat menangani kata di luar kosakata (OOV).
Model transformer modern berbasis deep learning seperti Bert dan GPT diperkenalkan untuk mengatasi masalah pada model sebelumnya. Model-model ini menangkap konteks dan makna di seluruh kalimat. Begini caranya:
- BERT dari Google membaca teks ke dua arah untuk lebih memahami konteks. Ia memasukkan fitur semantik dan sintaktik sehingga unggul pada tugas seperti menjawab pertanyaan dan menganalisis dokumen.
- GPT menggunakan pendekatan searah untuk memprediksi kata berikutnya dalam urutan, itulah mengapa ia dapat menghasilkan konten yang mirip manusia dan kontekstual.
Klasifikasi dan pengelompokan teks
Klasifikasi teks menetapkan kategori yang telah ditentukan pada data teks menggunakan model bag-of-words dan N-Gram. Misalnya, jika Anda memiliki kata “BERT” dan “GPT”, ia akan membuat dua kategori berdasarkan kata-kata ini. Lalu, ini akan digunakan untuk melatih model agar memprediksi kategori teks yang belum terlihat.
Sementara clustering mengelompokkan item serupa tanpa label yang telah ditentukan, algoritmenya memeriksa fitur setiap item untuk menemukan kesamaan dan mengelompokkan item serupa. Misalnya, tim pemasaran dapat menggabungkan clustering untuk mengidentifikasi kelompok konsumen berdasarkan demografi dan menampilkan iklan yang lebih relevan untuk mendorong pertumbuhan.
Belajar NLP dengan Python
Python populer untuk NLP karena kesederhanaan dan pustakanya yang membantu. Jadi, apakah Anda baru mulai atau sudah punya pengalaman ngoding, mari lihat cara membangun fondasi NLP yang kuat menggunakan Python.
Mengapa Python untuk NLP?
Python memiliki pustaka ekstensif, seperti NLTK, spaCy, dan TextBlob, yang menyediakan alat untuk pemrosesan, tokenisasi, dan lainnya. Komunitasnya yang aktif terus menambahkan fitur baru dan memperbaiki bug untuk meningkatkan alat-alat ini. Artinya, Anda dapat mengandalkannya untuk sumber daya terbaru dan dukungan daring.
Selain pustaka, Python juga memiliki kerangka kerja yang digunakan dalam NLP. TensorFlow dan PyTorch-NLP adalah dua kerangka kerja yang dapat Anda gunakan untuk klasifikasi teks, tanya jawab, dan analisis sentimen.
Pustaka Python untuk NLP
Beberapa pustaka Python yang paling sering digunakan untuk tugas NLP meliputi:
- NLTK (Natural Language Toolkit): Memiliki fungsi untuk mengidentifikasi entitas bernama dan membuat parse tree. Anda dapat menggunakannya untuk menandai bagian ujaran dan mengklasifikasikan teks. Kemampuan ini menjadikannya andalan bagi pemula maupun pengguna berpengalaman.
- spaCy: Sementara NLTK bagus untuk tugas dasar seperti tokenisasi dan bekerja dengan stopword, spaCy menangani tugas-tugas ini lebih cepat dan lebih akurat. Selain itu, ia unggul dalam dependency parsing, artinya memungkinkan Anda memahami hubungan antar kata dalam kalimat. Anda dapat menggunakannya untuk aplikasi tingkat produksi.
- Gensim: Jika Anda ingin bekerja dengan word embedding seperti Word2Vec, Gensim akan menjadi pustaka andalan Anda. Ia menemukan kemiripan kata dan mengelompokkan kata terkait. Anda juga dapat menggunakannya untuk memproses korpus besar karena mampu menangani dataset teks berukuran besar.
- Transformers (Hugging Face): Pustaka ini memberikan akses mudah ke model yang lebih terlatih, seperti BERT dan GPT. Anda dapat menggunakan pustaka ini untuk fine-tuning model pada dataset Anda sendiri. Misalnya, Anda dapat melakukan tugas seperti named entity recognition dan pembuatan lirik lagu dalam gaya yang Anda inginkan.
Cara Belajar NLP dari Nol
Karena NLP adalah bidang yang luas, terlihat menantang bagi pemula untuk mempelajarinya dari nol. Namun Anda sebaiknya mulai dari dasar, seperti praproses teks dan word embedding, lalu berlanjut ke topik lanjutan seperti deep learning.
Saya telah menyusun panduan bertahap untuk membantu Anda memulai perjalanan NLP dari nol:
Langkah 1: Pahami dasar-dasar data teks
Karena persiapan data adalah inti dari setiap tugas NLP, Anda harus mulai dengan memahami struktur data teks dan belajar menganalisis berbagai jenis data, seperti kalimat, paragraf, atau dokumen.
Langkah 2: Pelajari teknik praproses teks
Selanjutnya, pelajari tentang praproses teks (menyiapkan data untuk analisis). Dengan begitu, Anda akan memahami bagaimana tanda baca dihapus, bagaimana teks diubah menjadi huruf kecil, dan bagaimana karakter khusus ditangani. Meskipun tugas-tugas ini terlihat sederhana, sains dan logika di baliknya akan membantu Anda memahami bagaimana model NLP memproses teks.
Setelah semuanya dipahami, berlatihlah dengan contoh dunia nyata. Temukan sampel teks dari situs web atau platform media sosial. Lalu, terapkan berbagai metode pembersihan pada teks ini. Pendekatan praktik langsung ini akan membantu Anda melihat secara langsung bagaimana praproses mengubah data berantakan menjadi format yang siap dianalisis.
Saat berlatih, Anda akan memahami mengapa setiap langkah penting dan bagaimana kontribusinya terhadap tujuan keseluruhan menyiapkan teks untuk tugas NLP.
Langkah 3: Jelajahi metode representasi teks
Untuk bekerja secara efektif dengan data teks dalam NLP, Anda perlu memahami berbagai cara merepresentasikan data. Mulailah dengan mempelajari metode dasar seperti bag-of-words dan TF-IDF. Lalu, lanjutkan ke teknik lanjutan seperti word embedding, dan pelajari bagaimana teknik tersebut menangkap makna semantik kata.
Terapkan metode ini pada teks dunia nyata seperti artikel berita atau unggahan media sosial. Perhatikan bagaimana setiap teknik mengubah cara teks dianalisis dan memengaruhi hasil model NLP.
Langkah 4: Kerjakan tugas NLP
Selanjutnya, pahami konsep seperti analisis sentimen, klasifikasi teks, dan named entity recognition (NER). Mulailah dengan analisis sentimen untuk mengidentifikasi perasaan yang diekspresikan teks — positif, negatif, atau netral.
Untuk lebih memahami konsep-konsep ini, berlatihlah dengan proyek DataCamp, Who's Tweeting? Trump or Trudeau. Setelah menyelesaikannya, Anda akan dapat menganalisis tweet dan perasaan yang diekspresikannya.
Lalu, kerjakan klasifikasi dan pelajari cara menyortir teks ke dalam kategori berbeda.
Langkah 5: Pelajari topik NLP lanjutan
Sekarang, pelajari keterampilan lanjutan seperti deep learning, model bahasa, dan transfer learning. Membangun model dari nol bisa mahal dan memakan waktu. Itulah mengapa Anda sebaiknya belajar menggunakan model pra-latih seperti BERT.
Lakukan fine-tuning pada model-model ini untuk merangkum artikel, menjawab pertanyaan berbasis teks, dan mengklasifikasikan berbagai artikel. Contoh dunia nyata ini akan membantu Anda berkinerja lebih baik pada jenis teks tertentu.
Contoh Rencana Belajar untuk NLP
Sekarang Anda tahu langkah-langkah yang harus diambil untuk memulai, jadi ikuti rencana mingguan ini dan mulailah belajar:
|
Minggu |
Bidang fokus |
Tujuan pembelajaran |
Sumber daya |
|
Minggu 1 |
Konsep NLP |
Pelajari tentang sintaksis, semantik, pragmatik, dan representasi teks dasar (string, list, dictionary, set). |
|
|
Minggu 2 |
Representasi teks |
Pelajari tentang metode representasi teks dan teknik word embedding seperti Word2Vec atau GloVe. |
|
|
Minggu 3 |
Tugas NLP |
Terapkan pengetahuan pada analisis sentimen, klasifikasi teks, dan NER. Kenali pustaka Python. |
|
|
Minggu 4 |
Pelajari model bahasa |
Pelajari tentang model bahasa dan lakukan fine-tuning BERT untuk peringkasan teks dan tanya jawab. |
|
|
Minggu 5 |
Bangun proyek NLP |
Implementasikan proyek NLP (misalnya, chatbot atau alat analisis sentimen). |
Sebagai alternatif, Anda dapat mengikuti skill track NLP in Python dari DataCamp, yang berisi beberapa kursus untuk membawa Anda dari pemula hingga tingkat lanjut.
Sumber Terbaik untuk Belajar NLP
Baik Anda ingin mempelajari konsep dasar maupun lanjutan, ada banyak sumber, dari kursus daring hingga tutorial YouTube, untuk memulai dengan kuat. Berikut pilihan utama saya:
Kursus daring
Kursus daring memberi Anda kesempatan belajar sepanjang hayat. DataCamp menawarkan beberapa kursus hebat yang memberikan pengetahuan mendalam tentang NLP. Berikut beberapa kursus NLP yang bagus di DataCamp:
- Untuk dasar NLP: Introduction to Natural Language Processing
- Untuk aplikasi tingkat produksi dengan NLP: Advanced NLP with SpaCy
- Untuk melatih model dengan SpaCy: Natural Language Processing with SpaCy
- Temukan alat dasar untuk NLP di R: Introduction to Natural Language Processing in R
- Gunakan Python untuk memproses teks ke format yang cocok untuk machine learning: Feature Engineering for NLP in Python
Buku dan buku teks
Buku dan buku teks sangat baik untuk mempelajari masalah dan solusi NLP praktis. Mereka berguna saat Anda mengerjakan proyek panjang dan perlu memahami konsep baru.
Anda dapat membaca buku-buku ini untuk mahir dalam konsep NLP:
- Untuk dasar: Speech and Language Processing
- Untuk konsep NLP lanjutan: Natural Language Processing with Python
Channel dan tutorial YouTube
Untuk pembelajaran mandiri, tutorial YouTube adalah pilihan andalan saya. Ada beberapa channel YouTube hebat yang didedikasikan hanya untuk NLP dan implementasinya. Jadi Anda dapat menggunakannya dan berlatih bersamanya.
Berikut beberapa pilihan terbaik saya untuk Anda:
- Untuk dasar: Natural Language Processing (NLP) playlist
- Untuk word embedding: A Complete Overview of Word Embeddings
- Untuk model berbasis transformer: What is BERT and How Does It Work
- Untuk dasar transformer: Transformers For Beginners
Platform praktik
Jika Anda lebih suka praktik langsung, coba platform seperti Kaggle dan Hugging Face. Mereka menawarkan ribuan dataset untuk mengerjakan kasus penggunaan nyata. Beberapa perekrut bahkan mungkin meminta Anda menyelesaikan tugas NLP dalam kompetisi Kaggle pemain tunggal. Jadi, berlatih di platform ini sepadan dengan waktu Anda.
Lihat sumber berikut:
- Untuk dataset sederhana: Best 25 Datasets for NLP Projects
- Untuk dataset kompleks: IMDB Datasets at Hugging Face
- Untuk ulasan pelanggan: Amazon Reviews for Sentiment Analysis
Tips Menguasai NLP
Menguasai NLP memerlukan upaya konsisten dan pendekatan praktik langsung. Saya banyak belajar dalam perjalanan NLP saya, dan saya ingin berbagi beberapa tips yang membantu saya. Latihan rutin dengan konsistensi adalah cara yang bagus untuk terus maju. Namun berikut beberapa saran kunci yang perlu dipegang jika Anda ingin cepat unggul:
- Berlatih secara rutin: Teruslah berlatih untuk memahami spektrum luas konsep dan tugas NLP. Selain itu, coba masukkan latihan NLP ke rutinitas Anda, baik melalui tantangan coding maupun mengerjakan dataset berbasis teks.
- Bergabung dengan kelompok belajar atau forum: Saya selalu mendapat manfaat dari komunitas daring untuk proyek teknologi. Mereka mempertemukan pemula, praktisi data, peneliti, dan pakar AI dalam satu wadah. Karena itu, pastikan bergabung ke forum agar Anda bisa menemukan solusi untuk masalah terkait NLP apa pun.
- Kerjakan proyek NLP nyata: Untuk menonjol, Anda harus mengubah konsep seperti word embedding dan validasi model menjadi perangkat lunak nyata. Mulailah proyek Anda sendiri atau berkontribusi pada inisiatif open-source untuk memperoleh pengalaman praktis dan membangun portofolio.
- Tetap ingin tahu dan terus belajar: Karena NLP berkembang pesat, masa depannya tampak menjanjikan. Jadi, biasakan membaca makalah riset terbaru, mengikuti pemimpin pemikiran, dan mengambil kursus lanjutan untuk tetap selangkah di depan.
Penutup
Siapa pun Anda — lulusan ilmu komputer (CS) atau seseorang dengan pengalaman bertahun-tahun, menguasai NLP dapat mengantarkan Anda pada peran-peran spesialis.
Namun ingat, tugas NLP sangat beragam. Apa yang berhasil untuk satu masalah mungkin tidak berhasil untuk yang lain, jadi Anda harus menyesuaikan pendekatan berdasarkan tantangan dan data spesifik yang terlibat. Dan ini adalah sesuatu yang Anda pelajari dengan menerapkan pengetahuan teoretis ke praktik.
Untuk mulai belajar NLP dari nol hari ini, lihat Natural Language Processing in Python skill track kami.
FAQs
Apakah NLP memerlukan coding?
Ya, diperlukan sedikit coding untuk NLP, tetapi Anda tidak perlu menjadi ahli. Pemahaman dasar Python sudah cukup untuk bekerja dengan alat dan pustaka NLP. Anda juga akan menemui konsep dari machine learning, deep learning, dan statistik, yang integral dalam NLP.
Berapa penghasilan yang dapat saya peroleh dengan keterampilan NLP?
Menurut ZipRecruiter, profesional NLP memperoleh gaji rata-rata sekitar $122.738 per tahun, tergantung pengalaman dan lokasi.
Apakah NLP bagian dari AI atau ML?
NLP adalah subset AI yang sangat bergantung pada teknik machine learning (ML). NLP memungkinkan komputer memahami dan memproses bahasa manusia.
Bisakah saya belajar NLP tanpa machine learning?
Tidak, machine learning sangat penting untuk NLP. Banyak tugas NLP bergantung pada algoritme ML untuk memproses dan menganalisis data bahasa secara efektif.
Saya seorang ahli strategi konten yang senang menyederhanakan topik kompleks. Saya telah membantu perusahaan seperti Splunk, Hackernoon, dan Tiiny Host membuat konten yang menarik dan informatif untuk audiens mereka.

