{count, plural, one {Kursus} other {Kursus}}
Pengantar Data Science dengan Python
{hours} jam
503.6K
Analisis sentimen adalah teknik yang digunakan untuk menentukan nada emosional atau sentimen yang diungkapkan dalam sebuah teks. Teknik ini melibatkan analisis kata dan frasa yang digunakan dalam teks untuk mengidentifikasi sentimen yang mendasarinya, apakah positif, negatif, atau netral.
Analisis sentimen memiliki beragam penerapan, termasuk pemantauan media sosial, analisis umpan balik pelanggan, dan riset pasar.
Salah satu tantangan utama dalam analisis sentimen adalah kompleksitas bawaan bahasa manusia. Data teks sering kali mengandung sarkasme, ironi, dan bentuk bahasa kiasan lainnya yang sulit diinterpretasikan dengan metode tradisional.
Namun, kemajuan terbaru dalam pemrosesan bahasa alami (NLP) dan pembelajaran mesin memungkinkan analisis sentimen pada volume data teks yang besar dengan tingkat akurasi tinggi.
Ada beberapa cara untuk melakukan analisis sentimen pada data teks, dengan tingkat kompleksitas dan akurasi yang berbeda. Metode yang paling umum mencakup pendekatan berbasis leksikon, pendekatan berbasis machine learning (ML), dan pendekatan deep learning berbasis transformer pralatih. Mari kita lihat masing-masing secara lebih rinci:
Jenis analisis ini, seperti NLTK Vader sentiment analyzer, melibatkan penggunaan serangkaian aturan dan heuristik yang telah ditentukan untuk menentukan sentimen suatu teks. Aturan ini biasanya didasarkan pada fitur leksikal dan sintaktis dari teks, seperti keberadaan kata dan frasa positif atau negatif.
Meski analisis berbasis leksikon relatif mudah diterapkan dan diinterpretasikan, akurasinya mungkin tidak setinggi pendekatan berbasis ML atau berbasis transformer, terutama saat berhadapan dengan data teks yang kompleks atau ambigu.
Pendekatan ini melibatkan pelatihan model untuk mengidentifikasi sentimen suatu teks berdasarkan sekumpulan data latih berlabel. Model ini dapat dilatih menggunakan beragam algoritma ML, termasuk decision tree, support vector machine (SVM), dan neural network.
Pendekatan berbasis ML dapat lebih akurat daripada analisis berbasis aturan, terutama saat menangani data teks yang kompleks, namun memerlukan data latih berlabel dalam jumlah lebih besar dan mungkin lebih mahal secara komputasi.
Pendekatan berbasis deep learning, seperti pada BERT dan GPT-4, melibatkan penggunaan model pralatih yang dilatih pada sejumlah besar data teks. Model-model ini menggunakan neural network kompleks untuk mengenkode konteks dan makna teks, sehingga mencapai akurasi mutakhir pada berbagai tugas NLP, termasuk analisis sentimen. Namun, model-model ini memerlukan sumber daya komputasi yang signifikan dan mungkin tidak praktis untuk semua kasus penggunaan.
Pemilihan pendekatan akan bergantung pada kebutuhan dan batasan spesifik proyek yang dikerjakan.
Untuk menggunakan pustaka NLTK, Anda harus memiliki lingkungan Python di komputer Anda. Cara termudah untuk memasang Python adalah mengunduh dan memasang Anaconda Distribution. Distribusi ini hadir dengan lingkungan dasar Python 3 dan fitur tambahan lainnya, termasuk Jupyter Notebook. Anda juga tidak perlu memasang pustaka NLTK, karena distribusi ini sudah menyertakan NLTK dan banyak pustaka berguna lainnya.
Jika Anda memilih memasang Python tanpa distribusi apa pun, Anda dapat langsung mengunduh dan memasang Python dari python.org. Dalam kasus ini, Anda harus memasang NLTK setelah lingkungan Python siap.
Untuk memasang pustaka NLTK, buka terminal perintah dan ketik:
pip install nltkPerlu dicatat bahwa NLTK juga memerlukan beberapa data tambahan untuk diunduh sebelum dapat digunakan secara efektif. Data ini mencakup model pralatih, korpus, dan sumber daya lain yang digunakan NLTK untuk menjalankan berbagai tugas NLP. Untuk mengunduh data ini, jalankan perintah berikut di terminal atau skrip Python Anda:
import nltk

nltk.download('all')
Prapemrosesan teks adalah langkah krusial dalam melakukan analisis sentimen, karena membantu membersihkan dan menormalkan data teks, sehingga lebih mudah dianalisis. Langkah prapemrosesan melibatkan serangkaian teknik yang membantu mengubah data teks mentah menjadi bentuk yang dapat Anda gunakan untuk analisis. Beberapa teknik prapemrosesan umum meliputi tokenisasi, penghapusan stop word, stemming, dan lemmatisasi.
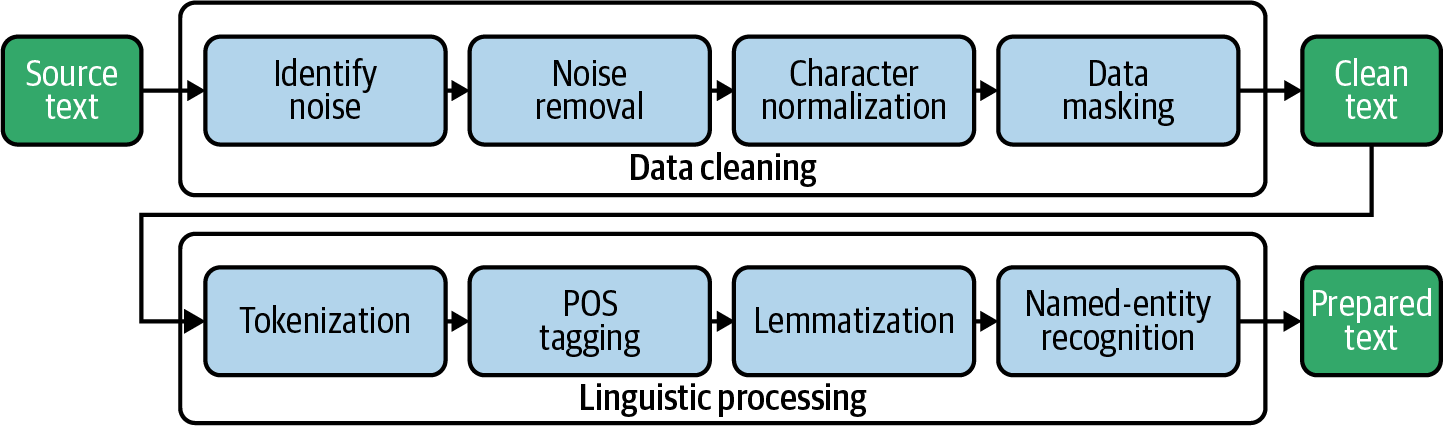
Tokenisasi adalah langkah prapemrosesan teks dalam analisis sentimen yang melibatkan pemecahan teks menjadi kata-kata atau token individual. Ini merupakan langkah penting dalam menganalisis data teks karena membantu memisahkan kata-kata individual dari teks mentah, sehingga lebih mudah dianalisis dan dipahami. Tokenisasi biasanya dilakukan menggunakan fungsi word_tokenize bawaan NLTK, yang dapat membagi teks menjadi kata dan tanda baca individual.
Penghapusan stop word adalah langkah prapemrosesan teks yang penting dalam analisis sentimen, yaitu menghapus kata-kata umum dan tidak relevan yang kecil kemungkinannya menyampaikan sentimen. Stop word adalah kata-kata yang sangat umum dalam suatu bahasa dan tidak membawa banyak makna, seperti "and," "the," "of," dan "it." Kata-kata ini dapat menimbulkan noise dan mengganggu analisis jika tidak dihapus.
Dengan menghapus stop word, kata-kata yang tersisa dalam teks lebih mungkin menunjukkan sentimen yang diungkapkan. Ini dapat membantu meningkatkan akurasi analisis sentimen. NLTK menyediakan daftar stop word bawaan untuk beberapa bahasa, yang dapat digunakan untuk menyaring kata-kata ini dari data teks.
Stemming dan lemmatisasi adalah teknik untuk mereduksi kata ke bentuk dasarnya. Stemming melibatkan penghapusan sufiks dari kata, seperti "ing" atau "ed," untuk mereduksinya ke bentuk dasar. Sebagai contoh, kata "jumping" akan di-stem menjadi "jump."
Sementara itu, lemmatisasi melibatkan pengurangan kata ke bentuk dasar berdasarkan kelas katanya. Misalnya, kata "jumped" akan dilemmatisasi menjadi "jump," tetapi kata "jumping" akan dilemmatisasi menjadi "jumping" karena merupakan present participle.
Untuk mempelajari lebih lanjut tentang stemming dan lemmatisasi, lihat tutorial kami Stemming and Lemmatization in Python.
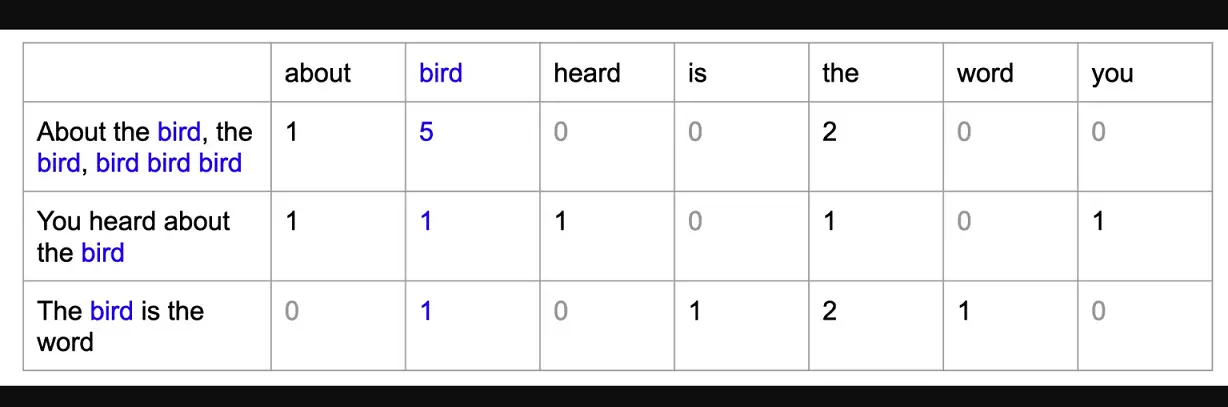
Model bag of words adalah teknik yang digunakan dalam pemrosesan bahasa alami (NLP) untuk merepresentasikan data teks sebagai sekumpulan fitur numerik. Dalam model ini, setiap dokumen atau potongan teks direpresentasikan sebagai "kantong" kata, dengan setiap kata dalam teks direpresentasikan oleh fitur atau dimensi terpisah dalam vektor yang dihasilkan. Nilai setiap fitur ditentukan oleh berapa kali kata terkait muncul dalam teks.
Model bag of words berguna dalam NLP karena memungkinkan kita menganalisis data teks menggunakan algoritma pembelajaran mesin, yang umumnya memerlukan input numerik. Dengan merepresentasikan data teks sebagai fitur numerik, kita dapat melatih model pembelajaran mesin untuk mengklasifikasikan teks atau menganalisis sentimen.
Contoh pada bagian berikutnya akan menggunakan model NLTK Vader untuk analisis sentimen pada dataset pelanggan Amazon. Dalam contoh khusus ini, kita tidak perlu melakukan langkah ini karena API NLTK Vader menerima teks sebagai input, bukan vektor numerik. Namun, jika Anda membangun model pembelajaran mesin terawasi untuk memprediksi sentimen (dengan asumsi Anda memiliki data berlabel), Anda harus mentransformasikan teks yang telah diproses menjadi model bag of words sebelum melatih model pembelajaran mesin.
Untuk melakukan analisis sentimen menggunakan NLTK di Python, data teks harus terlebih dahulu dipraproses menggunakan teknik seperti tokenisasi, penghapusan stop word, serta stemming atau lemmatisasi. Setelah teks dipraproses, kita kemudian akan meneruskannya ke Vader sentiment analyzer untuk menganalisis sentimen teks (positif atau negatif).
Pertama, kita akan mengimpor pustaka yang diperlukan untuk analisis teks dan analisis sentimen, seperti pandas untuk penanganan data, nltk untuk pemrosesan bahasa alami, dan SentimentIntensityAnalyzer untuk analisis sentimen.
Kemudian kita akan mengunduh seluruh korpus NLTK (kumpulan data linguistik) menggunakan nltk.download().
Setelah lingkungan siap, kita akan memuat dataset ulasan Amazon menggunakan pd.read_csv(). Ini akan membuat objek DataFrame di Python yang dapat kita gunakan untuk menganalisis data. Kita akan menampilkan isi DataFrame menggunakan df.
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df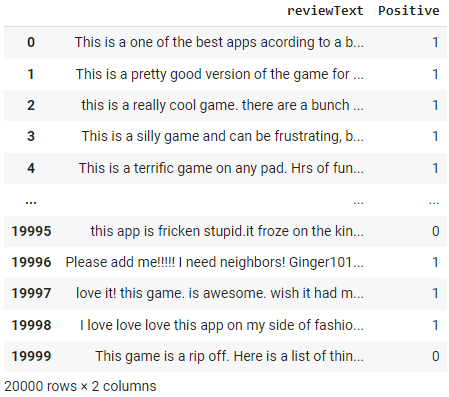
Mari kita buat fungsi preprocess_text di mana kita terlebih dahulu melakukan tokenisasi dokumen menggunakan fungsi word_tokenize dari NLTK, kemudian kita menghapus stop word menggunakan modul stepwords dari NLTK dan terakhir, kita melakukan lemmatisasi pada filtered_tokens menggunakan WordNetLemmatizer dari NLTK.
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df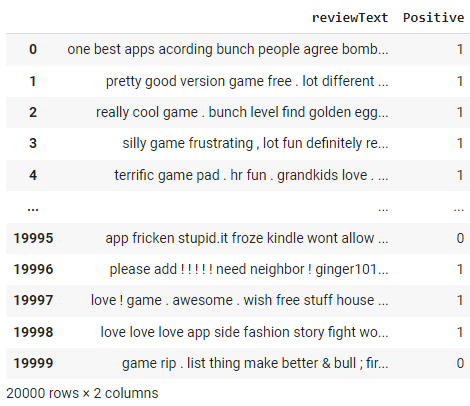
Perhatikan perubahan pada kolom "review text" sebagai hasil dari fungsi preprocess_text yang kita terapkan pada langkah di atas.
Pertama, kita akan menginisialisasi objek Sentiment Intensity Analyzer dari pustaka nltk.sentiment.vader.
Selanjutnya, kita akan mendefinisikan fungsi bernama get_sentiment yang menerima string teks sebagai inputnya. Fungsi ini memanggil metode polarity_scores dari objek analyzer untuk memperoleh kamus skor sentimen untuk teks, yang mencakup skor sentimen positif, negatif, dan netral.
Fungsi kemudian akan memeriksa apakah skor positif lebih besar dari 0 dan mengembalikan skor sentimen 1 jika iya, dan 0 jika tidak. Artinya, teks apa pun dengan skor positif akan diklasifikasikan memiliki sentimen positif, dan teks dengan skor tidak positif akan diklasifikasikan memiliki sentimen negatif.
Terakhir, kita akan menerapkan fungsi get_sentiment pada kolom reviewText dari DataFrame df menggunakan metode apply. Ini membuat kolom baru bernama sentiment di DataFrame, yang menyimpan skor sentimen untuk setiap ulasan. Kita kemudian akan menampilkan DataFrame yang telah diperbarui menggunakan df.
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df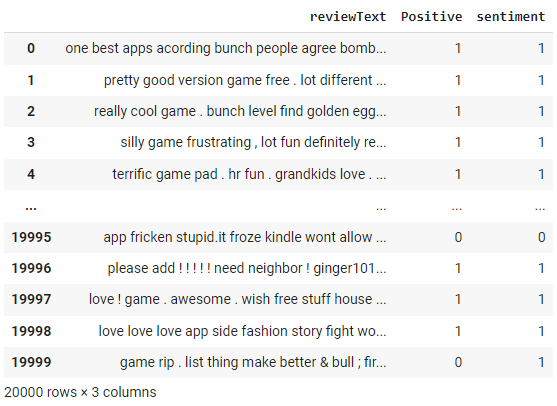
NLTK sentiment analyzer mengembalikan skor antara -1 dan +1. Kita menggunakan ambang batas 0 pada fungsi get_sentiment di atas. Apa pun di atas 0 diklasifikasikan sebagai 1 (berarti positif). Karena kita memiliki label aktual, kita dapat mengevaluasi kinerja metode ini dengan membuat confusion matrix.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))Keluaran:
[[ 1131  3636]

 [  576 14657]]
Kita juga dapat memeriksa classification report:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))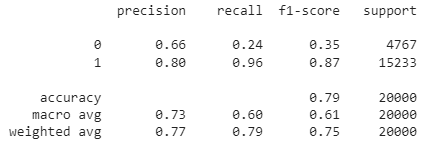
Seperti yang Anda lihat, akurasi keseluruhan model analisis sentimen berbasis aturan ini adalah 79%. Karena ini data berlabel, Anda juga dapat mencoba membangun model ML untuk mengevaluasi apakah pendekatan berbasis ML akan menghasilkan akurasi yang lebih baik.
Lihat notebook lengkapnya di ruang kerja Datacamp.
NLTK adalah pustaka yang kuat dan fleksibel untuk melakukan analisis sentimen dan tugas pemrosesan bahasa alami lainnya di Python. Dengan menggunakan NLTK, kita dapat memraproses data teks, mengonversinya menjadi model bag of words, dan melakukan analisis sentimen menggunakan Vader sentiment analyzer.
Melalui tutorial ini, kita telah mengeksplorasi dasar-dasar analisis sentimen NLTK, termasuk prapemrosesan data teks, membuat model bag of words, dan melakukan analisis sentimen menggunakan NLTK Vader. Kita juga telah membahas keunggulan dan keterbatasan analisis sentimen NLTK, serta memberikan saran untuk bacaan dan eksplorasi lebih lanjut.
Secara keseluruhan, NLTK adalah alat yang kuat dan banyak digunakan untuk melakukan analisis sentimen dan tugas pemrosesan bahasa alami lainnya di Python. Dengan menguasai teknik dan alat yang disajikan dalam tutorial ini, Anda dapat memperoleh wawasan berharga tentang sentimen data teks dan menggunakan wawasan tersebut untuk membuat keputusan berbasis data di berbagai aplikasi.
Jika Anda ingin mempelajari cara menerapkan NLP pada data dunia nyata, termasuk TED Talks, artikel, dan ulasan film, menggunakan pustaka dan kerangka kerja Python, termasuk NLTK, scikit-learn, spaCy, dan SpeechRecognition, lihat sumber daya di bawah ini:
Materi ini memberikan fondasi yang kuat untuk memroses dan menganalisis data teks menggunakan Python. Baik Anda baru di NLP maupun ingin mengembangkan keterampilan, kursus ini akan membekali Anda dengan alat dan pengetahuan untuk mengubah data tidak terstruktur menjadi wawasan berharga.
Kursus Python
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




