Terobosan ilmiah jarang terjadi dalam ruang hampa. Sebaliknya, biasanya merupakan langkah puncak dari tangga yang dibangun di atas akumulasi pengetahuan manusia. Untuk memahami keberhasilan model bahasa besar (LLM) seperti ChatGPT dan Google Bart, kita perlu menengok ke belakang dan membahas BERT.
Dikembangkan pada 2018 oleh peneliti Google, BERT adalah salah satu LLM pertama. Berkat hasil yang menakjubkan, model ini dengan cepat menjadi tolok ukur yang lazim dalam tugas NLP, termasuk pemahaman bahasa umum, tanya jawab, dan pengenalan entitas bernama.
Tertarik mempelajari lebih lanjut tentang LLM? Mulai Bab 1 dari kursus Konsep Large Language Models (LLMs) kami hari ini.
Bisa dibilang, BERT membuka jalan bagi revolusi AI generatif yang kita saksikan saat ini. Meski merupakan salah satu LLM pertama, BERT masih banyak digunakan, dengan ribuan model BERT sumber terbuka, gratis, dan pralatih yang tersedia untuk kasus penggunaan spesifik, seperti analisis sentimen, analisis catatan klinis, dan deteksi komentar beracun.
Penasaran dengan BERT? Teruskan membaca artikel ini, di mana kita akan menjelajahi arsitektur BERT, cara kerja teknologinya, beberapa aplikasi dunia nyata, serta keterbatasannya.
Apa itu BERT?
BERT (singkatan dari Bidirectional Encoder Representations from Transformers) adalah model open-source yang dikembangkan Google pada 2018. Ini merupakan eksperimen ambisius untuk menguji performa transformer –sebuah arsitektur neural inovatif yang dipresentasikan peneliti Google dalam makalah terkenal Attention is All You Need pada 2017– pada tugas pemrosesan bahasa alami (NLP).
Kunci kesuksesan BERT adalah arsitektur transformernya. Sebelum transformer muncul, pemodelan bahasa alami adalah tugas yang sangat menantang. Terlepas dari kemunculan jaringan saraf canggih –yaitu recurrent atau convolutional neural networks– hasilnya hanya sebagian berhasil.
Tantangan utama terletak pada mekanisme yang digunakan jaringan saraf untuk memprediksi kata yang hilang dalam sebuah kalimat. Saat itu, jaringan saraf mutakhir mengandalkan arsitektur encoder-decoder, sebuah mekanisme yang kuat namun menyita waktu dan sumber daya, serta tidak cocok untuk komputasi paralel.
Dengan mempertimbangkan tantangan ini, peneliti Google mengembangkan transformer, arsitektur neural inovatif berbasis mekanisme attention, seperti dijelaskan pada bagian berikut.
Bagaimana Cara Kerja BERT?
Mari kita lihat bagaimana BERT bekerja, mencakup teknologi di balik model, cara pelatihannya, dan bagaimana ia memproses data.
Arsitektur inti dan fungsionalitas
Jaringan saraf rekuren dan konvolusional menggunakan komputasi berurutan untuk menghasilkan prediksi. Artinya, mereka dapat memprediksi kata yang akan mengikuti rangkaian kata yang diberikan setelah dilatih pada himpunan data besar. Dalam pengertian itu, model-model tersebut dianggap searah atau bebas konteks.
Sebaliknya, model berbasis transformer seperti BERT, yang juga didasarkan pada arsitektur encoder-decoder, bersifat bidirectional karena memprediksi kata berdasarkan kata sebelumnya dan kata sesudahnya. Ini dicapai melalui mekanisme self-attention, sebuah lapisan yang disertakan pada encoder dan decoder. Tujuan lapisan attention adalah menangkap hubungan kontekstual yang ada antar kata dalam kalimat masukan.
Saat ini, ada banyak versi BERT pralatih, tetapi dalam makalah aslinya, Google melatih dua versi BERT: BERTbase dan BERTlarge dengan arsitektur neural berbeda. Intinya, BERTbase dikembangkan dengan 12 lapisan transformer, 12 lapisan attention, dan 110 juta parameter, sedangkan BERTlarge menggunakan 24 lapisan transformer, 16 lapisan attention, dan 340 juta parameter. Sesuai dugaan, BERTlarge mengungguli saudaranya yang lebih kecil dalam uji akurasi.
Untuk memahami secara rinci cara kerja arsitektur encoder-decoder pada transformer, kami sangat merekomendasikan Anda membaca Introduction to Using Transformers and Hugging Face kami.
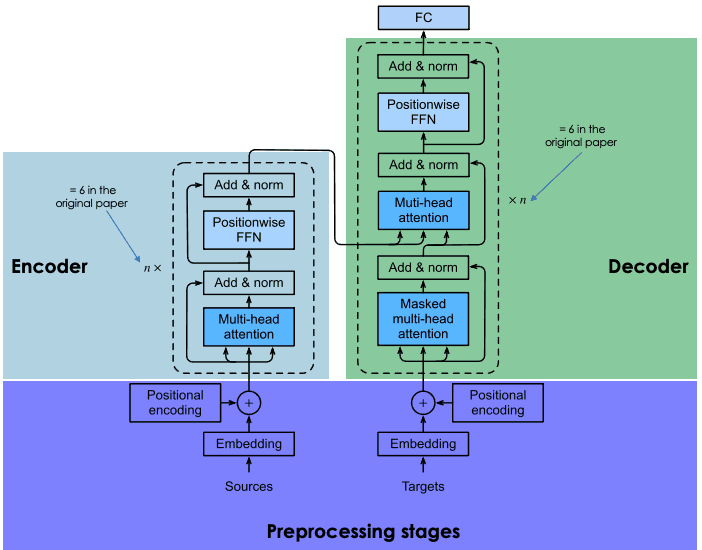
Penjelasan arsitektur transformer
Pre-training dan fine-tuning
Transformer dilatih dari nol pada korpus data yang sangat besar, melalui proses yang memakan waktu dan mahal (yang hanya dapat ditanggung oleh sejumlah perusahaan terbatas, termasuk Google).
Dalam kasus BERT, model ini dipralatih selama empat hari pada Wikipedia (~2,5 miliar kata) dan Google’s BooksCorpus (~800 juta kata). Ini memungkinkan model memperoleh pengetahuan tidak hanya dalam bahasa Inggris tetapi juga banyak bahasa lain di seluruh dunia.
Untuk mengoptimalkan proses pelatihan, Google mengembangkan perangkat keras baru, yaitu TPU (Tensor Processing Unit), yang dirancang khusus untuk tugas pembelajaran mesin.
Untuk menghindari interaksi yang tidak perlu dan mahal dalam proses pelatihan, peneliti Google menggunakan teknik transfer learning untuk memisahkan fase (pra)pelatihan dari fase fine-tuning. Ini memungkinkan pengembang memilih model pralatih, menyempurnakan data pasangan masukan-keluaran dari tugas target, dan melatih ulang head dari model pralatih menggunakan data spesifik domain. Fitur inilah yang membuat LLM seperti BERT menjadi model fondasi bagi berbagai aplikasi yang dibangun di atasnya,
Peran Masked Language Modelling dalam pemrosesan BERT
Elemen kunci untuk mencapai pembelajaran dua arah pada BERT (dan setiap LLM berbasis transformer) adalah mekanisme attention. Mekanisme ini didasarkan pada masked language modeling (MLM). Dengan menyamarkan sebuah kata dalam kalimat, teknik ini memaksa model menganalisis kata-kata lain di kedua arah dalam kalimat untuk meningkatkan peluang memprediksi kata yang disamarkan. MLM didasarkan pada teknik yang sudah dicoba di bidang visi komputer, dan sangat cocok untuk tugas yang membutuhkan pemahaman kontekstual yang baik atas seluruh urutan.
BERT adalah LLM pertama yang menerapkan teknik ini. Secara khusus, 15% kata yang sudah ditokenkan dipilih secara acak untuk disamarkan selama pelatihan. Hasilnya menunjukkan bahwa BERT dapat memprediksi kata tersembunyi dengan akurasi tinggi.
Penasaran dengan masked language modeling? Lihat Kursus Konsep Large Language Models (LLMs) kami untuk mempelajari semua detail tentang teknik inovatif ini.
Untuk Apa BERT Digunakan? Dampak BERT pada NLP
Didukung oleh transformer, BERT mampu mencapai hasil terkini pada berbagai tugas NLP. Berikut beberapa pengujian tempat BERT unggul:
- Tanya jawab. BERT adalah salah satu chatbot bertenaga transformer pertama, dengan hasil yang mengesankan.
- Analisis sentimen. Misalnya, BERT berhasil memprediksi penilaian positif atau negatif untuk ulasan film.
- Generasi teks. Sebagai pendahulu chatbot generasi berikutnya, BERT sudah mampu membuat teks panjang dengan prompt sederhana.
- Merangkum teks. Demikian pula, BERT mampu membaca dan merangkum teks dari domain kompleks, termasuk hukum dan kesehatan.
- Penerjemahan bahasa. BERT dilatih pada data dalam berbagai bahasa. Ini menjadikannya model multibahasa, yang sangat cocok untuk penerjemahan.
- Tugas pelengkapan otomatis. BERT dapat digunakan untuk pelengkapan otomatis, misalnya pada email atau layanan perpesanan.
Aplikasi BERT di Dunia Nyata
Banyak LLM telah diuji dalam lingkungan eksperimental, tetapi tidak banyak yang diintegrasikan ke dalam aplikasi mapan. Berbeda dengan itu, BERT digunakan setiap hari oleh jutaan orang (meski kita mungkin tidak menyadarinya).
Contoh yang sangat baik adalah Google Search. Pada 2020, Google mengumumkan bahwa mereka mengadopsi BERT melalui Google Search dalam lebih dari 70 bahasa. Artinya, Google menggunakan BERT untuk memberi peringkat konten dan menampilkan cuplikan unggulan. Dengan mekanisme attention, Google kini dapat menggunakan konteks pertanyaan Anda untuk memberikan informasi yang relevan, seperti ditunjukkan pada contoh berikut.
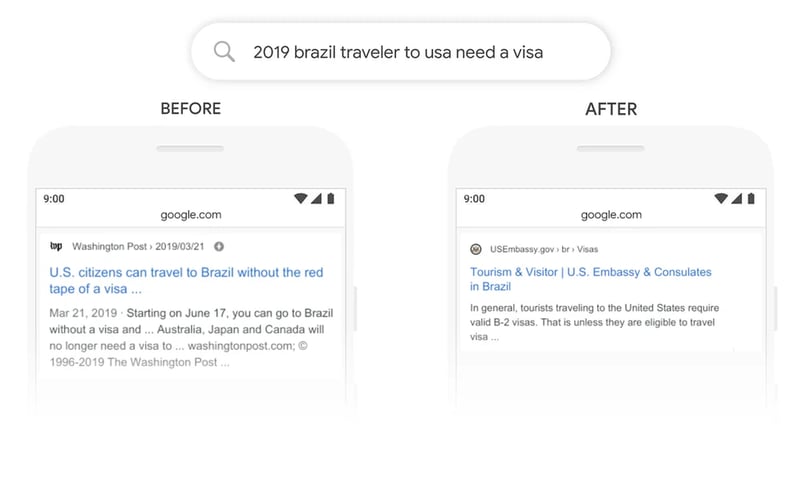
Sumber: Google
Varian dan adaptasi BERT
Namun ini baru sebagian cerita. Keberhasilan BERT sangat dipengaruhi oleh sifatnya yang open-source, yang memungkinkan pengembang mengakses kode sumber BERT asli dan membuat fitur serta peningkatan baru.
Hal ini menghasilkan sejumlah varian BERT. Di bawah ini, Anda dapat menemukan beberapa varian yang paling dikenal:
- RoBERTa. Kepanjangan dari “Robustly Optimized BERT Approach”, RoBERTa adalah varian BERT yang dibuat oleh Meta bekerja sama dengan Washington University. Dianggap sebagai versi yang lebih kuat daripada BERT asli, RoBERTa dilatih dengan dataset 10 kali lebih besar daripada yang digunakan untuk melatih BERT. Dari sisi arsitektur, perbedaan paling signifikan adalah penggunaan pembelajaran masking dinamis alih-alih masking statis. Teknik ini, yang melibatkan duplikasi data pelatihan dan melakukan masking 10 kali, setiap kali dengan strategi mask berbeda, memungkinkan RoBERTa mempelajari representasi kata yang lebih tangguh dan dapat digeneralisasi.
- DistilBERT. Sejak LLM pertama diluncurkan pada akhir 2010-an, ada tren konsisten membangun LLM yang semakin besar dan berat. Ini masuk akal, karena tampaknya ada hubungan langsung antara ukuran model dan akurasi model. Namun, semakin besar model, semakin banyak sumber daya yang dibutuhkan untuk menjalankannya, sehingga semakin sedikit pihak yang mampu menggunakannya. DistilBERT bertujuan membuat BERT lebih mudah diakses dengan menawarkan varian yang lebih kecil, lebih cepat, lebih murah, dan lebih ringan. Berdasarkan arsitektur BERT asli, DistilBERT menggunakan teknik distilasi pengetahuan selama prapelatihan untuk mengurangi ukuran sebesar 40% sambil mempertahankan 97% kemampuan pemahaman bahasanya dan 60% lebih cepat.
- ALBERT. Singkatan dari A Lite BERT, ALBERT dirancang khusus untuk meningkatkan efisiensi BERTlarge selama prapelatihan. Karena melatih model yang lebih besar sering kali mengakibatkan keterbatasan memori, waktu pelatihan yang lebih lama, dan degradasi model yang tidak terduga, para pembuat ALBERT mengembangkan dua teknik pengurangan parameter untuk mengurangi penggunaan memori dan meningkatkan kecepatan selama pelatihan.
Jika Anda ingin tahu lebih banyak tentang gerakan LLM open-source, kami sangat merekomendasikan membaca posting kami tentang Top Open-Source LLM in 2023
Fine-tuning BERT untuk tugas spesifik
Salah satu hal terbaik dari BERT, dan LLM pada umumnya, adalah proses prapelatihan dipisahkan dari proses fine-tuning. Artinya, pengembang dapat mengambil versi BERT pralatih, lalu menyesuaikannya untuk kasus penggunaan spesifik mereka.
Dalam kasus BERT, ada ratusan versi BERT hasil fine-tuning yang dikembangkan untuk beragam tugas NLP. Di bawah ini, Anda dapat menemukan daftar yang sangat, sangat terbatas dari versi BERT yang telah di-fine-tune:
- BERT-base-chinese. Versi BERTbase yang dilatih untuk tugas NLP dalam bahasa Mandarin
- BERT-base-NER. Versi BERTbase yang disesuaikan untuk pengenalan entitas bernama
- Symps_disease_bert_v3_c41. Model klasifikasi gejala-ke-penyakit untuk chatbot bahasa alami.
- BERT for Patents. adalah model yang dilatih oleh Google pada 100 juta+ paten di seluruh dunia. Berbasis BERTlarge.
Memahami Keterbatasan BERT
BERT memiliki keterbatasan dan masalah tradisional yang terkait dengan LLM. Prediksi BERT selalu bergantung pada kuantitas dan kualitas data yang digunakan untuk melatihnya. Jika data pelatihan terbatas, buruk, dan bias, BERT dapat menghasilkan hasil yang tidak akurat, berbahaya, atau bahkan halusinasi LLM.
Dalam kasus BERT asli, hal ini bahkan lebih mungkin terjadi, karena model ini dilatih tanpa Reinforcement Learning from Human Feedback (RLHF), teknik standar yang digunakan oleh model yang lebih maju, seperti ChatGPT, LLaMA 2, dan Google Bard, untuk meningkatkan keamanan AI. RLHF melibatkan penggunaan umpan balik manusia untuk memantau dan mengarahkan proses pembelajaran LLM selama pelatihan, sehingga memastikan sistem yang efektif, lebih aman, dan tepercaya.
Selain itu, meskipun dapat dianggap sebagai model kecil dibandingkan LLM mutakhir lainnya, seperti ChatGPT, model ini tetap membutuhkan daya komputasi yang cukup besar untuk menjalankannya, apalagi melatihnya dari nol. Oleh karena itu, pengembang dengan sumber daya terbatas mungkin tidak dapat menggunakannya.
Masa Depan BERT dan NLP
BERT adalah salah satu LLM modern pertama. Namun jauh dari usang, BERT masih menjadi salah satu LLM paling sukses dan paling banyak digunakan. Berkat sifatnya yang open-source, saat ini ada banyak varian dan ratusan versi BERT pralatih yang dirancang untuk tugas NLP spesifik.
Jika Anda tertarik mengikuti perkembangan BERT dan kemajuan NLP terbaru, DataCamp siap membantu. Lihat materi kurasi kami dan tetap ikuti revolusi AI generatif saat ini!





Terobosan ilmiah jarang terjadi dalam ruang hampa. Sebaliknya, biasanya merupakan langkah puncak dari tangga yang dibangun di atas akumulasi pengetahuan manusia. Untuk memahami keberhasilan model bahasa besar (LLM) seperti ChatGPT dan Google Bart, kita perlu menengok ke belakang dan membahas BERT.
Dikembangkan pada 2018 oleh peneliti Google, BERT adalah salah satu LLM pertama. Berkat hasil yang menakjubkan, model ini dengan cepat menjadi tolok ukur yang lazim dalam tugas NLP, termasuk pemahaman bahasa umum, tanya jawab, dan pengenalan entitas bernama.
Tertarik mempelajari lebih lanjut tentang LLM? Mulai Bab 1 dari kursus Konsep Large Language Models (LLMs) kami hari ini.
Bisa dibilang, BERT membuka jalan bagi revolusi AI generatif yang kita saksikan saat ini. Meski merupakan salah satu LLM pertama, BERT masih banyak digunakan, dengan ribuan model BERT sumber terbuka, gratis, dan pralatih yang tersedia untuk kasus penggunaan spesifik, seperti analisis sentimen, analisis catatan klinis, dan deteksi komentar beracun.
Penasaran dengan BERT? Teruskan membaca artikel ini, di mana kita akan menjelajahi arsitektur BERT, cara kerja teknologinya, beberapa aplikasi dunia nyata, serta keterbatasannya.
Apa itu BERT?
BERT (singkatan dari Bidirectional Encoder Representations from Transformers) adalah model open-source yang dikembangkan Google pada 2018. Ini merupakan eksperimen ambisius untuk menguji performa transformer –sebuah arsitektur neural inovatif yang dipresentasikan peneliti Google dalam makalah terkenal Attention is All You Need pada 2017– pada tugas pemrosesan bahasa alami (NLP).
Kunci kesuksesan BERT adalah arsitektur transformernya. Sebelum transformer muncul, pemodelan bahasa alami adalah tugas yang sangat menantang. Terlepas dari kemunculan jaringan saraf canggih –yaitu recurrent atau convolutional neural networks– hasilnya hanya sebagian berhasil.
Tantangan utama terletak pada mekanisme yang digunakan jaringan saraf untuk memprediksi kata yang hilang dalam sebuah kalimat. Saat itu, jaringan saraf mutakhir mengandalkan arsitektur encoder-decoder, sebuah mekanisme yang kuat namun menyita waktu dan sumber daya, serta tidak cocok untuk komputasi paralel.
Dengan mempertimbangkan tantangan ini, peneliti Google mengembangkan transformer, arsitektur neural inovatif berbasis mekanisme attention, seperti dijelaskan pada bagian berikut.
Bagaimana Cara Kerja BERT?
Mari kita lihat bagaimana BERT bekerja, mencakup teknologi di balik model, cara pelatihannya, dan bagaimana ia memproses data.
Arsitektur inti dan fungsionalitas
Jaringan saraf rekuren dan konvolusional menggunakan komputasi berurutan untuk menghasilkan prediksi. Artinya, mereka dapat memprediksi kata yang akan mengikuti rangkaian kata yang diberikan setelah dilatih pada himpunan data besar. Dalam pengertian itu, model-model tersebut dianggap searah atau bebas konteks.
Sebaliknya, model berbasis transformer seperti BERT, yang juga didasarkan pada arsitektur encoder-decoder, bersifat bidirectional karena memprediksi kata berdasarkan kata sebelumnya dan kata sesudahnya. Ini dicapai melalui mekanisme self-attention, sebuah lapisan yang disertakan pada encoder dan decoder. Tujuan lapisan attention adalah menangkap hubungan kontekstual yang ada antar kata dalam kalimat masukan.
Saat ini, ada banyak versi BERT pralatih, tetapi dalam makalah aslinya, Google melatih dua versi BERT: BERTbase dan BERTlarge dengan arsitektur neural berbeda. Intinya, BERTbase dikembangkan dengan 12 lapisan transformer, 12 lapisan attention, dan 110 juta parameter, sedangkan BERTlarge menggunakan 24 lapisan transformer, 16 lapisan attention, dan 340 juta parameter. Sesuai dugaan, BERTlarge mengungguli saudaranya yang lebih kecil dalam uji akurasi.
Untuk memahami secara rinci cara kerja arsitektur encoder-decoder pada transformer, kami sangat merekomendasikan Anda membaca Introduction to Using Transformers and Hugging Face kami.
Penjelasan arsitektur transformer
Pre-training dan fine-tuning
Transformer dilatih dari nol pada korpus data yang sangat besar, melalui proses yang memakan waktu dan mahal (yang hanya dapat ditanggung oleh sejumlah perusahaan terbatas, termasuk Google).
Dalam kasus BERT, model ini dipralatih selama empat hari pada Wikipedia (~2,5 miliar kata) dan Google’s BooksCorpus (~800 juta kata). Ini memungkinkan model memperoleh pengetahuan tidak hanya dalam bahasa Inggris tetapi juga banyak bahasa lain di seluruh dunia.
Untuk mengoptimalkan proses pelatihan, Google mengembangkan perangkat keras baru, yaitu TPU (Tensor Processing Unit), yang dirancang khusus untuk tugas pembelajaran mesin.
Untuk menghindari interaksi yang tidak perlu dan mahal dalam proses pelatihan, peneliti Google menggunakan teknik transfer learning untuk memisahkan fase (pra)pelatihan dari fase fine-tuning. Ini memungkinkan pengembang memilih model pralatih, menyempurnakan data pasangan masukan-keluaran dari tugas target, dan melatih ulang head dari model pralatih menggunakan data spesifik domain. Fitur inilah yang membuat LLM seperti BERT menjadi model fondasi bagi berbagai aplikasi yang dibangun di atasnya,
Peran Masked Language Modelling dalam pemrosesan BERT
Elemen kunci untuk mencapai pembelajaran dua arah pada BERT (dan setiap LLM berbasis transformer) adalah mekanisme attention. Mekanisme ini didasarkan pada masked language modeling (MLM). Dengan menyamarkan sebuah kata dalam kalimat, teknik ini memaksa model menganalisis kata-kata lain di kedua arah dalam kalimat untuk meningkatkan peluang memprediksi kata yang disamarkan. MLM didasarkan pada teknik yang sudah dicoba di bidang visi komputer, dan sangat cocok untuk tugas yang membutuhkan pemahaman kontekstual yang baik atas seluruh urutan.
BERT adalah LLM pertama yang menerapkan teknik ini. Secara khusus, 15% kata yang sudah ditokenkan dipilih secara acak untuk disamarkan selama pelatihan. Hasilnya menunjukkan bahwa BERT dapat memprediksi kata tersembunyi dengan akurasi tinggi.
Penasaran dengan masked language modeling? Lihat Kursus Konsep Large Language Models (LLMs) kami untuk mempelajari semua detail tentang teknik inovatif ini.
Untuk Apa BERT Digunakan? Dampak BERT pada NLP
Didukung oleh transformer, BERT mampu mencapai hasil terkini pada berbagai tugas NLP. Berikut beberapa pengujian tempat BERT unggul:
Aplikasi BERT di Dunia Nyata
Banyak LLM telah diuji dalam lingkungan eksperimental, tetapi tidak banyak yang diintegrasikan ke dalam aplikasi mapan. Berbeda dengan itu, BERT digunakan setiap hari oleh jutaan orang (meski kita mungkin tidak menyadarinya).
Contoh yang sangat baik adalah Google Search. Pada 2020, Google mengumumkan bahwa mereka mengadopsi BERT melalui Google Search dalam lebih dari 70 bahasa. Artinya, Google menggunakan BERT untuk memberi peringkat konten dan menampilkan cuplikan unggulan. Dengan mekanisme attention, Google kini dapat menggunakan konteks pertanyaan Anda untuk memberikan informasi yang relevan, seperti ditunjukkan pada contoh berikut.
Sumber: Google
Varian dan adaptasi BERT
Namun ini baru sebagian cerita. Keberhasilan BERT sangat dipengaruhi oleh sifatnya yang open-source, yang memungkinkan pengembang mengakses kode sumber BERT asli dan membuat fitur serta peningkatan baru.
Hal ini menghasilkan sejumlah varian BERT. Di bawah ini, Anda dapat menemukan beberapa varian yang paling dikenal:
Jika Anda ingin tahu lebih banyak tentang gerakan LLM open-source, kami sangat merekomendasikan membaca posting kami tentang Top Open-Source LLM in 2023
Fine-tuning BERT untuk tugas spesifik
Salah satu hal terbaik dari BERT, dan LLM pada umumnya, adalah proses prapelatihan dipisahkan dari proses fine-tuning. Artinya, pengembang dapat mengambil versi BERT pralatih, lalu menyesuaikannya untuk kasus penggunaan spesifik mereka.
Dalam kasus BERT, ada ratusan versi BERT hasil fine-tuning yang dikembangkan untuk beragam tugas NLP. Di bawah ini, Anda dapat menemukan daftar yang sangat, sangat terbatas dari versi BERT yang telah di-fine-tune:
Memahami Keterbatasan BERT
BERT memiliki keterbatasan dan masalah tradisional yang terkait dengan LLM. Prediksi BERT selalu bergantung pada kuantitas dan kualitas data yang digunakan untuk melatihnya. Jika data pelatihan terbatas, buruk, dan bias, BERT dapat menghasilkan hasil yang tidak akurat, berbahaya, atau bahkan halusinasi LLM.
Dalam kasus BERT asli, hal ini bahkan lebih mungkin terjadi, karena model ini dilatih tanpa Reinforcement Learning from Human Feedback (RLHF), teknik standar yang digunakan oleh model yang lebih maju, seperti ChatGPT, LLaMA 2, dan Google Bard, untuk meningkatkan keamanan AI. RLHF melibatkan penggunaan umpan balik manusia untuk memantau dan mengarahkan proses pembelajaran LLM selama pelatihan, sehingga memastikan sistem yang efektif, lebih aman, dan tepercaya.
Selain itu, meskipun dapat dianggap sebagai model kecil dibandingkan LLM mutakhir lainnya, seperti ChatGPT, model ini tetap membutuhkan daya komputasi yang cukup besar untuk menjalankannya, apalagi melatihnya dari nol. Oleh karena itu, pengembang dengan sumber daya terbatas mungkin tidak dapat menggunakannya.
Masa Depan BERT dan NLP
BERT adalah salah satu LLM modern pertama. Namun jauh dari usang, BERT masih menjadi salah satu LLM paling sukses dan paling banyak digunakan. Berkat sifatnya yang open-source, saat ini ada banyak varian dan ratusan versi BERT pralatih yang dirancang untuk tugas NLP spesifik.
Jika Anda tertarik mengikuti perkembangan BERT dan kemajuan NLP terbaru, DataCamp siap membantu. Lihat materi kurasi kami dan tetap ikuti revolusi AI generatif saat ini!