Kursus
Pengantar Embeddings dengan OpenAI API
3 jam
24.1K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleText embedding (sama dengan word embeddings) adalah teknik transformatif dalam natural language processing (NLP) yang meningkatkan cara mesin memahami dan memproses bahasa manusia.
Text embedding mengonversi teks mentah menjadi vektor numerik, sehingga komputer dapat memahaminya dengan lebih baik.
Alasannya sederhana — komputer hanya berpikir dalam angka dan tidak bisa memahami kata-kata manusia secara mandiri. Berkat text embeddings, komputer lebih mudah membaca, memahami teks, dan memberikan respons yang lebih akurat terhadap pertanyaan.
Dalam artikel ini, kita akan mengulas makna text embedding, pentingnya, evolusi, use case, model teratas, dan intuisinya.
Text embeddings adalah cara untuk mengonversi kata atau frasa dari teks menjadi data numerik yang dapat dipahami mesin. Anggap saja seperti mengubah teks menjadi daftar angka, di mana setiap angka menangkap sebagian makna teks. Teknik ini membantu mesin memahami konteks dan hubungan antar kata.
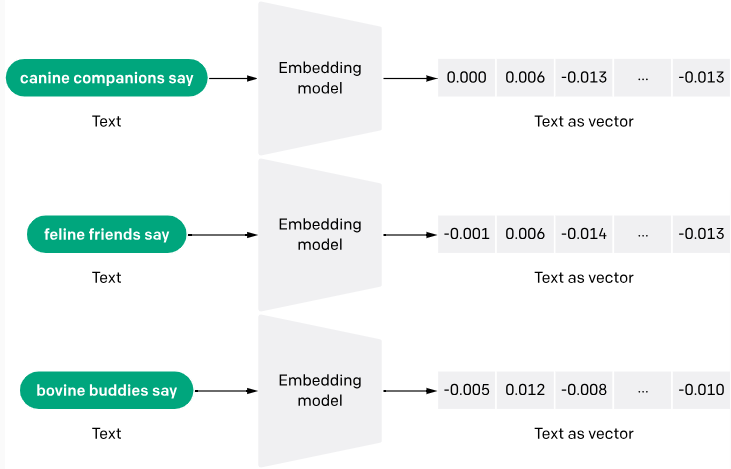
Proses menghasilkan text embeddings sering kali melibatkan neural network yang mempelajari cara mengenkode makna semantik kata ke dalam vektor padat berisi bilangan riil. Metode seperti Word2Vec dan GloVe populer untuk menghasilkan embedding ini dengan menganalisis ko-occurence kata dalam kumpulan teks yang besar.
Anda dapat mempelajari lebih lanjut tentang text embeddings dengan OpenAI API dan melihat penerapan praktisnya dalam artikel terpisah.
Model bahasa konvensional menganggap kata sebagai unit yang berdiri sendiri. Word embeddings mengatasi masalah ini dengan menempatkan kata-kata yang berbagi makna atau konteks berdekatan satu sama lain dalam ruang multi-dimensi.
Berikut beberapa alasan lain mengapa text embeddings penting:
Embedding membantu model melakukan generalisasi lebih baik terhadap kata atau frasa baru yang belum pernah dilihat, dengan memanfaatkan konteks yang dipelajari dari data pelatihan. Ini sangat berguna dalam bahasa yang dinamis di mana kata-kata baru sering bermunculan.
Embedding banyak digunakan sebagai fitur dalam berbagai tugas machine learning, seperti klasifikasi dokumen, analisis sentimen, dan penerjemahan mesin. Embedding meningkatkan kinerja algoritma dengan menyediakan bentuk data yang kaya dan ringkas yang menangkap sifat dasar tekstual.
Text embeddings mampu menangani banyak bahasa dengan mengidentifikasi dan merepresentasikan kemiripan semantik lintas bahasa. Contohnya adalah Language-agnostic BERT Sentence Embedding (LaBSE) model, yang menunjukkan kemampuan luar biasa dalam menghasilkan sentence embedding lintas bahasa yang mencakup 109 bahasa.
Metode tradisional seperti one-hot encoding dapat menghasilkan data yang jarang (terutama karena sebagian besar observasi bernilai 0) dan vektor berdimensi tinggi, yang tidak efisien untuk kosakata besar. Embedding mengurangi dimensi dan kompleksitas komputasi, sehingga lebih cocok untuk menangani data teks yang luas.
Text embeddings adalah representasi vektor padat dari data teks, di mana kata dan dokumen yang memiliki makna serupa direpresentasikan oleh vektor yang mirip dalam ruang vektor berdimensi tinggi.
Intuisi di balik text embeddings adalah menangkap hubungan semantik dan kontekstual antar elemen teks, sehingga model machine learning dapat menalar dan memproses data teks dengan lebih efektif.
Salah satu intuisi inti di balik text embeddings adalah hipotesis distribusional, yang menyatakan bahwa kata atau frasa yang muncul dalam konteks serupa cenderung memiliki makna yang serupa.
Sebagai contoh, pertimbangkan kata "king" dan "queen." Meskipun bukan sinonim, keduanya berbagi konteks yang mirip terkait kerajaan dan monarki. Text embeddings bertujuan menangkap kemiripan semantik ini dengan merepresentasikan kata-kata tersebut menggunakan vektor yang saling berdekatan dalam ruang vektor.
Intuisi lain di balik text embeddings adalah gagasan operasi ruang vektor. Dengan merepresentasikan teks sebagai vektor numerik, kita dapat menggunakan operasi ruang vektor seperti penjumlahan, pengurangan, dan cosine similarity untuk menangkap dan memanipulasi hubungan semantik antar kata dan frasa. Misalnya, pertimbangkan contoh berikut:
king - man + woman ≈ queen
Dalam contoh ini, operasi vektor "king - man + woman" dapat menghasilkan vektor yang sangat dekat dengan embedding untuk "queen," menangkap hubungan analogis di antara kata-kata ini.
Intuisi lain yang ingin saya soroti adalah reduksi dimensi dalam text embedding. Representasi teks yang jarang secara tradisional, seperti one-hot encoding, dapat memiliki dimensi yang sangat tinggi (sama dengan ukuran kosakata). Di sisi lain, text embeddings biasanya memiliki dimensi yang lebih rendah (misalnya, 300 dimensi), sehingga dapat menangkap fitur paling penting dari teks sambil mengurangi noise dan kompleksitas komputasi.
Saya akan menggunakan contoh restoran untuk menggambarkan intuisi umum word embeddings:
Bayangkan Anda memiliki korpus ulasan restoran dan ingin membangun sistem yang secara otomatis mengklasifikasikan sentimen setiap ulasan sebagai positif atau negatif. Saya menyarankan menggunakan text embeddings untuk merepresentasikan setiap ulasan sebagai vektor padat, sehingga dapat menangkap makna semantik dan sentimen yang diungkapkan dalam teks.
Mari kita pertimbangkan dua ulasan:
Ulasan 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
Ulasan 2: "The food was mediocre, and the service was poor. I won't be going back."
Meskipun kedua ulasan ini tidak banyak berbagi kata, embedding-nya seharusnya berjauhan dalam ruang vektor, mencerminkan sentimen yang berlawanan. Kata-kata sentimen positif seperti "delicious" dan "excellent" dalam Ulasan 1 akan memiliki embedding yang lebih dekat ke wilayah positif dalam ruang vektor, sedangkan kata-kata sentimen negatif seperti "mediocre" dan "poor" dalam Ulasan 2 akan lebih dekat ke wilayah negatif.
Dengan melatih model machine learning pada text embeddings ini, model dapat belajar memetakan pola semantik dan informasi sentimen yang dikodekan dalam embedding ke label sentimen yang sesuai (positif atau negatif), sehingga mengklasifikasikan ulasan baru yang belum pernah dilihat dengan akurat.
Menurut buku “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” - oleh Mohammad Taher Pilehvar dan Jose Camacho-Collados, text embeddings,
“utama dipopulerkan setelah 2013, dengan diperkenalkannya Word2vec.”
Tahun tersebut memang menandai terobosan besar bagi text embeddings. Namun, riset tentang text embeddings sudah dimulai sejak 1950-an. Meskipun bagian ini tidak lengkap, saya akan membahas beberapa tonggak utama dalam evolusi text embeddings.
Dari 1950-an hingga 2000-an, metode seperti one-hot encoding dan Bag-of-Words (BoW) menjadi standar. Sayangnya, metode ini kurang memadai dan menimbulkan beberapa tantangan, seperti:
TF-IDF (Term Frequency–Inverse Document Frequency) adalah upaya awal lain pada tahun 70-an untuk menangkap teks sebagai angka. Pendekatan ini menghitung bobot setiap kata tidak hanya berdasarkan frekuensinya dalam dokumen tertentu, tetapi juga berdasarkan tingkat umum kemunculannya di seluruh dokumen, memberikan nilai lebih tinggi pada kata yang kurang umum. Meskipun lebih baik daripada one-hot encoding karena menawarkan lebih banyak wawasan, pendekatan ini tetap belum mampu menangkap makna semantik kata.
Menurut IBM, 2000-an dimulai dengan para peneliti,
“menggali neural language models (NLM), yang menggunakan neural network untuk memodelkan hubungan antar kata dalam ruang kontinu. Model-model awal ini meletakkan dasar bagi pengembangan word embeddings di kemudian hari.”
Contoh awalnya adalah diperkenalkannya "Neural probabilistic language models" oleh Bengio dkk. sekitar tahun 2000, yang bertujuan mempelajari representasi terdistribusi dari kata.
Selanjutnya, pada 2013, Word2Vec hadir sebagai model revolusioner yang memperkenalkan gagasan mengubah kata menjadi vektor numerik. Vektor-vektor ini menangkap kemiripan semantik, sehingga kata-kata dengan makna serupa menjadi lebih dekat dalam ruang vektor. Ini seperti membuat peta kata berdasarkan hubungannya.
Pada 2014, GloVe diperkenalkan dalam makalah riset berjudul “Glove: Global Vectors for Word Representation” oleh Jeffery Pennington dan rekan penulisnya. GloVe menyempurnakan Word2Vec dengan lebih baik memahami makna kata dengan mempertimbangkan konteks langsung suatu kata dan penggunaan keseluruhannya di korpus.
Pada periode ini, metode seperti attention mechanism (2017) serta Transfer Learning dan Konteks (2018) mulai dikenal.
Attention mechanism memungkinkan model memfokuskan perhatian pada bagian-bagian tertentu dari sebuah kalimat dan memberikan bobot berbeda berdasarkan tingkat pentingnya. Ini membantu model memahami hubungan antar kata dan bagaimana kontribusinya terhadap makna.
Sebagai contoh, dalam kalimat "The quick brown fox jumps over the lazy dog," mekanisme attention mungkin memberikan perhatian lebih pada "quick" dan "jumps" saat memprediksi kata berikutnya, dibandingkan dengan "the" atau "brown."
Di sisi lain, Transfer Learning dan Konteks membuka jalan bagi penggunaan model pralatih. Teknik seperti ULMFiT dan BERT memungkinkan model pralatih ini disesuaikan untuk tugas spesifik. Ini berarti dibutuhkan lebih sedikit data dan daya komputasi untuk mencapai performa tinggi.
Embedding API adalah pendekatan terbaru untuk text embedding. Meskipun terbilang baru, kemunculannya secara bertahap sudah dimulai pada 2010-an, ketika solusi AI berbasis cloud dan kemajuan model pralatih mulai meluas.
Maju cepat ke 2020-an. Adopsi API tumbuh pesat di komunitas pengembang, demikian pula embedding API. Embedding API memudahkan memperoleh embedding teks melalui model pralatih.
Contoh bagus embedding API adalah OpenAI embedding API. OpenAI memperkenalkan Embedding API dengan pembaruan signifikan pada Desember 2022. API ini menawarkan model terpadu bernama text-embedding-ada-002, yang mengintegrasikan kemampuan dari beberapa model sebelumnya ke dalam satu model. Model ini dirancang untuk unggul dalam tugas seperti pencarian teks, pencarian kode, dan kemiripan kalimat.
Mari bahas beberapa use case text embeddings.
Word embeddings memungkinkan mesin pencari memahami makna mendasar dari kueri Anda dan menemukan dokumen yang relevan, bahkan jika dokumen tersebut tidak mengandung kata yang persis sama dengan yang Anda gunakan. Ini sangat membantu untuk pencarian yang ambigu atau menemukan konten serupa.
Platform e-commerce, media sosial, dan layanan streaming adalah contoh umum aplikasi yang menggunakan text embeddings untuk merekomendasikan produk atau konten berdasarkan preferensi Anda sebelumnya. Dengan menganalisis deskripsi dan ulasan item yang pernah Anda interaksikan, mereka dapat menyarankan hal-hal serupa yang mungkin Anda minati.
Meta (Facebook) menggunakan text embeddings untuk pencarian sosialnya. Anda dapat mempelajari lebih lanjut dalam abstrak ini.
Text embeddings melampaui penerjemahan kata demi kata. Embedding mempertimbangkan konteks dan makna teks, menghasilkan terjemahan yang lebih akurat dan terdengar alami.
Chatbot yang didukung text embeddings dapat memahami maksud di balik pertanyaan Anda dan merespons dengan lebih masuk akal dan menarik. Chatbot juga dapat menganalisis sentimen pesan Anda dan menyesuaikan gaya komunikasinya.
Word embeddings dapat digunakan untuk menghasilkan berbagai format teks kreatif, seperti deskripsi produk atau postingan media sosial. Merek juga dapat menggunakan text embeddings untuk menganalisis percakapan di media sosial dan memahami sentimen pelanggan terhadap produk atau layanan mereka.
Berikut adalah model text embedding teratas, mencakup opsi open-source dan closed-source:
Seperti yang sudah dibahas, Word2Vec adalah salah satu model text embedding pelopor. Model ini dikembangkan oleh Tomas Mikolov dan rekan-rekannya di Google. Word2Vec menggunakan shallow neural network untuk menghasilkan vektor kata yang menangkap kemiripan semantik.
Word2Vec memanfaatkan dua arsitektur model: Continuous Bag-of-Words (CBOW) dan Skip-Gram. CBOW memprediksi sebuah kata berdasarkan konteks di sekitarnya, sedangkan Skip-Gram memprediksi kata-kata sekitar berdasarkan kata yang diberikan. Proses ini membantu mengenkode hubungan semantik antar kata.
Pustaka NLP populer seperti Gensim dan spaCY menyediakan implementasi Word2Vec. Anda dapat menemukan versi open-source Word2vec yang di-host oleh Google dan dirilis di bawah lisensi Apache 2.0.
GloVe dari Stanford adalah model lain yang banyak digunakan. Model ini berfokus pada penangkapan konteks lokal dan global dengan menganalisis statistik ko-occurence kata dalam korpus teks besar. GloVe membangun matriks ko-occurence kata lalu melakukan faktorisasi untuk memperoleh vektor kata. Proses ini mempertimbangkan ko-occurence kata yang dekat maupun jauh, menghasilkan pemahaman makna kata yang lebih komprehensif.
GloVe juga bersifat open-source. Vektor GloVe pralatih tersedia untuk diunduh, dan implementasinya dapat ditemukan di pustaka seperti Gensim.
FastText, dikembangkan oleh Facebook (kini Meta), adalah perluasan Word2Vec yang mengatasi keterbatasan dalam menangani kata di luar kosakata (OOV). FastText memasukkan informasi subword untuk merepresentasikan kata, sehingga dapat membuat embedding untuk kata yang belum pernah dilihat.
FastText menguraikan kata menjadi n-gram karakter (subword). Mirip dengan Word2Vec, FastText melatih vektor kata berdasarkan unit subword ini. Hal ini memungkinkan model merepresentasikan kata baru berdasarkan makna subword penyusunnya.
FastText bersifat open-source dan tersedia melalui pustaka FastText. Vektor FastText pralatih juga dapat diunduh untuk berbagai bahasa.
Embedding v3 (Text-embedding-3) adalah rilis terbaru dari model embedding OpenAI. Model ini hadir dalam dua kelas: text-embedding-3-small (model yang lebih kecil) dan text-embedding-3-large (model yang lebih besar). Model ini bersifat closed-source, dan Anda memerlukan API berbayar untuk mengaksesnya.
Model Text-embedding-3 mentransformasikan teks menjadi representasi numerik dengan terlebih dahulu memecahnya menjadi token (kata atau subword). Setiap token dipetakan ke vektor dalam ruang berdimensi tinggi. Sebuah encoder Transformer kemudian menganalisis vektor ini, mempertimbangkan konteks setiap kata berdasarkan sekelilingnya.
Akhirnya, model menghasilkan satu vektor yang merepresentasikan keseluruhan teks, menangkap makna keseluruhan dan hubungan antar kata di dalamnya. Versi besar memiliki arsitektur yang lebih kompleks dan dimensi lebih tinggi untuk akurasi yang berpotensi lebih baik, sementara versi kecil memprioritaskan kecepatan dan efisiensi dengan arsitektur yang lebih sederhana dan dimensi lebih rendah.
Untuk mempelajari lebih lanjut tentang OpenAI embeddings, lihat panduan kami: Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings.
USE adalah model sentence embedding closed-source yang dibuat oleh Google AI. Model ini mengonversi teks menjadi embedding berdimensi tinggi yang mencerminkan makna semantik kalimat atau paragraf pendek.
Berbeda dengan model yang membuat embedding untuk kata per kata, USE menangani keseluruhan kalimat menggunakan deep neural network pralatih pada korpus teks yang beragam. Desain ini memungkinkannya menangkap hubungan semantik secara efektif, menghasilkan vektor berukuran tetap untuk kalimat berdurasi variabel yang meningkatkan efisiensi komputasi.
Google menyediakan akses melalui repositori TensorFlow Hub.
Dalam panduan ini, kita mendapatkan pengenalan komprehensif tentang text embeddings, apa artinya, pentingnya, dan tonggak utama dalam evolusinya. Kita juga meninjau use case text embedding dan model text embedding teratas.
Untuk mempelajari lebih dalam tentang AI, NLP, dan text embeddings, lihat sumber berikut:
Pelajari Lebih Lanjut tentang AI bersama DataCamp
Kursus
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



