

Kursus
Bekerja dengan DeepSeek di Python
3 jam
1.4K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GooglePada Januari 2025, DeepSeek merilis DeepSeek-R1, langkah berikutnya dalam pengerjaan model penalaran mereka. Ini merupakan peningkatan dari DeepSeek-R1-Lite-Preview sebelumnya dan menunjukkan keseriusan mereka untuk bersaing dengan o1 dari OpenAI.
Sejak itu, DeepSeek terus menyempurnakan modelnya. Pada Mei 2025, mereka merilis DeepSeek-R1-0528, versi yang ditingkatkan dengan kinerja tolok ukur yang lebih baik, lebih sedikit halusinasi, dan kapabilitas baru seperti function calling dan dukungan output JSON.
Meskipun DeepSeek mungkin sedikit tertinggal dari para pesaing di beberapa area, sifatnya yang open-source dan harga yang jauh lebih rendah menjadikannya pilihan menarik bagi komunitas AI.
Dalam blog ini, saya akan menguraikan fitur utama DeepSeek-R1, proses pengembangan, model-model distil, cara mengaksesnya, harga, dan perbandingannya dengan model-model OpenAI.
Saya awalnya menulis artikel ini pada hari DeepSeek-R1 dirilis, namun kini telah saya perbarui dengan bagian baru yang membahas dampaknya—bagaimana pengaruhnya terhadap pasar saham, ekonomi AI (termasuk paradoks Jevons dan komoditisasi model AI), serta tuduhan OpenAI bahwa DeepSeek melakukan distilasi model mereka. Saya juga menambahkan bagian terkini tentang DeepSeek-R1-0528 yang baru.
Kami terus memperbarui pembaca tentang kabar terbaru AI melalui The Median, buletin Jumat gratis kami yang merangkum cerita-cerita kunci setiap pekan. Berlangganan dan tetap tajam hanya dalam beberapa menit setiap minggu:
DeepSeek-R1 adalah model penalaran open-source yang dikembangkan oleh DeepSeek, perusahaan AI asal Tiongkok, untuk menangani tugas-tugas yang memerlukan inferensi logis, pemecahan masalah matematis, dan pengambilan keputusan real-time.
Yang membedakan model penalaran seperti DeepSeek-R1 dan o1 dari OpenAI dengan model bahasa tradisional adalah kemampuannya untuk memperlihatkan bagaimana mereka sampai pada suatu kesimpulan.
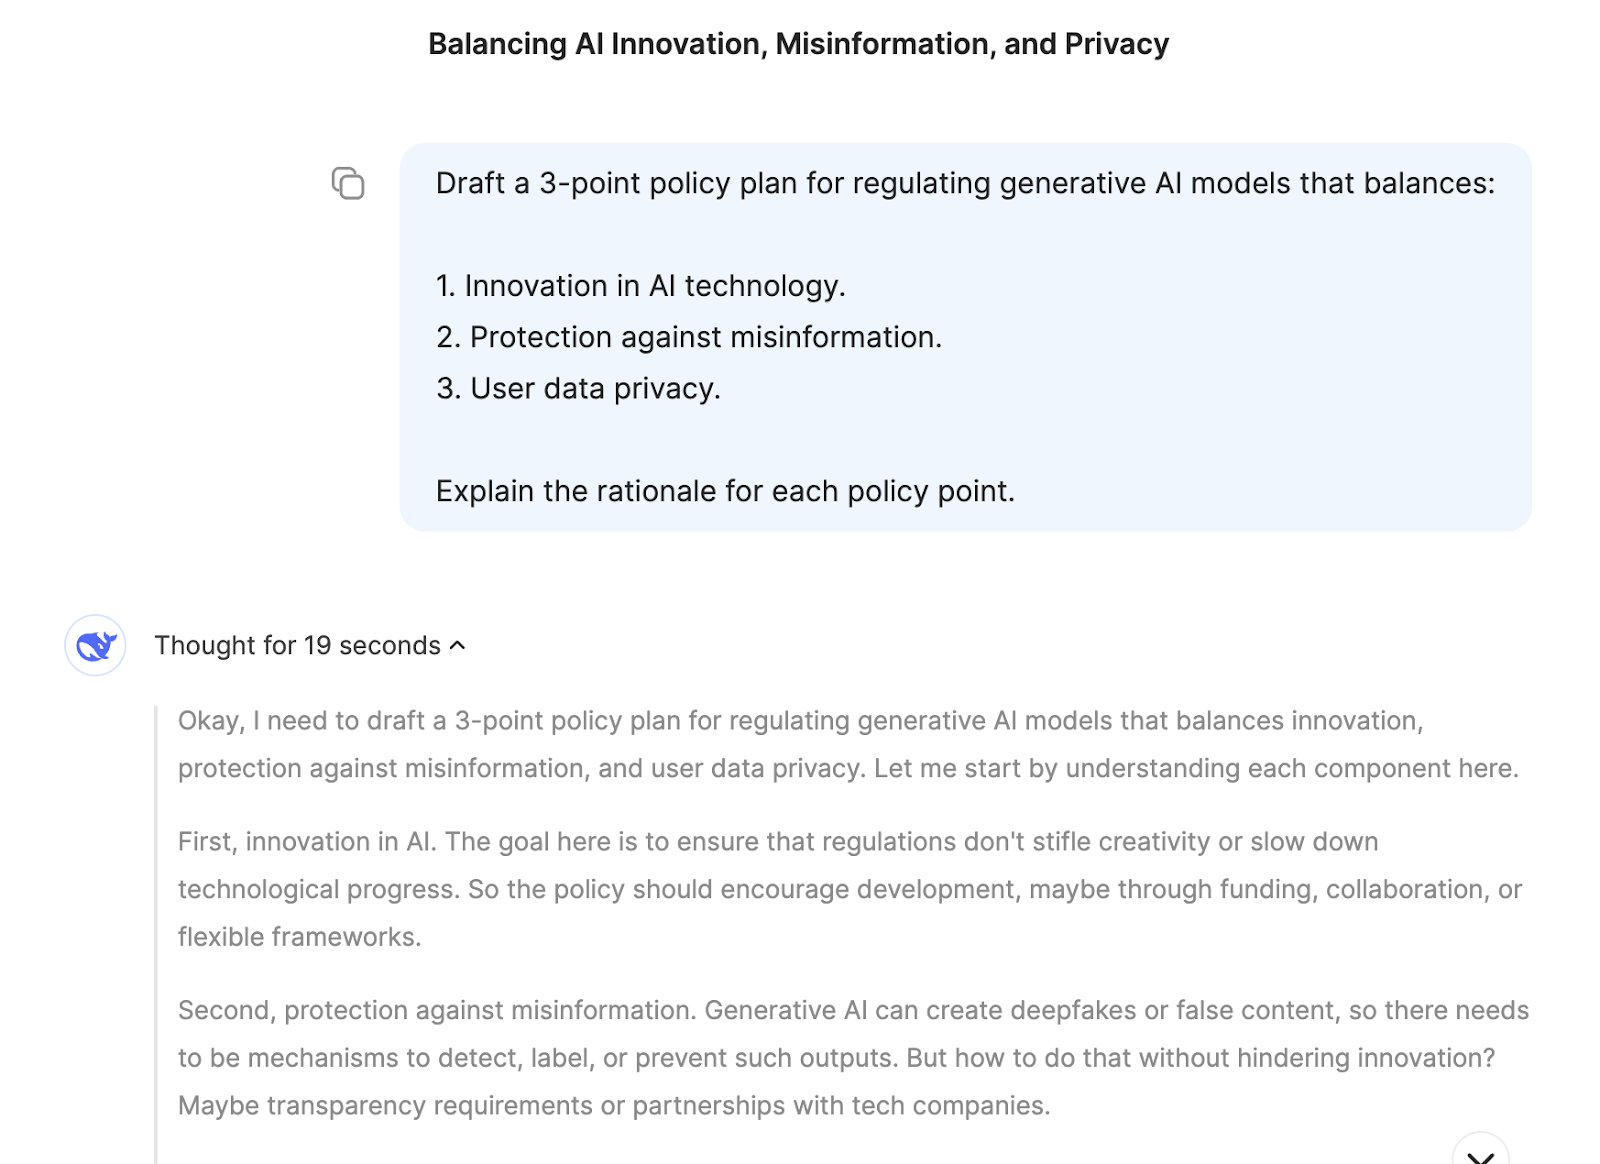
Dengan DeepSeek-R1, Anda dapat menelusuri logikanya, sehingga lebih mudah untuk memahami dan, bila perlu, mempertanyakan keluarannya. Kapabilitas ini memberi model penalaran keunggulan di bidang yang memerlukan hasil yang dapat dijelaskan, seperti riset atau pengambilan keputusan kompleks.
Yang membuat DeepSeek-R1 sangat kompetitif dan menarik adalah sifatnya yang open-source. Berbeda dari model proprietari, sifat open-source memampukan pengembang dan peneliti untuk mengeksplorasi, memodifikasi, dan menerapkannya dalam batas teknis tertentu, seperti kebutuhan sumber daya.
Di bagian ini, saya akan menjelaskan bagaimana DeepSeek-R1 dikembangkan, dimulai dari pendahulunya, DeepSeek-R1-Zero.
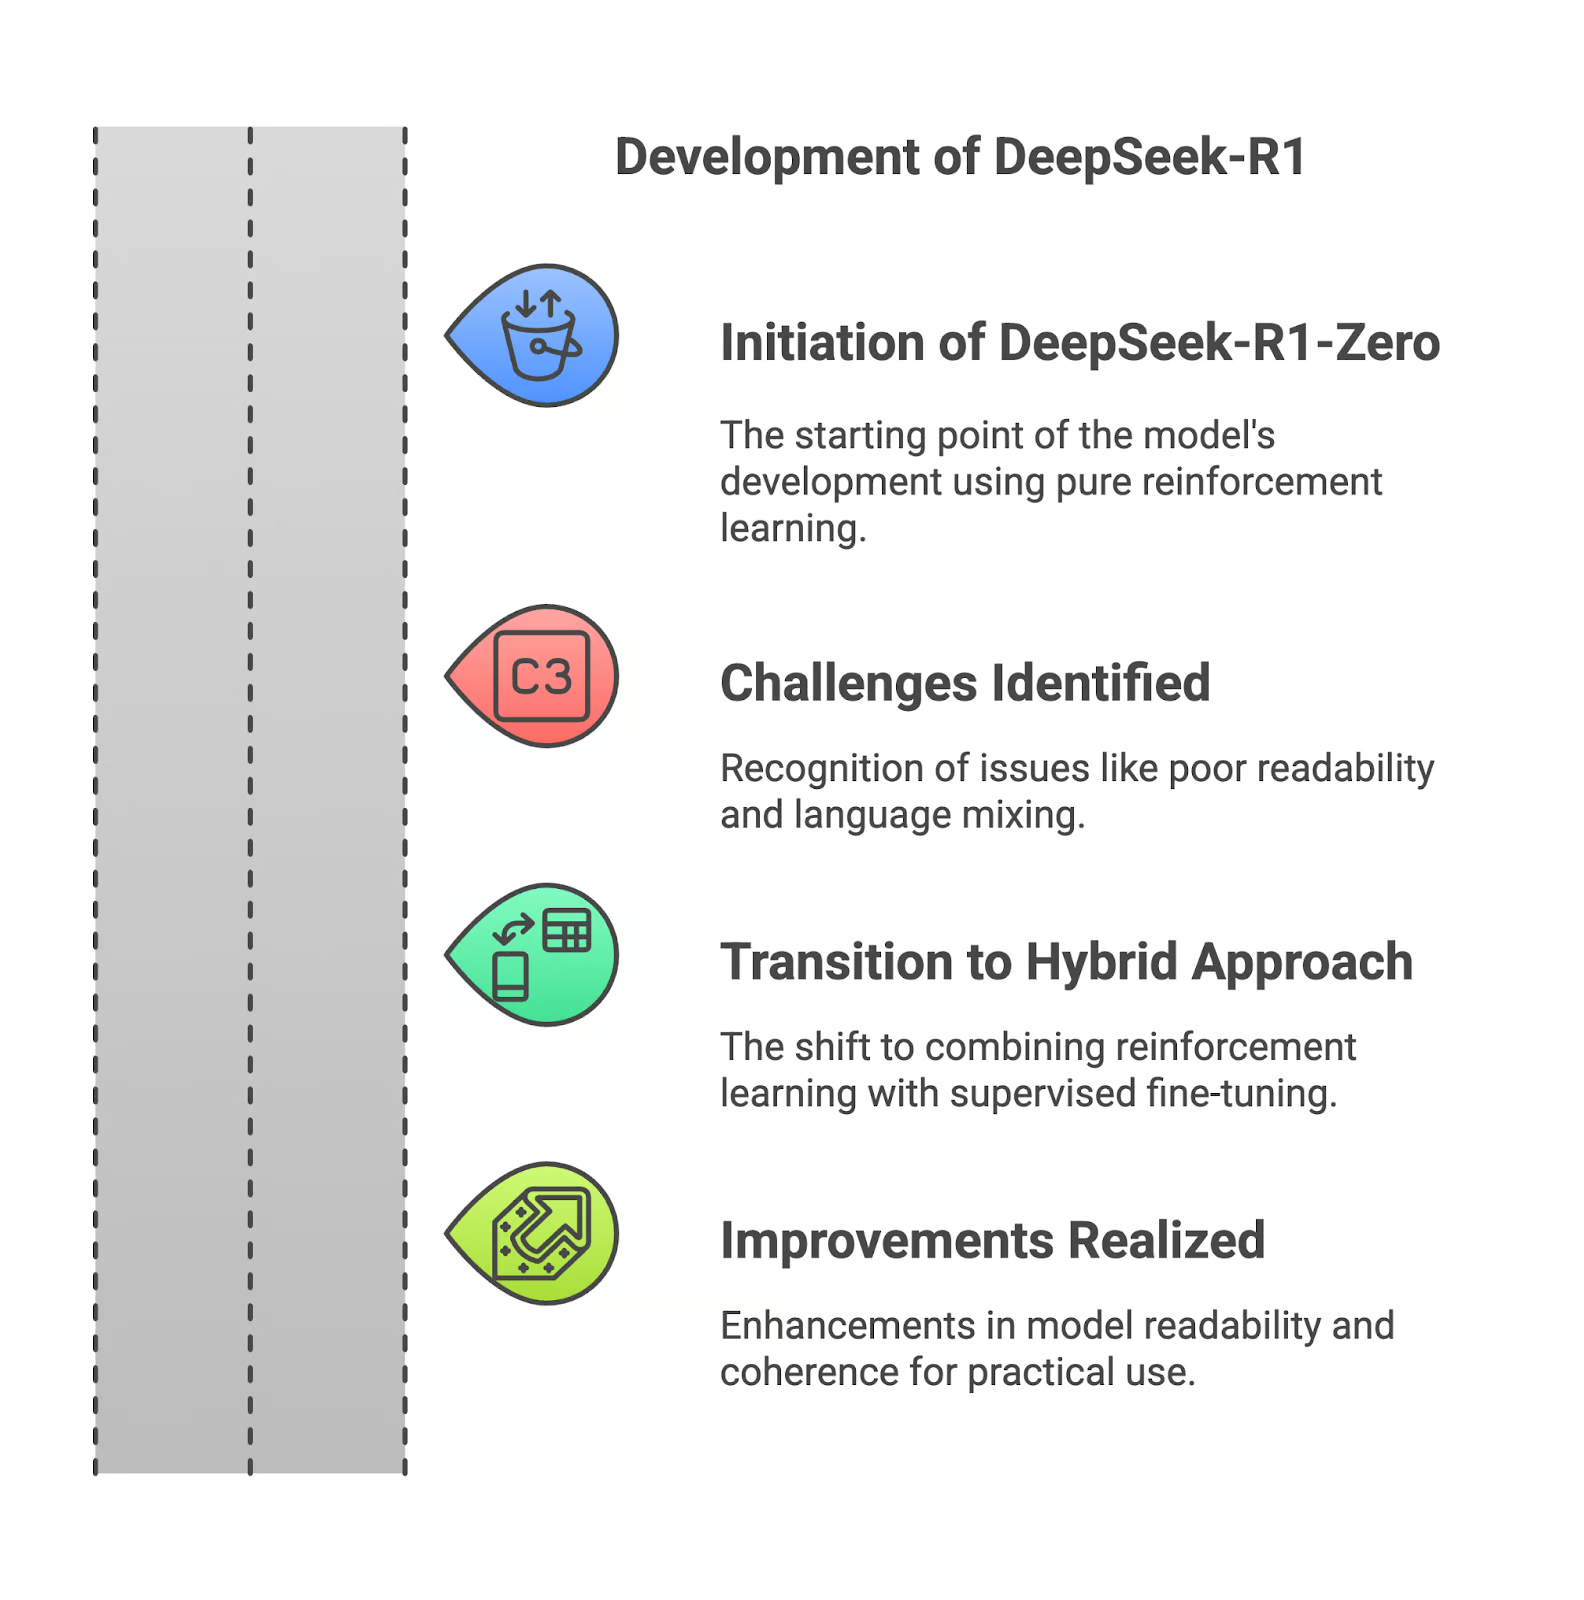
DeepSeek-R1 berawal dari R1-Zero, model yang dilatih sepenuhnya melalui reinforcement learning. Meskipun pendekatan ini memungkinkannya mengembangkan kemampuan penalaran yang kuat, ada kekurangan besar. Keluaran sering sulit dibaca, dan model kadang mencampur bahasa dalam responsnya. Keterbatasan ini membuat R1-Zero kurang praktis untuk penggunaan dunia nyata.
Ketergantungan pada reinforcement learning murni menghasilkan keluaran yang logis namun kurang terstruktur. Tanpa panduan data tersupervisi, model kesulitan mengomunikasikan penalarannya secara efektif. Ini menjadi hambatan bagi pengguna yang membutuhkan kejelasan dan ketepatan hasil.
Untuk mengatasi masalah ini, DeepSeek mengubah proses pengembangan R1 dengan menggabungkan reinforcement learning dan fine-tuning tersupervisi. Pendekatan hibrida ini mengikutkan dataset terkurasi, meningkatkan keterbacaan dan koherensi model. Masalah seperti pencampuran bahasa dan penalaran yang terfragmentasi berkurang signifikan, menjadikan model lebih layak untuk penggunaan praktis.
Jika Anda ingin mempelajari lebih lanjut tentang pengembangan DeepSeek-R1, saya rekomendasikan membaca makalah rilis.
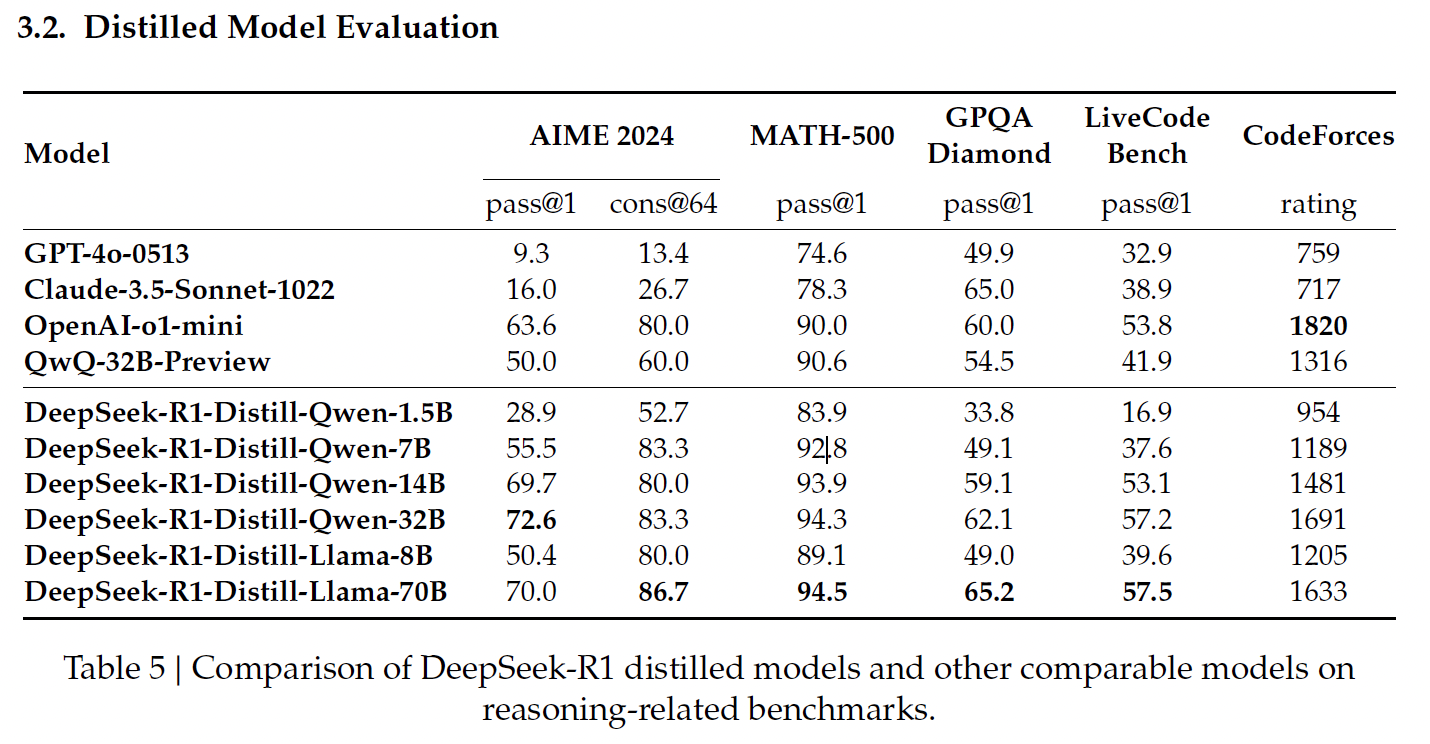
Distilasi dalam AI adalah proses membuat model yang lebih kecil dan efisien dari model yang lebih besar, mempertahankan banyak daya penalarannya sekaligus mengurangi beban komputasi. DeepSeek menerapkan teknik ini untuk membuat serangkaian model distil dari R1, menggunakan arsitektur Qwen dan Llama.
Sumber: makalah rilis DeepSeek
Model distil berbasis Qwen dari DeepSeek berfokus pada efisiensi dan skalabilitas, menawarkan keseimbangan antara performa dan kebutuhan komputasi.
Ini adalah model distil terkecil, meraih 83,9% pada MATH-500. MATH-500 menguji kemampuan menyelesaikan soal matematika tingkat sekolah menengah dengan penalaran logis dan solusi bertahap. Hasil ini menunjukkan model mampu menangani tugas matematika dasar dengan baik meski berukuran ringkas.
Namun, performanya turun signifikan pada LiveCodeBench (16,9%), tolok ukur untuk menilai kemampuan ngoding, menyoroti keterbatasannya dalam tugas pemrograman.
Qwen-7B menonjol di MATH-500 dengan skor 92,8%, menunjukkan kemampuan penalaran matematis yang kuat. Ia juga tampil cukup baik pada GPQA Diamond (49,1%), yang mengevaluasi tanya jawab faktual, menandakan keseimbangan yang baik antara penalaran matematis dan faktual.
Namun, performanya pada LiveCodeBench (37,6%) dan CodeForces (rating 1189) menunjukkan model ini kurang cocok untuk tugas ngoding yang kompleks.
Model ini tampil baik pada MATH-500 (93,9%), mencerminkan kemampuannya menangani masalah matematika kompleks. Skor 59,1% pada GPQA Diamond juga menunjukkan kompetensi dalam penalaran faktual.
Performa pada LiveCodeBench (53,1%) dan CodeForces (rating 1481) menunjukkan masih ada ruang untuk peningkatan di tugas ngoding dan penalaran spesifik pemrograman.
Model berbasis Qwen terbesar meraih skor tertinggi di antara rekannya pada AIME 2024 (72,6%), yang mengevaluasi penalaran matematis bertahap tingkat lanjut. Ia juga unggul pada MATH-500 (94,3%) dan GPQA Diamond (62,1%), menunjukkan kekuatan dalam penalaran matematis dan faktual.
Hasilnya pada LiveCodeBench (57,2%) dan CodeForces (rating 1691) menyiratkan model ini serbaguna, namun masih belum dioptimalkan untuk tugas pemrograman dibanding model yang terspesialisasi untuk ngoding.
Model distil berbasis Llama dari DeepSeek memprioritaskan performa tinggi dan kemampuan penalaran lanjut, terutama unggul pada tugas yang memerlukan ketelitian matematika dan faktual.
Llama-8B tampil baik pada MATH-500 (89,1%) dan cukup pada GPQA Diamond (49,0%), menunjukkan kemampuannya menangani penalaran matematis dan faktual. Namun, skornya lebih rendah pada tolok ukur ngoding seperti LiveCodeBench (39,6%) dan CodeForces (rating 1205), yang menyoroti keterbatasannya dalam tugas terkait pemrograman dibanding model berbasis Qwen.
Model distil terbesar, Llama-70B, menyuguhkan performa papan atas pada MATH-500 (94,5%), yang terbaik di antara semua model distil, dan meraih skor kuat 86,7% di AIME 2024, menjadikannya pilihan unggul untuk penalaran matematis tingkat lanjut.
Model ini juga tampil baik pada LiveCodeBench (57,5%) dan CodeForces (rating 1633), menyiratkan kompetensi lebih tinggi dalam tugas ngoding dibanding sebagian besar model lain. Di ranah ini, model tersebut sebanding dengan o1-mini atau GPT-4o dari OpenAI.
Anda dapat mengakses DeepSeek-R1 melalui dua metode utama: platform web DeepSeek Chat dan DeepSeek API, sehingga Anda bisa memilih opsi yang paling sesuai kebutuhan.
Platform DeepSeek Chat menawarkan cara langsung untuk berinteraksi dengan DeepSeek-R1. Untuk mengaksesnya, Anda bisa menuju langsung ke halaman chat atau klik Start Now di halaman beranda.
Setelah mendaftar, Anda dapat memilih mode “Deep Think” untuk merasakan kemampuan penalaran bertahap Deepseek-R1.
Untuk mengintegrasikan DeepSeek-R1 ke dalam aplikasi Anda, DeepSeek API menyediakan akses terprogram.
Untuk memulai, Anda perlu memperoleh kunci API dengan mendaftar di DeepSeek Platform.
API ini kompatibel dengan format OpenAI, sehingga integrasi menjadi mudah jika Anda sudah familier dengan alat OpenAI. Anda dapat menemukan petunjuk lebih lanjut di dokumentasi API DeepSeek.
Per Mei 2025, platform chat dapat digunakan gratis dengan model R1.
API menawarkan dua model—deepseek-chat (DeepSeek-V3) dan deepseek-reasoner (DeepSeek-R1)—dengan struktur harga berikut (per 1M token):
|
MODEL |
PANJANG KONTEKS |
MAKS TOKEN CoT |
MAKS TOKEN OUTPUT |
1M TOKEN HARGA INPUT (CACHE HIT) |
1M TOKEN HARGA INPUT (CACHE MISS) |
1M TOKEN HARGA OUTPUT |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
Sumber: halaman harga DeepSeek
Untuk memastikan Anda memiliki informasi harga terbaru dan memahami cara menghitung biaya penalaran CoT (Chain-of-Thought), kunjungi halaman harga DeepSeek.
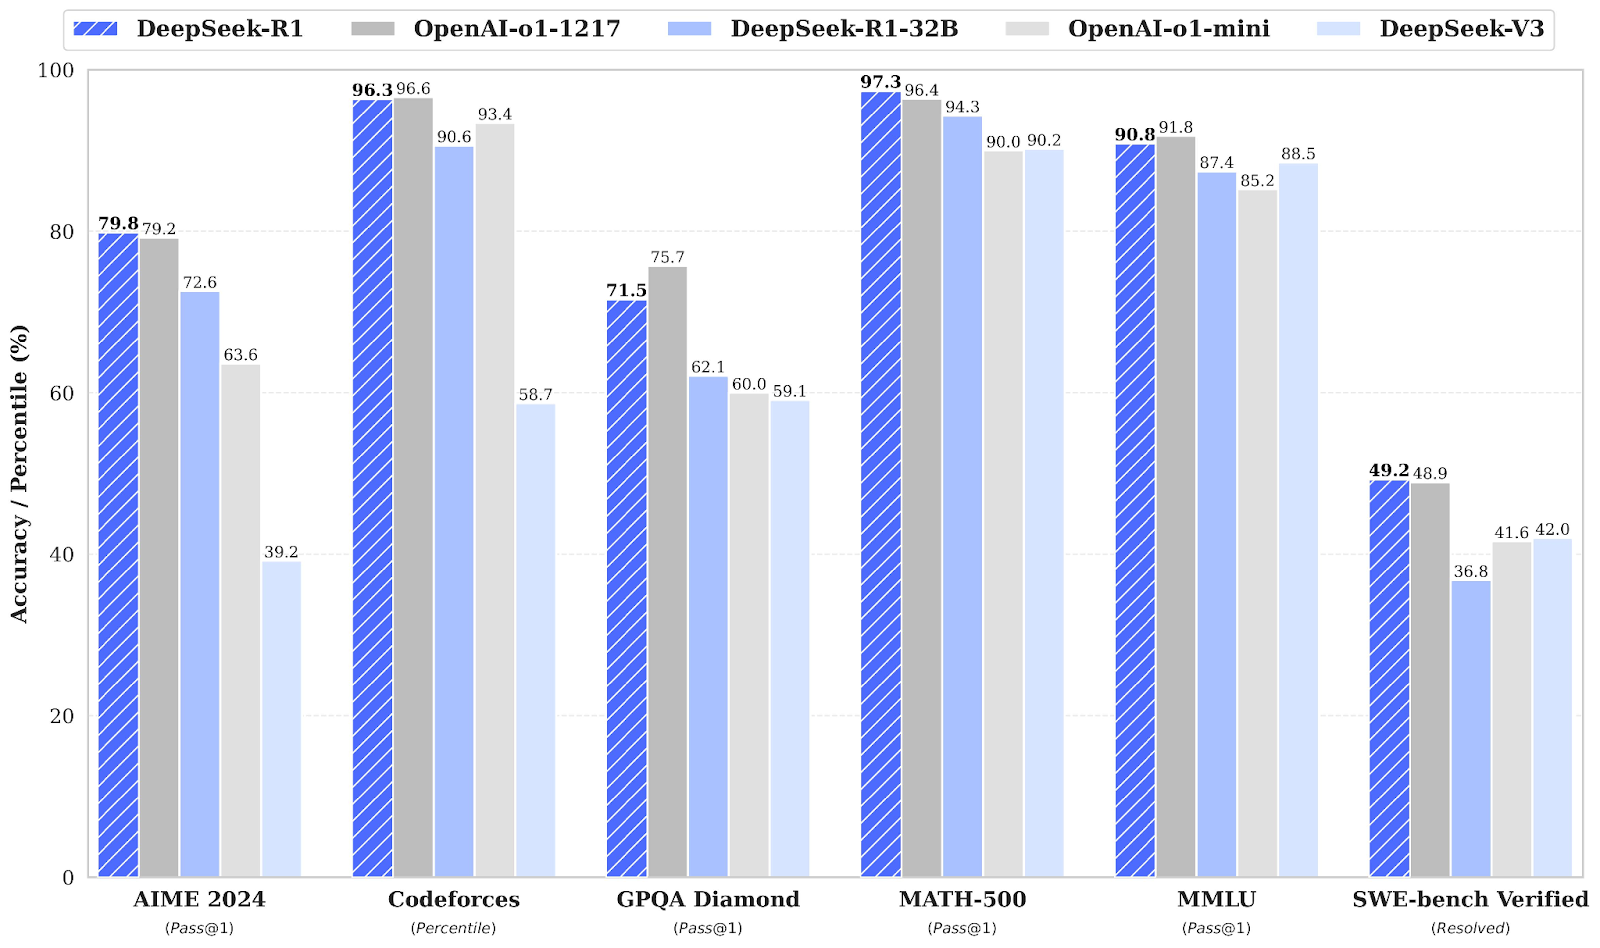
DeepSeek-R1 bersaing langsung dengan OpenAI o1 pada beberapa tolok ukur, sering kali menyamai atau melampaui o1 dari OpenAI.
Sumber: makalah rilis DeepSeek
Dalam tolok ukur matematika, DeepSeek-R1 menunjukkan performa kuat. Pada AIME 2024, yang mengevaluasi penalaran matematis bertahap tingkat lanjut, DeepSeek-R1 meraih 79,8%, sedikit di atas OpenAI o1-1217 dengan 79,2%.
Pada MATH-500, DeepSeek-R1 memimpin dengan 97,3% yang impresif, sedikit melampaui OpenAI o1-1217 pada 96,4%. Tolok ukur ini menguji model pada beragam soal matematika setingkat SMA yang membutuhkan penalaran terperinci.
Tolok ukur Codeforces mengevaluasi kemampuan ngoding dan penalaran algoritmik model, direpresentasikan sebagai peringkat persentil terhadap peserta manusia. OpenAI o1-1217 memimpin dengan 96,6%, sementara DeepSeek-R1 meraih 96,3% yang sangat kompetitif, dengan selisih kecil saja.
Tolok ukur SWE-bench Verified mengevaluasi penalaran dalam tugas rekayasa perangkat lunak. DeepSeek-R1 tampil kuat dengan skor 49,2%, sedikit di atas 48,9% milik OpenAI o1-1217. Hasil ini menempatkan DeepSeek-R1 sebagai penantang kuat dalam tugas penalaran spesialis seperti verifikasi perangkat lunak.
Untuk penalaran faktual, GPQA Diamond mengukur kemampuan menjawab pertanyaan pengetahuan umum. DeepSeek-R1 meraih 71,5%, di bawah OpenAI o1-1217 yang mencapai 75,7%. Hasil ini menyoroti keunggulan tipis OpenAI o1-1217 pada tugas penalaran faktual.
Pada MMLU, tolok ukur lintas disiplin yang mengevaluasi pemahaman bahasa multitugas, OpenAI o1-1217 sedikit unggul atas DeepSeek-R1, dengan 91,8% dibanding 90,8% milik DeepSeek-R1.
Perilisan DeepSeek-R1 berdampak luas, memengaruhi pasar saham, membentuk ulang ekonomi AI, dan memicu kontroversi atas praktik pengembangan model.
Pengenalan model R1 oleh DeepSeek, yang menawarkan kapabilitas AI canggih dengan biaya sebagian kecil dari pesaingnya, menyebabkan penurunan substansial pada harga saham perusahaan teknologi besar di AS.
Nvidia, misalnya, mengalami penurunan hampir 18% pada nilai sahamnya, setara dengan hilangnya sekitar $600 miliar kapitalisasi pasar. Penurunan ini didorong kekhawatiran investor bahwa model AI efisien dari DeepSeek dapat mengurangi permintaan untuk perangkat keras berkinerja tinggi yang secara tradisional disuplai perusahaan seperti Nvidia.
Model berbobot terbuka seperti DeepSeek-R1 menurunkan biaya dan memaksa perusahaan AI menata ulang strategi harga. Ini terlihat dari kontras harga yang mencolok:
Sejumlah pemimpin industri menyinggung paradoks Jevons—gagasan bahwa ketika efisiensi meningkat, konsumsi total justru bisa naik alih-alih turun. CEO Microsoft Satya Nadella menyinggung hal ini, berargumen bahwa saat AI makin murah, permintaan akan meledak.
Namun, saya menyukai pandangan berimbang ini dari The Economist, yang berargumen bahwa efek Jevons penuh sangat jarang dan bergantung pada apakah harga adalah penghalang utama adopsi. Dengan hanya “5% perusahaan Amerika saat ini menggunakan AI dan 7% berencana mengadopsinya”, efek Jevons kemungkinan rendah. Banyak bisnis masih menganggap integrasi AI sulit atau belum perlu.
Di samping dampaknya yang disruptif, DeepSeek juga berada di pusat kontroversi. OpenAI menuduh DeepSeek melakukan distilasi terhadap modelnya—pada dasarnya mengekstrak pengetahuan dari sistem proprietari OpenAI dan mereplikasi performanya dalam model yang lebih ringkas dan efisien.
Sejauh ini, OpenAI belum memberikan bukti langsung atas klaim ini, dan bagi banyak pihak, tuduhan tersebut tampak lebih seperti langkah strategis untuk menenangkan investor di tengah lanskap AI yang berubah.
Pada 28 Mei 2025, DeepSeek merilis versi yang ditingkatkan dari model penalarannya: DeepSeek-R1-0528. Pembaruan ini menghadirkan beberapa peningkatan utama:
Terlepas dari penambahan ini, tidak ada perubahan pada endpoint API—DeepSeek-R1-0528 sepenuhnya kompatibel mundur. Pengembang dapat terus menggunakan antarmuka yang sama, dengan manfaat tambahan dari model baru.
Anda bisa mencobanya di platform DeepSeek Chat atau menjelajahi bobot open-source di Hugging Face.
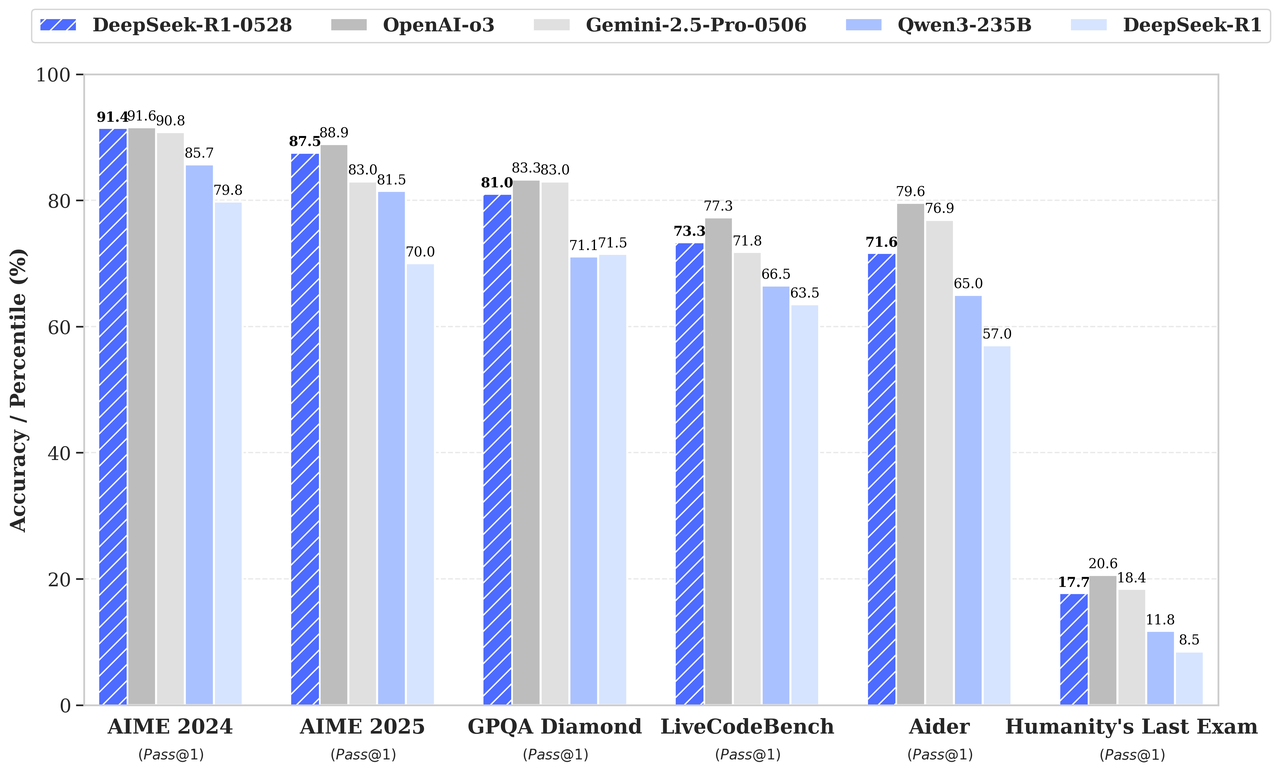
Menurut bagan tolok ukur dalam pengumuman rilis, DeepSeek-R1-0528 melampaui pendahulunya dan bersaing kuat dengan o3 dari OpenAI dan Gemini 2.5 Pro:
Sumber: DeepSeek
DeepSeek-R1 adalah pesaing kuat dalam AI berfokus penalaran, dengan performa setara o1 dari OpenAI. Sementara o1 dari OpenAI mungkin sedikit unggul dalam ngoding dan penalaran faktual, menurut saya sifat open-source dan akses yang hemat biaya membuat DeepSeek-R1 menjadi opsi yang menarik.
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




