
Kursus
Bekerja dengan OpenAI API
3 jam
178.4K
Saat kita, sebagai pengguna, berinteraksi dengan ChatGPT, kita cukup mengetikkan prompt di antarmuka web dan menekan enter. Biasanya, kita mulai menerima respons dalam beberapa detik. Namun, di balik interaksi yang mulus ini terdapat rangkaian langkah yang kompleks dan tertata yang memungkinkan ChatGPT memberikan pengalaman tersebut.
Eksekusi otomatis atas rangkaian langkah ini, yang dikenal sebagai Large Language Model Operations (LLMOps), menjamin bahwa prompt tidak hanya sampai ke model, tetapi juga diproses secara efisien, akurat, dan andal. Ini memastikan penyampaian respons yang tertata dengan baik dalam jangka waktu yang wajar.
Dalam artikel ini, kita akan menyelami paradigma LLMOps dengan menelusuri perjalanan sebuah prompt melalui layanan Large Language Model (LLM), seperti ChatGPT. Kita akan menelaah tahapan krusial, termasuk prapemrosesan prompt, pemilihan model, pembuatan respons, serta aspek yang sering diabaikan namun penting seperti penyeimbangan beban, pemantauan, dan Integrasi Berkelanjutan.
LLMOps memang merupakan evolusi dari Machine Learning Operations (MLOps) yang sudah dikenal, disesuaikan untuk menghadapi tantangan konkret yang dihadirkan oleh LLM. Sementara MLOps berfokus pada pengelolaan siklus hidup model Machine Learning secara umum, LLMOps mencakup aspek-aspek yang secara unik terkait dengan jenis model ini.
Penting untuk dipahami bahwa kapan pun kita berinteraksi dengan model dari OpenAI atau Google, baik melalui antarmuka web atau panggilan API dari kode kita, LLMOps bersifat transparan bagi kita. Dalam skenario ini, kita mengatakan model-model tersebut disediakan sebagai layanan (as-a-service).
Di sisi lain, jika tujuan kita adalah menyediakan model sendiri untuk kasus penggunaan tertentu tanpa bergantung pada penyedia eksternal, seperti asisten untuk karyawan perusahaan, maka tanggung jawab LLMOps ada pada kita.
Terlepas dari kapabilitas model baru kita, keberhasilannya sebagai sebuah layanan sangat bergantung pada keberadaan infrastruktur LLMOps yang kuat dan andal. Jika Anda tertarik mengetahui lebih banyak tentang MLOps, tutorial MLOps Fundamentals cocok untuk Anda!
LLM awal seperti GPT-2 diperkenalkan pada 2018. Namun, popularitasnya meningkat baru-baru ini, terutama karena kemajuan signifikan dalam kapabilitas versi-versi terbaru model tersebut, mulai dari GPT-3 dan seterusnya.
Banyak aplikasi yang memanfaatkan LLM bermunculan karena kemampuan model yang impresif. Contohnya termasuk chatbot layanan pelanggan, layanan terjemahan bahasa, serta asisten menulis dan pengodean, dan lain-lain.
Mengembangkan aplikasi siap produksi yang didukung LLM menghadirkan serangkaian tantangan unik, berbeda dari yang ditemui pada model ML tradisional. Untuk mengatasi tantangan ini, dikembangkan alat dan praktik terbaik baru untuk mengelola siklus hidup aplikasi LLM, yang melahirkan konsep “LLMOps”.
LLMOps penting untuk mengelola model kompleks ini secara efisien ketika diterapkan sebagai layanan (as-a-service) karena beberapa alasan:
1. LLM tidak hanya besar dari segi jumlah data yang ditangani, tetapi juga dari jumlah parameternya. LLMOps memastikan infrastruktur dapat mendukung model ini dari sisi penyimpanan dan bandwidth.
2. Mendapatkan respons yang akurat dalam waktu minimal sangat penting bagi pengguna. LLMOps memastikan respons dikirimkan dalam waktu yang wajar, menjaga kelancaran interaksi yang mirip manusia.
3. Pemantauan berkelanjutan dalam LLMOps tidak hanya tentang melacak aspek operasional atau gangguan pada infrastruktur. Ini juga mencakup pelacakan perilaku model secara cermat untuk memahami proses pengambilan keputusannya dan lebih lanjut meningkatkan model pada iterasi berikutnya.
4. Menjalankan LLM bisa mahal karena sumber daya yang dibutuhkan. LLMOps memperkenalkan strategi hemat biaya untuk memastikan sumber daya digunakan secara optimal tanpa mengorbankan kinerja.
Untuk memahami LLMOps, penting untuk mengenal “di balik layar” LLM ketika ditawarkan sebagai layanan. Itulah jalur yang diikuti sebuah prompt setelah diberikan ke model hingga respons dihasilkan. Skema berikut mewakili alur kerja ini:
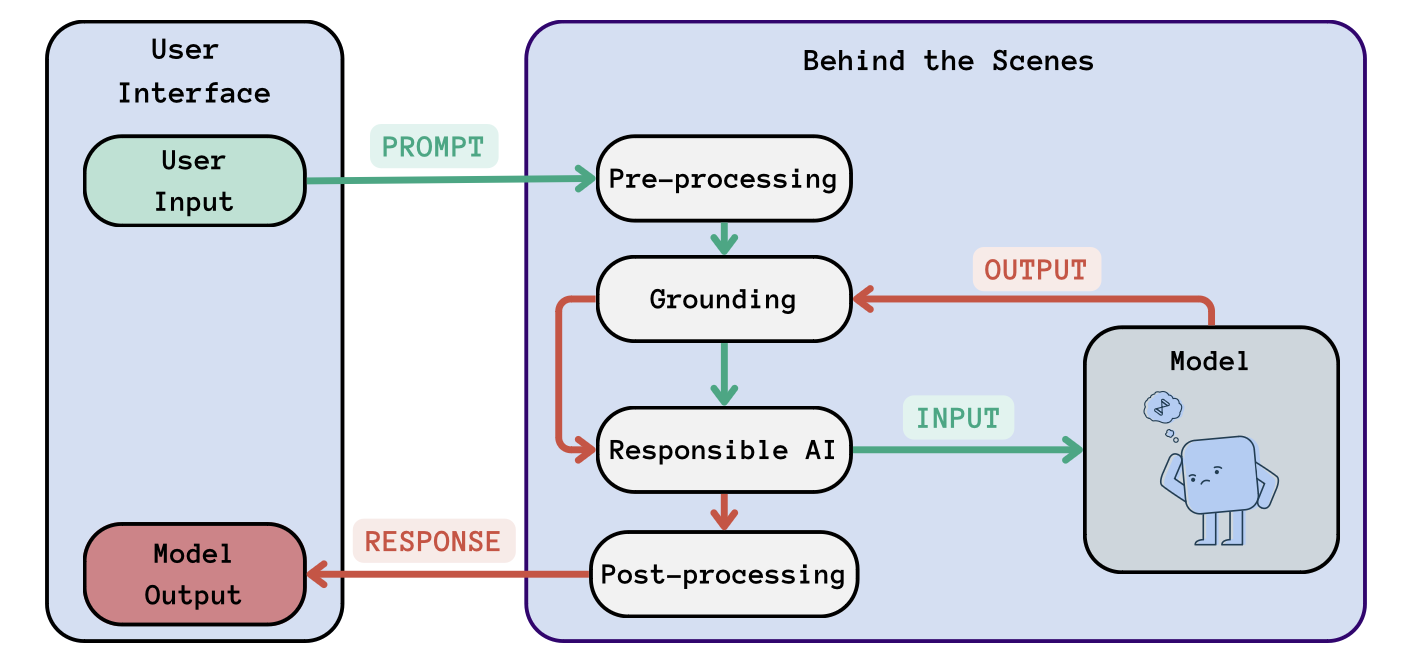
Alur kerja LLMOps: Langkah-langkah di balik layar dari sebuah LLM generik sebagai layanan. Masukan pengguna (hijau) menjalani beberapa langkah sebelum dimasukkan ke model. Demikian pula, keluaran model (merah) mengalami beberapa transformasi sebelum ditampilkan kepada pengguna.
Seperti yang dapat kita amati dari skema di atas, prompt melalui beberapa langkah sebelum mencapai model. Meskipun jumlah langkah dapat bervariasi, ada langkah-langkah dasar untuk memastikan, misalnya, bahwa masukan dipahami dengan jelas dan respons model relevan secara kontekstual. Mari kita uraikan langkah-langkah ini:
Langkah ini menyiapkan prompt pengguna agar model dapat memahami dan memprosesnya. Ini mencakup tokenisasi, di mana prompt dipecah menjadi unit-unit lebih kecil yang disebut token. Langkah ini juga melibatkan normalisasi data, termasuk menghapus atau mentransformasikan data berisik seperti karakter khusus, memperbaiki salah ketik, dan menyeragamkan teks.
Terakhir, selama pengodean, token dikonversi ke bentuk numerik yang dapat dipahami model. Ini dilakukan dengan menggunakan embedding, yang merepresentasikan setiap token sebagai vektor dalam ruang berdimensi tinggi.
Ini melibatkan kontekstualisasi prompt berdasarkan giliran percakapan sebelumnya atau sumber pengetahuan eksternal untuk memastikan respons model koheren dan sesuai konteks. Selain itu, pengenalan entitas dan penautan membantu sistem mengidentifikasi entitas (seperti nama, tempat, dan tanggal) dalam prompt dan menghubungkannya dengan konteks yang relevan.
Untuk memastikan penggunaan LLM bertujuan baik, beberapa layanan menerapkan pemeriksaan kewarasan pada prompt pengguna. Biasanya, prompt dievaluasi terhadap pedoman keamanan dan kepatuhan, khususnya dalam skenario yang melibatkan informasi sensitif, konten yang tidak pantas, bias, atau potensi misinformasi.
Baru setelah langkah-langkah ini, prompt akhirnya diteruskan ke model untuk diproses. Setelah model menghasilkan respons, dan sebelum ditampilkan kepada pengguna, respons tersebut mungkin kembali melalui langkah Grounding dan AI yang Bertanggung Jawab, serta satu langkah pascapemrosesan tambahan:
Respons yang dihasilkan oleh model berbentuk numerik karena embedding vektor yang telah disebutkan. Karena itu, proses dekode penting untuk mengonversi data numerik ini kembali menjadi teks yang dapat dibaca manusia. Setelah dekode, diperlukan langkah perapian untuk memoles respons dari sisi tata bahasa, gaya, atau keterbacaan.
Akhirnya, respons ditampilkan kepada pengguna. Infrastruktur LLMOps bertanggung jawab mengeksekusi langkah-langkah ini secara transparan bagi pengguna.
Sejauh ini, kita telah melihat cukup banyak langkah yang perlu dijalankan infrastruktur LLMOps sejak pengguna mengirim prompt hingga mereka menerima respons. Pada titik ini, pertanyaan yang wajar untuk diajukan adalah: Berapa lama waktu yang dibutuhkan langkah-langkah ini?
Saat menggunakan ChatGPT, waktu respons biasanya hampir seketika. Waktu respons ini dikenal sebagai latensi. Latensi adalah metrik kinerja yang kritis, terutama pada aplikasi yang berhadapan langsung dengan pengguna di mana waktu respons sangat memengaruhi pengalaman pengguna. Memilih latensi yang tepat sangat penting, tergantung pada kasus penggunaan kita.
Ketika berkaitan dengan pengurangan latensi respons, LLMOps menerapkan berbagai strategi dan praktik terbaik untuk memperlancar seluruh proses dari penerimaan masukan hingga penyampaian respons. LLMOps berkontribusi mengurangi latensi model dengan mengeksekusi semua langkah yang diperlukan secara otomatis dan mengelola sumber daya yang dibutuhkan secara efisien sehingga tidak ada komputasi yang menunggu sumber daya tersedia untuk dijalankan. Praktik terbaik lainnya juga dapat mengurangi latensi:
Mengurangi latensi tidak hanya meningkatkan pengalaman pengguna tetapi juga berkontribusi pada efisiensi biaya dengan mengoptimalkan penggunaan sumber daya.
Sampai titik ini, kita belum membahas model mana yang seharusnya ada dalam setup LLMOps kita. Ada berbagai jenis model yang tersedia, masing-masing dioptimalkan untuk kasus penggunaan tertentu, opsi ukuran yang berbeda, dan sebagainya. Memilih model yang tepat sangat krusial dan akan sangat bergantung pada aplikasi kita dan sumber daya yang tersedia.
Selain itu, tampaknya jumlah LLM dan penyedianya meningkat setiap hari. Itulah mengapa memiliki pemahaman luas tentang berbagai jenis LLM dan penyedianya bermanfaat, terutama saat mencoba mengidentifikasi yang paling sesuai dengan kasus penggunaan kita.
Model dan penyedia LLM dapat dikategorikan sebagai berikut:
Manfaat utama model open source terletak pada transparansi dan kemungkinan untuk menyesuaikannya. Model open source biasanya menawarkan kendali penuh atas semua komponen, memungkinkan debug yang mudah dan kustomisasi luas melalui pelatihan atau fine-tuning. Tingkat fleksibilitas ini memungkinkan penyelarasan LLM yang lebih baik dengan kebutuhan spesifik Anda, alih-alih menyesuaikan diri dengan opsi pra-ditetapkan oleh penyedia LLM.
Namun, mengelola LLM open source sendiri dapat menimbulkan tantangan rekayasa yang signifikan dan biaya terkait komputasi serta penyimpanan. Bahkan jika ada infrastruktur minimum yang disediakan oleh model open source, sering kali sulit untuk bersaing dengan model proprietari dalam hal latensi, throughput, dan biaya inferensi.
Ada banyak model di luar sana untuk dipilih. Tapi bagaimana kita memastikan kita memilih LLM yang tepat?
Memang, ada beberapa kriteria yang perlu dipertimbangkan tergantung pada kasus penggunaan dan kemungkinan kita:
Baik proprietari maupun open source, LLM sering memerlukan fine-tuning agar benar-benar sesuai untuk aplikasi tertentu.
LLM yang telah di-fine-tune sebelumnya tersedia untuk tugas pengguna tertentu, umumnya termasuk model percakapan dan model yang mengkhususkan diri pada peringkasan atau analisis sentimen. Varian lain yang perlu dipertimbangkan adalah model dengan konteks panjang. LLM modern biasanya menangani panjang konteks antara 2.000 hingga 8.000 token, artinya masukan dan keluaran di luar rentang ini tidak dapat diproses secara langsung. Namun, beberapa model menawarkan varian konteks panjang. Misalnya, GPT-3.5 memiliki varian ukuran konteks 16k yang lebih besar.
Namun demikian, jika opsi yang ada tidak memenuhi persyaratan spesifik, selalu ada kemungkinan untuk melakukan fine-tuning atau bahkan melatih model sendiri. Dalam hal ini, memilih dataset yang sesuai sangat krusial, karena memungkinkan model memahami sifat tugas yang ditargetkan.
Jika Anda tertarik melatih model LLM dari nol, saya sangat merekomendasikan membaca tutorial DataCamp, How to train an LLM with PyTorch.
Jika aplikasi kita memerlukan fine-tuning model yang sudah ada, langkah-langkah terkait juga harus menjadi bagian dari setup LLMOps kita. Mari tambahkan langkah kustomisasi ini ke diagram awal kita:
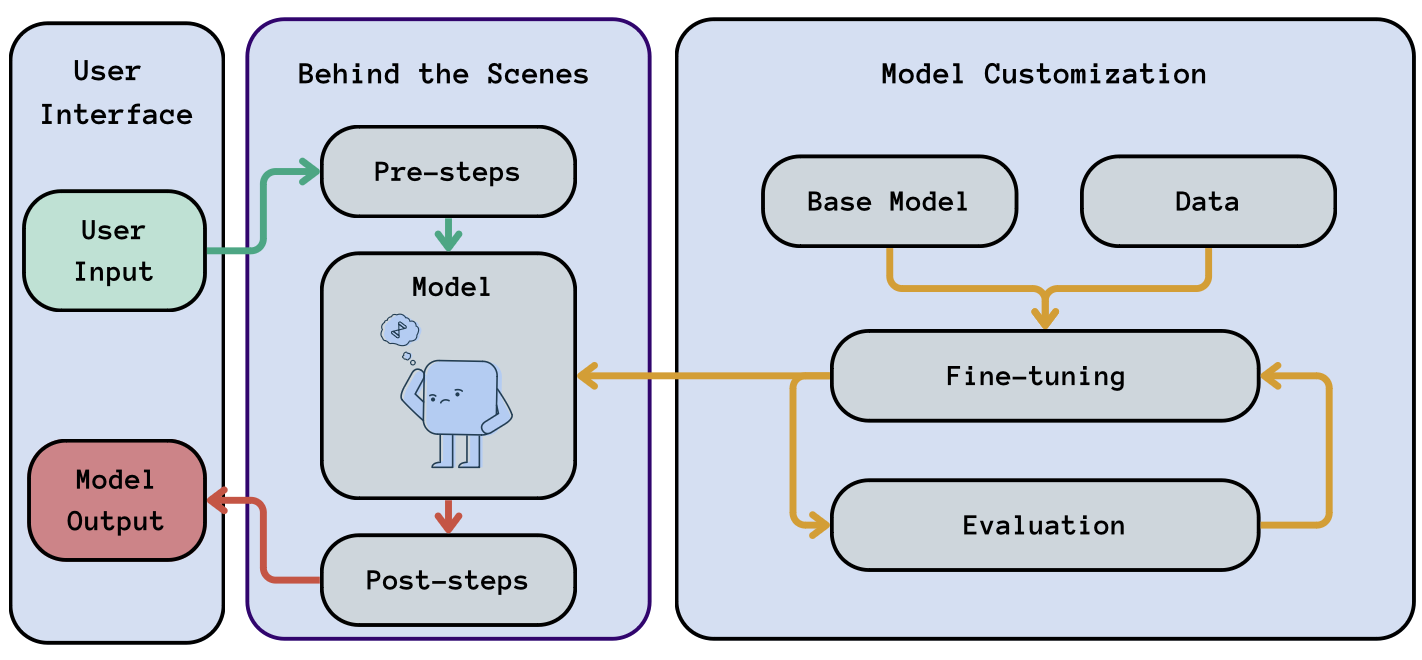
Alur kerja LLMOps: Menambahkan langkah Kustomisasi Model (oranye) ke alur kerja generik kita.
Memiliki pipeline fine-tuning yang konsisten dapat membantu Anda memperluas pengetahuan model dari waktu ke waktu seiring tersedianya lebih banyak data, memungkinkan Anda meningkatkan versi LLM atau melakukan modifikasi lain dengan mudah.
Saat bergantung pada model pihak ketiga, penting untuk dicatat bahwa model ini dapat berubah dari sisi ketersediaan hingga biaya. Ini berpotensi memaksa kita beralih ke model dasar yang berbeda. Setup LLMOps yang tangguh akan memungkinkan kita menangani situasi kritis ini dengan mulus hanya dengan mengganti kotak “Model” dengan LLM yang berbeda.
Orang bisa saja berpikir bahwa melakukan fine-tuning LLM atau melatihnya dari nol adalah langkah pertama di luar infrastruktur LLMOps karena LLM akan beroperasi setelah diterapkan ke produksi. Namun, itu tidak benar, terutama karena alasan yang disebutkan sebelumnya: layanan yang sukses akan membutuhkan peningkatan pada model dan tangguh terhadap perubahan penyedia, jika diperlukan.
Untuk pelatihan, fine-tuning, atau perapian model yang efektif dalam infrastruktur LLMOps generik, penting menjaga pemformatan data konsisten antara data pelatihan dan data inferensi berikutnya. Untuk melakukannya, kita biasanya memformat data pelatihan dalam format JSON Lines (.jsonl). Format ini sangat cocok untuk fine-tuning LLM karena strukturnya, yang memungkinkan pemrosesan dataset besar secara efisien. Berkas .jsonl khas untuk fine-tuning mungkin terlihat seperti ini:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Setiap baris dalam berkas .jsonl adalah objek JSON yang berdiri sendiri, mewakili satu contoh pelatihan, dengan kunci prompt dan completion yang menunjukkan teks masukan dan respons model yang diharapkan, sebagaimana yang kita harapkan saat inferensi. Selain itu, format ini memudahkan penambahan data baru secara bertahap ke basis pengetahuan model.
Parameter model juga penting saat menyiapkan infrastruktur LLMOps karena berdampak pada karakteristik seperti ukuran model dan konsumsi sumber daya.
Terkait parameter pelatihan, penting untuk mengoptimalkan parameter pelatihan guna menyeimbangkan kompleksitas model dengan keterbatasan deployment seperti penggunaan memori. Optimasi ini krusial untuk menerapkan model di berbagai lingkungan dengan kapasitas sumber daya yang bervariasi, memastikan model tidak hanya canggih tetapi juga praktis untuk aplikasi dunia nyata.
Terkait parameter inferensi, penyesuaian parameter seperti temperature dan max tokens memungkinkan pengendalian panjang dan tingkat keacakan respons. Pengaturan ini dikelola sebagai bagian dari proses LLMOps untuk menyelaraskan keluaran model dengan kebutuhan aplikasi spesifik dan maksud pengguna.
Teknik rekayasa prompt telah terbukti meningkatkan kapabilitas default LLM. Salah satu alasannya adalah karena teknik ini membantu mengontekstualisasikan model. Misalnya, menginstruksikan model untuk bertindak sebagai pakar dalam domain tertentu atau mengarahkan model menuju keluaran yang diinginkan. Rekayasa dan Manajemen Prompt adalah komponen krusial yang harus dimasukkan dalam setup LLMOps kita.
Di antara praktik rekayasa prompt yang paling efektif adalah few-shot prompting dan penalaran chain-of-thought. Mari kita tinjau singkat teknik-teknik ini dan bahas bagaimana mengintegrasikannya ke dalam setup LLMOps kita:
Menerapkan teknik seperti few-shot prompting dan penalaran chain-of-thought dalam setup LLMOps kita dapat dicapai secara efektif melalui penggunaan templat prompt.
Templat prompt adalah struktur yang telah ditentukan untuk memandu penalaran LLM. Templat ini memberikan struktur yang konsisten, memastikan jenis permintaan serupa dibuat secara seragam atau membantu memasukkan teknik rekayasa prompt secara transparan bagi pengguna.
Mengembangkan dan mengelola repositori templat prompt yang tersusun baik untuk berbagai kasus penggunaan adalah hal krusial dalam setup LLMOps. Pemilihan templat prompt yang sesuai untuk kasus penggunaan tertentu biasanya merupakan langkah awal yang dilakukan selama fase prapemrosesan sebelum kueri dikirim ke model.
Untuk few-shot prompting, templat harus dirancang untuk menyertakan beberapa contoh yang menunjukkan tugas atau gaya respons yang diharapkan dari model. Demikian pula, untuk memasukkan penalaran chain-of-thought, templat prompt harus dirancang dengan cermat untuk menyertakan proses berpikir langkah demi langkah. Intinya, templat tersebut harus membimbing model tentang cara mendekati dan menguraikan setiap masalah secara metodis menjadi langkah-langkah yang lebih sederhana dan mudah dikelola.
Mengintegrasikan pengetahuan dari sumber eksternal bisa menjadi langkah dalam penalaran chain-of-thought, yang sangat berguna dalam kerangka kerja seperti LangChain, di mana model diinstruksikan untuk mengambil informasi dari internet jika basis pengetahuan yang ada tidak mencukupi.
Baik dalam few-shot prompting maupun penalaran chain-of-thought, menerapkan pengujian A/B pada prompt sangat bermanfaat. Ini melibatkan pelaksanaan eksperimen terkontrol dengan memberikan versi prompt yang berbeda kepada subset pengguna yang berbeda, mengukur kinerjanya secara objektif, dan memilih yang paling efektif berdasarkan hasilnya. Selain itu, dalam kedua kasus, penting untuk mengandalkan data kinerja untuk meningkatkan templat prompt kita secara iteratif.
Setelah model dasar dilatih atau di-fine-tune dan kita puas dengan hasilnya, saatnya menerapkan (deploy) model tersebut. Deployment model dalam konteks LLMOps mengacu pada proses membuat model bahasa tersedia untuk digunakan dalam lingkungan produksi. Ini melibatkan memindahkan model dari lingkungan pelatihan dan mengintegrasikannya ke dalam infrastruktur produksi. Langkah ini ditandai dalam warna oranye pada diagram biasa kita:
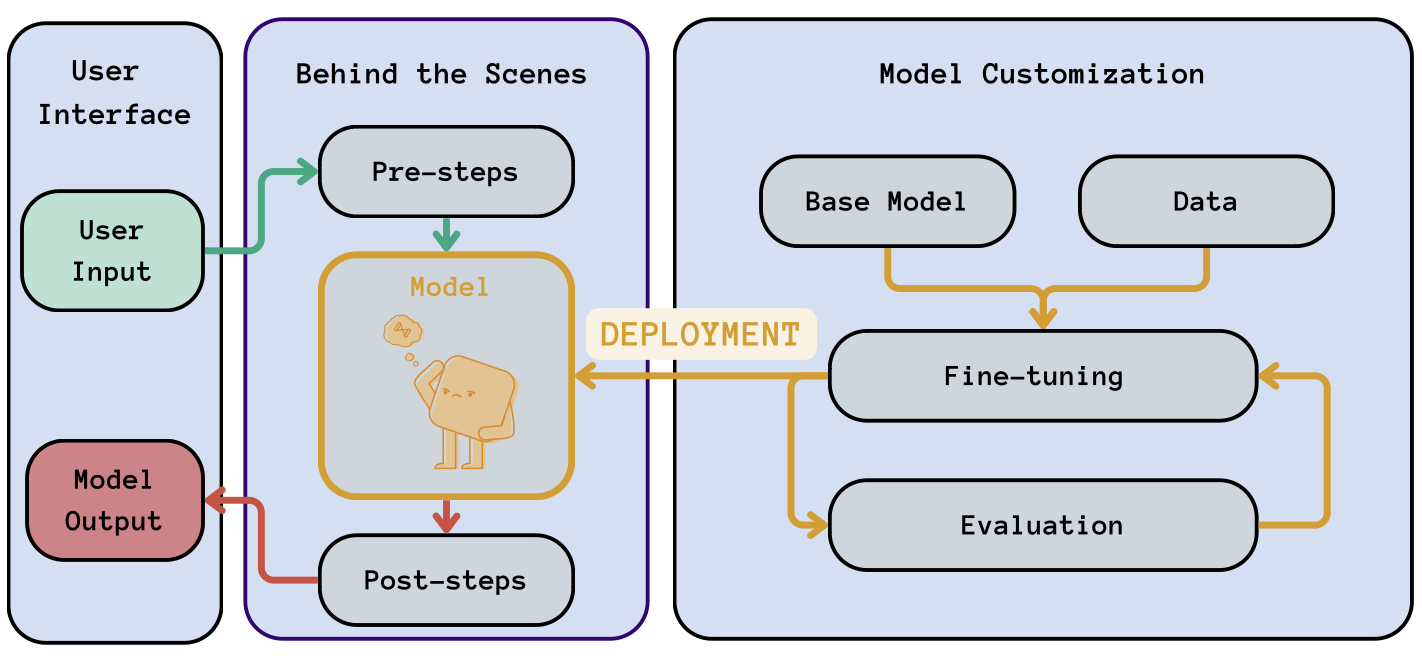
Alur kerja LLMOps: Menyoroti langkah deployment (oranye) dalam alur kerja generik kita. Langkah ini melibatkan “memindahkan” model dari lingkungan pengembangan ke produksi.
Deployment juga mencakup penetapan antarmuka yang akan kita gunakan untuk berkomunikasi dengan model saat berada di produksi. Secara umum, antarmuka bergantung pada mode pemrosesan kita:
API dapat diterapkan di server web atau platform cloud, memastikan API dapat diakses oleh pengguna atau sistem yang perlu berinteraksi dengan model. Setup LLMOps kita harus memastikan API dapat menangani beban yang diharapkan, dengan mempertimbangkan skala, penyeimbangan beban, dan mekanisme failover.
Untuk kasus batch, Anda dapat menjadwalkan pekerjaan batch menggunakan alat seperti cron (di sistem mirip Unix) atau layanan penjadwalan pekerjaan berbasis cloud. Pekerjaan ini akan menjalankan model pada data baru pada interval yang ditentukan, memproses data, dan menyimpan hasilnya.
Terakhir, menerapkan model ke setup produksi biasanya melibatkan pengemasan model dan pelacakan versi:
Pipeline Continuous Integration (CI) dan Continuous Delivery (CD) mengotomatisasi langkah-langkah yang terlibat dalam membawa model dari lingkungan pengembangan ke produksi, memastikan model andal, mutakhir, dan diterapkan secara efisien.
Dalam LLMOps, saat kode baru atau perubahan diperkenalkan ke model (seperti penyesuaian hyperparameter, perubahan arsitektur model, atau data pelatihan baru), CI memastikan perubahan ini diuji secara otomatis. Ini mencakup menjalankan unit test, integration test, dan pemeriksaan lainnya untuk memvalidasi bahwa perubahan tidak merusak model atau menurunkan performanya. Dalam pengertian ini, CI adalah cara memantau model kita secara berkelanjutan.
Setelah perubahan lulus semua pengujian pada fase CI, CD mengotomatiskan deployment model ke lingkungan produksi. Ini memastikan versi model yang paling stabil dan telah diuji selalu berjalan dalam setup produksi LLMOps. CD juga memfasilitasi rollback cepat ke versi sebelumnya jika masalah terdeteksi di lingkungan produksi, meminimalkan downtime dan memastikan keandalan layanan.
Terakhir, ada satu aspek yang belum kita komentari: bagaimana kita menata komponen LLMOps agar membentuk rantai langkah yang masuk akal?
Orkestrasi melibatkan pendefinisian dan pengelolaan urutan operasi dalam setup LLMOps, membentuk apa yang disebut alur kerja. Misalnya, mendefinisikan urutan langkah pra dan pascapemrosesan atau berbagai pengujian yang harus dijalani model baru hingga siap diterapkan.
Dalam konteks LLM, orkestrasi biasanya melibatkan pengoperan data antar berbagai komponen alur kerja. Ini sering dikelola dengan menentukan jalur data atau workspace tempat keluaran dari satu langkah disimpan dan kemudian diambil oleh langkah berikutnya.
Orkestrasi sering dikelola melalui berkas konfigurasi, biasanya ditulis dalam YAML (Yet Another Markup Language). Berkas-berkas ini mendefinisikan komponen, urutannya, dan parameter untuk setiap langkah dalam alur kerja. Domain Specific Language (DSL) sering digunakan dalam berkas konfigurasi ini untuk menyediakan sintaks yang lebih intuitif dan terspesialisasi dalam mendefinisikan alur kerja.
Terakhir, alur kerja biasanya diotomatisasi. Itu memastikan bahwa setelah alur kerja dimulai, semua langkah terkait berjalan mulus tanpa intervensi manual, dari satu langkah ke langkah berikutnya, sehingga mengurangi kebutuhan eksekusi tugas manual untuk menghindari masalah.
Dalam artikel ini, kita telah membahas komponen kunci infrastruktur LLMOps dan alasan keberadaannya. Namun demikian, teknik lanjutan lainnya dapat meningkatkan kinerja infrastruktur LLMOps Anda:
Memastikan privasi data dan perlindungan pengguna dalam infrastruktur LLMOps kita adalah inti untuk membangun layanan yang andal.
Misalnya, menerapkan teknik anonimisasi data yang kuat sangatlah krusial. Teknik seperti differential privacy, k-anonymity, atau data masking dapat digunakan untuk memastikan bahwa data pelatihan tidak mengungkapkan informasi pribadi sensitif yang dikumpulkan saat membentuk dataset pelatihan. Selain itu, jika kita berencana menggunakan data dunia nyata untuk meningkatkan model kita secara iteratif, pengguna harus menyadarinya, dan data mereka harus dianonimkan sebelum dimasukkan ke dalam loop fine-tuning.
Aspek lain terkait keamanan adalah jika kita berencana menyimpan informasi pengguna pribadi apa pun dalam sistem kita, seperti riwayat percakapan di ChatGPT. Dalam kasus ini, kita harus memastikan semua data ditangani dengan aman, dan mematuhi peraturan perlindungan data seperti GDPR. Ini mencakup memastikan penyimpanan data yang aman dan transmisi data terenkripsi dalam infrastruktur kita.
Terakhir, kita harus memastikan kontrol akses yang kuat dalam infrastruktur LLMOps, memastikan hanya orang yang berwenang yang memiliki akses ke model, data, dan lingkungan pelatihan serta tidak akan ada kebocoran yang mengekspos informasi pribadi pengguna.
Aplikasi yang didukung LLM meningkat sejak tahun lalu, didorong oleh kapabilitas yang ditingkatkan dari iterasi LLM terbaru. Aplikasi-aplikasi ini menghadirkan LLM sebagai layanan, sehingga memerlukan kerangka kerja yang kuat untuk pengelolaan dan pengoptimalannya, yang dikenal sebagai infrastruktur LLMOps.
Dalam artikel ini, kita telah menelaah peran krusial LLMOps sebagai tulang punggung layanan LLM yang sukses, efisien, dan berfokus pada pelanggan. Pertama, kita telah meninjau perjalanan sebuah prompt sejak pengguna mengirimkannya ke model hingga respons diterima. LLMOps memastikan semua langkah “di balik layar” ini berjalan lancar dan efisien.
Kedua, kita telah meninjau bagaimana LLMOps mencakup pelatihan model, deployment, pemantauan, dan pemeliharaan. LLMOps juga mencakup penskalaan sumber daya untuk menangani beban yang bervariasi secara efisien, sehingga menjamin skalabilitas dan keandalan aplikasi berbasis LLM kita. Selain itu, kita telah menyinggung praktik terbaik lanjutan untuk menyempurnakan infrastruktur LLMOps kita.
Terakhir, kita telah mengakui bagaimana LLMOps juga terlibat dalam menjaga integritas dan keamanan LLM sebagai layanan. Karena model-model ini sering memproses data sensitif, praktik LLMOps yang tangguh sangat penting untuk menegakkan langkah-langkah keamanan yang ketat, memastikan privasi data dan kepatuhan terhadap standar regulasi.
Sebagai penutup, setelah membaca artikel ini, saya harap saya telah meyakinkan Anda tentang satu aspek penting: LLMOps bukan sekadar kebutuhan operasional, melainkan aset strategis yang meningkatkan nilai, keandalan, dan keberlanjutan LLM sebagai layanan.
Siap mempraktikkan teori? Selami lebih dalam dunia Large Language Models dengan tutorial praktis kami: "How to Build LLM Applications with LangChain". Mulailah mengubah pengetahuan Anda menjadi keterampilan yang dapat diterapkan hari ini!
Mulai Perjalanan LLM Anda Hari Ini!
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




