Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Wenn wir als Nutzer mit ChatGPT interagieren, tippen wir einfach eine Eingabe in die Weboberfläche und drücken Enter. Meist erscheint die Antwort schon nach wenigen Sekunden. Hinter dieser reibungslosen Interaktion steckt jedoch eine komplexe, klar strukturierte Abfolge von Schritten, die ein Erlebnis wie dieses überhaupt erst ermöglichen.
Die automatische Ausführung dieser Abfolge, bekannt als Large Language Model Operations (LLMOps), stellt sicher, dass eine Eingabe nicht nur das Modell erreicht, sondern auch effizient, präzise und zuverlässig verarbeitet wird. So entsteht in angemessener Zeit eine durchdachte Antwort.
In diesem Artikel tauchen wir in das LLMOps‑Paradigma ein, indem wir die Reise einer Eingabe durch einen LLM‑Dienst wie ChatGPT nachzeichnen. Wir betrachten zentrale Phasen wie Prompt‑Vorverarbeitung, Modellauswahl und Antwortgenerierung sowie oft übersehene, aber wesentliche Aspekte wie Lastverteilung, Monitoring und Continuous Integration.
LLMOps sind eine Weiterentwicklung der etablierten Machine Learning Operations (MLOps), zugeschnitten auf die konkreten Herausforderungen von LLMs. Während sich MLOps auf das Lifecycle‑Management allgemeiner ML‑Modelle konzentriert, integriert LLMOps Aspekte, die speziell für diese Modellklasse relevant sind.
Wichtig ist: Immer wenn wir über eine Weboberfläche oder per API aus unserem Code mit einem Modell von OpenAI oder Google interagieren, bleibt LLMOps für uns unsichtbar. In diesem Fall sprechen wir davon, dass diese Modelle as‑a‑service bereitgestellt werden.
Wenn wir hingegen ein eigenes Modell für einen konkreten Anwendungsfall ohne Abhängigkeit von externen Anbietern bereitstellen wollen – etwa als Assistent für die Mitarbeitenden eines Unternehmens –, liegt die Verantwortung für LLMOps bei uns.
Unabhängig von den Fähigkeiten unseres neuen Modells hängt sein Erfolg als Service maßgeblich von einer robusten und verlässlichen LLMOps‑Infrastruktur ab. Wenn du mehr über MLOps erfahren möchtest, ist das Tutorial MLOps Fundamentals genau das Richtige!
Frühe LLMs wie GPT‑2 wurden 2018 vorgestellt. Ihre Popularität ist jedoch erst mit den deutlich verbesserten Nachfolgern wie GPT‑3 und darüber hinaus stark gestiegen.
Dank dieser beeindruckenden Fähigkeiten sind zahlreiche Anwendungen auf Basis von LLMs entstanden – von Chatbots im Kundenservice über Übersetzungsdienste bis hin zu Schreib‑ und Code‑Assistenten.
Produktionsreife Anwendungen mit LLMs zu entwickeln, bringt besondere Herausforderungen mit sich, die sich von denen klassischer ML‑Modelle unterscheiden. Um diese zu adressieren, entstanden neue Tools und Best Practices für das Management des LLM‑Anwendungslebenszyklus – und damit das Konzept „LLMOps“.
LLMOps sind unverzichtbar, um diese komplexen Modelle als Service effizient zu betreiben – aus mehreren Gründen:
1. LLMs sind nicht nur hinsichtlich der verarbeiteten Datenmenge groß, sondern auch in der Zahl ihrer Parameter. LLMOps stellen sicher, dass Speicher und Bandbreite der Infrastruktur diese Modelle tragen können.
2. Für Nutzer ist eine möglichst schnelle, präzise Antwort entscheidend. LLMOps sorgen dafür, dass Antworten in angemessener Zeit geliefert werden und Interaktionen flüssig wirken.
3. Kontinuierliches Monitoring bedeutet in LLMOps nicht nur, operative Aspekte oder Störungen der Infrastruktur zu beobachten. Es umfasst auch das genaue Nachverfolgen des Modellverhaltens, um Entscheidungen zu verstehen und das Modell in künftigen Iterationen zu verbessern.
4. Der Betrieb von LLMs kann aufgrund der benötigten Ressourcen teuer sein. LLMOps führen kosteneffiziente Strategien ein, die Ressourcen optimal nutzen, ohne die Performance zu gefährden.
Um LLMOps zu verstehen, hilft ein Blick hinter die Kulissen eines as‑a‑service angebotenen LLMs: der Weg, den ein Prompt nimmt, von der Eingabe bis zur Antwort. Das folgende Schema zeigt diesen Workflow:
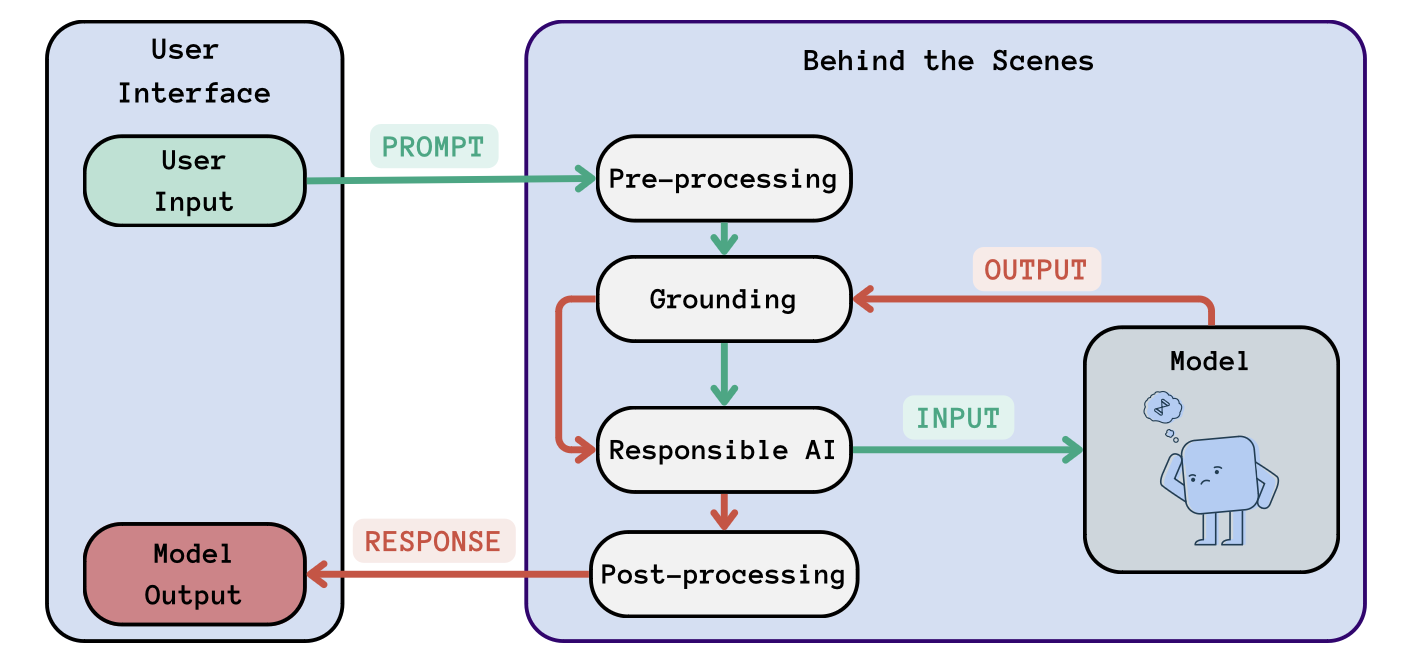
LLMOps‑Workflow: Die Schritte hinter den Kulissen eines generischen LLM as‑a‑service. Die Nutzereingabe (grün) durchläuft mehrere Schritte, bevor sie ins Modell gelangt. Ebenso wird die Modellausgabe (rot) mehrstufig transformiert, bevor sie dem Nutzer angezeigt wird.
Wie im Schema zu sehen, durchläuft der Prompt mehrere Schritte, bevor er das Modell erreicht. Die Anzahl kann variieren, aber es gibt grundlegende Schritte, um etwa die Verständlichkeit der Eingabe und die Kontextrelevanz der Antwort sicherzustellen. Schauen wir sie uns an:
Diese Phase bereitet den Prompt so auf, dass das Modell ihn verstehen und verarbeiten kann. Dazu gehört die Tokenisierung, bei der der Prompt in kleinere Einheiten, sogenannte Tokens, zerlegt wird. Ebenfalls wichtig ist die Normalisierung, also das Entfernen oder Umformen von Störsignalen wie Sonderzeichen, das Korrigieren von Tippfehlern und das Vereinheitlichen des Textes.
Bei der Kodierung werden die Tokens schließlich in eine numerische Form überführt, die das Modell verarbeiten kann. Dafür dienen Embeddings, die jedes Token als Vektor in einem hochdimensionalen Raum repräsentieren.
Hier wird der Prompt kontextualisiert – anhand vorheriger Gesprächsrunden oder externer Wissensquellen –, damit die Antwort stimmig und kontextgerecht ist. Zudem unterstützen Entity Recognition und Linking dabei, Entitäten (z. B. Namen, Orte, Daten) zu identifizieren und korrekt einzuordnen.
Damit LLMs verantwortungsvoll genutzt werden, implementieren manche Dienste Plausibilitäts‑ und Sicherheitsprüfungen der Nutzereingaben. Üblicherweise wird der Prompt gegen Safety‑ und Compliance‑Richtlinien geprüft – insbesondere bei sensiblen Informationen, unangebrachten Inhalten, Verzerrungen oder potenziellen Falschinformationen.
Erst danach wird der Prompt an das Modell weitergeleitet. Nachdem das Modell eine Antwort erzeugt hat und bevor sie angezeigt wird, können die Schritte Grounding und Responsible AI erneut angewandt werden – ergänzt um einen Post‑Processing‑Schritt:
Die Modellantwort liegt aufgrund der erwähnten Embeddings numerisch vor. Daher ist ein Dekodieren nötig, um sie wieder in lesbaren Text zu verwandeln. Anschließend sorgt ein Feinschliff für korrekte Grammatik, passenden Stil und gute Lesbarkeit.
Erst dann wird die Antwort angezeigt. Die LLMOps‑Infrastruktur führt all diese Schritte für den Nutzer transparent im Hintergrund aus.
Wir haben nun gesehen, wie viele Schritte die LLMOps‑Infrastruktur von der Eingabe bis zur Antwort ausführt. Da stellt sich berechtigterweise die Frage: Wie lange dauern diese Schritte?
Bei ChatGPT ist die Antwortzeit in der Regel fast unmittelbar. Diese Antwortzeit nennt man Latenz. Sie ist ein kritischer Leistungsindikator, gerade bei nutzerorientierten Anwendungen, in denen die Reaktionszeit das Erlebnis stark prägt. Je nach Use Case ist die passende Latenz entscheidend.
Um die Latenz zu senken, setzt LLMOps diverse Strategien und Best Practices ein, um den Weg von der Eingabe bis zur Auslieferung der Antwort zu straffen. LLMOps helfen, Modell‑Latenz zu reduzieren, indem alle erforderlichen Schritte automatisiert und Ressourcen so effizient verwaltet werden, dass keine Rechenaufgabe unnötig auf freie Kapazitäten warten muss. Weitere Praktiken zur Latenzreduktion sind:
Geringere Latenz verbessert nicht nur das Nutzererlebnis, sondern steigert durch optimierten Ressourceneinsatz auch die Kosteneffizienz.
Bislang haben wir noch nicht festgelegt, welches Modell in unserem LLMOps‑Setup laufen soll. Es gibt verschiedene Modelltypen, optimiert für unterschiedliche Use Cases und Größen. Die Wahl ist entscheidend und hängt stark von Anwendung und verfügbaren Ressourcen ab.
Zudem wächst die Zahl der LLMs und Anbieter gefühlt täglich. Ein breiter Überblick über Modelltypen und Provider hilft, das am besten passende Angebot für unseren Use Case zu identifizieren.
LLM‑Modelle und Anbieter lassen sich grob so einteilen:
Die großen Vorteile von Open‑Source‑Modellen sind Transparenz und Anpassbarkeit. In der Regel haben wir vollen Zugriff auf alle Komponenten, können leichter debuggen und per Training oder Fine‑Tuning umfangreich anpassen. Diese Flexibilität ermöglicht eine engere Ausrichtung an deinen Anforderungen, statt dich an Vorgaben eines Anbieters zu binden.
Die eigenständige Betreuung von Open‑Source‑LLMs bringt jedoch erhebliche Engineering‑Aufwände und Kosten für Rechenleistung und Speicher mit sich. Selbst mit minimaler bereitgestellter Infrastruktur ist es oft schwer, bei Latenz, Durchsatz und Inferenzkosten mit proprietären Modellen mitzuhalten.
Es gibt viele Modelle zur Auswahl. Wie stellen wir sicher, dass wir das richtige LLM wählen?
Je nach Use Case und Möglichkeiten sind folgende Kriterien wichtig:
Unabhängig davon, ob proprietär oder Open Source: LLMs benötigen häufig Fine‑Tuning, um für spezifische Anwendungen wirklich zu passen.
Es gibt vorab feinabgestimmte Modelle für bestimmte Aufgaben, etwa Chat‑Modelle oder Modelle für Zusammenfassungen oder Sentiment‑Analyse. Eine weitere Variante sind Long‑Context‑Modelle. Moderne LLMs verarbeiten typischerweise Kontexte von 2.000 bis 8.000 Tokens, darüber hinausgehende Eingaben/Ausgaben sind direkt nicht möglich. Manche Modelle bieten jedoch Varianten mit längerem Kontext, z. B. GPT‑3.5 mit 16k Kontext.
Wenn die verfügbaren Optionen Anforderungen nicht erfüllen, bleibt die Möglichkeit, selbst zu fine‑tunen oder sogar ein Modell neu zu trainieren. Entscheidend ist dann ein passender Datensatz, damit das Modell die Zielaufgabe versteht.
Wenn du ein LLM von Grund auf trainieren möchtest, empfehle ich das DataCamp‑Tutorial How to train an LLM with PyTorch.
Erfordert unsere Anwendung das Fine‑Tuning eines bestehenden Modells, sollten diese Schritte Teil unseres LLMOps‑Setups sein. Ergänzen wir den ursprünglichen Ablauf um die Anpassung:
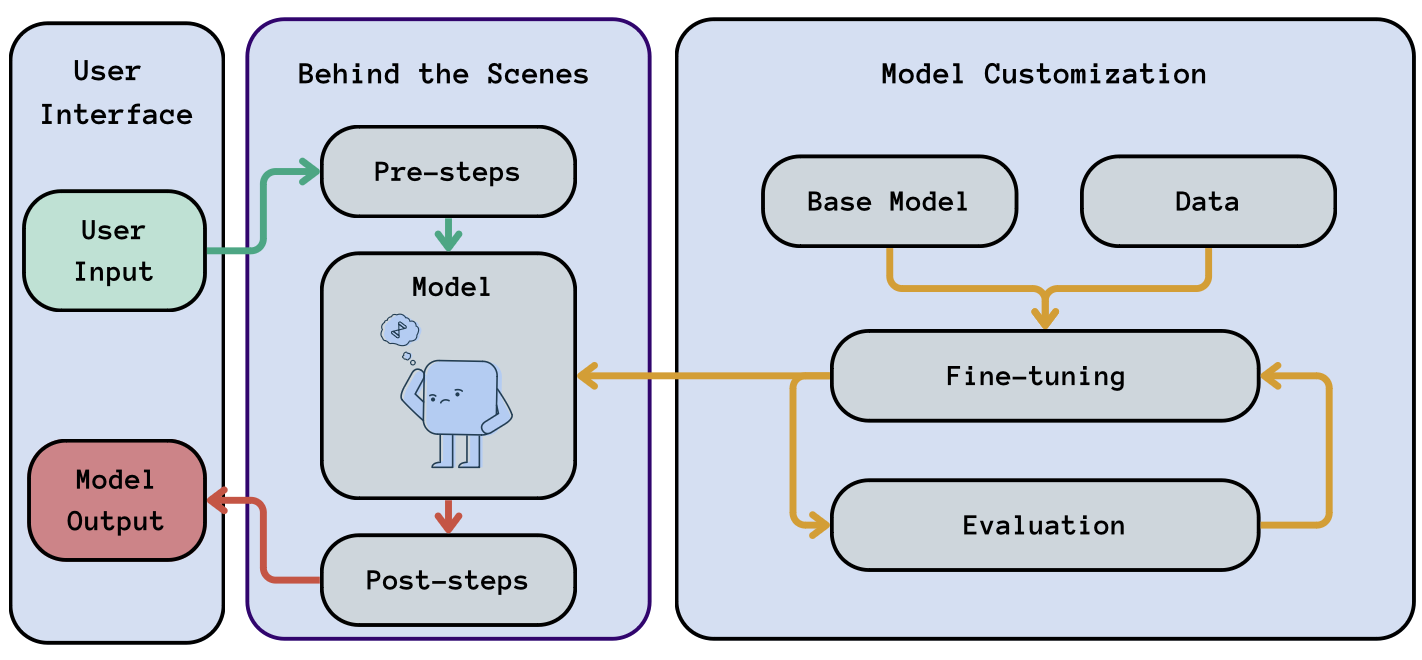
LLMOps‑Workflow: Einbindung der Schritte zur Modellanpassung (orange) in unseren generischen Ablauf.
Eine konsistente Fine‑Tuning‑Pipeline hilft dir, das Wissen deines Modells im Zeitverlauf mit neuen Daten zu erweitern, deine LLM‑Version einfach zu aktualisieren oder andere Änderungen vorzunehmen.
Bei Abhängigkeit von Drittmodellen können sich Verfügbarkeit oder Kosten ändern. Das kann einen Wechsel des Basismodells erzwingen. Ein robustes LLMOps‑Setup ermöglicht, diese kritische Situation reibungslos zu handhaben – indem wir im Diagramm einfach die Box „Model“ durch ein anderes LLM ersetzen.
Man könnte meinen, Fine‑Tuning oder Training eines LLMs sei ein Schritt außerhalb der LLMOps‑Infrastruktur, da das Modell erst nach dem Deployment produktiv läuft. Das stimmt so nicht – vor allem aus dem genannten Grund: Ein erfolgreicher Service braucht Modellverbesserungen und muss, falls nötig, anbieterwechselresistent sein.
Für effektives Training, Fine‑Tuning oder Modellveredelung in einer generischen LLMOps‑Infrastruktur ist es wichtig, dass das Datenformat zwischen Trainings‑ und Inferenzdaten konsistent bleibt. Typischerweise formatieren wir Trainingsdaten im JSON Lines‑Format (.jsonl). Es eignet sich sehr gut zum Fine‑Tuning von LLMs, da es die effiziente Verarbeitung großer Datensätze ermöglicht. Eine typische .jsonl‑Datei für Fine‑Tuning könnte so aussehen:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Jede Zeile in einer .jsonl‑Datei ist ein eigenes JSON‑Objekt, das ein Trainingsexemplar mit den Schlüsseln prompt und completion repräsentiert – so wie wir es später in der Inferenz erwarten. Zudem erleichtert das Format die schrittweise Erweiterung der Wissensbasis.
Modellparameter sind für unser LLMOps‑Setup ebenfalls wichtig, da sie sich auf Modellgröße und Ressourcenverbrauch auswirken.
Bei Trainingsparametern gilt es, die Komplexität des Modells mit Deploymenteinschränkungen wie Speicherbedarf auszubalancieren. Diese Optimierung ist entscheidend, um Modelle in unterschiedlichen Umgebungen mit variierenden Ressourcen praktikabel einzusetzen.
Bei Inferenzparametern erlauben Einstellungen wie Temperatur und maximale Tokenzahl, Länge und Zufälligkeit der Antworten zu steuern. Diese Parameter werden im Rahmen von LLMOps so verwaltet, dass die Modellausgaben zu Anwendung und Nutzerintention passen.
Prompt‑Engineering‑Techniken verbessern nachweislich die Standardfähigkeiten von LLMs. Ein Grund: Sie helfen, das Modell zu kontextualisieren – etwa indem es als Fachexpertin agieren oder auf ein gewünschtes Ausgabeformat hinsteuern soll. Prompt Engineering und dessen Verwaltung sind zentrale Bausteine im LLMOps‑Setup.
Zu den wirksamsten Praktiken zählen Few‑Shot‑Prompting und Chain‑of‑Thought‑Reasoning. Kurz zu beiden und ihrer Integration in LLMOps:
Die Umsetzung solcher Techniken im LLMOps‑Setup gelingt effektiv über Prompt‑Vorlagen.
Prompt‑Vorlagen sind vordefinierte Strukturen, die das Denken von LLMs lenken. Sie sorgen für Konsistenz, damit ähnliche Anfragen einheitlich gestellt werden, und binden Prompt‑Engineering‑Techniken für Nutzer transparent ein.
Eine gut gepflegte Sammlung hochwertiger Prompt‑Vorlagen für verschiedene Use Cases ist im LLMOps‑Setup essenziell. Die Wahl der passenden Vorlage für einen konkreten Fall ist meist ein vorbereitender Schritt in der Vorverarbeitung, bevor die Anfrage ans Modell geht.
Für Few‑Shot‑Prompting sollten Vorlagen mehrere Beispiele enthalten, die Aufgabe oder gewünschten Stil zeigen. Um Chain‑of‑Thought einzubinden, sollten die Vorlagen einen klaren Schritt‑für‑Schritt‑Denkprozess vorgeben – sie leiten das Modell an, Probleme systematisch in handhabbare Teilaufgaben zu zerlegen.
Die Einbindung externer Wissensquellen kann Teil der Chain‑of‑Thought sein, besonders in Frameworks wie LangChain, wo das Modell angewiesen wird, Informationen aus dem Internet zu holen, wenn die interne Wissensbasis nicht ausreicht.
Sowohl bei Few‑Shot‑Prompting als auch bei Chain‑of‑Thought ist A/B‑Testing von Prompts sehr sinnvoll. Dabei setzt man kontrollierte Experimente auf, zeigt unterschiedlichen Nutzergruppen verschiedene Prompt‑Varianten, misst deren Performance objektiv und wählt die besten aus. In beiden Fällen ist es wichtig, die Vorlagen iterativ datenbasiert zu verbessern.
Sobald das Basismodell trainiert oder feinabgestimmt ist und die Ergebnisse überzeugen, geht es ans Deployment. In LLMOps bedeutet das, ein Sprachmodell in einer Produktionsumgebung nutzbar zu machen – also aus der Trainingsumgebung in die Produktionsinfrastruktur zu überführen. Dieser Schritt ist in unserem Diagramm orange markiert:
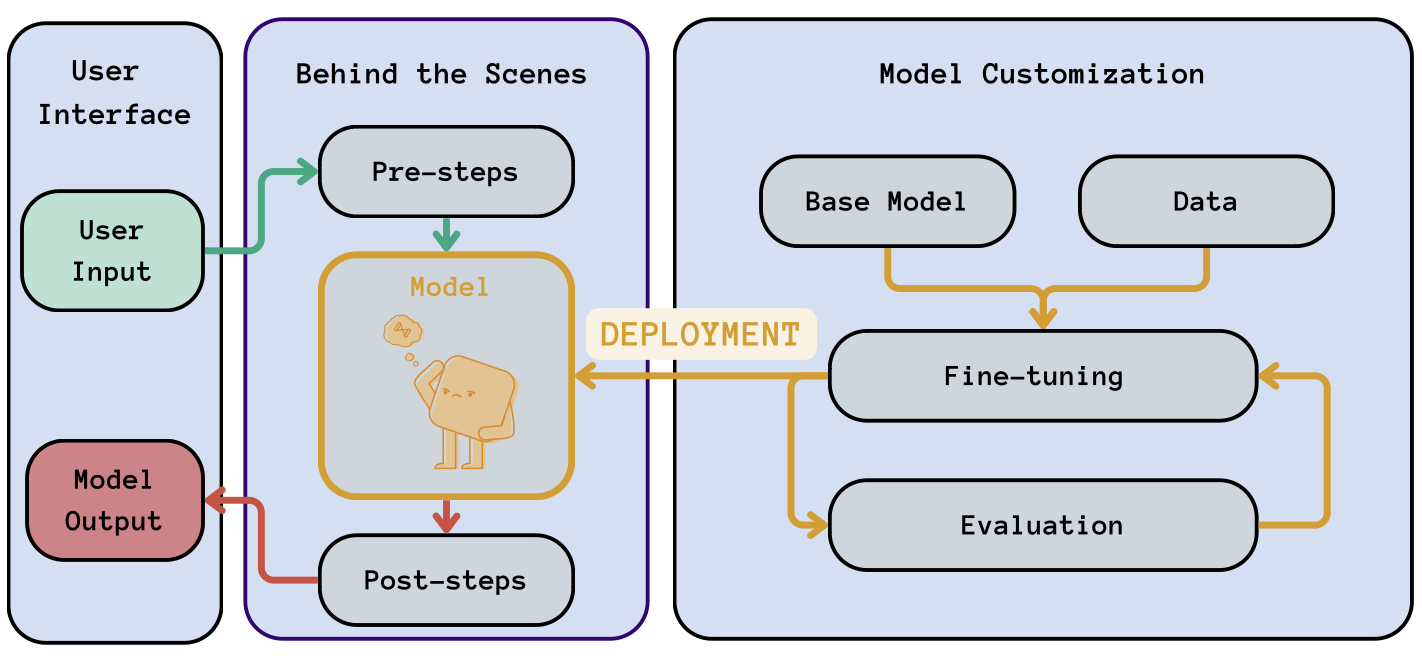
LLMOps‑Workflow: Hervorhebung des Deployment‑Schritts (orange) im generischen Ablauf. Dabei wird das Modell aus der Entwicklung in die Produktion „verschoben“.
Zum Deployment gehört auch die Schnittstelle, über die wir im Betrieb mit dem Modell kommunizieren. In der Regel hängt sie vom Verarbeitungsmodus ab:
APIs können auf Webservern oder Cloud‑Plattformen laufen und müssen für Nutzer oder angebundene Systeme erreichbar sein. Unser LLMOps‑Setup sollte sicherstellen, dass die API die erwartete Last verarbeiten kann – inklusive Skalierung, Lastverteilung und Failover‑Mechanismen.
Für Batch‑Szenarien lassen sich Jobs per Cron (unter Unix‑Systemen) oder mit Cloud‑basierten Job‑Planern terminieren. Diese Jobs lassen das Modell in festgelegten Intervallen neue Daten verarbeiten und Ergebnisse speichern.
Das produktive Deployment umfasst in der Regel auch Packaging und Versionierung:
Continuous Integration (CI) und Continuous Delivery (CD) automatisieren die Schritte vom Development bis in die Produktion – zuverlässig, aktuell und effizient.
In LLMOps sorgt CI dafür, dass neue Codes oder Änderungen am Modell (z. B. Hyperparameter, Architektur, Trainingsdaten) automatisch getestet werden: Unit‑ und Integrationstests sowie weitere Checks stellen sicher, dass nichts bricht und die Leistung nicht leidet. CI ist damit auch kontinuierliches Monitoring unserer Änderungen.
Nach bestandenen Tests übernimmt CD die automatisierte Auslieferung in die Produktionsumgebung. So läuft stets die stabilste, getestete Version im LLMOps‑Setup. Bei Problemen ermöglicht CD schnelle Rollbacks, minimiert Ausfallzeiten und sichert die Zuverlässigkeit des Service.
Zuletzt bleibt eine wichtige Frage: Wie ordnen wir die LLMOps‑Komponenten zu einer sinnvollen Kette von Schritten?
Orchestrierung definiert und steuert die Reihenfolge der Operationen im LLMOps‑Setup – also den Workflow. Beispielsweise die Abfolge von Vor‑ und Nachverarbeitung oder die Tests, die ein neues Modell bis zum Deployment durchlaufen muss.
Im LLM‑Kontext geht es dabei oft um das Weiterreichen von Daten zwischen Workflow‑Schritten. Üblich ist die Definition von Datenpfaden oder Workspaces, in denen ein Schritt seine Ergebnisse ablegt und der nächste sie übernimmt.
Orchestrierung wird häufig über Konfigurationsdateien gesteuert, typischerweise in YAML (Yet Another Markup Language). Darin werden Komponenten, Reihenfolge und Parameter der einzelnen Schritte definiert. Domänenspezifische Sprachen (DSLs) erleichtern die intuitive Beschreibung komplexer Workflows.
Workflows sind in der Regel automatisiert. Das stellt sicher, dass nach dem Start alle Schritte nahtlos ohne manuelles Eingreifen ablaufen – von einem Schritt zum nächsten – und vermeidet dadurch Fehlerquellen.
Wir haben die Schlüsselelemente einer LLMOps‑Infrastruktur und ihre Begründung betrachtet. Darüber hinaus gibt es fortgeschrittene Methoden, die Leistung weiter steigern:
Der Schutz von Daten und Nutzern steht im Zentrum einer vertrauenswürdigen LLMOps‑Infrastruktur.
Robuste Datenanonymisierung ist beispielsweise essenziell. Methoden wie Differential Privacy, k‑Anonymität oder Data Masking sorgen dafür, dass Trainingsdaten keine sensiblen persönlichen Informationen offenlegen. Planen wir, reale Nutzerdaten zur iterativen Verbesserung unserer Modelle zu verwenden, müssen Nutzer informiert werden, und ihre Daten sind vor Einbindung ins Fine‑Tuning zu anonymisieren.
Ein weiterer Sicherheitsaspekt ist die Speicherung privater Nutzerdaten, etwa von Chatverläufen wie bei ChatGPT. In diesem Fall müssen alle Daten sicher gehandhabt und im Einklang mit Datenschutzvorgaben wie der DSGVO verarbeitet werden – inklusive sicherer Speicherung und verschlüsselter Übertragung.
Schließlich sind robuste Zugriffskontrollen Pflicht: Nur autorisierte Personen dürfen auf Modell, Daten und Trainingsumgebung zugreifen, und es darf keine Lecks geben, die persönliche Informationen offenlegen.
LLM‑gestützte Anwendungen erleben seit dem vergangenen Jahr einen starken Aufschwung – getrieben durch die verbesserten Fähigkeiten neuer Modellgenerationen. Diese Anwendungen liefern LLMs als Service aus und benötigen dafür eine belastbare Management‑ und Optimierungsbasis: die LLMOps‑Infrastruktur.
Wir haben gezeigt, wie LLMOps als Rückgrat eines erfolgreichen, effizienten und nutzerzentrierten LLM‑Service fungieren. Zunächst haben wir die Reise eines Prompts von der Eingabe bis zur Antwort betrachtet. LLMOps sorgt dafür, dass all diese „Hinter‑den‑Kulissen“‑Schritte schlank und effizient ablaufen.
Zweitens haben wir erläutert, wie LLMOps Training, Deployment, Monitoring und Wartung umfasst. Dazu gehört auch das Skalieren von Ressourcen zur Bewältigung schwankender Lasten – für Skalierbarkeit und Zuverlässigkeit unserer LLM‑Anwendungen. Außerdem sind wir auf fortgeschrittene Best Practices zur Verfeinerung der LLMOps‑Infrastruktur eingegangen.
Drittens haben wir herausgestellt, dass LLMOps auch die Integrität und Sicherheit von LLMs als Service wahrt. Da diese Modelle häufig sensible Daten verarbeiten, sind robuste LLMOps‑Praktiken unerlässlich, um strenge Sicherheitsmaßnahmen, Datenschutz und regulatorische Compliance sicherzustellen.
Kurz gesagt, nach der Lektüre sollte eines klar sein: LLMOps sind nicht nur ein betrieblicher Pflichtpunkt, sondern ein strategischer Hebel, der den Wert, die Verlässlichkeit und die Zukunftsfähigkeit von LLMs als Service steigert.
Bereit für die Praxis? Vertiefe dein Wissen über Large Language Models mit unserem Hands‑on‑Tutorial: "How to Build LLM Applications with LangChain". Mach aus Wissen jetzt anwendbare Kompetenzen!
Starte deine LLM‑Reise heute!
Kurs
Kurs
Lernpfad