Cours
Travailler avec l'API OpenAI
3 h
173.1K
Lorsque nous, utilisateurs, interagissons avec ChatGPT, nous tapons simplement une invite dans l'interface web et appuyons sur Entrée. En général, nous recevons une réponse en quelques secondes. Pourtant, sous cette interaction fluide se cache une chaîne d'étapes complexes et parfaitement orchestrées qui rendent cette expérience possible.
L'exécution automatique de cette chaîne d'étapes, appelée opérations sur grands modèles de langue (LLMOps), garantit que l'invite parvient bien au modèle et qu'elle est traitée de manière efficace, précise et fiable. Elle assure ainsi la délivrance d'une réponse de qualité dans un délai raisonnable.
Dans cet article, nous allons explorer le paradigme LLMOps en retraçant le parcours d'une invite au sein d'un service de grand modèle de langue (LLM), comme ChatGPT. Nous examinerons les étapes clés, notamment le prétraitement des invites, la sélection du modèle, la génération de la réponse, ainsi que des aspects souvent négligés mais essentiels comme l'équilibrage de charge, la supervision et l'intégration continue.
LLMOps est en réalité une évolution des opérations de machine learning (MLOps), adaptées aux défis concrets posés par les LLM. Alors que MLOps se concentre sur la gestion du cycle de vie des modèles de machine learning en général, LLMOps intègre des aspects propres à cette catégorie de modèles.
Il est essentiel de comprendre que, lorsque nous utilisons un modèle d'OpenAI ou de Google, via une interface web ou des appels d'API depuis notre code, LLMOps reste invisible pour nous. Dans ce cas, on dit que ces modèles sont fournis en tant que service.
À l'inverse, si notre objectif est de proposer notre propre modèle pour un cas d'usage spécifique sans dépendre de fournisseurs externes — par exemple, un assistant pour les collaborateurs d'une entreprise —, la responsabilité de LLMOps nous incombe.
Quelle que soit la puissance de notre nouveau modèle, son succès en tant que service dépendra largement de l'existence d'une infrastructure LLMOps robuste et fiable. Si vous souhaitez en savoir plus sur MLOps, le tutoriel MLOps Fundamentals est fait pour vous !
Les premiers LLM, comme GPT-2, sont apparus en 2018. Leur popularité a toutefois explosé plus récemment, principalement grâce aux avancées majeures des versions suivantes, de GPT-3 et au-delà.
De nombreuses applications tirant parti des LLM ont vu le jour grâce à leurs performances impressionnantes : chatbots de service client, services de traduction, assistants à l'écriture et au code, entre autres.
Développer des applications prêtes pour la production et propulsées par des LLM pose un ensemble de défis spécifiques, différents de ceux des modèles de ML traditionnels. Pour y répondre, de nouveaux outils et bonnes pratiques ont été conçus pour gérer le cycle de vie des applications basées sur des LLM, donnant naissance au concept de « LLMOps ».
LLMOps est indispensable pour gérer efficacement ces modèles complexes lorsqu'ils sont déployés en tant que service, et ce pour plusieurs raisons :
1. Les LLM sont massifs, non seulement par le volume de données traité, mais aussi par le nombre de paramètres. LLMOps veille à ce que l'infrastructure puisse les supporter en termes de stockage et de bande passante.
2. Obtenir une réponse précise en un minimum de temps est crucial pour l'utilisateur. LLMOps garantit des délais raisonnables, condition essentielle pour des interactions fluides, proches du temps réel.
3. La supervision continue dans LLMOps ne se limite pas au suivi opérationnel ou aux incidents d'infrastructure. Elle inclut aussi l'observation attentive du comportement du modèle pour comprendre ses décisions et l'améliorer lors des itérations suivantes.
4. Faire tourner des LLM peut coûter cher en ressources. LLMOps introduit des stratégies de maîtrise des coûts pour utiliser les ressources de manière optimale sans sacrifier les performances.
Pour comprendre LLMOps, il faut connaître les « coulisses » d'un LLM proposé en tant que service : le chemin parcouru par une invite depuis son envoi au modèle jusqu'à la génération de la réponse. Le schéma suivant illustre ce flux :
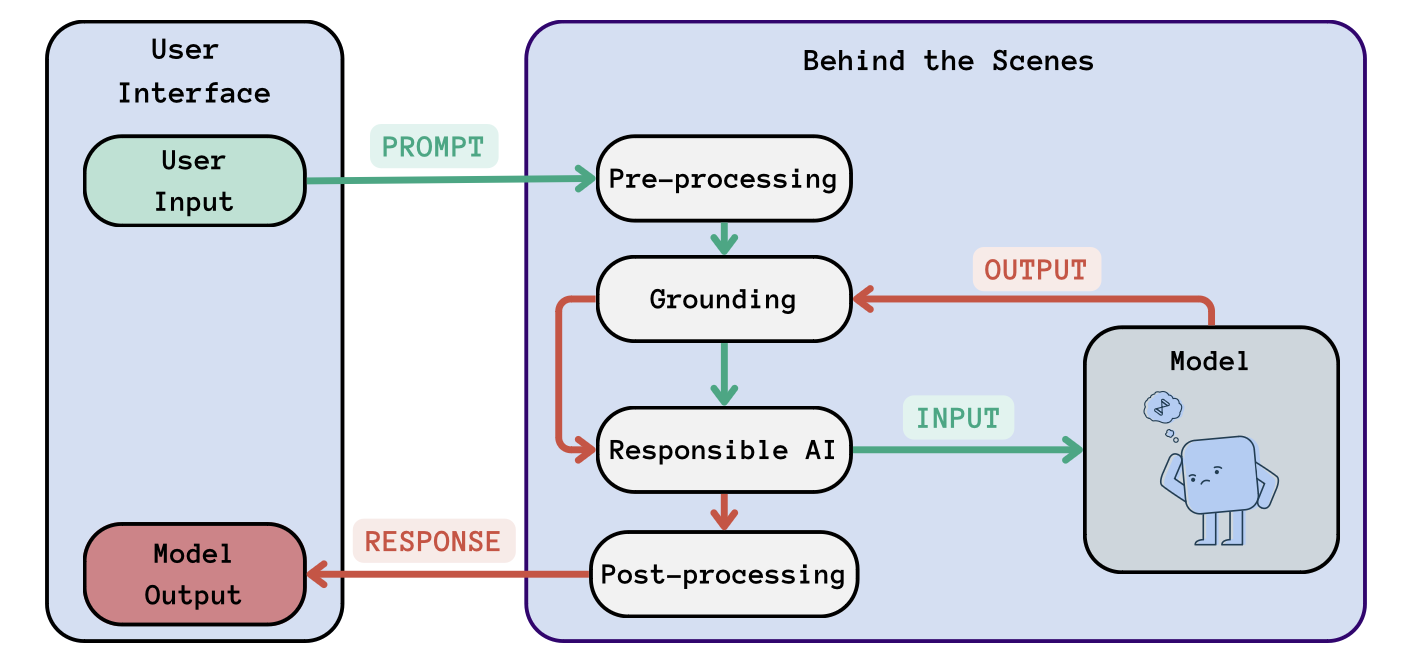
Workflow LLMOps : les étapes en coulisses d'un LLM générique en tant que service. L'entrée utilisateur (en vert) subit plusieurs étapes avant d'être transmise au modèle. De même, la sortie du modèle (en rouge) est transformée à plusieurs reprises avant d'être affichée à l'utilisateur.
Comme on peut le voir sur le schéma, l'invite passe par plusieurs étapes avant d'atteindre le modèle. Leur nombre peut varier, mais certaines sont incontournables pour, par exemple, clarifier l'entrée et garantir la pertinence contextuelle de la réponse. Détaillons-les :
Cette étape prépare l'invite de l'utilisateur pour que le modèle puisse la comprendre et la traiter. Elle inclut la tokenisation, qui segmente l'invite en unités plus petites appelées tokens. Elle comprend aussi la normalisation des données : suppression ou transformation des éléments bruités (caractères spéciaux), correction des fautes et standardisation du texte.
Enfin, lors de l'encodage, les tokens sont convertis en une forme numérique compréhensible par le modèle. On utilise pour cela des embeddings, qui représentent chaque token sous forme de vecteur dans un espace de grande dimension.
Il s'agit de contextualiser l'invite en fonction des tours de conversation précédents ou de sources de connaissance externes pour garantir une réponse cohérente et adaptée au contexte. Par ailleurs, la reconnaissance d'entités nommées et leur liage aident le système à identifier les entités (noms, lieux, dates, etc.) présentes dans l'invite et à les associer au bon contexte.
Afin d'encadrer l'usage des LLM, certains services mettent en place des garde-fous sur les invites des utilisateurs. En général, l'invite est évaluée au regard de règles de sécurité et de conformité, notamment en présence d'informations sensibles, de contenus inappropriés, de biais ou de risques de désinformation.
Ce n'est qu'après ces étapes que l'invite est transmise au modèle pour traitement. Une fois la réponse générée, et avant de l'afficher à l'utilisateur, elle peut de nouveau passer par l'ancrage et l'IA responsable, ainsi qu'une étape supplémentaire de post-traitement :
La réponse produite par le modèle est d'abord sous forme numérique, du fait des embeddings vectoriels mentionnés. Un processus de décodage est donc indispensable pour retransformer ces données en texte lisible. Après le décodage, une étape de révision permet d'affiner la grammaire, le style et la lisibilité.
Enfin, la réponse est affichée à l'utilisateur. L'infrastructure LLMOps exécute ces étapes de manière totalement transparente.
Nous avons vu qu'entre l'envoi d'une invite et la réception de la réponse, l'infrastructure LLMOps exécute de nombreuses étapes. Une question naturelle se pose alors : combien de temps tout cela prend-il ?
Avec ChatGPT, la réponse arrive généralement quasi instantanément. Ce délai est appelé latence. La latence est un indicateur de performance crucial, notamment dans les applications orientées utilisateur, où le temps de réponse impacte fortement l'expérience. Le niveau de latence acceptable dépend de notre cas d'usage.
Pour réduire la latence, LLMOps met en œuvre diverses stratégies et bonnes pratiques afin de fluidifier l'ensemble du processus, de la réception de l'entrée à la délivrance de la réponse. LLMOps contribue à réduire la latence du modèle en automatisant toutes les étapes requises et en gérant efficacement les ressources, de sorte qu'aucun calcul n'attende inutilement des ressources. D'autres pratiques aident également :
La réduction de la latence améliore l'expérience utilisateur et contribue aussi à la maîtrise des coûts en optimisant l'usage des ressources.
Jusqu'ici, nous n'avons pas discuté du modèle à intégrer dans notre dispositif LLMOps. Il existe de nombreux modèles, optimisés pour des cas d'usage précis, avec des tailles variées, etc. Le choix du modèle est déterminant et dépendra largement de l'application et des ressources disponibles.
Par ailleurs, le nombre de LLM et de fournisseurs semble croître chaque jour. D'où l'intérêt d'avoir une vision d'ensemble des différents types de LLM et de leurs fournisseurs, afin d'identifier celui qui convient le mieux à notre besoin.
Les modèles et fournisseurs de LLM se classent en plusieurs catégories :
Les principaux atouts des modèles open source résident dans la transparence et la possibilité de les personnaliser. Ils offrent généralement un contrôle complet sur les composants, facilitant le débogage et une personnalisation poussée via l'entraînement ou le fine-tuning. Cette flexibilité permet d'aligner le LLM au plus près de vos besoins, plutôt que de se limiter aux options prédéfinies par un fournisseur.
Cependant, gérer soi-même des LLM open source peut entraîner des défis d'ingénierie conséquents et des coûts élevés en calcul et stockage. Même avec une infrastructure minimale fournie, il est souvent difficile d'égaler les modèles propriétaires en termes de latence, de débit et de coûts d'inférence.
L'offre est vaste. Comment s'assurer de choisir le bon LLM ?
Plusieurs critères sont à considérer selon le cas d'usage et vos moyens :
Qu'ils soient propriétaires ou open source, les LLM nécessitent souvent un fine-tuning pour coller à des applications spécifiques.
Des LLM pré-ajustés existent pour certaines tâches courantes, notamment des modèles de chat, de résumé ou d'analyse de sentiment. Autre variante à considérer : les modèles à long contexte. Les LLM modernes gèrent typiquement des contextes de 2 000 à 8 000 tokens ; au-delà, entrées et sorties ne peuvent être traitées directement. Certains modèles offrent toutefois des variantes long contexte. Par exemple, GPT‑3.5 existe en version 16k.
Si les options existantes ne répondent pas au cahier des charges, on peut toujours affiner ou même entraîner un modèle soi-même. Dans ce cas, le choix du jeu de données est crucial pour permettre au modèle de bien saisir la tâche visée.
Si vous souhaitez entraîner un LLM depuis zéro, nous vous recommandons vivement le tutoriel DataCamp How to train an LLM with PyTorch.
Si notre application exige d'affiner un modèle existant, ces étapes doivent aussi faire partie de notre dispositif LLMOps. Ajoutons cette brique de personnalisation à notre schéma :
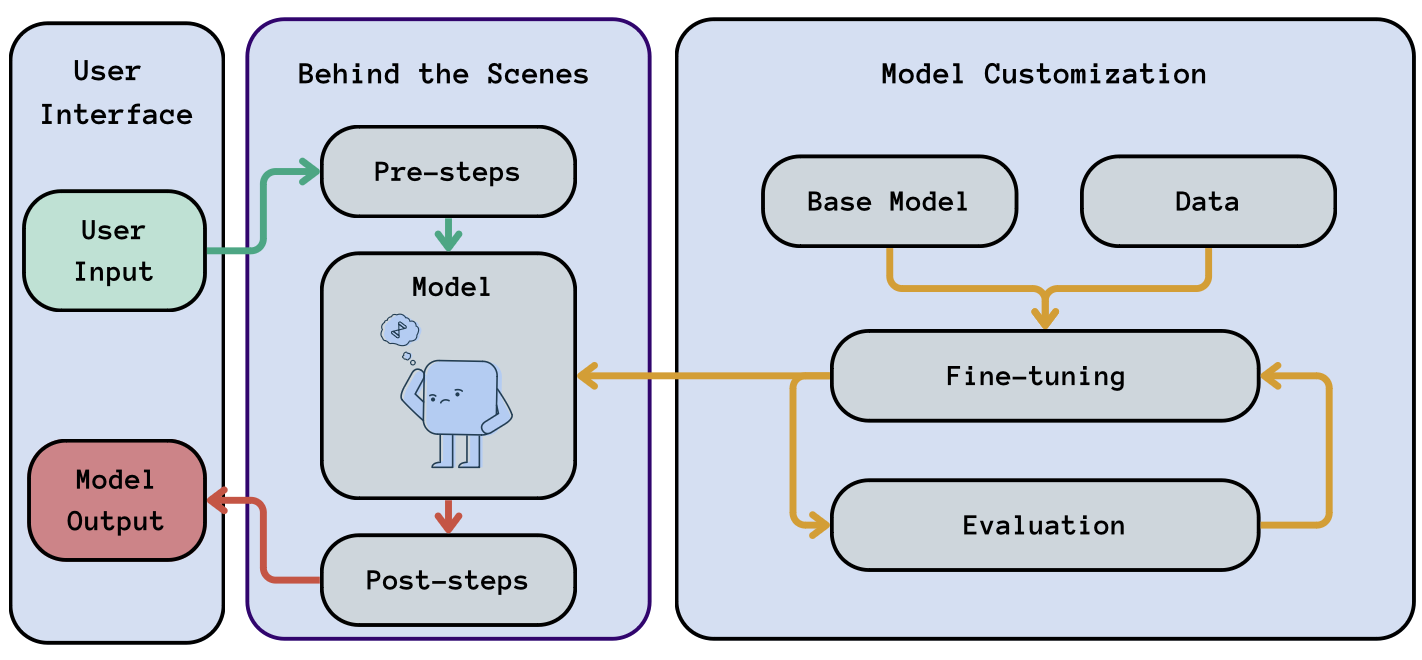
Workflow LLMOps : ajout des étapes de personnalisation du modèle (en orange) à notre flux générique.
Disposer d'une chaîne de fine-tuning cohérente vous aide à enrichir progressivement les connaissances du modèle à mesure que de nouvelles données arrivent, et vous permet de mettre à niveau votre LLM ou d'effectuer d'autres modifications sans friction.
Si vous dépendez de modèles tiers, notez qu'ils peuvent évoluer, tant en disponibilité qu'en coût. Vous pourriez être amené à changer de modèle de base. Une architecture LLMOps robuste permet de gérer sereinement cette situation critique en remplaçant simplement la « brique Modèle » par un autre LLM.
On pourrait penser que le fine-tuning ou l'entraînement depuis zéro sortent du périmètre LLMOps, le LLM n'opérant qu'une fois en production. C'est faux, notamment pour la raison évoquée : un service performant nécessite d'améliorer le modèle et de rester résilient à d'éventuels changements de fournisseur.
Pour un entraînement, un fine-tuning ou un affinement efficaces dans une infrastructure LLMOps générique, il est important d'assurer une mise en forme cohérente des données entre entraînement et inférence ultérieure. Pour cela, on formate généralement les données d'entraînement en JSON Lines (.jsonl). Ce format est particulièrement adapté au fine-tuning des LLM grâce à sa structure, qui facilite le traitement de grands jeux de données. Un fichier .jsonl typique pour le fine-tuning peut ressembler à ceci :
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Chaque ligne d'un fichier .jsonl est un objet JSON distinct représentant un exemple d'entraînement, avec les clés prompt et completion indiquant respectivement le texte d'entrée et la réponse attendue, comme lors de l'inférence. Ce format facilite en outre l'ajout incrémental de nouvelles données à la base de connaissances du modèle.
Les paramètres du modèle comptent également lors de la mise en place de notre infrastructure LLMOps, car ils impactent la taille du modèle et la consommation de ressources.
S'agissant des paramètres d'entraînement, il est important de les optimiser pour trouver l'équilibre entre complexité du modèle et contraintes de déploiement (comme l'usage mémoire). Cette optimisation est cruciale pour déployer des modèles sur des environnements hétérogènes, afin qu'ils soient non seulement avancés, mais aussi pratiques sur le terrain.
Côté inférence, le réglage de paramètres comme la température et le nombre maximal de tokens permet de contrôler la longueur et le degré d'aléa des réponses. Ces réglages font partie du processus LLMOps pour aligner la sortie du modèle sur les exigences de l'application et l'intention de l'utilisateur.
Les techniques de prompt engineering permettent d'amplifier les capacités par défaut des LLM, notamment en les contextualisant : demander au modèle d'agir en expert d'un domaine donné ou le guider vers un format de sortie souhaité. La conception et la gestion des invites doivent faire partie intégrante de notre dispositif LLMOps.
Parmi les pratiques les plus efficaces figurent le few-shot prompting et le raisonnement en chaîne (chain-of-thought). Passons-les brièvement en revue et voyons comment les intégrer à notre LLMOps :
L'implémentation de ces techniques dans notre dispositif LLMOps peut s'appuyer efficacement sur des modèles d'invite.
Les modèles d'invite sont des structures prédéfinies qui guident le raisonnement des LLM. Ils imposent une trame cohérente pour formuler des requêtes similaires, ou permettent d'intégrer des techniques de prompt engineering, sans friction pour l'utilisateur.
Concevoir et gérer un référentiel de modèles d'invite soignés pour divers cas d'usage est crucial en LLMOps. Le choix du bon modèle d'invite pour un besoin donné est généralement une étape préliminaire du prétraitement, avant l'envoi de la requête au modèle.
Pour le few-shot prompting, les modèles doivent inclure plusieurs exemples démontrant la tâche ou le style de réponse attendu. Pour intégrer le chain-of-thought, ils doivent détailler un cheminement pas à pas, guidant le modèle pour décomposer méthodiquement tout problème en étapes simples et gérables.
L'intégration de connaissances issues de sources externes peut faire partie du chain-of-thought, notamment dans des frameworks comme LangChain, où le modèle est invité à aller chercher sur internet si sa base de connaissances interne est insuffisante.
Dans les deux cas — few-shot et chain-of-thought —, tester les invites en A/B est très utile : mener des expérimentations contrôlées en exposant des sous-groupes d'utilisateurs à des variantes d'invites, mesurer objectivement les performances et retenir les meilleures. Il est essentiel de s'appuyer sur les données de performance pour améliorer nos modèles d'invite de manière itérative.
Une fois le modèle de base entraîné ou affiné, et le résultat satisfaisant, il est temps de le déployer. Dans le contexte LLMOps, le déploiement consiste à rendre le modèle disponible en production. Il s'agit de le sortir de l'environnement d'entraînement et de l'intégrer à l'infrastructure de production. Cette étape apparaît en orange sur notre schéma habituel :
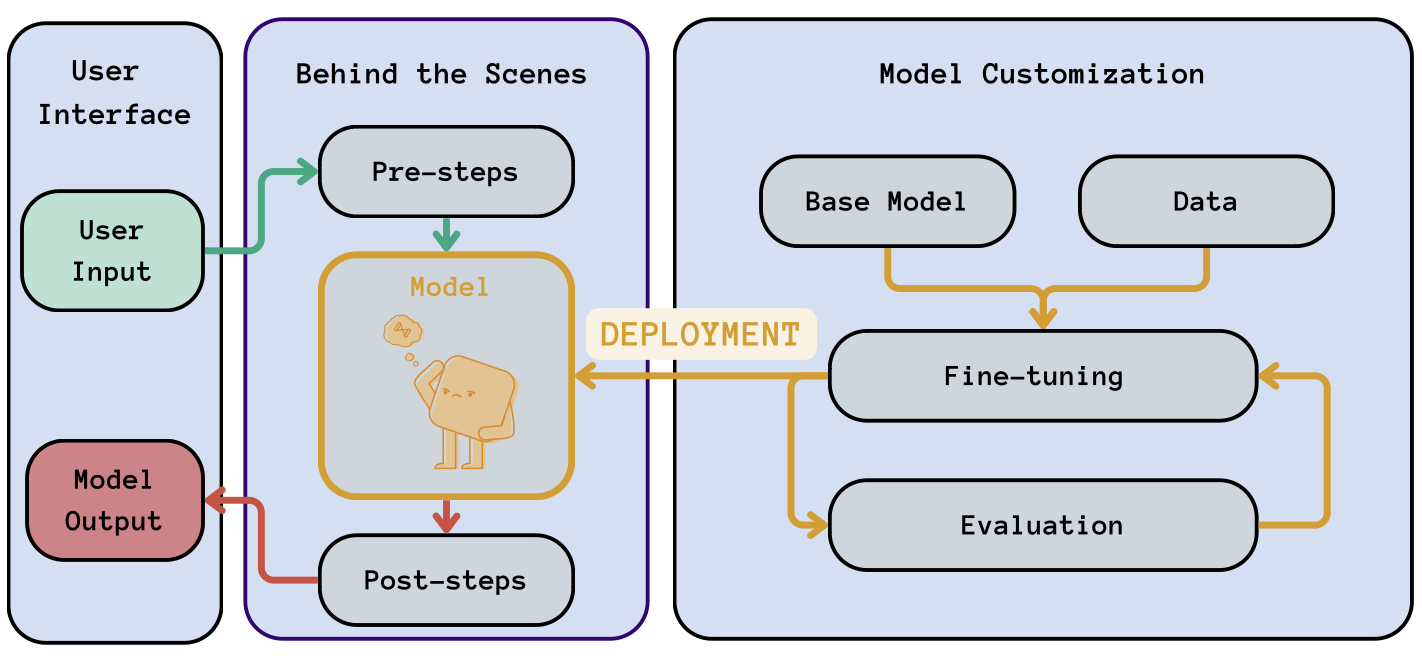
Workflow LLMOps : mise en évidence de l'étape de déploiement (en orange) dans notre flux générique. Cette étape consiste à « déplacer » le modèle de l'environnement de développement vers la production.
Le déploiement inclut aussi la définition de l'interface qui servira à communiquer avec le modèle en production. En général, elle dépend de notre mode de traitement :
Les API peuvent être déployées sur des serveurs web ou des plateformes cloud, afin d'être accessibles aux utilisateurs ou aux systèmes qui doivent interagir avec le modèle. Notre dispositif LLMOps doit garantir que l'API supporte la charge attendue, avec des mécanismes d'élasticité, d'équilibrage de charge et de bascule.
Pour ces usages batch, vous pouvez planifier des tâches avec cron (systèmes de type Unix) ou via des planificateurs cloud. Ces jobs exécutent le modèle sur les nouvelles données aux intervalles définis, traitent les données et stockent les résultats.
Enfin, le déploiement en production implique généralement empaquetage et versionnage du modèle :
Les pipelines d'intégration continue (CI) et de livraison continue (CD) automatisent les étapes qui mènent un modèle du développement à la production, en garantissant fiabilité, fraîcheur et efficacité de déploiement.
En LLMOps, dès que du nouveau code ou des changements sont introduits (réglage d'hyperparamètres, modification d'architecture, nouvelles données d'entraînement), la CI s'assure que ces changements sont testés automatiquement : tests unitaires, d'intégration et autres vérifications pour garantir qu'ils ne cassent rien ni ne dégradent les performances. En ce sens, la CI est une forme de supervision continue de notre modèle.
Une fois les tests passés, la CD automatise le déploiement en production. Ainsi, la version la plus stable et testée tourne toujours dans l'environnement LLMOps. La CD facilite également le retour rapide à une version antérieure en cas de problème, minimisant les interruptions et garantissant la fiabilité du service.
Il reste un aspect dont nous n'avons pas encore parlé : comment enchaîner nos composants LLMOps pour former un flux cohérent ?
L'orchestration consiste à définir et piloter l'ordre des opérations dans le dispositif LLMOps, autrement dit le workflow. Par exemple, ordonner les étapes de pré- et post-traitement, ou les différents tests qu'un nouveau modèle doit passer avant déploiement.
Dans le contexte LLM, l'orchestration implique souvent de faire circuler des données entre composants. On gère cela en spécifiant des emplacements ou espaces de travail où la sortie d'une étape est stockée puis récupérée par l'étape suivante.
L'orchestration s'appuie fréquemment sur des fichiers de configuration, souvent en YAML (Yet Another Markup Language). Ils définissent les composants, leur ordre et les paramètres de chaque étape. Des langages spécifiques au domaine (DSL) peuvent être utilisés pour offrir une syntaxe plus intuitive et spécialisée.
Enfin, les workflows sont généralement automatisés. Cela garantit qu'une fois lancée, la chaîne s'exécute sans intervention manuelle, étape après étape, en réduisant les risques d'erreur d'exécution.
Nous avons présenté les briques essentielles d'une infrastructure LLMOps et leur raison d'être. D'autres techniques avancées peuvent encore renforcer ses performances :
Assurer la confidentialité des données et la protection des utilisateurs dans notre infrastructure LLMOps est au cœur de la fiabilité du service.
Par exemple, mettre en place des techniques d'anonymisation robustes est essentiel. Des approches comme la confidentialité différentielle, le k-anonymat ou le masquage de données permettent d'éviter que les jeux d'entraînement ne révèlent des informations personnelles sensibles collectées lors de leur constitution. De plus, si vous prévoyez d'utiliser des données réelles pour améliorer vos modèles de façon itérative, l'utilisateur doit en être informé et ses données doivent être anonymisées avant d'entrer dans la boucle de fine-tuning.
Autre volet de sécurité : si vous stockez des informations privées (par exemple l'historique de conversation de type ChatGPT), vous devez garantir un traitement sécurisé et conforme aux réglementations comme le RGPD. Cela inclut le stockage sécurisé et le chiffrement des données en transit dans votre infrastructure.
Enfin, assurez des contrôles d'accès rigoureux dans l'infrastructure LLMOps, en veillant à ce que seules les personnes autorisées accèdent au modèle, aux données et à l'environnement d'entraînement, sans risque de fuite exposant des informations personnelles.
Les applications propulsées par des LLM se multiplient depuis l'an dernier, portées par les capacités accrues des itérations récentes. Livrés en tant que service, ces modèles exigent un cadre robuste pour leur gestion et leur optimisation : l'infrastructure LLMOps.
Dans cet article, nous avons montré le rôle central de LLMOps comme colonne vertébrale d'un service LLM performant, efficace et orienté utilisateur. Nous avons d'abord retracé le parcours d'une invite, de son envoi au modèle jusqu'à la réception de la réponse. LLMOps veille à ce que toutes ces étapes « en coulisses » soient fluides et efficaces.
Nous avons ensuite vu comment LLMOps couvre l'entraînement, le déploiement, la supervision et la maintenance du modèle. LLMOps englobe aussi la mise à l'échelle des ressources pour absorber les variations de charge, garantissant la scalabilité et la fiabilité de nos applications fondées sur des LLM. Nous avons enfin évoqué des bonnes pratiques avancées pour affiner notre infrastructure.
Enfin, nous avons souligné le rôle de LLMOps dans la préservation de l'intégrité et de la sécurité des LLM en tant que service. Ces modèles traitant souvent des données sensibles, des pratiques LLMOps solides sont essentielles pour appliquer des mesures de sécurité strictes, assurer la confidentialité des données et la conformité réglementaire.
En somme, après cette lecture, j'espère vous avoir convaincu d'un point clé : LLMOps n'est pas seulement une nécessité opérationnelle, mais un atout stratégique qui renforce la valeur, la fiabilité et la pérennité des LLM en tant que service.
Prêt à passer à la pratique ? Approfondissez l'univers des grands modèles de langue avec notre tutoriel concret : "How to Build LLM Applications with LangChain". Transformez dès aujourd'hui vos connaissances en compétences actionnables !
Commencez votre aventure LLM dès aujourd'hui !
Cours
Cours
Cursus