
Corso
Lavorare con l'API di OpenAI
3 ore
179.5K
Quando noi, come utenti, interagiamo con ChatGPT, ci basta digitare un prompt nell’interfaccia web e premere invio. Di solito iniziamo a ricevere una risposta entro pochi secondi. Tuttavia, sotto questa interazione senza attriti si cela una serie complessa e ordinata di passaggi che consentono a ChatGPT di offrire un’esperienza del genere.
L’esecuzione automatica di questa serie di passaggi, nota come Large Language Model Operations (LLMOps), garantisce che il prompt non solo raggiunga il modello, ma venga anche elaborato in modo efficiente, accurato e affidabile. Questo assicura la consegna di una risposta ben formulata entro tempi ragionevoli.
In questo articolo, approfondiremo il paradigma LLMOps seguendo il viaggio di un prompt attraverso un servizio di Large Language Model (LLM), come ChatGPT. Esamineremo le fasi cruciali, tra cui il pre-processing del prompt, la selezione del modello, la generazione della risposta e gli aspetti spesso trascurati ma vitali come il bilanciamento del carico, il monitoraggio e la Continuous Integration.
Gli LLMOps sono in effetti un’evoluzione dei ben noti Machine Learning Operations (MLOps), adattati per affrontare le sfide concrete poste dagli LLM. Mentre gli MLOps si concentrano sulla gestione del ciclo di vita dei modelli di Machine Learning generici, gli LLMOps incorporano aspetti specifici di questi particolari modelli.
È fondamentale capire che ogni volta che interagiamo con un modello di OpenAI o Google, sia tramite interfaccia web sia tramite chiamate API dal nostro codice, gli LLMOps sono trasparenti per noi. In questo scenario, diciamo che questi modelli sono forniti as-a-service.
Se, invece, l’obiettivo è offrire il nostro modello per un caso d’uso specifico senza dipendere da provider esterni, ad esempio un assistente per i dipendenti di un’azienda, allora la responsabilità degli LLMOps ricade su di noi.
A prescindere dalle capacità del nostro nuovo modello, il suo successo come servizio dipenderà in larga misura dalla presenza di un’infrastruttura LLMOps solida e affidabile. Se ti interessa saperne di più sugli MLOps, il tutorial MLOps Fundamentals fa per te!
I primi LLM, come GPT-2, sono stati introdotti nel 2018. Tuttavia, sono diventati popolari più recentemente, principalmente grazie ai significativi progressi nelle capacità delle versioni più recenti di quei modelli, da GPT-3 in poi.
Sono emerse numerose applicazioni che sfruttano gli LLM grazie alle loro impressionanti capacità. Esempi includono chatbot per il customer service, servizi di traduzione e assistenti alla scrittura e al coding, tra gli altri.
Sviluppare applicazioni pronte per la produzione alimentate da LLM presenta una serie di sfide specifiche, diverse da quelle dei modelli ML tradizionali. Per affrontarle, sono stati sviluppati nuovi strumenti e best practice per gestire il ciclo di vita delle applicazioni LLM, portando al concetto di “LLMOps”.
Gli LLMOps sono essenziali per gestire in modo efficiente questi modelli complessi quando vengono distribuiti as-a-service per molteplici motivi:
1. Gli LLM sono grandi non solo per la quantità di dati che gestiscono, ma anche per il numero di parametri. Gli LLMOps assicurano che l’infrastruttura possa supportare questi modelli in termini di archiviazione e banda.
2. Ricevere una risposta accurata nel minor tempo possibile è cruciale per gli utenti. Gli LLMOps garantiscono che le risposte arrivino in tempi ragionevoli, mantenendo la fluidità di un’interazione simile a quella umana.
3. Il monitoraggio continuo negli LLMOps non riguarda solo gli aspetti operativi o i problemi dell’infrastruttura. Comporta anche un attento tracciamento del comportamento del modello per comprenderne i processi decisionali e migliorarlo nelle iterazioni future.
4. Eseguire LLM può essere costoso a causa delle risorse necessarie. Gli LLMOps introducono strategie economiche per garantire un uso ottimale delle risorse senza compromettere le prestazioni.
Per capire gli LLMOps, è importante conoscere il “dietro le quinte” degli LLM quando sono offerti as-a-service. Ovvero il percorso che un prompt segue da quando viene fornito al modello fino a quando la risposta è generata. Il seguente schema rappresenta questo flusso di lavoro:
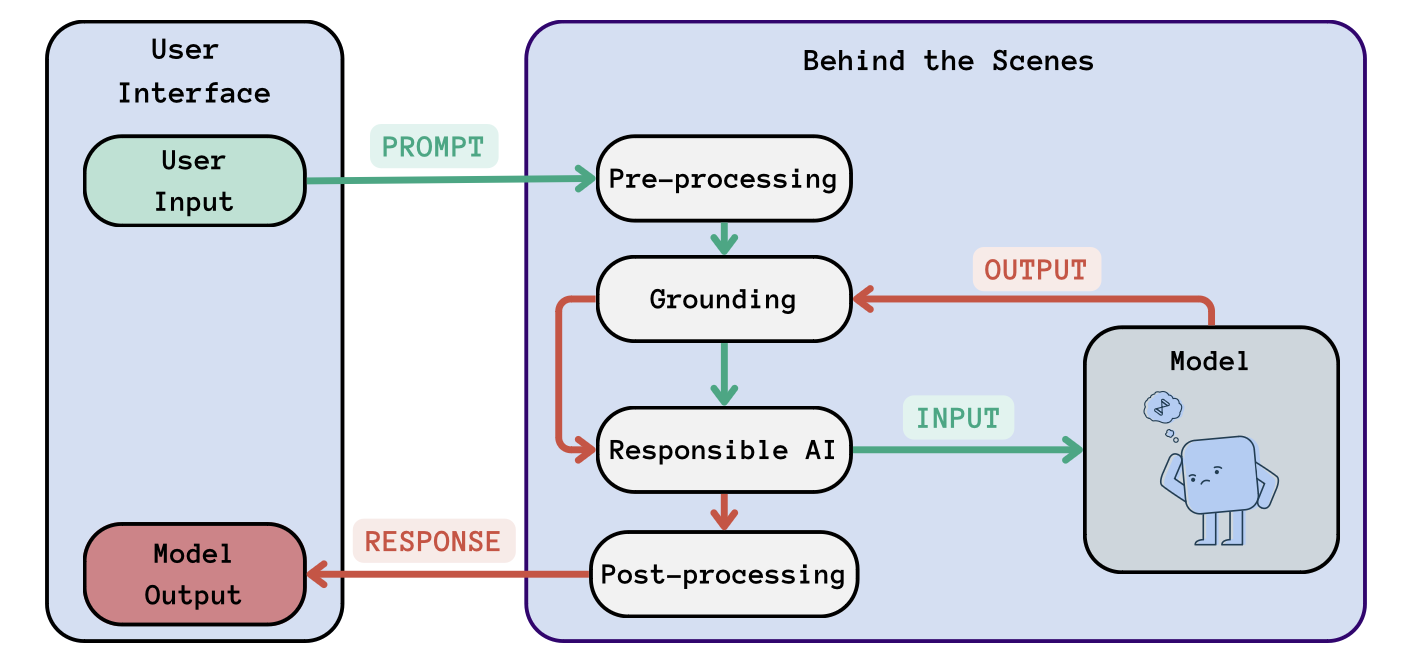
Flusso di lavoro LLMOps: i passaggi dietro le quinte di un LLM generico as-a-service. L’input dell’utente (in verde) attraversa alcuni passaggi prima di essere immesso nel modello. Allo stesso modo, l’output del modello (in rosso) subisce diverse trasformazioni prima di essere mostrato all’utente.
Come possiamo osservare dallo schema sopra, il prompt attraversa diversi passaggi prima di raggiungere il modello. Sebbene il numero di passaggi possa variare, ce ne sono alcuni di base per garantire, ad esempio, che l’input sia compreso chiaramente e che la risposta del modello sia pertinente al contesto. Vediamo questi passaggi:
Questo passaggio prepara il prompt dell’utente in modo che il modello possa comprenderlo ed elaborarlo. Include la tokenizzazione, in cui il prompt viene segmentato in unità più piccole chiamate token. Questo passaggio comprende anche la normalizzazione dei dati, che include la rimozione o trasformazione di rumore come caratteri speciali, la correzione di refusi e la standardizzazione del testo.
Infine, durante la codifica, i token vengono convertiti in una forma numerica comprensibile dal modello. Ciò avviene usando gli embedding, che rappresentano ciascun token come un vettore in uno spazio ad alta dimensionalità.
Questo passaggio consiste nel contestualizzare il prompt in base ai turni di conversazione precedenti o a fonti di conoscenza esterne per garantire che la risposta del modello sia coerente e appropriata al contesto. Inoltre, il riconoscimento e il linking delle entità aiutano il sistema a identificare entità (come nomi, luoghi e date) all’interno del prompt e ad associarle al contesto rilevante.
Per garantire un uso appropriato degli LLM, alcuni servizi applicano controlli di sanità sui prompt degli utenti. In genere, il prompt viene valutato rispetto a linee guida di sicurezza e conformità, soprattutto in scenari che coinvolgono informazioni sensibili, contenuti inappropriati, bias o potenziale disinformazione.
Solo dopo questi passaggi il prompt viene finalmente inoltrato al modello per l’elaborazione. Dopo che il modello genera la risposta, e prima di mostrarla all’utente, la risposta può ripetere i passaggi di Grounding e Responsible AI, oltre a un ulteriore passaggio di post-processing:
La risposta generata dal modello è in forma numerica a causa dei vettori di embedding menzionati in precedenza. Pertanto, è essenziale un processo di decodifica per convertire questi dati numerici in testo leggibile. Dopo la decodifica, è necessario un passaggio di rifinitura per migliorare la risposta in termini di grammatica, stile o leggibilità.
Infine, la risposta viene mostrata all’utente. L’infrastruttura LLMOps è responsabile dell’esecuzione di questi passaggi in modo trasparente per l’utente.
Abbiamo visto diversi passaggi che l’infrastruttura LLMOps deve eseguire dal momento in cui un utente invia un prompt fino a quando riceve la risposta. A questo punto sorge una domanda ragionevole: Quanto tempo richiedono questi passaggi?
Quando usiamo ChatGPT, il tempo di risposta è normalmente quasi immediato. Questo tempo di risposta è noto come latenza. La latenza è una metrica di prestazioni critica, soprattutto nelle applicazioni rivolte agli utenti, dove il tempo di risposta influisce notevolmente sull’esperienza d’uso. Scegliere la latenza appropriata è fondamentale, a seconda del nostro caso d’uso.
Per ridurre la latenza della risposta, gli LLMOps impiegano varie strategie e best practice per snellire l’intero processo, dalla ricezione dell’input alla consegna dell’output. Gli LLMOps contribuiscono a ridurre la latenza del modello eseguendo automaticamente tutti i passaggi necessari e gestendo in modo efficiente le risorse, così che nessun calcolo rimanga in attesa di risorse disponibili. Altre best practice possono inoltre ridurre la latenza:
Ridurre la latenza non solo migliora l’esperienza utente, ma contribuisce anche all’efficienza dei costi ottimizzando l’uso delle risorse.
Finora non abbiamo discusso quale modello debba essere presente nella nostra configurazione LLMOps. Esistono vari tipi di modelli disponibili, ciascuno ottimizzato per casi d’uso specifici, con opzioni di dimensione diverse, ecc. Selezionare il modello appropriato è fondamentale e dipenderà in gran parte dalla nostra applicazione e dalle risorse disponibili.
Inoltre, sembra che il numero di LLM e provider aumenti ogni giorno. Per questo avere una comprensione ampia dei diversi tipi di LLM e dei loro provider è utile, soprattutto quando si cerca di identificare quello più adatto al nostro caso d’uso.
I modelli e i provider di LLM possono essere classificati nelle seguenti tipologie:
I principali vantaggi dei modelli open source risiedono nella trasparenza e nella possibilità di personalizzazione. I modelli open source offrono normalmente il pieno controllo su tutte le componenti, consentendo un debug agevole e un’ampia personalizzazione tramite training o fine-tuning. Questo grado di flessibilità permette un migliore allineamento dell’LLM alle tue esigenze specifiche, invece di doversi conformare alle opzioni predefinite stabilite dal provider.
Tuttavia, gestire autonomamente LLM open source può comportare notevoli sfide ingegneristiche e costi relativi a calcolo e storage. Anche se i modelli open source forniscono un’infrastruttura minima, spesso è difficile competere con i modelli proprietari in termini di latenza, throughput e costi di inferenza.
Ci sono molti modelli tra cui scegliere. Ma come facciamo ad assicurarci di scegliere l’LLM giusto?
Esistono in effetti alcuni criteri da considerare in base al nostro caso d’uso e alle nostre possibilità:
Siano essi proprietari o open source, gli LLM richiedono spesso il fine-tuning per essere davvero adatti ad applicazioni specifiche.
Sono disponibili LLM pre-fine-tuned per alcuni compiti, comunemente inclusi i modelli per chat e quelli specializzati in riassunto o analisi del sentiment. Un’altra variante da considerare sono i modelli con contesti lunghi. Gli LLM moderni gestiscono tipicamente lunghezze di contesto da 2.000 a 8.000 token, il che significa che input e output oltre questo intervallo non possono essere elaborati direttamente. Tuttavia, alcuni modelli offrono varianti a contesto lungo. Ad esempio, GPT-3.5 ha una variante con contesto 16k più ampio.
Tuttavia, se le opzioni esistenti non soddisfano requisiti specifici, c’è sempre la possibilità di effettuare il fine-tuning o persino addestrare un modello da zero. In questo caso, la scelta di un dataset appropriato è cruciale, perché consente al modello di comprendere la natura del compito target.
Se ti interessa addestrare un LLM da zero, ti consiglio vivamente il tutorial di DataCamp, How to train an LLM with PyTorch.
Se la nostra applicazione richiede il fine-tuning di un modello esistente, i passaggi correlati dovrebbero far parte anche della nostra configurazione LLMOps. Aggiungiamo questo passaggio di personalizzazione al nostro diagramma originale:
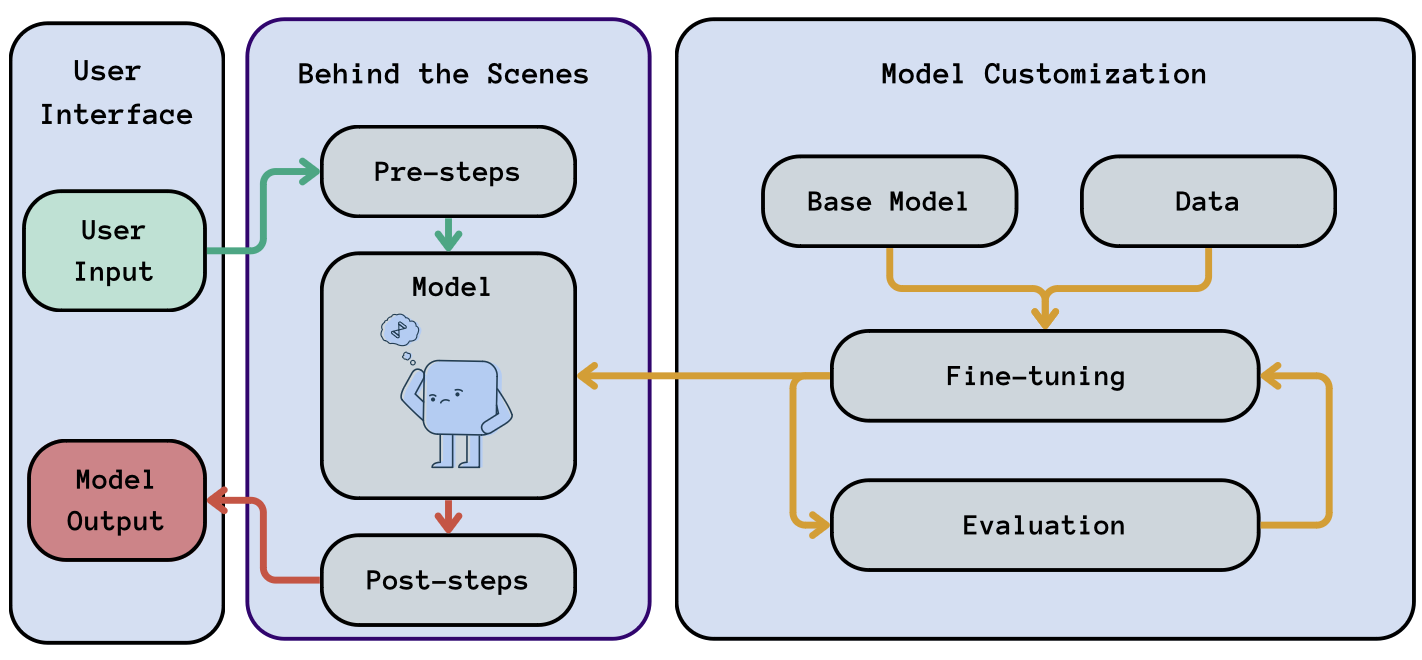
Flusso di lavoro LLMOps: inclusione dei passaggi di personalizzazione del modello (in arancione) nel nostro flusso generico.
Disporre di una pipeline di fine-tuning coerente può aiutarti a espandere la conoscenza del tuo modello nel tempo man mano che diventano disponibili più dati, consentendoti di aggiornare senza sforzo la versione del tuo LLM o apportare altre modifiche.
Quando dipendiamo da modelli di terze parti, è importante notare che questi modelli possono cambiare in termini di disponibilità e costo. Ciò può potenzialmente costringerci a passare a un modello di base diverso. Una solida configurazione LLMOps ci consentirà di gestire questa situazione critica in modo fluido sostituendo semplicemente il riquadro “Model” con un altro LLM.
Si potrebbe pensare che effettuare il fine-tuning del tuo LLM o addestrarlo da zero sia un primo passo al di fuori dell’infrastruttura LLMOps, poiché l’LLM opererà una volta distribuito in produzione. Tuttavia, non è così, soprattutto per il motivo citato: un servizio di successo richiederà miglioramenti del modello ed essere resiliente ai cambiamenti di provider, se necessario.
Per un training, un fine-tuning o un refinement efficaci in un’infrastruttura LLMOps generica, è importante mantenere un formato dei dati coerente tra i dati di training e quelli di inferenza successiva. Per farlo, in genere formattiamo i dati di training nel formato JSON Lines (.jsonl). Questo formato è molto adatto al fine-tuning degli LLM grazie alla sua struttura, che consente l’elaborazione efficiente di grandi dataset. Un file .jsonl tipico per il fine-tuning potrebbe essere così:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Ogni riga in un file .jsonl è un oggetto JSON distinto, che rappresenta un singolo esempio di training, con le chiavi prompt e completion che indicano rispettivamente il testo in input e la risposta attesa del modello, come ci aspetteremmo in inferenza. Inoltre, questo formato facilita l’aggiunta incrementale di nuovi dati alla base di conoscenza del modello.
Anche i parametri del modello sono importanti quando si imposta l’infrastruttura LLMOps, poiché impattano su caratteristiche come dimensione del modello e consumo di risorse.
Per quanto riguarda i parametri di training, è importante ottimizzarli per bilanciare la complessità del modello con i vincoli di deployment come l’uso della memoria. Questa ottimizzazione è cruciale per distribuire modelli in ambienti diversi con capacità di risorse variabili, garantendo che i modelli non siano solo avanzati ma anche pratici per applicazioni reali.
Per quanto riguarda i parametri di inferenza, la regolazione di parametri come temperature e max tokens consente di controllare la lunghezza e la casualità delle risposte. Queste impostazioni sono gestite come parte del processo LLMOps per allineare l’output del modello ai requisiti specifici dell’applicazione e all’intenzione dell’utente.
Le tecniche di prompt engineering hanno dimostrato di migliorare le capacità predefinite degli LLM. Un motivo è che aiutano a contestualizzare il modello. Ad esempio, istruendo il modello a comportarsi come un esperto in un dominio specifico o guidandolo verso un output desiderato. Prompt Engineering e Management sono componenti cruciali che dovrebbero essere inclusi nella nostra configurazione LLMOps.
Tra le pratiche di prompt engineering più efficaci ci sono il few-shot prompting e il chain-of-thought reasoning. Rivediamo brevemente queste tecniche e come integrarle nel nostro setup LLMOps:
L’implementazione di tecniche come few-shot prompting e chain-of-thought reasoning all’interno del nostro setup LLMOps può essere realizzata in modo efficace tramite l’uso di template di prompt.
I template di prompt sono strutture predefinite usate per guidare il ragionamento degli LLM. Forniscono una struttura coerente, assicurando che richieste simili vengano formulate in modo uniforme o aiutando a includere tecniche di prompt engineering in modo trasparente per l’utente.
Sviluppare e gestire un repository di template di prompt ben progettati per vari casi d’uso è cruciale in un setup LLMOps. La selezione del template di prompt appropriato per un caso d’uso specifico è di solito un passaggio preliminare eseguito durante la fase di pre-processing prima che la query venga inviata al modello.
Per il few-shot prompting, i template dovrebbero essere progettati per includere diversi esempi che mostrino il compito o lo stile di risposta atteso dal modello. Allo stesso modo, per incorporare il chain-of-thought reasoning, i template di prompt dovrebbero essere meticolosamente progettati per includere un processo di pensiero passo passo. In sostanza, dovrebbero guidare il modello su come affrontare e scomporre metodicamente qualsiasi problema in passaggi più semplici e gestibili.
Incorporare conoscenza da fonti esterne può essere un passaggio del chain-of-thought reasoning, particolarmente utile in framework come LangChain, dove il modello è istruito a recuperare informazioni da internet se la sua base di conoscenza esistente è insufficiente.
Sia nel few-shot prompting sia nel chain-of-thought reasoning, l’uso di A/B test dei prompt è estremamente vantaggioso. Ciò comporta la conduzione di esperimenti controllati esponendo diversi sottoinsiemi di utenti a diverse versioni di prompt, misurandone oggettivamente le prestazioni e selezionando le più efficaci in base ai risultati. Inoltre, in entrambi i casi è importante basarsi su dati di performance per migliorare iterativamente i nostri template di prompt.
Una volta che il modello base è addestrato o sottoposto a fine-tuning e siamo soddisfatti del risultato, è il momento di effettuare il deployment. Nel contesto degli LLMOps, il deployment di un modello si riferisce al processo di rendere un modello linguistico disponibile in un ambiente di produzione. Questo comporta lo spostamento del modello fuori dall’ambiente di training e la sua integrazione nell’infrastruttura di produzione. Questo passaggio è indicato in arancione nel nostro solito diagramma:
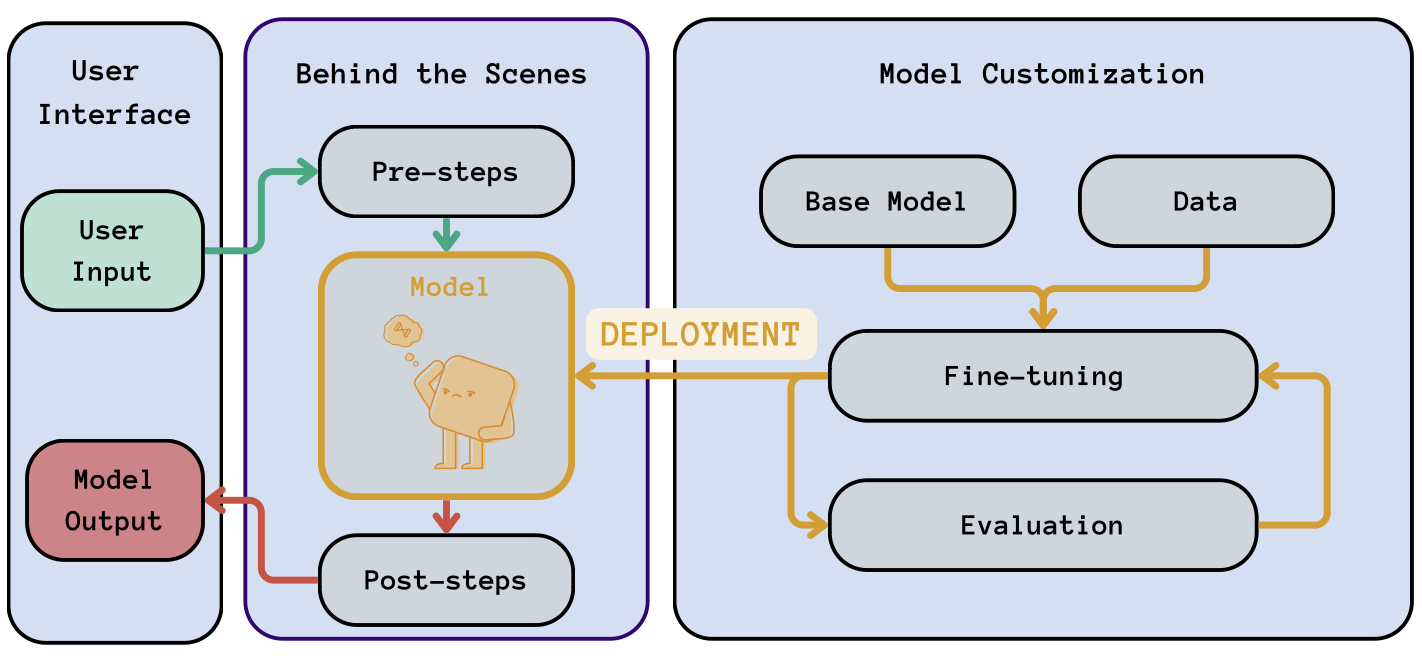
Flusso di lavoro LLMOps: evidenziare il passaggio di deployment (in arancione) nel nostro flusso generico. Questo passaggio comporta lo “spostamento” del modello dall’ambiente di sviluppo alla produzione.
Il deployment include anche la definizione dell’interfaccia che utilizzeremo per comunicare con il modello una volta in produzione. In genere, l’interfaccia dipende dalla nostra modalità di elaborazione:
Le API possono essere distribuite su server web o piattaforme cloud, assicurandone l’accessibilità per gli utenti o i sistemi che devono interagire con il modello. Il nostro setup LLMOps dovrebbe garantire che l’API possa gestire il carico previsto, con considerazioni su scaling, bilanciamento del carico e meccanismi di failover.
Per i casi d’uso batch, puoi programmare job periodici usando strumenti come cron (nei sistemi Unix-like) o servizi cloud di job scheduling. Questi job eseguiranno il modello sui nuovi dati agli intervalli specificati, elaboreranno i dati e archivieranno i risultati.
Infine, il deployment del modello nell’ambiente di produzione comporta normalmente il packaging del modello e il versioning:
Le pipeline di Continuous Integration (CI) e Continuous Delivery (CD) automatizzano i passaggi necessari per portare un modello dall’ambiente di sviluppo alla produzione, assicurando che il modello sia affidabile, aggiornato e distribuito in modo efficiente.
Negli LLMOps, quando vengono introdotti nuovo codice o modifiche al modello (come tuning degli iperparametri, cambiamenti nell’architettura o nuovi dati di training), la CI assicura che tali modifiche vengano testate automaticamente. Ciò include l’esecuzione di unit test, test di integrazione e altri controlli per verificare che le modifiche non rompano il modello o ne peggiorino le prestazioni. In questo senso, la CI è un modo di monitorare continuamente il nostro modello.
Una volta che le modifiche superano tutti i test nella fase di CI, la CD automatizza il deployment del modello nell’ambiente di produzione. Questo garantisce che la versione più stabile e testata del modello sia sempre in esecuzione nel setup LLMOps di produzione. La CD facilita anche rollback rapidi alle versioni precedenti se viene rilevato un problema in produzione, minimizzando i tempi di inattività e garantendo l’affidabilità del servizio.
Infine, c’è un aspetto mancante di cui non abbiamo ancora parlato: come ordiniamo i componenti LLMOps in modo da formare una catena di passaggi ragionevole?
L’orchestrazione implica definire e gestire l’ordine delle operazioni nel setup LLMOps, formando il cosiddetto workflow. Ad esempio, definire l’ordine dei passaggi di pre e post-processing o i diversi test che un nuovo modello deve superare prima di essere pronto per il deployment.
Nel contesto LLM, l’orchestrazione comporta normalmente il passaggio di dati tra diverse componenti del workflow. Questo è spesso gestito specificando percorsi di dati o workspace in cui l’output di un passaggio viene archiviato e poi prelevato dal successivo.
L’orchestrazione è spesso gestita tramite file di configurazione, solitamente scritti in YAML (Yet Another Markup Language). Questi file definiscono le componenti, il loro ordine e i parametri per ciascun passaggio del workflow. Nei file di configurazione si usano spesso Domain Specific Language (DSL) per fornire una sintassi più intuitiva e specializzata nella definizione dei workflow.
Infine, i workflow sono normalmente automatizzati. Ciò garantisce che, una volta avviato, tutti i passaggi correlati procedano senza intervento manuale, da uno step al successivo, riducendo la necessità di esecuzioni manuali per evitare problemi.
In questo articolo abbiamo discusso i componenti chiave di un’infrastruttura LLMOps e le loro ragioni d’essere. Tuttavia, altre tecniche avanzate possono migliorare le prestazioni della tua infrastruttura LLMOps:
Garantire la privacy dei dati e la protezione degli utenti nella nostra infrastruttura LLMOps è centrale per costruire un servizio affidabile.
Ad esempio, implementare solide tecniche di anonimizzazione dei dati è fondamentale. Tecniche come la privacy differenziale, la k-anonimity o il data masking possono essere usate per garantire che i dati di training non rivelino informazioni personali sensibili raccolte durante la creazione dei dataset di training. Inoltre, se intendiamo usare dati reali per migliorare iterativamente i nostri modelli, l’utente dovrebbe esserne consapevole e i suoi dati devono essere anonimizzati prima di essere incorporati nel ciclo di fine-tuning.
Un altro aspetto legato alla sicurezza riguarda l’eventuale archiviazione di informazioni private degli utenti nel nostro sistema, come la cronologia delle conversazioni in ChatGPT. In questo caso, dobbiamo assicurarci che tutti i dati siano gestiti in modo sicuro e in conformità con le normative sulla protezione dei dati come il GDPR. Ciò include garantire l’archiviazione sicura dei dati e la trasmissione crittografata nella nostra infrastruttura.
Infine, dobbiamo garantire robusti controlli di accesso nell’infrastruttura LLMOps, assicurando che solo persone autorizzate abbiano accesso al modello, ai dati e all’ambiente di training e che non vi siano fughe di informazioni che espongano dati personali degli utenti.
Le applicazioni basate su LLM sono in crescita dallo scorso anno, spinte dalle capacità migliorate delle iterazioni recenti degli LLM. Queste applicazioni offrono gli LLM as-a-service, richiedendo quindi un framework robusto per la loro gestione e ottimizzazione, noto come infrastruttura LLMOps.
In questo articolo, abbiamo esplorato il ruolo critico degli LLMOps come spina dorsale di un servizio LLM di successo, efficiente e orientato all’utente. Innanzitutto, abbiamo rivisto il percorso di un prompt dal momento in cui l’utente lo invia al modello fino alla ricezione della risposta. Gli LLMOps assicurano che tutti questi passaggi “dietro le quinte” siano snelli ed efficienti.
In secondo luogo, abbiamo esaminato come gli LLMOps comprendano training del modello, deployment, monitoraggio e manutenzione. Gli LLMOps includono anche lo scaling delle risorse per gestire in modo efficiente carichi variabili, garantendo così la scalabilità e l’affidabilità delle nostre applicazioni basate su LLM. Inoltre, abbiamo toccato best practice avanzate per affinare la nostra infrastruttura LLMOps.
Infine, abbiamo riconosciuto come gli LLMOps siano coinvolti anche nel mantenimento dell’integrità e della sicurezza degli LLM as-a-service. Poiché questi modelli spesso elaborano dati sensibili, pratiche LLMOps robuste sono essenziali per applicare rigorose misure di sicurezza, garantendo la privacy dei dati e la conformità agli standard normativi.
In conclusione, dopo aver letto questo articolo, spero di averti convinto di un aspetto importante: gli LLMOps non sono solo una necessità operativa, ma un asset strategico che aumenta il valore, l’affidabilità e la sostenibilità degli LLM as-a-service.
Pronto a mettere in pratica la teoria? Approfondisci il mondo dei Large Language Model con il nostro tutorial pratico: "How to Build LLM Applications with LangChain". Inizia oggi stesso a trasformare le tue conoscenze in competenze operative!
Inizia oggi il tuo percorso con gli LLM!
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



