Curso
Trabajar con la API de OpenAI
3 h
172.6K
Cuando interactuamos con ChatGPT como usuarios, simplemente escribimos un prompt en la interfaz web y pulsamos Intro. Normalmente, empezamos a recibir una respuesta en cuestión de segundos. Sin embargo, bajo esa experiencia fluida hay una cadena compleja y bien orquestada de pasos que hacen posible que ChatGPT funcione así.
La ejecución automática de esta cadena de pasos, conocida como operaciones con grandes modelos de lenguaje (LLMOps), garantiza no solo que el prompt llegue al modelo, sino que también se procese de forma eficiente, precisa y fiable. Así se asegura una respuesta bien redactada en un tiempo razonable.
En este artículo, profundizaremos en el paradigma de LLMOps siguiendo el recorrido de un prompt a través de un servicio de Large Language Model (LLM), como ChatGPT. Veremos las etapas clave, desde el preprocesamiento del prompt y la selección del modelo hasta la generación de la respuesta, y otros aspectos igual de vitales pero a menudo pasados por alto, como el balanceo de carga, el monitoreo y la integración continua.
LLMOps es una evolución de las conocidas operaciones de aprendizaje automático (MLOps), adaptada a los retos concretos que plantean los LLM. Mientras que MLOps se centra en la gestión del ciclo de vida de modelos de machine learning en general, LLMOps incorpora aspectos específicos de este tipo de modelos.
Es clave entender que, siempre que interactuamos con un modelo de OpenAI o Google —ya sea a través de una interfaz web o llamadas a su API desde nuestro código—, LLMOps es transparente para nosotros. En este escenario, decimos que estos modelos se ofrecen como servicio (as-a-service).
Por el contrario, si nuestro objetivo es ofrecer nuestro propio modelo para un caso de uso concreto sin depender de proveedores externos —por ejemplo, un asistente para los empleados de una empresa—, la responsabilidad de LLMOps recae en nosotros.
Independientemente de las capacidades de nuestro nuevo modelo, su éxito como servicio dependerá en gran medida de contar con una infraestructura de LLMOps sólida y fiable. Si te interesa saber más sobre MLOps, el tutorial MLOps Fundamentals es para ti.
Los primeros LLM, como GPT-2, se presentaron en 2018. Sin embargo, su popularidad ha crecido recientemente, sobre todo gracias a los avances significativos en las capacidades de sus versiones más nuevas, desde GPT-3 en adelante.
Han surgido múltiples aplicaciones que aprovechan los LLM debido a su impresionante capacidad: desde chatbots de atención al cliente y servicios de traducción hasta asistentes de escritura y programación, entre otros.
Crear aplicaciones listas para producción impulsadas por LLM plantea un conjunto de retos distintos a los de los modelos de ML tradicionales. Para afrontarlos, se han desarrollado herramientas y buenas prácticas novedosas para gestionar el ciclo de vida de aplicaciones con LLM, dando lugar al concepto de “LLMOps”.
LLMOps es esencial para gestionar de forma eficiente estos modelos complejos cuando se despliegan como servicio, por varios motivos:
1. Los LLM no solo son grandes por la cantidad de datos que manejan, sino también por su número de parámetros. LLMOps garantiza que la infraestructura soporte estos modelos en términos de almacenamiento y ancho de banda.
2. Para los usuarios, recibir una respuesta precisa en el menor tiempo es crucial. LLMOps asegura respuestas en un tiempo razonable, manteniendo la fluidez de interacciones casi humanas.
3. El monitoreo continuo en LLMOps no se limita a aspectos operativos o fallos de infraestructura. También implica un seguimiento cuidadoso del comportamiento del modelo para entender cómo decide y poder mejorarlo en iteraciones futuras.
4. Ejecutar LLM puede ser costoso por los recursos que requieren. LLMOps introduce estrategias rentables para aprovechar los recursos de forma óptima sin sacrificar rendimiento.
Para entender LLMOps, conviene conocer lo que ocurre “entre bambalinas” cuando se ofrecen LLM como servicio. Es decir, el camino que sigue un prompt desde que se envía al modelo hasta que se genera la respuesta. El siguiente esquema representa este flujo de trabajo:
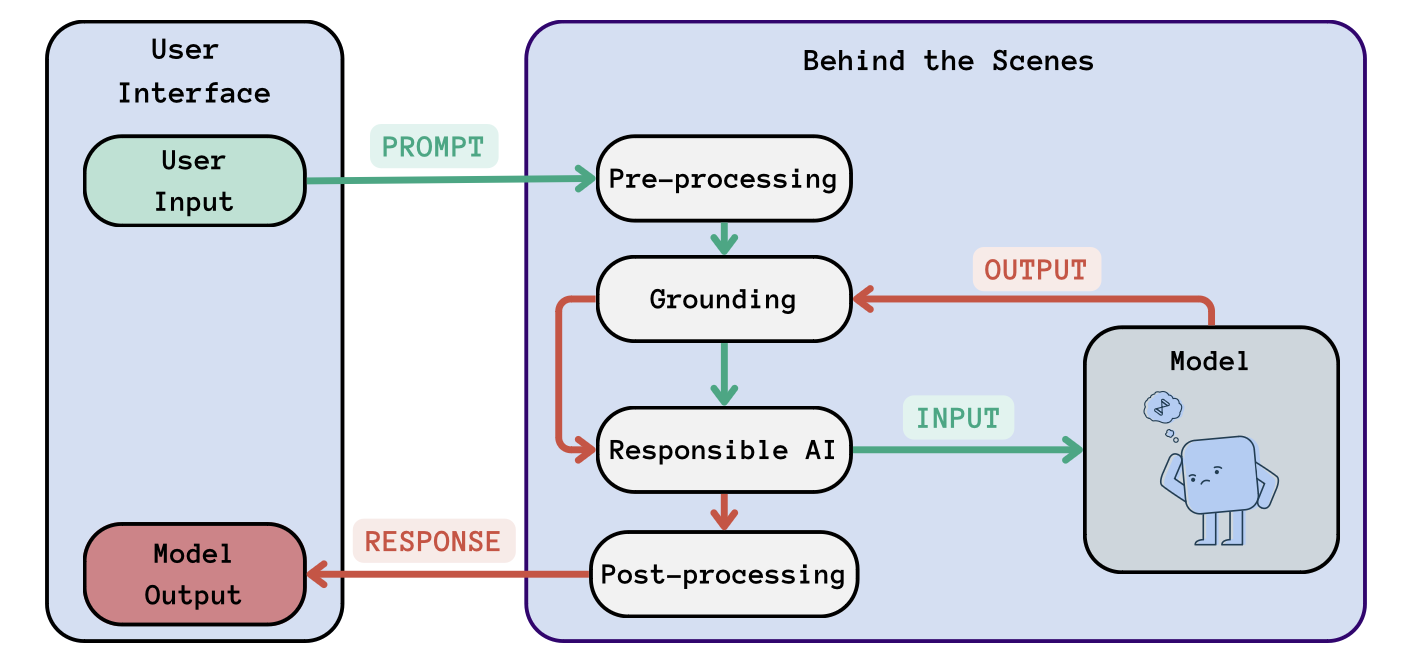
Flujo de LLMOps: los pasos entre bambalinas de un LLM genérico como servicio. La entrada del usuario (en verde) pasa por varios pasos antes de llegar al modelo. De forma similar, la salida del modelo (en rojo) se transforma varias veces antes de mostrarse al usuario.
Como vemos en el esquema, el prompt pasa por varias etapas antes de llegar al modelo. Aunque el número de pasos puede variar, hay algunos básicos para asegurar, por ejemplo, que la entrada se entiende claramente y que la respuesta del modelo es relevante en contexto. Desgranemos estos pasos:
Este paso prepara el prompt del usuario para que el modelo pueda entenderlo y procesarlo. Incluye la tokenización, donde el prompt se segmenta en unidades más pequeñas llamadas tokens. También conlleva la normalización de datos, que supone eliminar o transformar ruido (caracteres especiales), corregir erratas y estandarizar el texto.
Por último, durante la codificación, los tokens se convierten en una forma numérica que el modelo puede interpretar. Esto se hace usando embeddings, que representan cada token como un vector en un espacio de alta dimensión.
Consiste en contextualizar el prompt en función de turnos previos de la conversación o fuentes de conocimiento externas para asegurar que la respuesta del modelo sea coherente y adecuada al contexto. Además, el reconocimiento de entidades y su vinculación ayudan al sistema a identificar entidades (nombres, lugares, fechas) dentro del prompt y asociarlas con el contexto relevante.
Para asegurar un uso adecuado de los LLM, algunos servicios aplican controles de cordura sobre los prompts de usuario. Normalmente, se evalúan frente a directrices de seguridad y cumplimiento, especialmente en escenarios con información sensible, contenido inapropiado, sesgos o posible desinformación.
Solo tras estos pasos, el prompt se envía finalmente al modelo para su procesamiento. Después de que el modelo genera la respuesta, y antes de mostrarla al usuario, es posible que se repitan los pasos de Grounding y de IA responsable, además de un paso extra de posprocesado:
La respuesta generada por el modelo está en forma numérica por los embeddings vectoriales mencionados. Por tanto, es esencial un proceso de decodificación para convertir esos datos en texto legible. Tras la decodificación, un paso de refinado pule la respuesta en gramática, estilo o legibilidad.
Finalmente, la respuesta se muestra al usuario. La infraestructura de LLMOps se encarga de ejecutar estos pasos de manera transparente para él.
Hasta ahora hemos visto una buena cantidad de pasos que la infraestructura de LLMOps debe ejecutar desde que un usuario envía un prompt hasta que recibe la respuesta. Llegados a este punto, surge una pregunta razonable: ¿cuánto tardan todos estos pasos?
Al usar ChatGPT, el tiempo de respuesta suele ser casi inmediato. A este tiempo se le llama latencia. La latencia es un indicador crítico de rendimiento, sobre todo en aplicaciones de cara al usuario, donde el tiempo de respuesta afecta directamente a la experiencia. Elegir la latencia adecuada es crucial según el caso de uso.
Para reducir la latencia, LLMOps aplica varias estrategias y buenas prácticas que optimizan todo el proceso, desde recibir la entrada hasta entregar la respuesta. LLMOps contribuye a minimizar la latencia del modelo al ejecutar automáticamente todos los pasos necesarios y gestionar los recursos con eficiencia, evitando que haya cómputos esperando a recursos disponibles. Otras buenas prácticas que también reducen la latencia son:
Reducir la latencia no solo mejora la experiencia de usuario, sino que también ayuda a la eficiencia de costes al optimizar el uso de recursos.
Hasta ahora no hemos hablado de qué modelo debe estar presente en nuestro montaje de LLMOps. Hay distintos tipos de modelos, cada uno optimizado para casos de uso concretos, con diferentes tamaños, etc. Seleccionar el modelo adecuado es crucial y dependerá en gran medida de nuestra aplicación y de los recursos disponibles.
Además, parece que el número de LLM y de proveedores crece cada día. Por eso, tener una visión amplia de los distintos tipos de LLM y de sus proveedores es muy útil, especialmente para identificar el que mejor se adapte a nuestro caso.
Los modelos y proveedores de LLM pueden agruparse así:
Las principales ventajas de los modelos open source son la transparencia y la posibilidad de personalizarlos. Suelen ofrecer control total sobre los componentes, lo que facilita la depuración y la personalización extensiva mediante entrenamiento o fine-tuning. Este nivel de flexibilidad permite alinear mejor el LLM con tus necesidades específicas, en lugar de ajustarte a las opciones predeterminadas de un proveedor.
Sin embargo, gestionar LLM open source por tu cuenta puede acarrear desafíos de ingeniería y costes significativos en cómputo y almacenamiento. Incluso con una infraestructura mínima aportada por los modelos abiertos, suele ser difícil competir con los propietarios en latencia, rendimiento (throughput) y costes de inferencia.
Hay muchos modelos entre los que elegir. ¿Cómo nos aseguramos de escoger el LLM correcto?
Existen varios criterios a considerar según el caso de uso y nuestras posibilidades:
Tanto en modelos propietarios como en open source, a menudo es necesario el fine-tuning para adaptarlos de verdad a aplicaciones específicas.
Existen LLM ya afinados para ciertas tareas, como modelos de chat o especializados en resumen o análisis de sentimiento. Otra variante a considerar son los modelos de contexto largo. Los LLM modernos suelen manejar longitudes de contexto entre 2.000 y 8.000 tokens; entradas o salidas mayores no se procesan directamente. No obstante, algunos modelos ofrecen variantes de contexto largo. Por ejemplo, GPT-3.5 cuenta con una variante de 16k.
Aun así, si las opciones existentes no cumplen los requisitos, siempre es posible afinar o incluso entrenar un modelo desde cero. En este caso, la elección de un conjunto de datos adecuado es crucial para que el modelo entienda la naturaleza de la tarea objetivo.
Si te interesa entrenar un LLM desde cero, te recomiendo el tutorial de DataCamp How to train an LLM with PyTorch.
Si nuestra aplicación requiere afinar un modelo existente, esos pasos también deben formar parte de nuestro montaje de LLMOps. Añadamos esta fase de personalización a nuestro diagrama original:
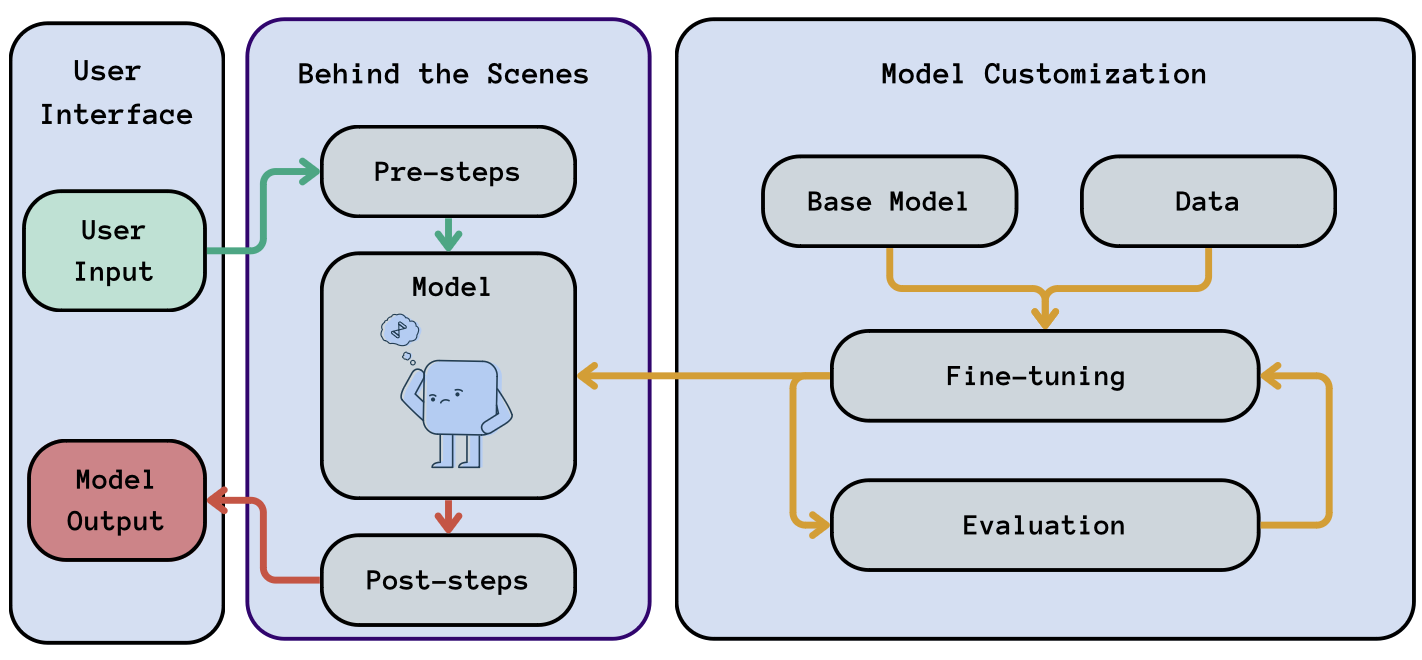
Flujo de LLMOps: inclusión de los pasos de personalización del modelo (en naranja) en nuestro flujo genérico.
Contar con una canalización de fine-tuning consistente te ayuda a ampliar el conocimiento del modelo a medida que dispones de más datos, y te permite actualizar la versión de tu LLM o introducir cambios sin fricciones.
Si dependemos de modelos de terceros, conviene tener en cuenta que pueden cambiar su disponibilidad o su coste. Esto puede obligarnos a cambiar de modelo base. Un montaje robusto de LLMOps nos permitirá gestionar esta situación crítica reemplazando la “caja” de Modelo por otro LLM.
Se podría pensar que afinar un LLM o entrenarlo desde cero queda fuera de la infraestructura de LLMOps, ya que el LLM operará una vez desplegado en producción. Sin embargo, no es así, especialmente por lo ya mencionado: un servicio exitoso necesitará mejoras del modelo y resiliencia ante cambios de proveedor, si hiciera falta.
Para un entrenamiento, fine-tuning o refinamiento efectivos en una infraestructura genérica de LLMOps, es importante mantener un formato de datos consistente entre el entrenamiento y la inferencia posterior. Para ello, solemos formatear los datos de entrenamiento en JSON Lines (.jsonl). Este formato es muy adecuado para el fine-tuning de LLM por su estructura, que permite procesar grandes conjuntos de datos con eficiencia. Un archivo típico .jsonl para fine-tuning podría ser así:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Cada línea de un .jsonl es un objeto JSON independiente que representa un ejemplo de entrenamiento, con las claves prompt y completion indicando el texto de entrada y la respuesta esperada del modelo, tal como esperaríamos en inferencia. Además, este formato facilita añadir nuevos datos de forma incremental a la base de conocimiento del modelo.
Los parámetros del modelo también son importantes al definir nuestra infraestructura de LLLMOps, ya que influyen en aspectos como el tamaño del modelo y el consumo de recursos.
En cuanto a los parámetros de entrenamiento, es importante optimizarlos para equilibrar la complejidad del modelo con limitaciones de despliegue como el uso de memoria. Esta optimización es clave para desplegar modelos en entornos diversos con capacidades de recursos variables y asegurar que no solo sean avanzados, sino también prácticos en aplicaciones reales.
Respecto a los parámetros de inferencia, ajustar valores como la temperatura y el máximo de tokens permite controlar la longitud y la aleatoriedad de las respuestas. Estas configuraciones se gestionan como parte del proceso de LLMOps para alinear la salida del modelo con los requisitos de la aplicación y la intención del usuario.
Las técnicas de prompt engineering han demostrado mejorar las capacidades por defecto de los LLM. Una razón es que ayudan a contextualizar el modelo: por ejemplo, indicándole que actúe como experto en un dominio concreto o guiándolo hacia un tipo de salida deseada. La ingeniería y gestión de prompts es un componente crucial que debe incluirse en nuestro montaje de LLMOps.
Entre las prácticas más eficaces están el few-shot prompting y el razonamiento en cadena (chain-of-thought). Veamos brevemente estas técnicas y cómo integrarlas en LLMOps:
Implementar técnicas como few-shot y razonamiento en cadena dentro de LLMOps puede lograrse eficazmente mediante plantillas de prompt.
Las plantillas de prompt son estructuras predefinidas que orientan el razonamiento de los LLM. Aportan consistencia, garantizan que peticiones similares se formulen de manera uniforme y permiten incluir técnicas de prompt engineering de forma transparente para el usuario.
Desarrollar y gestionar un repositorio de buenas plantillas para distintos casos de uso es clave en LLMOps. La selección de la plantilla adecuada para un caso concreto suele realizarse durante el preprocesamiento, antes de enviar la consulta al modelo.
Para few-shot prompting, las plantillas deben incluir varios ejemplos que muestren la tarea o el estilo de respuesta esperado. De forma similar, para incorporar razonamiento en cadena, las plantillas han de diseñarse con un proceso de pensamiento paso a paso. En esencia, deben guiar al modelo sobre cómo descomponer metódicamente un problema en partes más simples y manejables.
La incorporación de conocimiento de fuentes externas puede ser un paso dentro del razonamiento en cadena, especialmente útil en frameworks como LangChain, donde se instruye al modelo para recuperar información de internet si su base de conocimiento no es suficiente.
Tanto en few-shot como en razonamiento en cadena, aplicar pruebas A/B de prompts es muy recomendable. Consiste en realizar experimentos controlados mostrando a diferentes grupos de usuarios distintas versiones de prompts, medir su rendimiento de forma objetiva y escoger las más efectivas en base a los resultados. En ambos casos es importante apoyarse en datos de rendimiento para mejorar iterativamente las plantillas.
Cuando el modelo base está entrenado o afinado y el resultado nos convence, llega el momento de desplegarlo. En LLMOps, el despliegue es el proceso de poner un modelo de lenguaje a disposición en un entorno de producción. Supone sacarlo del entorno de entrenamiento e integrarlo en la infraestructura de producción. Este paso aparece en naranja en nuestro diagrama habitual:
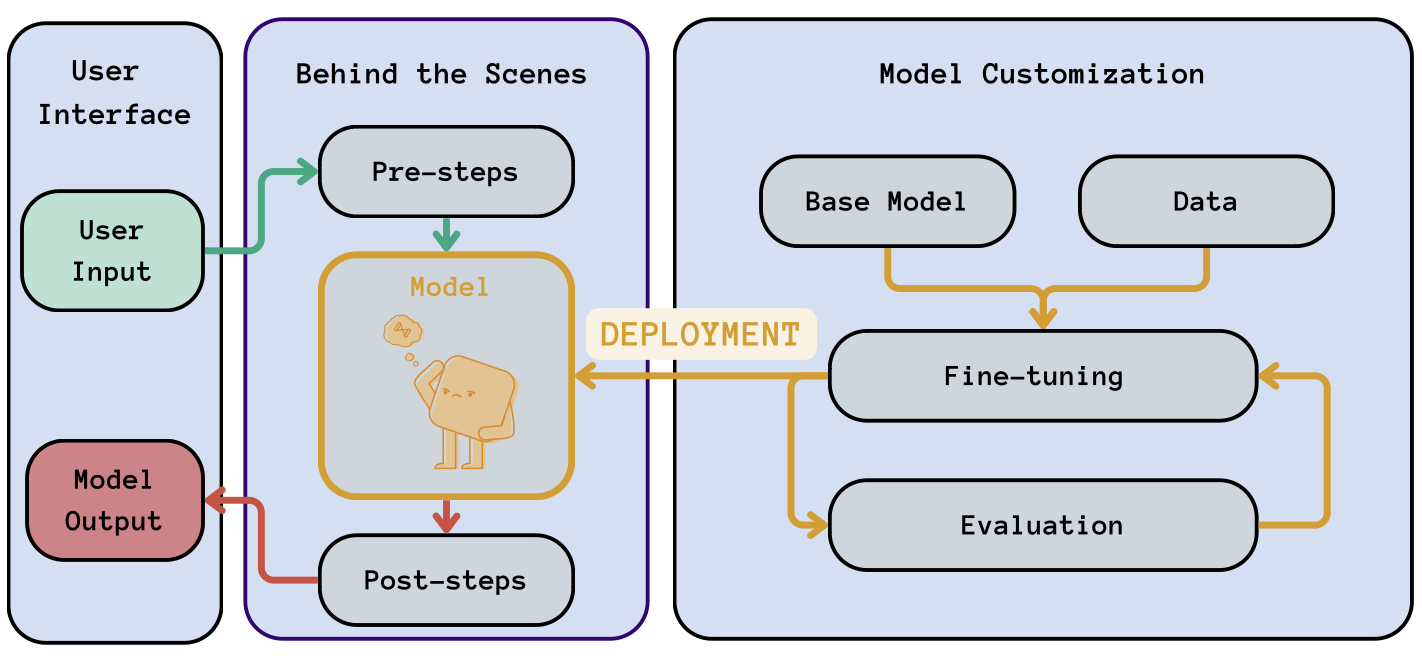
Flujo de LLMOps: resaltado del despliegue (en naranja) en el flujo genérico. Este paso implica “mover” el modelo del entorno de desarrollo a producción.
El despliegue también incluye definir la interfaz con la que nos comunicaremos con el modelo en producción. En general, la interfaz depende del modo de procesamiento:
Las APIs pueden desplegarse en servidores web o en plataformas cloud, garantizando su accesibilidad para usuarios o sistemas que necesiten interactuar con el modelo. Nuestro montaje de LLMOps debe asegurar que la API soporte la carga esperada, contemplando escalado, balanceo de carga y mecanismos de conmutación por error.
Para casos batch, puedes programar trabajos periódicos con herramientas como cron (en sistemas tipo Unix) o servicios de planificación en la nube. Estos trabajos ejecutarán el modelo con los datos nuevos en los intervalos establecidos, procesarán la información y almacenarán los resultados.
Por último, el despliegue en producción suele implicar empaquetado y versionado del modelo:
Las canalizaciones de integración continua (CI) y entrega continua (CD) automatizan los pasos necesarios para llevar un modelo del entorno de desarrollo a producción, garantizando fiabilidad, actualización y un despliegue eficiente.
En LLMOps, cuando se introduce nuevo código o cambios en el modelo (como ajuste de hiperparámetros, cambios de arquitectura o nuevos datos de entrenamiento), CI se encarga de probar automáticamente esos cambios. Esto incluye tests unitarios, de integración y otras comprobaciones para validar que no rompan el modelo ni degraden su rendimiento. En este sentido, CI es también una forma de monitorear continuamente nuestro modelo.
Una vez que los cambios superan todas las pruebas de CI, CD automatiza el despliegue del modelo en producción. Así nos aseguramos de que la versión más estable y probada esté siempre ejecutándose en el entorno de LLMOps. CD también facilita revertir rápidamente a versiones anteriores si se detecta un problema en producción, minimizando tiempos de inactividad y garantizando la fiabilidad del servicio.
Por último, falta un aspecto que no hemos comentado aún: ¿cómo ordenamos los componentes de LLMOps para formar una cadena de pasos coherente?
La orquestación consiste en definir y gestionar el orden de operaciones del montaje de LLMOps, formando el llamado flujo de trabajo. Por ejemplo, definir el orden de los pasos de pre y posprocesado o las distintas pruebas que debe superar un modelo nuevo antes de su despliegue.
En el contexto LLM, la orquestación suele implicar pasar datos entre distintos componentes del flujo. A menudo se gestiona especificando rutas de datos o espacios de trabajo donde se guarda la salida de un paso y la recoge el siguiente.
La orquestación se gestiona a menudo mediante archivos de configuración, normalmente en YAML (Yet Another Markup Language). Estos archivos definen los componentes, su orden y los parámetros de cada paso del flujo. También se usan lenguajes específicos de dominio (DSL) en estos archivos para proporcionar una sintaxis más intuitiva y especializada al definir los flujos.
Por último, los flujos suelen automatizarse. Así, una vez iniciado, todos los pasos relacionados se ejecutan sin intervención manual, de uno a otro, reduciendo el trabajo manual y evitando problemas.
En este artículo hemos visto los componentes clave de una infraestructura LLMOps y el porqué de cada uno. Aun así, hay técnicas avanzadas que pueden elevar el rendimiento de tu infraestructura:
Garantizar la privacidad de los datos y la protección del usuario en nuestra infraestructura de LLMOps es fundamental para construir un servicio fiable.
Por ejemplo, implementar sólidas técnicas de anonimización de datos es crítico. La privacidad diferencial, la k-anonimidad o el enmascaramiento pueden asegurar que los datos de entrenamiento no revelen información personal sensible recopilada al formar los conjuntos de entrenamiento. Además, si planeamos usar datos reales para mejorar iterativamente nuestros modelos, el usuario debe saberlo y sus datos deben anonimizarse antes de incorporarlos al ciclo de fine-tuning.
Otro aspecto de seguridad surge si planeamos almacenar información privada del usuario, como el historial de conversación en ChatGPT. En ese caso, debemos garantizar un manejo seguro y el cumplimiento de normativas como el RGPD, incluyendo almacenamiento seguro y transmisión cifrada en nuestra infraestructura.
Por último, debemos asegurar controles de acceso robustos en la infraestructura de LLMOps, garantizando que solo personas autorizadas accedan al modelo, los datos y el entorno de entrenamiento, evitando filtraciones de información personal.
Las aplicaciones impulsadas por LLM se han disparado desde el año pasado, gracias a las capacidades mejoradas de las últimas iteraciones. Estas aplicaciones entregan LLM como servicio, por lo que requieren un marco robusto para su gestión y optimización: la infraestructura de LLMOps.
En este artículo hemos explorado el papel crítico de LLMOps como columna vertebral de un servicio con LLM exitoso, eficiente y centrado en el usuario. Primero, hemos revisado el recorrido de un prompt desde que el usuario lo envía al modelo hasta que se recibe la respuesta. LLMOps garantiza que todos estos pasos “entre bambalinas” sean ágiles y eficientes.
Después, hemos visto cómo LLMOps abarca el entrenamiento, el despliegue, el monitoreo y el mantenimiento del modelo. También incluye el escalado de recursos para manejar cargas variables con eficiencia, asegurando la escalabilidad y la fiabilidad de nuestras aplicaciones basadas en LLM. Además, hemos mencionado buenas prácticas avanzadas para afinar nuestra infraestructura.
Por último, hemos reconocido que LLMOps también vela por la integridad y la seguridad de los LLM como servicio. Dado que a menudo procesan datos sensibles, unas prácticas sólidas de LLMOps son esenciales para aplicar medidas de seguridad estrictas, garantizando la privacidad y el cumplimiento normativo.
En definitiva, tras leer este artículo, espero haberte convencido de algo importante: LLMOps no es solo una necesidad operativa, sino un activo estratégico que potencia el valor, la fiabilidad y la sostenibilidad de los LLM como servicio.
¿Listo para pasar de la teoría a la práctica? Profundiza en el mundo de los grandes modelos de lenguaje con nuestro tutorial práctico: "How to Build LLM Applications with LangChain". ¡Empieza hoy mismo a convertir tu conocimiento en habilidades aplicables!
¡Empieza hoy tu camino con los LLM!
Curso
Curso
programa
blog
Stanislav Karzhev
9 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
11 min