

Khóa học
Làm việc với OpenAI API
3 giờ
184.5K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleKhi chúng ta, với tư cách người dùng, tương tác với ChatGPT, ta chỉ cần gõ một gợi ý vào giao diện web và nhấn Enter. Thông thường, ta sẽ bắt đầu nhận phản hồi trong vài giây. Tuy nhiên, ẩn sau tương tác mượt mà đó là một chuỗi bước phức tạp và có trật tự giúp ChatGPT mang lại trải nghiệm như vậy.
Việc tự động thực thi chuỗi bước này, được gọi là Vận hành Mô hình Ngôn ngữ Lớn (LLMOps), đảm bảo rằng gợi ý không chỉ đến được mô hình mà còn được xử lý hiệu quả, chính xác và ổn định. Nhờ đó, phản hồi được tạo ra chỉn chu trong một khung thời gian hợp lý.
Trong bài viết này, chúng ta sẽ đi sâu vào mô hình LLMOps bằng cách lần theo hành trình của một gợi ý qua một dịch vụ Mô hình Ngôn ngữ Lớn (LLM) như ChatGPT. Chúng ta sẽ xem xét các giai đoạn then chốt, bao gồm tiền xử lý gợi ý, lựa chọn mô hình, tạo phản hồi, và những khía cạnh thường bị bỏ qua nhưng quan trọng như cân bằng tải, giám sát và Tích hợp Liên tục.
LLMOps thực chất là một bước phát triển từ Vận hành Học máy (MLOps) vốn đã quen thuộc, được điều chỉnh để đáp ứng các thách thức cụ thể do LLM đặt ra. Trong khi MLOps tập trung vào quản trị vòng đời của các mô hình Học máy nói chung, LLMOps kết hợp các khía cạnh đặc thù gắn với loại mô hình này.
Điều quan trọng cần hiểu là bất cứ khi nào chúng ta tương tác với mô hình từ OpenAI hoặc Google, dù qua giao diện web hay gọi API từ mã của mình, LLMOps đều trong suốt đối với chúng ta. Trong bối cảnh đó, ta nói các mô hình này được cung cấp dưới dạng dịch vụ (as-a-service).
Ngược lại, nếu mục tiêu của chúng ta là cung cấp mô hình cho một trường hợp sử dụng cụ thể mà không phụ thuộc vào nhà cung cấp bên ngoài, chẳng hạn trợ lý cho nhân viên công ty, thì trách nhiệm về LLMOps sẽ thuộc về chúng ta.
Bất kể năng lực của mô hình mới ra sao, thành công của nó với tư cách dịch vụ sẽ phụ thuộc rất nhiều vào việc có một hạ tầng LLMOps vững chắc và đáng tin cậy. Nếu bạn quan tâm tìm hiểu thêm về MLOps, hãy xem hướng dẫn MLOps Fundamentals!
Những LLM đầu tiên như GPT-2 xuất hiện năm 2018. Tuy nhiên, chúng chỉ thực sự phổ biến gần đây, chủ yếu nhờ những tiến bộ vượt bậc trong năng lực của các phiên bản mới hơn, từ GPT-3 trở đi.
Nhiều ứng dụng tận dụng LLM đã ra đời nhờ năng lực ấn tượng của mô hình. Ví dụ gồm chatbot chăm sóc khách hàng, dịch ngôn ngữ, và trợ lý viết lách/lập trình, v.v.
Phát triển các ứng dụng sẵn sàng cho sản xuất dựa trên LLM mang đến một tập hợp thách thức riêng, khác với những gì gặp ở mô hình ML truyền thống. Để giải quyết, các công cụ và thực hành tốt mới đã được phát triển nhằm quản trị vòng đời ứng dụng LLM, dẫn đến khái niệm “LLMOps”.
LLMOps là thiết yếu để quản lý hiệu quả các mô hình phức tạp này khi triển khai dưới dạng dịch vụ, vì nhiều lý do:
1. LLM không chỉ lớn về lượng dữ liệu xử lý mà còn về số lượng tham số. LLMOps đảm bảo hạ tầng đủ sức hỗ trợ mô hình về lưu trữ và băng thông.
2. Nhận phản hồi chính xác trong thời gian tối thiểu là điều quan trọng với người dùng. LLMOps đảm bảo phản hồi được cung cấp trong thời gian hợp lý, duy trì sự liền mạch của tương tác giống con người.
3. Giám sát liên tục trong LLMOps không chỉ là theo dõi vận hành hay lỗi hạ tầng. Nó còn bao gồm theo dõi cẩn trọng hành vi của mô hình để hiểu quá trình ra quyết định và tiếp tục cải thiện mô hình ở các lần lặp sau.
4. Vận hành LLM có thể tốn kém do nhu cầu tài nguyên. LLMOps đưa ra các chiến lược tối ưu chi phí để đảm bảo sử dụng tài nguyên hiệu quả mà không đánh đổi hiệu năng.
Để hiểu LLMOps, điều quan trọng là nắm được “hậu trường” của LLM khi được cung cấp dưới dạng dịch vụ. Đó là con đường mà một gợi ý đi qua kể từ khi đưa vào mô hình cho đến khi phản hồi được tạo. Sơ đồ sau minh họa quy trình này:
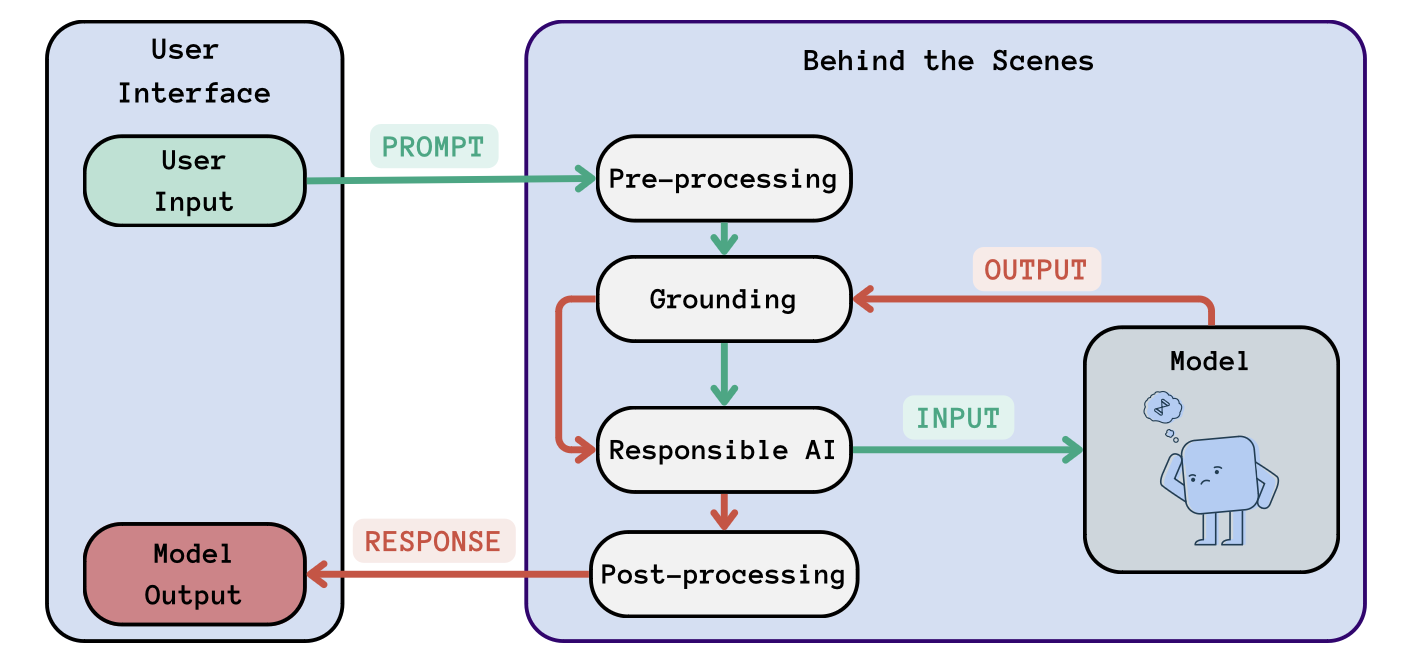
Quy trình LLMOps: Các bước hậu trường của một LLM dạng dịch vụ tổng quát. Đầu vào người dùng (màu xanh lá) trải qua một số bước trước khi đưa vào mô hình. Tương tự, đầu ra của mô hình (màu đỏ) trải qua nhiều biến đổi trước khi hiển thị cho người dùng.
Như ta thấy từ sơ đồ trên, gợi ý phải qua nhiều bước trước khi tới mô hình. Dù số bước có thể khác nhau, vẫn có những bước cơ bản để bảo đảm, chẳng hạn, đầu vào được hiểu rõ và phản hồi của mô hình phù hợp với ngữ cảnh. Hãy cùng phân rã các bước này:
Bước này chuẩn bị gợi ý của người dùng để mô hình có thể hiểu và xử lý. Bao gồm tách token, trong đó gợi ý được chia thành các đơn vị nhỏ hơn gọi là token. Bước này cũng gồm chuẩn hóa dữ liệu, như loại bỏ/biến đổi dữ liệu nhiễu (ký tự đặc biệt), sửa lỗi chính tả, và chuẩn hóa văn bản.
Cuối cùng, trong bước mã hóa, token được chuyển sang dạng số mà mô hình hiểu được. Việc này thực hiện bằng embedding, biểu diễn mỗi token thành một vector trong không gian nhiều chiều.
Bước này bối cảnh hóa gợi ý dựa trên các lượt hội thoại trước hoặc nguồn tri thức bên ngoài để đảm bảo phản hồi của mô hình mạch lạc và phù hợp ngữ cảnh. Bên cạnh đó, nhận dạng thực thể và liên kết giúp hệ thống nhận diện các thực thể (như tên riêng, địa điểm, ngày tháng) trong gợi ý và gắn chúng với ngữ cảnh liên quan.
Để đảm bảo việc sử dụng LLM vào mục đích tốt, một số dịch vụ triển khai kiểm tra hợp lý đối với gợi ý của người dùng. Thông thường, gợi ý được đánh giá theo các hướng dẫn về an toàn và tuân thủ, đặc biệt trong các tình huống liên quan thông tin nhạy cảm, nội dung không phù hợp, thiên lệch, hoặc nguy cơ sai lệch thông tin.
Chỉ sau các bước này, gợi ý mới được chuyển tới mô hình để xử lý. Sau khi mô hình tạo phản hồi, và trước khi hiển thị cho người dùng, phản hồi có thể lặp lại các bước về Grounding và AI có trách nhiệm, cũng như thêm một bước hậu xử lý:
Phản hồi do mô hình tạo ra ở dạng số do embedding vector đã nêu. Vì vậy, cần quá trình giải mã để chuyển dữ liệu số này trở lại văn bản mà con người đọc được. Sau giải mã, cần bước tinh chỉnh để trau chuốt phản hồi về ngữ pháp, phong cách, hoặc khả năng đọc.
Cuối cùng, phản hồi được hiển thị cho người dùng. Hạ tầng LLMOps chịu trách nhiệm thực thi các bước này một cách trong suốt với người dùng.
Đến lúc này, ta đã thấy khá nhiều bước mà hạ tầng LLMOps cần thực thi kể từ khi người dùng gửi gợi ý đến lúc họ nhận phản hồi. Một câu hỏi hợp lý là: Những bước này mất bao lâu?
Khi dùng ChatGPT, thời gian phản hồi thường gần như tức thì. Thời gian phản hồi này được gọi là độ trễ. Độ trễ là chỉ số hiệu năng quan trọng, nhất là ở ứng dụng hướng người dùng, nơi thời gian phản hồi ảnh hưởng lớn đến trải nghiệm. Lựa chọn độ trễ phù hợp là then chốt, tùy theo trường hợp sử dụng.
Để giảm độ trễ phản hồi, LLMOps áp dụng nhiều chiến lược và thực hành tốt nhằm tinh gọn toàn bộ quy trình từ nhận đầu vào đến trả phản hồi. LLMOps giúp giảm độ trễ của mô hình bằng cách tự động thực thi mọi bước cần thiết và quản trị tài nguyên hiệu quả để không có phép tính nào phải chờ tài nguyên. Một số thực hành tốt khác cũng giúp giảm độ trễ:
Giảm độ trễ không chỉ cải thiện trải nghiệm người dùng mà còn góp phần tăng hiệu quả chi phí bằng cách tối ưu hóa việc sử dụng tài nguyên.
Đến giờ, ta vẫn chưa bàn mô hình nào nên có trong thiết lập LLMOps. Có nhiều loại mô hình khác nhau, tối ưu cho các trường hợp dùng cụ thể, kích thước khác nhau, v.v. Việc chọn mô hình phù hợp là tối quan trọng và phụ thuộc lớn vào ứng dụng cùng tài nguyên sẵn có.
Bên cạnh đó, có vẻ số lượng LLM và nhà cung cấp đang tăng lên mỗi ngày. Vì vậy, có cái nhìn tổng quan về các loại LLM và nhà cung cấp là hữu ích, nhất là khi tìm mô hình phù hợp nhất với trường hợp sử dụng của chúng ta.
Mô hình và nhà cung cấp LLM có thể phân loại như sau:
Lợi ích chính của mô hình mã nguồn mở nằm ở tính minh bạch và khả năng tùy biến. Mô hình nguồn mở thường cho phép kiểm soát đầy đủ các thành phần, giúp gỡ lỗi dễ dàng và tùy biến sâu thông qua huấn luyện hoặc tinh chỉnh. Mức độ linh hoạt này cho phép điều chỉnh LLM khớp hơn với nhu cầu cụ thể của bạn, thay vì phải chấp nhận các tùy chọn định sẵn của nhà cung cấp LLM.
Tuy nhiên, tự quản lý LLM nguồn mở có thể dẫn đến thách thức kỹ thuật đáng kể và chi phí về tính toán/lưu trữ. Dù mô hình nguồn mở có thể cung cấp tối thiểu hạ tầng, thường khó cạnh tranh với mô hình độc quyền về độ trễ, thông lượng và chi phí suy luận.
Có rất nhiều mô hình để chọn. Vậy làm sao đảm bảo ta chọn đúng LLM?
Thực tế có một số tiêu chí tùy trường hợp sử dụng và khả năng của chúng ta:
Dù là độc quyền hay nguồn mở, LLM thường cần tinh chỉnh để thật sự phù hợp với ứng dụng cụ thể.
Một số LLM đã tinh chỉnh sẵn cho các tác vụ nhất định, phổ biến gồm mô hình trò chuyện và mô hình chuyên tóm tắt hoặc phân tích cảm xúc. Một biến thể khác cần cân nhắc là mô hình ngữ cảnh dài. LLM hiện đại thường xử lý độ dài ngữ cảnh từ 2.000 đến 8.000 token, nghĩa là đầu vào/ra vượt phạm vi này không thể xử lý trực tiếp. Tuy nhiên, một số mô hình có biến thể ngữ cảnh dài. Chẳng hạn, GPT-3.5 có biến thể ngữ cảnh lớn 16k.
Dẫu vậy, nếu các lựa chọn sẵn có không đáp ứng yêu cầu cụ thể, ta luôn có thể tinh chỉnh hoặc thậm chí tự huấn luyện mô hình. Khi đó, chọn bộ dữ liệu phù hợp là tối quan trọng, giúp mô hình hiểu bản chất tác vụ mục tiêu.
Nếu bạn muốn huấn luyện LLM từ đầu, tôi thực sự khuyên đọc hướng dẫn của DataCamp, How to train an LLM with PyTorch.
Nếu ứng dụng của chúng ta cần tinh chỉnh một mô hình sẵn có, các bước liên quan cũng nên là một phần trong thiết lập LLMOps. Hãy thêm bước tùy biến này vào sơ đồ ban đầu:
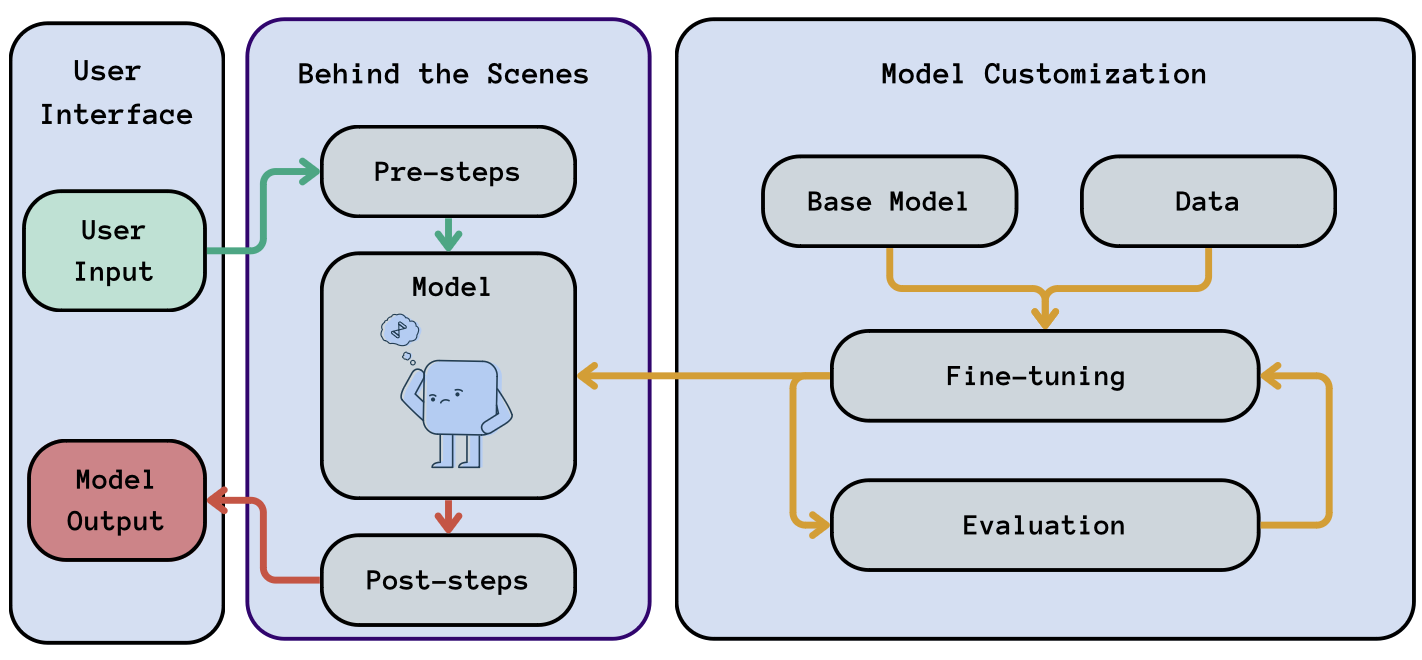
Quy trình LLMOps: Bổ sung các bước Tùy biến Mô hình (màu cam) vào quy trình tổng quát.
Có một đường ống tinh chỉnh nhất quán sẽ giúp bạn mở rộng tri thức của mô hình theo thời gian khi có thêm dữ liệu, cho phép nâng cấp phiên bản LLM hoặc thực hiện các thay đổi khác một cách dễ dàng.
Khi phụ thuộc vào mô hình bên thứ ba, cần lưu ý các mô hình này có thể thay đổi về mức độ sẵn có hoặc chi phí. Điều này có thể buộc ta chuyển sang mô hình nền khác. Một thiết lập LLMOps vững chắc sẽ cho phép xử lý tình huống quan trọng này trơn tru chỉ bằng cách thay thế ô “Model” bằng một LLM khác.
Có thể nghĩ rằng tinh chỉnh LLM hoặc huấn luyện từ đầu là bước nằm ngoài hạ tầng LLMOps vì LLM sẽ vận hành khi triển khai vào sản xuất. Tuy nhiên, không phải vậy, nhất là vì lý do đã nêu: một dịch vụ thành công sẽ cần cải tiến mô hình và đủ linh hoạt trước thay đổi nhà cung cấp khi cần.
Để huấn luyện, tinh chỉnh, hoặc tinh gọn mô hình hiệu quả trong hạ tầng LLMOps tổng quát, điều quan trọng là duy trì định dạng dữ liệu nhất quán giữa dữ liệu huấn luyện và dữ liệu suy luận về sau. Để làm vậy, ta thường định dạng dữ liệu huấn luyện theo JSON Lines (.jsonl). Định dạng này rất phù hợp để tinh chỉnh LLM nhờ cấu trúc cho phép xử lý hiệu quả các bộ dữ liệu lớn. Một tệp .jsonl điển hình cho tinh chỉnh có thể như sau:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Mỗi dòng trong tệp .jsonl là một đối tượng JSON riêng, biểu diễn một ví dụ huấn luyện, với khóa prompt và completion lần lượt chỉ định văn bản đầu vào và phản hồi kỳ vọng của mô hình, như ta mong đợi trong giai đoạn suy luận. Ngoài ra, định dạng này hỗ trợ bổ sung dần dần dữ liệu mới vào kho tri thức của mô hình.
Tham số mô hình cũng quan trọng khi thiết lập hạ tầng LLMOps vì chúng ảnh hưởng đến đặc tính như kích thước mô hình và mức tiêu thụ tài nguyên.
Về tham số huấn luyện, điều quan trọng là tối ưu để cân bằng độ phức tạp mô hình với các giới hạn triển khai như dung lượng bộ nhớ. Tối ưu này rất quan trọng để triển khai mô hình trên nhiều môi trường với khả năng tài nguyên khác nhau, đảm bảo mô hình không chỉ tiên tiến mà còn thực tế cho ứng dụng đời thực.
Về tham số suy luận, điều chỉnh các tham số như temperature và số token tối đa cho phép kiểm soát độ dài và tính ngẫu nhiên của phản hồi. Những thiết lập này được quản trị như một phần của quy trình LLMOps để đầu ra của mô hình phù hợp với yêu cầu ứng dụng và ý định người dùng.
Các kỹ thuật kỹ sư prompt đã cho thấy khả năng tăng cường năng lực mặc định của LLM. Một lý do là chúng giúp bối cảnh hóa mô hình. Ví dụ, hướng dẫn mô hình hành xử như một chuyên gia trong lĩnh vực cụ thể hoặc định hướng mô hình đến kiểu đầu ra mong muốn. Kỹ thuật và quản trị prompt là thành phần thiết yếu nên có trong thiết lập LLMOps.
Trong số các thực hành hiệu quả nhất có few-shot prompting và lập luận chuỗi suy nghĩ. Hãy điểm qua nhanh các kỹ thuật này và cách tích hợp vào LLMOps:
Triển khai các kỹ thuật như few-shot prompting và chuỗi suy nghĩ trong LLMOps có thể thực hiện hiệu quả thông qua các mẫu prompt.
Mẫu prompt là các cấu trúc định sẵn dùng để dẫn dắt lập luận của LLM. Chúng cung cấp cấu trúc nhất quán, đảm bảo những yêu cầu tương tự được đặt ra đồng đều hoặc giúp lồng ghép kỹ thuật prompt một cách trong suốt với người dùng.
Phát triển và quản lý một kho mẫu prompt được soạn thảo tốt cho nhiều trường hợp sử dụng là tối quan trọng trong LLMOps. Việc chọn mẫu prompt phù hợp cho trường hợp cụ thể thường là bước sơ bộ được thực hiện trong giai đoạn tiền xử lý trước khi gửi truy vấn tới mô hình.
Với few-shot prompting, các mẫu cần được thiết kế để bao gồm vài ví dụ minh họa tác vụ hoặc phong cách phản hồi kỳ vọng từ mô hình. Tương tự, để tích hợp chuỗi suy nghĩ, mẫu prompt cần được thiết kế tỉ mỉ để bao gồm quy trình suy nghĩ từng bước. Về bản chất, chúng nên hướng dẫn mô hình cách tiếp cận có phương pháp và phân rã bất kỳ bài toán nào thành các bước đơn giản, dễ xử lý hơn.
Việc tích hợp tri thức từ nguồn bên ngoài có thể là một bước trong chuỗi suy nghĩ, đặc biệt hữu ích trong các khung như LangChain, nơi mô hình được hướng dẫn truy xuất thông tin từ internet nếu kho tri thức sẵn có không đủ.
Trong cả few-shot prompting và chuỗi suy nghĩ, việc thử nghiệm A/B đối với prompt mang lại lợi ích lớn. Điều này bao gồm thực hiện thí nghiệm có kiểm soát bằng cách cho các nhóm người dùng khác nhau xem các phiên bản prompt khác nhau, đo lường khách quan hiệu quả của chúng và chọn ra phiên bản hiệu quả nhất dựa trên kết quả. Hơn nữa, ở cả hai trường hợp, điều quan trọng là dựa vào dữ liệu hiệu năng để cải tiến lặp lại các mẫu prompt.
Khi mô hình nền đã được huấn luyện hoặc tinh chỉnh và chúng ta hài lòng với kết quả, đã đến lúc triển khai mô hình. Triển khai mô hình trong bối cảnh LLMOps là quá trình đưa một mô hình ngôn ngữ vào sử dụng trong môi trường sản xuất. Điều này bao gồm đưa mô hình ra khỏi môi trường huấn luyện và tích hợp vào hạ tầng sản xuất. Bước này được tô màu cam trong sơ đồ quen thuộc của chúng ta:
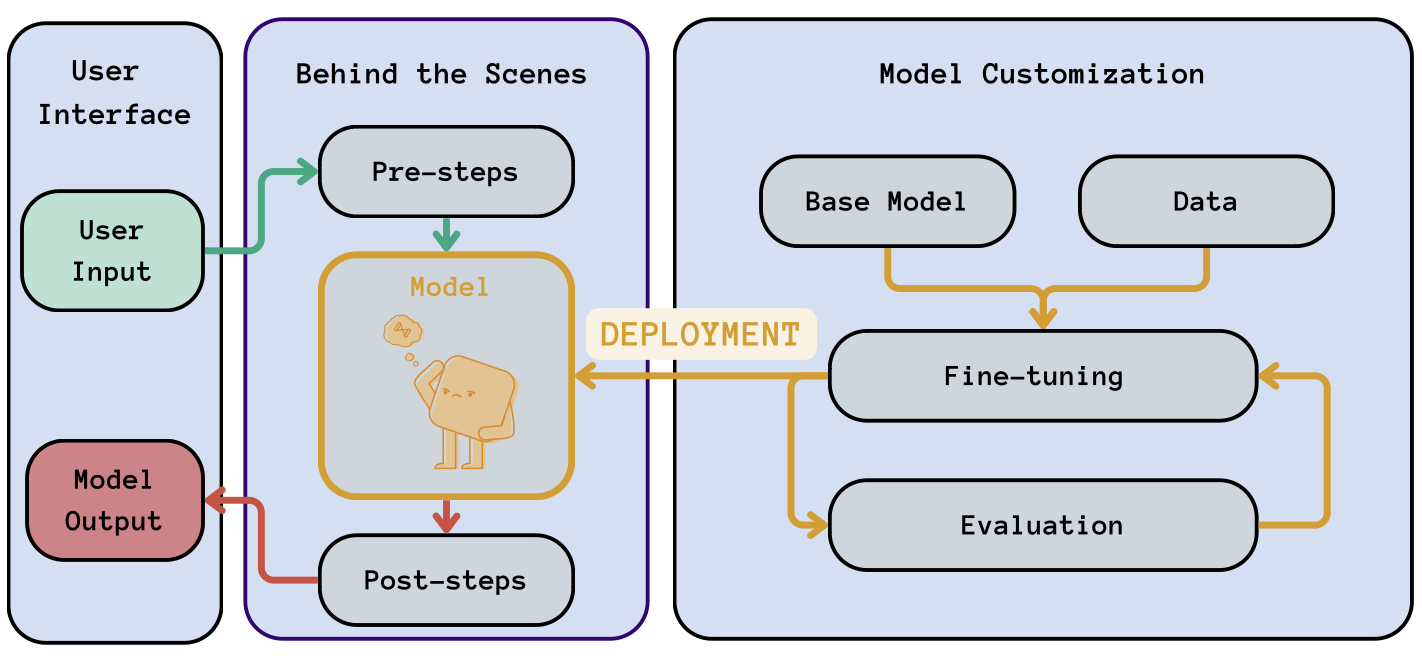
Quy trình LLMOps: Tô đậm bước triển khai (màu cam) trong quy trình tổng quát. Bước này liên quan đến việc “chuyển” mô hình từ môi trường phát triển sang sản xuất.
Triển khai cũng bao gồm thiết lập giao diện sẽ dùng để giao tiếp với mô hình khi ở sản xuất. Thông thường, giao diện phụ thuộc vào chế độ xử lý của chúng ta:
API có thể được triển khai trên máy chủ web hoặc nền tảng đám mây, đảm bảo khả năng truy cập cho người dùng hoặc hệ thống cần tương tác với mô hình. Thiết lập LLMOps của chúng ta phải đảm bảo API xử lý được tải dự kiến, có cân nhắc đến mở rộng, cân bằng tải và cơ chế chuyển đổi dự phòng.
Với các trường hợp theo lô, bạn có thể lập lịch các tác vụ theo lô bằng công cụ như cron (trên hệ thống dạng Unix) hoặc dịch vụ lập lịch công việc trên đám mây. Các tác vụ này sẽ chạy mô hình trên dữ liệu mới theo khoảng thời gian định sẵn, xử lý dữ liệu và lưu kết quả.
Cuối cùng, triển khai mô hình vào môi trường sản xuất thường bao gồm đóng gói và quản lý phiên bản mô hình:
Đường ống Tích hợp Liên tục (CI) và Phân phối Liên tục (CD) tự động hóa các bước đưa mô hình từ môi trường phát triển đến sản xuất, đảm bảo mô hình đáng tin cậy, cập nhật và được triển khai hiệu quả.
Trong LLMOps, khi có mã mới hoặc thay đổi đối với mô hình (như tinh chỉnh siêu tham số, thay đổi kiến trúc, hoặc dữ liệu huấn luyện mới), CI đảm bảo các thay đổi này được kiểm thử tự động. Bao gồm chạy unit test, integration test và các kiểm tra khác để xác nhận thay đổi không làm hỏng mô hình hoặc suy giảm hiệu năng. Ở nghĩa này, CI là cách giám sát liên tục mô hình của chúng ta.
Khi các thay đổi vượt qua toàn bộ kiểm thử ở giai đoạn CI, CD sẽ tự động triển khai mô hình vào môi trường sản xuất. Điều này đảm bảo phiên bản ổn định, đã kiểm thử kỹ lưỡng luôn chạy trong thiết lập LLMOps sản xuất. CD cũng tạo điều kiện hoàn nguyên nhanh về phiên bản trước nếu phát hiện sự cố trong sản xuất, giảm thiểu thời gian ngừng hoạt động và đảm bảo độ tin cậy của dịch vụ.
Cuối cùng, còn một khía cạnh chúng ta chưa bàn: làm thế nào sắp xếp các thành phần LLMOps để tạo thành chuỗi bước hợp lý?
Điều phối là định nghĩa và quản lý thứ tự thao tác trong thiết lập LLMOps, hình thành cái gọi là quy trình làm việc (workflow). Ví dụ, xác định thứ tự các bước tiền/hậu xử lý hoặc các kiểm thử mà một mô hình mới phải trải qua trước khi sẵn sàng triển khai.
Trong ngữ cảnh LLM, điều phối thường bao gồm truyền dữ liệu giữa các thành phần trong quy trình. Điều này thường được quản lý bằng cách chỉ định đường dẫn dữ liệu hoặc không gian làm việc nơi đầu ra của một bước được lưu và bước kế tiếp sẽ lấy lên.
Điều phối thường được quản lý qua tệp cấu hình, thường viết bằng YAML (Yet Another Markup Language). Các tệp này định nghĩa thành phần, thứ tự và tham số cho từng bước trong quy trình. Các Ngôn ngữ Miền chuyên biệt (DSL) thường được dùng trong các tệp cấu hình để cung cấp cú pháp trực quan và chuyên biệt hơn khi định nghĩa workflow.
Cuối cùng, các quy trình làm việc thường được tự động hóa. Điều đó đảm bảo khi quy trình được khởi động, mọi bước liên quan chạy trơn tru không cần can thiệp thủ công, từ bước này sang bước khác, từ đó giảm nhu cầu thực thi thủ công để tránh sự cố.
Trong bài viết này, chúng ta đã bàn về các thành phần chính của hạ tầng LLMOps và lý do tồn tại của chúng. Tuy vậy, còn có các kỹ thuật nâng cao khác có thể cải thiện hiệu năng hạ tầng LLMOps của bạn:
Đảm bảo quyền riêng tư dữ liệu và bảo vệ người dùng trong hạ tầng LLMOps là trọng tâm để xây dựng dịch vụ đáng tin cậy.
Chẳng hạn, triển khai các kỹ thuật ẩn danh dữ liệu mạnh mẽ là rất quan trọng. Các kỹ thuật như bảo mật vi sai, k-ẩn danh, hoặc che giấu dữ liệu có thể dùng để bảo đảm dữ liệu huấn luyện không làm lộ thông tin cá nhân nhạy cảm thu thập trong quá trình tạo bộ dữ liệu huấn luyện. Ngoài ra, nếu dự định dùng dữ liệu thế giới thực để cải thiện mô hình lặp lại, người dùng cần được biết và dữ liệu của họ phải được ẩn danh trước khi đưa vào vòng lặp tinh chỉnh.
Một khía cạnh khác về bảo mật là khi ta dự định lưu bất kỳ thông tin riêng tư nào của người dùng trong hệ thống, như lịch sử hội thoại trong ChatGPT. Khi đó, phải đảm bảo toàn bộ dữ liệu được xử lý an toàn và tuân thủ các quy định bảo vệ dữ liệu như GDPR. Điều này bao gồm đảm bảo lưu trữ an toàn và truyền dữ liệu được mã hóa trong hạ tầng.
Cuối cùng, chúng ta phải đảm bảo kiểm soát truy cập mạnh mẽ trong hạ tầng LLMOps, bảo đảm chỉ người được ủy quyền mới truy cập mô hình, dữ liệu và môi trường huấn luyện, và sẽ không có rò rỉ làm lộ thông tin cá nhân của người dùng.
Các ứng dụng vận hành bởi LLM đã tăng trưởng từ năm ngoái, được thúc đẩy bởi năng lực cải tiến của các phiên bản LLM gần đây. Những ứng dụng này cung cấp LLM dưới dạng dịch vụ, do đó đòi hỏi một khung quản trị và tối ưu hóa vững chắc, gọi là hạ tầng LLMOps.
Trong bài viết này, chúng ta đã khám phá vai trò then chốt của LLMOps như xương sống của một dịch vụ LLM thành công, hiệu quả và tập trung vào khách hàng. Trước hết, chúng ta đã điểm lại hành trình của một gợi ý từ khi người dùng gửi đến mô hình cho tới khi nhận phản hồi. LLMOps đảm bảo các bước “hậu trường” này được tinh gọn và hiệu quả.
Tiếp theo, chúng ta đã xem xét cách LLMOps bao trùm huấn luyện, triển khai, giám sát và bảo trì mô hình. LLMOps cũng bao gồm mở rộng tài nguyên để xử lý hiệu quả tải biến thiên, qua đó đảm bảo khả năng mở rộng và độ tin cậy của ứng dụng dựa trên LLM. Bên cạnh đó, chúng ta đã đề cập đến các thực hành nâng cao để tinh gọn hạ tầng LLMOps.
Cuối cùng, chúng ta ghi nhận LLMOps cũng tham gia duy trì tính toàn vẹn và bảo mật của LLM dưới dạng dịch vụ. Vì các mô hình này thường xử lý dữ liệu nhạy cảm, các thực hành LLMOps vững chắc là thiết yếu để áp dụng biện pháp bảo mật nghiêm ngặt, đảm bảo quyền riêng tư dữ liệu và tuân thủ các tiêu chuẩn pháp lý.
Tóm lại, sau khi đọc bài viết này, tôi hy vọng đã thuyết phục bạn về một điều quan trọng: LLMOps không chỉ là nhu cầu vận hành mà còn là tài sản chiến lược nâng cao giá trị, độ tin cậy và tính bền vững của LLM dưới dạng dịch vụ.
Sẵn sàng biến lý thuyết thành thực hành? Khám phá sâu hơn thế giới Mô hình Ngôn ngữ Lớn với hướng dẫn thực hành của chúng tôi: "Cách xây dựng ứng dụng LLM với LangChain". Bắt đầu chuyển hóa kiến thức thành kỹ năng có thể áp dụng ngay hôm nay!
Bắt đầu hành trình LLM của bạn ngay hôm nay!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
