Curso
Trabalhar com a API da OpenAI
3 h
172.6K
Quando nós, usuários, interagimos com o ChatGPT, simplesmente digitamos um prompt na interface web e apertamos Enter. Normalmente, começamos a receber uma resposta em poucos segundos. Mas, por trás dessa experiência fluida, existe uma série de etapas complexas e bem orquestradas que permitem ao ChatGPT entregar esse resultado.
A execução automática dessa sequência, conhecida como operações de modelos de linguagem grandes (LLMOps), garante que o prompt não só chegue ao modelo, como também seja processado de forma eficiente, precisa e confiável. Isso assegura a entrega de uma resposta bem elaborada em um tempo adequado.
Neste artigo, vamos mergulhar no paradigma de LLMOps acompanhando a jornada de um prompt por um serviço de Large Language Model (LLM), como o ChatGPT. Vamos analisar as etapas cruciais, incluindo pré-processamento do prompt, seleção do modelo, geração da resposta e aspectos muitas vezes ignorados, porém vitais, como balanceamento de carga, monitoramento e integração contínua.
LLMOps é uma evolução do conhecido Machine Learning Operations (MLOps), adaptada aos desafios específicos apresentados pelos LLMs. Enquanto o MLOps se concentra no gerenciamento do ciclo de vida de modelos de machine learning em geral, LLMOps incorpora aspectos exclusivos desses modelos.
É fundamental entender que, sempre que interagimos com um modelo da OpenAI ou do Google, seja via interface web ou por chamadas de API no nosso código, LLMOps é transparente para nós. Nesse cenário, dizemos que esses modelos são oferecidos as-a-service.
Por outro lado, se o objetivo é oferecer nosso próprio modelo para um caso de uso específico, sem depender de provedores externos — como um assistente para colaboradores de uma empresa —, a responsabilidade por LLMOps passa a ser nossa.
Independentemente das capacidades do nosso novo modelo, o sucesso como serviço vai depender muito da existência de uma infraestrutura de LLMOps robusta e confiável. Se você quer saber mais sobre MLOps, o tutorial MLOps Fundamentals é para você!
Os primeiros LLMs, como o GPT-2, foram apresentados em 2018. No entanto, eles se popularizaram mais recentemente, principalmente pelos grandes avanços nas capacidades das versões mais novas, do GPT-3 em diante.
Diversas aplicações alavancadas por LLMs surgiram graças às suas capacidades impressionantes. Exemplos incluem chatbots de atendimento ao cliente, serviços de tradução de idiomas e assistentes de escrita e de código, entre outros.
Desenvolver aplicações prontas para produção com LLMs traz um conjunto único de desafios, diferentes dos encontrados em modelos tradicionais de ML. Para enfrentá-los, novas ferramentas e boas práticas para gerenciar o ciclo de vida de aplicações com LLMs foram criadas, dando origem ao conceito de “LLMOps”.
LLMOps é essencial para gerenciar com eficiência esses modelos complexos quando implantados as-a-service, por vários motivos:
1. LLMs são grandes não só em volume de dados, mas também no número de parâmetros. LLMOps garante que a infraestrutura suporte esses modelos em termos de armazenamento e banda.
2. Receber uma resposta precisa no menor tempo possível é crucial para o usuário. LLMOps assegura que as respostas sejam entregues em tempo razoável, mantendo a fluidez de interações naturais.
3. O monitoramento contínuo em LLMOps não se limita a aspectos operacionais ou falhas de infraestrutura. Ele também envolve acompanhar o comportamento do modelo para entender seus processos de decisão e aprimorá-lo em futuras iterações.
4. Rodar LLMs pode ser caro pelos recursos necessários. LLMOps traz estratégias de otimização de custos para usar os recursos de forma ideal sem comprometer desempenho.
Para entender LLMOps, é importante conhecer os “bastidores” dos LLMs quando oferecidos as-a-service. É o caminho que um prompt percorre desde que é enviado ao modelo até a geração da resposta. O esquema a seguir representa esse fluxo:
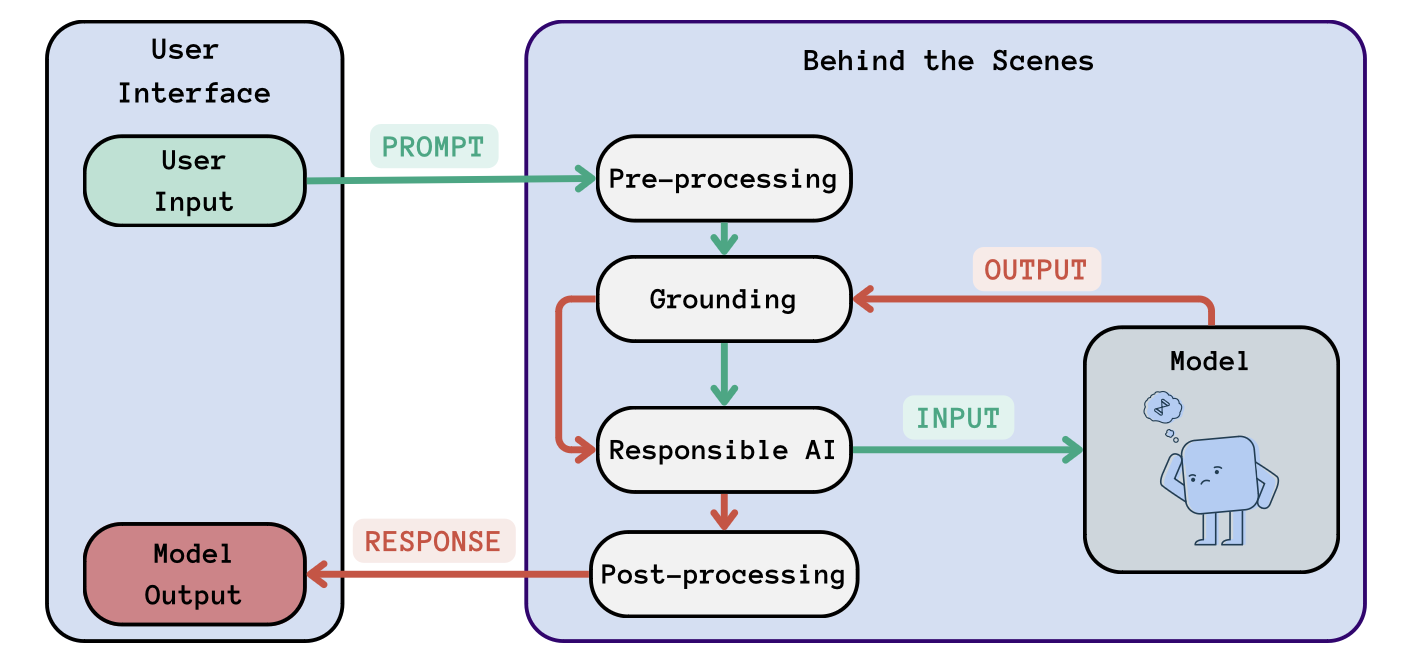
Fluxo de LLMOps: as etapas por trás dos bastidores de um LLM genérico as-a-service. A entrada do usuário (em verde) passa por algumas etapas antes de chegar ao modelo. Da mesma forma, a saída do modelo (em vermelho) sofre várias transformações antes de ser exibida ao usuário.
Como vemos no esquema acima, o prompt passa por várias etapas antes de chegar ao modelo. Embora o número de etapas possa variar, há passos básicos para garantir, por exemplo, que a entrada seja claramente entendida e que a resposta do modelo seja relevante no contexto. Vamos detalhar essas etapas:
Esta etapa prepara o prompt do usuário para que o modelo consiga entendê-lo e processá-lo. Inclui a tokenização, em que o prompt é segmentado em unidades menores chamadas tokens. Também envolve a normalização de dados, que inclui remover ou transformar ruídos, como caracteres especiais, corrigir erros de digitação e padronizar o texto.
Por fim, durante a codificação, os tokens são convertidos em uma forma numérica que o modelo entende. Isso é feito usando embeddings, que representam cada token como um vetor em um espaço de alta dimensionalidade.
Aqui ocorre a contextualização do prompt com base em turnos anteriores da conversa ou em fontes externas de conhecimento, garantindo que a resposta do modelo seja coerente e adequada ao contexto. Além disso, reconhecimento de entidades e linkagem ajudam o sistema a identificar entidades (como nomes, lugares e datas) no prompt e associá-las ao contexto relevante.
Para garantir que o uso de LLMs tenha bons propósitos, alguns serviços implementam verificações de sanidade nos prompts dos usuários. Normalmente, o prompt é avaliado segundo diretrizes de segurança e compliance, principalmente em cenários com informações sensíveis, conteúdo inadequado, vieses ou possível desinformação.
Só depois dessas etapas o prompt é finalmente encaminhado ao modelo para processamento. Após a geração da resposta e antes de exibi-la ao usuário, a resposta pode passar novamente por Grounding e IA responsável, além de uma etapa extra de pós-processamento:
A resposta gerada pelo modelo está em formato numérico por conta dos embeddings em vetor mencionados. Portanto, o decoding é essencial para converter esses dados numéricos em texto legível. Depois do decoding, uma etapa de refinamento é necessária para lapidar a resposta quanto a gramática, estilo e legibilidade.
Por fim, a resposta é exibida ao usuário. A infraestrutura de LLMOps é a responsável por executar essas etapas de forma transparente para quem usa.
Até aqui, vimos várias etapas que a infraestrutura de LLMOps precisa executar desde o momento em que um usuário envia um prompt até o recebimento da resposta. Neste ponto, é razoável perguntar: quanto tempo essas etapas levam?
Ao usar o ChatGPT, o tempo de resposta costuma ser quase imediato. Esse tempo é conhecido como latência. A latência é um indicador crítico de desempenho, especialmente em aplicações voltadas para o usuário, onde o tempo de resposta impacta diretamente a experiência. Escolher a latência adequada é crucial, dependendo do caso de uso.
Para reduzir a latência, LLMOps aplica diversas estratégias e boas práticas para agilizar todo o processo, da recepção da entrada à entrega da resposta. LLMOps ajuda a diminuir a latência do modelo executando automaticamente todas as etapas necessárias e gerenciando os recursos de maneira eficiente, evitando que cálculos fiquem esperando recursos. Outras boas práticas também reduzem latência:
Reduzir a latência não só melhora a experiência do usuário, como também contribui para a eficiência de custos ao otimizar o uso de recursos.
Até agora, não discutimos qual modelo deve estar presente no nosso setup de LLMOps. Existem diversos tipos de modelos disponíveis, cada um otimizado para casos de uso específicos, com diferentes tamanhos etc. Selecionar o modelo adequado é crucial e vai depender principalmente da aplicação e dos recursos disponíveis.
Além disso, o número de LLMs e provedores parece aumentar a cada dia. Por isso, ter uma visão ampla dos diferentes tipos de LLM e seus provedores é vantajoso, especialmente ao identificar qual se encaixa melhor no nosso caso de uso.
Modelos e provedores de LLM podem ser categorizados nos seguintes tipos:
Os principais benefícios dos modelos open source estão na transparência e na possibilidade de personalização. Normalmente, eles oferecem controle total sobre os componentes, permitindo depuração fácil e personalização ampla por meio de treinamento ou fine-tuning. Esse nível de flexibilidade permite alinhar melhor o LLM às suas necessidades específicas, em vez de se limitar às opções predefinidas do provedor.
No entanto, gerenciar LLMs open source por conta própria pode trazer desafios de engenharia significativos e custos com computação e armazenamento. Mesmo com alguma infraestrutura mínima disponível, muitas vezes é difícil competir com modelos proprietários em termos de latência, throughput e custos de inferência.
Há muitos modelos para escolher. Mas como garantir que estamos escolhendo o LLM certo?
De fato, existem alguns critérios a considerar, dependendo do caso de uso e das possibilidades:
Sejam proprietários ou open source, LLMs muitas vezes exigem fine-tuning para se adequarem de fato a aplicações específicas.
Existem LLMs pré-ajustados para certas tarefas, comumente incluindo modelos de chat e modelos especializados em sumarização ou análise de sentimento. Outra variante a considerar são os modelos de contexto longo. LLMs modernos normalmente lidam com contextos de 2.000 a 8.000 tokens, ou seja, entradas e saídas além desse intervalo não podem ser processadas diretamente. Contudo, alguns modelos oferecem variantes de contexto estendido. Por exemplo, o GPT-3.5 tem uma variante com contexto de 16k.
Ainda assim, se as opções existentes não atenderem a requisitos específicos, sempre há a possibilidade de fazer fine-tuning ou até treinar um modelo do zero. Nesse caso, escolher um dataset adequado é crucial, pois permite que o modelo entenda a natureza da tarefa-alvo.
Se você tem interesse em treinar um LLM do zero, recomendo o tutorial da DataCamp, How to train an LLM with PyTorch.
Se nossa aplicação exige fine-tuning de um modelo existente, as etapas relacionadas também devem fazer parte do nosso setup de LLMOps. Vamos adicionar essa etapa de customização ao nosso diagrama original:
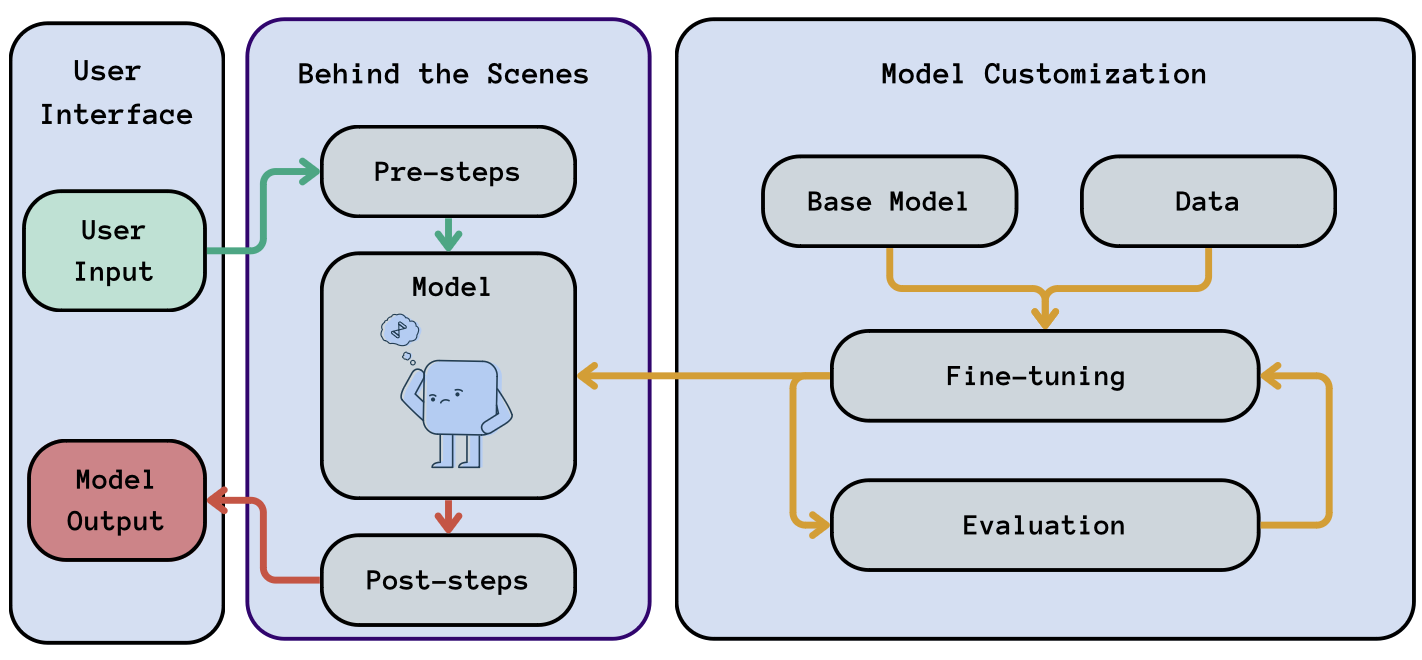
Fluxo de LLMOps: incluindo as etapas de customização do modelo (em laranja) no nosso fluxo genérico.
Ter um pipeline de fine-tuning consistente ajuda você a expandir o conhecimento do modelo ao longo do tempo, conforme mais dados ficam disponíveis, permitindo atualizar a versão do LLM ou fazer outras modificações com facilidade.
Ao depender de modelos de terceiros, é importante notar que eles podem mudar quanto à disponibilidade e ao custo. Isso pode nos forçar a migrar para outro modelo base. Um setup de LLMOps robusto permitirá lidar com essa situação crítica de forma tranquila, trocando apenas a “caixa” de “Model” por um LLM diferente.
Pode parecer que fazer o fine-tuning do seu LLM ou treiná-lo do zero seja um primeiro passo fora da infraestrutura de LLMOps, já que o LLM vai operar depois do deploy. No entanto, isso não é verdade, especialmente pelo motivo já citado: um serviço bem-sucedido vai precisar de melhorias no modelo e deve ser resiliente a mudanças de provedores, se necessário.
Para treinar, ajustar ou refinar modelos de forma eficaz em uma infraestrutura genérica de LLMOps, é importante manter o formato dos dados consistente entre o treinamento e a inferência posterior. Para isso, normalmente formatamos os dados de treinamento em JSON Lines (.jsonl). Esse formato é muito adequado para fine-tuning de LLMs por sua estrutura, permitindo processar grandes volumes de dados com eficiência. Um arquivo .jsonl típico para fine-tuning pode ser assim:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
Cada linha no arquivo .jsonl é um objeto JSON distinto, representando um exemplo de treino, com as chaves prompt e completion indicando o texto de entrada e a resposta esperada do modelo, respectivamente — exatamente como esperamos na inferência. Além disso, esse formato facilita a adição incremental de novos dados à base de conhecimento do modelo.
Parâmetros do modelo também são importantes ao definir nossa infraestrutura de LLMOps, pois impactam características como tamanho do modelo e consumo de recursos.
Sobre parâmetros de treinamento, é importante otimizá-los para equilibrar a complexidade do modelo com limitações de deploy, como uso de memória. Essa otimização é crucial para implantar modelos em ambientes diversos, com capacidades de recursos diferentes, garantindo que os modelos não sejam apenas avançados, mas também práticos para aplicações reais.
Quanto aos parâmetros de inferência, ajustar configurações como temperatura e número máximo de tokens permite controlar o comprimento e a aleatoriedade das respostas. Esses ajustes são gerenciados como parte de LLMOps para alinhar a saída do modelo com os requisitos da aplicação e a intenção do usuário.
Técnicas de engenharia de prompts têm mostrado melhoria nas capacidades padrão dos LLMs. Um dos motivos é ajudar na contextualização do modelo — por exemplo, instruindo-o a agir como especialista em um domínio específico ou guiando-o em direção ao formato de saída desejado. Engenharia e gestão de prompts são componentes essenciais no nosso setup de LLMOps.
Entre as práticas mais eficazes estão o few-shot prompting e o chain-of-thought reasoning. Vamos revisá-las rapidamente e discutir como integrá-las ao nosso LLMOps:
Implementar técnicas como few-shot prompting e chain-of-thought reasoning no nosso setup de LLMOps pode ser feito de forma eficaz com o uso de templates de prompt.
Templates de prompt são estruturas predefinidas usadas para orientar o raciocínio dos LLMs. Eles fornecem consistência, garantindo que solicitações semelhantes sejam feitas de forma uniforme, além de ajudar a incluir técnicas de engenharia de prompt de forma transparente para o usuário.
Desenvolver e gerenciar um repositório de templates de prompt bem elaborados para vários casos de uso é crucial em LLMOps. A seleção do template adequado para um caso específico geralmente é uma etapa preliminar realizada durante o pré-processamento, antes de enviar a consulta ao modelo.
Para few-shot prompting, os templates devem incluir vários exemplos que ilustrem a tarefa ou o estilo de resposta esperado do modelo. Da mesma forma, para incorporar chain-of-thought, os templates precisam ser cuidadosamente desenhados para incluir um processo de pensamento passo a passo. Em essência, eles devem guiar o modelo sobre como abordar metodicamente qualquer problema, decompondo-o em etapas mais simples e gerenciáveis.
Incorporar conhecimento de fontes externas pode ser um passo dentro do chain-of-thought, especialmente útil em frameworks como o LangChain, em que o modelo é instruído a recuperar informações da internet se sua base de conhecimento não for suficiente.
Tanto em few-shot prompting quanto em chain-of-thought reasoning, realizar testes A/B de prompts é altamente benéfico. Isso envolve conduzir experimentos controlados, expondo subconjuntos de usuários a versões diferentes de prompts, medindo objetivamente o desempenho e selecionando as mais eficazes. Além disso, em ambos os casos, é importante confiar em dados de performance para aprimorar os templates de forma iterativa.
Quando o modelo base está treinado ou ajustado e estamos satisfeitos com o resultado, é hora de fazer o deploy. No contexto de LLMOps, deploy é o processo de disponibilizar um modelo de linguagem para uso em produção. Isso envolve tirar o modelo do ambiente de treinamento e integrá-lo à infraestrutura de produção. Essa etapa está indicada em laranja no nosso diagrama:
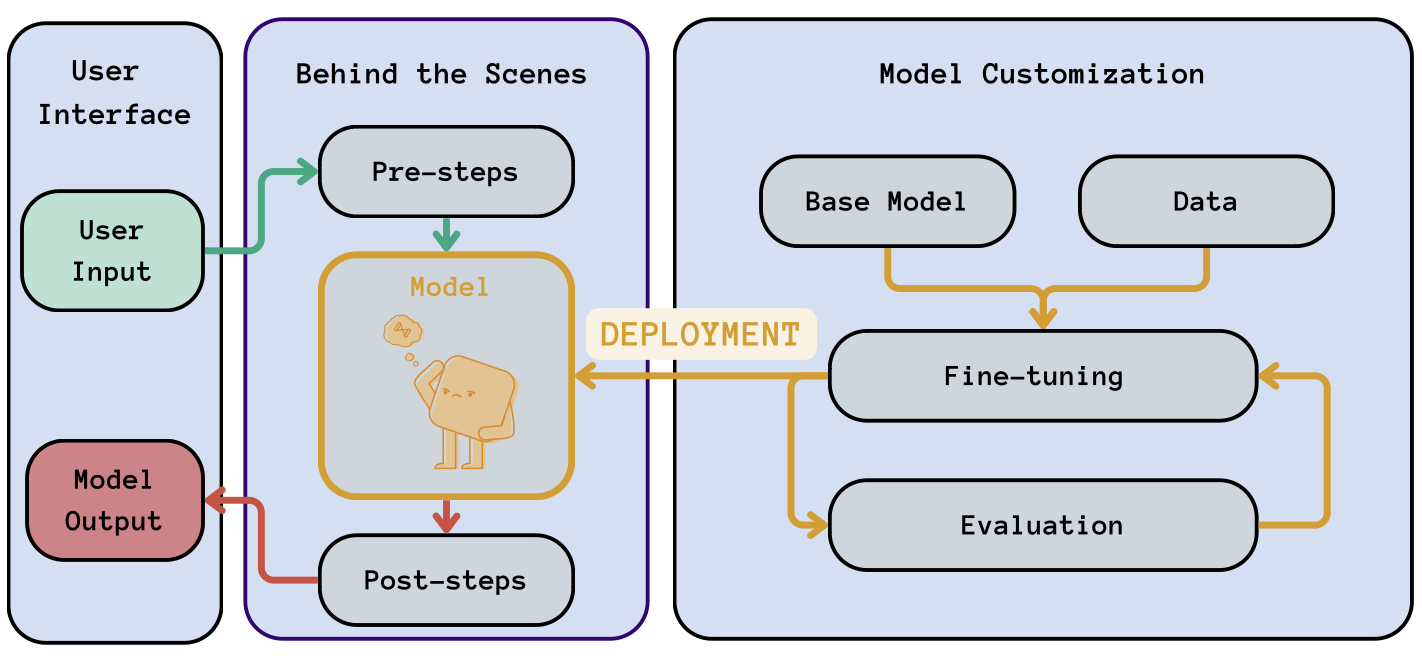
Fluxo de LLMOps: destacando a etapa de deploy (em laranja) no nosso fluxo genérico. Essa etapa envolve “mover” o modelo do ambiente de desenvolvimento para produção.
O deploy também inclui definir a interface que será usada para se comunicar com o modelo em produção. Em geral, a interface depende do nosso modo de processamento:
As APIs podem ser implantadas em servidores web ou plataformas em nuvem, garantindo acesso para usuários ou sistemas que precisem interagir com o modelo. Nosso setup de LLMOps deve assegurar que a API suporte a carga esperada, considerando escalabilidade, balanceamento de carga e mecanismos de failover.
Para cenários em lote, você pode agendar jobs usando ferramentas como cron (em sistemas tipo Unix) ou serviços de agendamento na nuvem. Esses jobs vão rodar o modelo nos novos dados nos intervalos definidos, processar as entradas e armazenar os resultados.
Por fim, fazer o deploy em produção normalmente envolve empacotamento e versionamento do modelo:
Pipelines de integração contínua (CI) e entrega contínua (CD) automatizam as etapas para levar um modelo do ambiente de desenvolvimento à produção, garantindo que ele seja confiável, atualizado e implantado com eficiência.
Em LLMOps, à medida que novo código ou mudanças são introduzidos no modelo (como ajuste de hiperparâmetros, alterações de arquitetura ou novos dados de treino), a CI garante que essas mudanças sejam testadas automaticamente. Isso inclui testes unitários, de integração e outras verificações para validar que as mudanças não quebrem o modelo nem degradem seu desempenho. Nesse sentido, CI é uma forma de monitorar continuamente nosso modelo.
Depois que as mudanças passam em todos os testes da fase de CI, a CD automatiza o deploy do modelo em produção. Isso assegura que a versão mais estável e testada esteja sempre rodando no setup de LLMOps. A CD também facilita o rollback rápido para versões anteriores caso algum problema seja detectado em produção, minimizando indisponibilidades e garantindo a confiabilidade do serviço.
Por fim, falta comentar um aspecto: como ordenar os componentes de LLMOps para formar uma cadeia de etapas coerente?
Orquestração é definir e gerenciar a ordem das operações no setup de LLMOps, formando o chamado workflow. Por exemplo, definir a ordem das etapas de pré e pós-processamento ou os diferentes testes que um novo modelo deve cumprir até estar pronto para o deploy.
No contexto de LLMs, orquestração normalmente envolve passar dados entre os diferentes componentes do fluxo. Isso costuma ser gerenciado especificando caminhos de dados ou workspaces onde a saída de uma etapa é armazenada e consumida pela etapa seguinte.
A orquestração costuma ser gerenciada por meio de arquivos de configuração, geralmente em YAML (Yet Another Markup Language). Esses arquivos definem os componentes, sua ordem e os parâmetros de cada etapa do workflow. Linguagens de domínio específico (DSLs) são frequentemente usadas nesses arquivos para oferecer uma sintaxe mais intuitiva e especializada.
Por fim, os workflows normalmente são automatizados. Isso garante que, uma vez iniciados, todos os passos relacionados rodem sem intervenção manual, de uma etapa à outra, reduzindo retrabalho e evitando problemas.
Neste artigo, discutimos os componentes-chave de uma infraestrutura de LLMOps e seus porquês. Ainda assim, outras técnicas avançadas podem turbinar o desempenho da sua infraestrutura:
Garantir privacidade de dados e proteção do usuário na nossa infraestrutura de LLMOps é central para construir um serviço confiável.
Por exemplo, implementar técnicas robustas de anonimização de dados é fundamental. Técnicas como privacidade diferencial, k-anonimato ou mascaramento de dados podem ser usadas para garantir que os dados de treinamento não revelem informações pessoais sensíveis coletadas na formação dos datasets. Além disso, se planejamos usar dados reais para melhorar os modelos de forma iterativa, o usuário deve estar ciente e seus dados precisam ser anonimizados antes de entrar no ciclo de fine-tuning.
Outro ponto de segurança surge se planejamos armazenar informações privadas do usuário no sistema, como o histórico de conversas no ChatGPT. Nesse caso, devemos garantir que todos os dados sejam tratados com segurança e em conformidade com regulações como a GDPR. Isso inclui armazenamento seguro e transmissão criptografada de dados na infraestrutura.
Por fim, precisamos garantir controles de acesso robustos na infraestrutura de LLMOps, assegurando que apenas pessoas autorizadas tenham acesso ao modelo, aos dados e ao ambiente de treinamento — e que não haja vazamentos de informações pessoais dos usuários.
Aplicações baseadas em LLMs vêm crescendo desde o ano passado, impulsionadas pelas capacidades ampliadas das versões mais recentes. Essas aplicações entregam LLMs as-a-service, exigindo uma estrutura robusta para gestão e otimização: a infraestrutura de LLMOps.
Neste artigo, exploramos o papel crítico de LLMOps como a espinha dorsal de um serviço de LLM bem-sucedido, eficiente e centrado no cliente. Primeiro, revisamos a jornada de um prompt desde o envio pelo usuário até o recebimento da resposta. LLMOps garante que todas essas etapas “nos bastidores” sejam ágeis e eficientes.
Em seguida, vimos como LLMOps abrange treinamento, deploy, monitoramento e manutenção do modelo. LLMOps também inclui o escalonamento de recursos para lidar com variações de carga com eficiência, garantindo escalabilidade e confiabilidade das aplicações baseadas em LLM. Além disso, abordamos boas práticas avançadas para refinar nossa infraestrutura.
Por fim, destacamos como LLMOps também preserva a integridade e a segurança dos LLMs as-a-service. Como esses modelos frequentemente processam dados sensíveis, práticas robustas de LLMOps são essenciais para aplicar medidas rigorosas de segurança, garantindo privacidade e conformidade regulatória.
Em resumo, após a leitura, espero ter convencido você de um ponto importante: LLMOps não é apenas uma necessidade operacional — é um ativo estratégico que eleva o valor, a confiabilidade e a sustentabilidade dos LLMs as-a-service.
Pronto para colocar a teoria em prática? Aprofunde-se no universo dos Large Language Models com nosso tutorial mão na massa: "How to Build LLM Applications with LangChain". Comece hoje mesmo a transformar conhecimento em habilidade aplicada!
Comece sua jornada em LLM hoje!
Curso
Curso
Programa
blog
Stanislav Karzhev
9 min
blog
Nisha Arya Ahmed
12 min
blog
Abid Ali Awan
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
12 min



