
Kurs
OpenAI API ile Çalışmak
3 sa
179.5K
Kullanıcı olarak ChatGPT ile etkileşime geçtiğimizde, web arayüzüne bir komut (prompt) yazıp enter tuşuna basarız. Genellikle birkaç saniye içinde yanıt almaya başlarız. Ancak bu sorunsuz etkileşimin altında, ChatGPT'nin bu deneyimi sunmasını sağlayan karmaşık ve düzenli bir adımlar dizisi yatar.
Büyük Dil Modeli Operasyonları (LLMOps) olarak bilinen bu adımlar dizisinin otomatik yürütülmesi, komutun yalnızca modele ulaşmasını değil, aynı zamanda verimli, doğru ve güvenilir bir şekilde işlenmesini de garanti eder. Bu sayede makul bir sürede özenle hazırlanmış bir yanıt sunulur.
Bu yazıda, ChatGPT gibi bir Büyük Dil Modeli (LLM) hizmetinde bir komutun yolculuğunu izleyerek LLMOps paradigmasına dalacağız. Komut ön işleme, model seçimi, yanıt üretimi gibi kritik aşamaların yanı sıra genellikle göz ardı edilen ancak hayati öneme sahip yük dengeleme, izleme ve Sürekli Entegrasyon gibi unsurları da inceleyeceğiz.
LLMOps, LLM'lerin ortaya çıkardığı somut zorluklara uyarlanmış, iyi bilinen Makine Öğrenimi Operasyonlarının (MLOps) bir evrimidir. MLOps genel Makine Öğrenimi modellerinin yaşam döngüsü yönetimine odaklanırken, LLMOps bu modellere özgü yönleri içerir.
OpenAI veya Google'dan bir modelle etkileşime geçtiğimiz her seferinde, ister web arayüzü üzerinden ister kodumuzdan yaptığımız API çağrılarıyla olsun, LLMOps'un bize şeffaf olduğunu anlamak önemlidir. Bu senaryoda, bu modellerin hizmet olarak sunulduğunu söyleriz.
Öte yandan, amacımız bir şirket çalışanlarına yönelik bir asistan gibi belirli bir kullanım durumu için modelimizi harici sağlayıcılara bağımlı olmadan sunmaksa, LLMOps sorumluluğu bize düşer.
Yeni modelimizin yetenekleri ne olursa olsun, bir hizmet olarak başarısı büyük ölçüde sağlam ve güvenilir bir LLMOps altyapısının varlığına bağlı olacaktır. MLOps hakkında daha fazla bilgi edinmekle ilgileniyorsanız, MLOps Fundamentals öğreticisi sizin için!
GPT-2 gibi erken dönem LLM'ler 2018'de tanıtıldı. Ancak bu modellerin GPT-3 ve sonrasındaki yeni sürümlerinin yeteneklerinde kaydedilen önemli ilerlemeler nedeniyle son dönemde popülerlik kazandılar.
LLM'lerden yararlanan çok sayıda uygulama, etkileyici model yetenekleri sayesinde ortaya çıktı. Örneklere müşteri hizmetleri sohbet botları, dil çeviri hizmetleri ve yazma ile kodlama asistanları dâhildir.
LLM'ler tarafından desteklenen, üretime hazır uygulamalar geliştirmek, geleneksel ML modellerinde karşılaşılanlardan farklı benzersiz bir dizi zorluk sunar. Bu zorlukları ele almak için, LLM uygulaması yaşam döngüsünü yönetmeye yönelik yeni araçlar ve en iyi uygulamalar geliştirildi ve “LLMOps” kavramı ortaya çıktı.
LLMOps, hizmet olarak dağıtıldıklarında bu karmaşık modelleri verimli bir şekilde yönetmek için birçok nedenle gereklidir:
1. LLM'ler yalnızca işledikleri veri miktarı açısından değil, aynı zamanda parametre sayıları açısından da büyüktür. LLMOps, altyapının bu modelleri depolama ve bant genişliği açısından destekleyebilmesini sağlar.
2. Kullanıcılar için minimum sürede doğru bir yanıt almak kritik önemdedir. LLMOps, yanıtlara makul sürede ulaşılmasını sağlayarak insan benzeri etkileşimlerin akıcılığını korur.
3. LLMOps kapsamındaki sürekli izleme, yalnızca operasyonel yönleri veya altyapıdaki aksaklıkları takip etmekle sınırlı değildir. Aynı zamanda modelin davranışını dikkatle takip etmeyi, karar verme süreçlerini anlamayı ve gelecekteki yinelemelerde modeli daha da iyileştirmeyi de içerir.
4. LLM'leri çalıştırmak, ihtiyaç duydukları kaynaklar nedeniyle pahalı olabilir. LLMOps, performanstan ödün vermeden kaynakların en iyi şekilde kullanılmasını sağlamak için maliyet etkin stratejiler sunar.
LLMOps'u anlamak için, LLM'lerin hizmet olarak sunulduğunda “perde arkasına” aşina olmak önemlidir. Yani bir komutun modele verildikten sonra yanıt üretilene kadar izlediği yol. Aşağıdaki şema bu iş akışını temsil eder:
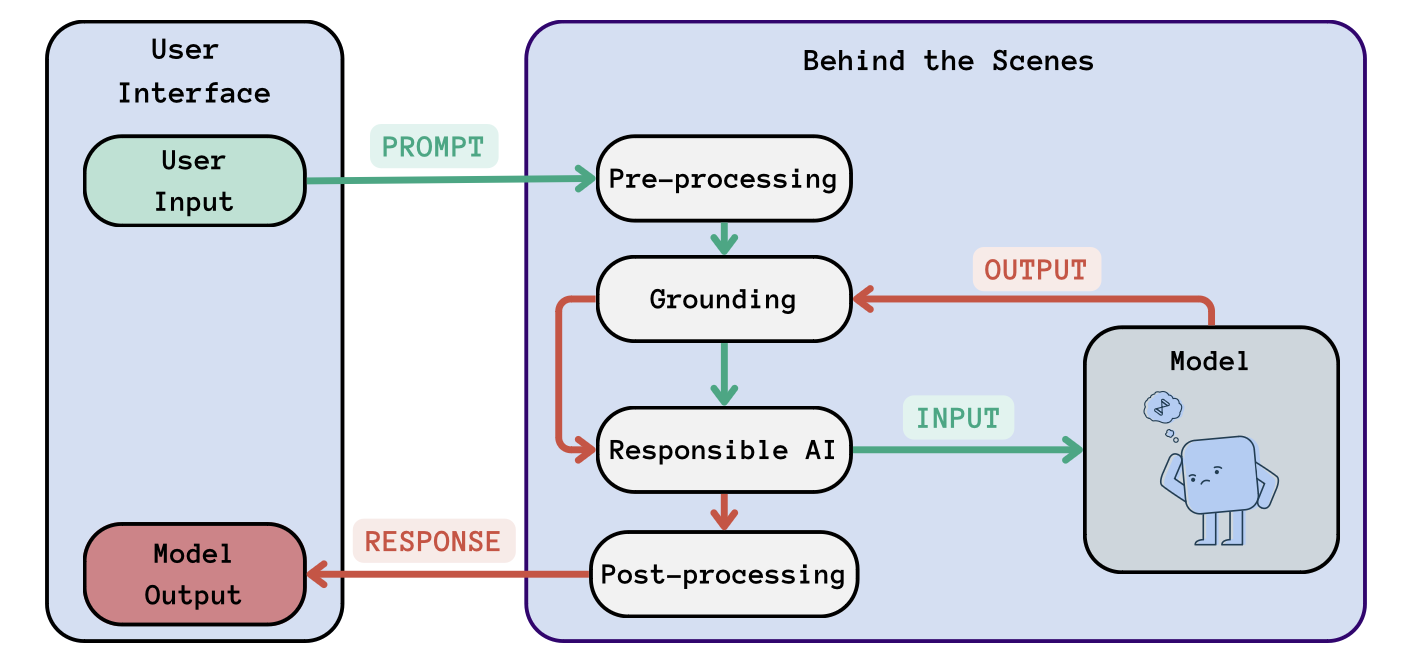
LLMOps iş akışı: Genel bir LLM'nin hizmet olarak perde arkasındaki adımları. Kullanıcı girdisi (yeşil), modele verilmeden önce bazı adımlardan geçer. Benzer şekilde, model çıktısı (kırmızı) kullanıcıya gösterilmeden önce birkaç dönüşümden geçer.
Yukarıdaki şemadan gördüğümüz üzere, komut modele ulaşmadan önce birkaç adımdan geçer. Adım sayısı değişebilse de, örneğin girdinin net anlaşılmasını ve modelin yanıtının bağlamsal olarak uygun olmasını sağlamak için temel adımlar vardır. Bu adımları inceleyelim:
Bu adım, modelin kullanıcı komutunu anlayıp işlemesini sağlamak için hazırlanmasını içerir. Komutun tokenizasyonu, yani token adı verilen daha küçük birimlere bölünmesi de buna dâhildir. Bu adım ayrıca özel karakterlerin kaldırılması veya dönüştürülmesi, yazım hatalarının düzeltilmesi ve metnin standardize edilmesi gibi veri normalizasyonunu içerir.
Son olarak, kodlama sırasında token'lar modelin anlayabileceği sayısal bir biçime dönüştürülür. Bu, her token'ı yüksek boyutlu bir uzayda bir vektör olarak temsil eden gömlemeler (embeddings) kullanılarak yapılır.
Bu, modelin yanıtının tutarlı ve bağlamsal olarak uygun olmasını sağlamak için komutun önceki konuşma turları veya harici bilgi kaynakları temelinde bağlamlandırılmasını içerir. Ek olarak, varlık tanıma ve bağlama, komuttaki varlıkların (isimler, yerler, tarihler gibi) belirlenmesine ve ilgili bağlamla ilişkilendirilmesine yardımcı olur.
LLM'lerin iyi amaçlarla kullanımını sağlamak için bazı hizmetler, kullanıcının komutlarında makuliyet kontrolleri uygular. Genellikle komut, özellikle hassas bilgiler, uygunsuz içerik, önyargı veya olası yanlış bilgi içeren senaryolarda güvenlik ve uyumluluk yönergelerine göre değerlendirilir.
Bu adımlardan sonra komut nihayet işlenmek üzere modele iletilir. Model yanıtı ürettikten ve kullanıcıya gösterilmeden önce, yanıt yine Zeminleme ve Sorumlu Yapay Zekâ adımlarından ve ayrıca bir ek son işleme adımından geçebilir:
Model tarafından üretilen yanıt, daha önce bahsedilen vektör gömlemeleri nedeniyle sayısal biçimdedir. Bu nedenle, bu sayısal veriyi tekrar insan tarafından okunabilir metne dönüştürmek için bir kod çözme süreci gereklidir. Kod çözmeyi takiben, yanıtın dil bilgisi, üslup veya okunabilirlik açısından cilalanması için bir iyileştirme adımı gerekir.
Son olarak, yanıt kullanıcıya gösterilir. LLMOps altyapısı bu adımları kullanıcıya şeffaf şekilde yürütmekten sorumludur.
Şu ana kadar, bir kullanıcının komutu göndermesinden yanıtı almasına kadar LLMOps altyapısının yürütmesi gereken epeyce adım gördük. Bu noktada akla makul bir soru gelebilir: Bu adımlar ne kadar zaman alır?
ChatGPT kullanırken yanıt süresi genellikle neredeyse anlıktır. Bu yanıt süresine gecikme denir. Gecikme, özellikle yanıt süresinin kullanıcı deneyimini önemli ölçüde etkilediği, kullanıcıya dönük uygulamalarda kritik bir performans ölçütüdür. Uygun gecikmeyi seçmek, kullanım durumumuza bağlı olarak hayati önem taşır.
Yanıt gecikmesini azaltmaya gelince, LLMOps girişin alınmasından yanıtın teslimine kadar tüm süreci yalınlaştırmak için çeşitli stratejiler ve en iyi uygulamalar kullanır. LLMOps, gerekli tüm adımları otomatik olarak yürüterek ve ihtiyaç duyulan kaynakları verimli şekilde yöneterek, hiçbir hesaplamanın çalışmak için kaynak beklememesini sağlayarak model gecikmesini azaltmaya katkıda bulunur. Diğer en iyi uygulamalar da gecikmeyi azaltabilir:
Gecikmeyi azaltmak yalnızca kullanıcı deneyimini iyileştirmekle kalmaz, aynı zamanda kaynak kullanımını optimize ederek maliyet etkinliğine de katkıda bulunur.
Bu noktaya kadar LLMOps kurulumumuzda hangi modelin bulunması gerektiğini tartışmadık. Belirli kullanım durumları için optimize edilmiş, farklı boyut seçeneklerine sahip çeşitli model türleri mevcuttur. Uygun modeli seçmek kritik önemdedir ve büyük ölçüde uygulamamıza ve mevcut kaynaklarımıza bağlı olacaktır.
Ayrıca, LLM'lerin ve sağlayıcıların sayısının her gün arttığı görülüyor. Bu nedenle, özellikle kullanım durumumuza en uygun olanı belirlemeye çalışırken, farklı LLM türleri ve sağlayıcıları hakkında geniş bir anlayışa sahip olmak faydalıdır.
LLM modelleri ve sağlayıcıları aşağıdaki türlere ayrılabilir:
Açık kaynaklı modellerin temel faydaları şeffaflık ve özelleştirme olanağında yatar. Açık kaynaklı modeller genellikle tüm bileşenler üzerinde tam kontrol sunarak kolay hata ayıklama ve eğitim veya ince ayar yoluyla kapsamlı özelleştirmeye olanak tanır. Bu esneklik derecesi, LLM'i sağlayıcının önceden tanımladığı seçeneklere uydurmaya kıyasla, özel ihtiyaçlarınıza daha iyi uyum sağlamayı mümkün kılar.
Bununla birlikte, açık kaynaklı LLM'leri kendi başınıza yönetmek, bilişim ve depolama ile ilgili önemli mühendislik zorluklarına ve maliyetlere yol açabilir. Açık kaynaklı modeller tarafından asgari bir altyapı sağlansa bile, gecikme, iş hacmi (throughput) ve çıkarım maliyetleri açısından tescilli modellerle rekabet etmek genellikle zordur.
Seçilebilecek çok sayıda model var. Peki doğru LLM'i seçtiğimizden nasıl emin oluruz?
Gerçekten de, kullanım durumumuza ve imkânlarımıza bağlı olarak dikkate alınması gereken bazı kriterler vardır:
İster tescilli ister açık kaynak olsun, LLM'ler genellikle belirli uygulamalar için gerçekten uygun hâle gelmeleri amacıyla ince ayar gerektirir.
Önceden ince ayarı yapılmış LLM'ler, sohbet modelleri ve özetleme veya duygu analizi konusunda uzmanlaşmış modeller gibi belirli kullanıcı görevleri için mevcuttur. Dikkate alınması gereken bir diğer varyant ise uzun bağlamlı modellerdir. Modern LLM'ler tipik olarak 2.000 ila 8.000 token arası bağlam uzunluklarını idare eder; bu aralığın ötesindeki giriş ve çıkışlar doğrudan işlenemez. Ancak bazı modeller uzun bağlamlı varyantlar sunar. Örneğin GPT-3.5'in daha büyük, 16k bağlam boyutlu bir varyantı vardır.
Yine de, mevcut seçenekler belirli gereksinimleri karşılamıyorsa, her zaman bir modele ince ayar yapma veya hatta modeli kendimiz eğitme olanağı vardır. Bu durumda, hedeflenen görevin doğasını modelin anlayabilmesini sağladığı için uygun bir veri kümesi seçmek kritik önemdedir.
Sıfırdan bir LLM modeli eğitmekle ilgileniyorsanız, DataCamp öğreticisi How to train an LLM with PyTorch'u okumanızı gerçekten öneririm.
Uygulamamız mevcut bir modele ince ayar gerektiriyorsa, ilgili adımlar da LLMOps kurulumumuzun bir parçası olmalıdır. Bu özelleştirme adımını orijinal diyagramımıza ekleyelim:
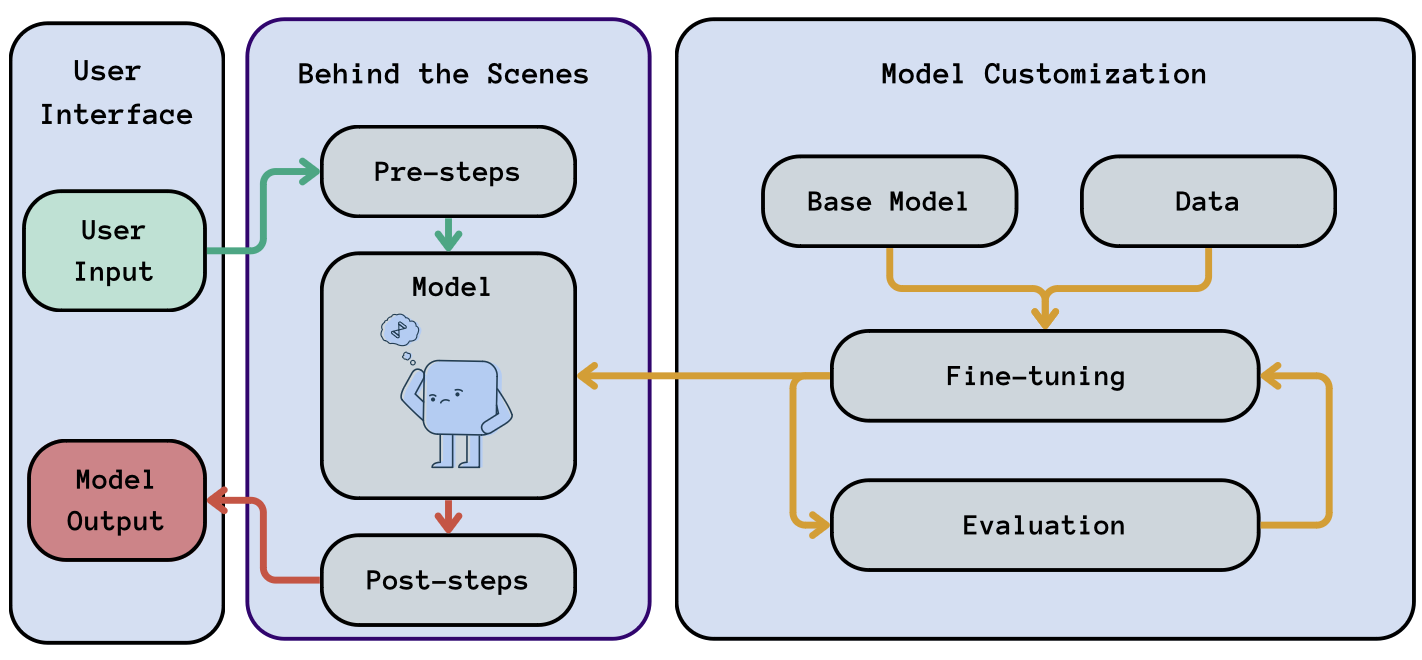
LLMOps iş akışı: Genel iş akışımıza (turuncu renkte) Model Özelleştirme adımlarını ekleme.
Tutarlı bir ince ayar hattına (pipeline) sahip olmak, daha fazla veri kullanıma girdikçe modelinizin bilgisini zaman içinde genişletmenize, LLM sürümünüzü zahmetsizce yükseltmenize veya diğer değişiklikleri yapmanıza yardımcı olabilir.
Üçüncü taraf modellere bağımlı olduğumuzda, bu modellerin erişilebilirliklerinden maliyetlerine kadar değişebileceğini unutmamak önemlidir. Bu durum, bizi farklı bir temel modele geçmeye zorlayabilir. Sağlam bir LLMOps kurulumu, yalnızca “Model” kutusunu farklı bir LLM ile değiştirerek bu kritik durumu sorunsuzca yönetmemizi sağlar.
LLM'inize ince ayar yapmanın veya onu sıfırdan eğitmenin, LLM üretime dağıtıldığında çalışacağı için LLMOps altyapısının dışında bir ilk adım olduğunu düşünebilirsiniz. Ancak bu doğru değildir; özellikle de az önce bahsi geçen nedenle: Başarılı bir hizmet, modelde iyileştirmeler gerektirecek ve gerekiyorsa sağlayıcı değişikliklerine dayanıklı (rezilyan) olmalıdır.
Genel bir LLMOps altyapısında etkili eğitim, ince ayar veya model iyileştirme için, eğitim ve sonraki çıkarım verileri arasında veri biçimlendirmesinin tutarlı tutulması önemlidir. Bunu yapmak için, eğitim verilerini genellikle JSON Lines (.jsonl) biçiminde düzenleriz. Bu biçim, yapısı sayesinde büyük veri kümelerinin verimli şekilde işlenmesine olanak tanıdığından LLM'lere ince ayar yapmak için son derece uygundur. İnce ayar için tipik bir .jsonl dosyası şöyle görünebilir:
{"prompt": "Question: What is the capital of France?", "completion": "The capital of France is Paris."}
{"prompt": "Question: Who wrote Macbeth?", "completion": "Macbeth was written by William Shakespeare."}
.jsonl dosyasındaki her satır, tek bir eğitim örneğini temsil eden ayrı bir JSON nesnesidir; prompt ve completion anahtarları sırasıyla giriş metnini ve beklenen model yanıtını belirtir; tıpkı çıkarım sırasında bekleyeceğimiz gibi. Ek olarak, bu biçim modele yeni verilerin artımlı olarak eklenmesini kolaylaştırır.
Model parametreleri, model boyutu ve kaynak tüketimi gibi özellikleri etkiledikleri için LLMOps altyapımızı kurarken önemlidir.
Eğitim parametreleriyle ilgili olarak, modelin karmaşıklığı ile bellek kullanımı gibi dağıtım sınırlamaları arasında denge kurmak üzere eğitim parametrelerini optimize etmek önemlidir. Bu optimizasyon, farklı kaynak kapasitelerine sahip çeşitli ortamlara model dağıtımı için kritik önemdedir; böylece modeller yalnızca gelişmiş değil, gerçek dünya uygulamaları için de pratiktir.
Çıkarım parametreleri açısından, temperature ve azami token sayısı gibi parametreleri ayarlamak yanıtların uzunluğunu ve rastgeleliğini kontrol etmeye olanak tanır. Bu ayarlar, modelin çıktısını belirli uygulama gereksinimleri ve kullanıcı niyetiyle hizalamak için LLMOps sürecinin bir parçası olarak yönetilir.
Komut mühendisliği tekniklerinin, LLM'lerin varsayılan yeteneklerini geliştirdiği gösterilmiştir. Bunun bir nedeni, modeli bağlamlandırmaya yardımcı olmalarıdır. Örneğin, modeli belirli bir alanda uzman gibi davranması için yönlendirmek veya istenen çıktıya doğru kılavuzlamak. Komut Mühendisliği ve Yönetimi, LLMOps kurulumumuza dahil edilmesi gereken kritik bileşenlerdir.
En etkili komut mühendisliği uygulamaları arasında az örnekli komut verme (few-shot) ve düşünce zinciri (chain-of-thought) akıl yürütme yer alır. Bu teknikleri kısaca gözden geçirelim ve LLMOps kurulumumuza nasıl entegre edilebileceklerini tartışalım:
Az örnekli komut verme ve düşünce zinciri gibi teknikleri LLMOps kurulumumuzda uygulamak, komut şablonları kullanılarak etkili bir şekilde gerçekleştirilebilir.
Komut şablonları, LLM'lerin akıl yürütmesini yönlendirmek için kullanılan önceden tanımlı yapılardır. Tutarlı bir yapı sunarak benzer türdeki isteklerin yeknesak şekilde yapılmasını sağlar veya kullanıcıya şeffaf biçimde komut mühendisliği tekniklerinin dahil edilmesine yardımcı olur.
LLMOps kurulumunda, çeşitli kullanım durumları için iyi tasarlanmış komut şablonlarının bulunduğu bir havuzun geliştirilmesi ve yönetilmesi çok önemlidir. Belirli bir kullanım durumu için uygun komut şablonunun seçimi genellikle, sorgu modele gönderilmeden önce ön işleme aşamasında gerçekleştirilen ön bir adımdır.
Az örnekli komut verme için şablonlar, modelden beklenen görevi veya yanıt tarzını gösteren birkaç örneği içerecek şekilde tasarlanmalıdır. Benzer şekilde, düşünce zinciri akıl yürütmeyi dâhil etmek için komut şablonları, adım adım bir düşünce sürecini içerecek şekilde özenle tasarlanmalıdır. Özetle, modele herhangi bir problemi yöntemli biçimde ele alıp daha basit ve yönetilebilir adımlara nasıl ayrıştıracağına rehberlik etmelidirler.
Harici kaynaklardan bilgi dahil etmek, özellikle LangChain gibi çerçevelerde faydalı olan düşünce zinciri akıl yürütmenin bir adımı olabilir; burada, modelin mevcut bilgi tabanı yetersizse internetten bilgi getirmesi talimatı verilir.
Hem az örnekli komut vermede hem de düşünce zinciri akıl yürütmede, A/B testi uygulamak oldukça faydalıdır. Bu, farklı kullanıcı alt kümelerini farklı komut sürümlerine maruz bırakarak kontrollü deneyler yürütmeyi, performanslarını nesnel olarak ölçmeyi ve sonuçlara göre en etkili olanları seçmeyi içerir. Ayrıca her iki durumda da komut şablonlarımızı yinelemeli olarak iyileştirmek için performans verilerine güvenmek önemlidir.
Temel model eğitilip ince ayar yapıldıktan ve sonuçtan memnun kaldıktan sonra, modeli dağıtma zamanı gelir. LLMOps bağlamında bir modelin dağıtımı, bir dil modelinin üretim ortamında kullanımına sunulması sürecini ifade eder. Bu, modeli eğitim ortamından alıp üretim altyapısına entegre etmeyi içerir. Bu adım, alışıldık diyagramımızda turuncu ile gösterilmiştir:
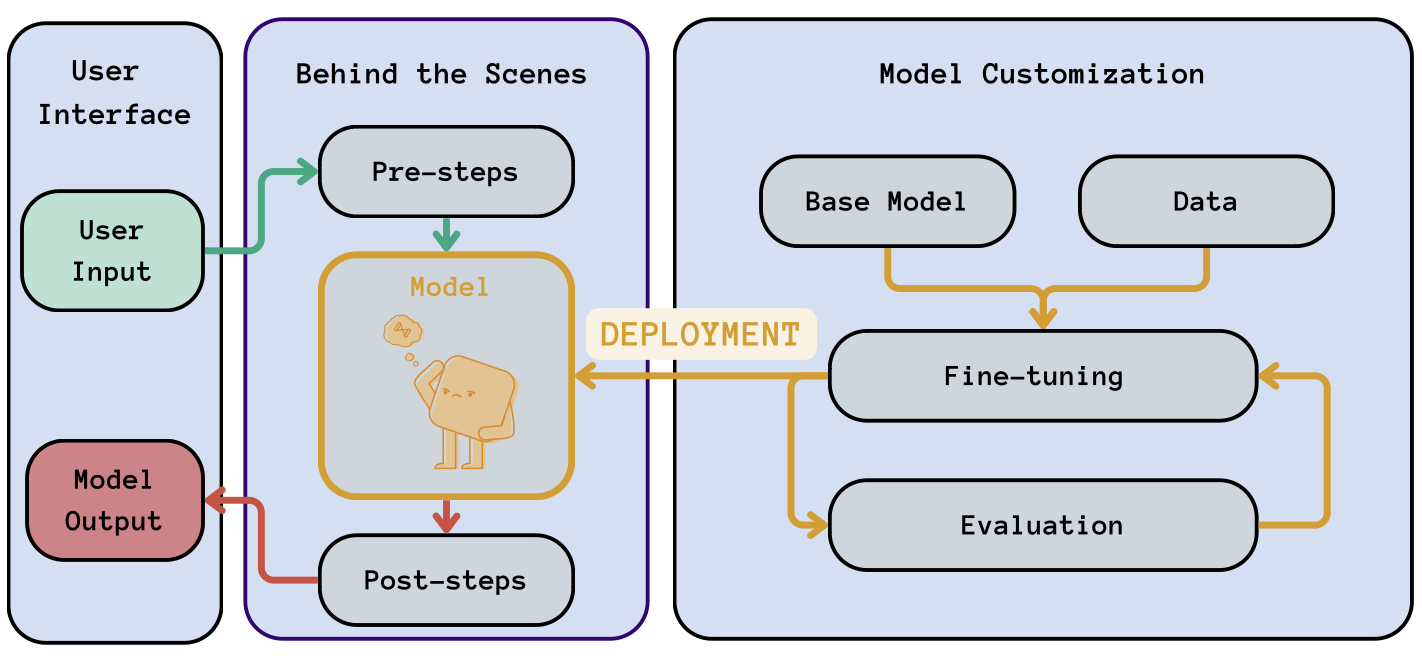
LLMOps iş akışı: Genel iş akışımıza (turuncu renkte) dağıtım adımını vurgulama. Bu adım, modelin geliştirme ortamından üretime “taşınmasını” içerir.
Dağıtım ayrıca, modelle üretimdeyken iletişim kurmak için kullanacağımız arayüzün ayarlanmasını da içerir. Genel olarak, arayüz işleme modumuza bağlıdır:
API'ler web sunucularına veya bulut platformlarına dağıtılabilir; böylece onlara erişmesi gereken kullanıcılar veya sistemler tarafından erişilebilir olmaları sağlanır. LLMOps kurulumumuz, API'nin beklenen yükü karşılayabilmesini; ölçekleme, yük dengeleme ve yedekli çalışma (failover) mekanizmalarını dikkate almasını sağlamalıdır.
Toplu kullanım durumlarında, cron (Unix benzeri sistemlerde) veya bulut tabanlı iş zamanlama hizmetleri gibi araçlarla toplu işleri zamanlayabilirsiniz. Bu işler, belirtilen aralıklarda modeli yeni veriler üzerinde çalıştırır, verileri işler ve sonuçları depolar.
Son olarak, modeli üretim kurulumuna dağıtmak genellikle model paketleme ve sürümlemesini içerir:
Sürekli Entegrasyon (CI) ve Sürekli Teslimat (CD) hatları, bir modeli geliştirme ortamından üretime taşıma adımlarını otomatikleştirir; modelin güvenilir, güncel ve verimli şekilde dağıtılmasını sağlar.
LLMOps'ta, modele yeni kod veya değişiklikler (hiperparametre ayarı, model mimarisi değişiklikleri veya yeni eğitim verileri gibi) eklendiğinde, CI bu değişikliklerin otomatik olarak test edilmesini sağlar. Buna birim testleri, entegrasyon testleri ve değişikliklerin modeli bozmadığını veya performansını düşürmediğini doğrulayan diğer kontroller dahildir. Bu anlamda CI, modelimizi sürekli izlemenin bir yoludur.
Değişiklikler CI aşamasındaki tüm testleri geçtikten sonra, CD modelin üretim ortamına dağıtımını otomatikleştirir. Bu, LLMOps üretim kurulumunda her zaman en kararlı, test edilmiş model sürümünün çalışmasını sağlar. CD ayrıca üretim ortamında bir sorun tespit edilirse önceki sürümlere hızlı geri dönüşe olanak tanır; böylece kesinti süresini en aza indirir ve hizmet güvenilirliğini garanti eder.
Son olarak, henüz değinmediğimiz bir husus daha var: LLMOps bileşenlerimizi mantıklı bir adımlar zinciri oluşturacak şekilde nasıl sıralarız?
Orkestrasyon, LLMOps kurulumunda işlem sırasının tanımlanmasını ve yönetilmesini, yani sözde iş akışının oluşturulmasını içerir. Örneğin, ön ve son işleme adımlarının sırasını veya yeni bir modelin dağıtıma hazır olana kadar geçmesi gereken farklı testleri tanımlamak gibi.
LLM bağlamında orkestrasyon, normalde verilerin iş akışının farklı bileşenleri arasında aktarılmasını içerir. Bu genellikle bir adımın çıktısının depolandığı ve bir sonraki adım tarafından alındığı veri yolları veya çalışma alanları belirtilerek yönetilir.
Orkestrasyon genellikle yapılandırma dosyaları aracılığıyla yönetilir; bunlar tipik olarak YAML (Yet Another Markup Language) ile yazılır. Bu dosyalar, iş akışındaki bileşenleri, sıralarını ve her adımın parametrelerini tanımlar. Alan Özel Dilleri (DSL'ler), iş akışlarını tanımlamak için daha sezgisel ve uzmanlaşmış bir sözdizimi sağlamak üzere bu yapılandırma dosyalarında sıklıkla kullanılır.
Son olarak, iş akışları genellikle otomatikleştirilir. Bu, iş akışı başlatıldığında, ilgili tüm adımların bir sonraki adıma kadar manuel müdahale olmadan sorunsuz şekilde çalışmasını sağlayarak, görevlerin manuel yürütülmesine olan bağımlılığı ve olası sorunları azaltır.
Bu yazıda, bir LLMOps altyapısının temel bileşenlerini ve varlık nedenlerini tartıştık. Bununla birlikte, LLMOps altyapınızın performansını artırabilecek ileri teknikler de vardır:
LLMOps altyapımızda veri gizliliğini ve kullanıcı korumasını sağlamak, güvenilir bir hizmet inşa etmenin merkezindedir.
Örneğin, sağlam veri anonimleştirme tekniklerini uygulamak kritiktir. Diferansiyel gizlilik, k-anonimlik veya veri maskeleme gibi teknikler, eğitim veri kümeleri oluşturulurken toplanan hassas kişisel bilgilerin ifşa edilmemesini sağlamak için kullanılabilir. Ayrıca, modellerimizi yinelemeli olarak iyileştirmek için gerçek dünya verilerini kullanmayı planlıyorsak, kullanıcının bunun farkında olması ve verilerinin ince ayar döngüsüne dahil edilmeden önce anonimleştirilmesi gerekir.
Güvenlikle ilgili bir diğer husus da sistemimizde, ChatGPT'deki sohbet geçmişi gibi herhangi bir özel kullanıcı bilgisini depolamayı planlayıp planlamadığımızdır. Bu durumda, tüm verilerin güvenli bir şekilde ve GDPR gibi veri koruma düzenlemelerine uygun olarak işlenmesini sağlamalıyız. Bu, altyapımızda güvenli veri depolamayı ve şifrelenmiş veri iletimini sağlamayı içerir.
Son olarak, LLMOps altyapısında sağlam erişim kontrolleri sağlamalı; yalnızca yetkili kişilerin modele, verilere ve eğitim ortamına erişebilmesini ve kullanıcıların kişisel bilgilerinin ifşa olmasına yol açacak sızıntıların olmamasını garanti etmeliyiz.
Geçen yıldan bu yana, LLM destekli uygulamalar, LLM'lerin son sürümlerinin gelişmiş yetenekleriyle ivme kazandı. Bu uygulamalar, LLM'leri hizmet olarak sunar ve bu da LLMOps altyapısı olarak bilinen, yönetim ve optimizasyon için sağlam bir çerçeveyi zorunlu kılar.
Bu yazıda, LLMOps'un başarılı, verimli ve müşteri odaklı bir LLM hizmetinin bel kemiği olarak kritik rolünü inceledik. İlk olarak, bir kullanıcının komutu modeli gönderdiği andan yanıtı aldığı ana kadar komutun yolculuğunu gözden geçirdik. LLMOps, bu “perde arkası” adımların akıcı ve verimli olmasını sağlar.
İkinci olarak, LLMOps'un model eğitimi, dağıtımı, izlenmesi ve bakımı kapsadığını ele aldık. LLMOps ayrıca değişken yükleri verimli şekilde ele almak için kaynakların ölçeklenmesini de içerir; böylece LLM tabanlı uygulamalarımızın ölçeklenebilirliğini ve güvenilirliğini garanti eder. Ek olarak, LLMOps altyapımızı iyileştirmeye yönelik ileri en iyi uygulamalara değindik.
Son olarak, LLMOps'un hizmet olarak LLM'lerin bütünlüğünü ve güvenliğini sağlamaya da dahil olduğunu kabul ettik. Bu modeller sıklıkla hassas verileri işlerken, veri gizliliğini ve düzenleyici standartlara uyumu sağlayacak katı güvenlik önlemlerini uygulamak için sağlam LLMOps uygulamaları esastır.
Sonuç olarak, bu makaleyi okuduktan sonra sizi önemli bir konuda ikna etmiş olmayı umuyorum: LLMOps yalnızca operasyonel bir gereklilik değil, aynı zamanda hizmet olarak LLM'lerin değerini, güvenilirliğini ve sürdürülebilirliğini artıran stratejik bir varlıktır.
Teoriyi uygulamaya dökmeye hazır mısınız? Uygulamalı öğreticimizle Büyük Dil Modelleri dünyasına daha derin dalın: "How to Build LLM Applications with LangChain". Bilginizi bugün eyleme dönüştürülebilir becerilere çevirmeye başlayın!
LLM Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



