

Kursus
Memahami Machine Learning
2 jam
313.7K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleSaat berusia 14 tahun, saya memasang taruhan sepak bola pertama saya untuk pemenang Piala Dunia FIFA 2010. Hanya mengandalkan intuisi, saya menebak tiap pertandingan dan bertaruh pada dua finalis dalam bagan turnamen saya: Belanda dan Spanyol. Pada akhirnya, kedua tim itu benar-benar lolos ke final—saya sangat senang karena prediksi saya menjadi kenyataan.
Empat belas tahun berlalu, saya mencari proyek untuk memperdalam keterampilan Python dan machine learning, yang membawa saya pada proyek prediksi untuk EURO 2024. Tujuan utama saya adalah memprediksi hasil pertandingan (menang, seri, atau kalah) dan jumlah gol yang dicetak tiap tim.
Dalam artikel ini, saya menyajikan gambaran proyek prediksi EURO 2024, menyoroti langkah-langkah utama yang saya ambil, tantangan yang saya temui, dan wawasan yang saya peroleh. Untuk pembahasan teknis yang lebih mendalam, termasuk implementasi kode, silakan lihat notebook proyek pendamping—Anda memerlukan akun DataLab untuk mengakses semua berkas.
Memprediksi hasil sepak bola terkenal sulit karena beberapa faktor. Dalam sepak bola, sebaran statistik gol sangat bervariasi. Pada saat yang sama, peluang mencetak gol per pertandingan relatif sedikit dibanding cabang olahraga beregu berbasis bola lainnya, sehingga hasilnya kerap tak terduga.
Ambil contoh bola tangan: frekuensi peluang mencetak gol yang tinggi cenderung menghasilkan hasil yang lebih dapat diprediksi karena jumlah gol lebih mungkin mencerminkan penciptaan dan pencegahan peluang seiring jumlah percobaan gol yang dirata-ratakan sepanjang pertandingan. Dalam sepak bola, bagaimanapun, terkadang cukup "parkir bus" di depan gawang dan melakukan satu serangan balik bertekad untuk membalikkan keadaan pertandingan.
Selain itu, pertandingan sepak bola memiliki ketergantungan jalur yang tinggi, artinya momentum dan hasil pertandingan biasanya sangat bergantung pada gol pertama. Tindakan kecil namun penting dapat berujung pada gol atau kartu merah dan secara dramatis mengubah jalannya pertandingan, sehingga prediksi makin sulit.
Pengenalan VAR (Video Assistant Referee) dalam beberapa tahun terakhir menambah unsur ketidakpastian, karena dapat membatalkan keputusan krusial di lapangan. Dan jangan lupakan pula "bentuk permainan hari itu" yang sulit ditangkap, faktor yang bisa saya tulis satu buku sebagai penggemar Eintracht Frankfurt yang terkenal tak terduga (tepat dijuluki "diva moody").
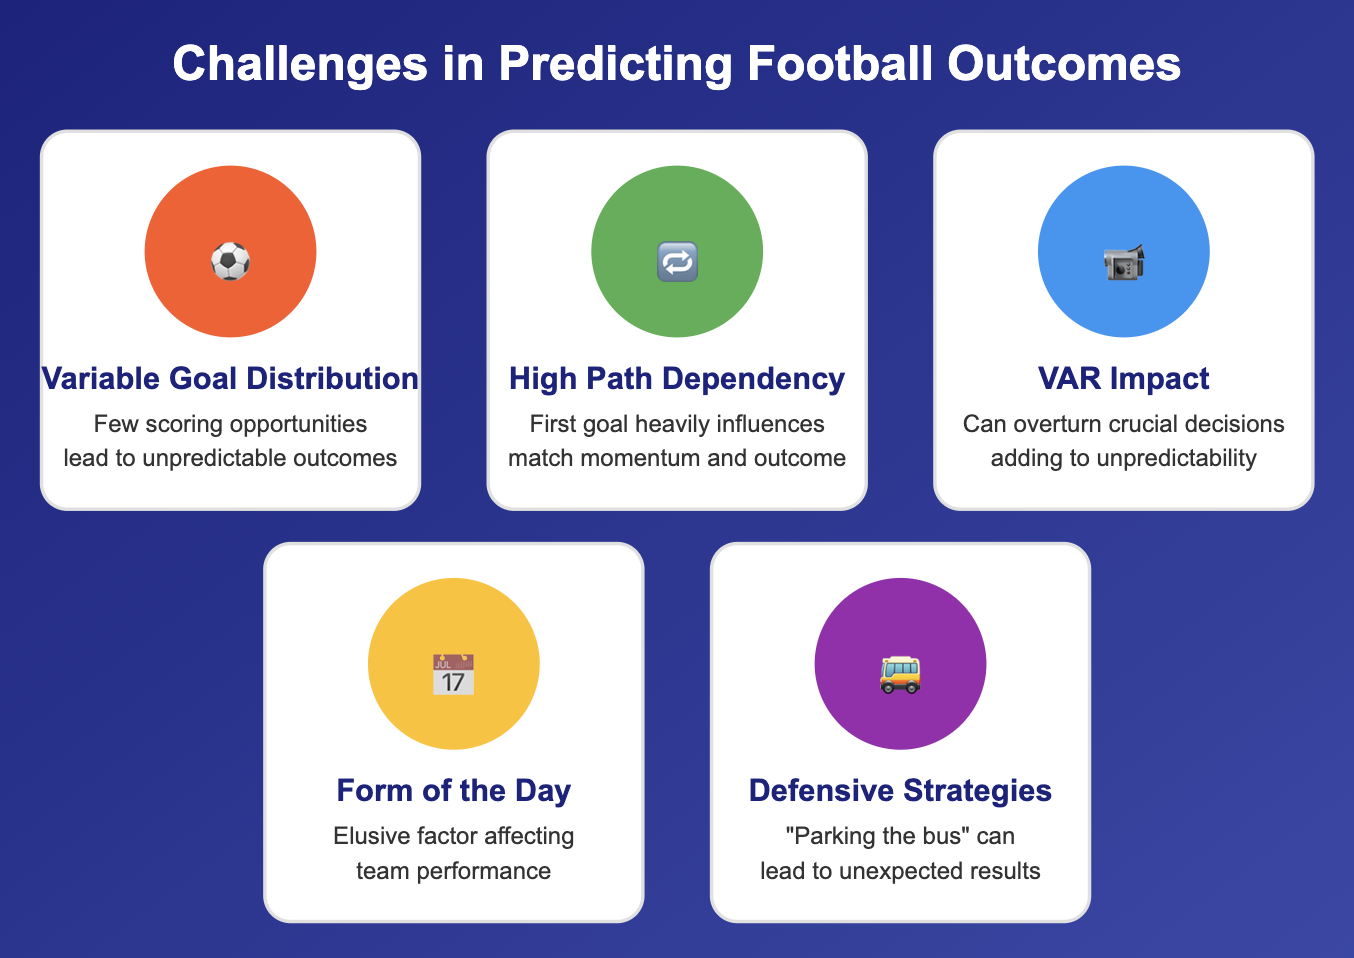
Selain faktor-faktor di atas, model prediksi saya juga menghadapi beberapa keterbatasan data tambahan yang harus saya tangani.
Untuk mengatasi tantangan pada data yang digunakan, beberapa strategi diterapkan:
Saya melengkapi titik data yang hilang sebisa mungkin agar dataset tetap komprehensif—misalnya, menambahkan formasi taktik untuk pertandingan yang akan diprediksi.
Karena sebagian besar tim bertahan pada formasi yang sama setelah mereka melatih dan mengujinya, saya berasumsi tiap tim akan bermain dengan formasi yang paling sering mereka gunakan dalam lima pertandingan terakhir. Ini memungkinkan kita memprediksi pertandingan sebelum susunan pemain diumumkan, yang baru terjadi satu jam sebelum kick-off.
Saat imputasi atau penghapusan tidak praktis, saya mengecualikan atau mengganti fitur tertentu agar tidak mengorbankan akurasi model.
Awalnya, misalnya, saya ingin membuat prediksi dua tingkat yang mengambil fitur primer untuk memprediksi fitur sekunder seperti penguasaan bola dan expected goals, guna juga memprediksi hasil berdasarkan fitur sekunder. Demi kesederhanaan, saya mengurungkan prosedur ini, dan sebagai gantinya menetapkan dua fitur untuk tiap tim berdasarkan statistik rata-rata pertandingan untuk merepresentasikan gaya main mereka.
Ketika imputasi tidak memungkinkan, saya menghapus data hilang untuk menjaga integritas dataset. Untungnya, hanya sedikit observasi yang hilang, sehingga dataset masih berisi lebih dari 3.000 pertandingan untuk membangun model.
Setelah mengatasi kesulitan dan keterbatasan, mari telaah proses mengubah data mentah menjadi prediksi yang bermakna. Pipa data, tulang punggung proyek, mencakup pengumpulan, prapemrosesan, dan penyiapan data untuk pemodelan, dengan memanfaatkan berbagai fitur taktis, psikologis, dan historis.
Langkah awal melibatkan scraping data pertandingan historis dari berbagai sumber, termasuk Transfermarkt, untuk mengumpulkan informasi komprehensif tentang pertandingan-pertandingan sebelumnya.
Satu baris dalam DataFrame hasil sesuai dengan satu pertandingan dari sudut pandang salah satu tim yang terlibat. Data ini dikombinasikan dengan data FootyStats untuk memasukkan fitur gaya main seperti rata-rata penguasaan bola dan metrik efisiensi.
Untuk detail lebih lanjut, lihat notebook scraping data di sini.
Berikutnya, data mentah diubah menjadi fitur-fitur bermakna yang dapat digunakan oleh model machine learning. Ini melibatkan ekstraksi nilai, transformasi variabel, dan perhitungan rata-rata.
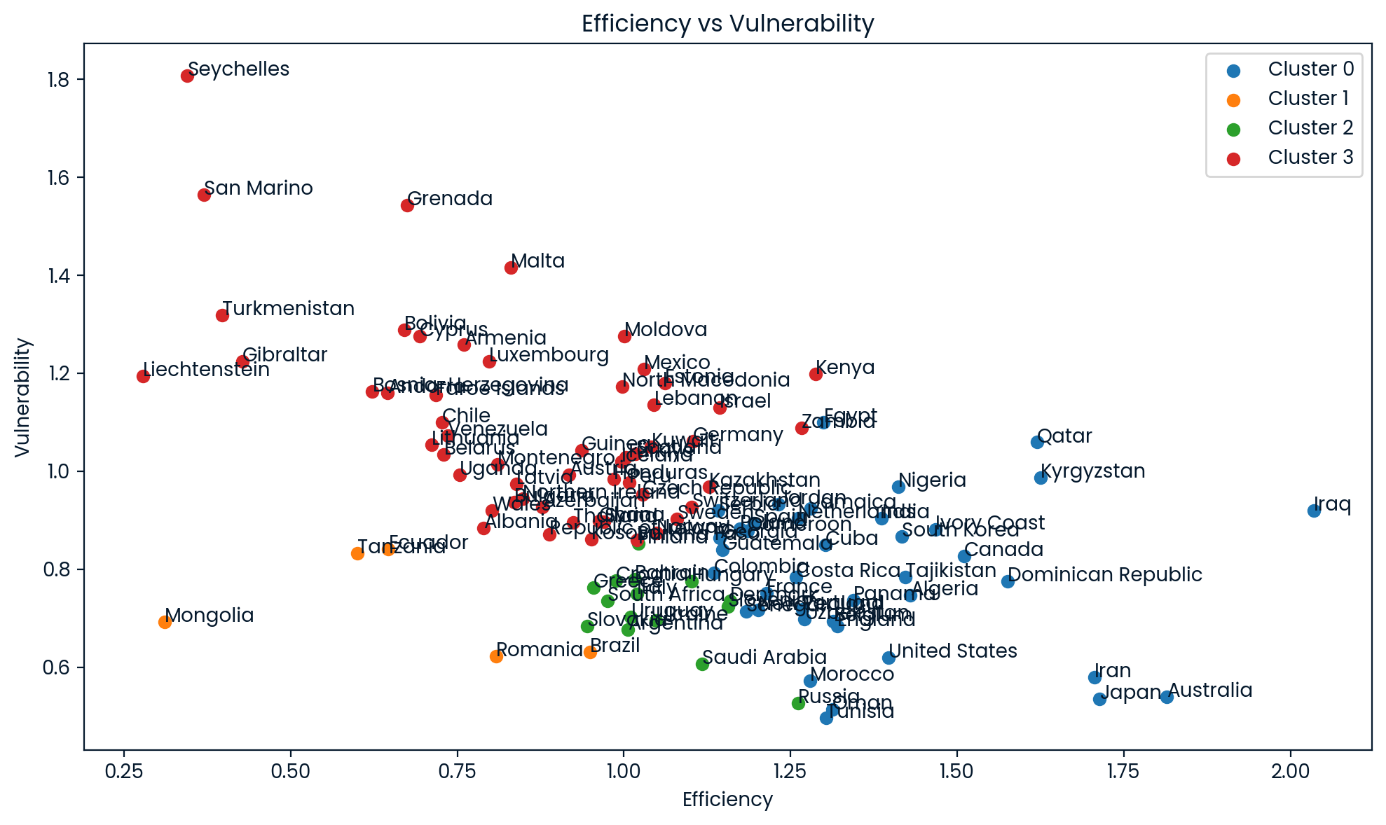
Klaster efisiensi versus kerentanan semua tim dalam dataset
Beberapa fitur kunci diidentifikasi dan digunakan dalam model untuk meningkatkan akurasi prediksi. Fitur-fitur tersebut meliputi:
Sebelum membangun model machine learning, dataset dibagi menjadi pertandingan yang belum dimainkan dan yang sudah dimainkan untuk membedakan data berlabel dan tak berlabel. Selain itu, kami mengambil logaritma pada fitur form yang sangat condong ke kanan dan menerapkan normalisasi serta one-hot encoding agar data berada dalam format yang sesuai.
Variabel tim termasuk tren jangka panjang harus diskalakan menggunakan MinMaxScaler untuk mencegah angka nol yang mewakili pertandingan tanpa tim terkait memengaruhi skala. Semua fitur numerik lainnya dinormalisasi menggunakan StandardScaler.
Untuk mengidentifikasi model paling efektif guna memprediksi hasil sepak bola, saya memulai dengan pilihan luas model machine learning. Mengadopsi pendekatan "black box", saya mengeksplorasi berbagai model untuk memahami kekuatan dan kelemahannya dalam menangani data. Untuk setiap model, saya menggunakan versi klasifikasi untuk memprediksi hasil pertandingan dan versi regresi untuk memprediksi jumlah gol yang dicetak kedua tim. Model yang saya uji meliputi:
Pertama, saya menetapkan seed (nomor punggung lama saya, sembilan) untuk reprodusibilitas. Pendefinisian label dan target serta pembangunan model mencakup beberapa langkah kunci, yang semuanya melibatkan perbandingan performa model menggunakan cross-validation:
Pada akhirnya, saya memilih model dengan performa terbaik berdasarkan presisi dalam memprediksi hasil pertandingan (menang/kalah) dan Root Mean Squared Error (RMSE) dalam memprediksi jumlah gol.
Saya memilih dua model untuk hasil pertandingan: satu untuk memprediksi menang dan kalah, dan satu lagi khusus untuk seri. Pembedaan ini diperlukan karena pola dan faktor yang memengaruhi hasil seri berbeda signifikan dari yang memengaruhi menang dan kalah. Untuk memastikan probabilitas akhir untuk ketiga hasil (menang, seri, kalah) berjumlah 100%, hasil penerapan model kemudian dinormalisasi.
Dengan menggunakan model terpilih beserta hiperparameter dan fiturnya, saya memprediksi semua label untuk setiap baris. Karena ada dua baris untuk setiap pertandingan yang akan diprediksi, kita mendapatkan dua probabilitas untuk setiap hasil pertandingan dan dua angka float sebagai prediksi gol untuk masing-masing tim.
Nilai-nilai ini seharusnya tidak terlalu berbeda satu sama lain, dan dalam banyak kasus memang tidak—jika berbeda, kami memberi tanda pada pertandingan tersebut untuk menandakan prediksi harus dipertimbangkan dengan sedikit kehati-hatian. Untuk mereduksinya menjadi satu nilai saja per label, saya mengambil rata-rata dari kedua nilai prediksi.
Untuk hasil pertandingan, saya menormalisasi probabilitas menang, seri, dan kalah agar berjumlah 100%. Saya juga membuat kolom tambahan untuk menangkap opsi taruhan populer seperti "double chance". Berdasarkan angka float prediksi gol per tim, saya membentuk distribusi Poisson dan menurunkan probabilitas untuk tiap jumlah gol setiap tim dan apakah total gol pertandingan di atas atau di bawah 1,5; 2,5; 3,5; 4,5; dan 5,5, yang cukup populer untuk dipertaruhkan.
Untuk prediksi tebak skor, saya memilih hasil dengan probabilitas tertinggi. Jika probabilitas menang kedua tim berada dalam selisih 0,05, saya menafsirkannya sebagai seri. Untuk prediksi gol, saya memilih jumlah gol yang paling mungkin untuk setiap tim, lalu menyesuaikannya seperlunya agar selaras dengan hasil pertandingan yang diprediksi.
Untuk memprediksi pertandingan EURO berikutnya, saya memperbarui data mentah pertandingan dengan hasil prediksi awal. Dengan memasukkan prediksi ini ke dalam dataset dan menerapkan kembali rekayasa fitur, saya kemudian dapat memprediksi babak berikutnya berdasarkan dinamika turnamen yang berkembang.
Memahami perbedaan antara akurasi dan presisi sangat penting dalam konteks prediksi sepak bola, terutama saat mempertimbangkan penerapannya. Menggunakan taruhan versus tebak skor sebagai contoh dapat mengilustrasikan pentingnya metrik ini:
Tujuannya adalah menemukan taruhan dengan ekspektasi imbal hasil positif. Ini berarti Anda perlu mengidentifikasi hasil yang mungkin terjadi dan mempertimbangkan odds yang ditawarkan bandar untuk menemukan value bet.
Presisi sangat krusial di sini, karena menitikberatkan pada ketepatan prediksi positif (misalnya, memprediksi kemenangan). Presisi tinggi membantu secara konsisten mengidentifikasi taruhan yang dinilai terlalu rendah oleh bandar, yang berdampak langsung pada profitabilitas.
Harap diingat bahwa perusahaan taruhan memiliki seluruh tim untuk membangun dan memelihara model prediktif yang sangat canggih yang kemungkinan besar akan mengungguli model sederhana seperti milik saya dalam banyak kasus.
Tujuannya adalah menebak hasil tiap pertandingan secara akurat. Peserta memperoleh poin untuk setiap prediksi yang benar, dengan target mengumpulkan poin terbanyak sepanjang rangkaian pertandingan. Akurasi keseluruhan lebih penting dalam skenario ini karena mengukur seberapa sering prediksi Anda benar, yang memengaruhi total skor Anda.
Prediksi hasil seri adalah contoh sempurna lain dari potensi perbedaan antara dua pengukuran ini. Hanya sekitar 20% pertandingan dalam data pelatihan berakhir seri, membuat sebagian besar model meremehkan peluang seri dan kadang bahkan tak pernah memprediksi seri.
Ini menghasilkan tingkat akurasi tinggi sekitar 80% karena semua non-seri diberi label dengan benar, tetapi presisi 0 untuk seri karena tidak ada satu pun seri yang diprediksi sebagai seri.
Performa model bervariasi berdasarkan jenis prediksi:
Karena menggunakan model yang berbeda, ada kasus di mana prediksi hasil dan gol tidak selaras. Walau sulit membandingkan skor kategorikal dan numerik, saya rasa adil untuk mengatakan bahwa prediksi hasil umumnya bekerja lebih baik daripada prediksi gol, itulah sebabnya yang terakhir disesuaikan dengan yang pertama jika terjadi ketidaksesuaian.
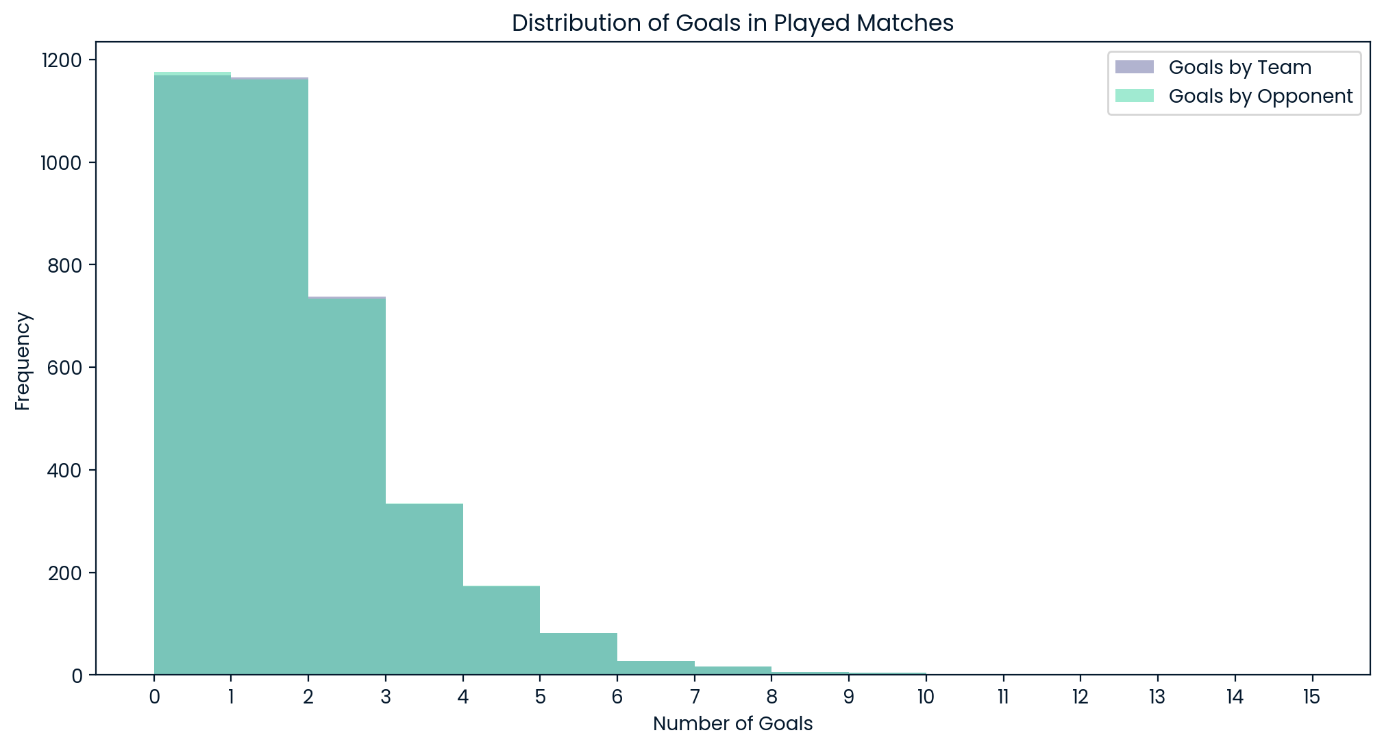
Distribusi Gol di Semua Pertandingan yang Dimainkan
Perlu dicatat bahwa model secara eksklusif memilih skor nol, satu, dan dua sebagai jumlah gol paling mungkin untuk tim mana pun di pertandingan mana pun. Mengingat distribusi gol keseluruhan dalam data pengujian, ini bukan hal mengejutkan, namun perlu diingat bahwa model tidak akan pernah mengharapkan laga dengan banyak gol sebagai hasil yang paling mungkin.
Menerapkan model pada pertandingan EURO pertama menghasilkan temuan menarik!
Dalam tiga perempat kasus, model memprediksi pemenang adalah tim yang difavoritkan, sementara pada seperempat sisanya, hasil prediksi tidak mencerminkan favorit bandar.
Sekilas, rasio ini tampak seperti peluang bagus, karena wajar berasumsi akan ada sejumlah hasil mengejutkan. Namun di sinilah bagian yang rumit, yang merupakan pertanyaan umum dalam prediksi sepak bola, terlepas dari apakah Anda menggunakan firasat atau model machine learning: Kapan masuk akal untuk bertaruh pada underdog?
Salah satu strategi untuk menyiasati ini adalah hanya dan selalu bertaruh pada favorit. Ini berarti Anda akan keliru pada sebagian kejutan, tetapi secara keseluruhan akurasi Anda akan cukup baik. Mencoba menebak hasil tak terduga juga adalah satu-satunya peluang untuk mengoptimalkan akurasi taruhan Anda, namun jelas lebih sulit dan berisiko.
Dengan asumsi rasio kejutan relatif konstan, setiap kesalahan bernilai ganda—untuk setiap kejutan yang ditebak namun tak terjadi, Anda kehilangan satu lagi karena bertaruh pada favorit.
Saya memilih pendekatan yang lebih berisiko, namun sejauh ini belum membuahkan hasil besar. Model saya cukup apes terkait potensi kejutan, menyebabkan akurasi yang agak mengecewakan yakni 50% pada matchday pertama.
Misalnya, model memprediksi Serbia dan Georgia, dua underdog, masing-masing akan bermain imbang melawan Inggris dan menang melawan Turki. Namun, favorit menang di kedua laga tersebut. Di sisi lain, model tidak memprediksi kejutan nyata seperti kemenangan Slovakia atas Belgia, kemenangan telak 3:0 Rumania atas Ukraina, dan hasil imbang Denmark melawan Slovenia.
Prediksi berikut dibuat setelah matchday kedua, dengan satu laga grup tersisa untuk tiap tim. Hasil paling mengejutkan muncul di grup paling menarik, yakni grup E, di mana semua tim memiliki poin sama (3) dengan satu laga tersisa.
Dengan model, Slovakia diprediksi menjuarai grup setelah menang 1:0 atas Rumania karena mereka menang melawan Belgia. Dengan demikian, Slovakia akan menurunkan favorit besar grup ke posisi kedua. Model bahkan meramalkan Slovakia menjadi kejutan terbesar turnamen, memprediksi mereka menang atas Austria dan melaju ke perempat final.
Prediksi untuk keseluruhan jalannya turnamen sangat menantang karena format di mana tim peringkat ketiga terbaik juga lolos ke fase gugur. Ini memunculkan berbagai kemungkinan pasangan laga, menambah kompleksitas tergantung dari grup mana empat tim peringkat ketiga terbaik berasal. Jadi, ambil prediksi berikut dengan sedikit kehati-hatian—pasangan laga bisa berubah total, bahkan jika selisih gol satu tim berubah hanya satu gol.
Laga K.O. umumnya diprediksi sangat ketat, dengan kemenangan 2:0 Spanyol pada kemungkinan laga 1/8 final melawan Rumania sebagai satu-satunya yang memiliki selisih gol ekspektasi lebih dari satu.
Laga Italia mendorong tingkat keketatan ke ekstrem, dengan hasil seri diprediksi untuk dua laga K.O. pertama mereka. Karena adu penalti jarang terjadi dan tidak ada cukup data untuk memprediksi pemenangnya, saya mengandalkan ingatan akan rekam jejak penalti Italia yang baik dan memperkirakan Italia akan memenangkan kedua adu penalti melawan Swiss dan Inggris.
Pada akhirnya, model memprediksi Spanyol, Portugal, Belanda, dan Italia mencapai semifinal.
Belanda dan Spanyol menjadi final yang saya prediksi, persis seperti tahun 2010—mungkinkah sejarah terulang?
Proyek ini memberikan beberapa pembelajaran utama:
Untuk meningkatkan prediksi dan memperluas cakupan proyek, beberapa langkah dapat diambil:
Untuk informasi dan kode yang lebih detail, silakan kunjungi notebook proyek.
Artikel blog ini menyajikan gambaran tantangan dan metodologi dalam memprediksi hasil sepak bola, menyoroti perjalanan dan pembelajaran dari proyek prediksi EURO 2024.
Mengintegrasikan data science dan analitik olahraga membuka peluang menarik bagi para penggemar dan profesional di bidang ini. Seiring proyek terus berkembang, tujuannya tetap untuk menyempurnakan model dan memperluas penerapannya ke turnamen lain, berkontribusi pada berkembangnya bidang analitik olahraga.
Jika Anda ingin mempelajari lebih lanjut tentang analitik olahraga, berikut beberapa sumber yang dapat Anda coba:
Pelajari machine learning dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



