14 岁那年,我第一次为 2010 年世界杯冠军下注。全凭直觉,我逐场猜测,并把决赛席位押在了我赛程规划中的两支队:荷兰和西班牙。最终,这两队真的会师决赛——我的预测成真,令我激动不已。
时隔 14 年,我想做一个项目来加深对 Python 和机器学习的掌握,于是选择了 2024 年欧洲杯的预测项目。我的主要目标是预测比赛结果(胜、平、负)以及每支球队的进球数。
本文概述了我的 EURO 2024 预测项目,重点介绍了我采取的关键步骤、遇到的挑战以及获得的洞见。若想深入了解技术细节(包括代码实现),请参阅配套的笔记本项目——您需要一个 DataLab 账户才能访问全部文件。
预测足球比赛结果的难点
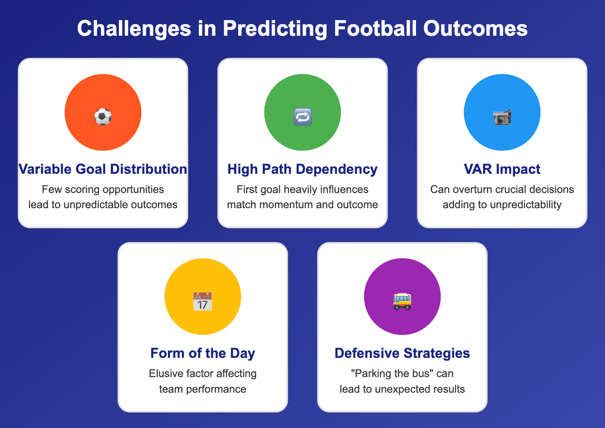
预测足球比赛的结果因多种因素而出名地困难。足球的进球数在统计分布上波动很大;同时,相比其他集体球类运动,每场比赛的得分机会相对较少,导致结果更难以预料。
以手球为例:频繁的得分机会往往带来更可预测的结果,因为在比赛过程中,尝试射门的次数不断拉平,进球数更可能反映出机会的创造与遏制。在足球中,有时只需在门前“摆大巴”,再抓住一次坚决的反击,就能颠覆整场比赛。
此外,足球比赛具有高度路径依赖,即比赛的势头与结果通常高度取决于第一粒进球。细小却关键的动作可能带来进球或红牌,剧烈改变比赛走向,进一步加大了预测难度。
近年引入的 VAR(视频助理裁判)也增添了不确定性,因为它可能推翻场上的关键判罚。别忘了还有玄之又玄的“当日状态”——作为那支以多变著称、绰号“情绪化女神”的法兰克福队球迷,我对这个话题简直可以写一本书。
应对数据局限的策略
除上述因素外,我的预测模型还面临若干数据层面的限制,需要一一解决。
- 缺乏球员层面数据: 若没有关键球员、个人表现指标或伤病等详尽数据,模型可能会忽视影响赛果的关键因素。尽管国家队不像俱乐部那样受转会市场波动影响,但多年间阵容变化依然很大,因此数据若能反映这一点会更理想。
- 缺乏赛中数据: 缺少如控球率、传球成功率等赛中统计,会降低模型做出精确预测的能力。诸如首粒进球的时间与所属球队等数据点,也有助于追踪前述路径依赖的模式,从而更容易预测比赛可能走向。
为应对所用数据的挑战,我采用了多种策略:
填补缺失数据
在可行的情况下,我填补了缺失数据点,以确保数据集完整——例如为待预测的比赛加入战术阵型信息。
多数球队在训练与检验后会坚持同一套阵型,因此我假定各队将沿用其最近五场比赛中最常用的阵型。这样我们就能在首发阵容公布之前进行预测(通常只会在开赛前一小时公布)。
剔除或替换特征
当既无法填补也不便删除时,我会剔除或替换某些特征,以避免影响模型精度。
例如,最初我想做两级预测:先用主要特征去预测控球率、预期进球(xG)等次级特征,再基于这些次级特征预测赛果。为简化流程,我放弃了这一做法,转而依据比赛平均统计为每支球队设定两项特征,以代表其踢法风格。
删除缺失数据
在无法填补时,我删除缺失数据以保持数据集的完整性。幸运的是,样本损失很小,数据集仍有 3000 场以上的比赛可用于建模。
数据管道:从收集到预测
在解决了困难与限制之后,我们来看看如何把原始数据转化为有洞见的预测。该数据管道是项目的骨架,涵盖了数据收集、预处理与建模准备,利用了多种战术、心理与历史特征。
数据抓取
第一步是从多个来源抓取历史比赛数据,包括Transfermarkt,以汇总过往比赛的详尽信息。
生成的 DataFrame 中,每一行对应一场比赛中某一支参赛队伍的视角。该数据与FootyStats 数据结合,以纳入诸如平均控球率与效率指标等踢法特征。
更多细节可在数据抓取笔记本这里查看。
特征工程
随后,将原始数据转化为可供机器学习模型使用的有意义特征,包括提取数值、变量变换与计算均值等。
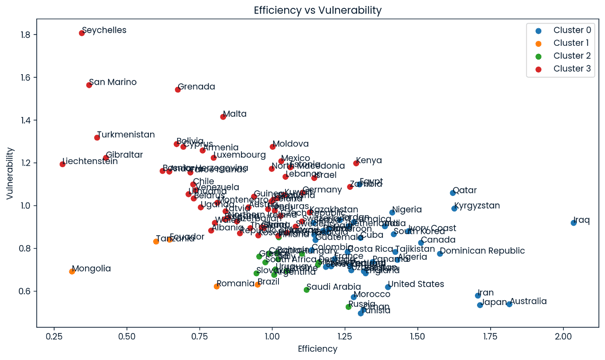
数据集中所有球队的“效率 vs. 脆弱性”聚类
我识别并在模型中使用了若干关键特征,以提升预测准确性。这些特征包括:
- 战术阵型: 双方阵型及其前锋与后卫人数。目标是辨识各类流行阵型之间与球队攻防能力相关的结果模式。
- 强弱身份: 为简洁客观地衡量这一点,我基于欧国联级别(非欧洲球队则参照相应的 FIFA 排名区间)提取此特征,以指示哪支球队更被看好。
- 球队状态: 最近五场比赛的场均进球与失球,反映各队当前攻防水准。
- 踢法风格: 采用平均控球率与“效率—脆弱性”聚类(见上图)来刻画球队的风格。效率定义为进球数与预期进球(xG)之比,既包含本队进球也包含本队丢球。聚类仅在已获得参赛资格的球队上拟合(它们才是关注对象),随后应用于数据集中至少有一场比赛的所有其他球队。请注意,由于样本较少,非欧洲球队的取值可能偏差较大。
- 赛段: 纳入赛事阶段(小组赛或淘汰赛),以体现球队所承受压力的差异。思路是探索不同筹码高低下的表现模式。
- 球队本质与长期趋势: 该特征假定存在某种难以解释的“余量”,可被捕捉为每支队伍的“本质”。与时间变量结合后,它能代表其他特征未覆盖的要素,提供球队整体表现与趋势的全景视图。
在构建机器学习模型之前,将数据集分为未赛与已赛两部分,以区分有标签与无标签数据。此外,我们对高度右偏的状态特征取对数,并进行归一化与独热编码,以确保数据格式适宜。
包含长期趋势在内的球队变量需用 MinMaxScaler 缩放,以避免“0”(表示不含该队的比赛)影响其量纲。其他数值特征使用 StandardScaler 标准化。
模型选择与工作流实现
为找出最有效的足球赛果预测模型,我从一组较广的机器学习模型入手。采取“黑箱”式探索,我尝试多种模型,以了解它们在处理数据时的长短。对每个模型,我均使用分类版本预测赛果,并用回归版本预测双方进球数。测试的模型包括:
- 随机森林(Random Forest)
- 梯度提升(Gradient Boosting)
- 极端梯度提升(XGBoost)
- 支持向量机(SVM)
- K 近邻(K-Nearest Neighbors)
- 极端随机树(Extra Trees)
- 自适应提升(AdaBoost)
- LightGBM(Light Gradient Boosting Machine)
- CatBoost(Categorical Boosting)
- 线性回归(Linear Regression)
我先设置了随机种子(我曾经的球衣号码 9)以保证可复现性。随后定义标签与目标并进行建模,核心步骤均通过交叉验证比较模型表现:
- 评估基线模型:将上述模型实例化、拟合并用交叉验证评估。
- 超参数调优: 优化各模型参数以提升性能。通过微调,模型能更好适配数据并给出更准确的预测。
- 递归特征选择: 使用递归特征选择识别最相关的特征。这有助于聚焦对预测影响最大的变量,提高模型效率与准确度。不过,对某些标签而言,使用全部特征的预测更佳;若出现这种情况,我会采用“全特征”版本。
最终,我依据预测比赛结果(胜/负)的精度,以及预测进球数的均方根误差(RMSE)来挑选表现最佳的模型。
我为赛果选择了两套模型:一套用于预测胜负,另一套专门用于预测平局。之所以区分,是因为影响平局的模式与因素与胜负有显著差异。为确保三种结果(胜、平、负)的最终概率相加为 100%,模型应用的结果随后会进行归一化。
模型应用
用所选模型及其超参数与特征,我为每一行预测所有标签。由于每场待预测比赛有两行记录,我们会得到每种赛果的两组概率,以及双方各自的两组浮点型预测进球数。
这些数值不应相差太多,绝大多数情况也确实如此;若差异较大,我们会对该场比赛打标,提示需要谨慎看待该预测。为将每个标签归并为单一取值,我取两组预测的平均值。
对赛果,我将胜、平、负概率归一化,使其总和为 100%。我还创建了其他列来反映诸如“双重机会”等热门投注选项。基于每队浮点型预测进球数,我构建泊松分布,推导出各队每个进球数的概率,以及全场总进球是否大于或小于 1.5、2.5、3.5、4.5、5.5 的概率——这些都是较常见的投注标的。
在“竞猜”层面的预测中,我选择概率最高的赛果。若双方胜率相差不超过 0.05,我将其判作平局。对进球数,我选取每队最可能的进球数,并在必要时进行调整,以确保与所预测的赛果一致。
为预测后续欧洲杯赛事,我用初始预测结果更新了原始比赛数据。将这些预测并入数据集并重新执行特征工程后,我便可在赛事形势演变的基础上预测下一轮比赛。
评估模型表现:准确率 vs. 精确率
理解准确率与精确率的区别在足球预测情境中至关重要,尤其在考虑预测的应用方式时。以投注与竞猜为例,可以说明这两个指标的重要性:
在体育博彩中
目标是找到期望回报为正的投注。这意味着您需要识别可能的结果,并结合庄家给出的赔率,找出有价值的下注。
这里精确率尤为关键,它关注正类预测(如预测胜利)的正确性。较高的精确率有助于持续识别被庄家低估的投注,直接关系到盈利能力。
请注意,博彩公司拥有整支团队来构建并维护非常复杂的预测模型,在大多数情况下,它们很可能优于像我这样较为简单的模型。
在竞猜比赛中
目标是尽可能准确地猜中每场比赛的结果。参与者每猜中一场即可得分,力争在多场比赛中累积最高分。在这种场景下,整体准确率更重要,因为它衡量了预测命中的频率,从而影响总得分。
对平局的预测正是两项度量可能出现背离的典型示例。训练数据中约 20% 的比赛以平局收场,导致多数模型低估平局概率,甚至从不预测平局。
这会带来约 80% 的高准确率,因为所有非平局都被正确标注;但平局的精确率为 0,因为没有任何平局被预测为平局。
模型表现结果
模型表现因预测类型而异:
- 赛果预测
- CatBoost 与 AdaBoost: 这两种模型在胜/负预测上最佳,最高准确率达 72%,精确率达 70%。
- SVC 预测平局: 该模型取得了 79% 的准确率与 47% 的精确率,虽远非理想,但相较于起点为零已是显著进步。
- 进球数预测
- CatBoost 与梯度提升: 这两类模型在进球预测上表现最佳,最低 RMSE 为 1.19 球,最高 R2 为 0.23。尽管这些分数显示仍有巨大改进空间,但为进球预测奠定了可靠基础。
由于使用了不同模型,赛果与进球数预测有时会不匹配。尽管分类与数值评分难以直接比较,但我认为总体上赛果预测优于进球预测,因此在不匹配时后者将调整以符合前者。
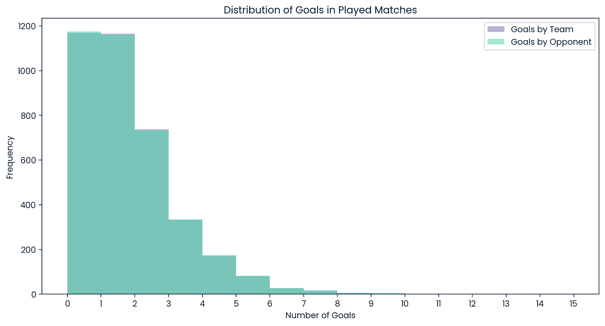
所有已赛比赛的进球分布
值得注意的是,模型在任何球队、任何比赛中,最可能的进球数几乎只会给出 0、1、2 三种。鉴于测试数据中的总体进球分布,这并不令人惊讶,但也意味着模型不会把大比分进球大战作为最可能的结果。
预测上场:2024 欧洲杯前瞻
将模型应用于欧洲杯首轮比赛,产生了一些有意思的结果!
小组赛
在四分之三的场次中,模型预测的胜者是更被看好的一方;其余四分之一的场次,预测结果与博彩公司所看好的球队不一致。
乍看之下,这个比例似乎适合下注,因为合理假设总会有一定数量的冷门。但接下来便是最棘手的部分,也是足球预测中的普遍问题——无论您依赖直觉还是机器学习模型:什么时候押注弱者才有意义?
一种应对策略是只且总是押注热门。这样会在一些冷门上出错,但总体准确率会相当不错。尝试连意外之喜也去猜中,才有机会把准确率优化到更高,但这显然更难、更冒险。
假设冷门比例大致恒定,那么每次失误的代价会翻倍——每猜错一个冷门,等于错过一个押热门的正确机会。
我选择了更冒险的策略,但目前收效甚微。模型在可能的冷门上有些“运气不佳”,导致首轮比赛的准确率仅为 50%,颇为令人失望。
比如,模型预测塞尔维亚与格鲁吉亚这两支弱队,分别能与英格兰打平、战胜土耳其;然而两场比赛的胜者都是热门一方。另一方面,模型也未能预测出实际发生的冷门,如斯洛伐克击败比利时、罗马尼亚 3:0 大胜乌克兰,以及丹麦战平斯洛文尼亚。
以下预测是在第二轮小组赛后作出的,每队还剩一场小组赛。最令人意外的结果出现在最具看点的小组,例如 E 组,在还剩一轮的情况下,所有球队都是 3 分。
根据模型,斯洛伐克将以 1:0 战胜罗马尼亚并最终小组第一,因为他们此前战胜过比利时。如此一来,斯洛伐克会把这支小组大热门挤到第二名。模型甚至预测斯洛伐克将成为本届赛事的最大黑马,淘汰奥地利并挺进八强。
淘汰赛阶段
预测整个赛事走向尤其困难,原因在于赛制允许成绩最好的小组第三晋级淘汰赛。这会引入多种可能的对阵组合,并因四支最佳第三来自哪些小组而更趋复杂。因此,以下预测请谨慎参考——哪怕只是某队净胜球改变一球,对阵也可能完全不同。
淘汰赛普遍会很胶着,唯独西班牙在可能的 1/8 决赛对阵罗马尼亚时被预测以 2:0 取胜,是少数预期净胜超过一球的场次。
意大利的比赛将“胶着”推向极致,前两场淘汰赛都被预测为平局。点球大战较为少见,且缺乏足够数据来预测胜者,我只好凭记忆中意大利在点球上的良好战绩,预计他们会在对阵瑞士与英格兰的两次点球大战中皆胜出。
最终,模型预测西班牙、葡萄牙、荷兰与意大利将会师半决赛。
我预测的决赛对阵是荷兰 vs. 西班牙,恰如 2010 年——历史会重演吗?
关键收获
本项目带来了几项重要收获:
- 预测足球赛果既具挑战又充满乐趣: 足球比赛的高度路径依赖,加上情景事件的强烈影响,使得预测困难却也引人入胜。
- 工作流至关重要: 从一开始就需要结构良好的工作流。规划数据流与工作簿结构能节省时间,产出更整洁、更易读的代码,也更易于排错,提升项目整体质量。
为改进预测并扩展项目范围,可采取以下措施:
- 更多数据: 纳入更多比赛有助于识别不同特征之间的模式,提升模型准确性。更大的数据集将为预测模型提供更全面的基础。
- 更多特征: 新增特征可带来更多洞见:
- 经验值: 纳入每名入选球员的平均国家队出场次数,可指示球队的经验水平。
- 赛前赔率: 通过抓取博彩公司网站的数据,反映赛前的强弱身份,可为预测提供有价值的背景。不过也有局限,因为赔率变化很频繁。但若只是简单判断谁是热门、谁是弱者,这种做法已足够。
- 扩展思路:
- 赛中数据: 纳入实时比赛统计可提升预测精度。诸如控球率、传球准确率与球员移动等指标,能在比赛过程中提供更深入的洞见。
- 球员数据: 更详尽的球员层面信息,包括个人表现指标与健康状况,可为赛果提供更深入的洞见。
更多详细信息与代码,请访问项目笔记本。
结语
本文概览了预测足球赛果的挑战与方法,回顾了 EURO 2024 预测项目的历程与收获。
将数据科学与体育分析结合,为爱好者与从业者提供了令人兴奋的机会。随着项目持续演进,目标仍是不断优化模型,并将其应用拓展到其他赛事,为日益发展的体育数据分析领域贡献力量。
如果您想进一步了解体育数据分析,可参考以下资源:
14 岁那年,我第一次为 2010 年世界杯冠军下注。全凭直觉,我逐场猜测,并把决赛席位押在了我赛程规划中的两支队:荷兰和西班牙。最终,这两队真的会师决赛——我的预测成真,令我激动不已。
时隔 14 年,我想做一个项目来加深对 Python 和机器学习的掌握,于是选择了 2024 年欧洲杯的预测项目。我的主要目标是预测比赛结果(胜、平、负)以及每支球队的进球数。
本文概述了我的 EURO 2024 预测项目,重点介绍了我采取的关键步骤、遇到的挑战以及获得的洞见。若想深入了解技术细节(包括代码实现),请参阅配套的笔记本项目——您需要一个 DataLab 账户才能访问全部文件。
预测足球比赛结果的难点
预测足球比赛的结果因多种因素而出名地困难。足球的进球数在统计分布上波动很大;同时,相比其他集体球类运动,每场比赛的得分机会相对较少,导致结果更难以预料。
以手球为例:频繁的得分机会往往带来更可预测的结果,因为在比赛过程中,尝试射门的次数不断拉平,进球数更可能反映出机会的创造与遏制。在足球中,有时只需在门前“摆大巴”,再抓住一次坚决的反击,就能颠覆整场比赛。
此外,足球比赛具有高度路径依赖,即比赛的势头与结果通常高度取决于第一粒进球。细小却关键的动作可能带来进球或红牌,剧烈改变比赛走向,进一步加大了预测难度。
近年引入的 VAR(视频助理裁判)也增添了不确定性,因为它可能推翻场上的关键判罚。别忘了还有玄之又玄的“当日状态”——作为那支以多变著称、绰号“情绪化女神”的法兰克福队球迷,我对这个话题简直可以写一本书。
应对数据局限的策略
除上述因素外,我的预测模型还面临若干数据层面的限制,需要一一解决。
为应对所用数据的挑战,我采用了多种策略:
填补缺失数据
在可行的情况下,我填补了缺失数据点,以确保数据集完整——例如为待预测的比赛加入战术阵型信息。
多数球队在训练与检验后会坚持同一套阵型,因此我假定各队将沿用其最近五场比赛中最常用的阵型。这样我们就能在首发阵容公布之前进行预测(通常只会在开赛前一小时公布)。
剔除或替换特征
当既无法填补也不便删除时,我会剔除或替换某些特征,以避免影响模型精度。
例如,最初我想做两级预测:先用主要特征去预测控球率、预期进球(xG)等次级特征,再基于这些次级特征预测赛果。为简化流程,我放弃了这一做法,转而依据比赛平均统计为每支球队设定两项特征,以代表其踢法风格。
删除缺失数据
在无法填补时,我删除缺失数据以保持数据集的完整性。幸运的是,样本损失很小,数据集仍有 3000 场以上的比赛可用于建模。
数据管道:从收集到预测
在解决了困难与限制之后,我们来看看如何把原始数据转化为有洞见的预测。该数据管道是项目的骨架,涵盖了数据收集、预处理与建模准备,利用了多种战术、心理与历史特征。
数据抓取
第一步是从多个来源抓取历史比赛数据,包括Transfermarkt,以汇总过往比赛的详尽信息。
生成的 DataFrame 中,每一行对应一场比赛中某一支参赛队伍的视角。该数据与FootyStats 数据结合,以纳入诸如平均控球率与效率指标等踢法特征。
更多细节可在数据抓取笔记本这里查看。
特征工程
随后,将原始数据转化为可供机器学习模型使用的有意义特征,包括提取数值、变量变换与计算均值等。
数据集中所有球队的“效率 vs. 脆弱性”聚类
我识别并在模型中使用了若干关键特征,以提升预测准确性。这些特征包括:
在构建机器学习模型之前,将数据集分为未赛与已赛两部分,以区分有标签与无标签数据。此外,我们对高度右偏的状态特征取对数,并进行归一化与独热编码,以确保数据格式适宜。
包含长期趋势在内的球队变量需用 MinMaxScaler 缩放,以避免“0”(表示不含该队的比赛)影响其量纲。其他数值特征使用 StandardScaler 标准化。
模型选择与工作流实现
为找出最有效的足球赛果预测模型,我从一组较广的机器学习模型入手。采取“黑箱”式探索,我尝试多种模型,以了解它们在处理数据时的长短。对每个模型,我均使用分类版本预测赛果,并用回归版本预测双方进球数。测试的模型包括:
我先设置了随机种子(我曾经的球衣号码 9)以保证可复现性。随后定义标签与目标并进行建模,核心步骤均通过交叉验证比较模型表现:
最终,我依据预测比赛结果(胜/负)的精度,以及预测进球数的均方根误差(RMSE)来挑选表现最佳的模型。
我为赛果选择了两套模型:一套用于预测胜负,另一套专门用于预测平局。之所以区分,是因为影响平局的模式与因素与胜负有显著差异。为确保三种结果(胜、平、负)的最终概率相加为 100%,模型应用的结果随后会进行归一化。
模型应用
用所选模型及其超参数与特征,我为每一行预测所有标签。由于每场待预测比赛有两行记录,我们会得到每种赛果的两组概率,以及双方各自的两组浮点型预测进球数。
这些数值不应相差太多,绝大多数情况也确实如此;若差异较大,我们会对该场比赛打标,提示需要谨慎看待该预测。为将每个标签归并为单一取值,我取两组预测的平均值。
对赛果,我将胜、平、负概率归一化,使其总和为 100%。我还创建了其他列来反映诸如“双重机会”等热门投注选项。基于每队浮点型预测进球数,我构建泊松分布,推导出各队每个进球数的概率,以及全场总进球是否大于或小于 1.5、2.5、3.5、4.5、5.5 的概率——这些都是较常见的投注标的。
在“竞猜”层面的预测中,我选择概率最高的赛果。若双方胜率相差不超过 0.05,我将其判作平局。对进球数,我选取每队最可能的进球数,并在必要时进行调整,以确保与所预测的赛果一致。
为预测后续欧洲杯赛事,我用初始预测结果更新了原始比赛数据。将这些预测并入数据集并重新执行特征工程后,我便可在赛事形势演变的基础上预测下一轮比赛。
评估模型表现:准确率 vs. 精确率
理解准确率与精确率的区别在足球预测情境中至关重要,尤其在考虑预测的应用方式时。以投注与竞猜为例,可以说明这两个指标的重要性:
在体育博彩中
目标是找到期望回报为正的投注。这意味着您需要识别可能的结果,并结合庄家给出的赔率,找出有价值的下注。
这里精确率尤为关键,它关注正类预测(如预测胜利)的正确性。较高的精确率有助于持续识别被庄家低估的投注,直接关系到盈利能力。
请注意,博彩公司拥有整支团队来构建并维护非常复杂的预测模型,在大多数情况下,它们很可能优于像我这样较为简单的模型。
在竞猜比赛中
目标是尽可能准确地猜中每场比赛的结果。参与者每猜中一场即可得分,力争在多场比赛中累积最高分。在这种场景下,整体准确率更重要,因为它衡量了预测命中的频率,从而影响总得分。
对平局的预测正是两项度量可能出现背离的典型示例。训练数据中约 20% 的比赛以平局收场,导致多数模型低估平局概率,甚至从不预测平局。
这会带来约 80% 的高准确率,因为所有非平局都被正确标注;但平局的精确率为 0,因为没有任何平局被预测为平局。
模型表现结果
模型表现因预测类型而异:
由于使用了不同模型,赛果与进球数预测有时会不匹配。尽管分类与数值评分难以直接比较,但我认为总体上赛果预测优于进球预测,因此在不匹配时后者将调整以符合前者。
所有已赛比赛的进球分布
值得注意的是,模型在任何球队、任何比赛中,最可能的进球数几乎只会给出 0、1、2 三种。鉴于测试数据中的总体进球分布,这并不令人惊讶,但也意味着模型不会把大比分进球大战作为最可能的结果。
预测上场:2024 欧洲杯前瞻
将模型应用于欧洲杯首轮比赛,产生了一些有意思的结果!
小组赛
在四分之三的场次中,模型预测的胜者是更被看好的一方;其余四分之一的场次,预测结果与博彩公司所看好的球队不一致。
乍看之下,这个比例似乎适合下注,因为合理假设总会有一定数量的冷门。但接下来便是最棘手的部分,也是足球预测中的普遍问题——无论您依赖直觉还是机器学习模型:什么时候押注弱者才有意义?
一种应对策略是只且总是押注热门。这样会在一些冷门上出错,但总体准确率会相当不错。尝试连意外之喜也去猜中,才有机会把准确率优化到更高,但这显然更难、更冒险。
假设冷门比例大致恒定,那么每次失误的代价会翻倍——每猜错一个冷门,等于错过一个押热门的正确机会。
我选择了更冒险的策略,但目前收效甚微。模型在可能的冷门上有些“运气不佳”,导致首轮比赛的准确率仅为 50%,颇为令人失望。
比如,模型预测塞尔维亚与格鲁吉亚这两支弱队,分别能与英格兰打平、战胜土耳其;然而两场比赛的胜者都是热门一方。另一方面,模型也未能预测出实际发生的冷门,如斯洛伐克击败比利时、罗马尼亚 3:0 大胜乌克兰,以及丹麦战平斯洛文尼亚。
以下预测是在第二轮小组赛后作出的,每队还剩一场小组赛。最令人意外的结果出现在最具看点的小组,例如 E 组,在还剩一轮的情况下,所有球队都是 3 分。
根据模型,斯洛伐克将以 1:0 战胜罗马尼亚并最终小组第一,因为他们此前战胜过比利时。如此一来,斯洛伐克会把这支小组大热门挤到第二名。模型甚至预测斯洛伐克将成为本届赛事的最大黑马,淘汰奥地利并挺进八强。
淘汰赛阶段
预测整个赛事走向尤其困难,原因在于赛制允许成绩最好的小组第三晋级淘汰赛。这会引入多种可能的对阵组合,并因四支最佳第三来自哪些小组而更趋复杂。因此,以下预测请谨慎参考——哪怕只是某队净胜球改变一球,对阵也可能完全不同。
淘汰赛普遍会很胶着,唯独西班牙在可能的 1/8 决赛对阵罗马尼亚时被预测以 2:0 取胜,是少数预期净胜超过一球的场次。
意大利的比赛将“胶着”推向极致,前两场淘汰赛都被预测为平局。点球大战较为少见,且缺乏足够数据来预测胜者,我只好凭记忆中意大利在点球上的良好战绩,预计他们会在对阵瑞士与英格兰的两次点球大战中皆胜出。
最终,模型预测西班牙、葡萄牙、荷兰与意大利将会师半决赛。
我预测的决赛对阵是荷兰 vs. 西班牙,恰如 2010 年——历史会重演吗?
关键收获
本项目带来了几项重要收获:
为改进预测并扩展项目范围,可采取以下措施:
更多详细信息与代码,请访问项目笔记本。
结语
本文概览了预测足球赛果的挑战与方法,回顾了 EURO 2024 预测项目的历程与收获。
将数据科学与体育分析结合,为爱好者与从业者提供了令人兴奋的机会。随着项目持续演进,目标仍是不断优化模型,并将其应用拓展到其他赛事,为日益发展的体育数据分析领域贡献力量。
如果您想进一步了解体育数据分析,可参考以下资源: