
Cours
Comprendre le Machine Learning
2 h
308.8K
À 14 ans, j’ai fait mon tout premier pari sur le vainqueur de la Coupe du monde 2010. Misant uniquement sur l’intuition, j’ai pronostiqué match après match et misé sur les deux finalistes de mon tableau : les Pays-Bas et l’Espagne. Au final, ces deux équipes se sont bien hissées en finale — j’étais ravi de voir mes prédictions se réaliser.
Quatorze ans plus tard, je cherchais un projet pour approfondir mes compétences en Python et en apprentissage automatique. Cela m’a conduit à un projet de prédiction pour l’EURO 2024. Mon objectif principal : prédire les résultats des matches (victoire, nul ou défaite) et le nombre de buts marqués par chaque équipe.
Dans cet article, je présente une vue d’ensemble de mon projet de prédiction de l’EURO 2024, en mettant en avant les étapes clés, les défis rencontrés et les enseignements tirés. Pour plonger dans les détails techniques, y compris l’implémentation du code, référez-vous au notebook de projet associé — vous aurez besoin d’un compte DataLab pour accéder à tous les fichiers.
Prédire des résultats de football est notoirement complexe pour plusieurs raisons. La distribution statistique des buts en football est très variable. Par ailleurs, le nombre d’occasions franches par match est relativement faible par rapport à d’autres sports collectifs, ce qui accroît l’imprévisibilité.
Prenez le handball, par exemple : la fréquence des tirs y génère des résultats plus prévisibles, car le nombre de buts reflète davantage la création et la prévention d’occasions lorsque les tentatives s’étalonnent sur toute la rencontre. En football, en revanche, il suffit parfois de « garer le bus » devant son but et de placer une contre-attaque déterminée pour renverser le match.
De plus, les matches de football présentent une forte dépendance au chemin (path dependency) : la dynamique et l’issue d’un match dépendent très fortement du premier but. De petites actions significatives peuvent aboutir à un but ou à un carton rouge et bouleverser le cours de la rencontre, ce qui complique encore la prédiction.
L’arrivée de la VAR (Video Assistant Referee) ces dernières années a ajouté une part d’aléa supplémentaire en pouvant annuler des décisions cruciales sur le terrain. Et n’oublions pas l’insaisissable « forme du jour », sujet sur lequel je pourrais écrire un livre en tant que fan de l’Eintracht Francfort, équipe aussi brillante qu’imprévisible (surnommée « la diva capricieuse »).
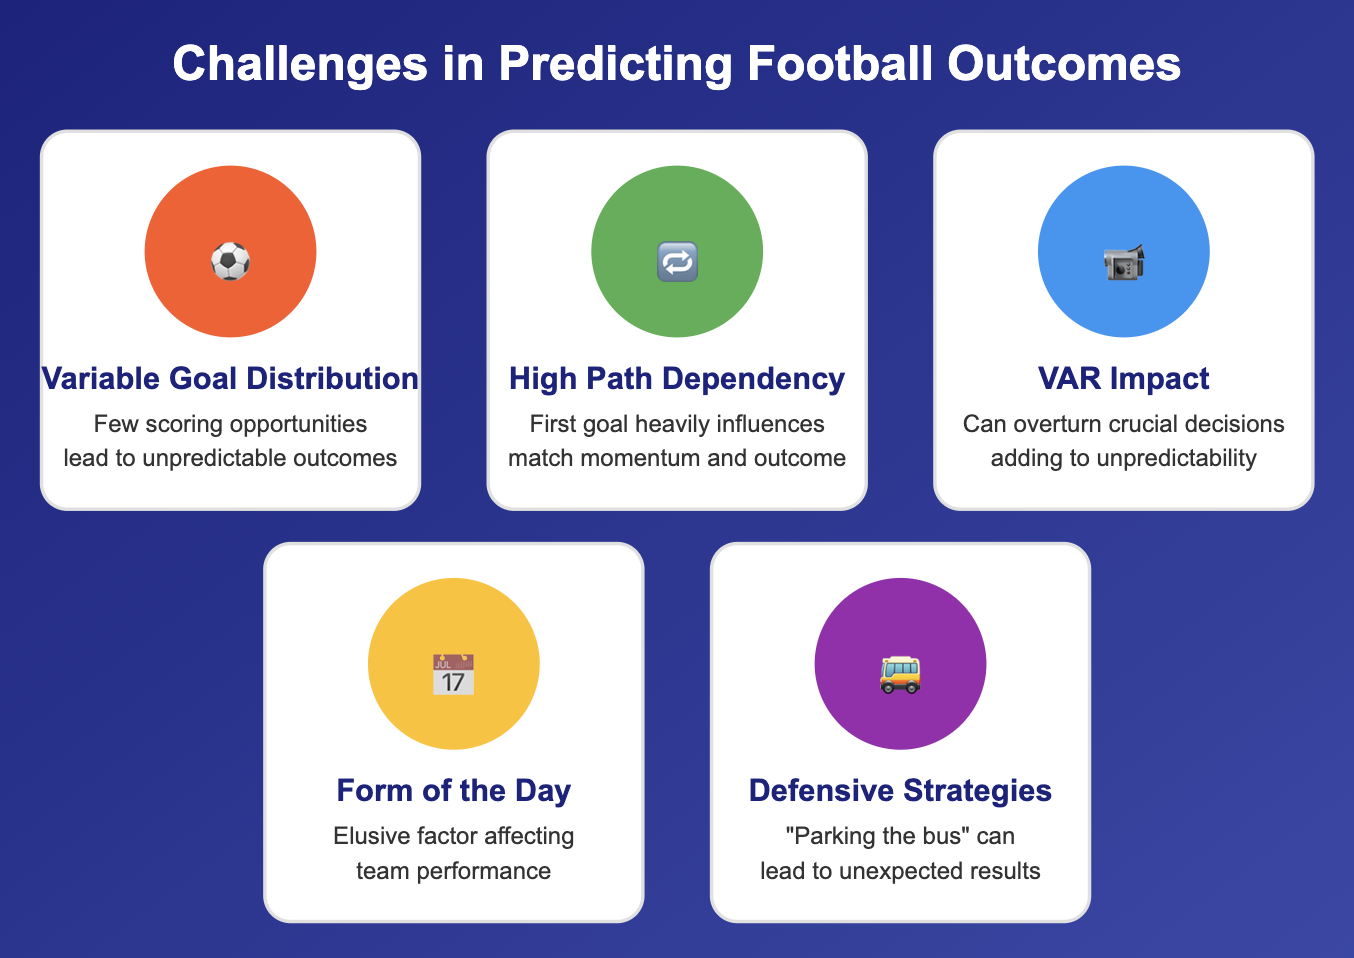
Au-delà de ces facteurs, mon modèle de prédiction faisait face à plusieurs limites de données supplémentaires qu’il a fallu traiter.
Pour contourner ces limites, plusieurs approches ont été adoptées :
J’ai complété les points de données manquants lorsque c’était possible, afin de conserver un jeu de données complet — par exemple, en ajoutant les schémas tactiques des matches à prédire.
La plupart des équipes gardant la même formation une fois qu’elles l’ont travaillée et testée, j’ai supposé que chaque équipe jouerait dans la formation la plus fréquemment utilisée lors de ses cinq derniers matches. Cela permet de prédire des rencontres avant l’annonce officielle des compositions, qui n’a lieu qu’une heure avant le coup d’envoi.
Quand l’imputation ou la suppression n’étaient pas pertinentes, j’ai exclu ou remplacé certaines variables afin de ne pas dégrader la précision du modèle.
initialement, je voulais effectuer une prédiction en deux étages : utiliser les variables primaires pour prédire des variables secondaires (possession, expected goals), puis prédire l’issue à partir de ces secondes variables. Par simplicité, j’ai renoncé à cette approche et attribué à chaque équipe deux variables représentant son style de jeu, dérivées de statistiques moyennes par match.
Lorsque l’imputation n’était pas envisageable, j’ai supprimé les entrées manquantes pour préserver l’intégrité du jeu de données. Heureusement, la perte d’observations est restée marginale, et le jeu de données comptait encore plus de 3 000 matches pour l’entraînement des modèles.
Après avoir traité les difficultés et les limites, voyons comment transformer des données brutes en prédictions exploitables. Le pipeline de données, colonne vertébrale du projet, a consisté à collecter, prétraiter et préparer les données pour la modélisation, en mobilisant des variables tactiques, psychologiques et historiques.
Première étape : extraire des données historiques de match à partir de diverses sources, dont Transfermarkt, pour réunir des informations complètes sur les rencontres passées.
Chaque ligne du DataFrame résultant correspond à un match vu du point de vue de l’une des équipes concernées. Ces données ont été croisées avec celles de FootyStats pour inclure des indicateurs de style de jeu comme la possession moyenne et des mesures d’efficacité.
Pour plus de détails, consultez le notebook de scraping des données ici.
Ensuite, les données brutes ont été transformées en variables pertinentes exploitables par les modèles d’apprentissage automatique. Cela a impliqué l’extraction de valeurs, la transformation de variables et le calcul de moyennes.
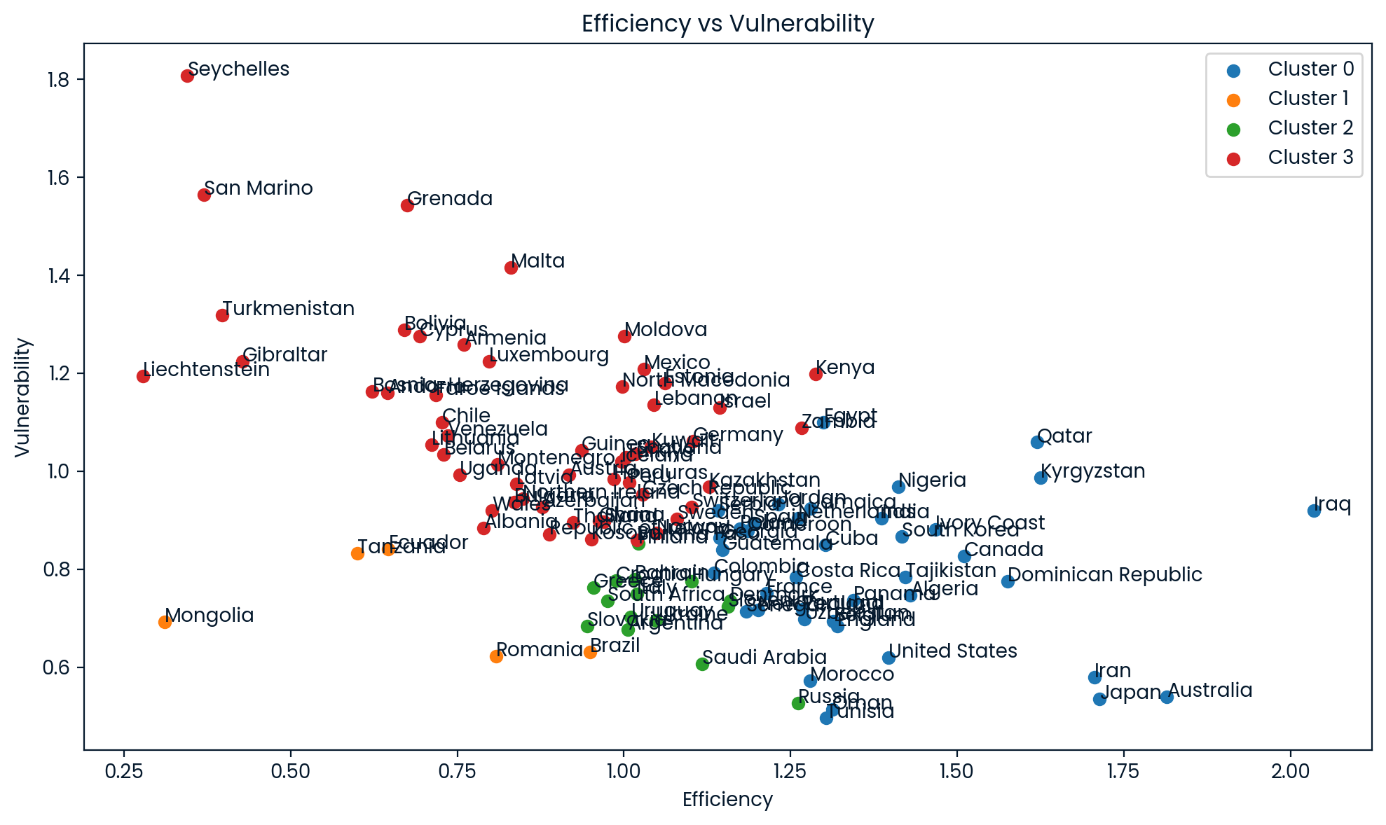
Clusters d’efficacité versus vulnérabilité de toutes les équipes du jeu de données
Plusieurs variables clés ont été identifiées et intégrées aux modèles pour améliorer la précision des prédictions :
Avant d’entraîner les modèles, le jeu de données est scindé entre matches joués et non joués afin de distinguer données étiquetées et non étiquetées. Nous appliquons ensuite un logarithme aux variables de forme très asymétriques à droite, puis une normalisation et un one-hot encoding pour obtenir un format adéquat.
Les variables d’équipe, y compris la tendance long terme, doivent être mises à l’échelle avec MinMaxScaler pour éviter que les zéros (matches sans l’équipe concernée) n’influencent l’échelle. Les autres variables numériques sont normalisées via StandardScaler.
Pour identifier les modèles les plus efficaces, j’ai commencé par un large éventail de techniques d’apprentissage automatique. En adoptant une approche « boîte noire », j’ai exploré différents algorithmes pour comprendre leurs forces et faiblesses sur ces données. Pour chaque modèle, j’ai utilisé la version classification pour prédire l’issue (victoire/nul/défaite) et la version régression pour prédire le nombre de buts des deux équipes. Modèles testés :
J’ai d’abord fixé une graine (mon ancien numéro de maillot, le neuf) pour la reproductibilité. La définition des étiquettes-cibles et la construction des modèles ont suivi plusieurs étapes, toutes comparées par validation croisée :
Au final, j’ai retenu les modèles les plus performants selon leur précision pour prédire l’issue (victoire/défaite) et la RMSE pour le nombre de buts.
J’ai choisi deux modèles pour l’issue : un pour prédire victoire/défaite, un autre spécifique aux nuls. Cette distinction est nécessaire car les facteurs qui mènent au nul diffèrent nettement de ceux des victoires/défaites. Pour que les probabilités des trois issues (victoire, nul, défaite) somment à 100 %, les résultats ont ensuite été normalisés.
En utilisant les modèles retenus avec leurs hyperparamètres optimisés, je prédis toutes les étiquettes pour chaque ligne. Comme il y a deux lignes par match à prédire, on obtient deux probabilités par issue et deux valeurs flottantes de buts prédits pour chaque équipe.
Ces valeurs ne devraient pas trop diverger, et c’est généralement le cas ; sinon, le match est signalé et la prédiction doit être prise avec des pincettes. Pour ramener à une valeur unique par étiquette, je fais la moyenne des deux prédictions.
Pour les issues, j’ai normalisé les probabilités de victoire, nul et défaite afin qu’elles totalisent 100 %. J’ai aussi créé des colonnes supplémentaires pour des options de pari courantes comme la « double chance ». À partir des buts flottants prédits par équipe, j’instancie une distribution de Poisson et j’en déduis les probabilités de chaque nombre de buts par équipe, ainsi que des totaux de buts supérieurs/inférieurs à 1,5 ; 2,5 ; 3,5 ; 4,5 et 5,5, très prisés des parieurs.
Pour mes pronostics, je retiens l’issue la plus probable. Si les probabilités de victoire des deux équipes sont à moins de 0,05 d’écart, j’interprète cela comme un nul. Pour les buts, je sélectionne le nombre le plus probable pour chaque équipe, en ajustant si besoin pour rester cohérent avec l’issue prédite.
Pour prédire les matches à venir, j’actualise les données brutes avec les issues initialement prédites. En intégrant ces prédictions et en réappliquant le feature engineering, je peux projeter le tour suivant en fonction de l’évolution du tournoi.
Comprendre la différence entre exactitude (accuracy) et précision est crucial dans ce contexte, notamment selon l’usage des prédictions. L’exemple du pari sportif vs le concours de pronostics l’illustre bien :
L’objectif est de dénicher des mises à espérance de gain positive. Il faut donc identifier les issues probables et comparer aux cotes des bookmakers pour trouver de la valeur.
La précision est clé ici, car elle mesure la justesse des prédictions positives (p. ex., prédire une victoire). Une forte précision aide à repérer régulièrement des cotes sous-évaluées, ce qui influe directement sur la rentabilité.
Gardez à l’esprit que les bookmakers disposent d’équipes entières pour construire et maintenir des modèles prédictifs très sophistiqués, souvent supérieurs à un modèle plus simple comme le mien.
L’objectif est de deviner le résultat de chaque match. On marque des points pour chaque prédiction correcte, le but étant d’en accumuler le plus sur une série de matches. L’exactitude globale prime, puisqu’elle mesure la fréquence des bonnes prédictions et conditionne le score final.
La prédiction des nuls illustre bien l’écart possible entre ces deux mesures. Environ 20 % seulement des matches d’entraînement se terminent par un nul, ce qui amène la plupart des modèles à sous-estimer cette issue et parfois à ne jamais la prédire.
On obtient alors une forte exactitude d’environ 80 % (tous les non-nuls étant correctement étiquetés), mais une précision nulle sur les nuls, puisqu’aucun nul n’a été prédit.
Les performances varient selon le type de prédiction :
Comme différents modèles sont utilisés, il arrive que les prédictions d’issue et de buts ne concordent pas. Difficiles à comparer (catégoriel vs numérique), les résultats d’issue sont généralement meilleurs ; en cas d’écart, j’ajuste donc les buts à l’issue.
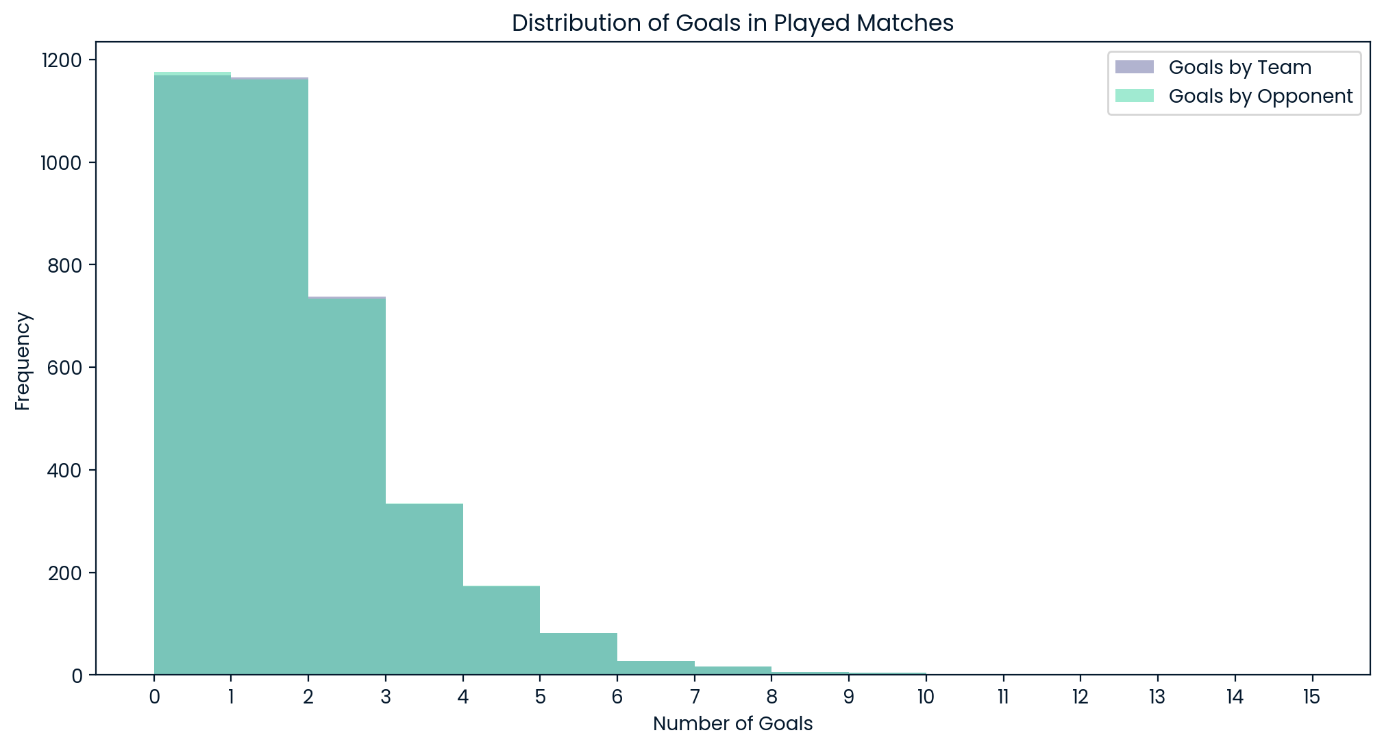
Distribution des buts dans tous les matches joués
On remarque que le modèle retient presque toujours 0, 1 ou 2 comme nombre de buts le plus probable pour une équipe. Vu la distribution globale observée en test, rien de surprenant ; mais gardons à l’esprit qu’il n’anticipera jamais comme issue la plus probable un match très prolifique.
L’application des modèles aux premiers matches de l’EURO a donné des résultats intéressants !
Dans trois quarts des cas, le modèle a donné le favori gagnant ; dans le quart restant, le résultat prédit n’allait pas dans le sens des bookmakers.
De prime abord, ce ratio paraissait correct — on peut supposer un certain nombre de surprises. Mais voilà la question épineuse, valable que l’on joue à l’instinct ou avec un modèle : quand a-t-on intérêt à miser sur l’outsider ?
Une stratégie consiste à ne parier que sur le favori. Vous raterez une partie des surprises, mais votre exactitude globale sera correcte. Tenter d’anticiper aussi les résultats inattendus est la seule façon d’optimiser l’exactitude, mais c’est évidemment plus difficile et risqué.
En supposant le ratio de surprises relativement constant, chaque erreur compte double : chaque surprise tentée à tort vous en fait manquer une autre en ne pariant pas sur le favori.
J’ai choisi l’approche la plus risquée, sans grand succès jusqu’ici. Mon modèle a été assez malheureux sur les surprises potentielles, aboutissant à une exactitude d’environ 50 % pour la première journée.
Par exemple, il prévoyait que la Serbie et la Géorgie, deux outsiders, tiendraient l’Angleterre en échec et battraient la Turquie, respectivement. Or les favoris se sont imposés dans les deux cas. À l’inverse, il n’a pas anticipé les vraies surprises comme la victoire de la Slovaquie face à la Belgique, le succès net 3 : 0 de la Roumanie contre l’Ukraine, ou le nul du Danemark face à la Slovénie.
Les prédictions suivantes ont été émises après la deuxième journée, avec un match de poule restant pour chaque équipe. Le résultat le plus surprenant concerne le groupe le plus disputé : en groupe E, toutes les équipes comptent 3 points avant la dernière rencontre.
Selon le modèle, la Slovaquie remporterait le groupe après une victoire 1 : 0 contre la Roumanie, forte de son succès contre la Belgique. Elle reléguerait ainsi le grand favori du groupe à la deuxième place. Le modèle prédit même que la Slovaquie serait la grosse surprise du tournoi, en battant l’Autriche pour filer en quarts.
La projection de tout le tableau s’est révélée particulièrement délicate, le format retenant aussi les meilleurs troisièmes. Cela introduit de multiples affiches potentielles selon l’origine des quatre meilleurs troisièmes. Donc à prendre avec prudence : les tableaux peuvent changer du tout au tout si une équipe améliore/empire sa différence de buts d’une unité seulement.
Les matches à K.O. sont généralement annoncés très serrés, avec un 2 : 0 de l’Espagne contre la Roumanie en huitièmes comme seule affiche affichant un écart attendu supérieur à un but.
Les matches de l’Italie poussent le suspense à l’extrême, avec des nuls prédits sur ses deux premiers tours à élimination directe. Les séances de tirs au but étant rares et faute de données suffisantes pour en prédire l’issue, je me suis fié à mon souvenir du solide passif italien dans l’exercice et j’ai supposé des succès contre la Suisse puis l’Angleterre.
Au final, le modèle envoie l’Espagne, le Portugal, les Pays-Bas et l’Italie en demi-finales.
Les Pays-Bas et l’Espagne composent ma finale prédite, comme en 2010 — et si l’histoire se répétait ?
Ce projet m’a appris plusieurs choses :
Pour améliorer les prédictions et élargir le périmètre, plusieurs pistes sont possibles :
Pour plus d’informations et le code, consultez le notebook du projet.
Cet article propose un aperçu des défis et méthodologies liés à la prédiction des résultats en football, en retraçant le parcours et les enseignements du projet EURO 2024.
Croiser science des données et analytique sportive ouvre de belles perspectives pour les passionnés comme pour les professionnels. Au fil des itérations, l’objectif reste d’affiner les modèles et d’étendre leur application à d’autres compétitions, contribuant à la progression de l’analytique sportive.
Pour aller plus loin sur l’analytique sportive, voici quelques ressources :
Apprenez le machine learning avec ces cours !
Cours
Cours
Cours