Năm 14 tuổi, tôi đặt cược bóng đá đầu tiên cho đội vô địch FIFA World Cup 2010. Chỉ dựa vào trực giác, tôi đoán từng trận và đặt cược vào hai đội lọt vào chung kết theo kế hoạch giải đấu của mình: Hà Lan và Tây Ban Nha. Cuối cùng, đúng là hai đội đó đã vào chung kết—tôi vô cùng phấn khích khi dự đoán của mình thành hiện thực.
Sau 14 năm, tôi tìm kiếm một dự án để đào sâu kỹ năng Python và học máy, và điều đó dẫn tôi đến một dự án dự đoán cho EURO 2024. Mục tiêu chính của tôi là dự đoán kết quả trận đấu (thắng, hòa hoặc thua) và số bàn thắng của mỗi đội.
Trong bài viết này, tôi cung cấp cái nhìn tổng quan về dự án dự đoán EURO 2024 của mình, nêu bật các bước quan trọng đã thực hiện, những thách thức gặp phải và các phát hiện thu được. Để đi sâu vào chi tiết kỹ thuật, bao gồm cả triển khai mã, vui lòng tham khảo sổ tay dự án đi kèm—bạn sẽ cần một tài khoản DataLab để truy cập tất cả tệp.
Thách thức khi dự đoán kết quả bóng đá
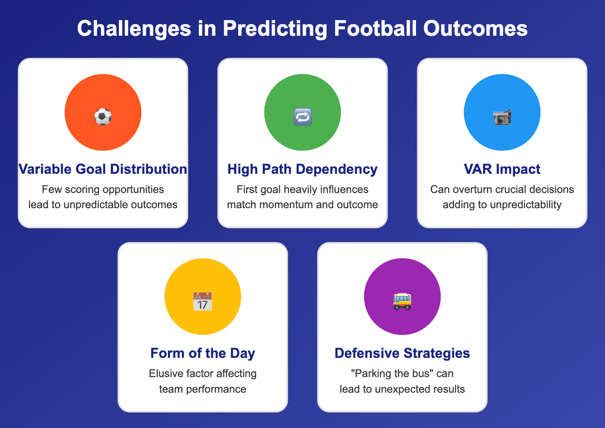
Dự đoán kết quả bóng đá nổi tiếng là khó do nhiều yếu tố. Trong bóng đá, phân phối thống kê của số bàn thắng khá biến thiên. Đồng thời, số cơ hội ghi bàn trong mỗi trận tương đối ít so với các môn thể thao đồng đội dùng bóng khác, dẫn đến những kết quả khó lường.
Lấy ví dụ bóng ném: số cơ hội ghi bàn thường xuyên tạo ra các kết quả dễ dự đoán hơn vì số bàn thắng có xu hướng phản ánh việc tạo ra và ngăn chặn cơ hội khi số lần dứt điểm được trung bình hóa theo thời gian trận đấu. Còn trong bóng đá, đôi khi chỉ cần "dựng xe buýt" trước khung thành và thực hiện một pha phản công quyết đoán cũng đủ để xoay chuyển cục diện trận đấu.
Ngoài ra, các trận bóng đá có đặc trưng là phụ thuộc đường hướng rất cao, nghĩa là nhịp độ và kết quả trận đấu thường phụ thuộc rất nhiều vào bàn thắng đầu tiên. Những hành động nhỏ nhưng quan trọng có thể dẫn đến một bàn thắng hoặc thẻ đỏ và thay đổi hoàn toàn cục diện trận đấu, khiến việc dự đoán càng khó hơn.
Việc VAR (Trợ lý Trọng tài Video) được đưa vào những năm gần đây càng làm tăng tính khó lường, vì nó có thể đảo ngược các quyết định then chốt trên sân. Và đừng quên yếu tố khó nắm bắt là "phong độ ngày thi đấu", điều mà với tư cách là người hâm mộ Eintracht Frankfurt nổi tiếng thất thường (biệt danh rất đúng là "quý cô đỏng đảnh"), tôi có thể viết cả một cuốn sách.
Chiến lược khắc phục hạn chế dữ liệu
Bên cạnh các yếu tố đã thảo luận, mô hình dự đoán của tôi cũng đối mặt với một số hạn chế dữ liệu bổ sung cần xử lý.
- Thiếu dữ liệu theo cầu thủ: Không có dữ liệu chi tiết về cầu thủ, như sự hiện diện của các trụ cột, chỉ số hiệu suất cá nhân hoặc chấn thương, mô hình có thể bỏ lỡ các yếu tố quan trọng ảnh hưởng đến kết quả trận đấu. Mặc dù đội tuyển quốc gia không chịu biến động thị trường chuyển nhượng như các câu lạc bộ, thành phần đội hình thay đổi rất nhiều theo năm tháng, nên sẽ hữu ích nếu dữ liệu phản ánh điều đó.
- Thiếu dữ liệu trong trận: Thiếu các thống kê trong trận, như tỷ lệ cầm bóng hoặc tỷ lệ chuyền bóng chính xác, có thể làm giảm khả năng dự đoán chính xác của mô hình. Các điểm dữ liệu như phút và đội ghi bàn thắng đầu tiên của trận cũng sẽ giúp truy vết các mẫu liên quan đến tính phụ thuộc đường hướng đã nêu, từ đó dễ dự đoán hướng đi của trận đấu hơn.
Để xử lý các thách thức với dữ liệu sử dụng, tôi áp dụng một số chiến lược:
Bù khuyết dữ liệu thiếu
Tôi điền các điểm dữ liệu còn thiếu khi có thể để đảm bảo bộ dữ liệu vẫn toàn diện—ví dụ, bổ sung sơ đồ chiến thuật cho các trận cần dự đoán.
Vì hầu hết đội tuyển giữ nguyên sơ đồ khi đã được rèn luyện và thử nghiệm, tôi giả định mỗi đội sẽ chơi với sơ đồ họ dùng thường xuyên nhất trong 5 trận gần đây. Điều này cho phép chúng ta dự đoán trước khi đội hình xuất phát được công bố, vốn chỉ diễn ra một giờ trước khi trận bắt đầu.
Loại bỏ hoặc thay thế đặc trưng
Khi không thể bù khuyết hoặc loại bỏ, tôi loại trừ hoặc thay thế một số đặc trưng nhất định để tránh làm giảm độ chính xác của mô hình.
Ban đầu, tôi muốn thực hiện dự đoán hai tầng, trong đó dùng các đặc trưng sơ cấp để dự đoán các đặc trưng thứ cấp như cầm bóng và bàn thắng kỳ vọng, rồi dựa thêm vào các đặc trưng thứ cấp để dự đoán kết quả. Vì sự đơn giản, tôi đã không theo quy trình này, mà thay vào đó gán cho mỗi đội hai đặc trưng dựa trên thống kê trung bình trận để đại diện cho phong cách chơi.
Xóa dữ liệu thiếu
Khi không thể bù khuyết, tôi xóa dữ liệu thiếu để duy trì tính toàn vẹn của bộ dữ liệu. May mắn là chỉ mất một lượng nhỏ quan sát, nên bộ dữ liệu vẫn còn hơn 3.000 trận để xây dựng mô hình.
Chuỗi dữ liệu: Từ thu thập đến dự đoán
Sau khi giải quyết những khó khăn và hạn chế, hãy xem xét quy trình biến dữ liệu thô thành dự đoán có ý nghĩa. Chuỗi dữ liệu, xương sống của dự án, bao gồm thu thập, tiền xử lý và chuẩn bị dữ liệu cho mô hình, tận dụng nhiều đặc trưng chiến thuật, tâm lý và lịch sử.
Thu thập dữ liệu web
Bước đầu tiên là quét dữ liệu lịch sử các trận đấu từ nhiều nguồn, bao gồm Transfermarkt, để thu thập thông tin toàn diện về các trận đã qua.
Mỗi hàng trong DataFrame kết quả tương ứng với một trận từ góc nhìn của một trong hai đội tham gia. Dữ liệu này được kết hợp với dữ liệu từ FootyStats để bổ sung các đặc trưng phong cách chơi như cầm bóng trung bình và các chỉ số hiệu quả.
Để biết thêm chi tiết, hãy xem sổ tay thu thập dữ liệu tại đây.
Kỹ thuật đặc trưng
Tiếp theo, dữ liệu thô được chuyển đổi thành các đặc trưng có ý nghĩa để mô hình học máy sử dụng. Việc này bao gồm trích xuất giá trị, biến đổi biến và tính trung bình.
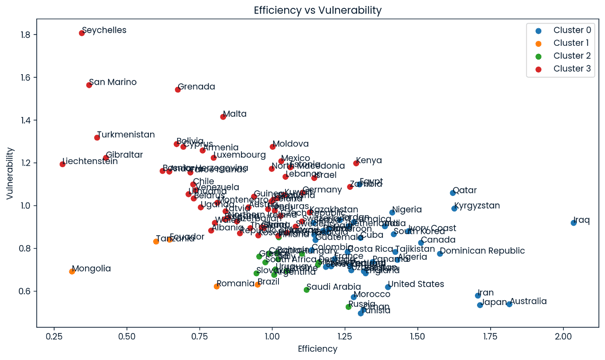
Các cụm về hiệu quả so với mức dễ tổn thương của tất cả đội trong bộ dữ liệu
Một số đặc trưng chủ chốt được xác định và sử dụng trong các mô hình để nâng cao độ chính xác của dự đoán. Bao gồm:
- Sơ đồ chiến thuật: Sơ đồ của cả hai đội và số tiền đạo, hậu vệ. Mục tiêu là xác định các mẫu kết quả giữa các sơ đồ phổ biến khác nhau và năng lực tấn công, phòng ngự của đội.
- Vị thế cửa trên/cửa dưới: Để đo lường đơn giản và khách quan, tôi dẫn xuất đặc trưng này từ cấp độ UEFA Nations League (và các khoảng xếp hạng FIFA tương ứng cho đội ngoài châu Âu) để chỉ ra đội nào được kỳ vọng chơi tốt hơn.
- Phong độ đội bóng: Số bàn thắng ghi được và bị thủng lưới trung bình trong 5 trận gần nhất cung cấp góc nhìn về mức độ tấn công và phòng thủ hiện tại của mỗi đội.
- Phong cách chơi: Cầm bóng trung bình và các cụm chỉ số hiệu quả so với mức dễ tổn thương (xem biểu đồ ở trên) được dùng để nắm bắt phong cách chơi của đội. Hiệu quả được tính là tỷ lệ giữa số bàn thắng và bàn thắng kỳ vọng (xG), cả với bàn tự ghi và bàn thua. Các cụm được huấn luyện chỉ trên các đội đã giành quyền tham dự, vì đó là các đội quan tâm, rồi áp dụng cho tất cả đội khác có ít nhất một trận trong bộ dữ liệu. Lưu ý rằng giá trị có thể sai lệch đáng kể với đội ngoài châu Âu do số trận hạn chế trong dữ liệu.
- Giai đoạn: Giai đoạn giải đấu (vòng bảng hay vòng loại trực tiếp) được đưa vào để tính đến mức độ áp lực khác nhau mà các đội phải đối mặt. Ý tưởng là phát hiện các mẫu thể hiện tùy theo tính chất quan trọng.
- Bản sắc đội và xu hướng dài hạn: Đặc trưng này giả định tồn tại một phần không thể giải thích được có thể nắm bắt như bản sắc của mỗi đội. Kết hợp với biến thời gian, đặc trưng này đại diện cho các yếu tố không được bao phủ bởi đặc trưng khác, cung cấp cái nhìn tổng thể về hiệu suất và xu hướng của đội.
Trước khi xây dựng mô hình học máy, bộ dữ liệu được tách thành các trận chưa đấu và đã đấu để phân biệt dữ liệu có nhãn và không nhãn. Hơn nữa, chúng tôi lấy log của các đặc trưng phong độ có phân phối lệch phải mạnh và áp dụng chuẩn hóa cùng mã hóa one-hot để đảm bảo dữ liệu ở dạng phù hợp.
Các biến theo đội bao gồm xu hướng dài hạn phải được scale bằng MinMaxScaler để ngăn các số 0 (đại diện cho các trận không có đội tương ứng) làm ảnh hưởng đến thang đo. Tất cả đặc trưng số khác được chuẩn hóa bằng StandardScaler.
Lựa chọn mô hình và triển khai quy trình
Để xác định các mô hình hiệu quả nhất cho dự đoán kết quả bóng đá, tôi bắt đầu với một tập rộng các mô hình học máy. Theo cách tiếp cận "hộp đen", tôi khám phá nhiều mô hình để hiểu điểm mạnh, điểm yếu của chúng khi xử lý dữ liệu. Với mỗi mô hình, tôi dùng phiên bản phân loại để dự đoán kết quả trận và phiên bản hồi quy để dự đoán số bàn của cả hai đội. Các mô hình tôi đã thử gồm:
- Random Forest
- Gradient Boosting
- Extreme Gradient Boosting (XGBoost)
- Support Vector Machine (SVM)
- K-Nearest Neighbors
- Extra Trees
- Adaptive Boosting (AdaBoost)
- Light Gradient Boosting Machine (LightGBM)
- Categorical Boosting (CatBoost)
- Hồi quy tuyến tính
Trước tiên, tôi đặt seed (số áo cũ của tôi, số chín) để tái lập kết quả. Việc xác định nhãn và mục tiêu cùng xây dựng mô hình gồm một số bước chính, tất cả đều so sánh hiệu năng mô hình bằng cross-validation:
- Đánh giá mô hình cơ sở: Tất cả mô hình nêu trên được khởi tạo, huấn luyện và đánh giá bằng Cross-Validation.
- Tinh chỉnh siêu tham số: Bước này tối ưu tham số của từng mô hình để nâng cao hiệu năng. Bằng cách tinh chỉnh, mô hình có thể thích ứng tốt hơn với dữ liệu và dự đoán chính xác hơn.
- Chọn lọc đặc trưng đệ quy: Kỹ thuật này được dùng để xác định các đặc trưng liên quan nhất. Nó giúp thu hẹp về những đặc trưng có tác động lớn nhất đến dự đoán, cải thiện hiệu quả và độ chính xác của mô hình. Tuy vậy, với một số nhãn, dự đoán tốt hơn khi dùng toàn bộ đặc trưng; trong trường hợp đó, tôi dùng phiên bản với tất cả đặc trưng.
Cuối cùng, tôi chọn các mô hình đạt hiệu năng tốt nhất dựa trên độ chính xác khi dự đoán kết quả (thắng/thua) và RMSE khi dự đoán số bàn thắng.
Tôi chọn hai mô hình cho kết quả trận: một để dự đoán thắng và thua, và một mô hình riêng cho hòa. Sự phân tách này là cần thiết vì các mẫu và yếu tố ảnh hưởng đến tỷ số hòa khác biệt đáng kể so với thắng và thua. Để đảm bảo tổng xác suất của ba kết quả (thắng, hòa, thua) bằng 100%, kết quả áp dụng mô hình sau đó được chuẩn hóa.
Áp dụng mô hình
Sử dụng các mô hình đã chọn với siêu tham số và đặc trưng tương ứng, tôi dự đoán tất cả nhãn cho mọi hàng dữ liệu. Vì mỗi trận cần dự đoán có hai hàng tương ứng, chúng ta nhận được hai xác suất cho mỗi kết cục trận và hai số thực là số bàn dự đoán cho mỗi đội.
Các giá trị này không nên khác nhau quá nhiều, và trong đa số trường hợp là vậy—nếu khác biệt lớn, chúng tôi gắn cờ trận đấu để biểu thị dự đoán cần được xem xét thận trọng. Để rút gọn về một giá trị cho mỗi nhãn, tôi lấy trung bình của hai giá trị dự đoán.
Với kết quả trận, tôi chuẩn hóa xác suất thắng, hòa, thua để đảm bảo tổng bằng 100%. Tôi cũng tạo thêm các cột để phản ánh các lựa chọn cược phổ biến như "kép cơ hội". Dựa trên số thực của số bàn thắng dự đoán cho mỗi đội, tôi khởi tạo phân phối Poisson và suy ra xác suất cho từng số bàn của mỗi đội và cho việc tổng số bàn của trận trên hay dưới 1.5, 2.5, 3.5, 4.5 và 5.5, vốn rất phổ biến khi đặt cược.
Với dự đoán tip, tôi chọn kết cục có xác suất cao nhất. Nếu xác suất thắng của hai đội chênh nhau trong phạm vi 0,05, tôi diễn giải là hòa. Với dự đoán số bàn, tôi chọn số bàn có khả năng cao nhất cho mỗi đội, điều chỉnh khi cần để khớp với kết cục dự đoán.
Để dự đoán các trận EURO sắp tới, tôi cập nhật dữ liệu thô về trận đấu bằng các kết quả dự đoán ban đầu. Bằng cách đưa các dự đoán này vào bộ dữ liệu và áp dụng lại kỹ thuật đặc trưng, tôi có thể dự đoán vòng tiếp theo dựa trên bối cảnh giải đấu đang thay đổi.
Đo lường hiệu năng mô hình: Độ chính xác vs. độ chuẩn xác
Hiểu sự khác biệt giữa accuracy (độ chính xác tổng thể) và precision (độ chuẩn xác) là rất quan trọng trong bối cảnh dự đoán bóng đá, đặc biệt khi xét tới cách áp dụng các dự đoán. Dùng ví dụ giữa đặt cược và tip có thể minh họa tầm quan trọng của các thước đo này:
Trong cá cược thể thao
Mục tiêu là tìm các kèo có kỳ vọng lợi nhuận dương. Điều này nghĩa là bạn cần xác định các kết quả khả dĩ và cân nhắc tỷ lệ do nhà cái đưa ra để tìm kèo giá trị.
Độ chuẩn xác là then chốt, vì nó tập trung vào tính đúng đắn của các dự đoán dương (ví dụ, dự đoán một trận thắng). Độ chuẩn xác cao giúp liên tục xác định các kèo bị nhà cái định giá thấp, tác động trực tiếp đến lợi nhuận.
Xin lưu ý rằng các công ty cá cược có cả đội ngũ xây dựng và duy trì những mô hình dự đoán rất tinh vi, và trong đa số trường hợp sẽ vượt trội so với một mô hình đơn giản như của tôi.
Trong cuộc thi dự đoán (tipping)
Mục tiêu là đoán chính xác kết quả từng trận. Người tham gia nhận điểm cho mỗi dự đoán đúng, với mục tiêu tích lũy nhiều điểm nhất qua loạt trận. Trong tình huống này, độ chính xác tổng thể quan trọng hơn vì nó đo lường tần suất dự đoán đúng, ảnh hưởng đến tổng điểm của bạn.
Dự đoán tỷ số hòa là ví dụ hoàn hảo về sự chênh lệch có thể có giữa hai thước đo. Chỉ khoảng 20% trận trong dữ liệu huấn luyện kết thúc với tỷ số hòa, khiến đa số mô hình đánh giá thấp khả năng hòa và đôi khi thậm chí không bao giờ dự đoán hòa.
Điều này dẫn đến tỷ lệ chính xác tổng thể cao khoảng 80% vì tất cả các trận không hòa đều được gán nhãn đúng, nhưng độ chuẩn xác bằng 0 cho hòa vì không trận hòa nào được dự đoán là hòa.
Kết quả hiệu năng mô hình
Hiệu năng của các mô hình thay đổi tùy loại dự đoán:
- Dự đoán kết quả
- CatBoost và AdaBoost: Hai mô hình này tốt nhất cho dự đoán thắng/thua, đạt accuracy tối đa 72% và precision 70%.
- SVC cho hòa: Mô hình này đạt accuracy 79% và precision 47%, tuy còn xa mức tối ưu nhưng là cải thiện đáng kể so với xuất phát điểm bằng không.
- Dự đoán số bàn
- CatBoost và Gradient Boosting: Hai mô hình này hoạt động tốt nhất cho dự đoán số bàn, với RMSE tối thiểu 1,19 bàn và điểm R2 tối đa 0,23. Dù các điểm số này cho thấy còn rất nhiều dư địa cải thiện, chúng vẫn tạo nền tảng vững cho dự đoán số bàn.
Vì dùng các mô hình khác nhau, có những trường hợp dự đoán kết quả và dự đoán số bàn không khớp. Dù khó so sánh thước đo hạng mục và số học, tôi cho rằng có thể nói dự đoán kết quả nhìn chung tốt hơn dự đoán số bàn, vì thế trong trường hợp bất nhất, dự đoán số bàn sẽ được điều chỉnh cho phù hợp với kết quả.
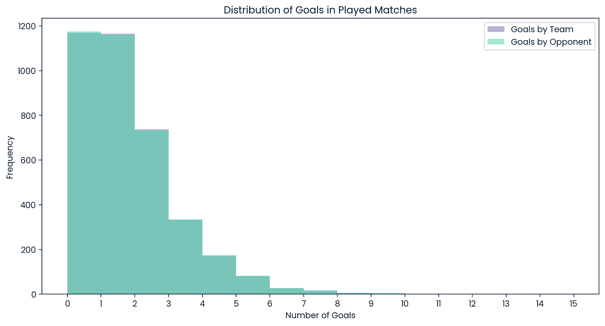
Phân phối số bàn trong tất cả các trận đã đấu
Đáng chú ý là mô hình hầu như chỉ dựa vào các tỷ số 0, 1 và 2 làm số bàn có khả năng nhất cho bất kỳ đội nào trong bất kỳ trận nào. Xét phân phối số bàn chung trong dữ liệu kiểm thử, điều này không có gì ngạc nhiên, nhưng cần nhớ rằng mô hình sẽ không bao giờ xem một trận có nhiều bàn là kết quả có khả năng nhất.
Dự đoán được vận hành: Các dự báo EURO 2024
Áp dụng các mô hình cho những trận EURO đầu tiên đã tạo ra các kết quả thú vị!
Vòng bảng
Trong ba phần tư trường hợp, mô hình dự đoán đội thắng là đội cửa trên, trong khi ở phần tư còn lại, kết quả dự đoán không phản ánh các đội cửa trên theo nhà cái.
Thoạt nhìn, tỷ lệ này có vẻ là một kèo tốt, vì có thể cho rằng sẽ có một số kết quả bất ngờ. Nhưng đây là phần khó, cũng là câu hỏi chung trong dự đoán bóng đá, bất kể bạn dùng trực giác hay mô hình học máy: Khi nào thì nên đặt cược vào cửa dưới?
Một chiến lược để đối phó là chỉ và luôn cược vào cửa trên. Nghĩa là bạn sẽ đoán sai một phần các bất ngờ, nhưng nhìn chung độ chính xác sẽ khá tốt. Cố gắng đoán cả những kết quả bất ngờ là cơ hội duy nhất để tối ưu độ chính xác cược của bạn, nhưng rõ ràng đó là chiến lược khó và rủi ro hơn.
Giả định tỷ lệ bất ngờ tương đối ổn định, mỗi sai lầm sẽ tính thành hai—với mỗi bất ngờ bạn đoán nhưng không xảy ra, bạn lại bỏ lỡ một bất ngờ khác khi cược vào cửa trên.
Tôi chọn cách tiếp cận rủi ro hơn, nhưng đến nay chưa gặt hái lợi ích lớn. Mô hình của tôi khá kém may mắn với các khả năng bất ngờ, dẫn đến độ chính xác khá thất vọng là 50% cho lượt đấu đầu tiên.
Chẳng hạn, mô hình dự đoán Serbia và Georgia, hai đội cửa dưới, sẽ lần lượt cầm hòa Anh và thắng Thổ Nhĩ Kỳ. Tuy nhiên, các đội cửa trên đều giành chiến thắng trong cả hai trường hợp. Ngược lại, mô hình đã không dự đoán được những bất ngờ thực sự như Slovakia thắng Bỉ, Romania thắng Ukraine 3:0 đầy ấn tượng, và Đan Mạch hòa Slovenia.
Các dự đoán sau đây được đưa ra sau lượt trận thứ hai, khi mỗi đội còn một trận vòng bảng. Kết quả gây ngạc nhiên nhất thuộc về bảng đấu thú vị nhất, ngay cả ở bảng E, nơi tất cả đội đều có cùng số điểm (3) khi còn một trận.
Theo mô hình, Slovakia được dự đoán sẽ thắng bảng sau chiến thắng 1:0 trước Romania do họ đã thắng Bỉ. Như vậy, Slovakia sẽ đẩy ứng viên số một của bảng xuống nhì. Mô hình thậm chí dự báo Slovakia là bất ngờ lớn nhất của giải, khi dự đoán họ sẽ thắng Áo và tiến vào tứ kết.
Vòng loại trực tiếp
Dự đoán cục diện cả giải đặc biệt thách thức do thể thức, trong đó các đội đứng thứ ba tốt nhất cũng vào vòng loại trực tiếp. Điều này tạo ra nhiều cặp đấu khả dĩ, bổ sung độ phức tạp tùy thuộc bốn đội thứ ba xuất sắc đến từ bảng nào. Vì vậy, hãy đón nhận các dự đoán sau với chút dè dặt—các cặp đấu có thể thay đổi hoàn toàn, ngay cả khi hiệu số bàn thắng bại của một đội chỉ thay đổi một bàn.
Các trận K.O. nhìn chung được dự đoán rất sít sao, với chiến thắng 2:0 của Tây Ban Nha trước Romania ở trận 1/8 có thể là trường hợp duy nhất có hiệu số kỳ vọng lớn hơn một.
Các trận của Italia đẩy sự sít sao lên cực điểm, với kết quả dự đoán là hòa cho hai trận K.O. đầu tiên của họ. Vì loạt luân lưu hiếm khi xảy ra và không có đủ dữ liệu để dự đoán đội thắng, tôi dựa vào ký ức về thành tích luân lưu tốt của Italia và kỳ vọng họ sẽ thắng cả hai loạt trước Thụy Sĩ và Anh.
Cuối cùng, mô hình dự đoán Tây Ban Nha, Bồ Đào Nha, Hà Lan và Italia sẽ vào bán kết.
Hà Lan và Tây Ban Nha tạo nên trận chung kết dự đoán của tôi, giống như năm 2010—có lẽ lịch sử sẽ lặp lại?
Bài học rút ra
Dự án này mang lại một số bài học chính:
- Dự đoán kết quả bóng đá đầy thách thức nhưng thú vị: Tính phụ thuộc đường hướng cao của trận đấu cùng tác động mạnh của các tình huống nhỏ khiến dự đoán khó nhưng cuốn hút.
- Quy trình là tối quan trọng: Cần có một quy trình bài bản ngay từ đầu. Lên kế hoạch luồng dữ liệu và cấu trúc sổ tay có thể tiết kiệm thời gian và tạo ra mã sạch, dễ đọc hơn. Cách tiếp cận này cũng đơn giản hóa việc khắc phục sự cố và nâng cao chất lượng tổng thể của dự án.
Để cải thiện dự đoán và mở rộng phạm vi dự án, có thể thực hiện một số bước:
- Nhiều dữ liệu hơn: Bổ sung thêm các trận có thể giúp nhận diện các mẫu giữa những đặc trưng khác nhau, nâng cao độ chính xác của mô hình. Bộ dữ liệu lớn hơn sẽ là nền tảng toàn diện hơn cho các mô hình dự đoán.
- Bổ sung đặc trưng: Thêm các đặc trưng mới có thể mang lại nhiều insight hơn:
- Kinh nghiệm: Bao gồm số trận quốc tế trung bình trên mỗi cầu thủ trong danh sách để chỉ ra mức độ kinh nghiệm của đội.
- Tỷ lệ trước trận: Phản ánh vị thế cửa trên trước trận bằng cách quét dữ liệu từ các trang nhà cái có thể bổ sung ngữ cảnh giá trị cho dự đoán. Tuy nhiên, có một số hạn chế vì tỷ lệ cược thay đổi khá thường xuyên. Dù vậy, cho một phân tích đơn giản về đội cửa trên và cửa dưới thì vẫn đủ.
- Mở rộng cách tiếp cận:
- Dữ liệu trong trận: Bao gồm các thống kê theo thời gian thực có thể cải thiện độ chuẩn xác của dự đoán. Các chỉ số như tỷ lệ cầm bóng, độ chính xác chuyền, chuyển động của cầu thủ có thể mang lại insight sâu hơn trong trận.
- Dữ liệu cầu thủ: Thông tin chi tiết theo cầu thủ, bao gồm chỉ số hiệu suất cá nhân và thể trạng, có thể mang lại cái nhìn sâu hơn về kết quả trận đấu.
Để biết thêm thông tin chi tiết và mã nguồn, vui lòng truy cập sổ tay dự án.
Kết luận
Bài đăng này cung cấp cái nhìn tổng quan về các thách thức và phương pháp luận khi dự đoán kết quả bóng đá, làm nổi bật hành trình và bài học từ dự án dự đoán EURO 2024.
Kết hợp khoa học dữ liệu và phân tích thể thao mang đến những cơ hội thú vị cho người đam mê và chuyên gia trong lĩnh vực này. Khi dự án tiếp tục phát triển, mục tiêu vẫn là tinh chỉnh các mô hình và mở rộng ứng dụng sang các giải đấu khác, đóng góp vào lĩnh vực phân tích thể thao đang lớn mạnh.
Nếu bạn muốn tìm hiểu thêm về phân tích thể thao, đây là một số tài nguyên bạn có thể thử:

 Matt Crabtree · 10 min
Năm 14 tuổi, tôi đặt cược bóng đá đầu tiên cho đội vô địch FIFA World Cup 2010. Chỉ dựa vào trực giác, tôi đoán từng trận và đặt cược vào hai đội lọt vào chung kết theo kế hoạch giải đấu của mình: Hà Lan và Tây Ban Nha. Cuối cùng, đúng là hai đội đó đã vào chung kết—tôi vô cùng phấn khích khi dự đoán của mình thành hiện thực.
Sau 14 năm, tôi tìm kiếm một dự án để đào sâu kỹ năng Python và học máy, và điều đó dẫn tôi đến một dự án dự đoán cho EURO 2024. Mục tiêu chính của tôi là dự đoán kết quả trận đấu (thắng, hòa hoặc thua) và số bàn thắng của mỗi đội.
Trong bài viết này, tôi cung cấp cái nhìn tổng quan về dự án dự đoán EURO 2024 của mình, nêu bật các bước quan trọng đã thực hiện, những thách thức gặp phải và các phát hiện thu được. Để đi sâu vào chi tiết kỹ thuật, bao gồm cả triển khai mã, vui lòng tham khảo sổ tay dự án đi kèm—bạn sẽ cần một tài khoản DataLab để truy cập tất cả tệp.
Thách thức khi dự đoán kết quả bóng đá
Dự đoán kết quả bóng đá nổi tiếng là khó do nhiều yếu tố. Trong bóng đá, phân phối thống kê của số bàn thắng khá biến thiên. Đồng thời, số cơ hội ghi bàn trong mỗi trận tương đối ít so với các môn thể thao đồng đội dùng bóng khác, dẫn đến những kết quả khó lường.
Lấy ví dụ bóng ném: số cơ hội ghi bàn thường xuyên tạo ra các kết quả dễ dự đoán hơn vì số bàn thắng có xu hướng phản ánh việc tạo ra và ngăn chặn cơ hội khi số lần dứt điểm được trung bình hóa theo thời gian trận đấu. Còn trong bóng đá, đôi khi chỉ cần "dựng xe buýt" trước khung thành và thực hiện một pha phản công quyết đoán cũng đủ để xoay chuyển cục diện trận đấu.
Ngoài ra, các trận bóng đá có đặc trưng là phụ thuộc đường hướng rất cao, nghĩa là nhịp độ và kết quả trận đấu thường phụ thuộc rất nhiều vào bàn thắng đầu tiên. Những hành động nhỏ nhưng quan trọng có thể dẫn đến một bàn thắng hoặc thẻ đỏ và thay đổi hoàn toàn cục diện trận đấu, khiến việc dự đoán càng khó hơn.
Việc VAR (Trợ lý Trọng tài Video) được đưa vào những năm gần đây càng làm tăng tính khó lường, vì nó có thể đảo ngược các quyết định then chốt trên sân. Và đừng quên yếu tố khó nắm bắt là "phong độ ngày thi đấu", điều mà với tư cách là người hâm mộ Eintracht Frankfurt nổi tiếng thất thường (biệt danh rất đúng là "quý cô đỏng đảnh"), tôi có thể viết cả một cuốn sách.
Chiến lược khắc phục hạn chế dữ liệu
Bên cạnh các yếu tố đã thảo luận, mô hình dự đoán của tôi cũng đối mặt với một số hạn chế dữ liệu bổ sung cần xử lý.
Để xử lý các thách thức với dữ liệu sử dụng, tôi áp dụng một số chiến lược:
Bù khuyết dữ liệu thiếu
Tôi điền các điểm dữ liệu còn thiếu khi có thể để đảm bảo bộ dữ liệu vẫn toàn diện—ví dụ, bổ sung sơ đồ chiến thuật cho các trận cần dự đoán.
Vì hầu hết đội tuyển giữ nguyên sơ đồ khi đã được rèn luyện và thử nghiệm, tôi giả định mỗi đội sẽ chơi với sơ đồ họ dùng thường xuyên nhất trong 5 trận gần đây. Điều này cho phép chúng ta dự đoán trước khi đội hình xuất phát được công bố, vốn chỉ diễn ra một giờ trước khi trận bắt đầu.
Loại bỏ hoặc thay thế đặc trưng
Khi không thể bù khuyết hoặc loại bỏ, tôi loại trừ hoặc thay thế một số đặc trưng nhất định để tránh làm giảm độ chính xác của mô hình.
Ban đầu, tôi muốn thực hiện dự đoán hai tầng, trong đó dùng các đặc trưng sơ cấp để dự đoán các đặc trưng thứ cấp như cầm bóng và bàn thắng kỳ vọng, rồi dựa thêm vào các đặc trưng thứ cấp để dự đoán kết quả. Vì sự đơn giản, tôi đã không theo quy trình này, mà thay vào đó gán cho mỗi đội hai đặc trưng dựa trên thống kê trung bình trận để đại diện cho phong cách chơi.
Xóa dữ liệu thiếu
Khi không thể bù khuyết, tôi xóa dữ liệu thiếu để duy trì tính toàn vẹn của bộ dữ liệu. May mắn là chỉ mất một lượng nhỏ quan sát, nên bộ dữ liệu vẫn còn hơn 3.000 trận để xây dựng mô hình.
Chuỗi dữ liệu: Từ thu thập đến dự đoán
Sau khi giải quyết những khó khăn và hạn chế, hãy xem xét quy trình biến dữ liệu thô thành dự đoán có ý nghĩa. Chuỗi dữ liệu, xương sống của dự án, bao gồm thu thập, tiền xử lý và chuẩn bị dữ liệu cho mô hình, tận dụng nhiều đặc trưng chiến thuật, tâm lý và lịch sử.
Thu thập dữ liệu web
Bước đầu tiên là quét dữ liệu lịch sử các trận đấu từ nhiều nguồn, bao gồm Transfermarkt, để thu thập thông tin toàn diện về các trận đã qua.
Mỗi hàng trong DataFrame kết quả tương ứng với một trận từ góc nhìn của một trong hai đội tham gia. Dữ liệu này được kết hợp với dữ liệu từ FootyStats để bổ sung các đặc trưng phong cách chơi như cầm bóng trung bình và các chỉ số hiệu quả.
Để biết thêm chi tiết, hãy xem sổ tay thu thập dữ liệu tại đây.
Kỹ thuật đặc trưng
Tiếp theo, dữ liệu thô được chuyển đổi thành các đặc trưng có ý nghĩa để mô hình học máy sử dụng. Việc này bao gồm trích xuất giá trị, biến đổi biến và tính trung bình.
Các cụm về hiệu quả so với mức dễ tổn thương của tất cả đội trong bộ dữ liệu
Một số đặc trưng chủ chốt được xác định và sử dụng trong các mô hình để nâng cao độ chính xác của dự đoán. Bao gồm:
Trước khi xây dựng mô hình học máy, bộ dữ liệu được tách thành các trận chưa đấu và đã đấu để phân biệt dữ liệu có nhãn và không nhãn. Hơn nữa, chúng tôi lấy log của các đặc trưng phong độ có phân phối lệch phải mạnh và áp dụng chuẩn hóa cùng mã hóa one-hot để đảm bảo dữ liệu ở dạng phù hợp.
Các biến theo đội bao gồm xu hướng dài hạn phải được scale bằng MinMaxScaler để ngăn các số 0 (đại diện cho các trận không có đội tương ứng) làm ảnh hưởng đến thang đo. Tất cả đặc trưng số khác được chuẩn hóa bằng StandardScaler.
Lựa chọn mô hình và triển khai quy trình
Để xác định các mô hình hiệu quả nhất cho dự đoán kết quả bóng đá, tôi bắt đầu với một tập rộng các mô hình học máy. Theo cách tiếp cận "hộp đen", tôi khám phá nhiều mô hình để hiểu điểm mạnh, điểm yếu của chúng khi xử lý dữ liệu. Với mỗi mô hình, tôi dùng phiên bản phân loại để dự đoán kết quả trận và phiên bản hồi quy để dự đoán số bàn của cả hai đội. Các mô hình tôi đã thử gồm:
Trước tiên, tôi đặt seed (số áo cũ của tôi, số chín) để tái lập kết quả. Việc xác định nhãn và mục tiêu cùng xây dựng mô hình gồm một số bước chính, tất cả đều so sánh hiệu năng mô hình bằng cross-validation:
Cuối cùng, tôi chọn các mô hình đạt hiệu năng tốt nhất dựa trên độ chính xác khi dự đoán kết quả (thắng/thua) và RMSE khi dự đoán số bàn thắng.
Tôi chọn hai mô hình cho kết quả trận: một để dự đoán thắng và thua, và một mô hình riêng cho hòa. Sự phân tách này là cần thiết vì các mẫu và yếu tố ảnh hưởng đến tỷ số hòa khác biệt đáng kể so với thắng và thua. Để đảm bảo tổng xác suất của ba kết quả (thắng, hòa, thua) bằng 100%, kết quả áp dụng mô hình sau đó được chuẩn hóa.
Áp dụng mô hình
Sử dụng các mô hình đã chọn với siêu tham số và đặc trưng tương ứng, tôi dự đoán tất cả nhãn cho mọi hàng dữ liệu. Vì mỗi trận cần dự đoán có hai hàng tương ứng, chúng ta nhận được hai xác suất cho mỗi kết cục trận và hai số thực là số bàn dự đoán cho mỗi đội.
Các giá trị này không nên khác nhau quá nhiều, và trong đa số trường hợp là vậy—nếu khác biệt lớn, chúng tôi gắn cờ trận đấu để biểu thị dự đoán cần được xem xét thận trọng. Để rút gọn về một giá trị cho mỗi nhãn, tôi lấy trung bình của hai giá trị dự đoán.
Với kết quả trận, tôi chuẩn hóa xác suất thắng, hòa, thua để đảm bảo tổng bằng 100%. Tôi cũng tạo thêm các cột để phản ánh các lựa chọn cược phổ biến như "kép cơ hội". Dựa trên số thực của số bàn thắng dự đoán cho mỗi đội, tôi khởi tạo phân phối Poisson và suy ra xác suất cho từng số bàn của mỗi đội và cho việc tổng số bàn của trận trên hay dưới 1.5, 2.5, 3.5, 4.5 và 5.5, vốn rất phổ biến khi đặt cược.
Với dự đoán tip, tôi chọn kết cục có xác suất cao nhất. Nếu xác suất thắng của hai đội chênh nhau trong phạm vi 0,05, tôi diễn giải là hòa. Với dự đoán số bàn, tôi chọn số bàn có khả năng cao nhất cho mỗi đội, điều chỉnh khi cần để khớp với kết cục dự đoán.
Để dự đoán các trận EURO sắp tới, tôi cập nhật dữ liệu thô về trận đấu bằng các kết quả dự đoán ban đầu. Bằng cách đưa các dự đoán này vào bộ dữ liệu và áp dụng lại kỹ thuật đặc trưng, tôi có thể dự đoán vòng tiếp theo dựa trên bối cảnh giải đấu đang thay đổi.
Đo lường hiệu năng mô hình: Độ chính xác vs. độ chuẩn xác
Hiểu sự khác biệt giữa accuracy (độ chính xác tổng thể) và precision (độ chuẩn xác) là rất quan trọng trong bối cảnh dự đoán bóng đá, đặc biệt khi xét tới cách áp dụng các dự đoán. Dùng ví dụ giữa đặt cược và tip có thể minh họa tầm quan trọng của các thước đo này:
Trong cá cược thể thao
Mục tiêu là tìm các kèo có kỳ vọng lợi nhuận dương. Điều này nghĩa là bạn cần xác định các kết quả khả dĩ và cân nhắc tỷ lệ do nhà cái đưa ra để tìm kèo giá trị.
Độ chuẩn xác là then chốt, vì nó tập trung vào tính đúng đắn của các dự đoán dương (ví dụ, dự đoán một trận thắng). Độ chuẩn xác cao giúp liên tục xác định các kèo bị nhà cái định giá thấp, tác động trực tiếp đến lợi nhuận.
Xin lưu ý rằng các công ty cá cược có cả đội ngũ xây dựng và duy trì những mô hình dự đoán rất tinh vi, và trong đa số trường hợp sẽ vượt trội so với một mô hình đơn giản như của tôi.
Trong cuộc thi dự đoán (tipping)
Mục tiêu là đoán chính xác kết quả từng trận. Người tham gia nhận điểm cho mỗi dự đoán đúng, với mục tiêu tích lũy nhiều điểm nhất qua loạt trận. Trong tình huống này, độ chính xác tổng thể quan trọng hơn vì nó đo lường tần suất dự đoán đúng, ảnh hưởng đến tổng điểm của bạn.
Dự đoán tỷ số hòa là ví dụ hoàn hảo về sự chênh lệch có thể có giữa hai thước đo. Chỉ khoảng 20% trận trong dữ liệu huấn luyện kết thúc với tỷ số hòa, khiến đa số mô hình đánh giá thấp khả năng hòa và đôi khi thậm chí không bao giờ dự đoán hòa.
Điều này dẫn đến tỷ lệ chính xác tổng thể cao khoảng 80% vì tất cả các trận không hòa đều được gán nhãn đúng, nhưng độ chuẩn xác bằng 0 cho hòa vì không trận hòa nào được dự đoán là hòa.
Kết quả hiệu năng mô hình
Hiệu năng của các mô hình thay đổi tùy loại dự đoán:
Vì dùng các mô hình khác nhau, có những trường hợp dự đoán kết quả và dự đoán số bàn không khớp. Dù khó so sánh thước đo hạng mục và số học, tôi cho rằng có thể nói dự đoán kết quả nhìn chung tốt hơn dự đoán số bàn, vì thế trong trường hợp bất nhất, dự đoán số bàn sẽ được điều chỉnh cho phù hợp với kết quả.
Phân phối số bàn trong tất cả các trận đã đấu
Đáng chú ý là mô hình hầu như chỉ dựa vào các tỷ số 0, 1 và 2 làm số bàn có khả năng nhất cho bất kỳ đội nào trong bất kỳ trận nào. Xét phân phối số bàn chung trong dữ liệu kiểm thử, điều này không có gì ngạc nhiên, nhưng cần nhớ rằng mô hình sẽ không bao giờ xem một trận có nhiều bàn là kết quả có khả năng nhất.
Dự đoán được vận hành: Các dự báo EURO 2024
Áp dụng các mô hình cho những trận EURO đầu tiên đã tạo ra các kết quả thú vị!
Vòng bảng
Trong ba phần tư trường hợp, mô hình dự đoán đội thắng là đội cửa trên, trong khi ở phần tư còn lại, kết quả dự đoán không phản ánh các đội cửa trên theo nhà cái.
Thoạt nhìn, tỷ lệ này có vẻ là một kèo tốt, vì có thể cho rằng sẽ có một số kết quả bất ngờ. Nhưng đây là phần khó, cũng là câu hỏi chung trong dự đoán bóng đá, bất kể bạn dùng trực giác hay mô hình học máy: Khi nào thì nên đặt cược vào cửa dưới?
Một chiến lược để đối phó là chỉ và luôn cược vào cửa trên. Nghĩa là bạn sẽ đoán sai một phần các bất ngờ, nhưng nhìn chung độ chính xác sẽ khá tốt. Cố gắng đoán cả những kết quả bất ngờ là cơ hội duy nhất để tối ưu độ chính xác cược của bạn, nhưng rõ ràng đó là chiến lược khó và rủi ro hơn.
Giả định tỷ lệ bất ngờ tương đối ổn định, mỗi sai lầm sẽ tính thành hai—với mỗi bất ngờ bạn đoán nhưng không xảy ra, bạn lại bỏ lỡ một bất ngờ khác khi cược vào cửa trên.
Tôi chọn cách tiếp cận rủi ro hơn, nhưng đến nay chưa gặt hái lợi ích lớn. Mô hình của tôi khá kém may mắn với các khả năng bất ngờ, dẫn đến độ chính xác khá thất vọng là 50% cho lượt đấu đầu tiên.
Chẳng hạn, mô hình dự đoán Serbia và Georgia, hai đội cửa dưới, sẽ lần lượt cầm hòa Anh và thắng Thổ Nhĩ Kỳ. Tuy nhiên, các đội cửa trên đều giành chiến thắng trong cả hai trường hợp. Ngược lại, mô hình đã không dự đoán được những bất ngờ thực sự như Slovakia thắng Bỉ, Romania thắng Ukraine 3:0 đầy ấn tượng, và Đan Mạch hòa Slovenia.
Các dự đoán sau đây được đưa ra sau lượt trận thứ hai, khi mỗi đội còn một trận vòng bảng. Kết quả gây ngạc nhiên nhất thuộc về bảng đấu thú vị nhất, ngay cả ở bảng E, nơi tất cả đội đều có cùng số điểm (3) khi còn một trận.
Theo mô hình, Slovakia được dự đoán sẽ thắng bảng sau chiến thắng 1:0 trước Romania do họ đã thắng Bỉ. Như vậy, Slovakia sẽ đẩy ứng viên số một của bảng xuống nhì. Mô hình thậm chí dự báo Slovakia là bất ngờ lớn nhất của giải, khi dự đoán họ sẽ thắng Áo và tiến vào tứ kết.
Vòng loại trực tiếp
Dự đoán cục diện cả giải đặc biệt thách thức do thể thức, trong đó các đội đứng thứ ba tốt nhất cũng vào vòng loại trực tiếp. Điều này tạo ra nhiều cặp đấu khả dĩ, bổ sung độ phức tạp tùy thuộc bốn đội thứ ba xuất sắc đến từ bảng nào. Vì vậy, hãy đón nhận các dự đoán sau với chút dè dặt—các cặp đấu có thể thay đổi hoàn toàn, ngay cả khi hiệu số bàn thắng bại của một đội chỉ thay đổi một bàn.
Các trận K.O. nhìn chung được dự đoán rất sít sao, với chiến thắng 2:0 của Tây Ban Nha trước Romania ở trận 1/8 có thể là trường hợp duy nhất có hiệu số kỳ vọng lớn hơn một.
Các trận của Italia đẩy sự sít sao lên cực điểm, với kết quả dự đoán là hòa cho hai trận K.O. đầu tiên của họ. Vì loạt luân lưu hiếm khi xảy ra và không có đủ dữ liệu để dự đoán đội thắng, tôi dựa vào ký ức về thành tích luân lưu tốt của Italia và kỳ vọng họ sẽ thắng cả hai loạt trước Thụy Sĩ và Anh.
Cuối cùng, mô hình dự đoán Tây Ban Nha, Bồ Đào Nha, Hà Lan và Italia sẽ vào bán kết.
Hà Lan và Tây Ban Nha tạo nên trận chung kết dự đoán của tôi, giống như năm 2010—có lẽ lịch sử sẽ lặp lại?
Bài học rút ra
Dự án này mang lại một số bài học chính:
Để cải thiện dự đoán và mở rộng phạm vi dự án, có thể thực hiện một số bước:
Để biết thêm thông tin chi tiết và mã nguồn, vui lòng truy cập sổ tay dự án.
Kết luận
Bài đăng này cung cấp cái nhìn tổng quan về các thách thức và phương pháp luận khi dự đoán kết quả bóng đá, làm nổi bật hành trình và bài học từ dự án dự đoán EURO 2024.
Kết hợp khoa học dữ liệu và phân tích thể thao mang đến những cơ hội thú vị cho người đam mê và chuyên gia trong lĩnh vực này. Khi dự án tiếp tục phát triển, mục tiêu vẫn là tinh chỉnh các mô hình và mở rộng ứng dụng sang các giải đấu khác, đóng góp vào lĩnh vực phân tích thể thao đang lớn mạnh.
Nếu bạn muốn tìm hiểu thêm về phân tích thể thao, đây là một số tài nguyên bạn có thể thử: