14 yaşıma geldiğimde, ilk futbol bahsimi 2010 FIFA Dünya Kupası şampiyonu üzerine yaptım. Yalnızca sezgilere güvenerek her maçı tahmin ettim ve turnuva planımdaki iki finaliste, Hollanda ve İspanya’ya, bahis oynadım. Sonunda bu iki takım finale kaldı—tahminlerimin doğru çıkmasına çok sevindim.
Aradan 14 yıl geçtikten sonra, Python ve makine öğrenimi becerilerimi derinleştireceğim bir proje aradım ve bu da beni EURO 2024 için bir tahmin projesine götürdü. Ana hedefim, maç sonuçlarını (galibiyet, beraberlik veya mağlubiyet) ve her takımın atacağı gol sayısını tahmin etmekti.
Bu yazıda, EURO 2024 tahmin projemin genel bir özetini sunuyor, attığım temel adımları, karşılaştığım zorlukları ve edindiğim içgörüleri vurguluyorum. Kod uygulaması da dahil olmak üzere teknik ayrıntılara daha derinlemesine dalmak için lütfen eşlik eden not defteri projesine bakın—tüm dosyalara erişmek için bir DataLab hesabına ihtiyacınız olacak.
Futbol Sonuçlarını Tahmin Etmenin Zorlukları
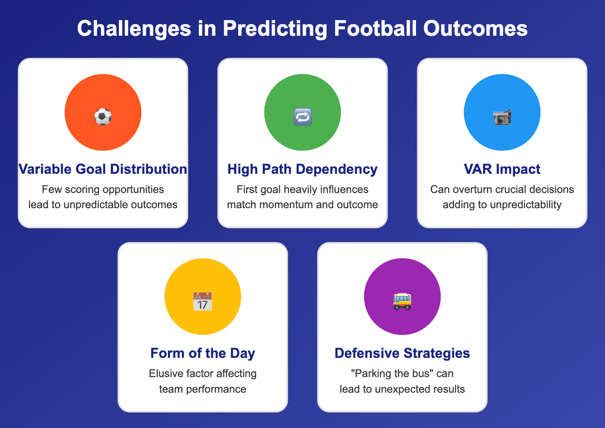
Futbol sonuçlarını tahmin etmek, çeşitli etkenler nedeniyle ünlü derecede zordur. Futbolda gollerin istatistiksel dağılımı oldukça değişkendir. Aynı zamanda, diğer takım sporlarına kıyasla maç başına nispeten az sayıda gol pozisyonu vardır; bu da öngörülemeyen sonuçlara yol açar.
Örneğin hentbolu ele alalım: Sık gol pozisyonları, maç boyunca denemelerin ortalaması alındıkça, gollerin sayısı pozisyon üretimi ve önlemesini daha iyi yansıttığından, daha öngörülebilir sonuçlar üretme eğilimindedir. Futbolda ise bazen kalenizin önüne “otobüs çekmek” ve kararlı bir kontra atak oynamak maçı tersine çevirmek için yeterli olabilir.
Buna ek olarak, futbol maçları yüksek yol bağımlılığı ile karakterize edilir; yani maçın ivmesi ve sonucu genellikle ilk gole büyük ölçüde bağlıdır. Küçük ama anlamlı eylemler bir gole veya kırmızı karta yol açarak maçın gidişatını dramatik biçimde değiştirebilir; bu da tahminleri daha da zorlaştırır.
Son yıllarda VAR’ın (Video Yardımcı Hakem) devreye girmesi de öngörülemezliği artırdı; çünkü sahadaki kritik kararları bozabiliyor. Ve bir de ele avuca sığmayan "günün formu" var ki, namı diğer "huysuz diva" lakaplı, ünlü derecede öngörülemez Eintracht Frankfurt taraftarı olarak bunun hakkında bir kitap yazabilirim.
Veri Kısıtlarını Aşma Stratejileri
Tartışılan etkenlerin yanı sıra, tahmin modelim ele almam gereken birkaç ek veri kısıtıyla da karşı karşıya.
- Oyuncuya özgü veri eksikliği: Kilit oyuncuların varlığı, bireysel performans metrikleri veya sakatlıklar gibi ayrıntılı oyuncu verileri olmadan, model maç sonucunu etkileyen kritik etkenleri gözden kaçırabilir. Milli takımlar, kulüpler gibi transfer piyasasının oynaklığına maruz kalmasalar da kadro yapıları yıllar içinde epey değişir; bu nedenle verinin bunu yansıtması faydalı olurdu.
- Maç içi veri eksikliği: Topa sahip olma yüzdeleri veya pas isabet oranları gibi maç içi istatistiklerin yokluğu, modelin isabetli tahmin yapma kabiliyetini azaltabilir. İlk golün atıldığı dakika ve takım gibi veri noktaları da bahsedilen yol bağımlılığına dair örüntüleri izlemeye yardımcı olur, böylece maçın hangi yöne evrilebileceğini tahmin etmeyi kolaylaştırır.
Kullanılan verilerle ilgili zorlukları ele almak için birkaç strateji uygulandı:
Eksik veriyi değer atama ile tamamlama
Veri kümesinin kapsamlı kalmasını sağlamak için mümkün olan yerlerde eksik veri noktalarını doldurdum—örneğin, tahmin edilecek maçlar için taktik dizilişleri ekledim.
Çoğu takım, çalışıp denedikten sonra aynı dizilişe sadık kaldığından, her takımın son beş maçında en sık kullandığı dizilişle oynayacağını varsaydım. Bu sayede, yalnızca maçtan bir saat önce açıklanan ilk 11 kamuya duyurulmadan önce maçları tahmin edebiliyoruz.
Özellikleri hariç tutma veya değiştirme
Ne değer atamanın ne de kaldırmanın pratik olmadığı durumlarda, modelin doğruluğunu zedelememek için bazı özellikleri hariç tuttum veya değiştirdim.
Örneğin başlangıçta, birincil özelliklerden topa sahip olma ve beklenen gol (xG) gibi ikincil özellikleri tahmin eden ve sonucu bu ikincil özelliklere göre de öngören iki seviyeli bir tahmin yapmak istiyordum. Basitlik adına bu yaklaşımdan vazgeçtim ve bunun yerine her takıma, oyun tarzlarını temsil etmek üzere maç başına ortalama istatistiklere dayalı iki özellik atadım.
Eksik veriyi kaldırma
Değer atamanın mümkün olmadığı yerlerde, veri kümesinin bütünlüğünü korumak için eksik verileri kaldırdım. Neyse ki gözlem kaybı azdı; bu nedenle veri kümesi model kurmak için 3.000’in üzerinde maçı içeriyordu.
Veri Boru Hattı: Toplamadan Tahmine
Zorlukları ve kısıtları ele aldıktan sonra, ham veriyi anlamlı tahminlere dönüştürme sürecine bakalım. Projenin omurgası olan veri boru hattı; verilerin toplanmasını, ön işlenmesini ve modellere hazırlanmasını kapsıyor ve çeşitli taktiksel, psikolojik ve tarihsel özelliklerden yararlanıyor.
Veri kazıma
İlk adım, geçmiş maçlar hakkında kapsamlı bilgi toplamak için Transfermarkt da dahil olmak üzere çeşitli kaynaklardan tarihsel maç verilerini kazımayı içeriyordu.
Ortaya çıkan DataFrame’deki her satır, maçta yer alan takımlardan birinin bakış açısından tek bir maça karşılık gelir. Bu veriler, ortalama topa sahip olma ve verimlilik metrikleri gibi oyun tarzı özelliklerini eklemek için FootyStats verileriyle birleştirildi.
Daha fazla ayrıntı için veri kazıma not defterine buradan göz atın.
Özellik geliştirme
Devamında, ham veriler makine öğrenimi modelleri tarafından kullanılabilecek anlamlı özelliklere dönüştürüldü. Bu, değerlerin çıkarılmasını, değişkenlerin dönüştürülmesini ve ortalamaların hesaplanmasını içerdi.
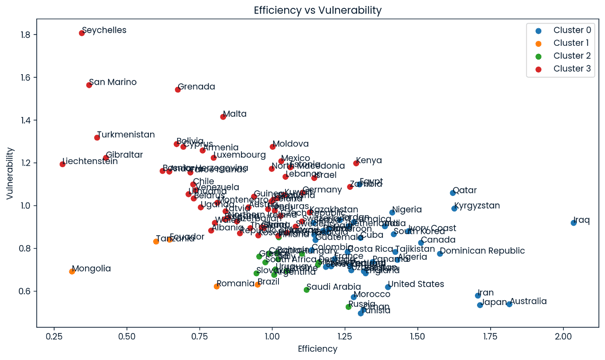
Veri kümesindeki tüm takımların verimlilik ve kırılganlık kümeleri
Bir dizi kilit özellik belirlendi ve tahminlerin doğruluğunu artırmak için modellerde kullanıldı. Bu özellikler şunları içeriyordu:
- Taktik dizilişler: Her iki takımın dizilişi ile forvet ve savunmacı sayıları. Amaç, çeşitli popüler dizilişler ile takımın hücum ve savunma kabiliyetleri arasındaki sonuç örüntülerini belirlemekti.
- Favori/sürpriz (underdog) durumu: Bunu basit ve nesnel biçimde ölçmek için bu özelliği, hangi takımın daha iyi performans göstermesinin beklendiğini belirtmek üzere UEFA Uluslar Ligi seviyelerinden (Avrupa dışı takımlar için karşılık gelen FIFA Dünya Sıralaması aralıklarıyla) türettim.
- Takım formu: Son beş maçta atılan ve yenilen ortalama goller, her takımın mevcut hücum ve savunma performans düzeyine ışık tuttu.
- Oyun stili: Ortalama topa sahip olma ve verimlilik ile kırılganlık metriklerinin kümeleri (bkz. üstteki grafik) bir takımın oyun tarzını yakalamak için kullanıldı. Verimlilik, gerek atılan gerek yenilen goller için gollerin beklenen gollere (xG) oranı olarak hesaplandı. Kümeler yalnızca eleme aşamasına kalan takımlar üzerinde (ilgi alanımız olanlar) uyduruldu ve ardından veri kümesinde en az bir maçı olan diğer tüm takımlara uygulandı. Lütfen, veri azlığı nedeniyle Avrupa dışı takımlarda bu değerin epey sapabileceğini not edin.
- Aşama: Turnuva aşaması (grup aşaması veya eleme turları), takımların karşı karşıya kaldığı farklı baskı düzeylerini hesaba katmak için dahil edildi. Amaç, riske bağlı olarak performanslardaki örüntüleri keşfetmekti.
- Takım özü ve uzun vadeli eğilimler: Bu özellik, her takımın özünü yakalayabilecek açıklanamaz bir kalıntı olduğu varsayımına dayanır. Bir zaman değişkeniyle birleştirildiğinde, bu özellik diğer özelliklerin kapsamadığı unsurları temsil ederek takımın genel performansına ve eğilimlerine kapsamlı bir bakış sağlar.
Makine öğrenimi modellerini kurmadan önce, etiketli ve etiketsiz veriyi ayırt etmek için veri kümesi oynanmamış ve oynanmış maçlar olarak ayrılır. Ayrıca, sağa çarpık form özelliklerinin logaritmasını alır ve verinin uygun biçimde olmasını sağlamak için normalleştirme ve one-hot kodlama uygularız.
Uzun vadeli eğilim dahil takım değişkenleri, ilgili takımın yer almadığı maçları temsil eden sıfırların ölçeği etkilemesini önlemek için MinMaxScaler ile ölçeklendirilmelidir. Diğer tüm sayısal özellikler StandardScaler kullanılarak normalize edilir.
Model Seçimi ve İş Akışı Uygulaması
Futbol sonuçlarını tahmin etmek için en etkili modelleri belirlemek amacıyla geniş bir makine öğrenimi modeli yelpazesiyle başladım. Bir "siyah kutu" yaklaşımı benimseyerek, veriyi ele alışlarındaki güçlü ve zayıf yönlerini anlamak için çeşitli modelleri keşfettim. Her model için, maç sonuçlarını tahmin etmek üzere sınıflandırma sürümünü ve her iki takımın atacağı gol sayısını tahmin etmek üzere regresyon sürümünü kullandım. Test ettiğim modeller şunlardı:
- Random Forest
- Gradient Boosting
- Extreme Gradient Boosting (XGBoost)
- Support Vector Machine (SVM)
- K-En Yakın Komşular
- Extra Trees
- Adaptive Boosting (AdaBoost)
- Light Gradient Boosting Machine (LightGBM)
- Categorical Boosting (CatBoost)
- Doğrusal Regresyon
Öncelikle, tekrarlanabilirlik için bir tohum (eski forma numaram, dokuz) belirledim. Etiketlerin ve hedeflerin tanımlanması ile model kurma, tamamı çapraz doğrulama ile model performanslarının karşılaştırılmasını içeren birkaç temel adımdan oluşuyordu:
- Temel modelleri değerlendirme: Tüm bahsi geçen modeller başlatıldı, uyarlandı ve Çapraz Doğrulama kullanılarak değerlendirildi.
- Hiperparametre ayarlama: Bu adım, her modelin performansını artırmak için parametrelerinin optimize edilmesini içeriyordu. Bu parametreleri ince ayarlayarak, modeller veriye daha iyi uyum sağlayıp daha doğru tahminler yapabildi.
- Özyinelemeli özellik seçimi: En ilgili özellikleri belirlemek için özyinelemeli özellik seçimi kullanıldı. Bu teknik, tahminler üzerinde en büyük etkiye sahip özelliklere daraltmaya yardımcı olarak modellerin verimliliğini ve doğruluğunu artırdı. Ancak, bazı etiketlerin tahminleri tüm özellikler kullanıldığında daha iyiydi; böyle bir durumda tüm özellikleri içeren sürümü kullandım.
Sonuçta, maç sonuçlarını (kazanma/kaybetme) tahmin etmedeki hassasiyetleri ve gol sayısını tahmin etmedeki Kök Ortalama Kare Hatası (RMSE) temel alınarak en iyi performans gösteren modelleri seçtim.
Maç sonuçları için iki model seçtim: biri galibiyet ve mağlubiyetleri, diğeri özel olarak beraberlikleri tahmin etmek için. Bu ayrım gerekliydi; çünkü beraberlikleri etkileyen örüntüler ve etkenler, galibiyet ve mağlubiyetleri etkileyenlerden önemli ölçüde farklıdır. Üç sonucun (galibiyet, beraberlik, mağlubiyet) olasılıklarının toplamının %100 olmasını sağlamak için model uygulaması sonuçları daha sonra normalize edildi.
Model Uygulaması
Seçilen modelleri, hiperparametrelerini ve özelliklerini kullanarak her satır için tüm etiketleri tahmin ediyorum. Tahmin edilecek her maç için iki satır olduğundan, her maç sonucu için iki olasılık ve her takım için tahmin edilen gollere ilişkin iki ondalık sayı elde ediyoruz.
Bu değerlerin birbirinden çok fazla sapmaması gerekir ve çoğu durumda sapmaz—ancak saparsa, tahmine bir miktar şüpheyle yaklaşılması gerektiğini belirtmek için maçı işaretliyoruz. Her etikete tek bir değere indirgemek için iki tahminin ortalamasını alıyorum.
Maç sonuçları için galibiyet, beraberlik ve mağlubiyet olasılıklarını topları %100 olacak şekilde normalize ettim. Ayrıca, "çifte şans" gibi popüler bahis seçeneklerini yakalamak için ek sütunlar oluşturdum. Takım başına tahmin edilen gol sayısının ondalık değeri temelinde bir Poisson dağılımı başlatıyor ve her takım için her gol sayısının olasılıklarını ve toplam gol sayısının 1,5, 2,5, 3,5, 4,5 ve 5,5 üzerinde mi altında mı olduğuna dair olasılıkları türetiyorum; bunlar bahislerde oldukça popülerdir.
Tahmin seçimlerimde, en yüksek olasılığa sahip sonucu tercih ettim. Her iki takımın kazanma olasılıkları birbirine 0,05 içinde ise bunu beraberlik olarak yorumladım. Gol tahminlerinde, her takım için en olası gol sayısını seçtim ve tahmin edilen sonuçla uyumlu olacak şekilde gerektiğinde sayıları ayarladım.
Gelecekteki EURO maçlarını tahmin etmek için ham maç verilerini başlangıçtaki tahmin edilen sonuçlarla güncelledim. Bu tahminleri veri kümesine dahil edip özellik mühendisliğini yeniden uygulayarak, gelişen turnuva dinamiklerine göre bir sonraki tur maçlarını da tahmin edebildim.
Futbol tahminleri bağlamında doğruluk (accuracy) ile kesinlik (precision) arasındaki farkı anlamak, özellikle bu tahminlerin uygulamasını düşünürken kritiktir. Bunu, örnek olarak bahis ve tahmin (tipping) karşılaştırmasıyla açıklayabiliriz:
Spor bahislerinde
Amaç, beklenen getirinin pozitif olduğu bahisleri bulmaktır. Bu, olası sonuçları belirlemeniz ve değer bahsi bulmak için bahis şirketlerinin sunduğu oranları dikkate almanız gerektiği anlamına gelir.
Burada kesinlik çok önemlidir; çünkü olumlu tahminlerin (ör. galibiyet tahmini) doğruluğuna odaklanır. Yüksek kesinlik, bahis şirketlerince düşük fiyatlanan bahisleri tutarlı biçimde belirlemeye yardımcı olur ve kârlılığı doğrudan etkiler.
Unutmayın ki bahis şirketlerinin, çoğu durumda benimkisi gibi daha basit bir modeli muhtemelen alt edecek son derece sofistike tahmin modellerini kurup sürdüren koca ekipleri vardır.
Tahmin yarışmalarında
Amaç, her maçın sonucunu doğru tahmin etmektir. Katılımcılar her doğru tahmin için puan kazanır ve hedef, bir dizi maç boyunca en çok puanı toplamaktır. Bu senaryoda genel doğruluk daha önemlidir; çünkü tahminlerinizin ne sıklıkla doğru olduğunu ölçer ve toplam puanınızı etkiler.
Beraberlik tahmini, bu iki ölçüm arasındaki olası farkın mükemmel bir örneğidir. Eğitim verisindeki maçların yalnızca yaklaşık %20’si beraberlikle sona erdi; bu da çoğu modelin beraberlik olasılığını hafife almasına ve bazen hiç beraberlik tahmin etmemesine yol açtı.
Bu da, beraberlik dışındaki tüm sonuçlar doğru etiketlendiği için yaklaşık %80 doğruluk oranına, fakat hiçbir beraberlik beraberlik olarak tahmin edilmediği için beraberliklerde 0 kesinliğe neden olur.
Modellerin performansı, tahmin türüne göre değişiklik gösterdi:
- Sonuç Tahminleri
- CatBoost ve AdaBoost: Bu modeller, kazanma/kaybetme sonuçlarını tahmin etmede en iyilerdi; maksimum %72 doğruluk ve %70 kesinlik elde edildi.
- Beraberlikler için SVC: Bu model %79 doğruluk ve %47 kesinliğe ulaştı; mükemmel olmaktan uzak olsa da sıfırdan önemli bir iyileşme.
- Gol Tahminleri
- CatBoost ve Gradient Boosting: Bu modeller, golleri tahmin etmede en iyi performansı gösterdi; minimum 1,19 gol RMSE ve maksimum 0,23 R2 skoru elde edildi. Bu skorlar büyük bir iyileştirme alanına işaret etse de gol tahminleri için sağlam bir temel sağladı.
Farklı modeller kullanıldığından, sonuç ve gol tahminlerinin uyuşmadığı durumlar vardır. Kategorik ve sayısal skorları karşılaştırmak zor olsa da genel olarak sonuç tahminlerinin gol tahminlerinden daha iyi çalıştığını söylemek adil; bu nedenle uyumsuzluk halinde ikincisi birincisine göre ayarlanır.
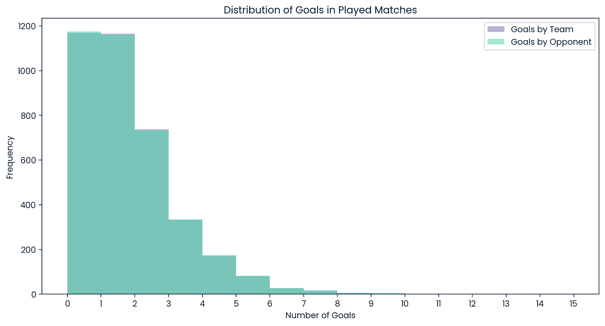
Oynanan Tüm Maçlardaki Gol Dağılımı
Modelin, herhangi bir takım için herhangi bir maçta en olası gol sayısı olarak yalnızca sıfır, bir ve ikiye başvurması dikkat çekicidir. Test verilerindeki genel gol dağılımı göz önüne alındığında bu şaşırtıcı değildir; ancak modelin birçok gollü bir maçı hiçbir zaman en olası sonuç olarak beklemeyeceği akılda tutulmalıdır.
Tahminlerin Sahada Karşılığı: EURO 2024 Öngörüleri
Modelleri ilk EURO maçlarına uygulamak ilginç sonuçlar üretti!
Grup aşaması
Vakaların dörtte üçünde model kazanan olarak favori takımı öngördü; kalan dörtte birinde ise tahmin edilen sonuç bahisçilerin favorilerini yansıtmadı.
İlk bakışta bu oran iyi bir bahis gibi göründü; zira belirli sayıda sürprizin olacağını varsaymak makul. Ama işin zor kısmı burada başlıyor ve bu, ister kalbinizle ister makine öğrenimi modeliyle tahmin yapın, futbolda genel bir sorudur: Ne zaman sürpriz (underdog) üzerine bahis oynamak mantıklıdır?
Bununla başa çıkmanın bir stratejisi yalnızca ve daima favoriye oynamaktır. Bu, sürprizlerin bir kısmında yanılacağınız anlamına gelir; ancak genel doğruluğunuz oldukça iyi olur. Beklenmedik sonuçları da tahmin etmeye çalışmak, bahislerinizin doğruluğunu optimize etmenin tek yoludur; fakat açıkça daha zor ve riskli bir stratejidir.
Sürpriz oranının kabaca sabit olduğunu varsayarsak, her hata iki kere sayılır—gerçekleşmeyen her sürpriz tahmininde, favoriye oynayarak kaçırdığınız bir sürpriz daha vardır.
Ben daha riskli yaklaşımı seçtim; ancak şu ana kadar büyük getiri sağlamadı. Modelim, olası sürprizler konusunda epey şanssızdı ve ilk maç haftasında %50 gibi hayal kırıklığı yaratan bir doğruluğa yol açtı.
Örneğin model, iki sürpriz takımdan Sırbistan’ın İngiltere ile berabere kalacağını, Gürcistan’ın ise Türkiye’yi yeneceğini tahmin etmişti. Ancak her iki durumda da favoriler kazandı. Öte yandan model, Slovakya’nın Belçika karşısındaki galibiyeti, Romanya’nın Ukrayna karşısında şaşırtan 3:0’lık zaferi ve Danimarka’nın Slovenya ile beraberliği gibi gerçek sürprizleri öngöremedi.
Aşağıdaki tahminler, her takımın bir grup maçı kaldığı ikinci maç gününün ardından yapıldı. En şaşırtıcı sonuç, tüm takımların birer maçı kalmışken aynı puana (3) sahip olduğu en ilginç grup olan E Grubu için çıktı.
Modele göre Slovakya, Belçika’yı yendiği için Romanya karşısında 1:0’lık bir galibiyetle grubu lider tamamlayacak. Böylece Slovakya, grubun büyük favorisini ikinci sıraya itmiş olacak. Model, Slovakya’yı turnuvanın en büyük sürprizi olarak da görüyor; Avusturya’yı yenip çeyrek finale çıkacaklarını öngörüyor.
Eleme turları
Turnuvanın tüm seyrine ilişkin tahmin format nedeniyle özellikle zorluydu; zira en iyi üçüncüler de eleme turlarına kalıyor. Bu da, en iyi dört üçüncü takımın hangi gruplardan geldiğine bağlı olarak çeşitli olası eşleşmeleri devreye sokuyor ve karmaşıklığı artırıyor. Dolayısıyla aşağıdaki tahminlere bir nebze ihtiyatla yaklaşın—bir takımın averajı yalnızca bir gol değişse bile eşleşmeler tamamen değişebilir.
K.O. maçları genel olarak çok başa baş öngörülüyor; olası 1/8 finalde İspanya’nın Romanya karşısında 2:0’lık galibiyeti, beklenen gol farkının birden büyük olduğu tek maç.
İtalya’nın maçları ise yakınlığı uç noktaya taşıyor; ilk iki K.O. maçları için tahmin edilen sonuç beraberlik. Penaltı atışları nadir olduğundan ve kazananlarını tahmin etmek için yeterli veri bulunmadığından, hafızamdaki iyi İtalyan penaltı geçmişine dayanarak İtalya’nın hem İsviçre hem de İngiltere karşısındaki penaltı atışlarını kazanacağını varsaydım.
Sonunda model, yarı finallere İspanya, Portekiz, Hollanda ve İtalya’nın ulaşacağını öngörüyor.
Tahmin ettiğim finali Hollanda ve İspanya oluşturuyor; tıpkı 2010’daki gibi—tarih tekerrür eder mi dersiniz?
Önemli Çıkarımlar
Bu proje birkaç önemli çıkarım sağladı:
- Futbol sonuçlarını tahmin etmek zor ama eğlenceli: Futbol maçlarının yüksek yol bağımlılığı ve küçük anlık olayların güçlü etkisi, futbol tahminlerini zor ama cezbedici kılar.
- İş akışı kritik önemde: Baştan iyi yapılandırılmış bir iş akışına sahip olmak esastır. Veri akışını ve çalışma kitabı yapısını planlamak zaman kazandırır ve daha temiz, daha okunabilir kod üretir. Bu yaklaşım, sorun gidermeyi de basitleştirir ve projenin genel kalitesini artırır.
Tahminleri iyileştirmek ve projenin kapsamını genişletmek için birkaç adım atılabilir:
- Daha fazla veri: Daha fazla maçın dahil edilmesi, farklı özellikler arasındaki örüntülerin tanınmasına yardımcı olarak modelin doğruluğunu artırabilir. Daha büyük bir veri kümesi, tahmin modelleri için daha kapsamlı bir temel sağlar.
- Ek özellikler: Yeni özellikler eklemek daha fazla içgörü sağlayabilir:
- Deneyim: Kadrodaki oyuncu başına ortalama milli maç sayısının eklenmesi, takımın deneyim düzeyini gösterebilir.
- Maç önü oranlar: Favori statüsünü maça başlamadan önce yansıtmak için bahis sitelerinden veri kazımak, tahminlere değerli bir bağlam katabilir. Ancak, oranların oldukça sık değiştiği için bazı sınırlamalar vardır. Yine de kimin favori, kimin sürpriz aday olduğunu basitçe analiz etmek için yeterli olmalıdır.
- Genişletilmiş yaklaşım:
- Maç içi veri: Gerçek zamanlı maç istatistiklerini dahil etmek tahminlerin kesinliğini artırabilir. Topa sahip olma yüzdesi, pas isabeti ve oyuncu hareketleri gibi metrikler, maç sırasında daha derin içgörüler sunabilir.
- Oyuncu verisi: Bireysel performans metrikleri ve kondisyon düzeyleri dahil ayrıntılı oyuncu bilgileri, maç sonuçlarına dair daha derin içgörüler sağlayabilir.
Daha ayrıntılı bilgi ve kod için lütfen proje not defterini ziyaret edin.
Sonuç
Bu blog yazısı, futbol sonuçlarını tahmin etmede karşılaşılan zorluklara ve kullanılan yöntemlere genel bir bakış sunuyor; EURO 2024 tahmin projesindeki yolculuğu ve çıkarımları öne çıkarıyor.
Veri bilimi ile spor analitiğinin entegrasyonu, bu alandaki meraklılar ve profesyoneller için heyecan verici fırsatlar sunuyor. Proje gelişmeye devam ederken amaç, modelleri rafine etmek ve uygulamalarını diğer turnuvalara genişleterek spor analitiği alanının büyümesine katkıda bulunmak.
Spor analitiği hakkında daha fazla bilgi edinmek isterseniz, deneyebileceğiniz bazı kaynaklar:

 Dario Radečić · 15 min

 Abid Ali Awan · 14 min

 Kurtis Pykes · 8 min


14 yaşıma geldiğimde, ilk futbol bahsimi 2010 FIFA Dünya Kupası şampiyonu üzerine yaptım. Yalnızca sezgilere güvenerek her maçı tahmin ettim ve turnuva planımdaki iki finaliste, Hollanda ve İspanya’ya, bahis oynadım. Sonunda bu iki takım finale kaldı—tahminlerimin doğru çıkmasına çok sevindim.
Aradan 14 yıl geçtikten sonra, Python ve makine öğrenimi becerilerimi derinleştireceğim bir proje aradım ve bu da beni EURO 2024 için bir tahmin projesine götürdü. Ana hedefim, maç sonuçlarını (galibiyet, beraberlik veya mağlubiyet) ve her takımın atacağı gol sayısını tahmin etmekti.
Bu yazıda, EURO 2024 tahmin projemin genel bir özetini sunuyor, attığım temel adımları, karşılaştığım zorlukları ve edindiğim içgörüleri vurguluyorum. Kod uygulaması da dahil olmak üzere teknik ayrıntılara daha derinlemesine dalmak için lütfen eşlik eden not defteri projesine bakın—tüm dosyalara erişmek için bir DataLab hesabına ihtiyacınız olacak.
Futbol Sonuçlarını Tahmin Etmenin Zorlukları
Futbol sonuçlarını tahmin etmek, çeşitli etkenler nedeniyle ünlü derecede zordur. Futbolda gollerin istatistiksel dağılımı oldukça değişkendir. Aynı zamanda, diğer takım sporlarına kıyasla maç başına nispeten az sayıda gol pozisyonu vardır; bu da öngörülemeyen sonuçlara yol açar.
Örneğin hentbolu ele alalım: Sık gol pozisyonları, maç boyunca denemelerin ortalaması alındıkça, gollerin sayısı pozisyon üretimi ve önlemesini daha iyi yansıttığından, daha öngörülebilir sonuçlar üretme eğilimindedir. Futbolda ise bazen kalenizin önüne “otobüs çekmek” ve kararlı bir kontra atak oynamak maçı tersine çevirmek için yeterli olabilir.
Buna ek olarak, futbol maçları yüksek yol bağımlılığı ile karakterize edilir; yani maçın ivmesi ve sonucu genellikle ilk gole büyük ölçüde bağlıdır. Küçük ama anlamlı eylemler bir gole veya kırmızı karta yol açarak maçın gidişatını dramatik biçimde değiştirebilir; bu da tahminleri daha da zorlaştırır.
Son yıllarda VAR’ın (Video Yardımcı Hakem) devreye girmesi de öngörülemezliği artırdı; çünkü sahadaki kritik kararları bozabiliyor. Ve bir de ele avuca sığmayan "günün formu" var ki, namı diğer "huysuz diva" lakaplı, ünlü derecede öngörülemez Eintracht Frankfurt taraftarı olarak bunun hakkında bir kitap yazabilirim.
Veri Kısıtlarını Aşma Stratejileri
Tartışılan etkenlerin yanı sıra, tahmin modelim ele almam gereken birkaç ek veri kısıtıyla da karşı karşıya.
Kullanılan verilerle ilgili zorlukları ele almak için birkaç strateji uygulandı:
Eksik veriyi değer atama ile tamamlama
Veri kümesinin kapsamlı kalmasını sağlamak için mümkün olan yerlerde eksik veri noktalarını doldurdum—örneğin, tahmin edilecek maçlar için taktik dizilişleri ekledim.
Çoğu takım, çalışıp denedikten sonra aynı dizilişe sadık kaldığından, her takımın son beş maçında en sık kullandığı dizilişle oynayacağını varsaydım. Bu sayede, yalnızca maçtan bir saat önce açıklanan ilk 11 kamuya duyurulmadan önce maçları tahmin edebiliyoruz.
Özellikleri hariç tutma veya değiştirme
Ne değer atamanın ne de kaldırmanın pratik olmadığı durumlarda, modelin doğruluğunu zedelememek için bazı özellikleri hariç tuttum veya değiştirdim.
Örneğin başlangıçta, birincil özelliklerden topa sahip olma ve beklenen gol (xG) gibi ikincil özellikleri tahmin eden ve sonucu bu ikincil özelliklere göre de öngören iki seviyeli bir tahmin yapmak istiyordum. Basitlik adına bu yaklaşımdan vazgeçtim ve bunun yerine her takıma, oyun tarzlarını temsil etmek üzere maç başına ortalama istatistiklere dayalı iki özellik atadım.
Eksik veriyi kaldırma
Değer atamanın mümkün olmadığı yerlerde, veri kümesinin bütünlüğünü korumak için eksik verileri kaldırdım. Neyse ki gözlem kaybı azdı; bu nedenle veri kümesi model kurmak için 3.000’in üzerinde maçı içeriyordu.
Veri Boru Hattı: Toplamadan Tahmine
Zorlukları ve kısıtları ele aldıktan sonra, ham veriyi anlamlı tahminlere dönüştürme sürecine bakalım. Projenin omurgası olan veri boru hattı; verilerin toplanmasını, ön işlenmesini ve modellere hazırlanmasını kapsıyor ve çeşitli taktiksel, psikolojik ve tarihsel özelliklerden yararlanıyor.
Veri kazıma
İlk adım, geçmiş maçlar hakkında kapsamlı bilgi toplamak için Transfermarkt da dahil olmak üzere çeşitli kaynaklardan tarihsel maç verilerini kazımayı içeriyordu.
Ortaya çıkan DataFrame’deki her satır, maçta yer alan takımlardan birinin bakış açısından tek bir maça karşılık gelir. Bu veriler, ortalama topa sahip olma ve verimlilik metrikleri gibi oyun tarzı özelliklerini eklemek için FootyStats verileriyle birleştirildi.
Daha fazla ayrıntı için veri kazıma not defterine buradan göz atın.
Özellik geliştirme
Devamında, ham veriler makine öğrenimi modelleri tarafından kullanılabilecek anlamlı özelliklere dönüştürüldü. Bu, değerlerin çıkarılmasını, değişkenlerin dönüştürülmesini ve ortalamaların hesaplanmasını içerdi.
Veri kümesindeki tüm takımların verimlilik ve kırılganlık kümeleri
Bir dizi kilit özellik belirlendi ve tahminlerin doğruluğunu artırmak için modellerde kullanıldı. Bu özellikler şunları içeriyordu:
Makine öğrenimi modellerini kurmadan önce, etiketli ve etiketsiz veriyi ayırt etmek için veri kümesi oynanmamış ve oynanmış maçlar olarak ayrılır. Ayrıca, sağa çarpık form özelliklerinin logaritmasını alır ve verinin uygun biçimde olmasını sağlamak için normalleştirme ve one-hot kodlama uygularız.
Uzun vadeli eğilim dahil takım değişkenleri, ilgili takımın yer almadığı maçları temsil eden sıfırların ölçeği etkilemesini önlemek için MinMaxScaler ile ölçeklendirilmelidir. Diğer tüm sayısal özellikler StandardScaler kullanılarak normalize edilir.
Model Seçimi ve İş Akışı Uygulaması
Futbol sonuçlarını tahmin etmek için en etkili modelleri belirlemek amacıyla geniş bir makine öğrenimi modeli yelpazesiyle başladım. Bir "siyah kutu" yaklaşımı benimseyerek, veriyi ele alışlarındaki güçlü ve zayıf yönlerini anlamak için çeşitli modelleri keşfettim. Her model için, maç sonuçlarını tahmin etmek üzere sınıflandırma sürümünü ve her iki takımın atacağı gol sayısını tahmin etmek üzere regresyon sürümünü kullandım. Test ettiğim modeller şunlardı:
Öncelikle, tekrarlanabilirlik için bir tohum (eski forma numaram, dokuz) belirledim. Etiketlerin ve hedeflerin tanımlanması ile model kurma, tamamı çapraz doğrulama ile model performanslarının karşılaştırılmasını içeren birkaç temel adımdan oluşuyordu:
Sonuçta, maç sonuçlarını (kazanma/kaybetme) tahmin etmedeki hassasiyetleri ve gol sayısını tahmin etmedeki Kök Ortalama Kare Hatası (RMSE) temel alınarak en iyi performans gösteren modelleri seçtim.
Maç sonuçları için iki model seçtim: biri galibiyet ve mağlubiyetleri, diğeri özel olarak beraberlikleri tahmin etmek için. Bu ayrım gerekliydi; çünkü beraberlikleri etkileyen örüntüler ve etkenler, galibiyet ve mağlubiyetleri etkileyenlerden önemli ölçüde farklıdır. Üç sonucun (galibiyet, beraberlik, mağlubiyet) olasılıklarının toplamının %100 olmasını sağlamak için model uygulaması sonuçları daha sonra normalize edildi.
Model Uygulaması
Seçilen modelleri, hiperparametrelerini ve özelliklerini kullanarak her satır için tüm etiketleri tahmin ediyorum. Tahmin edilecek her maç için iki satır olduğundan, her maç sonucu için iki olasılık ve her takım için tahmin edilen gollere ilişkin iki ondalık sayı elde ediyoruz.
Bu değerlerin birbirinden çok fazla sapmaması gerekir ve çoğu durumda sapmaz—ancak saparsa, tahmine bir miktar şüpheyle yaklaşılması gerektiğini belirtmek için maçı işaretliyoruz. Her etikete tek bir değere indirgemek için iki tahminin ortalamasını alıyorum.
Maç sonuçları için galibiyet, beraberlik ve mağlubiyet olasılıklarını topları %100 olacak şekilde normalize ettim. Ayrıca, "çifte şans" gibi popüler bahis seçeneklerini yakalamak için ek sütunlar oluşturdum. Takım başına tahmin edilen gol sayısının ondalık değeri temelinde bir Poisson dağılımı başlatıyor ve her takım için her gol sayısının olasılıklarını ve toplam gol sayısının 1,5, 2,5, 3,5, 4,5 ve 5,5 üzerinde mi altında mı olduğuna dair olasılıkları türetiyorum; bunlar bahislerde oldukça popülerdir.
Tahmin seçimlerimde, en yüksek olasılığa sahip sonucu tercih ettim. Her iki takımın kazanma olasılıkları birbirine 0,05 içinde ise bunu beraberlik olarak yorumladım. Gol tahminlerinde, her takım için en olası gol sayısını seçtim ve tahmin edilen sonuçla uyumlu olacak şekilde gerektiğinde sayıları ayarladım.
Gelecekteki EURO maçlarını tahmin etmek için ham maç verilerini başlangıçtaki tahmin edilen sonuçlarla güncelledim. Bu tahminleri veri kümesine dahil edip özellik mühendisliğini yeniden uygulayarak, gelişen turnuva dinamiklerine göre bir sonraki tur maçlarını da tahmin edebildim.
Model Performansını Ölçmek: Doğruluk ve Kesinlik
Futbol tahminleri bağlamında doğruluk (accuracy) ile kesinlik (precision) arasındaki farkı anlamak, özellikle bu tahminlerin uygulamasını düşünürken kritiktir. Bunu, örnek olarak bahis ve tahmin (tipping) karşılaştırmasıyla açıklayabiliriz:
Spor bahislerinde
Amaç, beklenen getirinin pozitif olduğu bahisleri bulmaktır. Bu, olası sonuçları belirlemeniz ve değer bahsi bulmak için bahis şirketlerinin sunduğu oranları dikkate almanız gerektiği anlamına gelir.
Burada kesinlik çok önemlidir; çünkü olumlu tahminlerin (ör. galibiyet tahmini) doğruluğuna odaklanır. Yüksek kesinlik, bahis şirketlerince düşük fiyatlanan bahisleri tutarlı biçimde belirlemeye yardımcı olur ve kârlılığı doğrudan etkiler.
Unutmayın ki bahis şirketlerinin, çoğu durumda benimkisi gibi daha basit bir modeli muhtemelen alt edecek son derece sofistike tahmin modellerini kurup sürdüren koca ekipleri vardır.
Tahmin yarışmalarında
Amaç, her maçın sonucunu doğru tahmin etmektir. Katılımcılar her doğru tahmin için puan kazanır ve hedef, bir dizi maç boyunca en çok puanı toplamaktır. Bu senaryoda genel doğruluk daha önemlidir; çünkü tahminlerinizin ne sıklıkla doğru olduğunu ölçer ve toplam puanınızı etkiler.
Beraberlik tahmini, bu iki ölçüm arasındaki olası farkın mükemmel bir örneğidir. Eğitim verisindeki maçların yalnızca yaklaşık %20’si beraberlikle sona erdi; bu da çoğu modelin beraberlik olasılığını hafife almasına ve bazen hiç beraberlik tahmin etmemesine yol açtı.
Bu da, beraberlik dışındaki tüm sonuçlar doğru etiketlendiği için yaklaşık %80 doğruluk oranına, fakat hiçbir beraberlik beraberlik olarak tahmin edilmediği için beraberliklerde 0 kesinliğe neden olur.
Model Performans Sonuçları
Modellerin performansı, tahmin türüne göre değişiklik gösterdi:
Farklı modeller kullanıldığından, sonuç ve gol tahminlerinin uyuşmadığı durumlar vardır. Kategorik ve sayısal skorları karşılaştırmak zor olsa da genel olarak sonuç tahminlerinin gol tahminlerinden daha iyi çalıştığını söylemek adil; bu nedenle uyumsuzluk halinde ikincisi birincisine göre ayarlanır.
Oynanan Tüm Maçlardaki Gol Dağılımı
Modelin, herhangi bir takım için herhangi bir maçta en olası gol sayısı olarak yalnızca sıfır, bir ve ikiye başvurması dikkat çekicidir. Test verilerindeki genel gol dağılımı göz önüne alındığında bu şaşırtıcı değildir; ancak modelin birçok gollü bir maçı hiçbir zaman en olası sonuç olarak beklemeyeceği akılda tutulmalıdır.
Tahminlerin Sahada Karşılığı: EURO 2024 Öngörüleri
Modelleri ilk EURO maçlarına uygulamak ilginç sonuçlar üretti!
Grup aşaması
Vakaların dörtte üçünde model kazanan olarak favori takımı öngördü; kalan dörtte birinde ise tahmin edilen sonuç bahisçilerin favorilerini yansıtmadı.
İlk bakışta bu oran iyi bir bahis gibi göründü; zira belirli sayıda sürprizin olacağını varsaymak makul. Ama işin zor kısmı burada başlıyor ve bu, ister kalbinizle ister makine öğrenimi modeliyle tahmin yapın, futbolda genel bir sorudur: Ne zaman sürpriz (underdog) üzerine bahis oynamak mantıklıdır?
Bununla başa çıkmanın bir stratejisi yalnızca ve daima favoriye oynamaktır. Bu, sürprizlerin bir kısmında yanılacağınız anlamına gelir; ancak genel doğruluğunuz oldukça iyi olur. Beklenmedik sonuçları da tahmin etmeye çalışmak, bahislerinizin doğruluğunu optimize etmenin tek yoludur; fakat açıkça daha zor ve riskli bir stratejidir.
Sürpriz oranının kabaca sabit olduğunu varsayarsak, her hata iki kere sayılır—gerçekleşmeyen her sürpriz tahmininde, favoriye oynayarak kaçırdığınız bir sürpriz daha vardır.
Ben daha riskli yaklaşımı seçtim; ancak şu ana kadar büyük getiri sağlamadı. Modelim, olası sürprizler konusunda epey şanssızdı ve ilk maç haftasında %50 gibi hayal kırıklığı yaratan bir doğruluğa yol açtı.
Örneğin model, iki sürpriz takımdan Sırbistan’ın İngiltere ile berabere kalacağını, Gürcistan’ın ise Türkiye’yi yeneceğini tahmin etmişti. Ancak her iki durumda da favoriler kazandı. Öte yandan model, Slovakya’nın Belçika karşısındaki galibiyeti, Romanya’nın Ukrayna karşısında şaşırtan 3:0’lık zaferi ve Danimarka’nın Slovenya ile beraberliği gibi gerçek sürprizleri öngöremedi.
Aşağıdaki tahminler, her takımın bir grup maçı kaldığı ikinci maç gününün ardından yapıldı. En şaşırtıcı sonuç, tüm takımların birer maçı kalmışken aynı puana (3) sahip olduğu en ilginç grup olan E Grubu için çıktı.
Modele göre Slovakya, Belçika’yı yendiği için Romanya karşısında 1:0’lık bir galibiyetle grubu lider tamamlayacak. Böylece Slovakya, grubun büyük favorisini ikinci sıraya itmiş olacak. Model, Slovakya’yı turnuvanın en büyük sürprizi olarak da görüyor; Avusturya’yı yenip çeyrek finale çıkacaklarını öngörüyor.
Eleme turları
Turnuvanın tüm seyrine ilişkin tahmin format nedeniyle özellikle zorluydu; zira en iyi üçüncüler de eleme turlarına kalıyor. Bu da, en iyi dört üçüncü takımın hangi gruplardan geldiğine bağlı olarak çeşitli olası eşleşmeleri devreye sokuyor ve karmaşıklığı artırıyor. Dolayısıyla aşağıdaki tahminlere bir nebze ihtiyatla yaklaşın—bir takımın averajı yalnızca bir gol değişse bile eşleşmeler tamamen değişebilir.
K.O. maçları genel olarak çok başa baş öngörülüyor; olası 1/8 finalde İspanya’nın Romanya karşısında 2:0’lık galibiyeti, beklenen gol farkının birden büyük olduğu tek maç.
İtalya’nın maçları ise yakınlığı uç noktaya taşıyor; ilk iki K.O. maçları için tahmin edilen sonuç beraberlik. Penaltı atışları nadir olduğundan ve kazananlarını tahmin etmek için yeterli veri bulunmadığından, hafızamdaki iyi İtalyan penaltı geçmişine dayanarak İtalya’nın hem İsviçre hem de İngiltere karşısındaki penaltı atışlarını kazanacağını varsaydım.
Sonunda model, yarı finallere İspanya, Portekiz, Hollanda ve İtalya’nın ulaşacağını öngörüyor.
Tahmin ettiğim finali Hollanda ve İspanya oluşturuyor; tıpkı 2010’daki gibi—tarih tekerrür eder mi dersiniz?
Önemli Çıkarımlar
Bu proje birkaç önemli çıkarım sağladı:
Tahminleri iyileştirmek ve projenin kapsamını genişletmek için birkaç adım atılabilir:
Daha ayrıntılı bilgi ve kod için lütfen proje not defterini ziyaret edin.
Sonuç
Bu blog yazısı, futbol sonuçlarını tahmin etmede karşılaşılan zorluklara ve kullanılan yöntemlere genel bir bakış sunuyor; EURO 2024 tahmin projesindeki yolculuğu ve çıkarımları öne çıkarıyor.
Veri bilimi ile spor analitiğinin entegrasyonu, bu alandaki meraklılar ve profesyoneller için heyecan verici fırsatlar sunuyor. Proje gelişmeye devam ederken amaç, modelleri rafine etmek ve uygulamalarını diğer turnuvalara genişleterek spor analitiği alanının büyümesine katkıda bulunmak.
Spor analitiği hakkında daha fazla bilgi edinmek isterseniz, deneyebileceğiniz bazı kaynaklar: