

Corso
Capire il Machine Learning
2 ore
313.7K
Pratica and corso your progress.
Continua Con GoogleA 14 anni ho fatto la mia prima scommessa calcistica sul vincitore della Coppa del Mondo FIFA 2010. Affidandomi solo all'intuizione, ho indovinato partita per partita e puntato sulle due finaliste del mio tabellone: Paesi Bassi e Spagna. Alla fine, quelle due squadre sono arrivate davvero in finale—ero entusiasta che le mie previsioni si fossero avverate.
Quattordici anni dopo, cercavo un progetto per approfondire le mie competenze in Python e machine learning, e questo mi ha portato a un progetto di previsione per EURO 2024. Il mio obiettivo principale era prevedere i risultati delle partite (vittoria, pareggio o sconfitta) e il numero di gol segnati da ciascuna squadra.
In questo articolo offro una panoramica del mio progetto di previsione per EURO 2024, evidenziando i passaggi chiave che ho seguito, le sfide incontrate e gli insight ottenuti. Per un approfondimento tecnico, inclusa l'implementazione del codice, consulta il notebook di accompagnamento—ti servirà un account DataLab per accedere a tutti i file.
Prevedere i risultati nel calcio è notoriamente difficile per diversi motivi. Nel calcio, la distribuzione statistica dei gol è piuttosto variabile. Allo stesso tempo, ci sono relativamente poche occasioni da gol per partita rispetto ad altri sport di squadra con palla, il che porta a esiti imprevedibili.
Prendi la pallamano, per esempio: le frequenti occasioni da rete tendono a produrre risultati più prevedibili perché il numero di gol riflette più facilmente la creazione e la prevenzione delle occasioni, dato che i tentativi di segnare si livellano nel corso della gara. Nel calcio, però, a volte può bastare “parcheggiare il pullman” davanti alla propria porta e giocare un contropiede deciso per ribaltare la partita.
Inoltre, le partite di calcio sono caratterizzate da alta dipendenza dal percorso, cioè l'inerzia e l'esito della gara dipendono spesso in modo marcato dal primo gol. Piccole ma significative azioni possono portare a un gol o a un cartellino rosso e cambiare drasticamente l'andamento del match, rendendo le previsioni ancora più difficili.
L'introduzione del VAR (Video Assistant Referee) negli ultimi anni ha aggiunto ulteriore imprevedibilità, perché può ribaltare decisioni cruciali in campo. E non dimentichiamo l'elusiva "forma del giorno", un fattore su cui potrei scrivere un libro come tifoso della notoriamente imprevedibile Eintracht Frankfurt (soprannominata a ragione la "diva capricciosa").
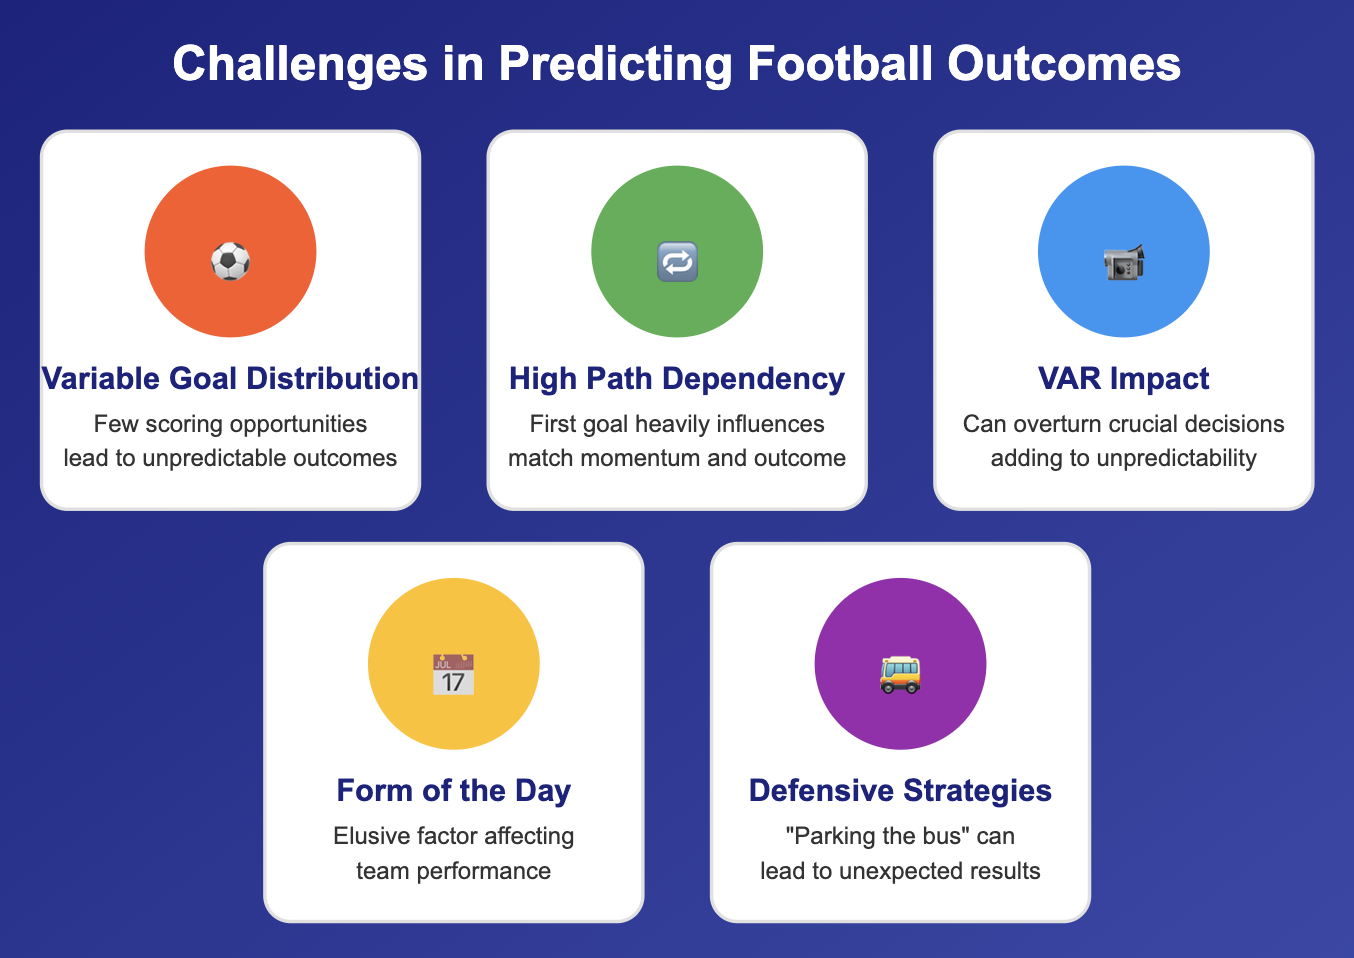
Oltre ai fattori discussi, il mio modello di previsione deve affrontare ulteriori limitazioni dei dati che devo gestire.
Per affrontare le criticità dei dati utilizzati, ho adottato diverse strategie:
Ho colmato i valori mancanti dove possibile per mantenere il dataset completo—ad esempio aggiungendo le formazioni tattiche delle partite da prevedere.
Poiché la maggior parte delle squadre mantiene la stessa formazione una volta che l'ha allenata e testata, ho assunto che ciascuna squadra giochi con la formazione usata più spesso nelle ultime cinque partite. Questo ci permette di fare previsioni prima che le formazioni ufficiali diventino pubbliche, cosa che accade solo un'ora prima del calcio d'inizio.
Quando l'imputazione né la rimozione erano praticabili, ho escluso o sostituito alcune feature per non compromettere l'accuratezza del modello.
In origine, per esempio, volevo fare una previsione a due livelli che prendesse le feature primarie per prevedere feature secondarie come possesso palla e expected goals, per poi prevedere l'esito anche in base a queste feature secondarie. Per semplicità ho rinunciato a questa procedura e ho assegnato a ciascuna squadra due feature basate su statistiche medie di partita per rappresentarne lo stile di gioco.
Dove l'imputazione non era fattibile, ho rimosso i dati mancanti per mantenere l'integrità del dataset. Per fortuna, la perdita di osservazioni è stata minima, quindi il dataset conteneva ancora oltre 3.000 partite per costruire il modello.
Affrontate difficoltà e limitazioni, vediamo come trasformare i dati grezzi in previsioni utili. La data pipeline, ossatura del progetto, ha previsto la raccolta, il pre-processing e la preparazione dei dati per il modeling, sfruttando diverse feature tattiche, psicologiche e storiche.
Il primo passo è stato il scraping di dati storici delle partite da varie fonti, tra cui Transfermarkt, per raccogliere informazioni complete sulle gare passate.
Una riga del DataFrame risultante corrisponde a una partita dal punto di vista di una delle due squadre coinvolte. Questi dati sono stati combinati con quelli di FootyStats per includere feature sullo stile di gioco, come possesso palla medio e metriche di efficienza.
Per maggiori dettagli, consulta il notebook di scraping dei dati qui.
Successivamente, i dati grezzi sono stati trasformati in feature significative utilizzabili dai modelli di machine learning. Ciò ha comportato l'estrazione di valori, la trasformazione di variabili e il calcolo di medie.
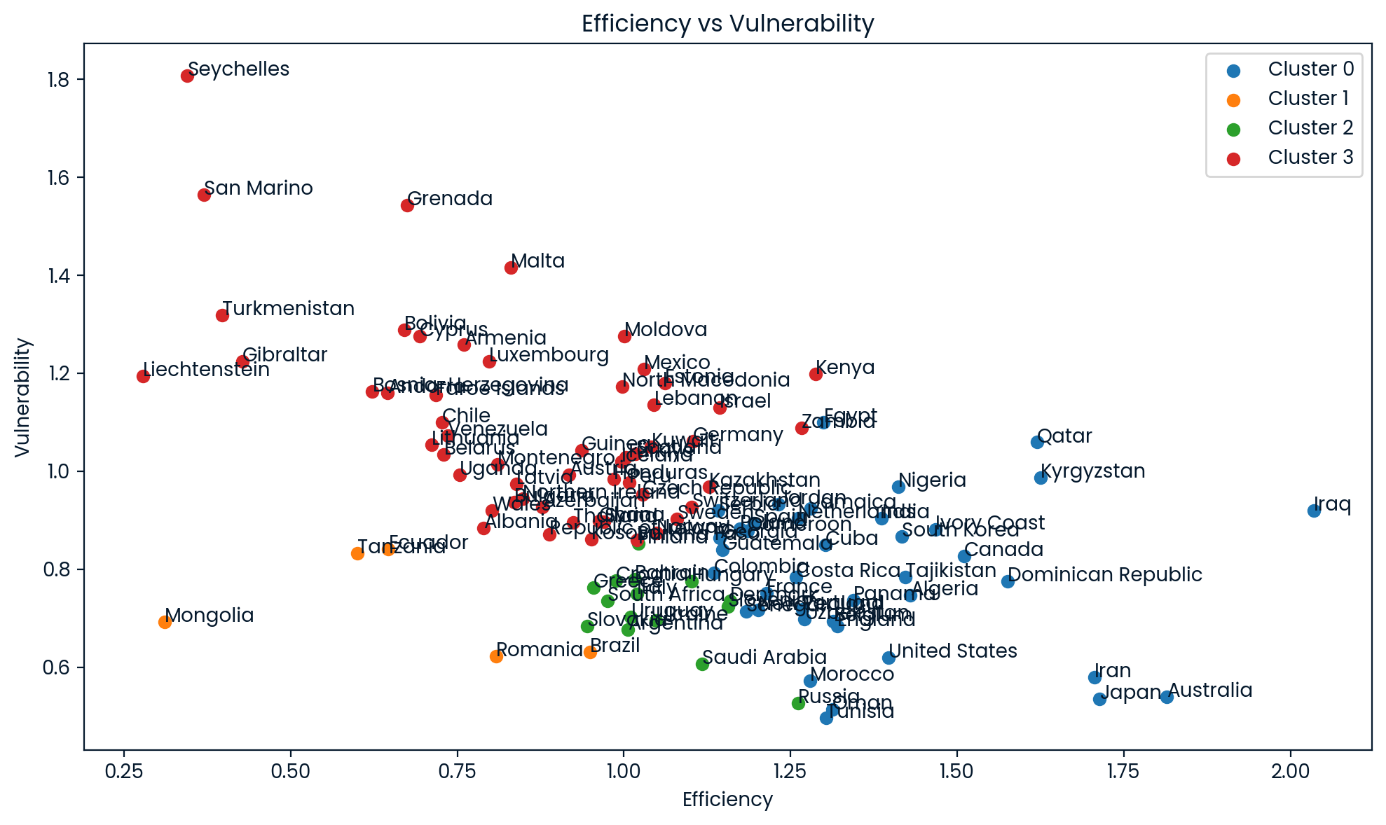
Cluster di efficienza vs vulnerabilità di tutte le squadre nel dataset
Sono state individuate diverse feature chiave e utilizzate nei modelli per aumentare l'accuratezza delle previsioni. Tra queste:
Prima di costruire i modelli di machine learning, il dataset viene suddiviso in partite non giocate e giocate per distinguere tra dati etichettati e non etichettati. Inoltre, applichiamo il log alle feature di forma fortemente asimmetriche a destra e usiamo normalizzazione e one-hot encoding per garantire che i dati siano nel formato adatto.
Le variabili di squadra, incluso il trend di lungo periodo, devono essere scalate con MinMaxScaler per evitare che gli zeri che rappresentano partite senza la relativa squadra influenzino la scala. Tutte le altre feature numeriche sono normalizzate con StandardScaler.
Per individuare i modelli più efficaci nella previsione dei risultati calcistici, sono partito da un'ampia selezione di modelli di machine learning. Adottando un approccio da "scatola nera", ho esplorato vari modelli per comprenderne punti di forza e debolezze nella gestione dei dati. Per ogni modello ho usato la versione di classificazione per prevedere gli esiti delle partite e la versione di regressione per prevedere il numero di gol segnati da entrambe le squadre. I modelli testati includevano:
Per prima cosa ho impostato un seed (il mio ex numero di maglia, il nove) per la riproducibilità. La definizione di label e target e la costruzione dei modelli hanno previsto vari passaggi chiave, tutti comprendenti il confronto delle performance tramite cross-validation:
Alla fine ho selezionato i modelli con le performance migliori in base alla precisione nel prevedere gli esiti (vittoria/sconfitta) e alla Root Mean Squared Error (RMSE) nel prevedere il numero di gol.
Ho scelto due modelli per gli esiti: uno per prevedere vittorie e sconfitte, e un altro specifico per i pareggi. Questa distinzione era necessaria perché i pattern e i fattori che influenzano i pareggi differiscono sensibilmente da quelli che influenzano vittorie e sconfitte. Per garantire che le probabilità finali per tutti e tre gli esiti (vittoria, pareggio, sconfitta) sommino al 100%, i risultati dell'applicazione dei modelli sono stati poi normalizzati.
Usando i modelli scelti con i relativi iperparametri e feature selezionate, ho previsto tutte le label per ogni riga. Poiché ci sono due righe per ogni partita da prevedere, otteniamo due probabilità per ogni esito e due numeri decimali come gol previsti per ciascuna squadra.
Questi valori non dovrebbero differire troppo tra loro, e nella maggior parte dei casi non lo fanno—se però succede, contrassegniamo la partita per indicare che la previsione va presa con le pinze. Per ridurli a un solo valore per ciascuna label, faccio la media dei due valori previsti.
Per gli esiti, ho normalizzato le probabilità di vittoria, pareggio e sconfitta affinché sommino al 100%. Ho creato anche colonne aggiuntive per catturare opzioni di scommessa popolari come la "doppia chance". In base al numero decimale di gol previsti per squadra, istanzio una distribuzione di Poisson e ricavo le probabilità per ciascun numero di gol per squadra e per se la somma totale dei gol della partita sia over o under 1.5, 2.5, 3.5, 4.5 e 5.5, quote molto popolari su cui puntare.
Per i miei pronostici, ho scelto l'esito con la probabilità più alta. Se le probabilità di vittoria delle due squadre erano entro 0,05 l'una dall'altra, l'ho interpretato come pareggio. Per i gol, ho selezionato il numero più probabile per ciascuna squadra, aggiustando i numeri se necessario per allinearli all'esito previsto.
Per prevedere le future partite dell'EURO, ho aggiornato i dati grezzi delle gare con gli esiti iniziali previsti. Incorporando queste previsioni nel dataset e riapplicando il feature engineering, ho potuto prevedere il turno successivo in base all'evoluzione del torneo.
Capire la differenza tra accuratezza e precisione è fondamentale nelle previsioni calcistiche, soprattutto considerando come si applicano. L'esempio tra scommesse e pronostici amichevoli può illustrare l'importanza di queste metriche:
L'obiettivo è trovare puntate con rendimento atteso positivo. Significa individuare esiti probabili e considerare le quote offerte dai bookmaker per trovare value bet.
Qui conta soprattutto la precisione, perché si concentra sulla correttezza delle previsioni positive (ad esempio, prevedere una vittoria). Un'alta precisione aiuta a identificare con costanza le scommesse sottovalutate dai bookmaker, incidendo direttamente sulla redditività.
Tieni presente che le società di scommesse hanno interi team per creare e mantenere modelli predittivi molto sofisticati che, nella maggior parte dei casi, probabilmente batteranno un modello più semplice come il mio.
L'obiettivo è indovinare correttamente il risultato di ogni partita. I partecipanti guadagnano punti per ogni previsione giusta, con lo scopo di accumulare più punti possibile su una serie di gare. In questo scenario conta di più l'accuratezza complessiva, perché misura quanto spesso le tue previsioni sono corrette, influenzando il punteggio totale.
La previsione dei pareggi è un altro esempio perfetto della possibile discrepanza tra le due misure. Solo circa il 20% delle partite nei dati di training è finito in pareggio, portando molti modelli a sottostimare la probabilità di un pari e a volte a non prevederne mai uno.
Questo porta a un'accuratezza alta, intorno all'80%, dato che tutti i non-pareggi sono etichettati correttamente, ma a una precisione pari a 0 per i pareggi perché nessuno è stato previsto come tale.
Le performance dei modelli sono variate in base al tipo di previsione:
Poiché si usano modelli diversi, ci sono casi in cui le previsioni di esito e di gol non coincidono. Sebbene sia difficile confrontare punteggi categoriali e numerici, credo sia giusto dire che le previsioni degli esiti funzionano in generale meglio di quelle sui gol, motivo per cui, in caso di discrepanza, queste ultime vengono adattate alle prime.
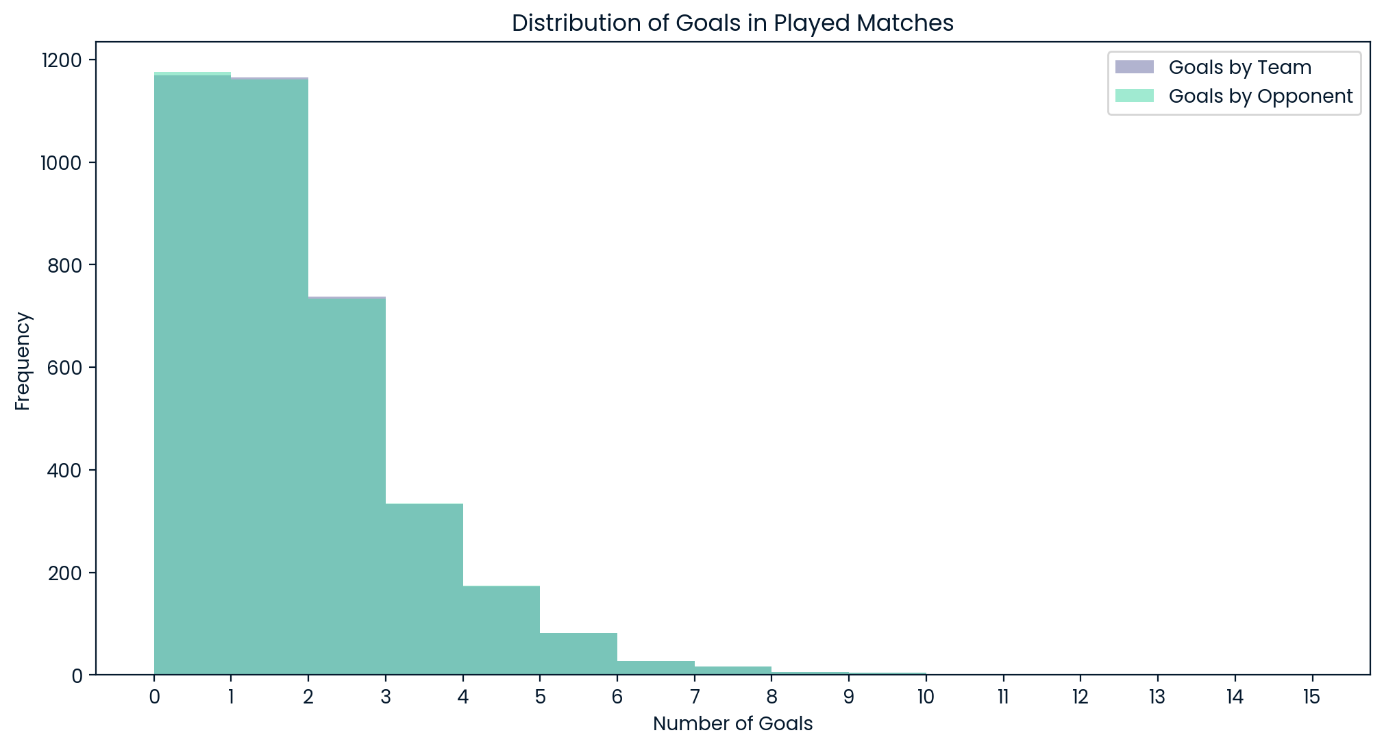
Distribuzione dei gol in tutte le partite giocate
È degno di nota che il modello si orienti esclusivamente su 0, 1 e 2 come numero di gol più probabile per qualsiasi squadra in qualsiasi gara. Data la distribuzione complessiva dei gol nei dati di test, non sorprende, ma va ricordato che il modello non considererà mai probabile una partita con molti gol.
Applicare i modelli alle prime partite dell'EURO ha generato risultati interessanti!
In tre quarti dei casi, il modello ha previsto come vincente la squadra favorita, mentre nel restante quarto l'esito previsto non rifletteva i favoriti dei bookmaker.
A prima vista, questo rapporto sembrava una buona base, dato che è lecito aspettarsi un certo numero di risultati sorprendenti. Ma qui arriva la parte difficile, una domanda generale nelle previsioni calcistiche, che tu usi l'istinto o un modello di machine learning: quando ha senso puntare sulla sfavorita?
Una strategia per gestire questo aspetto è puntare solo e sempre sulla favorita. Così sbaglierai una quota di sorprese, ma nel complesso la tua accuratezza sarà piuttosto buona. Cercare di indovinare anche i risultati inattesi è l'unica chance per ottimizzare l'accuratezza delle puntate, ma è ovviamente la strategia più difficile e rischiosa.
Supponendo che la quota di sorprese sia più o meno costante, ogni errore vale doppio—per ogni sorpresa indovinata che non si verifica, te ne manca una avendo puntato sulla favorita.
Ho scelto l'approccio più rischioso, ma finora non ha portato grandi benefici. Il mio modello è stato piuttosto sfortunato sulle possibili sorprese, con un'accuratezza piuttosto deludente del 50% nella prima giornata.
Per esempio, il modello prevedeva che Serbia e Georgia, le due sfavorite, pareggiassero contro l'Inghilterra e, rispettivamente, vincessero contro la Turchia. Tuttavia, in entrambi i casi hanno vinto le favorite. D'altra parte, il modello non ha previsto sorprese effettive come la vittoria della Slovacchia contro il Belgio, lo strepitoso 3-0 della Romania contro l'Ucraina e il pareggio della Danimarca con la Slovenia.
Le seguenti previsioni sono state fatte dopo la seconda giornata, con una partita del girone rimasta per ogni squadra. Il risultato più sorprendente riguarda il gruppo più interessante, persino nel gruppo E, dove tutte le squadre hanno lo stesso numero di punti (3) a una gara dalla fine.
Secondo il modello, la Slovacchia vincerà il girone dopo un 1-0 sulla Romania, dato che ha battuto il Belgio. Così la Slovacchia retrocederebbe la grande favorita del girone al secondo posto. Il modello prevede addirittura che la Slovacchia sia la più grande sorpresa del torneo, pronosticandone la vittoria contro l'Austria e l'accesso ai quarti di finale.
La previsione dell'intero andamento del torneo è stata particolarmente impegnativa per il formato, in cui passano anche le migliori terze. Questo introduce vari possibili accoppiamenti, aggiungendo ulteriore complessità a seconda dei gruppi da cui provengono le quattro migliori terze. Quindi prendi le seguenti previsioni con le pinze—gli abbinamenti potrebbero cambiare completamente anche se la differenza reti di una squadra varia di un solo gol.
Le partite a K.O. sono in generale previste molto equilibrate, con un 2-0 della Spagna nell'eventuale ottavo contro la Romania come unico match con differenza reti attesa superiore a uno.
Le partite dell'Italia spingono l'equilibrio all'estremo, con i pareggi previsti come esiti dei primi due K.O. Poiché i rigori sono rari e non ci sono dati sufficienti per prevederne i vincitori, mi sono affidato ai miei ricordi del buon track record dell'Italia ai rigori e ho ipotizzato che vincesse entrambe le lotterie contro Svizzera e Inghilterra.
Alla fine, il modello prevede Spagna, Portogallo, Paesi Bassi e Italia in semifinale.
Paesi Bassi e Spagna compongono la mia finale prevista, proprio come nel 2010—che sia un deja vu?
Questo progetto mi ha lasciato diversi insegnamenti chiave:
Per migliorare le previsioni ed espandere il perimetro del progetto, si possono intraprendere diversi passi:
Per maggiori informazioni e per il codice, visita il notebook del progetto.
Questo post offre una panoramica delle sfide e delle metodologie coinvolte nel prevedere gli esiti calcistici, mettendo in luce il percorso e gli apprendimenti del progetto su EURO 2024.
Integrare data science e sport analytics apre opportunità entusiasmanti per appassionati e professionisti del settore. Man mano che il progetto evolve, l'obiettivo resta affinare i modelli ed estenderne l'applicazione ad altri tornei, contribuendo alla crescita della sport analytics.
Se vuoi saperne di più sulla sport analytics, ecco alcune risorse da provare:
Impara il machine learning con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



