

Cursus
Inzicht in Machine Learning
2 uur
313.7K
Oefen en volg je voortgang.
Ga Verder Met GoogleToen ik 14 was, plaatste ik mijn eerste voetbalweddenschap op de winnaar van het WK 2010. Puur op intuïtie voorspelde ik per wedstrijd en zette ik in op de twee finalisten uit mijn toernooischema: Nederland en Spanje. Uiteindelijk haalden die twee teams de finale—ik was door het dolle heen dat mijn voorspellingen uitkwamen.
Veertien jaar later zocht ik een project om mijn Python- en machinelearningskills te verdiepen, wat leidde tot een voorspelproject voor EURO 2024. Mijn hoofddoel was om wedstrijduitslagen (winst, gelijkspel of verlies) en het aantal doelpunten per team te voorspellen.
In dit artikel geef ik een overzicht van mijn EURO 2024-voorspelproject, met de belangrijkste stappen die ik nam, de uitdagingen die ik tegenkwam en de inzichten die ik opdeed. Voor de technische details, inclusief de code, verwijs ik naar het bijbehorende notebookproject—je hebt een DataLab-account nodig om alle bestanden te bekijken.
Voetbaluitslagen voorspellen is berucht lastig door meerdere factoren. In het voetbal is de statistische verdeling van doelpunten behoorlijk variabel. Tegelijkertijd zijn er relatief weinig scoringskansen per wedstrijd vergeleken met andere teamsporten met een bal, wat tot onvoorspelbare uitkomsten leidt.
Neem handbal: de vele scoringskansen zorgen daar voor voorspelbaardere resultaten, omdat het aantal doelpunten de creatie en het voorkomen van kansen beter weerspiegelt naarmate het aantal pogingen over de wedstrijd gemiddeld wordt. In voetbal kan het echter genoeg zijn om het “bus parkeren” voor je goal te combineren met één gedreven counter om de wedstrijd op zijn kop te zetten.
Daarnaast zijn voetbalwedstrijden gekenmerkt door sterke padenafhankelijkheid: het spelbeeld en de uitkomst hangen vaak sterk af van het eerste doelpunt. Kleine maar bepalende acties kunnen tot een goal of rode kaart leiden en daarmee het verloop van de wedstrijd drastisch veranderen, wat voorspellen nog lastiger maakt.
De introductie van VAR (Video Assistant Referee) in de afgelopen jaren heeft de onvoorspelbaarheid verder vergroot, omdat hiermee cruciale beslissingen op het veld teruggedraaid kunnen worden. En dan is er nog de ongrijpbare “vorm van de dag”, een factor waar ik als fan van het berucht onvoorspelbare Eintracht Frankfurt (veelzeggend bijgenaamd de “Launische Diva”) een boek over zou kunnen schrijven.
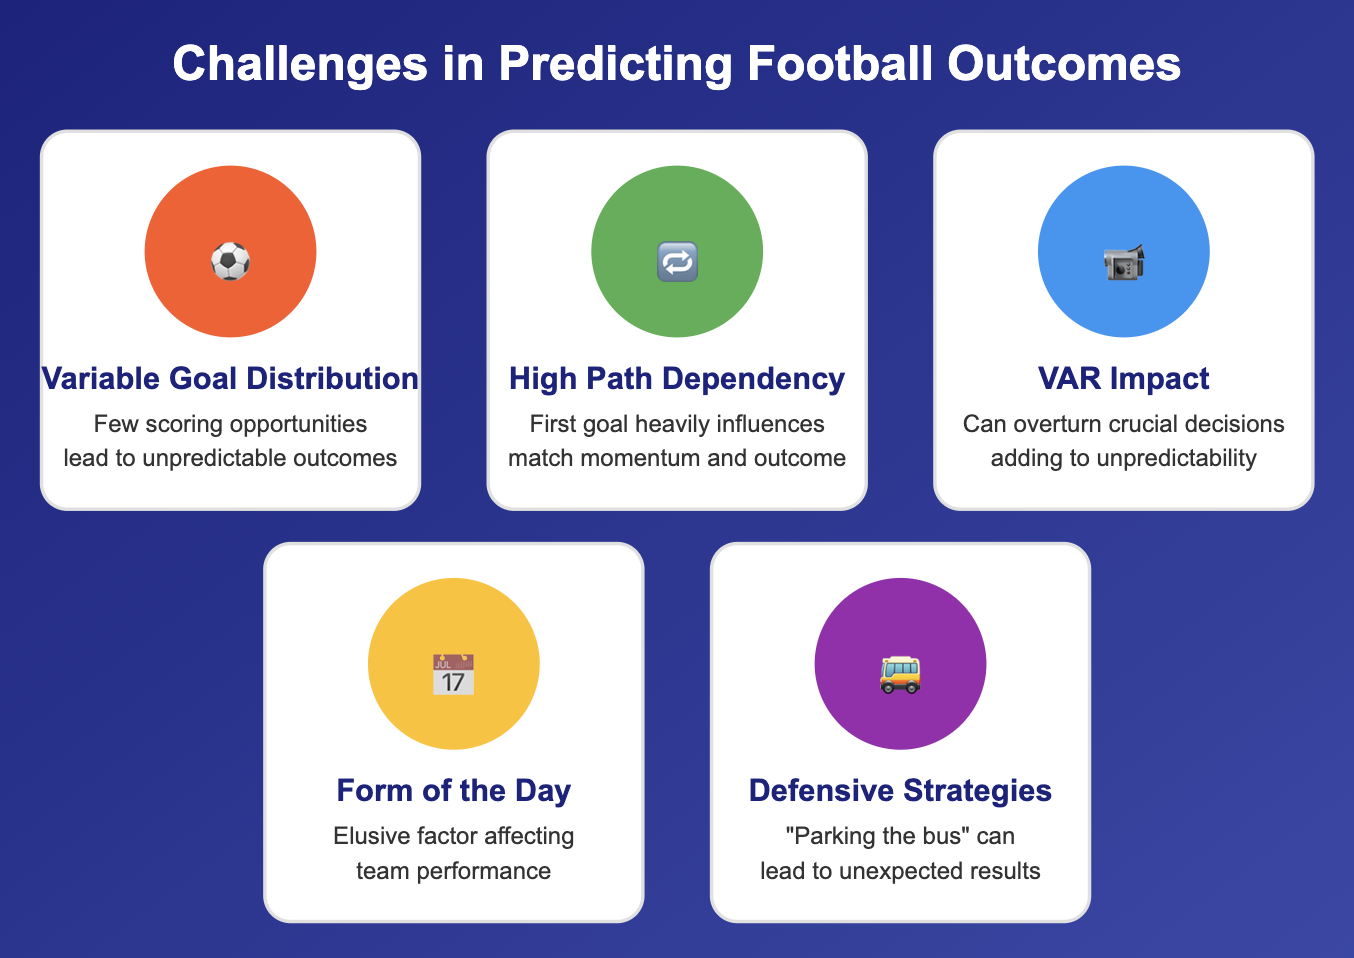
Naast de genoemde factoren kampt mijn voorspelmodel ook met extra datalimieten die ik moest aanpakken.
Om met deze dataproblemen om te gaan, heb ik verschillende strategieën toegepast:
Ik heb waar mogelijk ontbrekende datapunten aangevuld om het dataset compleet te houden—bijvoorbeeld door tactische formaties toe te voegen voor de te voorspellen wedstrijden.
Omdat de meeste teams vasthouden aan dezelfde formatie zodra die is ingeslepen en getest, nam ik aan dat elk team in de formatie speelt die het het vaakst gebruikte in de laatste vijf wedstrijden. Zo kunnen we voorspellen vóórdat de opstellingen bekend worden, wat pas een uur voor de aftrap gebeurt.
Als imputeren of verwijderen niet praktisch was, sloot ik bepaalde features uit of verving ik ze om de nauwkeurigheid van het model niet te ondermijnen.
Oorspronkelijk wilde ik bijvoorbeeld een tweelagige voorspelling doen waarbij primaire features worden gebruikt om secundaire features zoals balbezit en expected goals te voorspellen, en de uitslag mede daarop te baseren. Omwille van de eenvoud heb ik hier toch van afgezien, en in plaats daarvan elk team twee features gegeven op basis van gemiddelde wedstrijdstatistieken om hun speelstijl te representeren.
Waar imputeren niet haalbaar was, heb ik de ontbrekende data verwijderd om de integriteit van het dataset te behouden. Gelukkig ging het maar om een klein verlies aan observaties, waardoor er nog steeds meer dan 3.000 wedstrijden overbleven voor modelbouw.
Nu de moeilijkheden en beperkingen zijn behandeld, bekijken we het proces om ruwe data om te zetten in bruikbare voorspellingen. De datapijplijn, de ruggengraat van het project, omvatte het verzamelen, voorbewerken en voorbereiden van data voor modellering, met gebruik van diverse tactische, psychologische en historische features.
De eerste stap was het scrapen van historische wedstrijddata uit verschillende bronnen, waaronder Transfermarkt, om uitgebreide informatie over eerdere wedstrijden te verzamelen.
Eén rij in de resulterende DataFrame komt overeen met één wedstrijd vanuit het perspectief van een van de betrokken teams. Deze data is gecombineerd met FootyStats-data om speelstijlfeatures toe te voegen, zoals gemiddeld balbezit en efficiëntiemetingen.
Voor meer details, bekijk de datascraping-notebook hier.
Vervolgens is ruwe data omgezet in betekenisvolle features die de machinelearningmodellen kunnen gebruiken. Dit omvatte het extraheren van waarden, het transformeren van variabelen en het berekenen van gemiddelden.
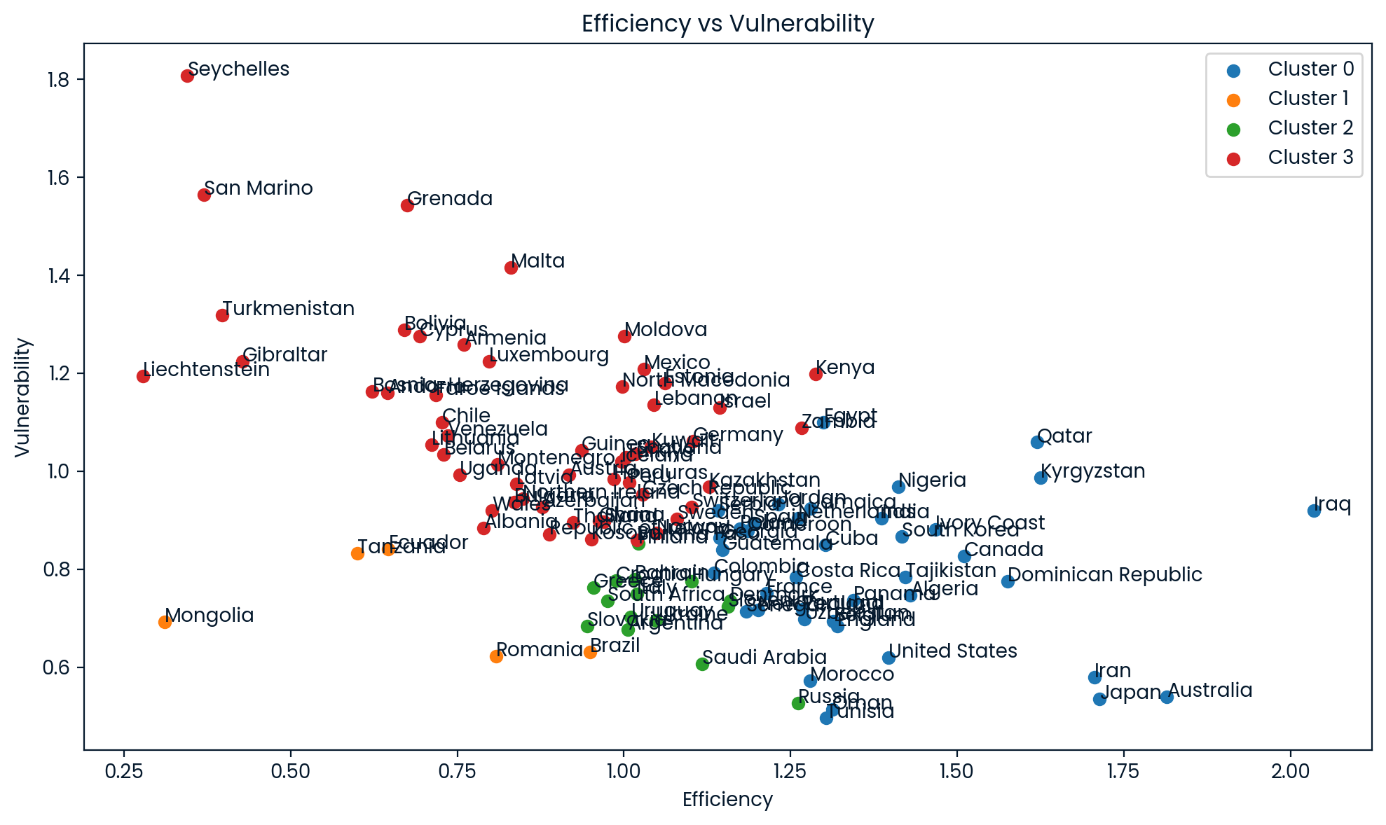
Clusters van efficiëntie versus kwetsbaarheid van alle teams in het dataset
Verschillende kernfeatures zijn geïdentificeerd en gebruikt in de modellen om de nauwkeurigheid te vergroten. Deze features omvatten:
Voordat de machinelearningmodellen worden gebouwd, wordt het dataset opgesplitst in niet-gespeelde en gespeelde wedstrijden om gelabelde en ongelabelde data te onderscheiden. Verder nemen we de logaritme van de sterk rechts-scheve vormfeatures en passen we normalisatie en one-hot encoding toe om de data in het juiste formaat te krijgen.
De teamvariabelen, inclusief de langetermijntrend, moeten geschaald worden met MinMaxScaler om te voorkomen dat de nullen (wedstrijden zonder het betreffende team) de schaal beïnvloeden. Alle overige numerieke features worden genormaliseerd met StandardScaler.
Om de effectiefste modellen voor voetbalvoorspellingen te vinden, begon ik met een brede selectie van machinelearningmodellen. Met een “black box”-benadering verkende ik diverse modellen om hun sterke en zwakke punten in het omgaan met de data te begrijpen. Voor elk model gebruikte ik de classificatievariant om wedstrijduitslagen te voorspellen en de regressievariant om het aantal doelpunten van beide teams te voorspellen. De geteste modellen waren onder meer:
Eerst zette ik een seed (mijn oude rugnummer, negen) voor reproduceerbaarheid. Het definiëren van labels en targets en de modelbouw bestonden uit verschillende stappen, die allemaal modelprestaties vergeleken met cross-validatie:
Uiteindelijk selecteerde ik de best presterende modellen op basis van hun precisie bij het voorspellen van wedstrijduitslagen (winst/verlies) en de Root Mean Squared Error (RMSE) bij het voorspellen van het aantal doelpunten.
Ik koos twee modellen voor wedstrijduitslagen: één voor het voorspellen van winst en verlies, en een ander specifiek voor gelijkspellen. Dat onderscheid was nodig omdat de patronen en factoren achter gelijkspellen sterk verschillen van die achter winst en verlies. Om ervoor te zorgen dat de eindkansen voor alle drie de uitkomsten (winst, gelijkspel, verlies) optellen tot 100%, zijn de resultaten later genormaliseerd.
Met de gekozen modellen en hun geselecteerde hyperparameters en features voorspel ik alle labels voor elke rij. Omdat er voor elke te voorspellen wedstrijd twee rijen zijn, krijgen we twee kansen per wedstrijduitslag en twee kommagetallen als voorspelde goals voor elk team.
Deze waarden zouden niet al te veel van elkaar mogen verschillen, en meestal doen ze dat ook niet—als dat wel zo is, markeren we de wedstrijd om aan te geven dat de voorspelling met een korreltje zout moet worden genomen. Om tot één waarde per label te komen, neem ik het gemiddelde van beide voorspellingen.
Voor wedstrijduitslagen heb ik de kansen op winst, gelijkspel en verlies genormaliseerd zodat ze samen 100% vormen. Ik heb ook extra kolommen gemaakt voor populaire opties zoals "dubbele kans". Op basis van het kommagetal aan voorspelde goals per team installeer ik een Poissonverdeling en leid ik kansen af voor elk mogelijk doelpuntentotaal per team en voor of de som van alle wedstrijdgoals over of onder 1,5, 2,5, 3,5, 4,5 en 5,5 ligt, waar vaak op gewed wordt.
Voor mijn tipvoorspellingen koos ik de uitkomst met de hoogste kans. Als de winstkansen van beide teams binnen 0,05 van elkaar lagen, interpreteerde ik dat als een gelijkspel. Voor doelpunten koos ik het meest waarschijnlijke aantal per team, met eventuele aanpassingen zodat het klopt met de voorspelde uitslag.
Om toekomstige EURO-wedstrijden te voorspellen heb ik de ruwe wedstrijddata aangevuld met de aanvankelijke voorspelde uitslagen. Door deze voorspellingen in het dataset op te nemen en de feature engineering opnieuw toe te passen, kon ik vervolgens de volgende ronde voorspellen op basis van het zich ontwikkelende toernooiverloop.
Het verschil tussen accuratesse en precisie begrijpen is cruciaal bij voetbalvoorspellingen, zeker met het oog op de toepassing ervan. Het contrast tussen wedden en tippcompetities illustreert het belang van deze statistieken:
Het doel is weddenschappen te vinden met een positieve verwachte opbrengst. Je moet dus waarschijnlijke uitkomsten identificeren en de odds van bookmakers meewegen om value bets te vinden.
Precisie is hier doorslaggevend, omdat het de juistheid van positieve voorspellingen (bijv. winst voorspellen) benadrukt. Hoge precisie helpt consequent ondergewaardeerde weddenschappen door bookmakers te vinden, wat direct je winstgevendheid beïnvloedt.
Houd er rekening mee dat wedkantoren hele teams hebben om zeer geavanceerde voorspelmodellen te bouwen en te onderhouden, die een eenvoudiger model als het mijne in de meeste gevallen waarschijnlijk zullen verslaan.
Het doel is om de uitslag van elke wedstrijd zo accuraat mogelijk te raden. Deelnemers verdienen punten voor elke juiste voorspelling en proberen over meerdere wedstrijden de meeste punten te verzamelen. De algemene accuratesse is hier belangrijker, omdat die meet hoe vaak je voorspellingen kloppen en dus je totaalscore beïnvloedt.
Het voorspellen van gelijkspellen is een perfect voorbeeld van het mogelijke verschil tussen beide maten. Slechts zo'n 20% van de wedstrijden in de trainingsdata eindigde in een gelijkspel, waardoor de meeste modellen de kans op een gelijkspel onderschatten en soms zelfs nooit een gelijkspel voorspellen.
Dat leidt tot een hoge accuratesse van zo'n 80%, omdat alle niet-gelijkspellen correct gelabeld zijn, maar tot een precisie van 0 voor gelijkspellen, omdat geen enkel gelijkspel als zodanig werd voorspeld.
De prestaties van de modellen verschilden per soort voorspelling:
Omdat verschillende modellen worden gebruikt, zijn er gevallen waarin uitslag- en doelpuntvoorspellingen niet matchen. Hoewel het lastig is om categorische en numerieke scores te vergelijken, denk ik dat je kunt stellen dat uitslagvoorspellingen over het algemeen beter werken dan doelpuntvoorspellingen; daarom worden die laatste waar nodig aangepast aan de eerste.
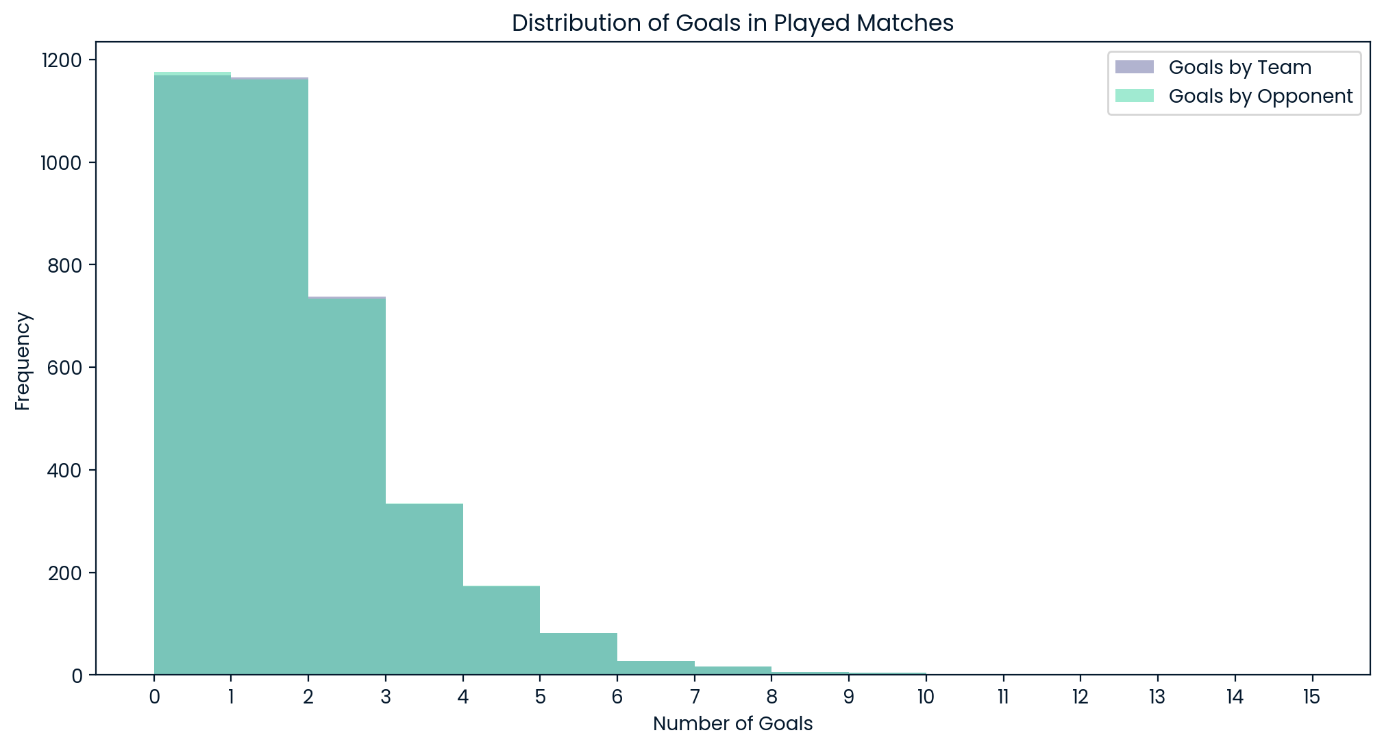
Verdeling van doelpunten in alle gespeelde wedstrijden
Opvallend is dat het model uitsluitend uitkomt op nul, één of twee als meest waarschijnlijke doelpuntentotaal voor een team in een wedstrijd. Gezien de algemene doelpuntenverdeling in de testdata is dat geen verrassing, maar het betekent wel dat het model nooit zal verwachten dat een doelpuntrijke wedstrijd de meest waarschijnlijke uitkomst is.
De toepassing van de modellen op de eerste EURO-wedstrijden leverde interessante resultaten op!
In driekwart van de gevallen voorspelde het model dat de favoriet zou winnen; in het overige kwart weerspiegelde de voorspelde uitslag de favoriet van de bookmakers niet.
Op het eerste gezicht leek die verhouding een aardige gok, want je mag aannemen dat er altijd verrassingen zijn. Maar dan komt het lastige deel, dat je bij voetbalvoorspellingen altijd hebt, of je nu op je gevoel of een model afgaat: wanneer heeft het zin om op de underdog te wedden?
Een strategie is om alleen en altijd op de favoriet te wedden. Dan heb je een deel van de verrassingen mis, maar je accuratesse is per saldo goed. Ook de onverwachte uitslagen proberen te raden is de enige manier om je nauwkeurigheid verder te optimaliseren, maar dat is duidelijk de lastigere en riskantere strategie.
Als je ervan uitgaat dat het aandeel verrassingen ruwweg constant is, telt elke fout dubbel—voor elke misgegokte verrassing mis je er ook één doordat je niet op de favoriet hebt ingezet.
Ik koos de riskantere aanpak, maar die heeft nog geen grote vruchten afgeworpen. Mijn model had pech met mogelijke verrassingen, wat leidde tot een teleurstellende accuratesse van 50% op de eerste speeldag.
Zo voorspelde het model dat Servië en Georgië, de underdogs, respectievelijk gelijk zouden spelen tegen Engeland en winnen van Turkije. In beide gevallen wonnen de favorieten. Andersom voorspelde het model geen echte verrassingen zoals de zege van Slowakije tegen België, de verbluffende 3-0 van Roemenië tegen Oekraïne en het gelijkspel van Denemarken met Slovenië.
De volgende voorspellingen zijn gedaan na de tweede speeldag, met nog één groepsduel te gaan voor elk team. Het meest verrassende resultaat komt uit de interessantste groep, namelijk groep E, waar alle teams met één wedstrijd te gaan hetzelfde puntenaantal (3) hebben.
Volgens het model wint Slowakije de groep na een 1-0 zege op Roemenië, omdat ze van België wonnen. Zo zou Slowakije de grote groepsfavoriet naar plek twee verwijzen. Het model voorspelt zelfs dat Slowakije dé verrassing van het toernooi wordt en van Oostenrijk wint om de kwartfinale te halen.
De voorspelling voor het volledige toernooiverloop was extra lastig door het format, waarbij ook de beste nummers drie zich plaatsen voor de knock-outfase. Dat levert verschillende mogelijke affiches op, afhankelijk van uit welke groepen de vier beste nummers drie komen. Neem de volgende voorspellingen dus met een korreltje zout—de affiches kunnen compleet veranderen als bijvoorbeeld het doelsaldo van één team met slechts één goal verschuift.
De K.O.-wedstrijden worden in het algemeen heel nipt voorspeld, met een Spaanse 2-0 zege in een mogelijke 1/8 finale tegen Roemenië als enige met een verwachte doelsaldo groter dan één.
De Italiaanse wedstrijden drijven de spanning tot het uiterste, met gelijkspellen als voorspelde uitslag voor hun eerste twee K.O.-duels. Omdat strafschoppen zeldzaam zijn en er niet genoeg data is om de winnaars daarvan te voorspellen, greep ik terug op mijn herinneringen aan de goede Italiaanse strafschoppenhistorie en verwachtte ik dat Italië beide series zou winnen, tegen Zwitserland en Engeland.
Uiteindelijk voorspelt het model dat Spanje, Portugal, Nederland en Italië de halve finales halen.
Nederland en Spanje vormen mijn voorspelde finale, net als in 2010—zou de geschiedenis zich herhalen?
Dit project leverde meerdere belangrijke inzichten op:
Om de voorspellingen te verbeteren en de reikwijdte van het project uit te breiden, kun je verschillende stappen nemen:
Voor meer details en code, ga naar de projectnotebook.
Deze blogpost geeft een overzicht van de uitdagingen en methodes bij het voorspellen van voetbaluitslagen, en belicht de reis en lessen uit het EURO 2024-voorspelproject.
De combinatie van data science en sportanalytics biedt mooie kansen voor liefhebbers en professionals. Terwijl het project zich blijft ontwikkelen, is het doel om de modellen te verfijnen en ze uit te breiden naar andere toernooien, als bijdrage aan het groeiende veld van sportanalytics.
Wil je meer leren over sportanalytics? Bekijk dan deze resources:
Leer machine learning met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

