
Kursus
Fine-Tuning dengan Llama 3
2 jam
4.1K
Qwen3.5 Small adalah model yang praktis untuk fine-tuning ringan karena dirancang untuk pembuatan prototipe, adaptasi tugas spesifik, dan alur kerja riset. Dipadukan dengan QLoRA, kita dapat melakukan fine-tuning di atas model dasar yang dibekukan dan dikwantisasi 4-bit, sehingga prosesnya jauh lebih efisien memori dan mudah diakses pada perangkat keras terbatas.
Dalam tutorial ini, kita akan menyiapkan lingkungan, memuat model dan dataset AG News, mengevaluasi model dasar, lalu melakukan fine-tuning Qwen3.5 small untuk klasifikasi berita. Kita akan mengakhiri dengan membandingkan hasil sebelum dan sesudah pelatihan, kemudian menyimpan dan memublikasikan adapter LoRA ke Hugging Face untuk digunakan kembali.
Saya menyarankan untuk mengikuti Hugging Face Fundamentals skill track jika Anda belum familiar dengan cara kerjanya.
Sebelum masuk ke kode, ada baiknya memahami model yang kita gunakan. Qwen3.5 adalah keluarga foundation model, dan seri "Small" mengacu pada lini yang ringan, khususnya model di bawah 10 miliar parameter. Untuk tutorial ini, kita akan menggunakan versi 0.8B.
Meskipun hanya memiliki 800 juta parameter, Qwen3.5-0.8B sangat kapabel dan amat efisien. Saat dimuat dengan presisi 4-bit, model ini membutuhkan kurang dari 2GB VRAM. Ini membuatnya cocok untuk laptop konsumen, lingkungan cloud gratis seperti Kaggle, dan deployment ringan di edge.
Selain itu, arsitektur Qwen3.5 mendukung jendela konteks 262K yang sangat besar dan multimodalitas native. Walau kita berfokus ketat pada klasifikasi teks dalam panduan ini, konsep dasar yang kita bahas dapat dengan mudah diperluas ke tugas visi di kemudian hari. Model ini juga memiliki mode penalaran hibrida, meski kita akan menonaktifkannya untuk memaksimalkan kecepatan inferensi pada tugas pelabelan yang langsung.
Secara keseluruhan, Qwen3.5-0.8B adalah opsi yang sangat praktis untuk pembuatan prototipe. Ia memberi kita cara cepat dan hemat biaya untuk menguji alur kerja fine-tuning sambil tetap memberikan hasil hilir yang kuat.
Dalam tutorial ini, kita akan menggunakan notebook Kaggle sebagai lingkungan pelatihan. Kaggle memberi akses ke GPU, menjadikannya platform yang nyaman untuk melatih, melakukan fine-tuning, dan mengevaluasi model. Sebelum menjalankan notebook, buat notebook Kaggle baru, buka pengaturan Session, dan pilih GPU P100 sebagai akselerator.
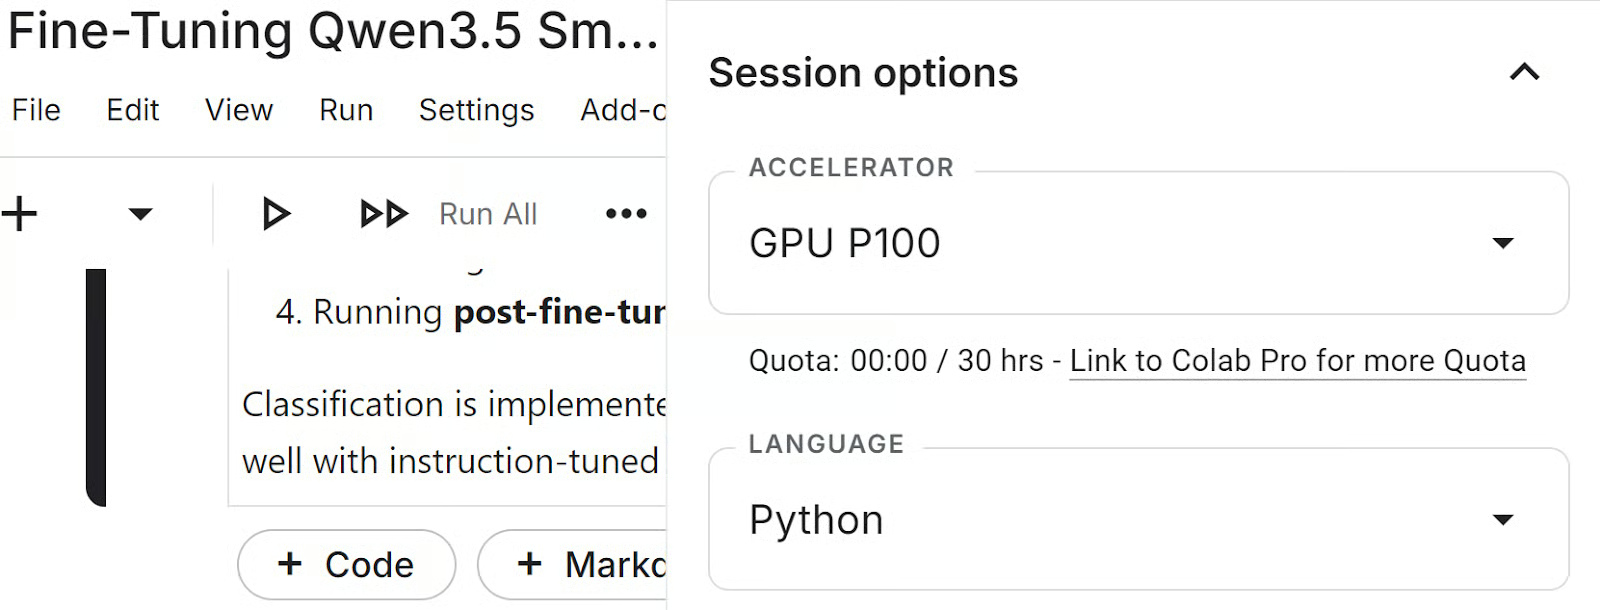
Selanjutnya, kita akan menyiapkan lingkungan, menambahkan token Hugging Face ke Kaggle, dan mengimpor pustaka Python yang digunakan sepanjang tutorial.
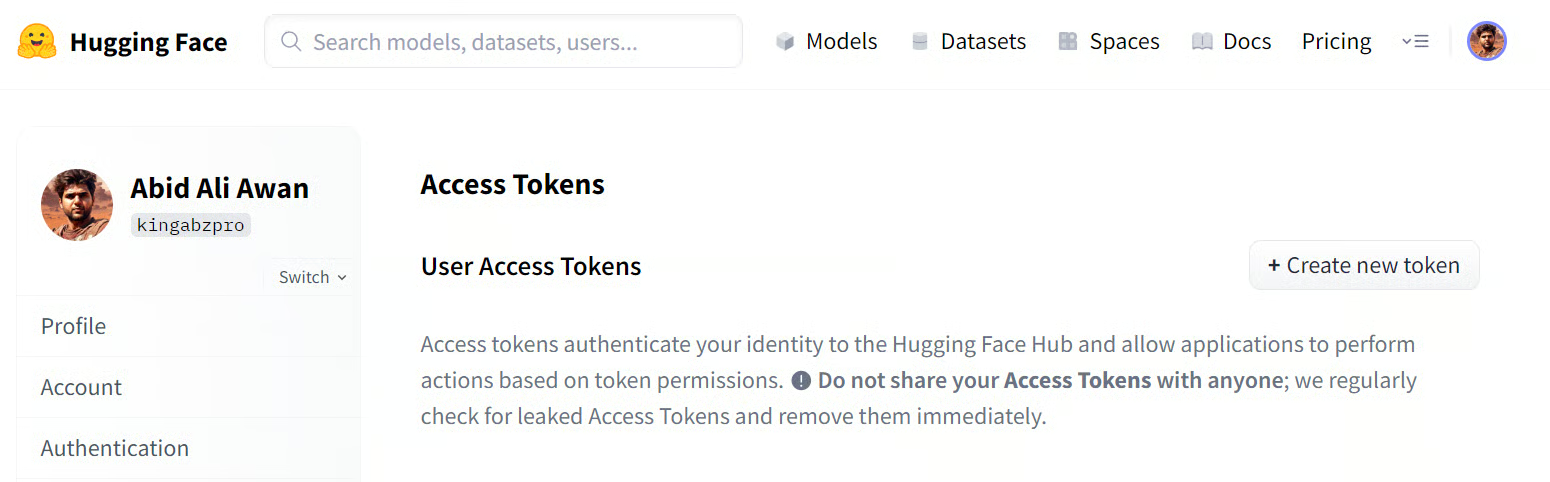
Sebelum menjalankan notebook, buat token akses Hugging Face dari pengaturan akun Anda. Buka Settings, buka Access Tokens, dan buat token baru. Jika Anda ingin memublikasikan adapter LoRA yang telah di-fine-tune ke Hugging Face Hub di akhir tutorial, pastikan token memiliki akses tulis.
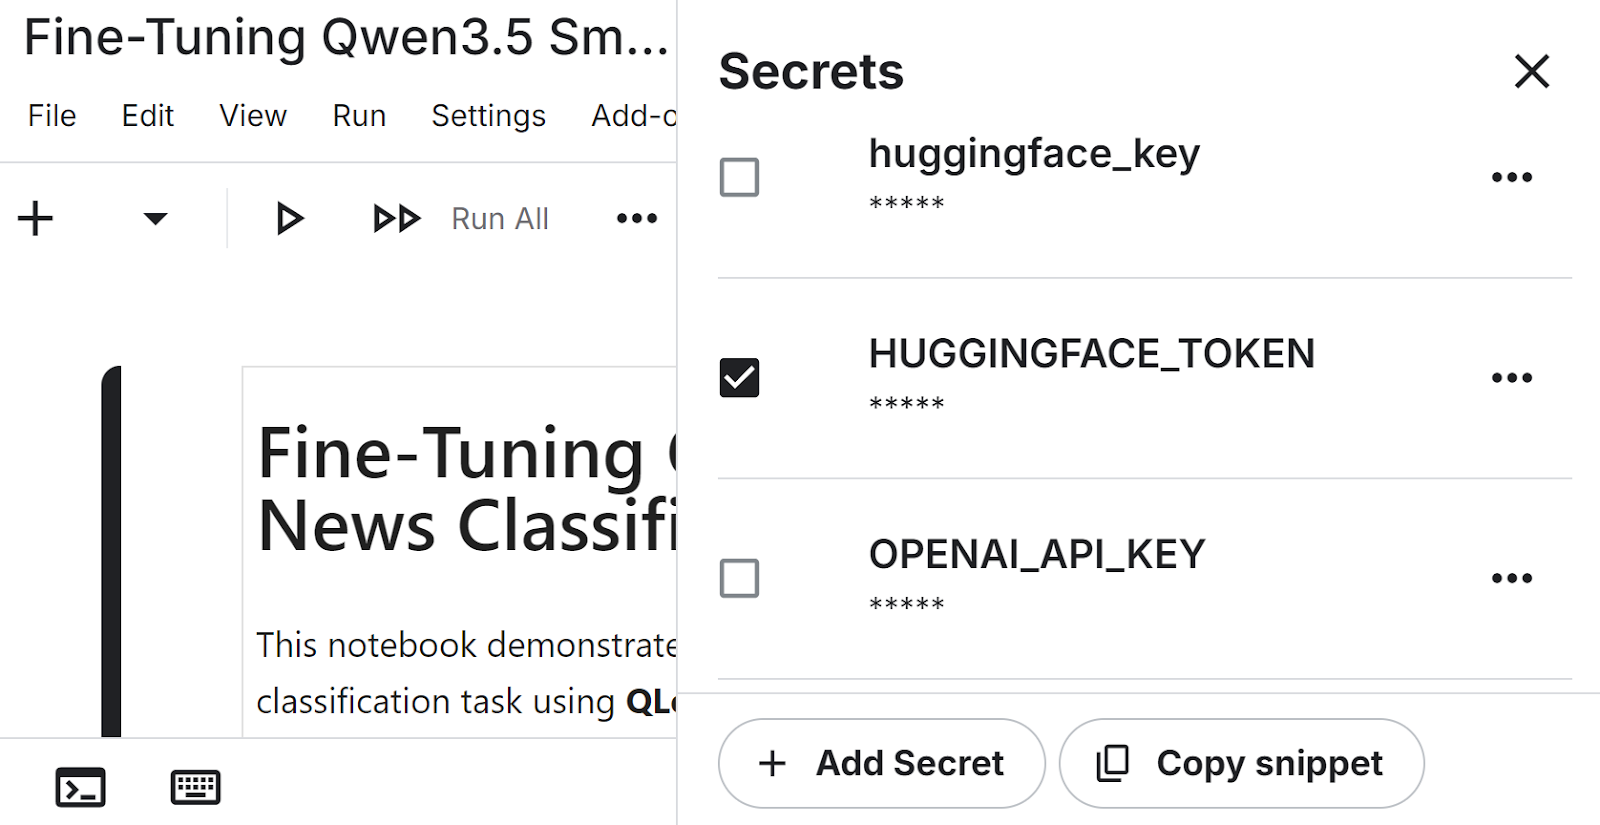
Setelah membuat token, buka notebook Kaggle Anda dan tambahkan sebagai secret. Di editor notebook, buka Add-ons, lalu Secrets, dan buat secret baru bernama HUGGINGFACE_TOKEN. Tempelkan nilai token Anda di sana agar notebook dapat mengaksesnya secara aman tanpa mengeksposnya di dalam kode.
Sekarang kita dapat menginstal pustaka utama yang diperlukan untuk alur kerja ini. Paket-paket ini mencakup pemuatan model, kuantisasi, fine-tuning yang efisien parameter, penanganan dataset, dan evaluasi.
!pip install -q -U transformers accelerate
!pip install -q peft trl bitsandbytes datasets scikit-learnSelanjutnya, kita memuat token Hugging Face dari Kaggle secrets dan menggunakannya untuk autentikasi. Ini memberi notebook akses ke model dan memungkinkan kita mendorong adapter terlatih nanti.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient

user_secrets = UserSecretsClient()
login(token=user_secrets.get_secret("HUGGINGFACE_TOKEN"))Terakhir, kita mengimpor pustaka Python yang digunakan sepanjang tutorial untuk pemuatan model, pelatihan, pemrosesan dataset, dan evaluasi.
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig
from transformers import TrainingArguments
from sklearn.metrics import accuracy_score, f1_score
from tqdm.notebook import tqdmSetelah lingkungan siap, kita dapat memuat model dasar dan menyiapkan dataset untuk fine-tuning.
Di bagian ini, kita akan memuat Qwen3.5-0.8B dalam presisi 4-bit untuk membuat pelatihan lebih efisien memori, menyiapkan tokenizer, dan memuat subset kecil dari dataset AG News untuk pelatihan dan evaluasi.
Kita mulai dengan memuat Qwen3.5-0.8B dengan kuantisasi 4-bit menggunakan BitsAndBytes. Ini mengurangi penggunaan memori dan membuat model lebih praktis digunakan di lingkungan notebook Kaggle.
model_id = "Qwen/Qwen3.5-0.8B"

bnb_config = BitsAndBytesConfig(
  load_in_4bit=True,
  bnb_4bit_quant_type="nf4",
  bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  quantization_config=bnb_config,
  device_map="auto",
  dtype=torch.bfloat16
)Berikutnya, kita memuat tokenizer untuk model yang sama. Kita juga menyetel token padding ke token end-of-sequence agar model dapat menangani input ber-padding dengan benar selama pelatihan dan generasi.
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model.config.pad_token_id = tokenizer.eos_token_id
model.generation_config.pad_token_id = tokenizer.eos_token_idTerakhir, kita memuat dataset AG News dan membuat split pelatihan serta uji yang lebih kecil untuk tutorial ini. Menggunakan subset membuat alur kerja lebih cepat sambil tetap memberi cukup data untuk mengevaluasi efek fine-tuning.
dataset = load_dataset("ag_news")

train_dataset = dataset["train"].select(range(2500))
test_dataset = dataset["test"].select(range(200))Sebelum fine-tuning, kita perlu menentukan bagaimana model akan melihat tugasnya dan mengukur seberapa baik performanya dalam bentuk asli.
Di bagian ini, kita akan membuat prompt bergaya instruksi untuk klasifikasi berita, mengekstrak prediksi dari output model, menjalankan inferensi contoh, dan mengevaluasi model dasar pada set uji sebelum pelatihan.
Kita mulai dengan mendefinisikan nama label dan menyusun prompt yang meminta model untuk mengklasifikasikan artikel berita. Prompt ditulis agar model mengembalikan hanya label numerik, yang membuat output lebih mudah diurai saat evaluasi.
labels = ['World','Sports','Business','Sci/Tech']

def build_prompt(text):

    return f"""
Classify the news article.

Article:
{text}

Return ONLY the number of the correct label.

0 = World
1 = Sports
2 = Business
3 = Sci/Tech

Answer:
"""Selanjutnya, kita membuat fungsi pembantu kecil untuk mengekstrak label yang diprediksi dari teks yang dihasilkan. Fungsi ini menghapus token penalaran tambahan dan mengembalikan label kelas akhir sebagai integer.
import re

def extract_label(text):

   text = re.sub(r"<think>.*?</think>", "", text, flags=re.DOTALL)
   matches = re.findall(r"[0-3]", text)

   if matches:
       return int(matches[-1])

return -1Sebelum mengevaluasi model pada seluruh set uji, kita mencobanya terlebih dahulu pada satu contoh. Ini membantu kita meninjau artikel, memeriksa label yang benar, dan melihat apa yang diprediksi model sebelum fine-tuning.
sample = train_dataset[10]

sample_text = sample["text"]
sample_label = sample["label"]

print("Ground truth label:", sample_label)
print("Sample text:")
print(sample_text[:300])
Output menunjukkan bahwa label sebenarnya adalah 2, yang sesuai dengan Business.
Ground truth label: 2
Sample text:
Oil and Economy Cloud Stocks' Outlook  NEW YORK (Reuters) - Soaring crude prices plus worries  about the economy
and the outlook for earnings are expected to  hang over the stock market next week during the depth of the  summer doldrums.
Selanjutnya, kita format prompt, mengoperkannya ke model, dan menghasilkan prediksi.
prompt = build_prompt(sample_text)

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

with torch.inference_mode():
    outputs = model.generate(
        **inputs,
        max_new_tokens=5,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id
    )

prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

print("Model prediction (before training):")
print(extract_label(prediction))
Model juga memprediksi 2, jadi ia mengklasifikasikan contoh ini dengan benar. Ini memberi kita pemeriksaan cepat bahwa format prompt dan pipeline prediksi berfungsi sebagaimana mestinya.
Model prediction (before training):
2Sekarang kita mengevaluasi model dasar pada set uji untuk menetapkan baseline. Ini memberi kita titik acuan untuk membandingkan performa sebelum dan sesudah fine-tuning.
def evaluate_model(dataset):

    preds = []
    refs = []

    model.eval()

    for example in tqdm(dataset):

        text = example["text"]
        label = example["label"]

        prompt = build_prompt(text)

        inputs = tokenizer(prompt, return_tensors="pt", truncation=True)
        inputs = {k: v.to("cuda") for k, v in inputs.items()}

        with torch.inference_mode():

            outputs = model.generate(
                **inputs,
                max_new_tokens=5,
                do_sample=False,
                pad_token_id=tokenizer.eos_token_id
            )

        prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

        pred_label = extract_label(prediction)

        preds.append(pred_label)
        refs.append(label)

    acc = accuracy_score(refs, preds)
    f1 = f1_score(refs, preds, average="weighted")

    print("Accuracy:", acc)
    print("F1:", f1)


print('Pre-fine-tuning evaluation')
evaluate_model(test_dataset)
Output melaporkan akurasi 0.52 dan skor F1 berbobot 0.4589. Hasil baseline ini menunjukkan bahwa model sudah memiliki kemampuan untuk melakukan tugas tersebut, sekaligus masih menyisakan ruang jelas untuk perbaikan melalui fine-tuning.
Pre-fine-tuning evaluation
Accuracy: 0.52
F1: 0.45889163289429247Setelah baseline ditetapkan, kita dapat melakukan fine-tuning model pada tugas klasifikasi berita. Di bagian ini, kita akan memformat data pelatihan, mengonfigurasi adapter LoRA, mendefinisikan pengaturan pelatihan, melatih model, dan menyimpan adapter akhir untuk penggunaan selanjutnya.
Pertama, kita memformat setiap contoh pelatihan agar sesuai dengan struktur prompt yang sama seperti saat inferensi. Kita menambahkan label yang benar di akhir prompt agar model dapat belajar menghasilkan jawaban yang tepat selama fine-tuning.
def format_train(example):
    prompt = build_prompt(example['text'])
    answer = str(example['label'])
    return {'text': prompt + ' ' + answer}

train_dataset = train_dataset.map(format_train)Berikutnya, kita mendefinisikan konfigurasi LoRA. Ini memberi tahu model layer mana yang akan diadaptasi saat fine-tuning, sehingga kita melatih sekumpulan kecil parameter tambahan alih-alih memperbarui seluruh model.
lora_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    bias='none',
    task_type='CAUSAL_LM',
    target_modules=[
        'q_proj','k_proj','v_proj','o_proj',
        'gate_proj','up_proj','down_proj'
    ]
)Lalu kita menetapkan argumen pelatihan untuk supervised fine-tuning. Pengaturan ini mengontrol berapa banyak contoh yang diproses sekaligus, bagaimana gradien diakumulasikan, berapa lama pelatihan berjalan, dan di mana berkas output disimpan.
training_args = SFTConfig(
    output_dir="./qwen35-lora",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=1,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    packing=False,
)Sekarang kita inisialisasi trainer dengan model, dataset, konfigurasi LoRA, pengaturan pelatihan, dan tokenizer. Lalu kita mulai melakukan fine-tuning model pada set pelatihan AG News yang telah diformat.
trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer
)
trainer.train()
Output:
TrainOutput(global_step=157, training_loss=1.9094241804378047, metrics={'train_runtime': 616.477, 'train_samples_per_second': 4.055, 'train_steps_per_second': 0.255, 'total_flos': 1041693973114368.0, 'train_loss': 1.9094241804378047})Setelah pelatihan selesai, kita menyimpan adapter LoRA dan tokenizer. Ini memungkinkan kita memuat ulang adapter yang telah di-fine-tune nanti untuk evaluasi, berbagi, atau publikasi ke Hugging Face.
trainer.model.save_pretrained("qwen35-small-news-class")
tokenizer.save_pretrained("qwen35-small-news-class")Setelah pelatihan, kita memuat ulang model dasar dan memasang adapter LoRA yang disimpan. Ini memungkinkan kita menjalankan evaluasi menggunakan bobot yang telah di-fine-tune dan membandingkan hasilnya dengan baseline sebelumnya.
Pertama kita memuat model Qwen3.5 dasar lagi, lalu memasang adapter LoRA yang telah di-fine-tune dan disimpan di direktori kerja Kaggle. Setelah itu, kita ubah model ke mode evaluasi dan meninjau ringkasan parameter yang dapat dilatih.
from transformers import AutoModelForCausalLM
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype=torch.bfloat16
)


from peft import PeftModel

model = PeftModel.from_pretrained(
    base_model,
    "/kaggle/working/qwen35-small-news-class"
)

model.eval()
model.print_trainable_parameters()
Output menunjukkan bahwa tidak ada parameter yang dapat dilatih pada tahap ini karena pelatihan telah selesai, dan kini kita menggunakan adapter yang disimpan untuk inferensi dan evaluasi.
trainable params: 0 || all params: 758,782,784 || trainable%: 0.0000Selanjutnya, kita menjalankan fungsi evaluasi yang sama pada set uji lagi. Ini memungkinkan kita mengukur seberapa besar peningkatan model setelah fine-tuning.
print('Post-fine-tuning evaluation')
evaluate_model(test_dataset)
Output melaporkan akurasi 0.865 dan skor F1 berbobot 0.8661. Dibandingkan dengan hasil baseline, ini menunjukkan peningkatan besar setelah fine-tuning.
Post-fine-tuning evaluation
Accuracy: 0.865
F1: 0.8660926258753361Sekarang kita dapat membandingkan performa model sebelum dan sesudah fine-tuning. Baik akurasi maupun skor F1 meningkat secara substansial, menunjukkan bahwa fine-tuning QLoRA membantu model beradaptasi dengan baik pada tugas klasifikasi berita.
|
Metrik |
Sebelum Pelatihan |
Sesudah Pelatihan |
|
Akurasi |
0.52 |
0.865 |
|
Skor F1 |
0.4589 |
0.866 |
Seperti yang terlihat, fine-tuning Qwen3.5 Small dengan QLoRA secara signifikan meningkatkan performa klasifikasi.
Setelah evaluasi selesai, kita dapat mengunggah adapter yang telah di-fine-tune dan tokenizer ke Hugging Face. Ini membuat model lebih mudah digunakan kembali, dibagikan, dan dimuat dalam proyek mendatang tanpa mengulangi proses pelatihan penuh.
model.push_to_hub("kingabzpro/qwen35-small-news-class")
tokenizer.push_to_hub("kingabzpro/qwen35-small-news-class")
Setelah unggahan selesai, model akan tersedia di:
Model:
https://huggingface.co/kingabzpro/qwen35-small-news-class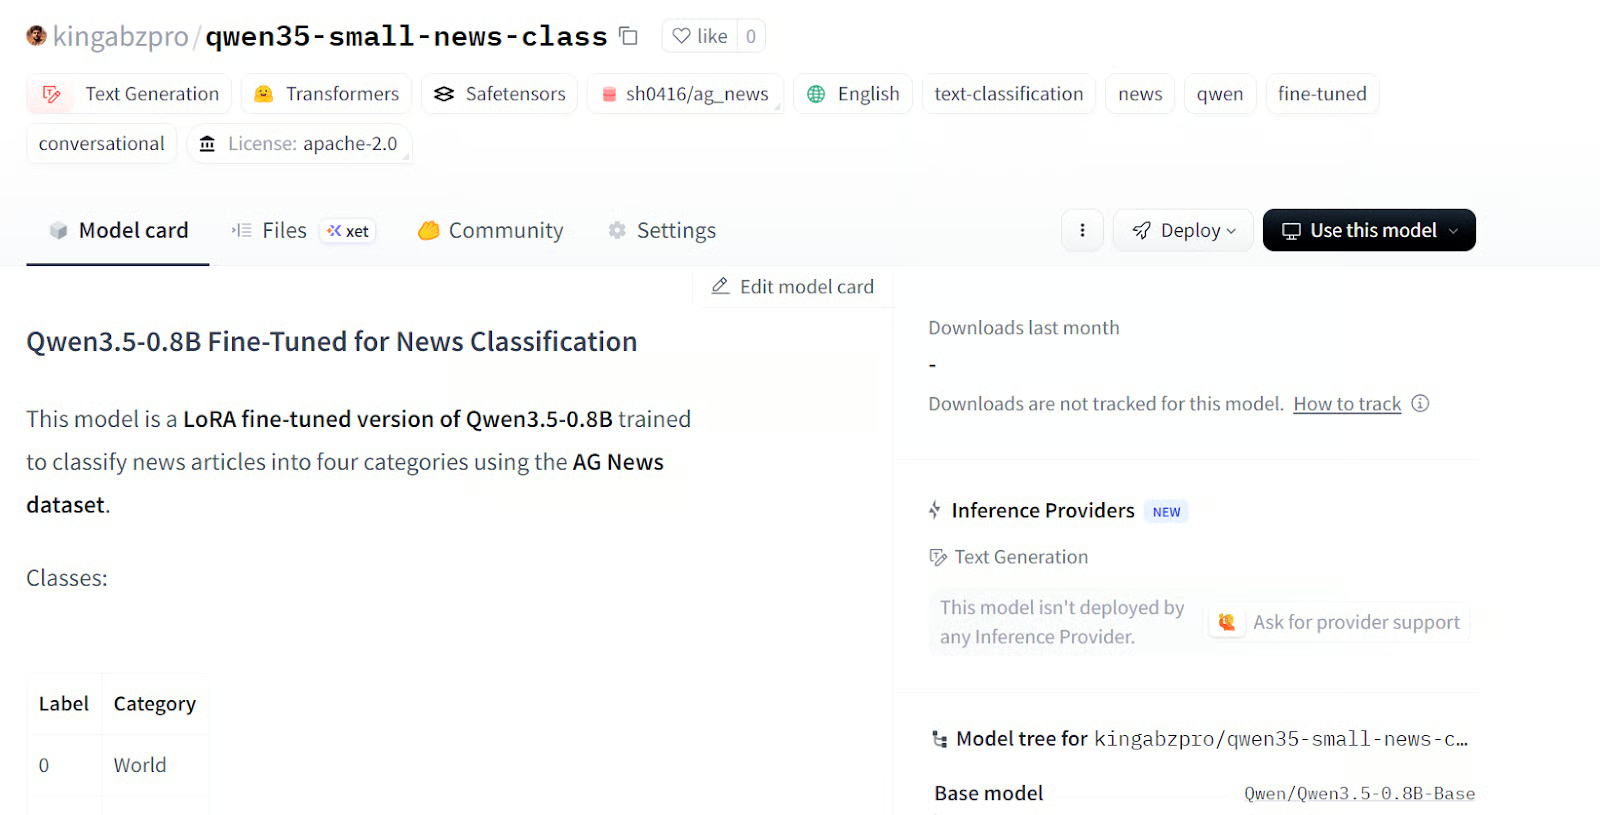
Sumber: kingabzpro/qwen35-small-news-class
Notebook Kaggle untuk tutorial ini juga tersedia. Saya menyarankan untuk menggunakannya hanya jika Anda mengalami kendala saat mereproduksi langkah-langkah di atas. Anda juga dapat mengkloning notebook dan menjalankannya di sistem Anda sendiri, tetapi ingat untuk memperbarui nama pengguna dan token Hugging Face agar sesuai dengan akun Anda.
Dalam tutorial ini, kita melakukan fine-tuning Qwen3.5-0.8B dengan QLoRA untuk klasifikasi berita dan memperoleh hasil yang kuat dari setup yang sangat ringan. Hanya setelah satu epoch pada subset data kecil, akurasi meningkat dari 0.52 menjadi 0.865, dan F1 berbobot naik dari 0.4589 menjadi 0.8661.
Untuk model sekecil ini, itulah bagian yang paling mengejutkan: kita tidak memerlukan model besar, dataset besar, atau pelatihan lama untuk mendapatkan hasil hilir yang kuat.
Yang membuatnya semakin berguna adalah betapa praktisnya setup ini. Qwen menggambarkan model 0.8B sebagai cocok untuk pembuatan prototipe dan fine-tuning tugas spesifik, dan QLoRA menjaga penggunaan memori tetap rendah dengan melatih adapter di atas model dasar 4-bit yang dibekukan. Artinya, ini bukan hanya alur kerja notebook cloud. Ini juga realistis untuk pengujian pada GPU konsumen dan laptop yang lebih kecil.
Alasan lain kenapa model ini menarik adalah karena keluarga Qwen3.5 mendukung fine-tuning teks dan visi. Jadi meski di sini kita menggunakannya untuk klasifikasi teks, ide yang sama dapat diperluas ke klasifikasi gambar, image-to-text, dan text-to-text juga. Itu membuat model kecil seperti ini menjadi opsi yang sangat praktis ketika Anda ingin menguji ide dengan cepat, fine-tuning secara hemat, dan tetap menjaga deployment tetap ringan.
Saya juga menyarankan Anda melihat sumber daya kami yang lain, termasuk panduan Qwen3.5 dan tutorial cara menjalankan Qwen3.5 secara lokal pada satu GPU.
Kursus DataCamp Teratas
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




