
Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 Hr
Saya sudah menyebutkan bahwa ekspektasi harus sesuai dengan modelnya. Hal ini terutama berlaku untuk Jev, dan sebagian besar terkait dengan kelas modelnya, yang disebut sebagai model System One.
Model System One mengembalikan keputusan bertipe alih-alih teks. Anda mengirim satu blok state beserta satu set pertanyaan, masing-masing dengan ruang jawaban yang Anda definisikan, dan model mengembalikan satu jawaban per pertanyaan dengan probabilitas terlampir. Tidak ada yang dihasilkan token demi token, jadi tidak ada string untuk diurai dan tidak ada JSON rusak untuk diperbaiki. TypeSafe mencetuskan istilah ini merujuk pada pembagian terkenal Daniel Kahneman:
Karena ruang jawaban adalah skema yang dideklarasikan oleh kode Anda, model System One secara desain tidak akan pernah mengembalikan kategori yang tidak Anda definisikan. Artinya, ia tidak akan pernah keluar dari skema. Meski demikian, model tetap bisa salah, dan kita akan membahas beberapa kasus yang rumit nanti.
TypeSafe keluar dari mode stealth pada 15 September 2026, dengan Jev dalam early access, melaporkan respons 70 hingga 500 ms dan biaya $0,042 per sejuta token input dengan output gratis. Pada tolok ukur empat alur kerjanya sendiri, Jev mencapai sekitar 68% akurasi—kira-kira setara LLM kelas menengah—dengan biaya sebagian kecilnya.
Untuk informasi lebih lanjut tentang fitur dan performa benchmark, saya sarankan membaca panduan Jev kami.
Tuliskan jawaban yang valid sebelum Anda memanggil API. Jika Anda bisa mendaftarkannya, Anda punya masalah berbentuk Jev:
Gunakan LLM saat outputnya berupa prosa atau kode, saat ruang jawabannya terbuka, atau ketika tugas membutuhkan beberapa lompatan penalaran yang dirangkai. Jev juga bukan alat yang tepat untuk apa pun yang numerik, dan saya akan kembali pada alasannya nanti.
Sebelum menulis kode, buat akun TypeSafe dan buka Playground. Di sini, Anda dapat menempelkan teks sebagai state, menambahkan pertanyaan, dan melihat objek jawaban lengkap tanpa menginstal apa pun. Ini cara tercepat untuk memahami apa yang dikembalikan tiap tipe pertanyaan (dan untuk mengetahui apakah pertanyaan Anda ditulis dengan buruk).
Saya akan menggunakan satu tiket dukungan sebagai state untuk ketiga contoh:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Setiap tipe pertanyaan menerima instructions, pertanyaan dalam bahasa sehari-hari yang ingin Anda jawab. Yang membedakan antar tipe adalah criteria dan apa yang dikembalikan.
Sebuah Choice memilih satu opsi dari set yang Anda definisikan.
Anda mengirim criteria sebagai sebuah dictionary yang memetakan setiap opsi ke deskripsinya, mulai dari 1 hingga 255 opsi, dan jawabannya kembali dengan:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Untuk melihat output kode yang juga akan Anda terima melalui API, klik tombol </> di pojok kanan atas, lalu klik Run agar Jev menjawab pertanyaan.
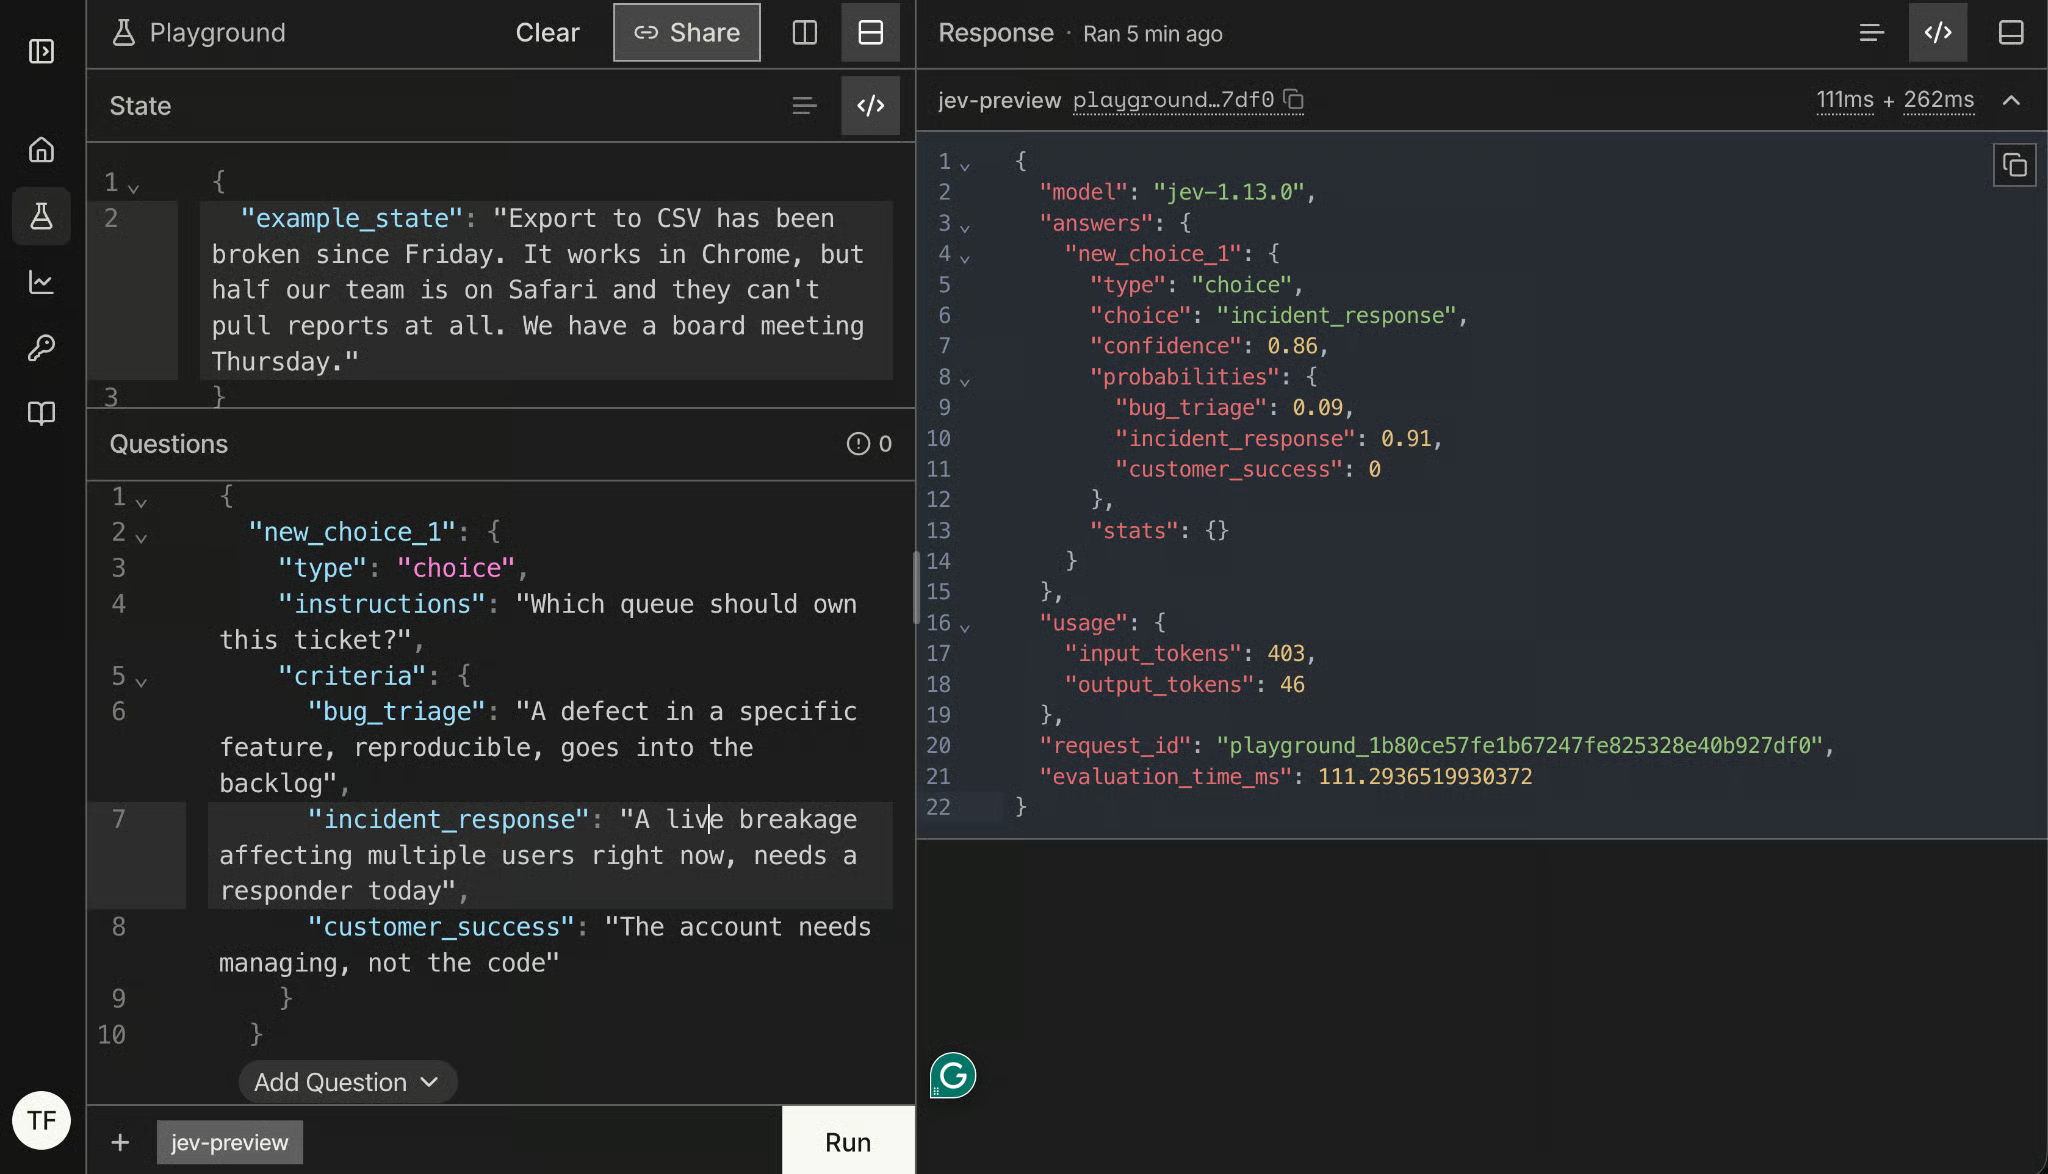
Dalam kasus ini, incident_response adalah choice dengan probabilitas 91%. confidence Jev untuk pilihan tersebut adalah 86%.
Distribusi penuh adalah bagian yang patut diperhatikan.
choice hanya memberi tahu opsi mana yang menang.
probabilities memberi tahu seberapa besar selisihnya.
Itu adalah informasi yang berbeda saat Anda akan merutekan tiket secara otomatis. Pembagian 0,41/0,38/0,21 dan 0,91/0,09/0 yang kita terima sama-sama mungkin mengembalikan choice yang sama.
Score menilai state terhadap level yang berurutan. Anda mengirim criteria sebagai sebuah array berisi 2 hingga 10 deskripsi level, dari terendah dulu, dan jawaban mencakup skor, legend yang memetakan setiap posisi ke deskripsi Anda, probabilitas per level, dan confidence.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}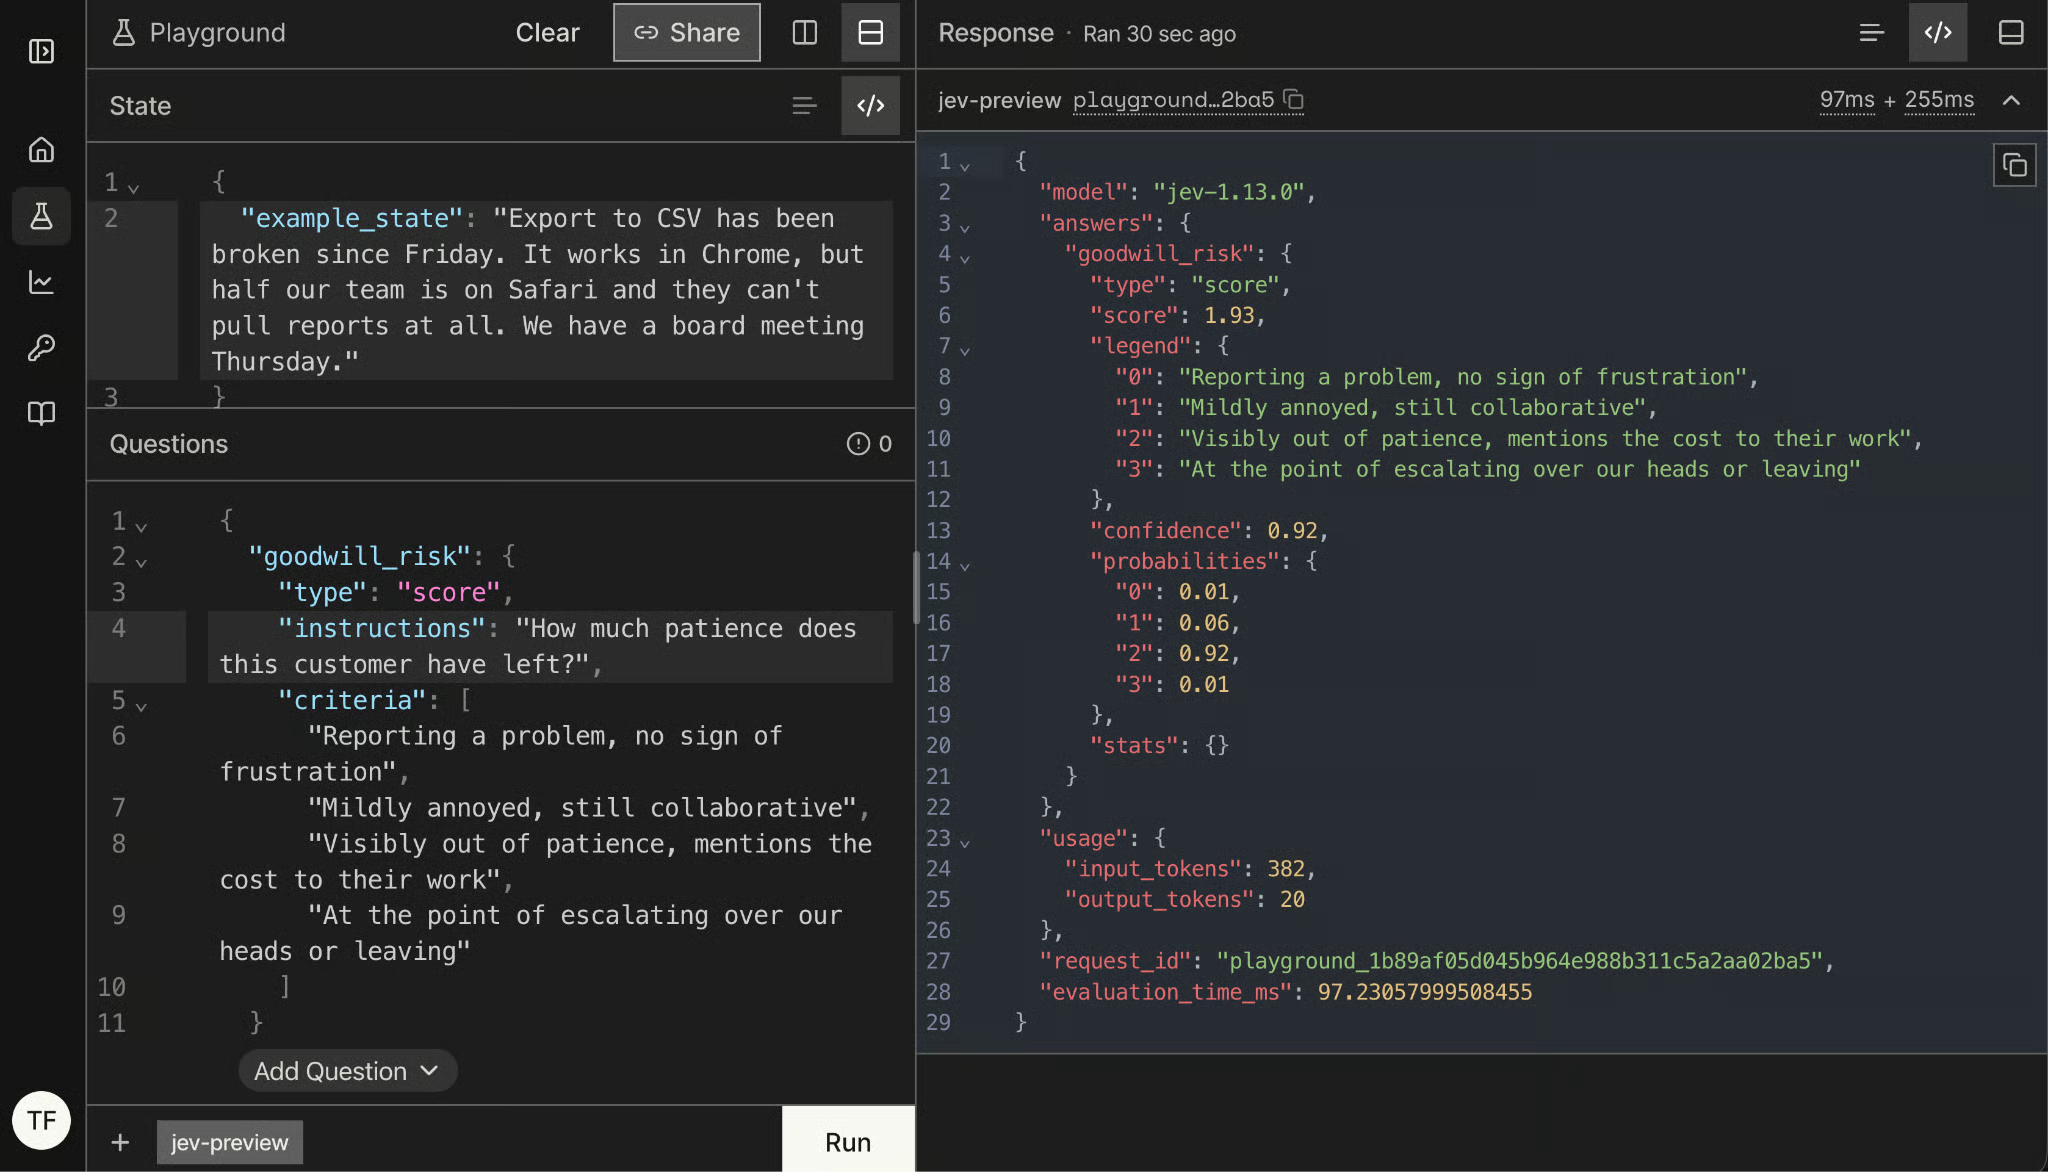
Skor dapat berada di antara level Anda, dan di situlah poin dari legend. score 1,93 di sini berarti model terbagi antara "sedikit kesal" dan "jelas sudah kehabisan kesabaran", dengan kecenderungan kuat ke yang terakhir—bacaan yang wajar untuk tiket yang tetap sopan sambil menyebutkan tenggat yang akan terlewat.
Sekali lagi, baca sebaran probabilities alih-alih hanya angkanya: probabilitas yang terkonsentrasi pada satu level berarti jawaban tegas, probabilitas yang tersebar di tiga level berarti Anda mendapat rata-rata alih-alih penilaian.
Noul adalah tipe untuk pertanyaan biner, dan namanya diciptakan oleh TypeSafe. criteria bersifat opsional di sini, meskipun Anda bisa menjelaskan apa arti true dan false, yang layak dilakukan kapan pun "ya" bisa dibaca dua makna.
Rumuskan pertanyaan sehingga nilai tinggi berarti ya. Dokumentasi TypeSafe tegas soal ini, dan Noul yang true-nya dipetakan ke "tidak" berperformansi lebih buruk secara terukur.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}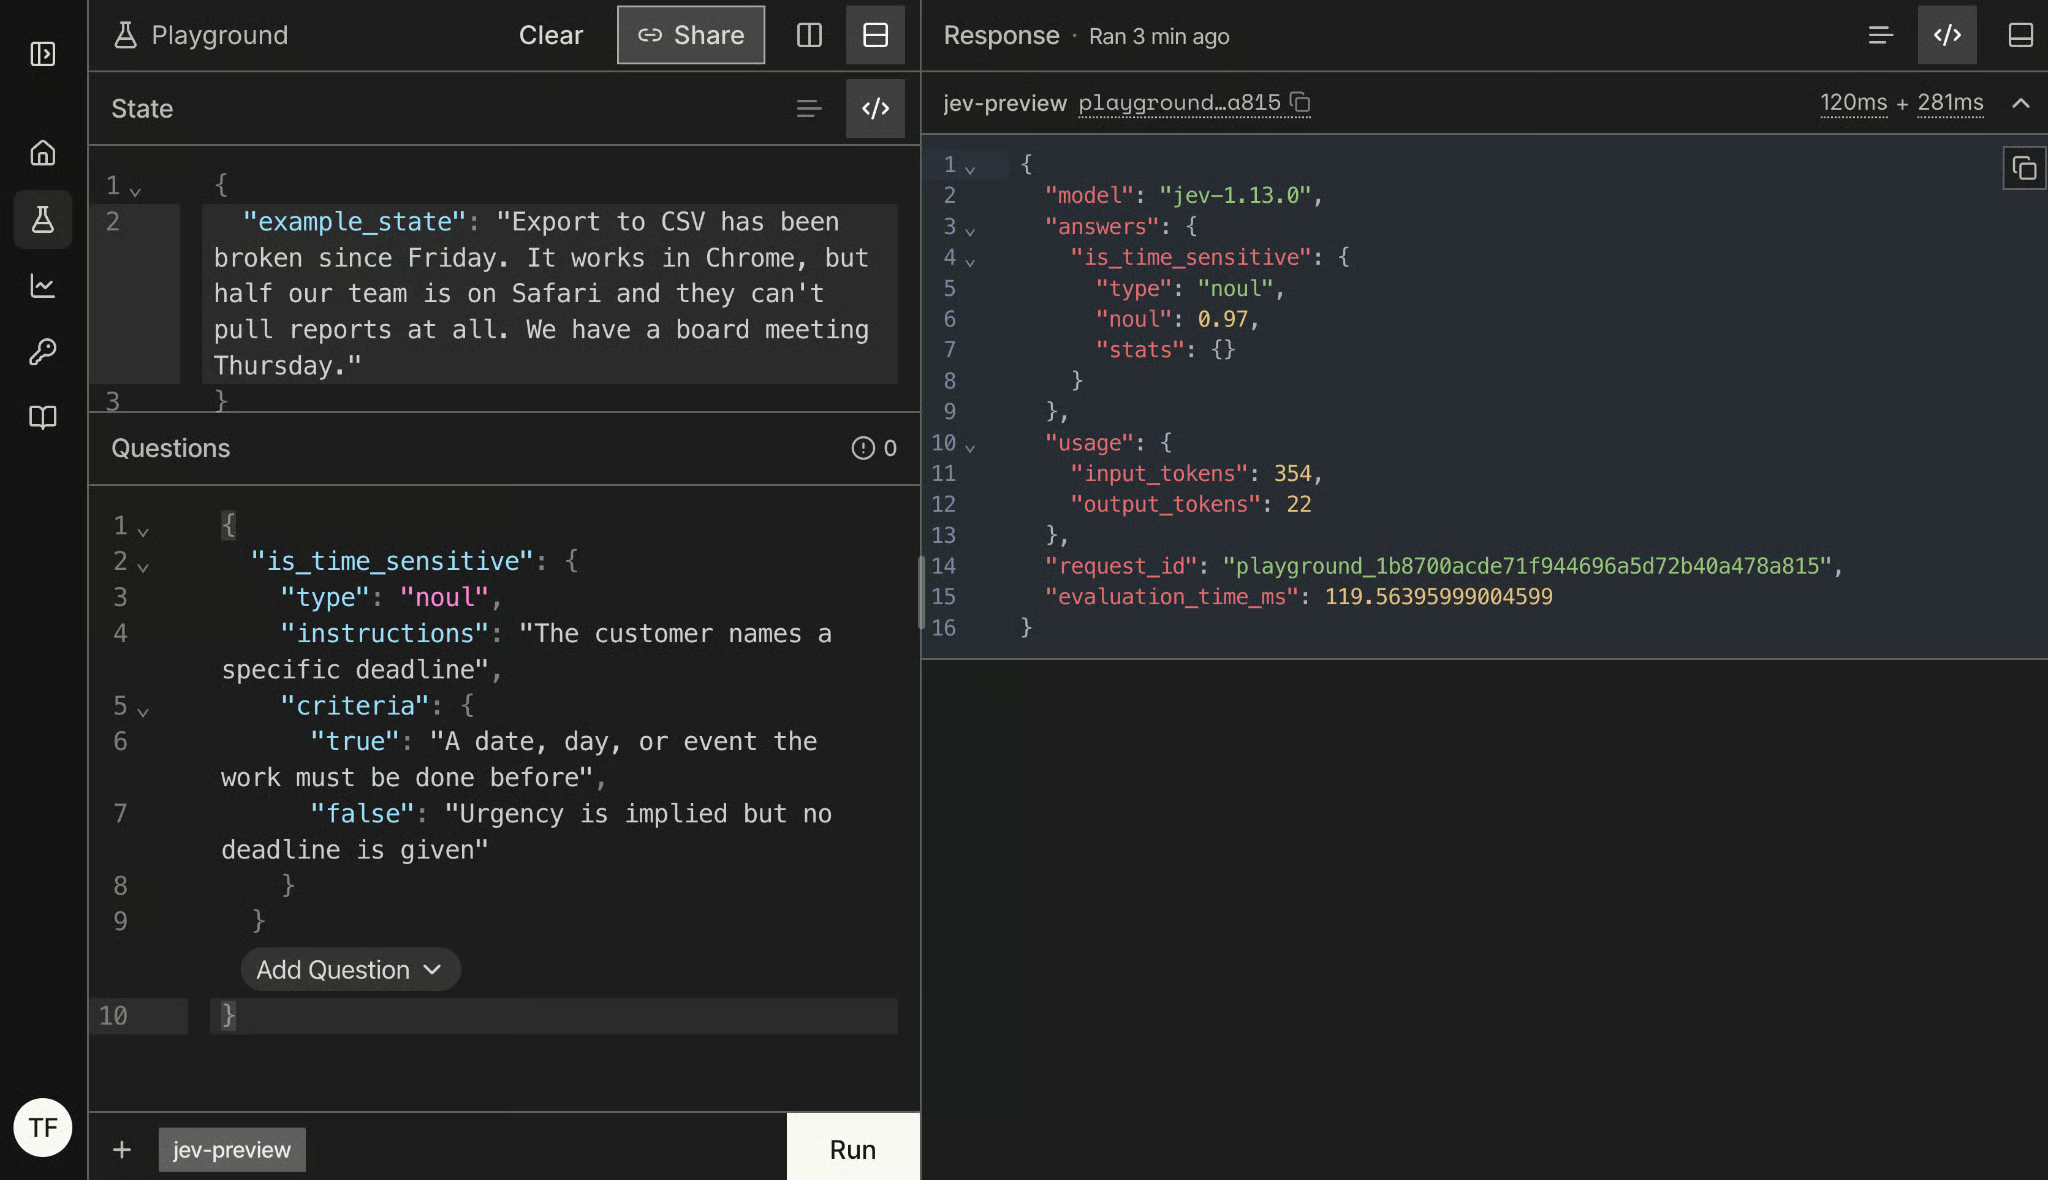
Karena rapat dewan pada Kamis disebutkan dalam state, nilai noul yang tinggi sebesar 0,97 sudah diperkirakan.
Choice dan Score mengembalikan confidence bersama probabilitasnya. Noul tidak, dan itu sering membingungkan orang, jadi ada baiknya kita jelaskan alasannya.
Confidence dan probability berada pada sumbu yang berbeda. Untuk Choice, probabilities menunjukkan bagaimana model mendistribusikan keyakinan di antara opsi Anda, dan confidence menunjukkan seberapa teguh ia memegang jawaban itu—itulah mengapa Choice bisa mengembalikan opsi teratas 0,85 dengan confidence 0,78. Noul hanya punya dua keluaran, jadi probabilitas tunggal sudah memuat keduanya: 0,97 adalah "ya" yang mantap, 0,03 adalah "tidak" yang mantap, dan 0,52 adalah model yang memberi tahu Anda bahwa ia tidak tahu.
Itu berarti jarak dari 0,5 adalah sinyal ketegasan Anda, bukan field terpisah untuk dibaca. Ini juga berarti Anda tidak bisa memindahkan threshold dari Noul ke Choice, dan saya akan kembali ke hal ini di bagian jaggedness, karena dampaknya lebih besar dari yang terlihat.
Untuk mengikuti, Anda hanya memerlukan Python 3.10+ dan kunci early-access TypeSafe.
Instal SDK:
pip install typesafe-sdkAtau dengan uv:
uv add typesafe-sdkLalu buat kunci di konsol TypeSafe dan ekspor. Klien membaca TYPESAFE_API_KEY dari environment, jadi Anda tidak pernah memasukkannya di kode:
export TYPESAFE_API_KEY="your-key"Import berikut memberi Anda semua yang ada di playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul, dan Score adalah tipe pertanyaan yang sama seperti yang baru saja Anda klik, sebagai objek Python.
TypeSafeClient adalah klien sinkron, dan ada AsyncTypeSafeClient dengan antarmuka yang sama jika Anda memanggil Jev dari layanan async. Keduanya bekerja sebagai context manager, yang akan saya gunakan untuk apa pun yang lebih dari sekadar skrip:
with TypeSafeClient() as client:
...Jika dibiarkan, klien akan memanggil jev-latest, yang bergerak setiap kali TypeSafe merilis versi baru, dan itulah yang akan kita gunakan di seluruh tutorial. Untuk apa pun yang sudah Anda kalibrasi threshold-nya, pin versinya:
client = TypeSafeClient(model="jev-1.13.0")Respons akan memberi tahu Anda model mana yang sebenarnya menjawab, dan ada bagian di dekat akhir tentang mengapa Anda harus mencatatnya.
Untuk melakukan panggilan API ke Jev, Anda perlu mendefinisikan item response menggunakan TypeSafeClient dan fungsi system_one(), yang menerima konteks pertanyaan Anda sebagai parameter state, dan questions itu sendiri dalam format yang sama seperti di playground.
Kita dapat membuat satu panggilan yang menjawab ketiga pertanyaan playground kita, karena semuanya berbagi state yang sama:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Jawaban kembali di bawah nama yang sama yang Anda pilih untuk setiap pertanyaan, detail yang membuat semuanya nyaman untuk digunakan:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Jika panggilan pertama Anda gagal dengan TypeError tentang output_buffer_limit: itu adalah ketidakcocokan versi di backend kompresi SDK, bukan kode Anda. SDK menyertakan klien HTTP sendiri, httpx2, yang mendekompresi respons melalui zstandard dan brotli, dan salinan lama salah satunya tidak memiliki argumen yang dipanggil. pip install -U typesafe-sdk httpx2 zstandard brotli menyelesaikannya bagi saya.
Ada dua hal pada output tersebut yang layak dicermati.
Pertama, response.model mengembalikan jev-1.13.0, bukan jev-latest. Anda meminta alias yang bergerak dan Jev memberi tahu versi mana yang sebenarnya menjawab, satu-satunya alasan mengapa mencatat field itu cukup murah untuk dilakukan.
Kedua, objek jawaban diketik per tipe pertanyaan, jadi .choice, .score, dan .noul adalah atribut nyata dan editor Anda mengetahuinya. Tidak ada string JSON di mana pun dalam kode ini, tidak ada yang perlu diurai, dan tidak ada cabang untuk panggilan yang kembali dalam keadaan rusak. Jika Anda lebih suka pengelompokan, SDK juga menyediakan response.choices, response.scores, dan response.nouls, dengan kunci yang sama.
Periksa juga response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Token output hanya digit tunggal dan gratis. Anda membayar untuk state dan pertanyaan, jadi Anda bisa sepenuhnya mengendalikan tuas biaya dengan memutuskan seberapa banyak konteks yang Anda kirim. Itu lebih penting daripada kelihatannya, dan akan muncul lagi di bagian jaggedness: state yang membengkak membuat Anda rugi biaya dan akurasi sekaligus.
Ini adalah salah satu use case yang dibangun untuk Jev. Satu tiket dukungan masuk, dan sesuatu harus memutuskan ke antrean mana tiket itu akan masuk, apakah harus dilihat manusia terlebih dahulu, dan seberapa cepat. Masing-masing adalah penilaian dengan ruang jawaban yang bisa Anda tuliskan sebelum tiket tiba.
Aturan desain yang layak dinyatakan sejak awal: Jev memutuskan apa adanya, kode Anda memutuskan apa yang terjadi. Jev tidak pernah merutekan apa pun. Ia mengembalikan angka, dan perutean hidup dalam fungsi biasa yang bisa Anda baca, uji, dan ubah tanpa menyentuh model.
Pertanyaan dalam satu permintaan dievaluasi secara paralel, jadi pertanyaan keenam hanya menambah biaya token teksnya dan hampir tidak menambah latensi. Itu mengubah cara Anda bertanya. Dengan LLM, Anda akan membatch dengan hati-hati untuk menghemat waktu round-trip, tetapi di sini Anda menanyakan segala yang mungkin Anda perlukan tentang konteks tertentu, termasuk pertanyaan yang mungkin akan Anda abaikan.
Mari perluas pertanyaan sebelumnya dengan tiga Noul lagi yang memberi kita informasi penting tentang cara menangani tiket:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Enam pertanyaan, semuanya dijawab dalam satu panggilan dan satu tagihan. is_automated adalah yang spekulatif: nilainya salah pada hampir semua tiket nyata, dan tetap layak ditanyakan karena ketika sekali saja benar, itu menyelamatkan seseorang dari membuka balasan mailer daemon.
Dua kebiasaan yang ingin saya sarankan.
Simpan set pertanyaan sebagai konstanta level modul alih-alih membangunnya inline, karena itulah yang akan Anda versi-kan bersama threshold.
Dan beri nama pertanyaan sesuai apa yang diukurnya, bukan apa yang akan Anda lakukan dengan jawabannya, karena is_time_sensitive bertahan melewati perubahan kebijakan sedangkan route_to_incident tidak.
Rumuskan pertanyaan secara positif: Kita juga bisa menamai is_automated sesuatu seperti needs_no_reply, tetapi menurut TypeSafe, performa untuk pertanyaan yang dirumuskan positif lebih baik.
Sekarang bagian yang tidak dilakukan Jev. Setiap jawaban datang dengan nilai confidence atau probabilitas, dan angka kedua inilah yang memungkinkan Anda membangun tiga jalur alih-alih dua:
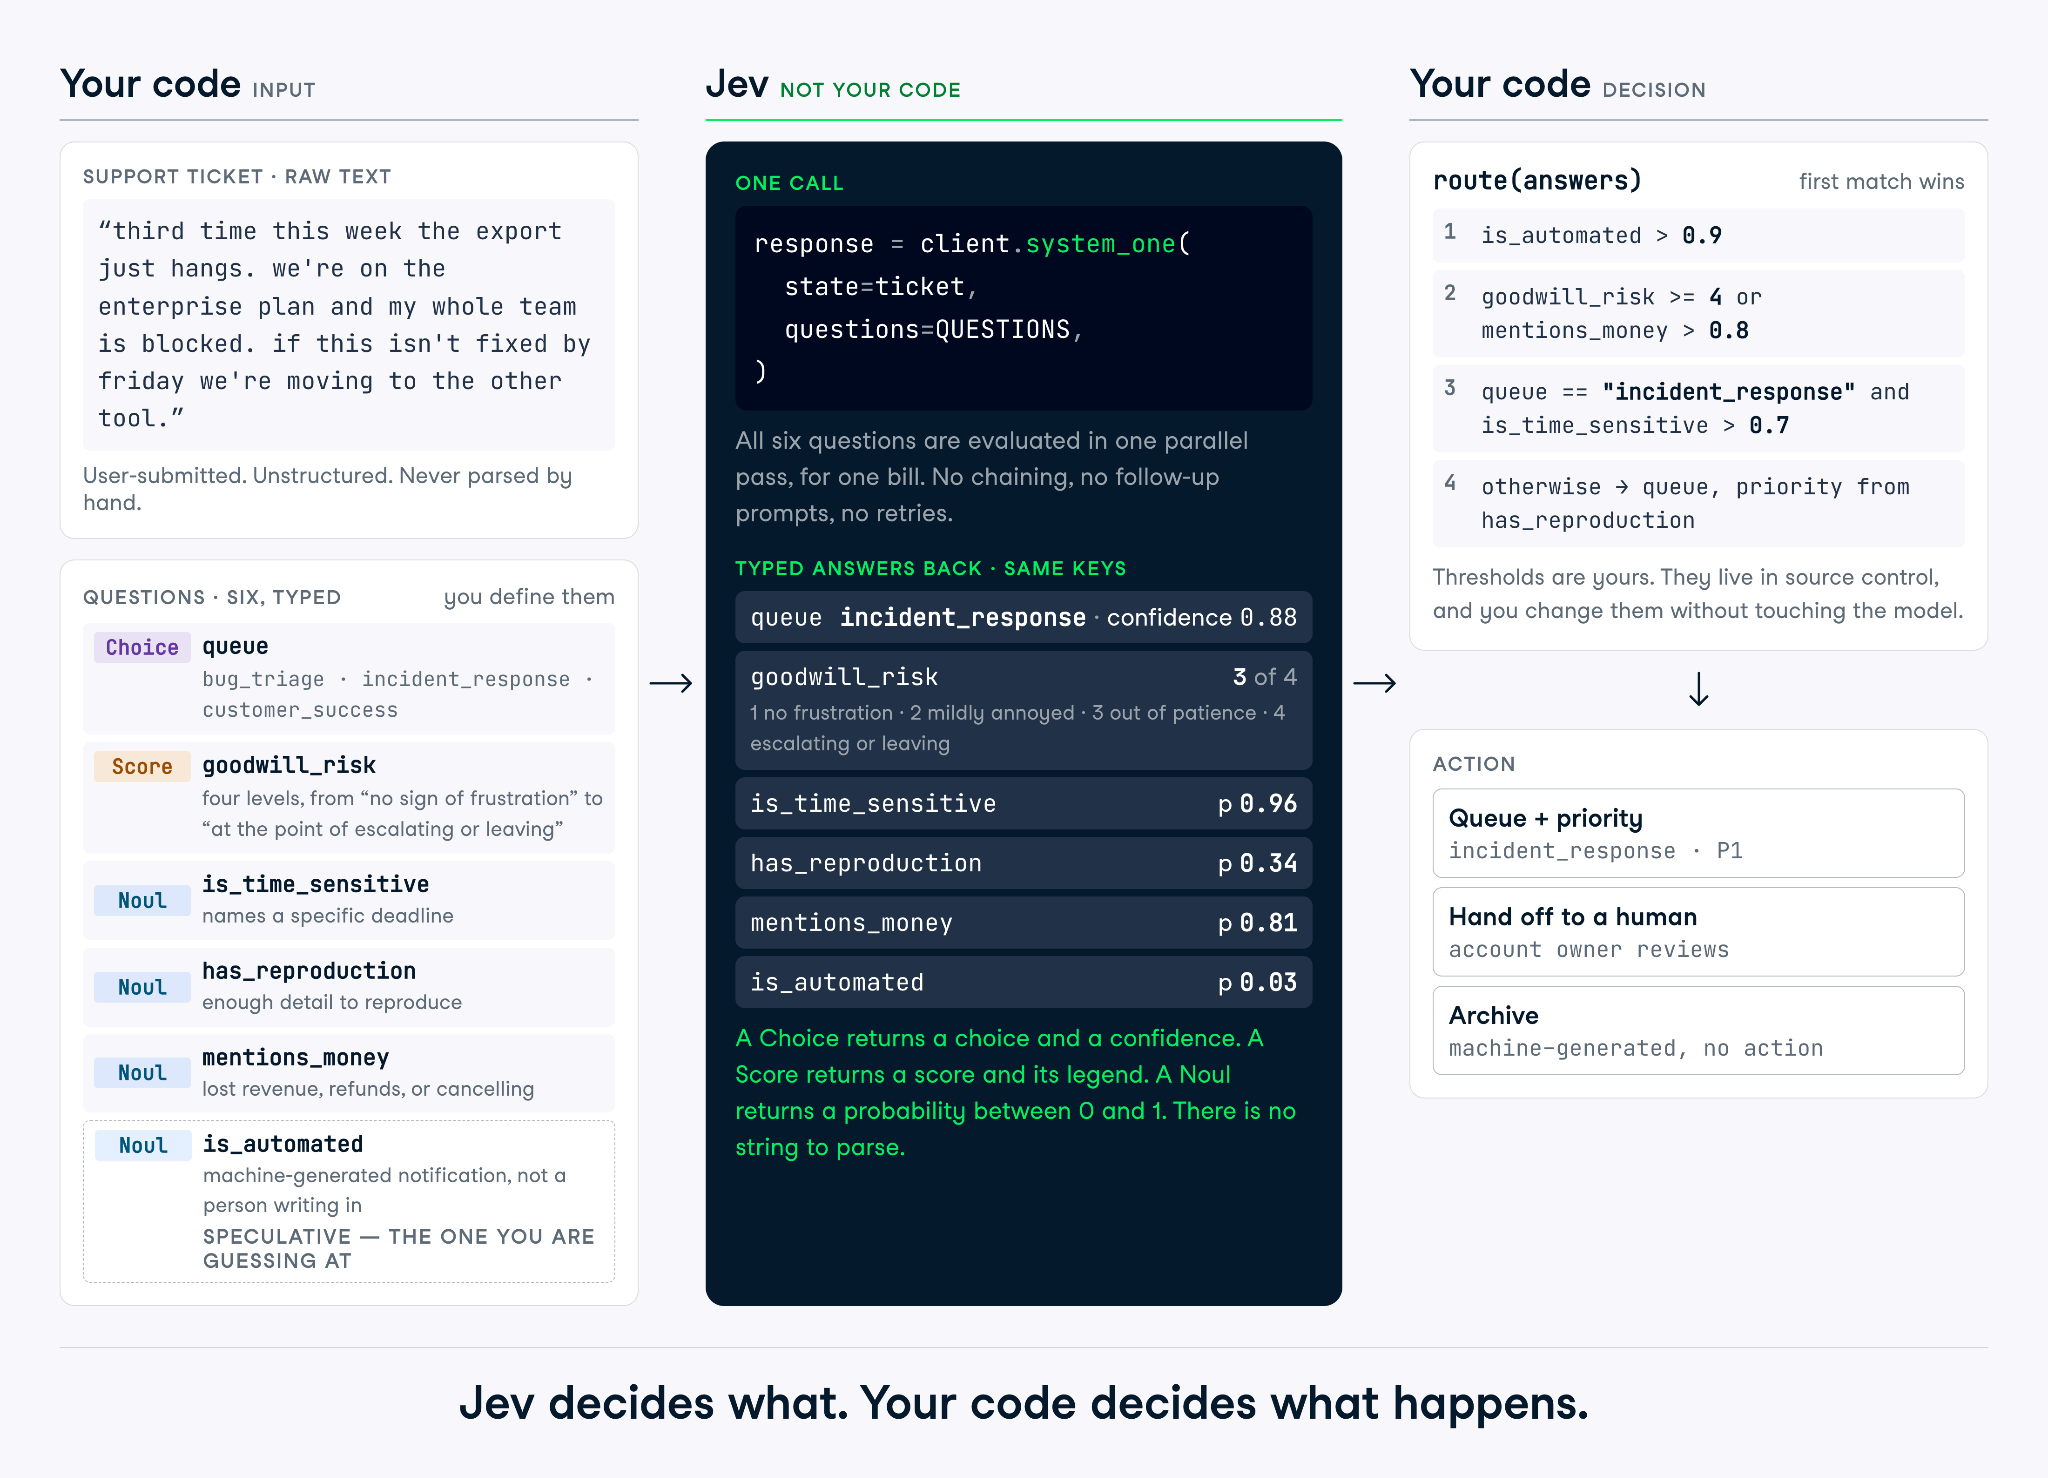
Mari kita ubah itu menjadi beberapa aturan untuk merutekan tiket:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Baca apa yang dilakukan fungsi tersebut. Model memberikan enam penilaian, dan kebijakan memutuskan bahwa salah satunya, mentions_money yang dikombinasikan dengan pelanggan yang frustrasi, mengungguli antrean yang dipilih Jev. Penggantian ini adalah keputusan bisnis, tempatnya di kode, dan Anda bisa mengubahnya pada Jumat sore tanpa menguji ulang model.
has_reproduction tidak pernah digunakan. Saya sengaja membiarkannya, karena seperti itulah pola fan-out dalam praktik: Anda meminta lebih dari yang saat ini dikonsumsi kebijakan, log semuanya, dan ketika seseorang bertanya apakah tiket bug_triage tanpa langkah reproduksi memakan waktu lebih lama untuk ditutup, Anda sudah memiliki enam minggu datanya.
Threshold di atas hanya contoh. Menentukan yang tepat adalah soal kalibrasi, dan ada bagian di akhir tentang cara menentukannya dengan data, bukan perasaan.
Anda dapat mengakses skrip lengkap dari repo GitHub pendamping ini. Saat saya menjalankan skrip Python dengan skenario kita, keputusannya adalah merutekan tiket ke tim incident response hari ini.
python routing.py('incident_response', 'today')TypeSafe memublikasikan halaman jaggedness per versi model, yang mencantumkan mode kegagalan yang diketahui. Saya berharap lebih banyak lab melakukan ini. Bacalah sebelum Anda membangun apa pun, dan bacalah lagi saat Anda meningkatkan versi, karena daftarnya diberi versi dan sisi-sisinya bisa berubah.
Berikut lima hal yang paling banyak akan menghabiskan waktu saya.
Anda tidak bisa memindahkan threshold di antara tipe pertanyaan. Contoh dari TypeSafe sendiri menanyakan "Apakah pelanggan meminta pengembalian dana?" dengan dua cara pada tiket yang sama: Noul mengembalikan 0,22, Choice ya/tidak mengembalikan 0,01 untuk ya, dengan confidence 0,97. Pertanyaan sama, dua angka, selisih dua orde besaran.
Negasi juga tidak kooperatif. Noul dan kebalikannya kembali pada 0,72 dan 0,47, yang jika dijumlahkan menjadi 1,19.
Alasannya adalah kedua tipe menanyakan hal yang berbeda. Choice bersifat relatif dan menentukan opsi mana yang menang, sementara setiap Noul bersifat absolut dan bisa bernilai rendah untuk semuanya. Kalibrasikan threshold per pertanyaan, dalam bentuk yang akan Anda rilis, dan jangan pernah berasumsi P(yes) dan 1 - P(no) adalah angka yang sama.
Level score itu berurutan, bukan berjarak sama. Angka 1,6 memberi tahu bahwa model berada di antara level kedua dan ketiga Anda, condong ke yang ketiga, dan itu saja yang diberitahukan.
Yang tidak bisa Anda lakukan adalah menginterpolasi kuantitas riil darinya. Jika level Anda adalah "kurang dari sejam", "beberapa jam", dan "sehari", angka 1,5 bukan berarti lima jam. Gunakan skor untuk menguji threshold, lalu simpan setiap angka riil di kode.
Jev memperlakukan state sebagai data, tetapi tidak dikeraskan terhadap kode yang ditulis dalam state untuk mengarahkannya. Instruksi tersuntik, framing yang menyesatkan, atau teks yang memperdebatkan klasifikasinya sendiri dapat menggeser jawaban, dan TypeSafe mengatakan mereka berharap untuk membaik di sini. Jika permukaan serangan ini baru bagi Anda, kami membahas kasus umum di panduan prompt injection kami.
Hal ini paling penting ketika state dikirimkan oleh pengguna, yang untuk router tiket terjadi selalu. Tulis kriteria yang cukup presisi sehingga klaim tiket tentang dirinya sendiri tidak menentukan hasil, dan uji dengan input yang bermusuhan sebelum Anda merutekan apa pun secara otomatis.
Penghitungan tidak andal dan semakin buruk seiring bertambahnya jumlah yang dihitung, karena model mengenali bentuk jawaban alih-alih menghitung. Tanggal dibaca sebagai teks, jadi pengurutan, jarak, dan rentang semua gagal. Pengodean numerik berkinerja lebih buruk daripada padanannya yang semantik, jadi tanyakan tentang "merah" alih-alih #FF0000.
Solusinya sama pada ketiganya: pisahkan pekerjaannya.
Jika Anda perlu hitungan, iterasikan di kode dan ajukan satu Noul per item:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Tiga hal kecil yang berbagi penyebab. Jev menjawab pertanyaan yang Anda tulis, bukan yang Anda maksud, jadi kata-kata ruang lingkup dan negasi dibaca apa adanya. Negasi ganda dan pertanyaan tentang properti dari properti mengurangi akurasi. Dan state besar yang dipenuhi detail tak relevan mengorbankan akurasi dan biaya, karena materi tak terkait bertindak sebagai pengalih.
Tandanya untuk yang pertama: saat Anda melihat jawaban yang salah dan mendapati diri Anda menjelaskan apa yang sebenarnya Anda maksud, penjelasan itu adalah setengah instruksi Anda yang hilang.
Berdasarkan yang sudah kita pelajari, berikut beberapa praktik terbaik untuk memaksimalkan Jev.
Tulis kondisi, bukan niat. Jika Anda menjelaskan apa yang Anda maksud saat meninjau jawaban yang salah, penjelasan itu seharusnya ada di instructions. Artinya:
jev-latest bergerak. Pin versinya setelah ada threshold yang bergantung pada perilaku model:
client = TypeSafeClient(model="jev-1.13.0")Catat response.model bersama jawaban lengkap pada setiap panggilan, bukan hanya nilai yang Anda tindaklanjuti. Ketika threshold mulai berperilaku aneh, log itu adalah satu-satunya cara membedakan perubahan model dari drift pada tiket Anda.
Terakhir, threshold bukan hal yang given melainkan hasil eksperimen.
Jev adalah alat yang sempit lingkupnya, dan memang itulah tujuannya. Ia menjawab pertanyaan yang jawabannya bisa Anda enumerasi, cukup murah sehingga Anda berhenti mengiritnya, dan menyerahkan keputusan kembali ke kode Anda.
Yang ingin saya luruskan adalah frasa "tidak bisa berhalusinasi". Ini benar dalam arti sempit bahwa model tidak bisa menjawab di luar skema, tetapi itu tidak mengatakan apa pun tentang apakah jawabannya benar. Choice selalu mengembalikan antrean yang valid. Namun tetap bisa salah pada confidence 0,9, dan keluaran bertipe membuat kegagalan itu lebih senyap.
Untuk mengujinya pada pekerjaan Anda sendiri, saya sarankan temukan satu keputusan yang dibuat kode Anda dengan aturan rapuh atau panggilan LLM yang lambat, lalu coba tuliskan jawaban yang valid. Jika bisa, itu berbentuk Jev. Jika tidak, seberapa pun teknik merancang pertanyaan tidak akan mengubahnya.
Jika Anda ingin mulai membangun sistem yang menggunakan AI, saya sangat merekomendasikan untuk mendaftar ke Associate AI Engineer for Developers career track kami. Anda akan belajar cara bekerja dengan OpenAI API, MCP, LangChain, dan banyak lagi.
Pelajari AI Engineering Bersama DataCamp!
Program
Kursus
Kursus