
{count, plural, one {Kursus} other {Kursus}}
Pengembangan Kode dengan Bantuan AI untuk Developer
{hours} jam {minutes} menit
11K
Kebanyakan pengumuman AI di 2026 berlomba-lomba unggul dalam chat dan penalaran, seperti terlihat pada GPT-6 Astra dari OpenAI, Fable 5.1 dari Anthropic.
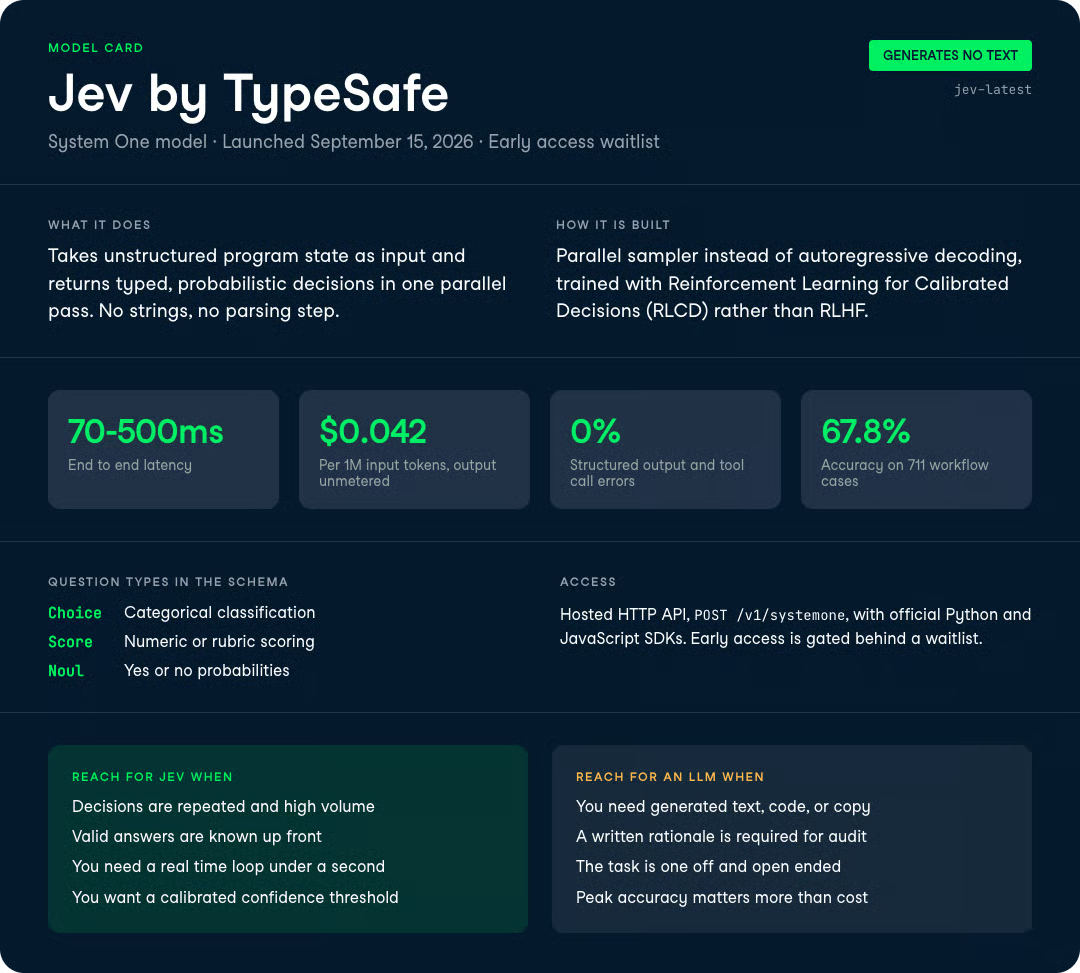
TypeSafe mengambil pendekatan baru. Pada 15 September 2026, perusahaan mengumumkan model yang sama sekali tidak menghasilkan teks.
Model itu bernama Jev, dan termasuk dalam kategori baru model AI yang oleh TypeSafe disebut sebagai model System One.
Alih-alih menghasilkan string satu token demi satu, Jev menerima state program tak terstruktur sebagai masukan dan mengembalikan keputusan bertipe dan probabilistik dalam satu lintasan paralel.
Klaim utama TypeSafe adalah Jev berjalan 40x-200x lebih cepat daripada LLM frontier pada tugas sebanding, biaya $0.042 per satu juta token input dengan output gratis, dan secara matematis tidak dapat berhalusinasi atau menghasilkan kesalahan tipe.
Dalam artikel ini, saya akan membahas apa sebenarnya model System One itu, bagaimana Jev berbeda dari LLM standar, apa yang ditunjukkan tolok ukur alur kerja dibanding model lain, dan di mana menurut saya ini cocok dalam tumpukan nyata.
Untuk liputan lebih mendalam tentang model yang menjadi pembanding Jev, lihat perbandingan kami Jev vs GPT-6 Astra, GPT-5.6 Terra vs Claude Sonnet 5 dan Claude Opus 5 vs GPT-5.6 Sol. Saya juga menyarankan melihat panduan alternatif Jev dan tutorial API Jev kami.
Model System One adalah model AI frontier yang mengembalikan keputusan probabilistik bertipe alih-alih teks.
Anda memberinya satu blok state dan satu set pertanyaan bertipe; ia mengevaluasi semuanya secara paralel dan mengembalikan jawaban terstruktur dengan skor keyakinan terkalibrasi, tanpa generasi string dan tanpa perlu parsing. TypeSafe mencetuskan nama kategori ini bersamaan dengan Jev, rilis publik pertamanya pada September 2026.
Jev adalah model frontier yang dibangun untuk membuat keputusan terstruktur dengan cepat agar dapat langsung dikonsumsi perangkat lunak tanpa langkah parsing atau validasi.
Ini adalah rilis publik pertama di kelas System One milik TypeSafe, tersedia dalam akses awal per September 2026 dan dinamai dari ekonom William Stanley Jevons.
Namanya berasal dari buku Daniel Kahneman, Thinking, Fast and Slow.
System 1 Kahneman bersifat cepat dan intuitif; System 2 lambat dan deliberatif.
LLM yang ada, dengan chain-of-thought dan jejak penalaran beberapa detik, berada kuat di wilayah System 2.
Pendiri TypeSafe, Diogo Almeida, yang turut menciptakan ChatGPT di OpenAI, berargumen bahwa kesenjangan otomatisasi muncul karena semua orang membangun model System 2, padahal sebagian besar keputusan perangkat lunak membutuhkan jawaban System 1 yang cepat.
Dari sisi arsitektur, Jev benar-benar berbeda dari LLM transformer.
Ia menggunakan arsitektur model baru dengan sampler paralel yang menghasilkan semua output dalam satu kueri alih-alih autoregresif, dan metode pelatihan yang oleh TypeSafe disebut Reinforcement Learning for Calibrated Decisions (RLCD).
Jika GPT-5.6 dan Opus 5 dilatih dengan RLHF dan reward terverifikasi untuk menghasilkan teks yang disukai manusia, RLCD mengoptimalkan probabilitas terkalibrasi pada keputusan terstruktur.
Hasilnya, menurut angka TypeSafe sendiri, adalah tingkat kesalahan output terstruktur 0% dan latensi end-to-end 70-500 ms.
Satu catatan tentang metode pelatihan RLCD: TypeSafe memosisikannya langsung berhadapan dengan RLHF dan RLVR. Jika RLHF mengoptimalkan respons chat yang disukai penilai manusia dan RLVR untuk output yang dapat diverifikasi program, RLCD mengoptimalkan probabilitas yang jujur secara epistemik pada tugas keputusan. Itulah mengapa kalibrasi menjadi properti kelas satu di Jev, bukan sesuatu yang ditempelkan lewat prompt.
Berikut kontras arsitektural inti dalam satu tabel, karena perbedaannya mudah terlewat dalam prosa.
| Properti | LLM Frontier (GPT-5.6, Opus 5) | Jev (Model System One) |
|---|---|---|
| Output | String terhasilkan, perlu parsing | Nilai bertipe, dijamin skema |
| Sampling | Sekuensial, satu token tiap kali | Paralel, satu kueri |
| Harga input / 1M token | $0.20-$10 | $0.042 |
| Harga output | ~5x input | Gratis |
| Latensi | 3-329 dtk | 70-500 ms |
| Halusinasi / kesalahan tipe | Mungkin | Tidak mungkin secara konstruksi |
| Kepercayaan diri | Terlalu percaya diri, tidak konsisten | Terkalibrasi per output |
Semua fitur ini berangkat dari satu pilihan desain: Jev melepaskan generasi string sepenuhnya.
Pengurangan itu yang menghadirkan kecepatan, harga, dan jaminan tipe.
Jev mengembalikan nilai terstruktur yang aman tipe, dengan kemungkinan output didefinisikan dalam skema Anda sebelum pemanggilan.
API mengekspos sejumlah kecil tipe pertanyaan:
Anggap saja ini seperti pemanggilan fungsi berinteligensi frontier: state tak terstruktur masuk, keputusan probabilistik bertipe keluar.
Jika Anda melakukan perutean tiket dukungan, Anda bisa mendefinisikan Choice atas {billing, technical, sales, spam} dan Score untuk urgensi dari 0 hingga 100, dan Jev mengisi keduanya dalam satu lintasan. Tidak ada JSON yang perlu di-parse dan tidak ada risiko model menyimpang lalu menulis satu paragraf.
Keterbatasan yang jelas adalah ini hanya bekerja ketika ruang jawaban valid dibatasi dan diketahui sejak awal. Jev tidak berguna untuk generasi terbuka, dan ia tidak menulis skemanya untuk Anda.
Setiap output Jev dilengkapi probabilitas terkalibrasi, artinya keyakinan yang lebih tinggi benar-benar berkorelasi dengan akurasi yang lebih tinggi.
Ini fitur yang menurut saya paling berguna dalam praktik.
LLM standar terkenal terlalu percaya diri bahkan saat Anda secara eksplisit meminta probabilitas.
Jika sebuah model dapat mengklasifikasikan sesuatu dengan benar 95% waktu tetapi tidak bisa memberi tahu 5% mana yang diragukannya, Anda tidak bisa mengotomatiskan proses dengan aman di sekitarnya.
Kalibrasi Jev memungkinkan Anda menetapkan ambang keyakinan dan hanya melakukan tindakan otomatis di atasnya, mengalihkan kasus tidak pasti ke manusia atau LLM yang lebih lambat.
Keterbatasan yang patut dicatat adalah Jev memberi Anda angka, bukan alasan.
Tidak ada penjelasan bahasa alami tentang mengapa ia memberi skor tertentu, yang penting untuk debug dan audit di domain teregulasi.
Karena output Jev dibatasi oleh skema, secara matematis mustahil baginya menghasilkan nilai tidak valid atau kesalahan tipe.
TypeSafe melaporkan tingkat kesalahan output terstruktur 0% dan tingkat kesalahan pemanggilan tool 0%.
Sebagai perbandingan, pada uji output terstruktur TypeSafe, luna dan terra dari OpenAI berada di 0,58%, Opus 5 dari Anthropic 5,73%, dan Claude Haiku 4.5 di 45,5%.
Pada pemanggilan tool, GPT-5.6 Sol yang terburuk di 17,0%.
Pemanggilan tool yang berhalusinasi adalah gangguan pada agen interaktif, namun menjadi masalah nyata saat tersembunyi beberapa lapis dalam rantai dependensi dengan jaminan latensi.
Jev menghasilkan seluruh outputnya dalam satu kueri paralel, bukan memancarkan satu token demi satu.
Inilah sumber latensi 70-500 ms.
Kecepatan itu membuka use case yang tak tersentuh LLM token-by-token.
Demo TypeSafe menunjukkan Jev memainkan Doom dengan bereaksi terhadap state game terstruktur (diberikan sebagai teks) sekitar 10 kali per detik, dengan biaya inferensi sekitar $7/jam.
Intinya bukan bahwa Jev bermain Doom dengan baik—bot terskrip akan mengalahkannya—melainkan ia mampu membuat keputusan reaktif di dalam loop real-time, di mana panggilan LLM 3-30 detik tidak mungkin dilakukan.
Biaya per kasus Jev sekitar $0.0004 membuatnya layak menjalankan satu keputusan pada setiap baris dataset besar, sesuatu yang terlalu mahal dengan LLM frontier.
TypeSafe memosisikan ini sebagai cara mengubah petabita data mentah menjadi fitur dan insight dengan map-reduce keputusan di atasnya.
Contoh konkretnya adalah memberi skor setiap ulasan produk di tabel berisi 50 juta baris untuk sentimen dan pelanggaran kebijakan, yang akan menelan biaya sekitar $20 dalam panggilan keputusan dengan Jev pada tarif yang dilaporkan, dibanding ribuan dolar dengan LLM yang menagih per token.
Versi singkatnya: Jev mendarat kira-kira setara dengan LLM frontier kelas menengah dalam akurasi, sambil mengalahkan semuanya dalam biaya dan latensi satu hingga dua ordo magnitudo.
Semua angka di bawah berasal dari tabel evaluasi milik TypeSafe sendiri, dan belum ada replikasi independen skala besar yang muncul, jadi perlakukan sebagai data dari vendor.
TypeSafe membangun evaluasi kustom di 4 alur kerja (penanganan insiden keamanan, observabilitas jejak agen, pemrosesan faktur, dan layanan pelanggan), memberi skor setiap model terhadap rata-rata prediksi GPT-6 Astra dan Fable dari Anthropic.
Jev rata-rata mencapai 67,8% kesesuaian dengan jawaban acuan.
Begini perbandingannya dengan LLM frontier pada alur kerja yang sama:
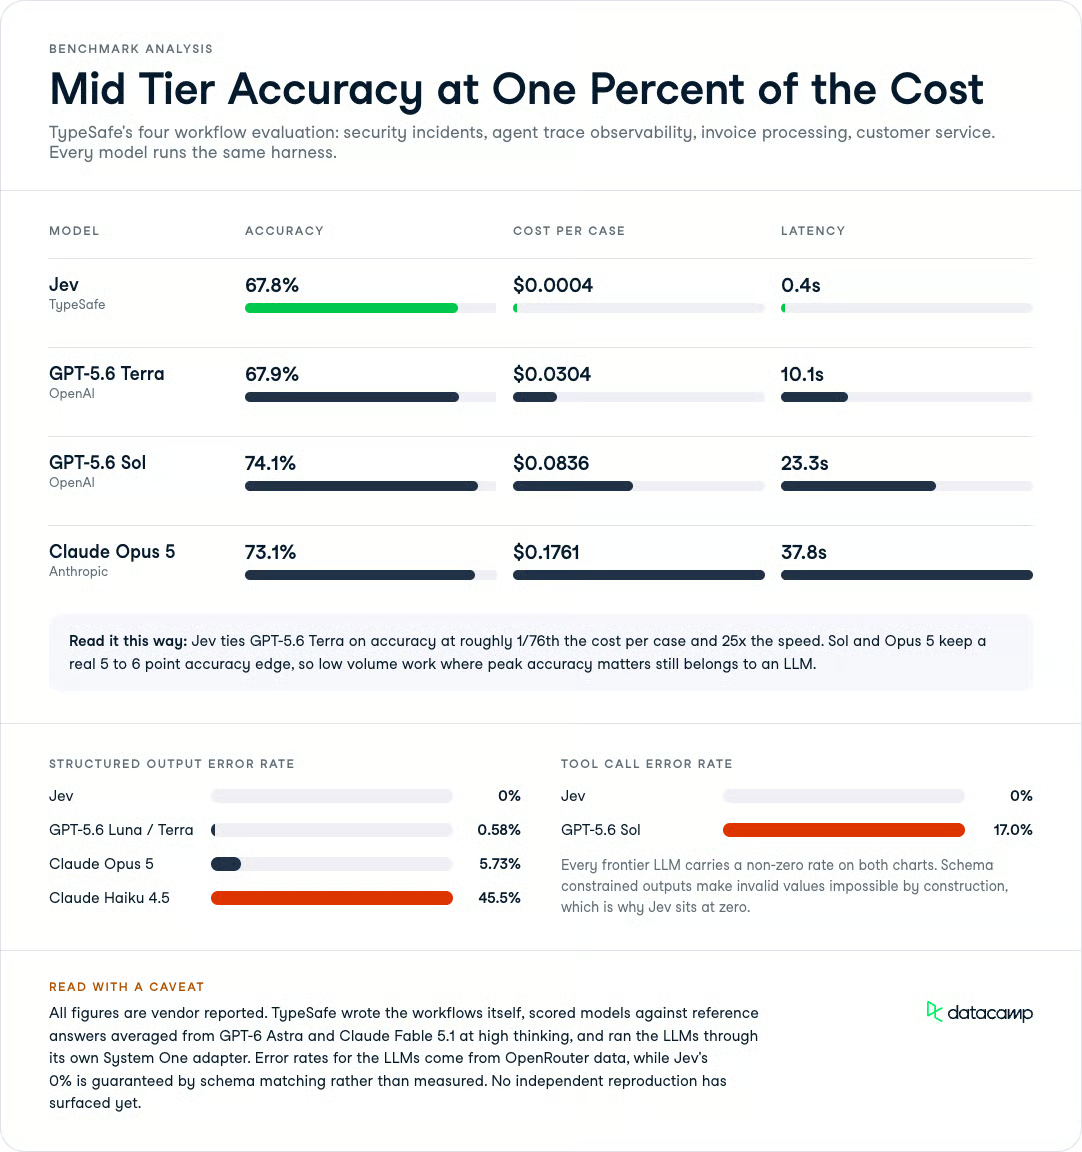
Pola ini konsisten: Jev menukar beberapa poin akurasi dibanding model terbaik dengan penghematan biaya dan latensi yang sangat besar.
| Model | Akurasi | Biaya per kasus | Latensi |
|---|---|---|---|
| Jev (TypeSafe) | 67.8% | $0.0004 | 0.4 dtk |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1 dtk |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3 dtk |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8 dtk |
Jev secara efektif seri dengan Terra dalam akurasi sambil menelan biaya sekitar 1/76 per kasus dan berjalan 25x lebih cepat.
Model dengan akurasi tertinggi, Sol di 74,1% dan Opus 5 di 73,1%, mempertahankan keunggulan nyata 5-6 poin, jadi jika akurasi puncak yang Anda butuhkan pada tugas ber-volume rendah, LLM masih menang.
Pada grafik keandalan, Jev berada di 0% kesalahan baik pada output terstruktur maupun pemanggilan tool, yang memang tujuan dari desain dibatasi skema.
Semua LLM frontier membawa tingkat kegagalan non-nol di sini.
Dua angka menonjol. Claude Haiku 4.5 mencatat 45,5% tingkat kesalahan output terstruktur, dan GPT-5.6 Sol mencatat 17,0% tingkat kesalahan pemanggilan tool.
Itu bukan kasus tepi yang langka; itu jenis kegagalan yang mematahkan pipeline tanpa pengawasan saat dijalankan dalam volume.
Jev mengembalikan probabilitas tetapi tanpa alasan bahasa alami, yang ditandai peninjau sebagai kendala nyata untuk debug dan audit di domain teregulasi.
Jika tim kepatuhan perlu tahu mengapa sebuah aplikasi pinjaman diberi skor tertentu, angka keyakinan saja tidak akan memuaskan.
Solusi praktisnya adalah menyisihkan Jev untuk lapisan perutean volume tinggi dan mengeskalasi kasus bertanda/berkeyakinan rendah ke model yang dapat menghasilkan penjelasan tertulis.
Itu mempertahankan manfaat throughput sambil menjaga jejak audit di mana diwajibkan secara hukum.
TypeSafe cukup terbuka mengenai bias dalam evaluasinya sendiri.
Alur kerja ditulis oleh tim kapabilitas model internal, jadi beberapa bias bisa ada, dan jawaban acuan berasal dari model OpenAI dan Anthropic, yang kemungkinan mengecilkan kinerja relatif Jev dan model DeepSeek.
LLM dalam tes ini dijalankan melalui adapter System One open-source dari TypeSafe, yang memaksa mereka mengeluarkan keputusan terstruktur yang kompatibel dengan API.
TypeSafe mengatakan ini cara paling akurat untuk mengekstrak keputusan dari LLM, meski lebih lambat dan lebih mahal daripada membiarkan model menjawab tanpa probabilitas.
Sampai ada rangkaian independen yang mereproduksi ini pada harness netral, saya akan membaca paritas akurasi ini sebagai menjanjikan alih-alih sudah final.
Jev tidak bersaing dengan GPT-5.6 atau Opus 5 untuk pekerjaan yang sama, jadi pertanyaan berguna adalah kelas model mana yang harus dipilih.
Pemisahnya adalah apakah tugas Anda membutuhkan keputusan terbatas atau jawaban terbuka.
| Use case | Pilih | Alasan |
|---|---|---|
| Klasifikasi atau perutean jutaan tiket | Jev | Output terbatas, biaya dan throughput dominan |
| Pemberian skor atau guardrail output LLM dalam skala besar | Jev | Probabilitas ya/tidak yang cepat, tanpa risiko halusinasi |
| Keputusan real-time di dalam loop aplikasi | Jev | Latensi 70-500 ms vs 3-30 dtk untuk LLM |
| Menulis kode, email, atau ringkasan | LLM Frontier | Jev sama sekali tidak menghasilkan teks |
| Penalaran multi-langkah satu kali dengan penjelasan | LLM Frontier | Butuh alasan dan output terbuka |
Dalam praktiknya, keduanya saling melengkapi: gunakan Jev sebagai lapisan keputusan cepat yang mengklasifikasi, memberi skor, dan merutekan, lalu serahkan sebagian kecil kasus yang sulit atau terbuka ke model seperti Terra atau Opus 5. Kalibrasi Jev yang membuat pengalihan itu mulus, karena Anda dapat merutekan berdasarkan ambang keyakinan.
Harga Jev adalah bagian paling agresif dari penawarannya.
Token input berharga $0.042 per satu juta ($42 per satu miliar), dan token output tidak diukur, dijelaskan oleh TypeSafe sebagai terlalu murah untuk diukur karena model mengembalikan keputusan terstruktur alih-alih teks panjang.
Skalanya, tarif input itu kira-kira 1/48 dari $2.00 per satu juta token input milik GPT-5.6 Terra, dan Terra juga menagih $12.00 per satu juta token output di atasnya.
Pada level alur kerja, evaluasi internal TypeSafe menempatkan Jev sekitar $0.0004 per kasus dibanding $0.0304 untuk Terra dan $0.0836 untuk Sol.
TypeSafe terus terang bahwa mereka tidak bisa membuktikan harga ini tidak disubsidi, dan mengatakan jangka panjang yang akan membuktikan keberlanjutan, meski mereka memperkirakan harga akan turun, bukan naik.
Jev berada dalam akses awal per 15 September 2026, di balik daftar tunggu dengan pengembang yang ditarik dari sana seiring waktu. Saya tidak melihat adanya program kredit gratis atau uji coba yang eksplisit dalam materi peluncuran.
Jev adalah model proprietari yang di-host dan dapat diakses melalui HTTP API TypeSafe. Namun, untuk mengaksesnya, Anda perlu bergabung ke daftar tunggu dan memantau komunitas di TypeSafe AI Blog.
Endpoint-nya adalah POST https://api.typesafe.ai/v1/systemone, dan rute model akses awal direferensikan sebagai jev-latest.
TypeSafe menyediakan SDK resmi untuk Python dan JavaScript di samping HTTP API mentah.
Anda mendefinisikan tipe pertanyaan (Choice, Score, Noul) dalam skema dan meneruskan state program Anda sebagai input; responsnya kembali sebagai nilai bertipe dengan probabilitas terkalibrasi.
Berikut bentuk minimal sebuah permintaan ke rute serverless:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
Untuk referensi skema lengkap dan penyiapan SDK, dokumentasi resmi TypeSafe adalah sumber kebenaran.
TypeSafe membuat taruhan strategis bahwa banyak hal yang saat ini diminta orang ke LLM sejatinya adalah pengambilan keputusan terstruktur yang dibungkus sebagai chat.
Jika itu benar, keunggulan biaya 40-400x dan jaminan kesalahan tipe 0% dari Jev mengubah ekonomi otomasi volume tinggi dengan cara yang tidak bisa ditandingi GPT-5.6 dan Opus 5 dari sisi harga.
Penilaian jujur saya: Jev tampak benar-benar berguna sebagai lapisan keputusan dan guardrail yang cepat, dan kisah kalibrasinya adalah bagian yang benar-benar akan saya jadikan dasar bangunan.
Pertanyaan terbukanya adalah apakah tolok ukur independen mengonfirmasi paritas akurasi dan apakah harga bertahan setelah subsidi berakhir.
Jika Anda ingin memahami masalah keputusan yang dibangun untuk Jev, AI Fundamentals skill track kami membahas konsep klasifikasi dan kalibrasi yang mendasarinya.
Kursus Teratas di DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt



