
Kursus
Konsep Generative AI
2 jam
121.1K
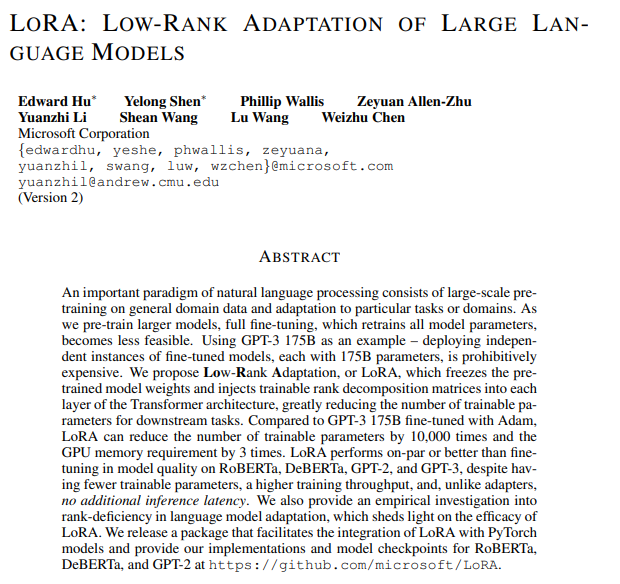
LoRA: Adaptasi Peringkat Rendah pada Large Language Models
Bidang machine learning dan natural language processing (NLP) mengalami kemajuan luar biasa dengan hadirnya Large Language Models (LLM) seperti GPT, LLaMa, Claude 2, dan lainnya. Model-model ini menunjukkan kemampuan yang luar biasa dalam berbagai aplikasi, mulai dari pembuatan teks hingga pemahaman bahasa.
Namun, penerapan praktis dan fine-tuning model-model ini menghadirkan tantangan besar, terutama karena ukuran dan kompleksitasnya.
Di sinilah Low-Rank Adaptation (LoRA) berperan, menawarkan solusi efektif untuk tantangan tersebut.
Tujuan tutorial ini adalah membangun pemahaman teoretis dan praktis tentang apa itu LoRA dan bagaimana Anda dapat memanfaatkannya.
Awal mula LoRA bermula pada awal 2021, setelah rilis GPT-3. Microsoft, bekerja sama dengan OpenAI, menghadapi tantangan membuat model besar seperti GPT-3 layak secara komersial.
Mereka menemukan bahwa one-shot prompting saja tidak cukup untuk mencapai performa optimal di produksi, terutama untuk tugas kompleks seperti menerjemahkan bahasa alami ke kode. Hal ini mendorong eksplorasi metode fine-tuning yang hemat biaya namun efisien.
Penemuan LoRA berangkat dari kebutuhan produk untuk memungkinkan fine-tuning LLM yang cepat, efisien, dan hemat biaya guna menghadirkan kekhususan domain, peralihan tugas yang efisien, atau peralihan pengguna saat run time.
Makalah riset LoRA diterbitkan pada Oktober 2021 oleh tim peneliti dari Microsoft.
Mari pahami masalahnya sebelum kita memahami apa itu LoRA dan bagaimana cara kerjanya.
Model bahasa besar seperti GPT-4, Claude 2, LLaMA 70b, dan lainnya memang hebat, tetapi sangat generik dan besar. Untuk mengadopsi LLM ini pada domain spesifik seperti layanan kesehatan atau perbankan, atau untuk tugas tertentu seperti mengonversi teks menjadi kode, kita memerlukan sesuatu yang disebut fine-tuning.
Fine-tuning adalah proses melatih model pra-latih pada dataset yang lebih kecil dan spesifik untuk mengkhususkan kinerjanya pada tugas atau domain tertentu. Seiring ukuran model membesar (misalnya, GPT-3 memiliki 175 miliar parameter), fine-tuning penuh yang melatih ulang semua parameter model menjadi kurang layak karena waktu, biaya, dan sumber daya.
LoRA adalah teknik yang digunakan untuk melakukan fine-tuning pada model besar.
Secara garis besar, begini cara kerja LoRA:
LoRA mempertahankan model asli tanpa perubahan dan menambahkan bagian-bagian kecil yang dapat diubah ke setiap layer model. Ini secara signifikan mengurangi parameter yang dapat dilatih dan menurunkan kebutuhan memori GPU untuk proses pelatihan, yang juga menjadi tantangan besar saat melakukan fine-tuning atau melatih model besar.
Sebagai contoh, fine-tuning penuh pada model GPT-3 mengharuskan kita melatih 175 miliar parameter. Dengan LoRA, parameter yang dapat dilatih pada GPT-3 akan berkurang kira-kira 10.000 kali dan kebutuhan memori GPU turun tiga kali lipat.
Intinya, LoRA menyelesaikan masalah berikut:
Sebelum masuk ke detail LoRA, mari pahami konsep matriks berperingkat rendah.
Matriks berperingkat rendah adalah konsep dalam matematika, khususnya aljabar linier. Secara sederhana, peringkat (rank) suatu matriks adalah ukuran "kandungan informasi" atau "dimensionalitas" data yang direpresentasikan oleh matriks tersebut. Mari kita uraikan:
Contoh:
Pertimbangkan matriks 3 x 3:
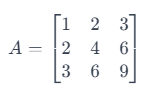
Di sini, baris kedua hanyalah baris pertama dikalikan 2, dan baris ketiga adalah baris pertama dikalikan 3. Ini berarti baris-baris tersebut tidak bebas linear. Peringkat matriks ini adalah 1 (karena hanya baris pertama yang independen), yang lebih rendah dari peringkat maksimum untuk matriks 3x3, yaitu 3. Jadi, ini adalah matriks berperingkat rendah.
Matriks berperingkat rendah penting dalam berbagai aplikasi seperti kompresi data, di mana menurunkan peringkat matriks membantu mengompresi data sambil mempertahankan informasi sebanyak mungkin.
Peringkat dalam matriks berlaku sama untuk baris dan kolom. Poin krusialnya adalah peringkat matriks sama, baik dihitung berdasarkan baris maupun kolom. Ini karena sifat fundamental dalam aljabar linier yang dikenal sebagai Teorema Rank-Nullity.
Dalam istilah yang lebih sederhana, teorema ini menyatakan bahwa dimensi ruang baris (ruang yang direntang oleh baris) dan ruang kolom (ruang yang direntang oleh kolom) dari sebuah matriks adalah sama. Dimensi umum inilah yang kita sebut sebagai peringkat matriks.
Jadi, pada contoh matriks 3 x 3 di atas, peringkatnya adalah 1, yang berarti hanya ada satu baris bebas linear dan hanya satu kolom bebas linear.
Secara sangat sederhana, LoRA memanfaatkan konsep matriks berperingkat rendah untuk membuat proses pelatihan model menjadi sangat efisien dan cepat.
Model besar memiliki banyak parameter. Misalnya, GPT-3 memiliki 175 miliar parameter. Parameter-parameter ini hanyalah angka yang disimpan dalam matriks. Menyimpannya membutuhkan banyak ruang penyimpanan.
Fine-tuning penuh berarti semua parameter akan dilatih, dan ini memerlukan sumber daya komputasi yang luar biasa besar yang bisa dengan mudah menelan biaya jutaan dolar untuk ukuran model seperti GPT.
Berbeda dari fine-tuning tradisional yang memerlukan penyesuaian seluruh model, LoRA berfokus pada modifikasi subset parameter yang lebih kecil (matriks berperingkat rendah), sehingga mengurangi beban komputasi dan memori.
LoRA dibangun atas pemahaman bahwa model besar secara inheren memiliki struktur berdimensi rendah. Dengan memanfaatkan matriks berpangkat rendah, LoRA mengadaptasi model-model ini secara efektif. Metode ini berfokus pada konsep inti bahwa perubahan model yang signifikan dapat direpresentasikan dengan lebih sedikit parameter, sehingga membuat proses adaptasi lebih efisien.
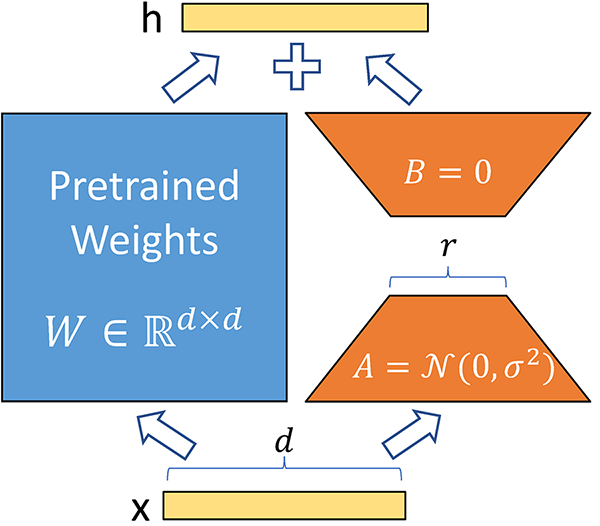
Sumber: Fine-Tuning LLMs: LoRA or Full-Parameter? An in-depth Analysis with Llama 2
Pertama, kita menguraikan matriks bobot besar menjadi matriks yang lebih kecil dengan teknik matriks berperingkat rendah, seperti dijelaskan di atas. Ini sangat mengurangi jumlah parameter yang dapat dilatih. Untuk model seperti GPT-3, parameter yang dapat dilatih berkurang 10.000 kali. Artinya alih-alih melatih 175 miliar parameter, jika Anda menerapkan LoRA, Anda hanya memiliki 17,5 juta parameter yang dapat dilatih.
Kita tidak mengubah parameter apa pun pada model pra-latih. Sebagai gantinya, hanya melatih matriks berperingkat rendah, yang berlangsung relatif sangat cepat karena jumlah parameternya lebih sedikit.
Bobotnya bersifat aditif. Artinya saat inferensi, kita cukup menambahkan bobot matriks berperingkat rendah ke bobot pra-latih tanpa latensi tambahan. Matriks berperingkat rendah juga berukuran sangat kecil sehingga sangat mudah dimuat dan dikeluarkan untuk berbagai tugas dan pengguna yang berbeda.
Ada beberapa keunggulan menggunakan LoRA untuk fine-tuning:
LoRA mengurangi beban komputasi, memungkinkan adaptasi model yang lebih cepat. Dengan membutuhkan lebih sedikit parameter yang dapat dilatih, LoRA memungkinkan fine-tuning model besar pada perangkat keras yang kurang bertenaga.
Meski jumlah parameter berkurang, LoRA mempertahankan kualitas model asli dan kecepatan inferensinya.
LoRA secara drastis mengurangi ukuran checkpoint model. Misalnya, pada GPT-3, ukuran checkpoint berkurang dari 1 TB menjadi hanya 25 MB.
LoRA tidak menimbulkan latensi tambahan selama inferensi. Sementara matriks berperingkat rendah digunakan saat pelatihan, matriks tersebut digabung dengan parameter asli saat inferensi, sehingga tidak ada perlambatan. Ini memungkinkan peralihan model yang cepat saat run time tanpa latensi inferensi tambahan.
LoRA dapat diterapkan pada model apa pun yang menggunakan perkalian matriks (seperti support vector machine), sehingga menjadi teknik yang berlaku luas di banyak kasus penggunaan lainnya. Faktanya, LoRA banyak digunakan pada model Stable Diffusion untuk memasukkan gaya pada model gambar besar.
Teknik LoRA juga banyak diadopsi pada model gambar seperti Stable Diffusion.
Gagasannya kurang lebih sama seperti pada model bahasa. Alih-alih melakukan fine-tuning penuh pada model besar seperti Stable Diffusion, kita hanya melatih matriks berperingkat rendah pada dataset kecil.
Dalam kasus model bahasa, tujuannya adalah kekhususan domain. Untuk model gambar, kasus penggunaan yang paling jelas adalah mengadopsi gaya atau karakter yang konsisten saat menghasilkan gambar.
Matriks berperingkat rendah ini dikenal sebagai adapter; ukurannya sangat kecil, dan ada ribuan di internet yang dapat Anda unduh dan terapkan di atas model dasar Stable Diffusion Anda untuk menghasilkan gambar spesifik gaya.
Beberapa penggunaan umum model LoRA Stable Diffusion adalah:
Anda dapat mengombinasikan beberapa LoRA untuk mendapatkan keluaran yang mencerminkan beberapa spesialisasi.
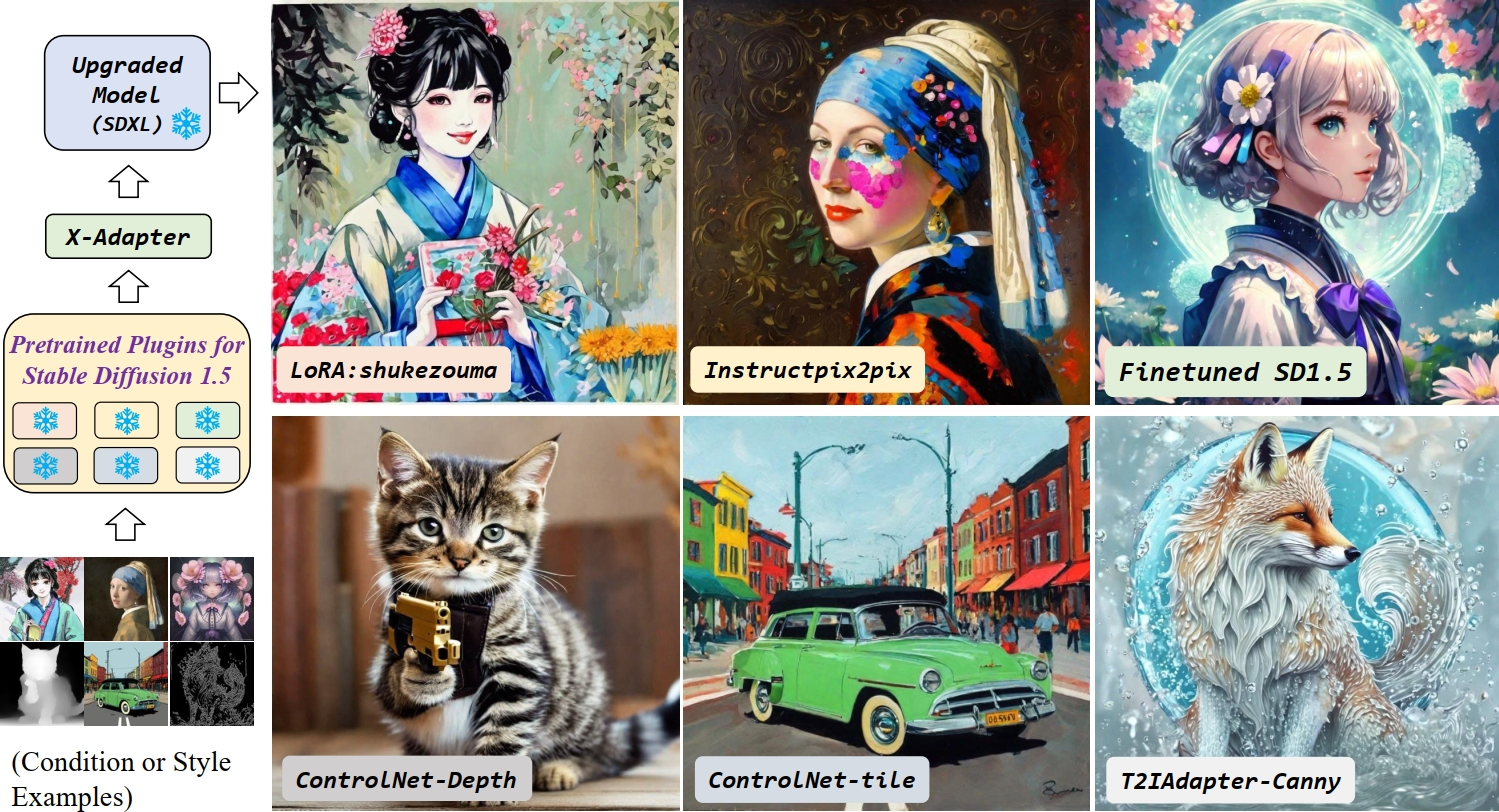
Adapter berbeda untuk Model Stable Diffusion (Sumber Gambar)
Jika Anda ingin mempelajari cara melakukan fine-tuning Stable Diffusion XL pada foto pribadi, baca blog Fine-tuning Stable Diffusion XL dengan DreamBooth dan LoRA di Datacamp.
Prefix tuning adalah metode ringan di mana vektor kontinu yang disebut "prefix" dioptimalkan dan ditambahkan ke input setiap layer Transformer. Model dilatih dengan cara prefix-stripped, berfokus hanya pada vektor-vektor ini.
LoRA dan prefix tuning dapat digabung dalam kerangka PEFT (Parameter Efficient Fine-Tuning):
Untuk mengimplementasikan LoRA, Anda dapat menggunakan pustaka Loralib dari Microsoft. Untuk memasang pustaka:
pip install loralib
Cara Anda biasanya melatih neural network tidak banyak berubah untuk mengadopsi LoRA.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Sebelum loop pelatihan dimulai, Anda cukup menambahkan:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Saat menyimpan checkpoint, Anda dapat menghasilkan state_dic yang hanya memuat parameter LoRA.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Jika Anda belum cukup memahami Neural Network, jangan khawatir. Baca blog How to Train a LLM with PyTorch untuk menguasai proses pelatihan LLM menggunakan PyTorch, dari penyiapan awal hingga implementasi akhir.
Kredit: Contoh kode telah direproduksi dari Microsoft/LoRA github.
LoRA muncul sebagai teknik yang sangat penting untuk mengatasi tantangan besar akibat ukuran dan kompleksitas model besar.
Dengan memanfaatkan matriks berperingkat rendah, LoRA menawarkan pendekatan adaptasi model yang lebih efisien dan hemat biaya, secara signifikan mengurangi parameter yang dapat dilatih dan kebutuhan memori GPU, sehingga memungkinkan pelatihan lebih cepat dan efisiensi memori.
Penerapan LoRA melampaui model bahasa, bermanfaat pula pada model gambar seperti Stable Diffusion, di mana LoRA memfasilitasi spesialisasi gaya dan konsistensi karakter dalam pembuatan gambar.
Jika Anda penasaran dan ingin mempelajari lebih lanjut tentang apa yang dapat Anda bangun dengan teknologi ini, lihat panduan kami 5 Projects You Can Build with Generative AI Models untuk mengetahui lebih jauh.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




