
Kursus
Database Vektor untuk Embeddings dengan Pinecone
3 jam
12.3K
Baru-baru ini, DuckDB keluar dari versi beta dan merilis versi stabilnya, dengan cepat meraih popularitas saat berbagai kerangka kerja data mengintegrasikannya ke dalam ekosistem mereka. Ini adalah waktu yang tepat untuk mempelajari DuckDB agar Anda dapat mengikuti dunia data dan AI yang terus berubah.
Dalam tutorial ini, kita akan mempelajari DuckDB dan fitur-fiturnya yang utama dengan contoh kode. Fokus utama kita adalah bagaimana kita dapat mengintegrasikannya dengan kerangka kerja AI saat ini. Untuk itu, kita akan mengerjakan dua proyek. Pertama, kita akan membangun aplikasi Retrieval-Augmented Generation (RAG) dengan menggunakan DuckDB sebagai basis data vektor. Lalu, kita akan menggunakan DuckDB sebagai mesin kueri AI untuk menganalisis data menggunakan bahasa alami alih-alih SQL.
DuckDB adalah sistem manajemen basis data analitis dalam memori (DBMS) modern dan berkinerja tinggi yang dirancang untuk mendukung kueri analitis yang kompleks. Ini adalah DBMS relasional (berorientasi tabel) yang mendukung Structured Query Language (SQL).
DuckDB menggabungkan kesederhanaan dan kemudahan penggunaan SQLite dengan kemampuan kinerja tinggi yang diperlukan untuk beban kerja analitik, menjadikannya pilihan yang sangat baik bagi data scientist dan analis.
Pada bagian ini, kita akan mempelajari cara menyiapkan DuckDB, memuat file CSV, melakukan analisis data, serta mempelajari relasi dan fungsi kueri.
Kita akan mulai dengan memasang paket Python DuckDB.
pip install duckdb --upgradeUntuk membuat basis data persisten, Anda hanya perlu menggunakan fungsi connect dan memberinya nama basis data.
import duckdb
con = duckdb.connect("datacamp.duckdb")
Ini akan membuat berkas basis data di direktori lokal Anda.
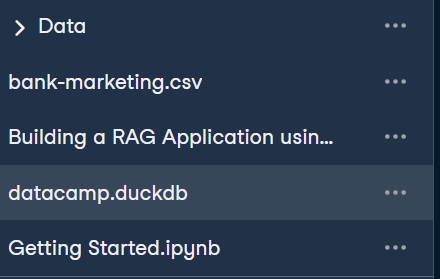
Kita akan memuat file CSV dan membuat tabel "bank". Dataset yang kita gunakan tersedia di DataLab dan bernama Bank Marketing. Dataset ini berisi kampanye pemasaran langsung oleh sebuah institusi perbankan Portugal menggunakan panggilan telepon.
Untuk memuat file CSV, Anda harus membuat Tabel terlebih dahulu menggunakan SQL lalu menggunakan fungsi read_csv() di dalam skrip SQL untuk memuat file. Semudah itu.
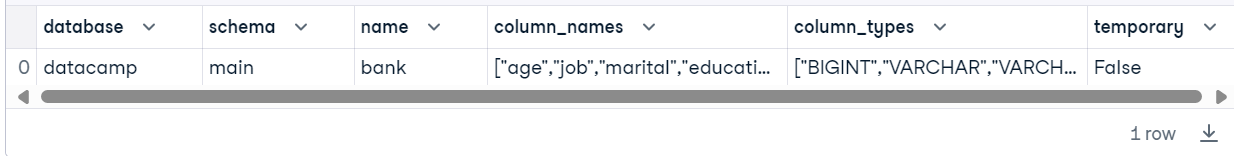
Kita kemudian akan memvalidasi tabel dengan menjalankan skrip SQL yang menampilkan semua tabel dalam basis data dan menggunakan fungsi fetchdf untuk menampilkan hasil sebagai DataFrame pandas.
Catatan: Kami menggunakan DataLab dari DataCamp sebagai editor kode. DataLab adalah Jupyter Notebook berbasis cloud yang dapat Anda akses gratis jika memiliki akun DataCamp.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
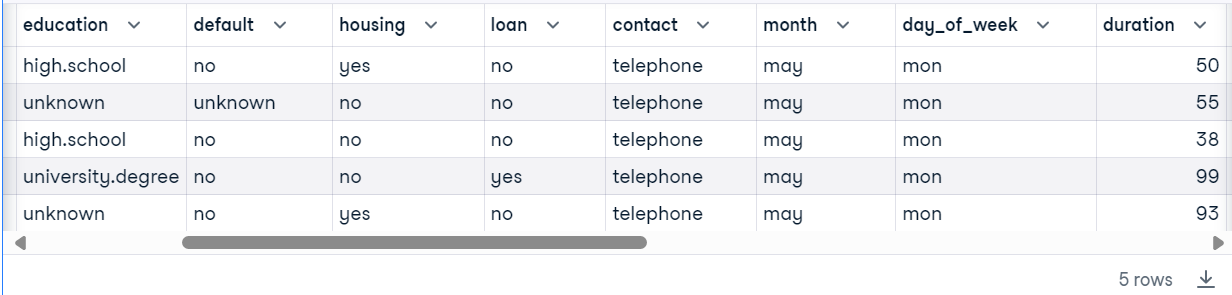
Sekarang setelah kita berhasil membuat tabel pertama, kita akan menjalankan kueri tingkat pemula untuk menganalisis data dan menampilkan hasilnya sebagai DataFrame.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB terintegrasi secara native ke DataLab baru dari DataCamp. Pelajari lebih lanjut dengan membaca blog "DuckDB Menjadikan SQL Warga Kelas Satu di DataLab" dan gunakan sel SQL interaktif untuk menganalisis data.
Relasi DuckDB pada dasarnya adalah tabel yang dapat dikueri menggunakan Relational API. API ini memungkinkan pengaitan berbagai operasi kueri pada sumber data seperti Pandas DataFrame. Alih-alih menggunakan kueri SQL, Anda akan menganalisis data dengan mengaitkan berbagai fungsi Python.
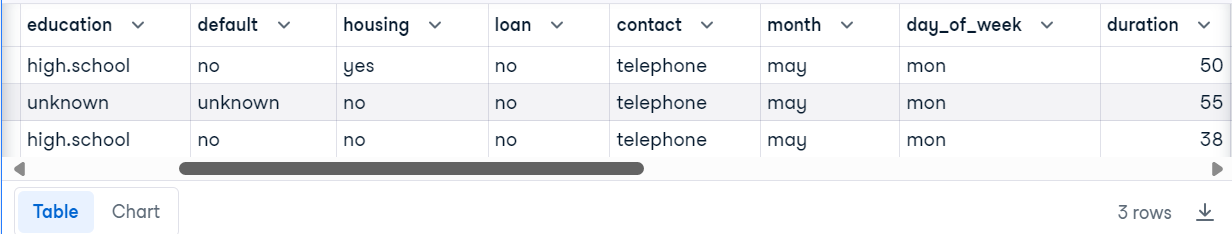
Sebagai contoh, kita akan memuat file CSV untuk membuat relasi DuckDB. Untuk menganalisis tabel, Anda dapat mengaitkan fungsi filter dan limit.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
Kita juga dapat membuat relasi dengan memuat tabel dari basis data DuckDB.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
'y']Mari menulis relasi yang menggunakan beberapa fungsi untuk menganalisis data.
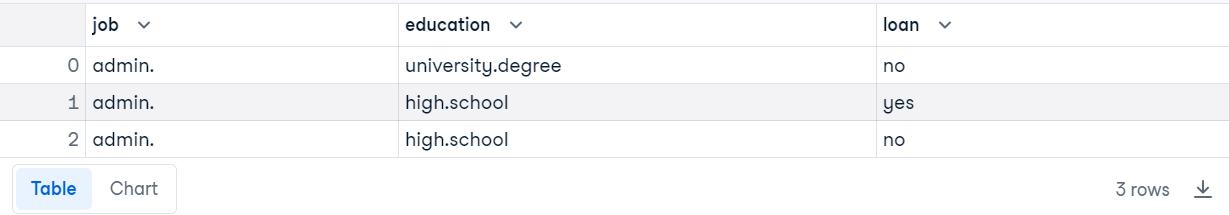
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()Kita memiliki tiga baris dan kolom yang diurutkan berdasarkan job dan difilter berdasarkan kolom duration.
Fungsi kueri DuckDB memungkinkan kueri SQL dijalankan di dalam basis data, mengembalikan hasil yang dapat dikonversi ke berbagai format untuk analisis lebih lanjut.
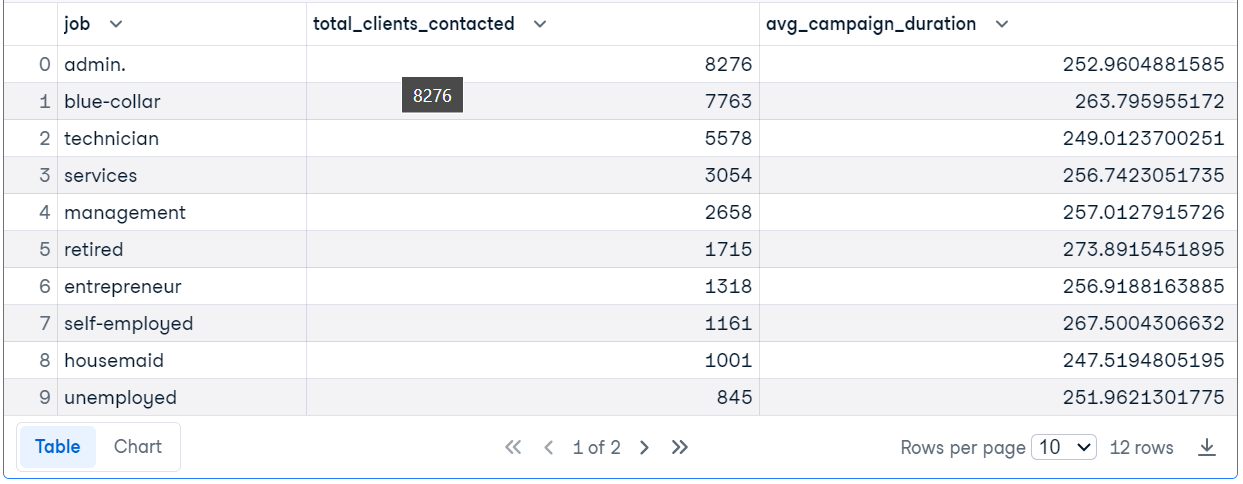
Pada contoh kode, kita menjalankan kueri SQL untuk mengetahui jabatan klien berusia di atas 30 tahun, menghitung jumlah klien yang dihubungi untuk setiap pekerjaan, dan menghitung rata-rata durasi kampanye.
Ikuti SQL Fundamentals untuk mempelajari cara mengelola basis data relasional dan menjalankan kueri untuk analisis data sederhana.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
Sekarang kita akan menutup koneksi ke basis data dan melepaskan sumber daya apa pun yang terkait dengan koneksi tersebut, untuk mencegah potensi kebocoran memori dan handle file.
con.close()Jika Anda mengalami masalah saat menjalankan kode di atas, silakan lihat Mulai Menggunakan DuckDB workspace.
Pada proyek pertama, kita akan belajar membangun aplikasi RAG dengan LlamaIndex dan menggunakan DuckDB sebagai basis data vektor dan retriever.
Pasang semua paket Python yang diperlukan untuk membuat dan mengambil indeks.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Impor paket Python yang diperlukan beserta fungsinya.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayUntuk model bahasa, kita akan menggunakan model GPT4o terbaru dan OpenAI API. Untuk membuat klien large language model (LLM), Anda hanya perlu memberikan nama model dan kunci API.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Lalu, kita akan membuat klien model embedding menggunakan model OpenAI text-embedding-3-small.
Catatan: Menyediakan kunci API OpenAI bersifat opsional jika variabel lingkungan ditetapkan dengan nama “OPENAI_API_KEY” di lingkungan pengembangan Anda.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
Kita akan menjadikan model OpenAI LLM dan Embedding bersifat global agar dapat digunakan oleh semua fungsi LlamaIndex. Singkatnya, model-model ini akan disetel sebagai default.
from llama_index.core import Settings

Settings.llm = llm
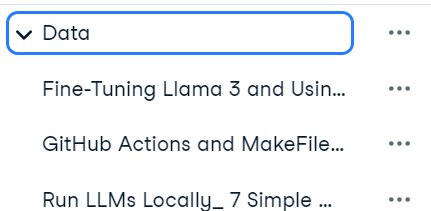
Settings.embed_model = embed_modelUntuk proyek kita, kita akan memuat file PDF dari folder data. File PDF ini adalah tutorial dari DataCamp yang disimpan sebagai PDF menggunakan fungsi cetak peramban.
Berikan direktori folder ke fungsi SimpleDirectoryReader dan muat datanya.
documents = SimpleDirectoryReader("Data").load_data()
Lalu, buat vector store bernama “blog” menggunakan basis data yang sudah ada bernama “datacamp.duckdb.” Setelah itu, ubah data PDF menjadi embedding dan simpan di vector store.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
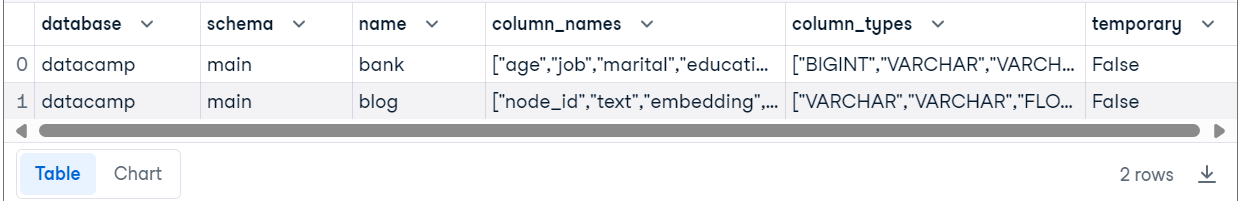
Untuk memeriksa apakah vector store berhasil dibuat, kita akan menghubungkan basis data menggunakan DuckDB Python API dan menjalankan kueri SQL untuk menampilkan semua tabel di basis data.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
Kita memiliki dua tabel: tabel promosi “bank” dan tabel “blog”, yang merupakan vector store. Tabel “blog” memiliki kolom “embedding” tempat semua embedding disimpan.
Ubah indeks menjadi mesin kueri, yang secara otomatis terlebih dahulu mencari dokumen serupa di basis data vektor dan menggunakan konteks tambahan untuk menghasilkan respons.
Untuk menguji mesin kueri RAG, kita akan mengajukan pertanyaan tentang tutorialnya.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
Dan jawabannya benar.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Sekarang, mari kita buat aplikasi RAG tingkat lanjut yang menggunakan riwayat percakapan untuk menghasilkan respons. Untuk itu, kita harus membuat penyangga memori percakapan lalu mesin chat dengan memori, LLM, dan retriever vector store.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

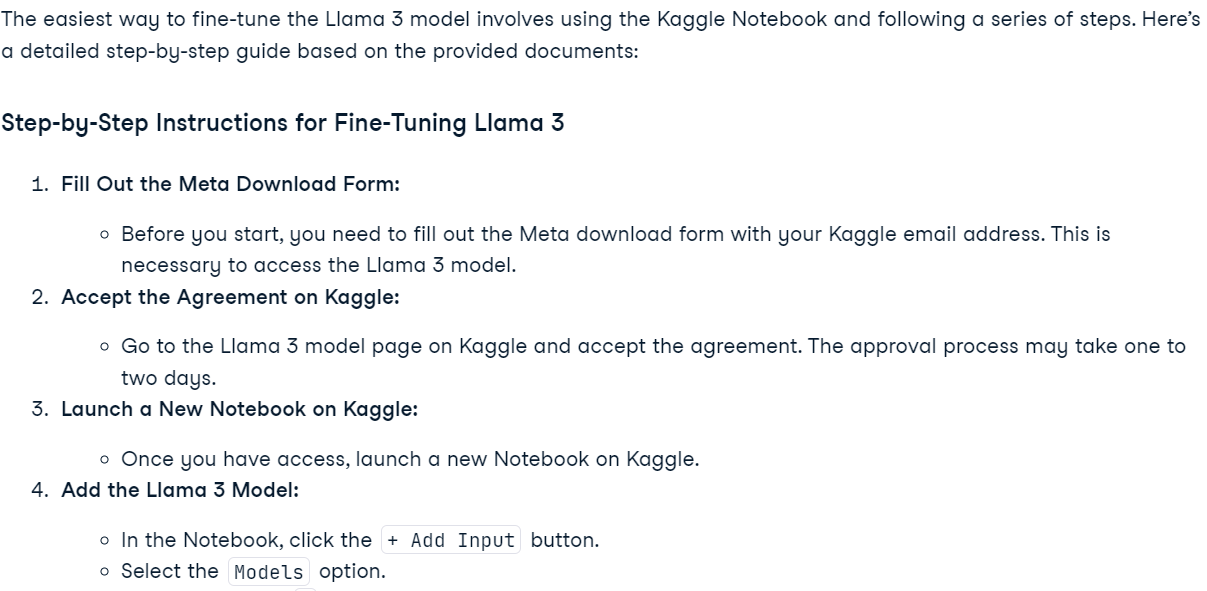
response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
Kita menanyakan ke mesin chat cara fine-tune model Llama 3, dan ia menggunakan vector store untuk memberikan jawaban yang sangat akurat.
Untuk memeriksa apakah penyangga memori berfungsi dengan benar, kita akan mengajukan pertanyaan lanjutan.
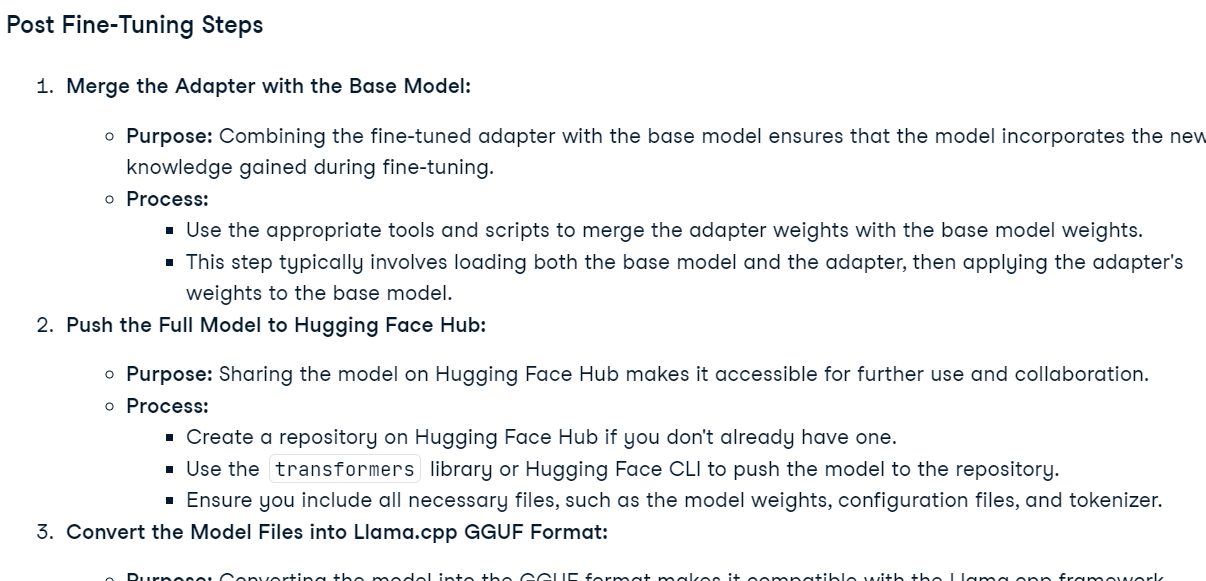
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
Mesin chat mengingat percakapan sebelumnya dan merespons sesuai.
Jika Anda mengalami masalah saat menjalankan kode di atas, silakan lihat Membangun aplikasi RAG dengan DuckDB workspace.
Pada proyek kedua, kita akan menggunakan DuckDB sebagai mesin kueri SQL. Ini melibatkan integrasi mesin basis data dengan model GPT-4o untuk menghasilkan respons bahasa alami atas pertanyaan tentang basis data.
Pasang duckdb-engine untuk membuat mesin basis data menggunakan SQLAlchemy.
%pip install duckdb-engine -qKita akan memuat basis data DuckDB menggunakan fungsi create_engine dan kemudian menulis kueri SQL sederhana untuk memeriksa apakah basis data berhasil dimuat.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Sempurna. Mesin basis data DuckDB kita siap digunakan.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Sekarang, kita harus membuat Tool basis data menggunakan fungsi SQLDatabase. Berikan objek engine dan nama tabel.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])Buat mesin kueri SQL menggunakan fungsi NLSQLTableQueryEngine dengan memberikan objek basis data SQL LlamaIndex.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Ajukan pertanyaan ke mesin kueri tentang tabel “bank” dalam bahasa alami.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
Sebagai respons, kita akan mendapatkan jawaban atas kueri Anda dalam bahasa alami. Keren, bukan?
The longest running campaign in the database has a duration of 4918 days.Mari ajukan pertanyaan yang lebih kompleks.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
Jawabannya tepat, dengan informasi tambahan.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Untuk memeriksa apa yang terjadi di backend, kita akan mencetak metadata.
print(response.metadata)Seperti yang kita lihat, GPT-4o terlebih dahulu menghasilkan kueri SQL, menjalankan kueri untuk mendapatkan hasil, dan menggunakan hasil tersebut untuk menghasilkan respons. Proses multi-langkah ini dicapai hanya dengan dua baris kode.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Tutup engine ketika Anda selesai dengan proyek.
engine.close()Jika Anda mengalami masalah saat menjalankan kode di atas, silakan lihat DuckDB SQL Query Engine workspace.
DuckDB cepat, mudah digunakan, dan terintegrasi mulus dengan banyak kerangka kerja data dan AI. Sebagai data scientist, Anda akan mendapati bahwa hanya perlu beberapa menit untuk membiasakan diri dengan API-nya dan mulai menggunakannya seperti paket Python lainnya. Salah satu fitur terbaik DuckDB adalah tidak memiliki dependensi, artinya Anda dapat menggunakannya hampir di mana saja tanpa perlu khawatir tentang hosting atau penyiapan tambahan.
Dalam tutorial ini, kita telah mempelajari DuckDB dan fitur-fiturnya yang utama. Kita juga mengeksplorasi DuckDB Python API, menggunakannya untuk membuat tabel dan melakukan analisis data sederhana. Paruh kedua tutorial membahas dua proyek: satu melibatkan aplikasi Retrieval-Augmented Generation (RAG) dengan DuckDB sebagai basis data vektor dan satu lagi mendemonstrasikan DuckDB sebagai mesin kueri SQL.
Sebelum terjun menggunakan mesin kueri SQL atau mengintegrasikan basis data dengan AI, Anda memerlukan pemahaman dasar tentang SQL dan analisis data. Anda bisa menulis kueri, tetapi bagaimana Anda tahu pertanyaan apa yang harus diajukan? Di sinilah pengetahuan dasar analisis data dan SQL diperlukan. Anda dapat memperoleh pengetahuan ini dengan menyelesaikan Associate Data Analyst in SQL career track.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



