
Cursus
AI-toepassingen bouwen met Pinecone
3 uur
12.2K
Onlangs kwam DuckDB uit de bèta en werd de stabiele versie uitgebracht, die snel aan populariteit wint nu verschillende dataframeworks het in hun ecosysteem integreren. Dit is dus hét moment om DuckDB te leren zodat je kunt bijblijven in de steeds veranderende wereld van data en AI.
In deze tutorial behandelen we DuckDB en de belangrijkste functies met codevoorbeelden. We focussen vooral op hoe we het kunnen integreren met huidige AI-frameworks. Daarvoor werken we aan twee projecten. Eerst bouwen we een Retrieval-Augmented Generation (RAG)-applicatie met DuckDB als vectordatabank. Daarna gebruiken we DuckDB als AI-query-engine om data te analyseren met natuurlijke taal in plaats van SQL.
DuckDB is een moderne, high-performance, in-memory analytisch databasebeheersysteem (DBMS) dat is ontworpen om complexe analytische queries te ondersteunen. Het is een relationeel (tabelgericht) DBMS dat de Structured Query Language (SQL) ondersteunt.
DuckDB combineert de eenvoud en het gebruiksgemak van SQLite met de prestaties die nodig zijn voor analytische workloads, waardoor het een uitstekende keuze is voor data scientists en analisten.
In deze sectie leren we DuckDB opzetten, CSV-bestanden laden, data-analyse uitvoeren en meer over relations en queryfuncties.
We beginnen met het installeren van het DuckDB Python-pakket.
pip install duckdb --upgradeOm de persistente database te maken, gebruik je gewoon de connect-functie en geef je de databasenaam op.
import duckdb
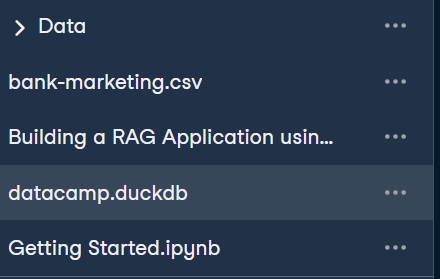
con = duckdb.connect("datacamp.duckdb")
Er wordt een databasebestand in je lokale map aangemaakt.
We laden een CSV-bestand en maken een "bank"-tabel. De dataset die we gebruiken is beschikbaar in DataLab en heet Bank Marketing. Deze bestaat uit direct marketingcampagnes van een Portugese bankinstelling via telefoongesprekken.
Om het CSV-bestand te laden, moet je eerst een tabel aanmaken met SQL en vervolgens de functie read_csv() in het SQL-script gebruiken om het bestand te laden. Zo simpel is het.
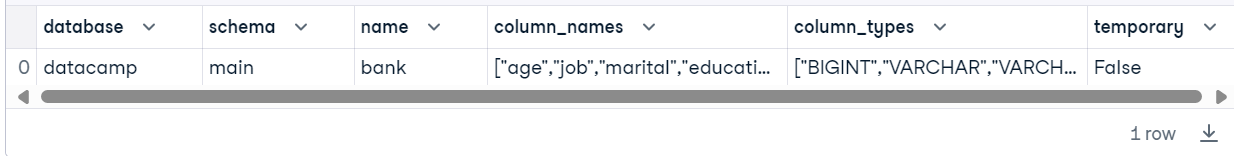
Daarna valideren we onze tabel door het SQL-script uit te voeren dat alle tabellen in de database toont en gebruiken we de functie fetchdf om het resultaat als een pandas DataFrame weer te geven.
Let op: We gebruiken DataCamp’s DataLab als code-editor. DataLab is een cloud Jupyter Notebook die je gratis kunt gebruiken als je een DataCamp-account hebt.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
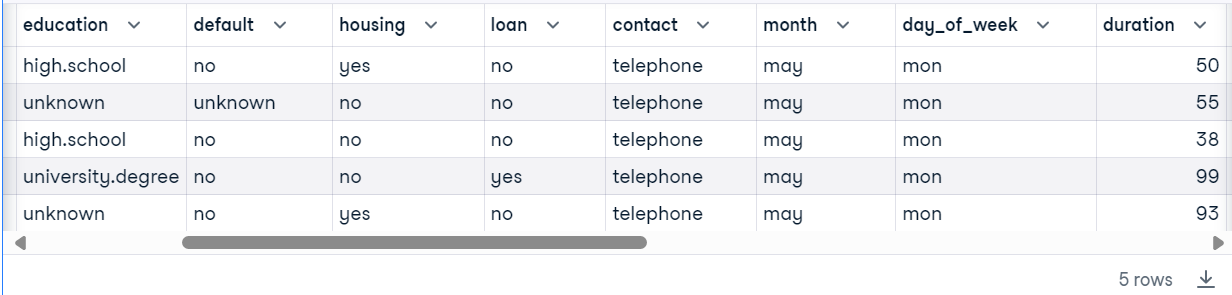
Nu we onze eerste tabel succesvol hebben gemaakt, voeren we een beginnersquery uit om de data te analyseren en tonen we het resultaat als een DataFrame.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB is native geïntegreerd in het nieuwe DataLab van DataCamp. Lees er meer over in de blog "DuckDB maakt SQL een first-class citizen in DataLab" en gebruik de interactieve SQL-cel om data te analyseren.
DuckDB-relations zijn in feite tabellen die je kunt bevragen met de Relational API. Deze API maakt het mogelijk om verschillende querybewerkingen te koppelen op gegevensbronnen zoals Pandas DataFrames. In plaats van SQL-queries te gebruiken, analyseer je de data door verschillende Python-functies aan elkaar te rijgen.
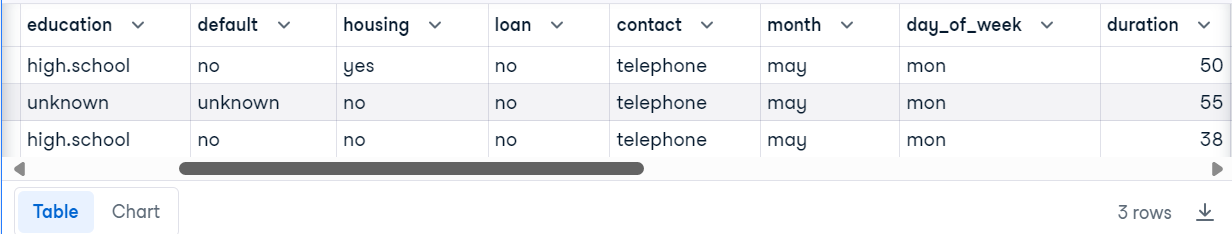
We laden bijvoorbeeld een CSV-bestand om de DuckDB-relation te maken. Om de tabel te analyseren, kun je de functies filter en limit chainen.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
We kunnen ook relations maken door de tabel uit de DuckDB-database te laden.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
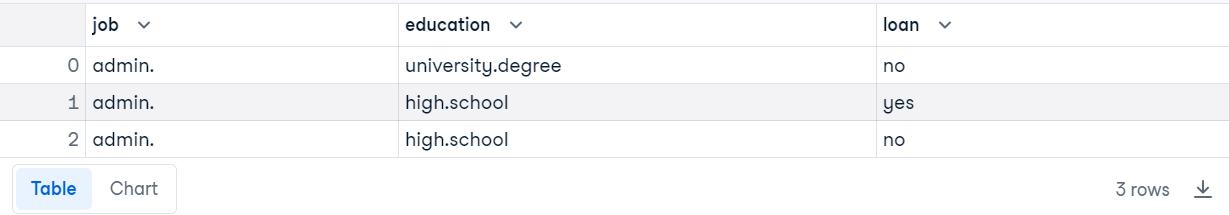
'y']Laten we een relation schrijven die meerdere functies gebruikt om de data te analyseren.
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()We hebben drie rijen en kolommen, gesorteerd op job en gefilterd op de kolom duration.
De DuckDB-queryfunctie maakt het mogelijk om SQL-queries binnen de database uit te voeren, met resultaten die je naar verschillende formaten kunt converteren voor verdere analyse.
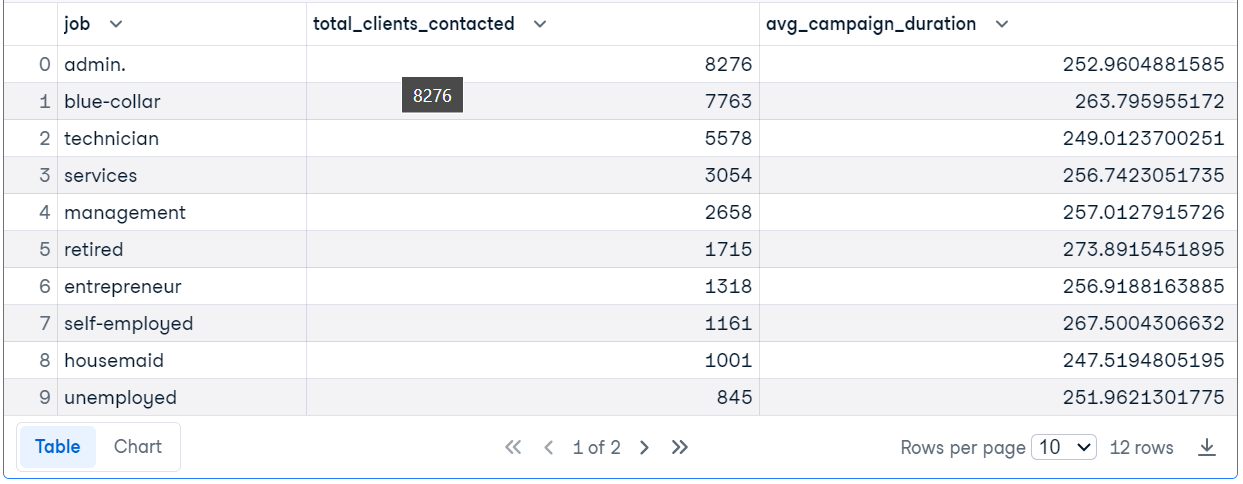
In het codevoorbeeld voeren we de SQL-query uit om de functietitels van klanten ouder dan 30 te vinden, het aantal gecontacteerde klanten per functie te tellen en de gemiddelde duur van de campagne te berekenen.
Volg de SQL Fundamentals skill track om te leren hoe je een relationele database beheert en queries uitvoert voor eenvoudige data-analyse.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
We sluiten nu de verbinding met de database en geven bijbehorende resources vrij om mogelijke geheugen- en file handle-lekken te voorkomen.
con.close()Heb je problemen met het uitvoeren van de bovenstaande code, bekijk dan de Aan de slag met DuckDB-workspace.
In het eerste project leren we een RAG-applicatie bouwen met LlamaIndex en DuckDB gebruiken als vectordatabank en retriever.
Installeer alle benodigde Python-pakketten die worden gebruikt om de index te maken en op te vragen.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Importeer het benodigde Python-pakket met de functies.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayAls taalmodel gebruiken we het nieuwste GPT4o-model en de OpenAI API. Om de client voor het large language model (LLM) te maken, hoef je alleen een modelnaam en API-sleutel op te geven.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Vervolgens maken we de client voor het embeddingmodel met het OpenAI text-embedding-3-small-model.
Let op: Het opgeven van een OpenAI API-sleutel is optioneel als de omgevingsvariabele met de naam “OPENAI_API_KEY” is ingesteld in je ontwikkelomgeving.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
We maken de OpenAI LLM- en embeddingmodellen globaal zodat alle LlamaIndex-functies ze kunnen gebruiken. Kort gezegd: deze modellen worden als standaard ingesteld.
from llama_index.core import Settings

Settings.llm = llm
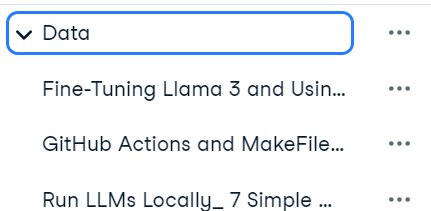
Settings.embed_model = embed_modelVoor ons project laden we de PDF-bestanden uit de data-map. Deze PDF-bestanden zijn tutorials van DataCamp die als PDF zijn opgeslagen via de printfunctie van de browser.
Geef de maplocatie door aan de functie SimpleDirectoryReader en laad de data.
documents = SimpleDirectoryReader("Data").load_data()
Maak daarna de vector store genaamd “blog” aan met een bestaande database “datacamp.duckdb”. Zet vervolgens de gegevens uit de PDF om in embeddings en sla ze op in de vector store.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
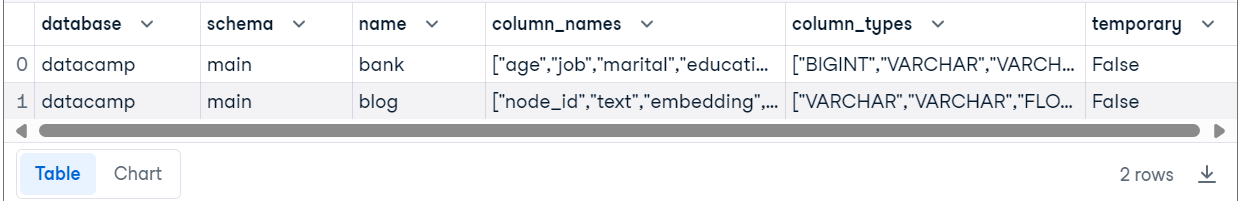
Om te controleren of onze vector store succesvol is aangemaakt, verbinden we met de database via de DuckDB Python-API en voeren we de SQL-query uit om alle tabellen in de database te tonen.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
We hebben twee tabellen: een promotietabel “bank” en een “blog”-tabel, die een vector store is. De “blog”-tabel heeft een “embedding”-kolom waarin alle embeddings zijn opgeslagen.
Zet de index om in de query-engine, die automatisch eerst in de vectordatabank zoekt naar vergelijkbare documenten en de extra context gebruikt om het antwoord te genereren.
Om de RAG-query-engine te testen, stellen we een vraag over de tutorial.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
En het antwoord is correct.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Laten we nu een geavanceerde RAG-app bouwen die de gesprekshistorie gebruikt om het antwoord te genereren. Daarvoor moeten we een chatgeheugenbuffer maken en vervolgens een chatengine met geheugen, LLM en vector store-retriever.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

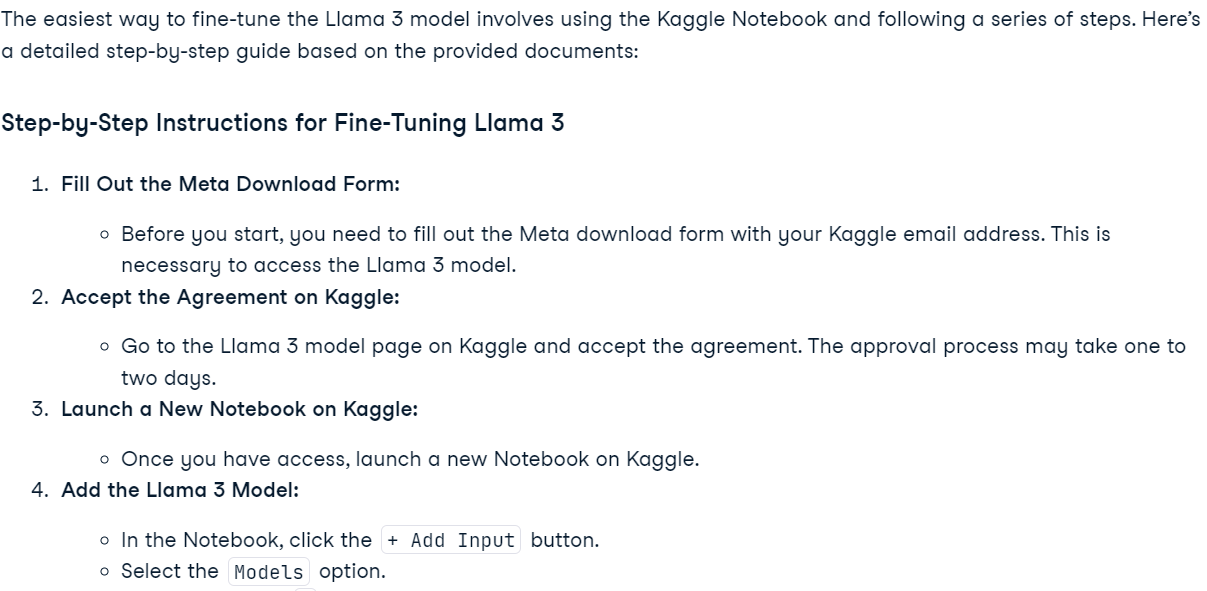
response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
We vroegen de chatengine hoe je het Llama 3-model fine-tunet, en hij gebruikte de vector store om een zeer nauwkeurig antwoord te geven.
Om te controleren of de geheugenbuffer goed werkt, stellen we een vervolgvraag.
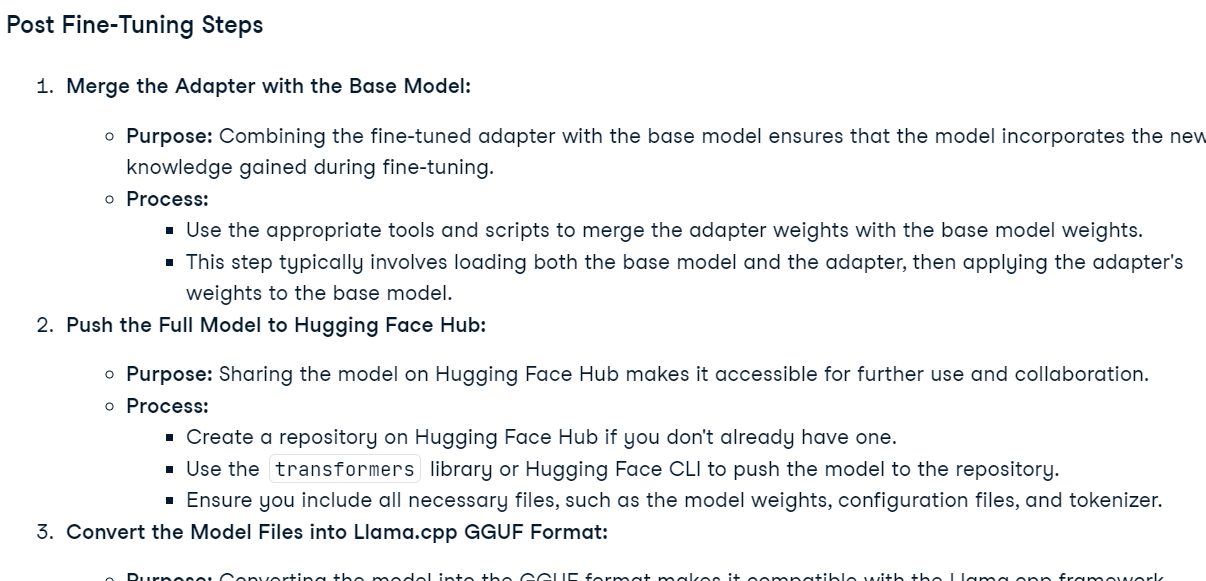
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
De chatengine onthield het eerdere gesprek en reageerde dienovereenkomstig.
Heb je problemen met het uitvoeren van de bovenstaande code, bekijk dan de Een RAG-toepassing bouwen met DuckDB-workspace.
In het tweede project gebruiken we DuckDB als SQL-query-engine. Dit houdt in dat we de database-engine integreren met het GPT-4o-model om natuurlijke taalantwoorden te genereren op vragen over de database.
Installeer duckdb-engine om een database-engine te maken met SQLAlchemy.
%pip install duckdb-engine -qWe laden de DuckDB-database met de functie create_engine en schrijven vervolgens een eenvoudige SQL-query om te controleren of deze succesvol is geladen.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Perfect. Onze DuckDB-database-engine is klaar voor gebruik.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Nu moeten we een database-tool maken met de functie SQLDatabase. Geef een engine-object en tabelnaam op.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])Maak de SQL-query-engine met de functie NLSQLTableQueryEngine door het LlamaIndex SQL-databaseobject op te geven.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Stel de vraag aan de query-engine over de “bank”-tabel in natuurlijke taal.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
Als antwoord krijgen we de uitkomst op je vraag in natuurlijke taal. Dit is toch geweldig?
The longest running campaign in the database has a duration of 4918 days.Laten we een complexe vraag stellen.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
Het antwoord is precies, met extra informatie.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Om te zien wat er op de achtergrond gebeurt, printen we de metadata.
print(response.metadata)Zoals we zien, genereert GPT-4o eerst de SQL-query, voert de query uit om het resultaat te krijgen en gebruikt dat resultaat om het antwoord te genereren. Dit meerstapsproces bereik je met twee regels code.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Sluit de engine wanneer je klaar bent met het project.
engine.close()Heb je problemen met het uitvoeren van de bovenstaande code, bekijk dan de DuckDB SQL Query Engine-workspace.
DuckDB is snel, makkelijk in gebruik en integreert naadloos met talloze data- en AI-frameworks. Als data scientist zul je merken dat je maar een paar minuten nodig hebt om aan de API te wennen en het te gebruiken zoals elk ander Python-pakket. Een van de beste eigenschappen van DuckDB is dat het geen afhankelijkheden heeft, wat betekent dat je het vrijwel overal kunt gebruiken zonder je zorgen te maken over hosting of extra setup.
In deze tutorial hebben we DuckDB en de belangrijkste functies behandeld. We hebben ook de DuckDB Python-API verkend en ermee een tabel gemaakt en eenvoudige data-analyse uitgevoerd. De tweede helft van de tutorial besloeg twee projecten: een Retrieval-Augmented Generation (RAG)-applicatie met DuckDB als vectordatabank en een demonstratie van DuckDB als SQL-query-engine.
Voordat je aan de slag gaat met een SQL-query-engine of een database met AI integreert, heb je basiskennis van SQL en data-analyse nodig. Je kunt de query misschien schrijven, maar hoe weet je welke vraag je moet stellen? Daar komt basiskennis van data-analyse en SQL bij kijken. Die kennis kun je opdoen door de Associate Data Analyst in SQL career track te voltooien.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

