
Corso
Database vettoriali per Embeddings con Pinecone
3 ore
12.2K
Di recente, DuckDB è uscito dalla beta e ha rilasciato la sua versione stabile, guadagnando rapidamente popolarità man mano che vari framework di dati lo integrano nei loro ecosistemi. È quindi il momento ideale per imparare DuckDB e stare al passo con il mondo in continua evoluzione dei dati e dell'IA.
In questo tutorial impareremo a conoscere DuckDB e le sue funzionalità principali con esempi di codice. Il nostro obiettivo principale sarà come integrarlo con i framework di IA attuali. Per questo, lavoreremo su due progetti. Per prima cosa, builderemo un'applicazione Retrieval-Augmented Generation (RAG) usando DuckDB come database vettoriale. Poi useremo DuckDB come motore di query AI per analizzare i dati usando il linguaggio naturale invece di SQL.
DuckDB è un moderno DBMS analitico in-memory ad alte prestazioni progettato per supportare query analitiche complesse. È un DBMS relazionale (orientato alle tabelle) che supporta SQL (Structured Query Language).
DuckDB combina la semplicità e la facilità d'uso di SQLite con le capacità ad alte prestazioni richieste dai carichi analitici, rendendolo una scelta eccellente per data scientist e analisti.
In questa sezione, impareremo a configurare DuckDB, caricare file CSV, eseguire analisi dei dati e conoscere le relazioni e le funzioni di query.
Inizieremo installando il pacchetto Python di DuckDB.
pip install duckdb --upgradePer creare il database persistente, ti basta usare la funzione connect e fornirle il nome del database.
import duckdb
con = duckdb.connect("datacamp.duckdb")
Verrà creato un file di database nella tua directory locale.
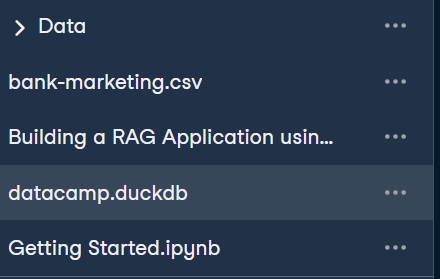
Caricheremo un file CSV e creeremo una tabella "bank". Il dataset che stiamo usando è disponibile su DataLab e si chiama Bank Marketing. È composto da campagne di marketing diretto di un istituto bancario portoghese tramite telefonate.
Per caricare il file CSV, devi prima creare una tabella usando SQL e poi usare la funzione read_csv() all'interno dello script SQL per caricare il file. È davvero semplice.
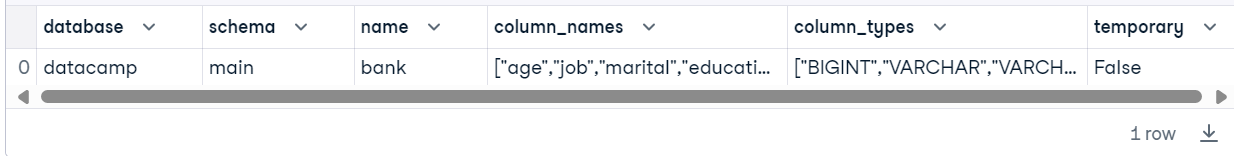
Convalideremo quindi la nostra tabella eseguendo lo script SQL che mostra tutte le tabelle nel database e usando la funzione fetchdf per visualizzare il risultato come DataFrame di pandas.
Nota: stiamo usando DataLab di DataCamp come editor di codice. DataLab è un Jupyter Notebook cloud a cui puoi accedere gratuitamente se hai un account DataCamp.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
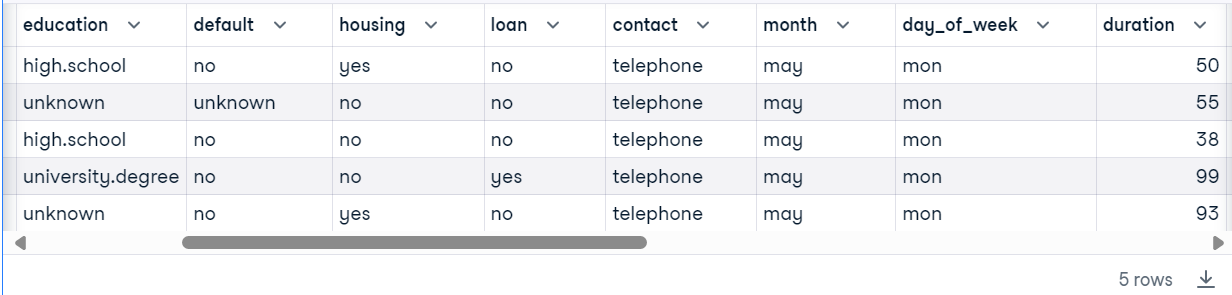
Ora che abbiamo creato con successo la nostra prima tabella, eseguiremo una query di base per analizzare i dati e visualizzare il risultato come DataFrame.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB è integrato nativamente nel nuovo DataLab di DataCamp. Scopri di più leggendo il blog "DuckDB rende SQL un cittadino di prima classe su DataLab" e usando la cella SQL interattiva per analizzare i dati.
Le relazioni in DuckDB sono essenzialmente tabelle interrogabili tramite la Relational API. Questa API consente di concatenare varie operazioni di query su sorgenti dati come DataFrame Pandas. Invece di usare query SQL, analizzerai i dati concatenando diverse funzioni Python.
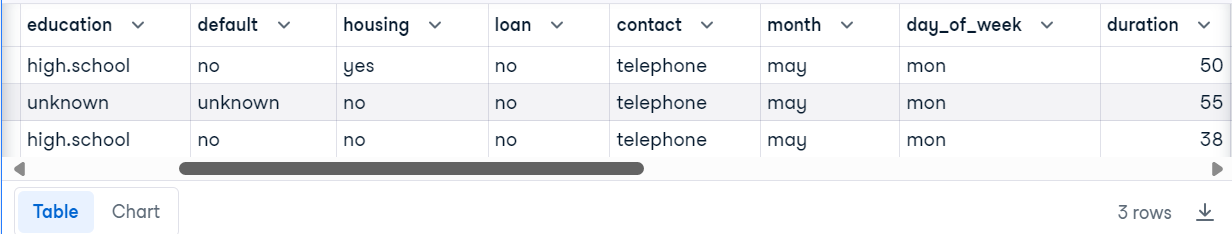
Ad esempio, caricheremo un file CSV per creare la relazione DuckDB. Per analizzare la tabella, puoi concatenare le funzioni filter e limit.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
Possiamo anche creare relazioni caricando la tabella dal database DuckDB.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
'y']Scriviamo una relazione che usa più funzioni per analizzare i dati.
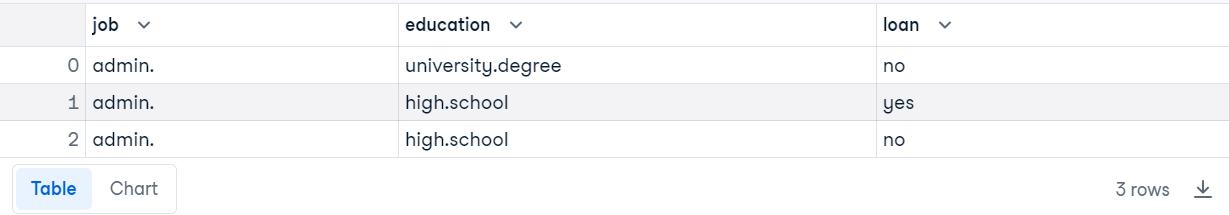
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()Abbiamo tre righe e colonne ordinate per job e filtrate per la colonna duration.
La funzione di query di DuckDB consente di eseguire query SQL nel database, restituendo risultati che possono essere convertiti in vari formati per ulteriori analisi.
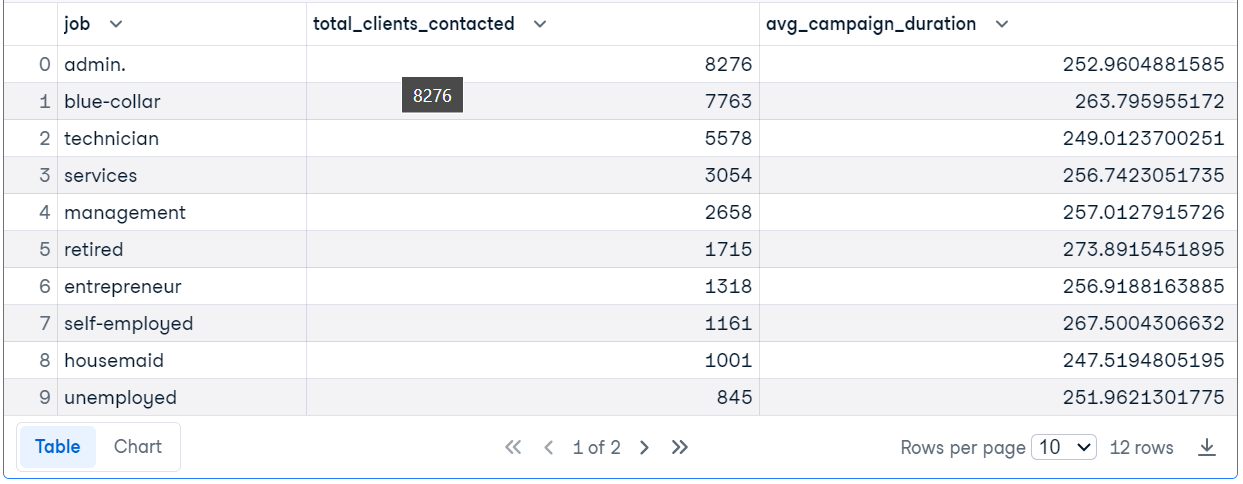
Nell'esempio di codice, eseguiamo la query SQL per individuare i titoli di lavoro dei clienti con più di 30 anni, contare il numero di clienti contattati per ciascun lavoro e calcolare la durata media della campagna.
Segui lo skill track SQL Fundamentals per imparare a gestire un database relazionale ed eseguire query per semplici analisi dei dati.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
Ora chiuderemo la connessione al database e rilasceremo le risorse associate a quella connessione, prevenendo potenziali perdite di memoria e handle di file.
con.close()Se riscontri problemi nell'esecuzione del codice sopra, dai un'occhiata allo spazio di lavoro Getting Started with DuckDB.
Nel primo progetto impareremo a costruire un'app RAG con LlamaIndex e a usare DuckDB come database vettoriale e retriever.
Installa tutti i pacchetti Python necessari che verranno usati per creare e interrogare l'indice.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Importa i pacchetti Python necessari con le relative funzioni.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayPer il modello linguistico useremo l'ultimo modello GPT4o e l'API di OpenAI. Per creare il client del large language model (LLM), ti basta fornire un nome modello e una chiave API.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Poi creeremo il client del modello di embedding usando il modello OpenAI text-embedding-3-small.
Nota: fornire una chiave API di OpenAI è facoltativo se la variabile d'ambiente è impostata con il nome "OPENAI_API_KEY" nel tuo ambiente di sviluppo.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
Imposteremo i modelli di OpenAI LLM ed Embedding come globali, in modo che possano essere usati da tutte le funzioni di LlamaIndex. In breve, questi modelli saranno impostati come predefiniti.
from llama_index.core import Settings

Settings.llm = llm
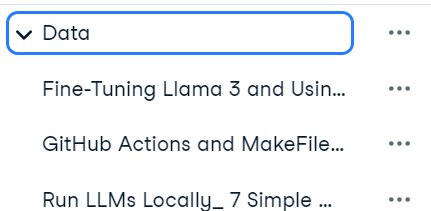
Settings.embed_model = embed_modelPer il nostro progetto, caricheremo i file PDF dalla cartella data. Questi PDF sono tutorial di DataCamp salvati come file PDF usando la funzione di stampa del browser.
Fornisci la directory della cartella alla funzione SimpleDirectoryReader e carica i dati.
documents = SimpleDirectoryReader("Data").load_data()
Quindi, crea l'archivio vettoriale chiamato “blog” usando un database esistente chiamato “datacamp.duckdb”. Dopodiché, converti i dati dei PDF in embedding e salvali nel vector store.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
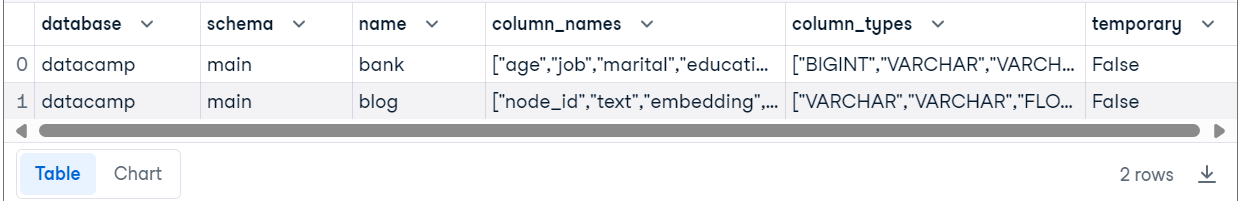
Per verificare che il nostro vector store sia stato creato correttamente, ci connetteremo al database usando l'API Python di DuckDB ed eseguiremo la query SQL per visualizzare tutte le tabelle nel database.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
Abbiamo due tabelle: una tabella promozionale “bank” e una tabella “blog”, che è un vector store. La tabella “blog” ha una colonna “embedding” in cui sono salvati tutti gli embedding.
Converti l'indice nel query engine, che cercherà automaticamente nel database vettoriale i documenti simili e userà il contesto aggiuntivo per generare la risposta.
Per testare il motore di query RAG, faremo una domanda sul tutorial.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
E la risposta è corretta.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Ora creiamo un'app RAG avanzata che usa la cronologia della conversazione per generare la risposta. Per farlo, dobbiamo creare un buffer di memoria della chat e poi un chat engine con memoria, LLM e retriever del vector store.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

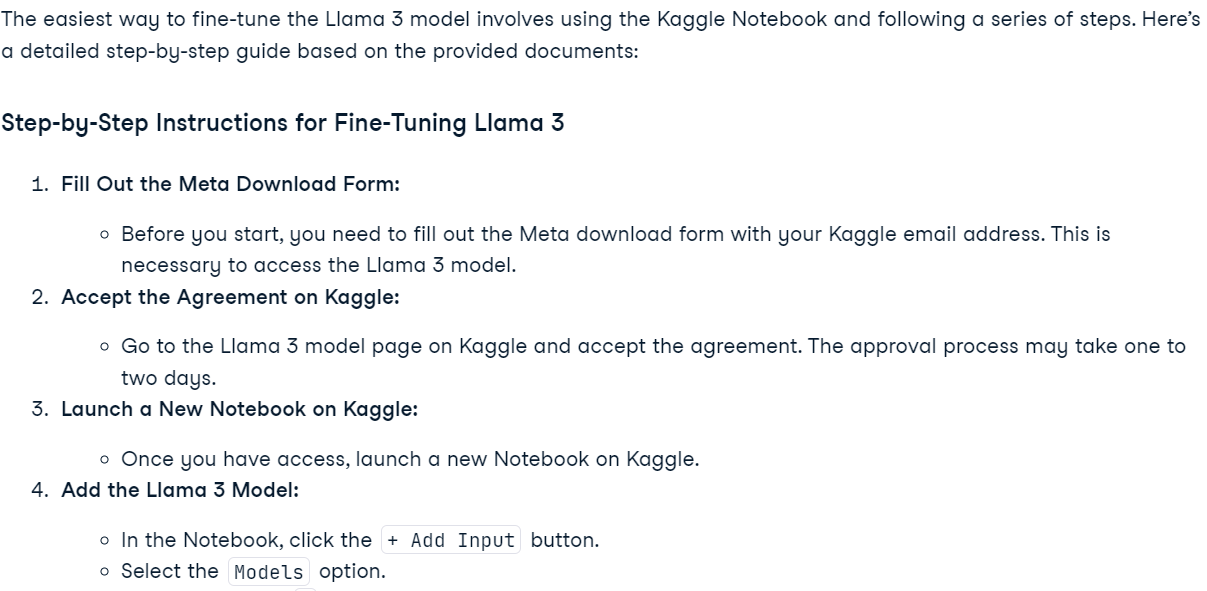
response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
Abbiamo chiesto al chat engine come fare il fine-tuning del modello Llama 3 e ha usato il vector store per dare una risposta molto accurata.
Per verificare che il buffer di memoria funzioni correttamente, faremo una domanda di follow-up.
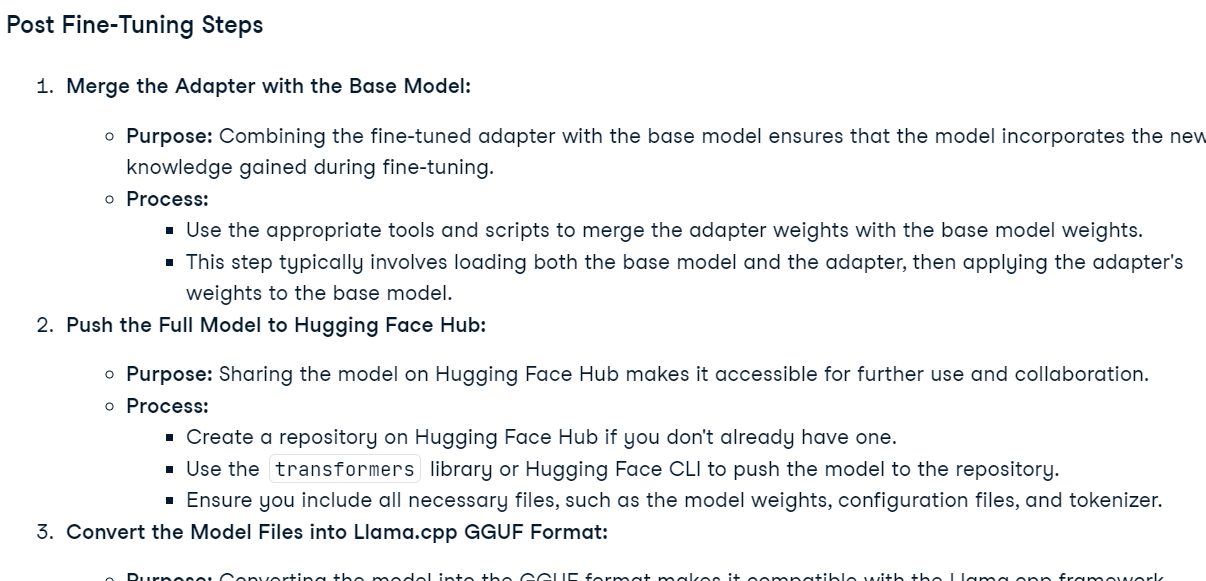
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
Il chat engine ha ricordato la conversazione precedente e ha risposto di conseguenza.
Se riscontri problemi nell'esecuzione del codice sopra, dai un'occhiata allo spazio di lavoro Building a RAG application with DuckDB.
Nel secondo progetto useremo DuckDB come motore di query SQL. Questo comporta l'integrazione del motore di database con il modello GPT-4o per generare risposte in linguaggio naturale a domande sul database.
Installa duckdb-engine per creare un motore di database usando SQLAlchemy.
%pip install duckdb-engine -qCaricheremo il database DuckDB usando la funzione create_engine e poi scriveremo una semplice query SQL per verificare che sia stato caricato correttamente.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Perfetto. Il nostro motore del database DuckDB è pronto per essere usato.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Ora dobbiamo creare uno Strumento database usando la funzione SQLDatabase. Fornisci un oggetto engine e il nome della tabella.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])Crea il motore di query SQL usando la funzione NLSQLTableQueryEngine fornendole l'oggetto database SQL di LlamaIndex.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Fai una domanda al motore di query sulla tabella “bank” in linguaggio naturale.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
In risposta, otterremo la risposta alla tua query in linguaggio naturale. Fantastico, non credi?
The longest running campaign in the database has a duration of 4918 days.Facciamo una domanda più complessa.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
La risposta è precisa, con informazioni aggiuntive.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Per vedere cosa succede nel back-end, stamperemo i metadati.
print(response.metadata)Come possiamo vedere, GPT-4o prima genera la query SQL, esegue la query per ottenere il risultato e usa il risultato per generare la risposta. Questo processo in più fasi è ottenuto con due righe di codice.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Chiudi il motore quando hai finito il progetto.
engine.close()Se riscontri problemi nell'esecuzione del codice sopra, dai un'occhiata allo spazio di lavoro DuckDB SQL Query Engine.
DuckDB è veloce, facile da usare e si integra perfettamente con numerosi framework di dati e IA. Come data scientist, scoprirai che bastano pochi minuti per abituarti alla sua API e iniziare a usarlo come qualsiasi altro pacchetto Python. Una delle migliori caratteristiche di DuckDB è che non ha dipendenze, il che significa che puoi usarlo praticamente ovunque senza preoccuparti dell'hosting o di configurazioni aggiuntive.
In questo tutorial abbiamo conosciuto DuckDB e le sue funzionalità chiave. Abbiamo anche esplorato la Python API di DuckDB, usandola per creare una tabella ed eseguire semplici analisi dei dati. La seconda parte del tutorial ha trattato due progetti: uno con un'applicazione Retrieval-Augmented Generation (RAG) con DuckDB come database vettoriale e l'altro che dimostra DuckDB come motore di query SQL.
Prima di lanciarti nell'uso di un motore di query SQL o nell'integrazione di un database con l'IA, ti serve una comprensione di base di SQL e dell'analisi dei dati. Puoi scrivere la query, ma come fai a sapere quale domanda porre? È qui che entrano in gioco le basi dell'analisi dei dati e di SQL. Puoi acquisire queste conoscenze completando il career track Associate Data Analyst in SQL.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



