
Kurs
KI-Anwendungen mit Pinecone entwickeln
3 Std.
11.6K
Kürzlich ist DuckDB aus der Beta-Phase herausgekommen und in einer stabilen Version erschienen. Seitdem gewinnt es rasant an Popularität, weil immer mehr Datenframeworks es in ihre Ökosysteme integrieren. Genau jetzt ist also der richtige Zeitpunkt, DuckDB zu lernen – damit du in der dynamischen Daten- und KI-Welt die Nase vorn behältst.
In diesem Tutorial lernst du DuckDB und seine Kernfunktionen anhand von Codebeispielen kennen. Unser Schwerpunkt liegt darauf, wie wir es mit aktuellen KI-Frameworks verbinden. Dazu arbeiten wir an zwei Projekten: Zuerst bauen wir eine Retrieval-Augmented-Generation-(RAG)-Anwendung und nutzen DuckDB als Vektordatenbank. Anschließend verwenden wir DuckDB als KI-Abfrage-Engine, um Daten in natürlicher Sprache statt mit SQL zu analysieren.
DuckDB ist ein modernes, leistungsstarkes, In-Memory-Analytical Database Management System (DBMS) für komplexe analytische Abfragen. Es ist ein relationales (tabellenorientiertes) DBMS und unterstützt die Structured Query Language (SQL).
DuckDB verbindet die Einfachheit und Benutzerfreundlichkeit von SQLite mit der Performance, die für analytische Workloads nötig ist – ideal für Data Scientists und Analysten.
In diesem Abschnitt richten wir DuckDB ein, laden CSV-Dateien, führen eine Datenanalyse durch und lernen Relations und Abfragefunktionen kennen.
Wir starten mit der Installation des DuckDB-Python-Pakets.
pip install duckdb --upgradeFür eine persistente Datenbank nutzt du einfach die Funktion connect und gibst einen Datenbanknamen an.
import duckdb
con = duckdb.connect("datacamp.duckdb")
Damit wird eine Datenbankdatei in deinem lokalen Verzeichnis angelegt.
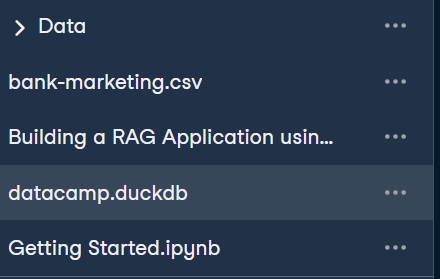
Wir laden nun eine CSV-Datei und erstellen die Tabelle "bank". Der Datensatz ist in DataLab verfügbar und heißt Bank Marketing. Er enthält Direktmarketing-Kampagnen einer portugiesischen Bank, durchgeführt per Telefon.
Um die CSV zu laden, legst du zuerst per SQL eine Tabelle an und nutzt dann innerhalb des SQL-Skripts die Funktion read_csv(). So einfach ist das.
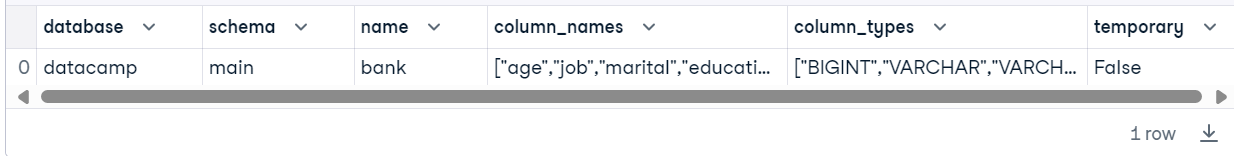
Anschließend prüfen wir die Tabelle, indem wir ein SQL-Skript ausführen, das alle Tabellen der Datenbank anzeigt, und verwenden fetchdf, um das Ergebnis als pandas-DataFrame darzustellen.
Hinweis: Wir nutzen DataCamps DataLab als Code-Editor. DataLab ist ein Cloud-Jupyter-Notebook, auf das du mit einem DataCamp-Account kostenlos zugreifen kannst.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
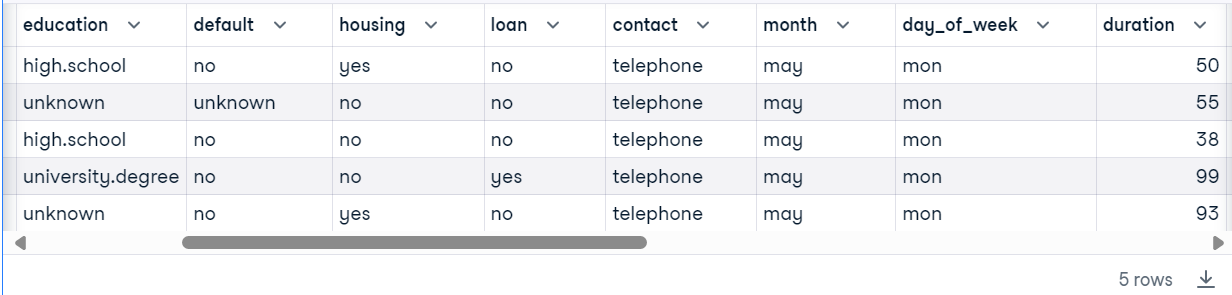
Nachdem die erste Tabelle steht, führen wir eine einfache Abfrage zur Analyse aus und zeigen das Ergebnis als DataFrame an.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB ist nativ in das neue DataLab von DataCamp integriert. Mehr dazu erfährst du im Blog „DuckDB Makes SQL a First-Class Citizen on DataLab“ und mit der interaktiven SQL-Zelle zur Datenanalyse.
DuckDB-Relations sind im Kern Tabellen, die über die Relational API abgefragt werden. Diese API erlaubt es, verschiedene Abfrageoperationen auf Datenquellen wie Pandas-DataFrames zu verketten. Anstatt SQL zu schreiben, analysierst du die Daten, indem du in Python Funktionen kettelst.
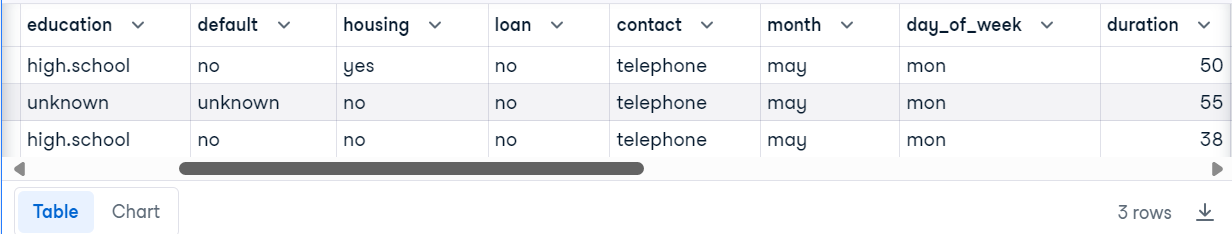
Im Beispiel laden wir eine CSV-Datei als DuckDB-Relation. Zur Analyse kettest du Filter- und Limit-Funktionen.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
Relations lassen sich auch erstellen, indem du Tabellen aus der DuckDB-Datenbank lädst.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
'y']Schreiben wir nun eine Relation, die mehrere Funktionen zur Analyse kombiniert.
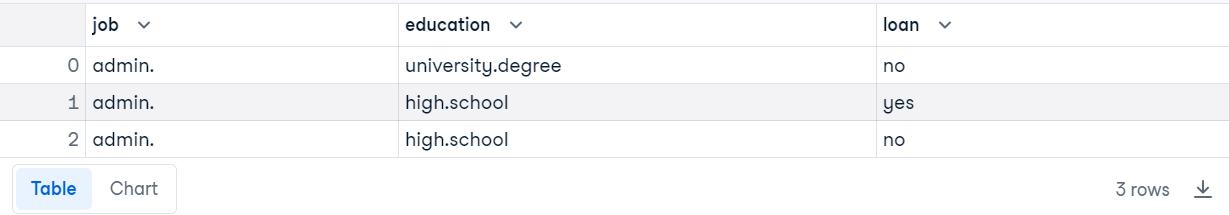
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()Wir erhalten drei Zeilen mit den Spalten, nach job sortiert und nach der Spalte duration gefiltert.
Mit der DuckDB-Query-Funktion kannst du SQL-Abfragen in der Datenbank ausführen und die Ergebnisse in verschiedene Formate für die weitere Analyse konvertieren.
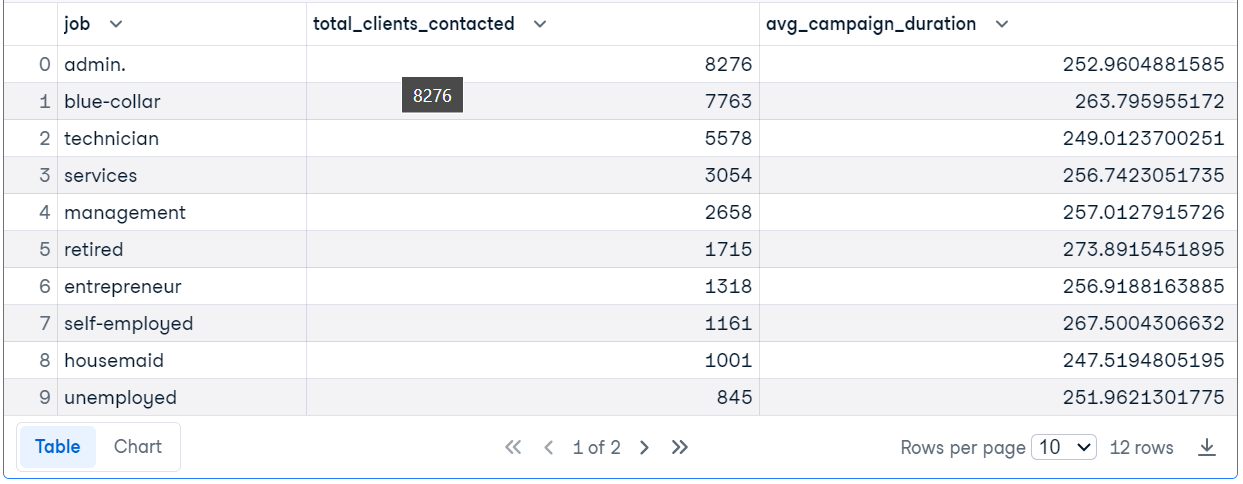
Im Codebeispiel ermitteln wir die Jobtitel von Kundinnen und Kunden über 30, zählen die kontaktierten Personen je Job und berechnen die durchschnittliche Kampagnendauer.
Absolviere den SQL Fundamentals Lernpfad, um relationale Datenbanken zu verwalten und Abfragen für einfache Datenanalysen auszuführen.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
Zum Schluss schließen wir die Verbindung zur Datenbank und geben Ressourcen frei, um Speicher- und Handle-Leaks zu vermeiden.
con.close()Wenn du Probleme beim Ausführen des Codes hast, schau in den Workspace Getting Started with DuckDB.
Im ersten Projekt bauen wir eine RAG-Anwendung mit LlamaIndex und nutzen DuckDB als Vektordatenbank und Retriever.
Installiere alle benötigten Python-Pakete zum Erstellen und Abfragen des Index.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Importiere die benötigten Python-Pakete und Funktionen.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayAls Sprachmodell nutzen wir das aktuelle GPT-4o über die OpenAI-API. Für den LLM-Client brauchst du nur den Modellnamen und einen API-Schlüssel.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Danach erstellen wir den Embedding-Client mit dem OpenAI-Modell text-embedding-3-small.
Hinweis: Das Angeben eines OpenAI-API-Schlüssels ist optional, wenn in deiner Entwicklungsumgebung die Umgebungsvariable „OPENAI_API_KEY“ gesetzt ist.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
Wir setzen OpenAI LLM und Embedding-Modell global, damit alle LlamaIndex-Funktionen sie standardmäßig nutzen.
from llama_index.core import Settings

Settings.llm = llm
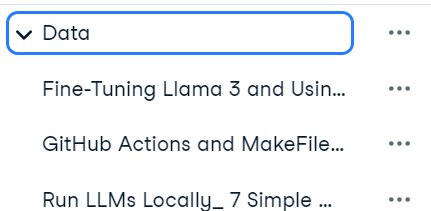
Settings.embed_model = embed_modelFür unser Projekt laden wir PDF-Dateien aus dem data-Ordner. Es handelt sich um DataCamp-Tutorials, die per Druckfunktion des Browsers als PDF gespeichert wurden.
Übergebe das Ordnerverzeichnis an SimpleDirectoryReader und lade die Daten.
documents = SimpleDirectoryReader("Data").load_data()
Erstelle dann den Vectorspeicher namens „blog“ in der bestehenden Datenbank „datacamp.duckdb“. Konvertiere anschließend die PDF-Inhalte in Embeddings und speichere sie im Vectorspeicher.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
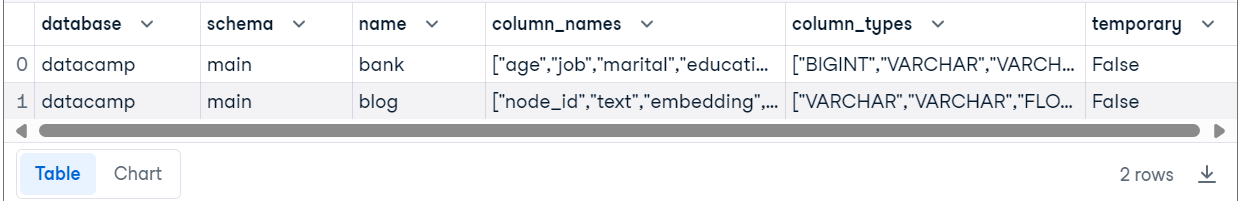
Um zu prüfen, ob der Vectorspeicher erfolgreich angelegt wurde, verbinden wir uns per DuckDB-Python-API mit der Datenbank und führen eine Abfrage aus, die alle Tabellen anzeigt.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
Wir sehen zwei Tabellen: die Promotionstabelle „bank“ und „blog“ als Vectorspeicher. Die Tabelle „blog“ enthält eine Spalte „embedding“, in der alle Embeddings gespeichert sind.
Wandle den Index in eine Query-Engine um. Diese sucht automatisch zuerst in der Vektordatenbank nach ähnlichen Dokumenten und nutzt den Kontext für die Antwortgenerierung.
Um die RAG-Query-Engine zu testen, stellen wir eine Frage zum Tutorial.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
Und die Antwort ist korrekt.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Jetzt erstellen wir eine erweiterte RAG-Anwendung, die den Gesprächsverlauf für die Antwort nutzt. Dafür bauen wir einen Chat-Speicherpuffer und anschließend eine Chat-Engine mit Memory, LLM und Vector-Store-Retriever.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
Wir haben die Chat-Engine gefragt, wie man Llama 3 feinabstimmt, und sie hat mithilfe des Vectorspeichers eine sehr präzise Antwort geliefert.
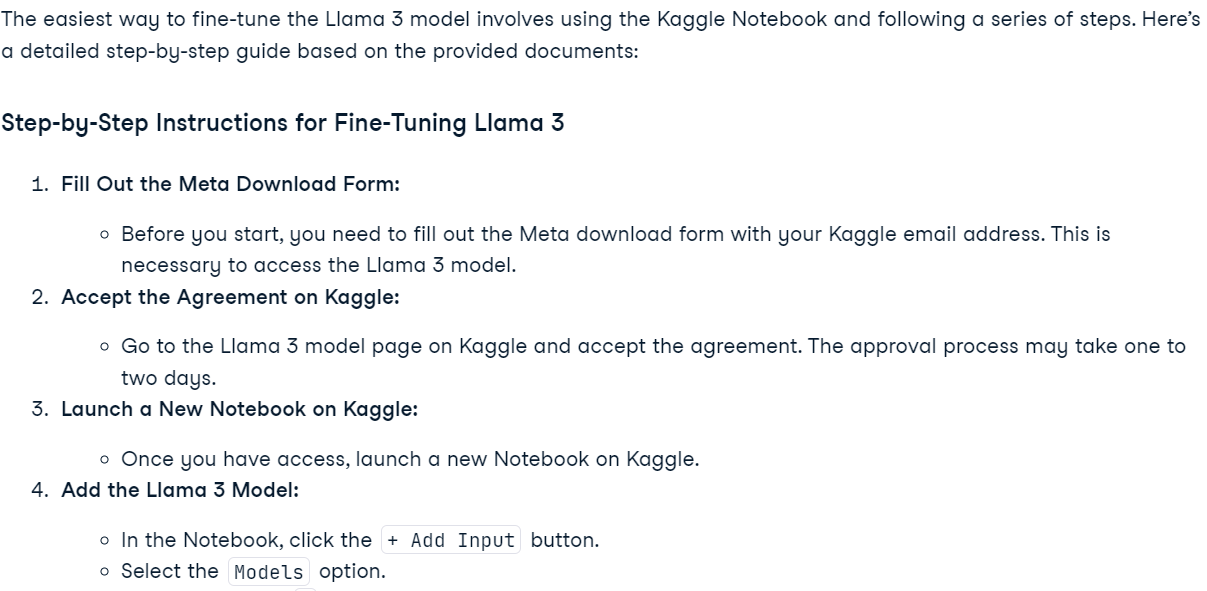
Um zu prüfen, ob der Memory-Puffer funktioniert, stellen wir eine Rückfrage.
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
Die Chat-Engine hat sich an das vorherige Gespräch erinnert und entsprechend geantwortet.
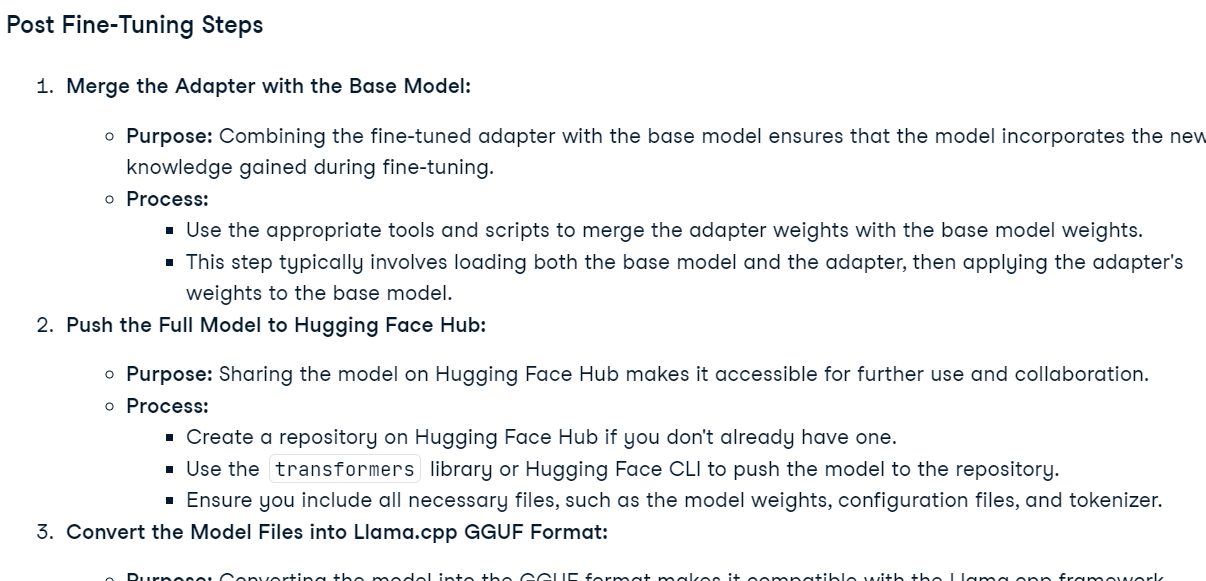
Wenn du Probleme beim Ausführen des Codes hast, schau in den Workspace Building a RAG application with DuckDB.
Im zweiten Projekt nutzen wir DuckDB als SQL-Abfrage-Engine. Dabei integrieren wir die Datenbankengine mit dem GPT-4o-Modell, um Antworten in natürlicher Sprache auf Fragen zur Datenbank zu erzeugen.
Installiere duckdb-engine, um mit SQLAlchemy eine Datenbank-Engine zu erstellen.
%pip install duckdb-engine -qWir laden die DuckDB-Datenbank mit create_engine und führen dann eine einfache SQL-Abfrage aus, um den erfolgreichen Zugriff zu prüfen.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Perfekt. Unsere DuckDB-Engine ist einsatzbereit.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Als Nächstes erstellen wir mit SQLDatabase ein Datenbank-Tool. Übergebe das Engine-Objekt und den Tabellennamen.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])Erstelle die SQL-Query-Engine mit NLSQLTableQueryEngine, indem du das LlamaIndex-SQL-Datenbankobjekt übergibst.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Stelle der Query-Engine eine Frage zur Tabelle „bank“ in natürlicher Sprache.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
Als Antwort erhältst du das Ergebnis in natürlicher Sprache. Ziemlich stark, oder?
The longest running campaign in the database has a duration of 4918 days.Stellen wir eine komplexere Frage.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
Die Antwort ist präzise und liefert zusätzliche Informationen.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Um zu sehen, was im Hintergrund passiert, geben wir die Metadaten aus.
print(response.metadata)Wie zu sehen ist, generiert GPT-4o zunächst die SQL-Abfrage, führt sie aus, holt das Ergebnis und erstellt darauf basierend die Antwort. Dieser mehrstufige Ablauf gelingt mit nur zwei Codezeilen.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Schließe die Engine, wenn du mit dem Projekt fertig bist.
engine.close()Wenn du Probleme beim Ausführen des Codes hast, schau in den Workspace DuckDB SQL Query Engine.
DuckDB ist schnell, einfach zu bedienen und lässt sich nahtlos mit zahlreichen Daten- und KI-Frameworks integrieren. Als Data Scientist wirst du feststellen, dass du nur wenige Minuten brauchst, um dich an die API zu gewöhnen – und sie dann wie jedes andere Python-Paket nutzt. Eines der besten Features: Es gibt keine Abhängigkeiten. Du kannst DuckDB praktisch überall einsetzen, ohne dir über Hosting oder zusätzliche Setups Gedanken zu machen.
In diesem Tutorial hast du DuckDB und seine wichtigsten Funktionen kennengelernt. Wir haben die DuckDB-Python-API genutzt, um eine Tabelle zu erstellen und einfache Analysen durchzuführen. Im zweiten Teil haben wir zwei Projekte umgesetzt: eine Retrieval-Augmented-Generation-(RAG)-Anwendung mit DuckDB als Vektordatenbank und eine SQL-Abfrage-Engine auf Basis von DuckDB.
Bevor du eine SQL-Abfrage-Engine nutzt oder eine Datenbank mit KI verbindest, brauchst du grundlegende SQL- und Analysekenntnisse. Du kannst zwar eine Abfrage schreiben – aber welche Fragen solltest du stellen? Genau hier hilft Basiswissen in Datenanalyse und SQL. Du erwirbst es zum Beispiel mit dem Associate Data Analyst in SQL Karrierepfad.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs