
Kurs
Pinecone ile AI Uygulamaları Geliştirme
3 sa
12.2K
Kısa süre önce DuckDB betadan çıkarak kararlı sürümünü yayımladı ve çeşitli veri çerçeveleri onu ekosistemlerine entegre ettikçe hızla popülerlik kazandı. Bu da, sürekli değişen veri ve yapay zekâ dünyasına ayak uydurabilmeniz için DuckDB öğrenmek adına ideal bir zaman olduğu anlamına geliyor.
Bu eğitimde, kod örnekleriyle DuckDB ve temel özelliklerini öğreneceğiz. Öncelikli odağımız, onu güncel yapay zekâ çerçeveleriyle nasıl entegre edebileceğimiz olacak. Bunun için iki proje üzerinde çalışacağız. İlk olarak, DuckDB'yi bir vektör veritabanı olarak kullanarak Alım Destekli Üretim (RAG) uygulaması geliştireceğiz. Ardından, SQL yerine doğal dili kullanarak veri analiz etmek için DuckDB'yi bir yapay zekâ sorgu motoru olarak kullanacağız.
DuckDB; karmaşık analitik sorguları desteklemek için tasarlanmış, modern, yüksek performanslı, bellek içi bir analitik veritabanı yönetim sistemidir (DBMS). İlişkisel (tablo odaklı) bir DBMS olup Yapılandırılmış Sorgu Dili'ni (SQL) destekler.
DuckDB, SQLite'ın sadeliği ve kullanım kolaylığını, analitik iş yükleri için gereken yüksek performans yetenekleriyle birleştirir; bu da onu veri bilimciler ve analistler için mükemmel bir seçenek yapar.
Bu bölümde DuckDB'yi kurmayı, CSV dosyalarını yüklemeyi, veri analizi yapmayı ve ilişkiler ile sorgu işlevlerini öğreniyor olacağız.
DuckDB Python paketini kurarak başlayacağız.
pip install duckdb --upgradeKalıcı veritabanı oluşturmak için connect işlevini kullanıp veritabanı adını vermeniz yeterlidir.
import duckdb
con = duckdb.connect("datacamp.duckdb")
Yerel dizininizde bir veritabanı dosyası oluşturacaktır.
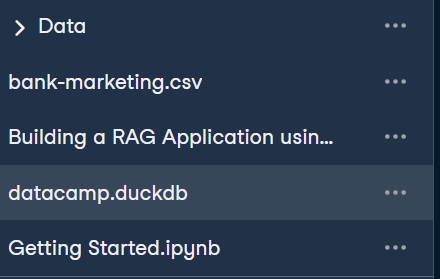
Bir CSV dosyası yükleyip bir "bank" tablosu oluşturacağız. Kullandığımız veri seti DataLab'de mevcuttur ve Bank Marketing adını taşır. Portekizli bir bankanın telefon aramalarıyla yürüttüğü doğrudan pazarlama kampanyalarından oluşur.
CSV dosyasını yüklemek için önce SQL kullanarak bir Tablo oluşturmalı, ardından dosyayı yüklemek için SQL betiği içinde read_csv() işlevini kullanmalısınız. Bu kadar basit.
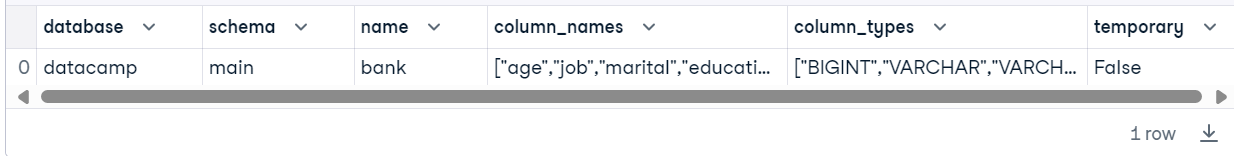
Daha sonra, veritabanındaki tüm tabloları gösteren SQL betiğini çalıştırıp sonucu bir pandas DataFrame olarak göstermek için fetchdf işlevini kullanarak tablomuzu doğrulayacağız.
Not: Kod düzenleyici olarak DataCamp’in DataLab’ini kullanıyoruz. DataLab, bir DataCamp hesabınız varsa ücretsiz erişebileceğiniz bulut tabanlı bir Jupyter Notebook'tur.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
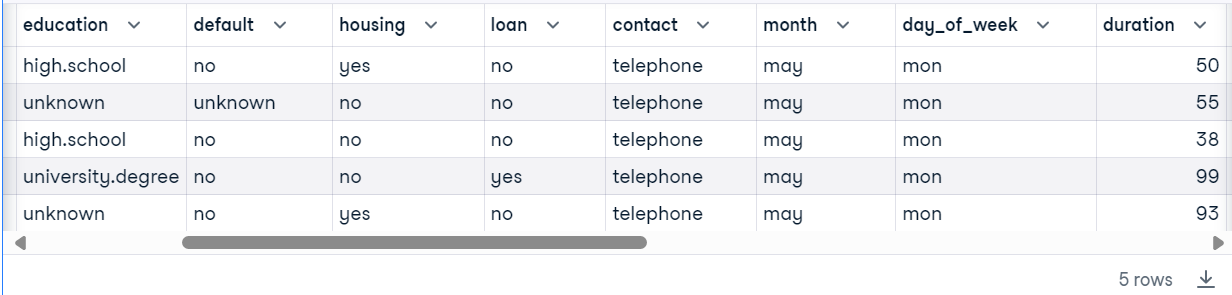
Artık ilk tablomuzu başarıyla oluşturduğumuza göre, veriyi analiz etmek ve sonucu bir DataFrame olarak göstermek için başlangıç düzeyinde bir sorgu çalıştıracağız.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB, DataCamp’in yeni DataLab’ine yerel olarak entegredir. Hakkında daha fazla bilgi edinmek için "DuckDB, DataLab'de SQL'i Birinci Sınıf Vatandaş Yapıyor" blog yazısını okuyun ve verileri analiz etmek için etkileşimli SQL hücresini kullanın.
DuckDB ilişkileri, aslında İlişkisel API kullanılarak sorgulanabilen tablolardır. Bu API, Pandas DataFrame’leri gibi veri kaynakları üzerinde çeşitli sorgu işlemlerini zincirleme biçimde uygulamaya olanak tanır. SQL sorguları kullanmak yerine, veriyi analiz etmek için birbirini izleyen çeşitli Python işlevlerini zincirleyerek kullanırsınız.
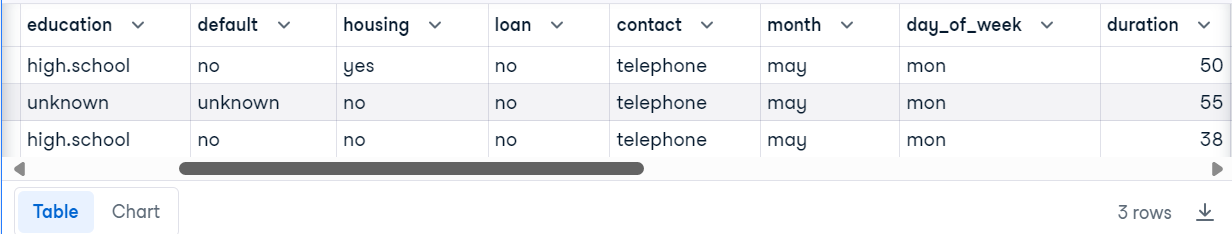
Örneğin, bir DuckDB ilişkisi oluşturmak için bir CSV dosyası yükleyeceğiz. Tabloyu analiz etmek için filter ve limit işlevlerini zincirleyebilirsiniz.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
İlişkileri, DuckDB veritabanından tablo yükleyerek de oluşturabiliriz.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
'y']Veriyi analiz etmek için birden çok işlev kullanan bir ilişki yazalım.
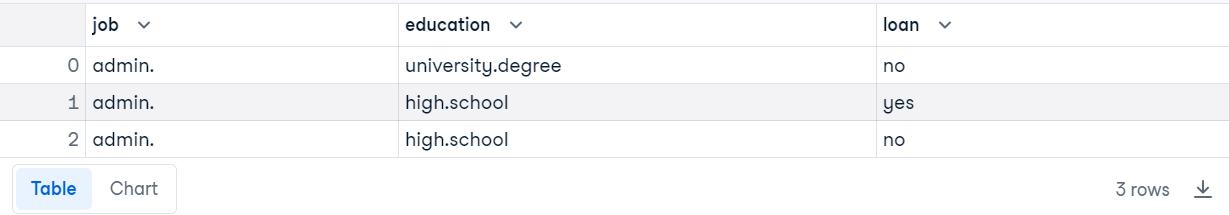
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()İşlere göre sıralanmış ve duration sütununa göre filtrelenmiş üç satır ve sütun elde ettik.
DuckDB sorgu işlevi, veritabanı içinde SQL sorgularının yürütülmesini sağlar ve sonuçları ileri analiz için çeşitli formatlara dönüştürülebilir biçimde döndürür.
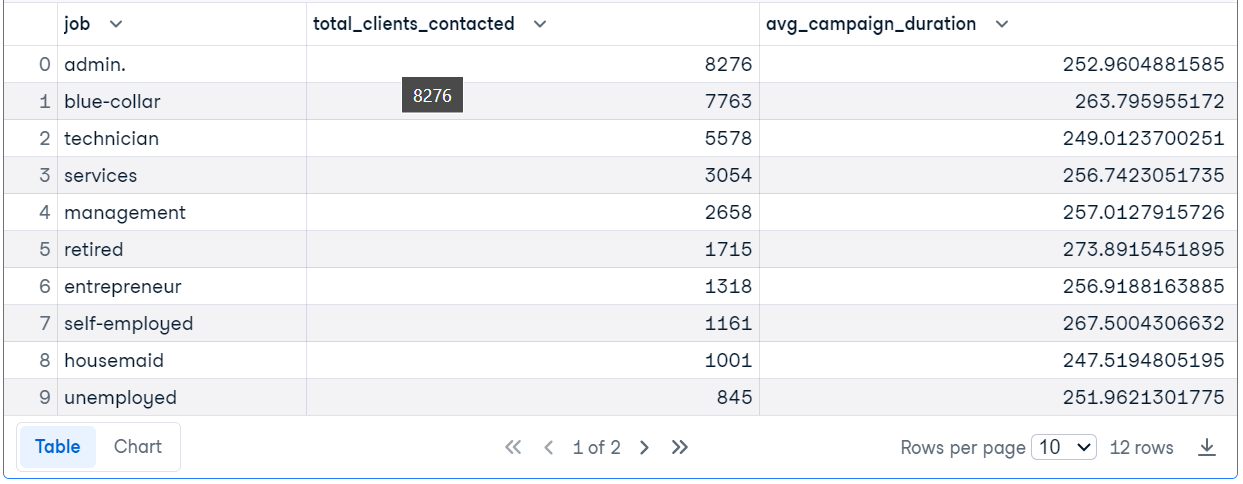
Kod örneğinde, 30 yaş üstü müşterilerin iş unvanlarını bulmak, her iş için iletişime geçilen müşteri sayısını saymak ve kampanyanın ortalama süresini hesaplamak için SQL sorgusu çalıştırıyoruz.
İlişkisel bir veritabanını yönetmeyi ve basit veri analizi için sorgular çalıştırmayı öğrenmek üzere SQL Fundamentals beceri yolunu tamamlayın.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
Şimdi veritabanı bağlantısını kapatacak ve bu bağlantıyla ilişkili kaynakları serbest bırakacağız; böylece olası bellek ve dosya tanıtıcı sızıntılarını önleyeceğiz.
con.close()Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız lütfen DuckDB ile Başlarken çalışma alanına göz atın.
İlk projede, LlamaIndex ile bir RAG uygulaması geliştirmeyi ve DuckDB’yi bir Vektör veritabanı ve alıcı (retriever) olarak kullanmayı öğreneceğiz.
İndeksi oluşturup sorgulamak için kullanılacak gerekli tüm Python paketlerini yükleyin.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Gerekli Python paketi ve işlevleri içe aktarın.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayBir dil modeli olarak en yeni GPT4o modelini ve OpenAI API’sini kullanacağız. Büyük dil modeli (LLM) istemcisini oluşturmak için yalnızca bir model adı ve API anahtarı sağlamanız yeterlidir.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Ardından, OpenAI text-embedding-3-small modelini kullanarak gömme modeli istemcisini oluşturacağız.
Not: Geliştirme ortamınızda “OPENAI_API_KEY” adlı ortam değişkeni ayarlıysa OpenAI API anahtarı sağlamanız isteğe bağlıdır.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
OpenAI LLM ve Gömme modellerini, tüm LlamaIndex işlevlerinin kullanabilmesi için genel (global) olarak ayarlayacağız. Kısacası, bu modeller varsayılan olarak tanımlanacak.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelProjemiz için, veri klasöründen PDF dosyalarını yükleyeceğiz. Bu PDF dosyaları, tarayıcının yazdırma işlevi kullanılarak PDF olarak kaydedilmiş DataCamp eğitimleridir.
Klasör dizinini SimpleDirectoryReader işlevine verin ve veriyi yükleyin.
documents = SimpleDirectoryReader("Data").load_data()
Ardından, mevcut “datacamp.duckdb” veritabanını kullanarak “blog” adlı vektör deposunu oluşturun. Sonrasında, PDF verilerini gömmelere dönüştürüp vektör deposunda saklayın.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
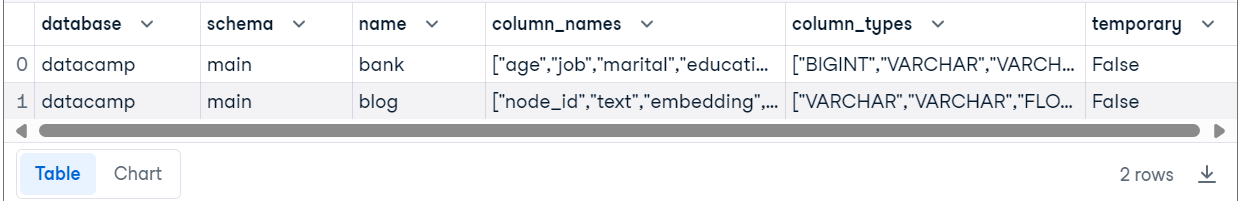
Vektör depomuzun başarıyla oluşturulup oluşturulmadığını kontrol etmek için DuckDB Python API’sini kullanarak veritabanına bağlanacak ve veritabanındaki tüm tabloları göstermek için SQL sorgusu çalıştıracağız.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
İki tablomuz var: “bank” adında tanıtım amaçlı bir tablo ve bir vektör deposu olan “blog” tablosu. “blog” tablosunda tüm gömmelerin saklandığı bir “embedding” sütunu bulunur.
İndeksi bir sorgu motoruna dönüştürün; bu motor, yanıt üretmeden önce benzer belgeleri bulmak için otomatik olarak vektör veritabanında arama yapacak ve ek bağlamı kullanacaktır.
RAG sorgu motorunu test etmek için eğitimle ilgili bir soru soracağız.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
Ve yanıt doğru.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Şimdi, yanıtı üretmek için konuşma geçmişini kullanan gelişmiş bir RAG uygulaması oluşturalım. Bunun için bir sohbet bellek arabelleği oluşturup ardından bellek, LLM ve vektör depo alıcısı içeren bir sohbet motoru kurmamız gerekiyor.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

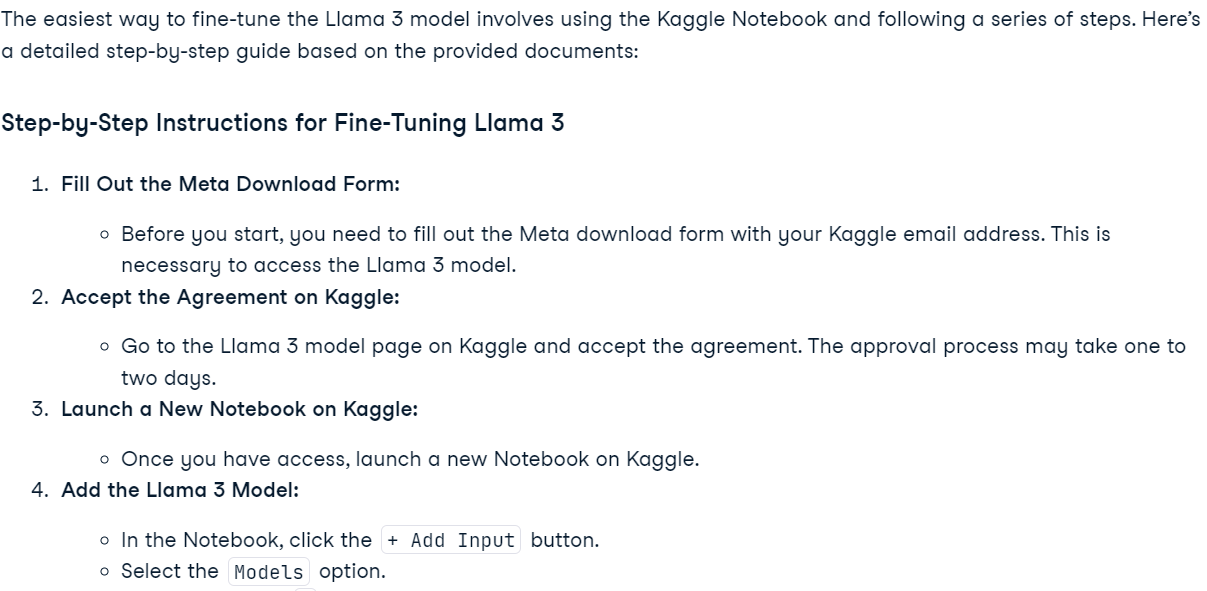
response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
Sohbet motoruna Llama 3 modelinin nasıl ince ayar yapılacağını sorduk ve vektör deposunu kullanarak son derece doğru bir yanıt verdi.
Bellek arabelleğinin doğru çalışıp çalışmadığını görmek için takip niteliğinde bir soru soracağız.
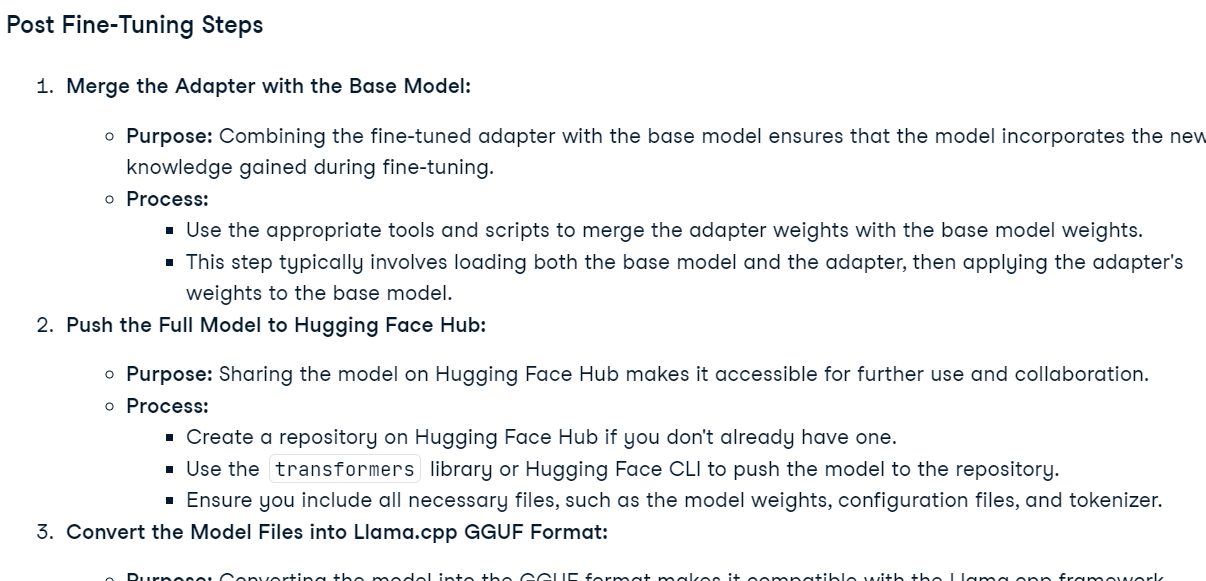
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
Sohbet motoru önceki konuşmayı hatırladı ve buna göre yanıt verdi.
Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız lütfen DuckDB ile bir RAG uygulaması oluşturma çalışma alanına göz atın.
İkinci projede, DuckDB’yi bir SQL sorgu motoru olarak kullanacağız. Bu, veritabanı motorunu GPT-4o modeliyle entegre ederek veritabanıyla ilgili sorulara doğal dilde yanıtlar üretmeyi içerir.
SQLAlchemy kullanarak bir veritabanı motoru oluşturmak için duckdb-engine paketini kurun.
%pip install duckdb-engine -qDuckDB veritabanını create_engine işlevini kullanarak yükleyeceğiz ve ardından başarıyla yüklendiğini kontrol etmek için basit bir SQL sorgusu yazacağız.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Harika. DuckDB veritabanı motorumuz kullanıma hazır.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Şimdi, SQLDatabase işlevini kullanarak bir veritabanı Aracı oluşturmalıyız. Ona bir engine nesnesi ve tablo adı verin.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])LlamaIndex SQL veritabanı nesnesini sağlayarak NLSQLTableQueryEngine işlevi ile SQL sorgu motorunu oluşturun.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Doğal dilde, sorgu motoruna “bank” tablosu hakkında soru sorun.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
Yanıt olarak, sorgunuza doğal dilde cevap alacağız. Harika değil mi?
The longest running campaign in the database has a duration of 4918 days.Daha karmaşık bir soru soralım.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
Yanıt, ek bilgilerle birlikte nettir.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Arka planda neler olup bittiğini görmek için metaveriyi yazdıracağız.
print(response.metadata)Görüldüğü gibi GPT-4o önce SQL sorgusunu oluşturuyor, sonucu almak için sorguyu çalıştırıyor ve ardından yanıtı üretmek için bu sonucu kullanıyor. Bu çok adımlı süreç yalnızca iki satır kodla gerçekleştiriliyor.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Proje bittiğinde motoru kapatın.
engine.close()Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız lütfen DuckDB SQL Sorgu Motoru çalışma alanına göz atın.
DuckDB hızlıdır, kullanımı kolaydır ve sayısız veri ve yapay zekâ çerçevesiyle sorunsuz şekilde entegre olur. Bir veri bilimci olarak, API’sine alışmanın ve onu herhangi bir Python paketi gibi kullanmaya başlamanın yalnızca birkaç dakikanızı alacağını göreceksiniz. DuckDB’nin en iyi özelliklerinden biri, bağımlılıklarının olmamasıdır; bu da barındırma veya ek kurulumla uğraşmadan neredeyse her yerde kullanabileceğiniz anlamına gelir.
Bu eğitimde DuckDB ve temel özelliklerini öğrendik. Ayrıca DuckDB Python API’sini keşfederek bir tablo oluşturup basit veri analizi yaptık. Eğitimin ikinci yarısında iki projeyi ele aldık: DuckDB’nin bir vektör veritabanı olarak kullanıldığı bir Alım Destekli Üretim (RAG) uygulaması ve DuckDB’nin bir SQL sorgu motoru olarak gösterimi.
Bir SQL sorgu motoru kullanmaya veya bir veritabanını yapay zekâ ile entegre etmeye başlamadan önce SQL ve veri analizi hakkında temel bir anlayışa ihtiyaç vardır. Sorguyu yazabilirsiniz, ancak hangi soruyu sormanız gerektiğini nasıl bileceksiniz? İşte burada temel düzeyde veri analizi ve SQL bilgisi devreye girer. Bu bilgiyi Associate Data Analyst in SQL kariyer yolunu tamamlayarak edinebilirsiniz.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



