
Khóa học
Xây dựng ứng dụng AI với Pinecone
3 giờ
12.3K
Gần đây, DuckDB đã ra khỏi giai đoạn beta và phát hành phiên bản ổn định, nhanh chóng trở nên phổ biến khi nhiều framework dữ liệu tích hợp nó vào hệ sinh thái của mình. Đây là thời điểm lý tưởng để học DuckDB để bạn có thể theo kịp thế giới dữ liệu và AI luôn thay đổi.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu về DuckDB và các tính năng chính kèm ví dụ mã. Trọng tâm sẽ là cách tích hợp nó với các framework AI hiện tại. Chúng ta sẽ thực hiện hai dự án. Đầu tiên, chúng ta sẽ build một ứng dụng Retrieval-Augmented Generation (RAG) sử dụng DuckDB như một cơ sở dữ liệu vector. Sau đó, chúng ta sẽ dùng DuckDB như một công cụ truy vấn AI để phân tích dữ liệu bằng ngôn ngữ tự nhiên thay cho SQL.
DuckDB là một hệ quản trị cơ sở dữ liệu phân tích hiện đại, hiệu năng cao, trong bộ nhớ (in-memory) được thiết kế để hỗ trợ các truy vấn phân tích phức tạp. Đây là một hệ quản trị cơ sở dữ liệu quan hệ (dạng bảng) hỗ trợ ngôn ngữ truy vấn có cấu trúc (SQL).
DuckDB kết hợp sự đơn giản và dễ sử dụng của SQLite với khả năng hiệu năng cao cần thiết cho khối lượng công việc phân tích, khiến nó trở thành lựa chọn tuyệt vời cho nhà khoa học dữ liệu và nhà phân tích.
Trong phần này, chúng ta sẽ thiết lập DuckDB, tải tệp CSV, thực hiện phân tích dữ liệu và tìm hiểu về quan hệ cùng các hàm truy vấn.
Chúng ta sẽ bắt đầu bằng cách cài đặt gói DuckDB cho Python.
pip install duckdb --upgradeĐể tạo cơ sở dữ liệu lưu trữ, bạn chỉ cần dùng hàm connect và cung cấp tên cơ sở dữ liệu.
import duckdb
con = duckdb.connect("datacamp.duckdb")
Nó sẽ tạo một tệp cơ sở dữ liệu trong thư mục cục bộ của bạn.
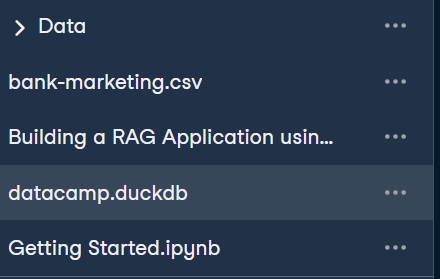
Chúng ta sẽ tải một tệp CSV và tạo bảng "bank". Bộ dữ liệu sử dụng có sẵn trên DataLab với tên Bank Marketing. Nó gồm các chiến dịch tiếp thị trực tiếp bằng cuộc gọi điện thoại của một tổ chức ngân hàng Bồ Đào Nha.
Để tải tệp CSV, bạn cần tạo bảng trước bằng SQL, sau đó dùng hàm read_csv() trong script SQL để nạp tệp. Đơn giản vậy thôi.
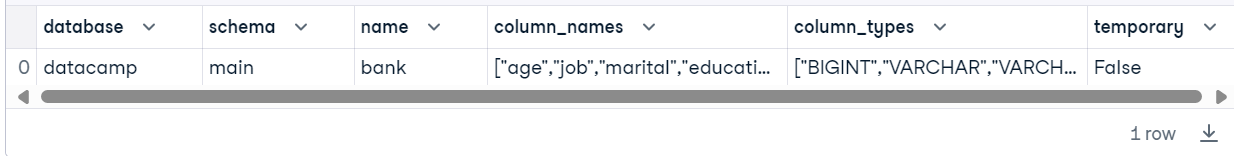
Sau đó, chúng ta sẽ xác thực bảng bằng cách chạy script SQL hiển thị tất cả bảng trong cơ sở dữ liệu và dùng hàm fetchdf để hiển thị kết quả dưới dạng DataFrame của pandas.
Lưu ý: Chúng tôi dùng DataLab của DataCamp làm trình soạn thảo mã. DataLab là Jupyter Notebook trên đám mây mà bạn có thể truy cập miễn phí nếu có tài khoản DataCamp.
con.execute("""
    CREATE TABLE IF NOT EXISTS bank AS
    SELECT * FROM read_csv('bank-marketing.csv')
""")
con.execute("SHOW ALL TABLES").fetchdf()
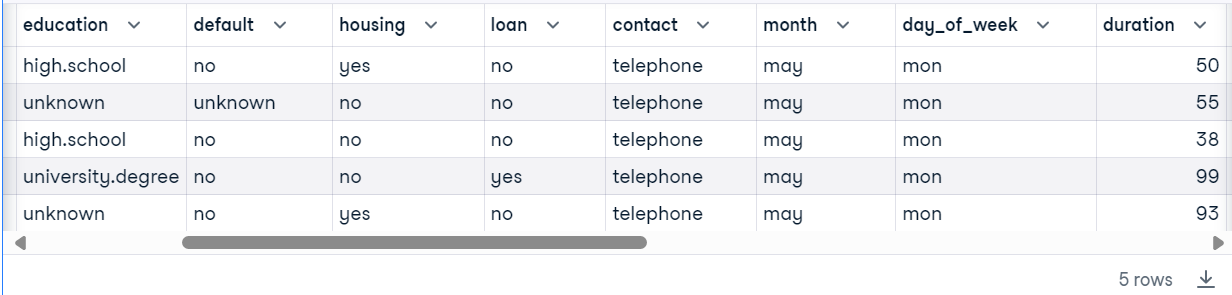
Giờ chúng ta đã tạo thành công bảng đầu tiên, hãy chạy một truy vấn mức nhập môn để phân tích dữ liệu và hiển thị kết quả dưới dạng DataFrame.
con.execute("SELECT * FROM bank WHERE duration < 100 LIMIT 5").fetchdf()
DuckDB được tích hợp gốc vào DataLab mới của DataCamp. Tìm hiểu thêm bằng cách đọc blog "DuckDB biến SQL thành công dân hạng nhất trên DataLab" và sử dụng ô SQL tương tác để phân tích dữ liệu.
Quan hệ (relations) trong DuckDB về cơ bản là các bảng có thể được truy vấn bằng Relational API. API này cho phép xâu chuỗi nhiều thao tác truy vấn trên các nguồn dữ liệu như DataFrame của Pandas. Thay vì dùng truy vấn SQL, bạn sẽ xâu chuỗi các hàm Python để phân tích dữ liệu.
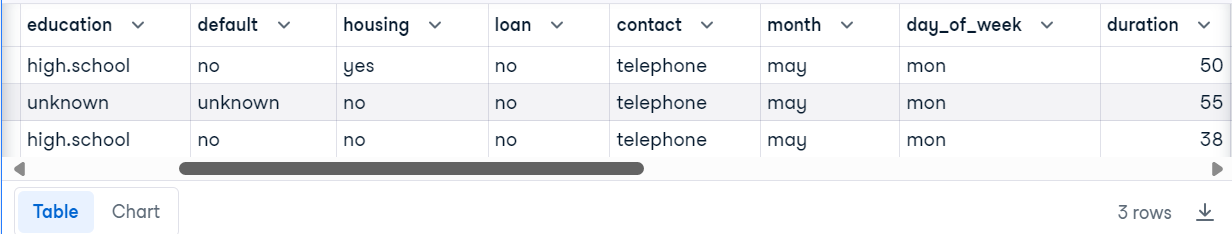
Ví dụ, chúng ta sẽ tải tệp CSV để tạo quan hệ DuckDB. Để phân tích bảng, bạn có thể xâu chuỗi các hàm filter và limit.
bank_duck = duckdb.read_csv("bank-marketing.csv",sep=";")
bank_duck.filter("duration < 100").limit(3).df()
Chúng ta cũng có thể tạo quan hệ bằng cách nạp bảng từ cơ sở dữ liệu DuckDB.
rel = con.table("bank")
rel.columns
['age',
'job',
'marital',
'education',
'default',
'housing',
'loan',
'contact',
'month',
'day_of_week',
'duration',
'campaign',
'pdays',
'previous',
'poutcome',
'emp.var.rate',
'cons.price.idx',
'cons.conf.idx',
'euribor3m',
'nr.employed',
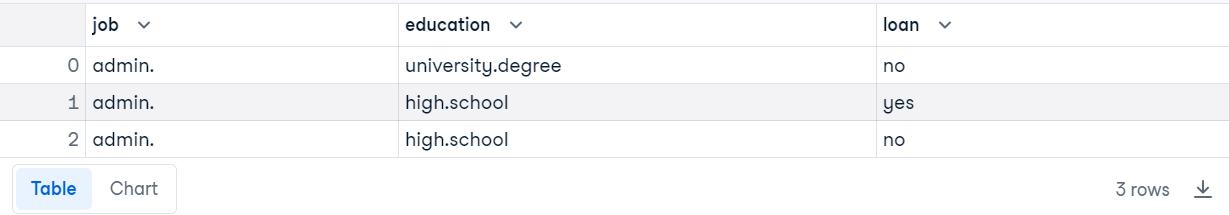
'y']Hãy viết một quan hệ sử dụng nhiều hàm để phân tích dữ liệu.
rel.filter("duration < 100").project("job,education,loan").order("job").limit(3).df()Chúng ta có ba hàng, các cột được sắp xếp theo job và đã lọc theo cột duration.
Hàm truy vấn của DuckDB cho phép thực thi truy vấn SQL trong cơ sở dữ liệu và trả về kết quả có thể chuyển đổi sang nhiều định dạng để phân tích tiếp.
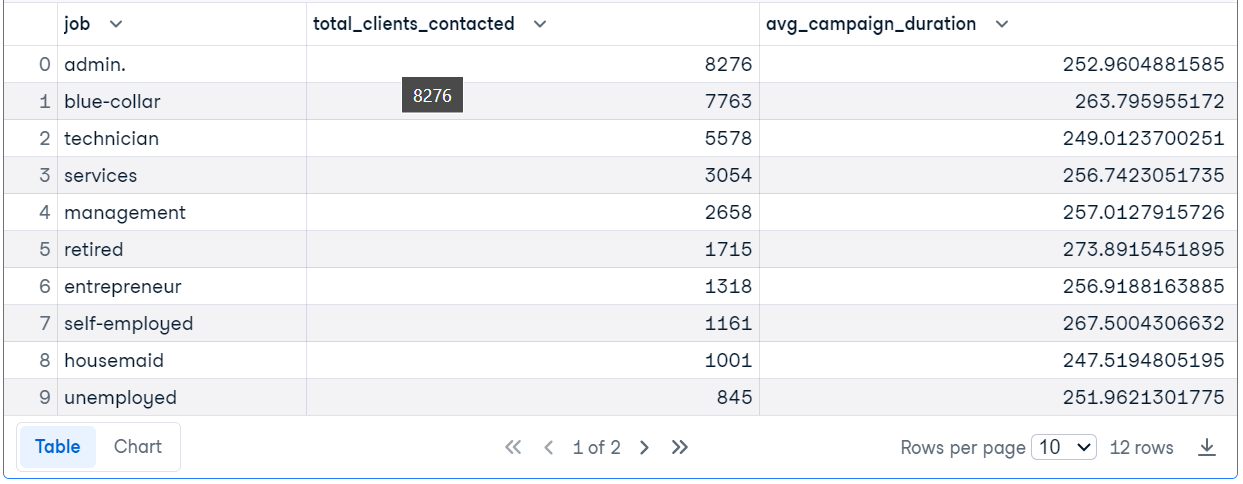
Trong ví dụ mã, chúng ta chạy truy vấn SQL để tìm chức danh công việc của các khách hàng trên 30 tuổi, đếm số khách hàng được liên hệ cho mỗi công việc và tính thời lượng trung bình của chiến dịch.
Tham gia SQL Fundamentals để học cách quản lý cơ sở dữ liệu quan hệ và thực thi truy vấn cho phân tích dữ liệu đơn giản.
res = duckdb.query("""SELECT
                            job,
                            COUNT(*) AS total_clients_contacted,
                            AVG(duration) AS avg_campaign_duration,
                        FROM
                            'bank-marketing.csv'
                        WHERE
                            age > 30
                        GROUP BY
                            job
                        ORDER BY
                            total_clients_contacted DESC;""")
res.df()
Giờ chúng ta sẽ đóng kết nối tới cơ sở dữ liệu và giải phóng mọi tài nguyên liên quan nhằm tránh rò rỉ bộ nhớ và handle tệp.
con.close()Nếu bạn gặp vấn đề khi chạy mã trên, hãy xem workspace Bắt đầu với DuckDB.
Trong dự án đầu tiên, chúng ta sẽ học cách xây dựng ứng dụng RAG với LlamaIndex và dùng DuckDB làm cơ sở dữ liệu vector và bộ truy xuất.
Cài đặt mọi gói Python cần thiết để tạo và truy xuất chỉ mục.
%%capture
%pip install duckdb
%pip install llama-index
%pip install llama-index-vector-stores-duckdb
Import các gói Python cần thiết với các hàm tương ứng.
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.duckdb import DuckDBVectorStore
from llama_index.core import StorageContext

from IPython.display import Markdown, displayVới mô hình ngôn ngữ, chúng ta sẽ dùng mẫu GPT4o mới nhất và OpenAI API. Để tạo client mô hình ngôn ngữ lớn (LLM), bạn chỉ cần cung cấp tên mô hình và API key.
import os
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-4o",api_key=os.environ["OPENAI_API_KEY"])
Tiếp theo, chúng ta sẽ tạo client mô hình nhúng bằng mẫu OpenAI text-embedding-3-small.
Lưu ý: Cung cấp OpenAI API key là tùy chọn nếu biến môi trường có tên “OPENAI_API_KEY” đã được thiết lập trong môi trường phát triển của bạn.
from llama_index.embeddings.openai import OpenAIEmbedding
embed_model = OpenAIEmbedding(
    model="text-embedding-3-small",
)
Chúng ta sẽ đặt mô hình OpenAI LLM và Embedding ở phạm vi toàn cục để mọi hàm của LlamaIndex sử dụng. Nói ngắn gọn, các mô hình này sẽ được đặt làm mặc định.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelTrong dự án này, chúng ta sẽ tải các tệp PDF từ thư mục dữ liệu. Những tệp PDF này là các bài hướng dẫn từ DataCamp được lưu dưới dạng PDF bằng chức năng in của trình duyệt.
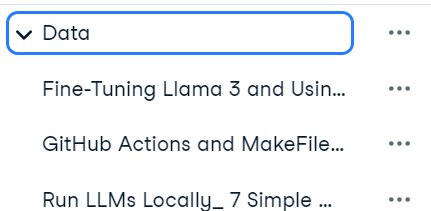
Cung cấp đường dẫn thư mục cho hàm SimpleDirectoryReader và nạp dữ liệu.
documents = SimpleDirectoryReader("Data").load_data()
Sau đó, tạo kho vector tên “blog” sử dụng cơ sở dữ liệu “datacamp.duckdb” hiện có. Tiếp theo, chuyển dữ liệu của PDF thành embeddings và lưu chúng vào kho vector.
vector_store = DuckDBVectorStore(database_name = "datacamp.duckdb",table_name = "blog",persist_dir="./", embed_dim=1536)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)
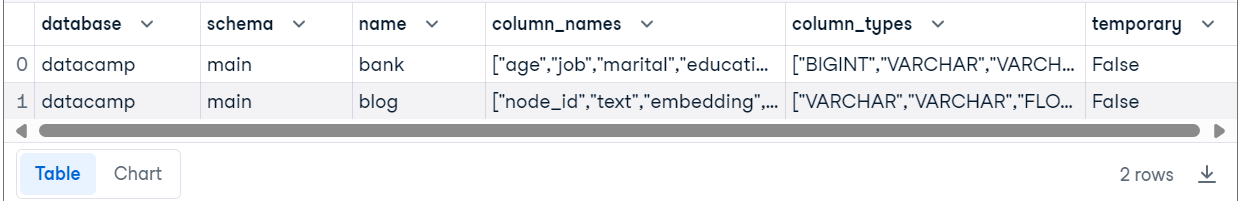
Để kiểm tra kho vector đã tạo thành công, chúng ta sẽ kết nối cơ sở dữ liệu bằng DuckDB Python API và chạy truy vấn SQL để hiển thị tất cả bảng trong cơ sở dữ liệu.
import duckdb
con = duckdb.connect("datacamp.duckdb")

con.execute("SHOW ALL TABLES").fetchdf()
Chúng ta có hai bảng: bảng quảng bá “bank” và bảng “blog”, là kho vector. Bảng “blog” có cột “embedding” nơi lưu tất cả embeddings.
Chuyển chỉ mục thành engine truy vấn, engine này sẽ tự động tìm kiếm trước trong cơ sở dữ liệu vector các tài liệu tương tự và dùng ngữ cảnh bổ sung để tạo phản hồi.
Để kiểm thử engine truy vấn RAG, chúng ta sẽ đặt câu hỏi về bài hướng dẫn.
query_engine = index.as_query_engine()
response = query_engine.query("Who wrote 'GitHub Actions and MakeFile: A Hands-on Introduction'?")
display(Markdown(f"<b>{response}</b>"))
Và câu trả lời là chính xác.
The author of "GitHub Actions and MakeFile: A Hands-on Introduction" is Abid Ali Awan.Bây giờ, hãy tạo một ứng dụng RAG nâng cao sử dụng lịch sử hội thoại để tạo phản hồi. Để làm vậy, chúng ta cần tạo bộ đệm trí nhớ hội thoại rồi tạo chat engine có bộ nhớ, LLM và bộ truy xuất từ kho vector.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
    index.as_retriever(),
    memory=memory,
    llm=llm
)

response = chat_engine.chat(
    "What is the easiest way of finetuning the Llama 3 model? Please provide step-by-step instructions."
)

display(Markdown(response.response))
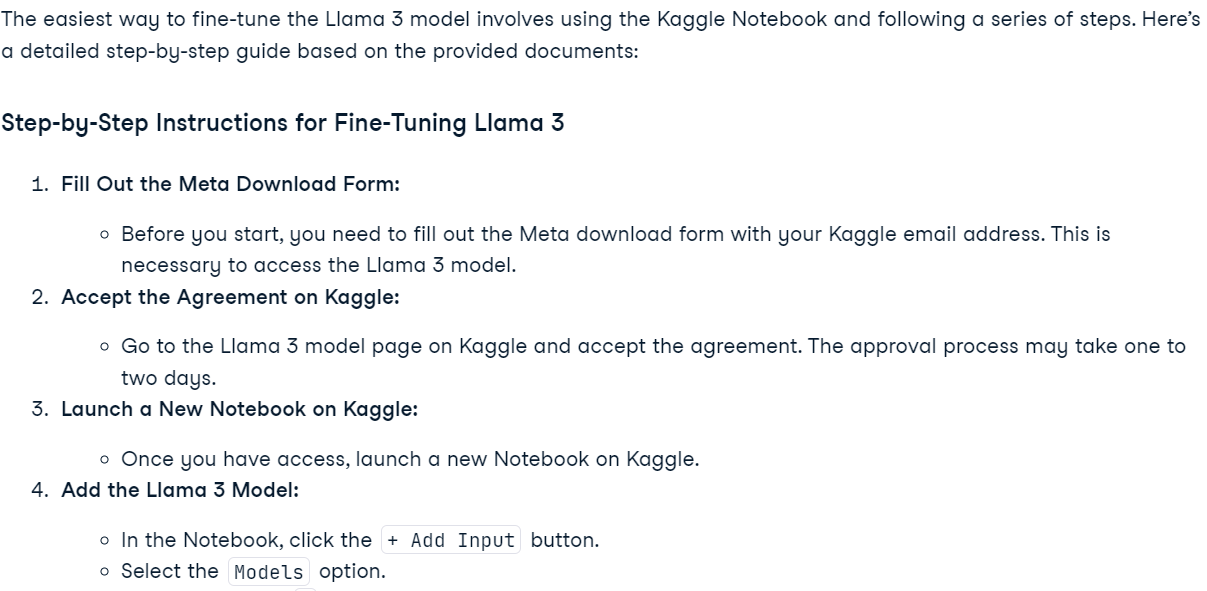
Chúng ta đã hỏi chat engine cách fine-tune mô hình Llama 3 và nó dùng kho vector để đưa ra câu trả lời rất chính xác.
Để kiểm tra bộ đệm trí nhớ hoạt động đúng, chúng ta sẽ hỏi một câu tiếp theo.
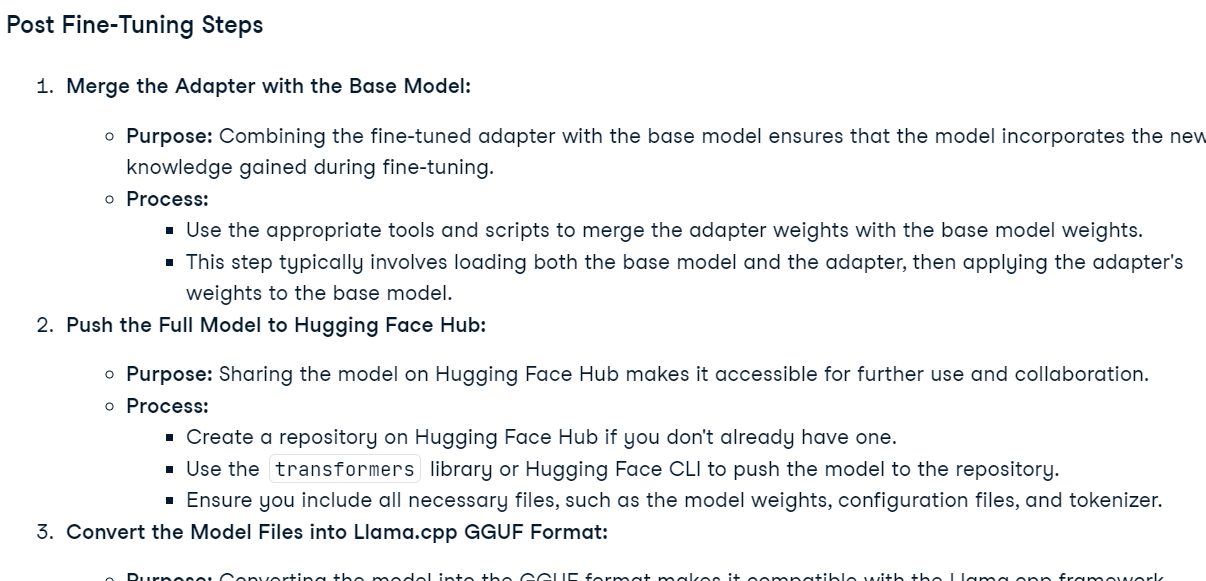
response = chat_engine.chat(
    "Could you please provide more details about the Post Fine-Tuning Steps?"
)
display(Markdown(response.response))
Chat engine đã ghi nhớ cuộc trò chuyện trước đó và phản hồi tương ứng.
Nếu bạn gặp vấn đề khi chạy mã trên, hãy xem workspace Xây dựng ứng dụng RAG với DuckDB.
Trong dự án thứ hai, chúng ta sẽ dùng DuckDB như một công cụ truy vấn SQL. Điều này liên quan đến việc tích hợp engine cơ sở dữ liệu với mô hình GPT-4o để tạo phản hồi ngôn ngữ tự nhiên cho các câu hỏi về cơ sở dữ liệu.
Cài đặt duckdb-engine để tạo engine cơ sở dữ liệu bằng SQLAlchemy.
%pip install duckdb-engine -qChúng ta sẽ nạp cơ sở dữ liệu DuckDB bằng hàm create_engine rồi viết một truy vấn SQL đơn giản để kiểm tra đã nạp thành công chưa.
from sqlalchemy import create_engine

engine = create_engine("duckdb:///datacamp.duckdb")
with engine.connect() as connection:
    cursor = connection.exec_driver_sql("SELECT * FROM bank LIMIT 3")
    print(cursor.fetchall())
Tuyệt vời. Engine cơ sở dữ liệu DuckDB của chúng ta đã sẵn sàng sử dụng.
[(56, 'housemaid', 'married', 'basic.4y', 'no', 'no', 'no', 'telephone', 'may', 'mon', 261, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (57, 'services', 'married', 'high.school', 'unknown', 'no', 'no', 'telephone', 'may', 'mon', 149, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no'), (37, 'services', 'married', 'high.school', 'no', 'yes', 'no', 'telephone', 'may', 'mon', 226, 1, 999, 0, 'nonexistent', 1.1, 93.994, -36.4, 4.857, 5191.0, 'no')]Bây giờ, chúng ta cần tạo một Công cụ cơ sở dữ liệu bằng hàm SQLDatabase. Cung cấp cho nó đối tượng engine và tên bảng.
from llama_index.core import SQLDatabase
sql_database = SQLDatabase(engine, include_tables=["bank"])Tạo công cụ truy vấn SQL bằng hàm NLSQLTableQueryEngine bằng cách cung cấp đối tượng cơ sở dữ liệu SQL của LlamaIndex.
from llama_index.core.query_engine import NLSQLTableQueryEngine

query_engine = NLSQLTableQueryEngine(sql_database)
Đặt câu hỏi cho công cụ truy vấn về bảng “bank” bằng ngôn ngữ tự nhiên.
response = query_engine.query("Which is the longest running campaign?")


print(response.response)
Đáp lại, chúng ta sẽ nhận câu trả lời cho truy vấn bằng ngôn ngữ tự nhiên. Thật tuyệt, bạn nghĩ vậy không?
The longest running campaign in the database has a duration of 4918 days.Hãy hỏi một câu phức tạp hơn.
response = query_engine.query("Which type of job has the most housing loan?")
print(response.response)
Câu trả lời chính xác, kèm thông tin bổ sung.
The job type with the most housing loans is 'admin.' with 5559 housing loans. This is followed by 'blue-collar' with 4710 housing loans and 'technician' with 3616 housing loans. Other job types with significant housing loans include 'services', 'management', 'retired', 'entrepreneur', and 'self-employed'.Để kiểm tra những gì diễn ra ở backend, chúng ta sẽ in metadata.
print(response.metadata)Như ta thấy, GPT-4o trước tiên tạo truy vấn SQL, chạy truy vấn để lấy kết quả, rồi dùng kết quả để tạo phản hồi. Quy trình nhiều bước này đạt được chỉ với hai dòng mã.
{'d4ddf03c-337e-4ee6-957a-5fd2cfaa4b1c': {}, 'sql_query': "SELECT job, COUNT(housing) AS housing_loan_count\nFROM bank\nWHERE housing = 'yes'\nGROUP BY job\nORDER BY housing_loan_count DESC;", 'result': [('admin.', 5559), ('blue-collar', 4710), ('technician', 3616), ('services', 2050), ('management', 1490), ('retired', 892), ('entrepreneur', 779), ('self-employed', 740), ('unemployed', 557), ('housemaid', 540), ('student', 471), ('unknown', 172)], 'col_keys': ['job', 'housing_loan_count']}Đóng engine khi bạn hoàn tất dự án.
engine.close()Nếu bạn gặp vấn đề khi chạy mã trên, hãy xem workspace DuckDB SQL Query Engine.
DuckDB nhanh, dễ sử dụng và tích hợp mượt với nhiều framework dữ liệu và AI. Là một nhà khoa học dữ liệu, bạn sẽ thấy chỉ mất vài phút để làm quen với API của nó và bắt đầu sử dụng như bất kỳ gói Python nào khác. Một trong những tính năng hay nhất của DuckDB là không có phụ thuộc, nghĩa là bạn có thể dùng gần như ở mọi nơi mà không lo về hosting hay thiết lập bổ sung.
Trong hướng dẫn này, chúng ta đã học về DuckDB và các tính năng chính. Chúng ta cũng đã khám phá DuckDB Python API, dùng nó để tạo bảng và thực hiện phân tích dữ liệu đơn giản. Nửa sau của hướng dẫn bao gồm hai dự án: một ứng dụng Retrieval-Augmented Generation (RAG) với DuckDB làm cơ sở dữ liệu vector và một dự án trình diễn DuckDB như một công cụ truy vấn SQL.
Trước khi bắt tay vào dùng công cụ truy vấn SQL hoặc tích hợp cơ sở dữ liệu với AI, bạn cần hiểu biết cơ bản về SQL và phân tích dữ liệu. Bạn có thể viết truy vấn, nhưng làm sao biết hỏi câu gì? Đây là lúc kiến thức nền tảng về phân tích dữ liệu và SQL phát huy tác dụng. Bạn có thể tích lũy kiến thức này bằng cách hoàn thành lộ trình nghề nghiệp Associate Data Analyst in SQL.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học