
Kursus
Memahami Machine Learning
2 jam
311.6K
Continuous Integration (CI) dan Continuous Deployment (CD) adalah praktik yang umum digunakan dalam pengembangan perangkat lunak untuk mengotomatiskan proses pengintegrasian perubahan kode, mengujinya, dan dengan cepat mendistribusikan aplikasi yang diperbarui. Awalnya, praktik ini dikembangkan untuk aplikasi perangkat lunak tradisional, namun kini semakin relevan juga untuk proyek machine learning (ML).
Dalam panduan komprehensif ini, kita akan meninjau CI/CD untuk ML dan mempelajari cara membangun pipeline machine learning kita sendiri yang akan mengotomatiskan proses pelatihan, evaluasi, dan deployment model.
Panduan ini menyajikan proyek sederhana yang hanya menggunakan GitHub Actions untuk mengotomatiskan seluruh proses. Sebagian besar hal yang akan kita bahas sudah dikenal oleh machine learning engineer dan data scientist. Satu-satunya hal baru di sini adalah cara menggunakan GitHub Actions, Makefile, CML, dan Hugging Face CLI.
Daftar di kursus MLOps Concepts untuk mempelajari cara membawa model machine learning dari notebook lokal menjadi model produksi yang menghasilkan nilai bisnis.
CI/CD adalah pengubah permainan saat Anda mengoperasionalkan model dan menggunakannya untuk mengembangkan produk. Menyederhanakan proses otomatisasi memberikan solusi yang bebas bug, cepat, dan skalabel untuk proyek ML Anda, sehingga Anda dapat fokus meningkatkan model alih-alih mengelola dan mendistribusikan solusinya.
Secara khusus, CI/CD untuk machine learning membantu dalam hal-hal berikut:
Dengan CI/CD, Anda dapat melatih ulang model secara otomatis pada data baru sesuai jadwal rutin, menghemat waktu dibandingkan memicu pelatihan ulang secara manual.
Alat CI menjalankan pengujian dan pemeriksaan untuk setiap commit kode, yang membantu menangkap bug, masalah integrasi, dan penurunan kinerja model.
CI/CD membantu memastikan model dapat dibangun ulang dan dilatih ulang dengan cara yang persis sama, sehingga hasil dapat direproduksi. Lingkungan, versi model dan data, serta konfigurasi dikodifikasi.
CI/CD memungkinkan pengujian otomatis model baru sebelum deployment untuk memeriksa masalah. Ini juga memungkinkan pemantauan model pascadeployment yang lebih baik melalui integrasi dengan alat monitoring.
Versi model baru atau eksperimen dapat dengan cepat dilatih, diuji, dan dideploy secara otomatis dengan CI/CD. Ini mempercepat pengembangan dan peningkatan sistem ML.
Seiring pertumbuhan ukuran dan kompleksitas proyek ML, mengelola seluruh siklus hidup secara manual menjadi tidak praktis. Pipeline CI/CD menyediakan solusi yang dapat diskalakan untuk menangani volume data besar, banyak model, dan beragam dependensi sambil menjaga efisiensi dan keandalan.
Dalam panduan ini, kami akan memandu Anda menyiapkan akun dan lingkungan, membuat pipeline CI/CD, dan mengoptimalkan seluruh proses.
Kita akan menggunakan pipeline scikit-learn untuk melatih algoritme random forest dan membangun pengklasifikasi obat. Setelah pelatihan, kita akan mengotomatiskan proses evaluasi menggunakan CML. Terakhir, kita akan membangun dan mendeploy aplikasi web ke Hugging Face Hub.
Dari pelatihan hingga evaluasi, seluruh proses akan diotomatisasi menggunakan GitHub Actions. Yang perlu Anda lakukan hanyalah mendorong (push) kode ke repositori GitHub Anda, dan dalam dua menit, model akan diperbarui di Hugging Face bersama aplikasi, model, dan hasil yang diperbarui.
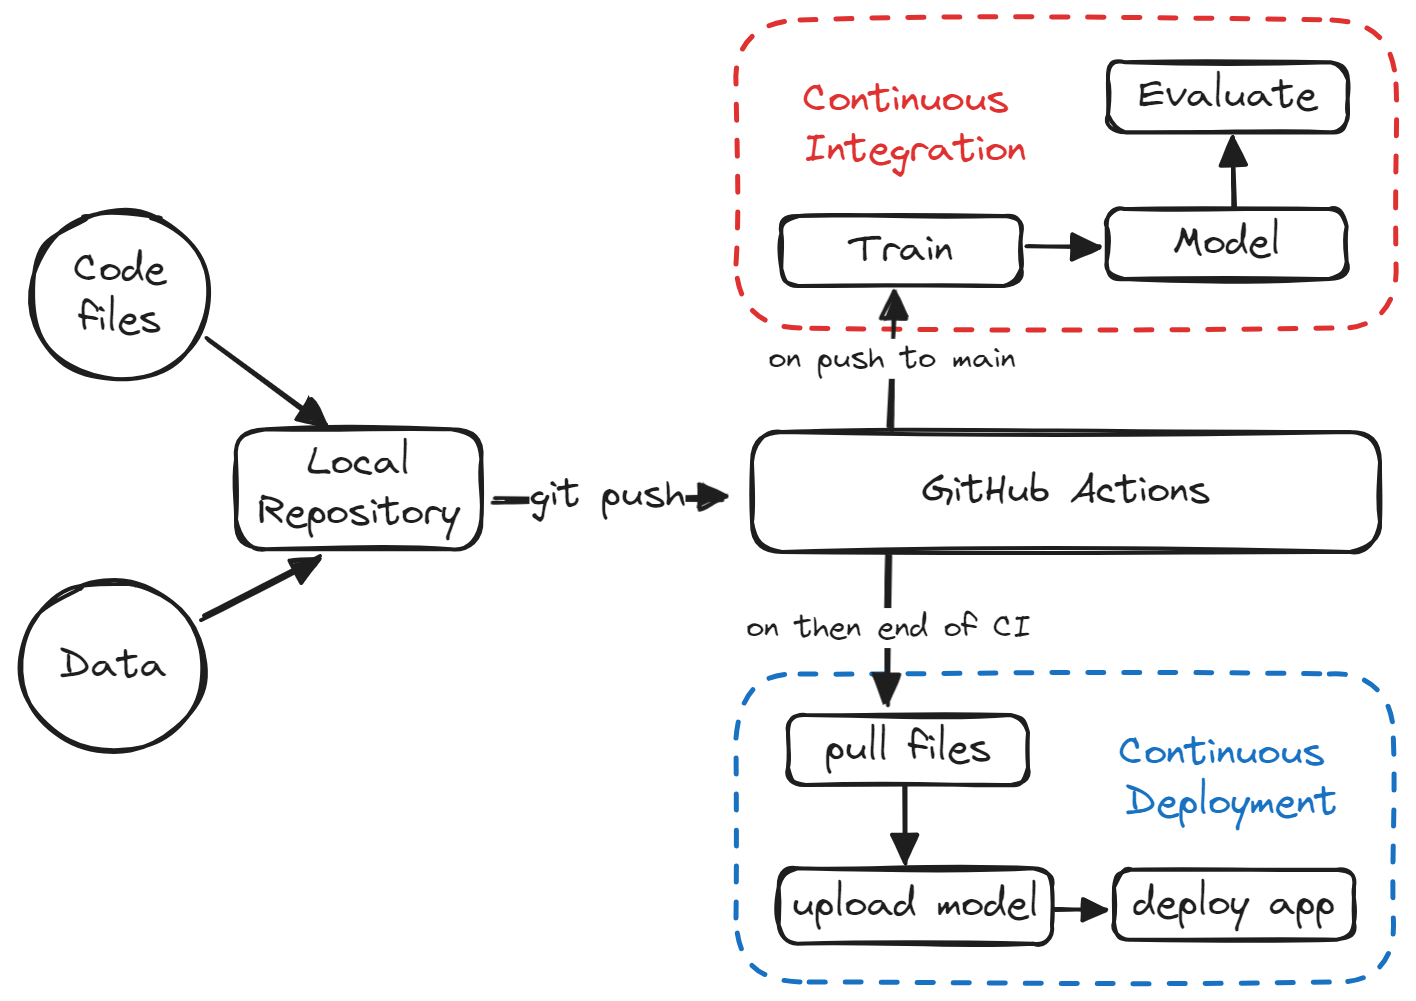
Jika Anda ingin belajar lebih lanjut melalui latihan interaktif, cobalah mengikuti kursus CI/CD for Machine Learning dari DataCamp untuk meningkatkan pengembangan machine learning Anda dengan GitHub Actions dan Data Version Control.
Di bagian ini, kita akan membuat repositori GitHub, file dan folder yang diperlukan, serta sebuah Space di Hugging Face.
Klik tombol “+” di kanan atas halaman utama GitHub dan pilih “New repository”.
Tambahkan nama dan deskripsi repositori, centang file README, dan atur .gitignore sebagai Python.
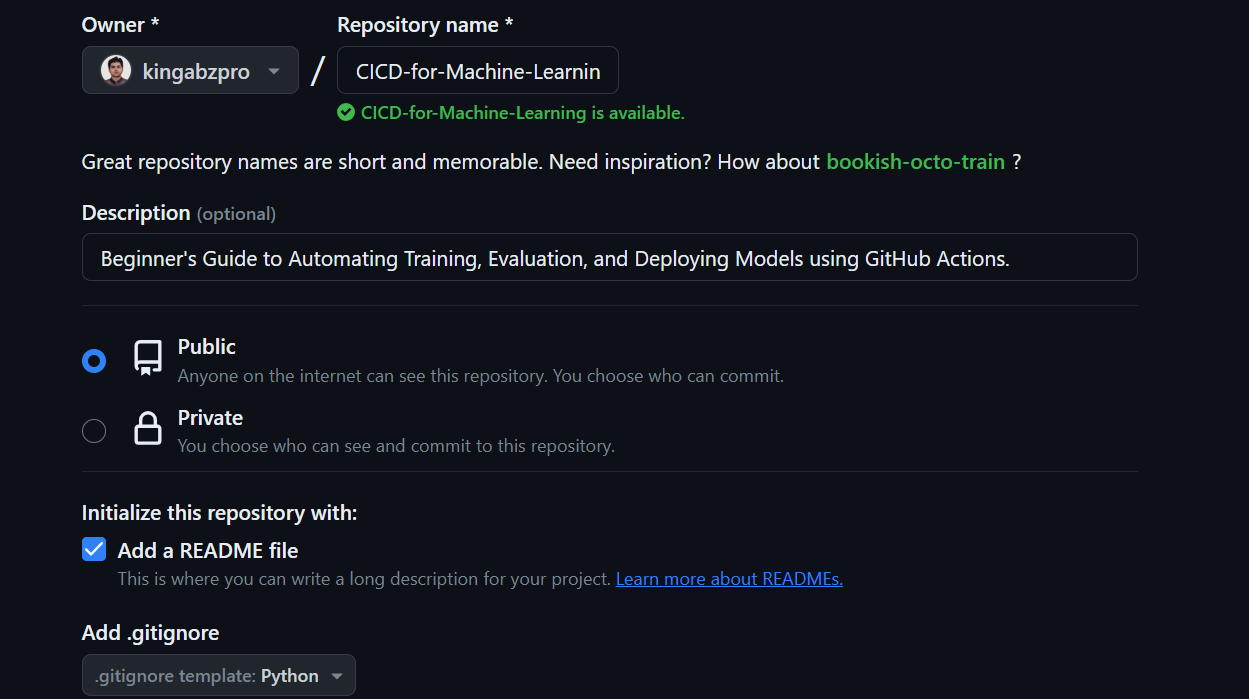
Setelah membuat repositori, kita perlu menyalin URL-nya. Lalu, buka terminal atau bash dan navigasikan ke direktori tempat kita ingin menyimpan folder proyek.
Terakhir, klon repositori dengan menjalankan perintah berikut:
git clone https://github.com/kingabzpro/CICD-for-Machine-Learning.gitUntuk memulai, gunakan IDE pilihan Anda untuk membuka repositori lokal. Kami menyarankan menggunakan VSCode untuk proyek ini. Setelah Anda membuka IDE, Anda akan melihat workspace VSCode berisi file seperti README dan LICENSE.
Mari buat Hugging Face Space yang akan kita gunakan untuk mendeploy aplikasi beserta file model.
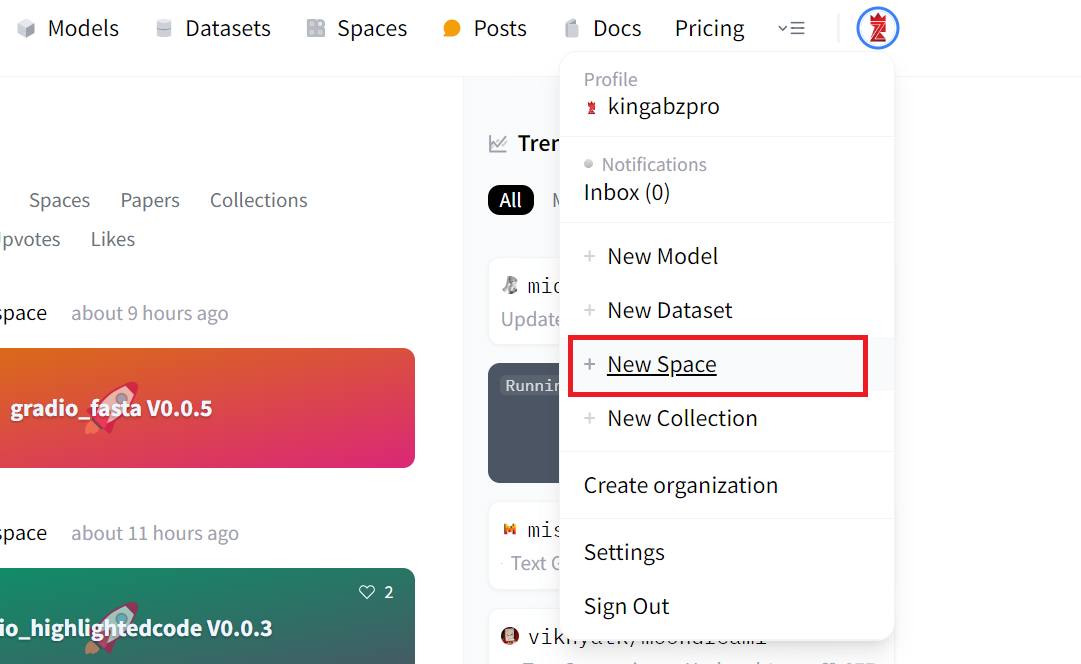
1. Klik foto profil Anda dan pilih "New Space".
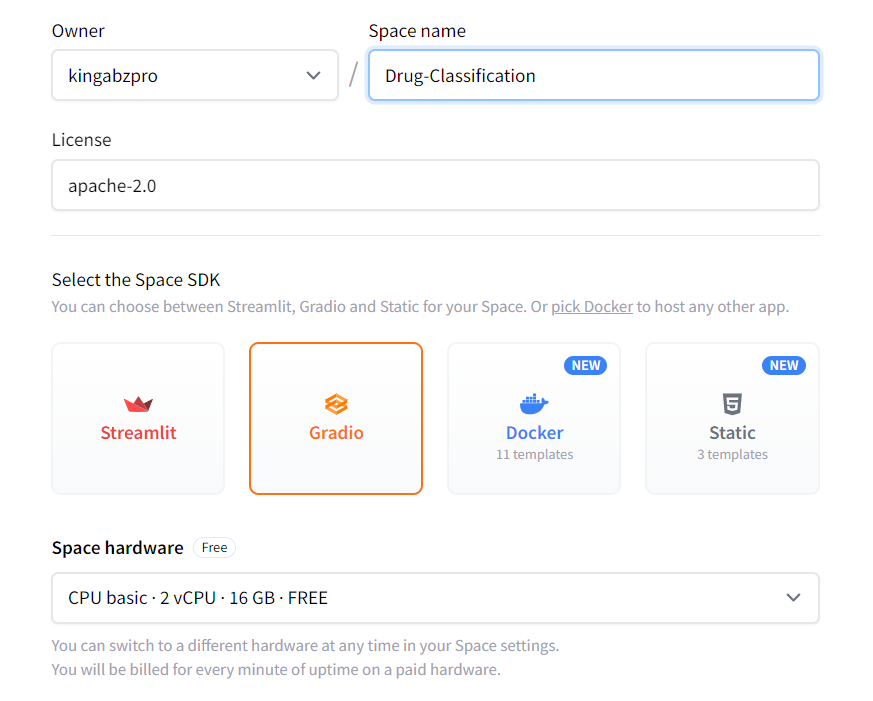
2. Tambahkan nama Spaces, Lisensi, tipe SDK, dan buat Space.
3. Untuk mengedit file README.md, klik tiga titik di kiri atas, pilih Files, dan lakukan perubahan yang diperlukan.
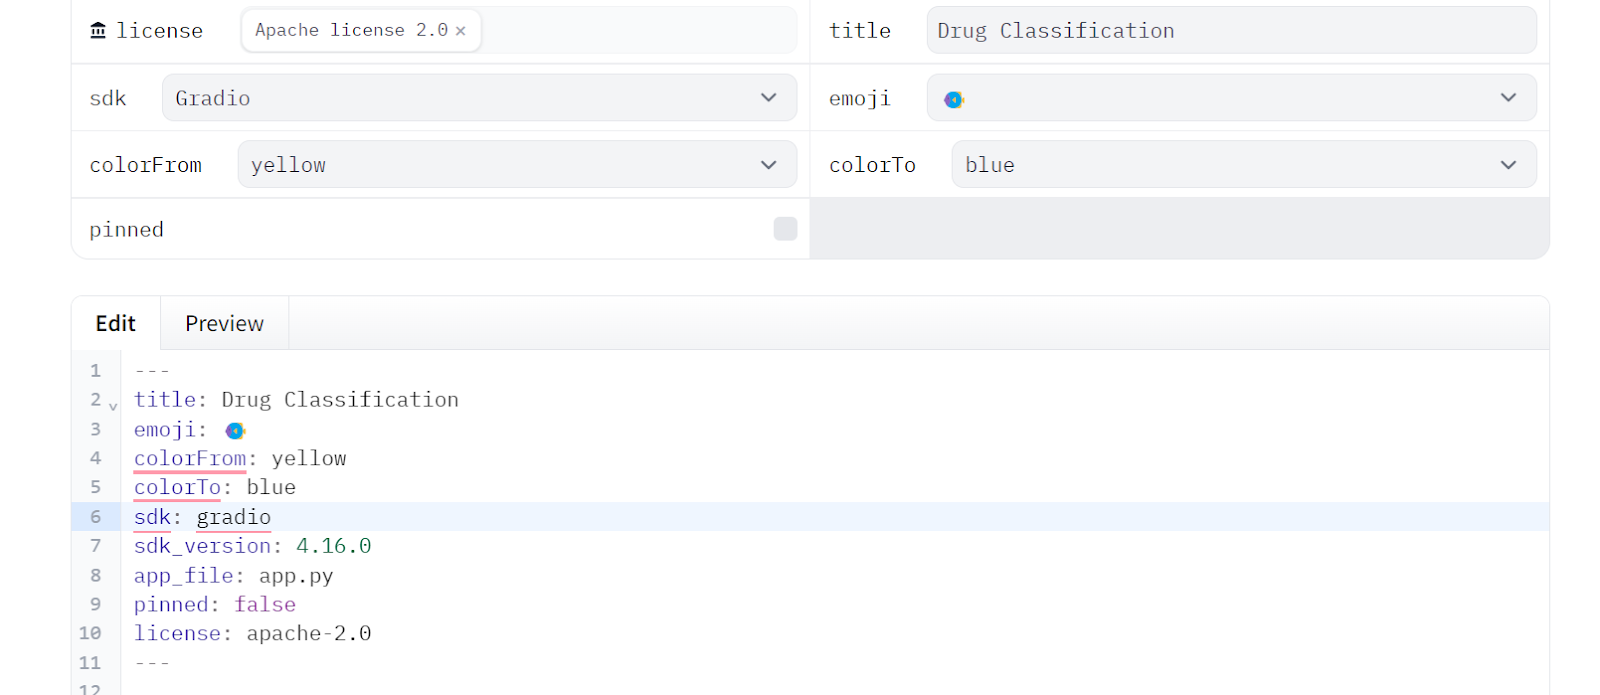
4. Kita akan menyalin metadata dari file README Space dan menempelkannya ke file README lokal kita yang akan disimpan di folder App.
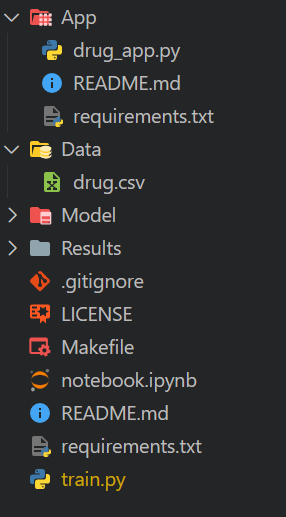
Kita perlu membuat folder dan file yang diperlukan sebelum mulai bereksperimen dan membangun pipeline. Ini akan membantu kita menjaga workspace tetap rapi dalam jangka panjang.
Buat file Python bernama drug_app.py, bersama file README.md dan requirements.txt, lalu pindahkan semua file ini ke folder App. Ini akan membantu kita menata semua file yang diperlukan untuk menjalankan aplikasi.
Selanjutnya, edit file README.md di folder App dan pastikan semua versi metadata telah disesuaikan. Ini akan memudahkan Anda untuk menunjuk lokasi file aplikasi, mengubah warna, menetapkan versi SDK, dan menambahkan informasi lisensi.
---
title: Drug Classification
emoji: 💊
colorFrom: yellow
colorTo: red
sdk: gradio
sdk_version: 4.16.0
app_file: drug_app.py
pinned: false
license: apache-2.0
---
Edit file requirement.txt di folder App dengan menambahkan paket Python yang belum ada:
scikit-learn
skops
Catatan: file requirement dan README akan berbeda untuk repositori GitHub dan Hugging Face Space.
Unduh dataset Drug Classification dari Kaggle, ekstrak file CSV-nya, dan pindahkan ke folder Data.
Baik folder Model maupun Results akan dibiarkan kosong karena akan diisi oleh skrip Python yang kita jalankan.
Makefile untuk menyederhanakan menjalankan skrip pada workflow GitHub Action.notebook.ipynb. Di notebook ini, kita akan bereksperimen dengan algoritme dan pipeline pemrosesan.requirements.txt. File ini akan digunakan untuk menyiapkan lingkungan saat menjalankan job workflow CI.train.py. File ini akan berisi kode Python untuk memuat dan memproses data, serta melatih, mengevaluasi, dan menyimpan model serta metrik kinerja.Struktur direktori kita seharusnya terlihat seperti ini:
Di bagian ini, kita akan bereksperimen membuat kode Python yang memproses data dan melatih model menggunakan pipeline scikit-learn. Kemudian kita akan mengevaluasinya serta menyimpan hasil dan modelnya.
Kita akan menggunakan pandas untuk memuat file CSV, mengacaknya menggunakan fungsi sample, dan menampilkan tiga baris teratas.
import pandas as pd

drug_df = pd.read_csv("Data/drug.csv")
drug_df = drug_df.sample(frac=1)
drug_df.head(3)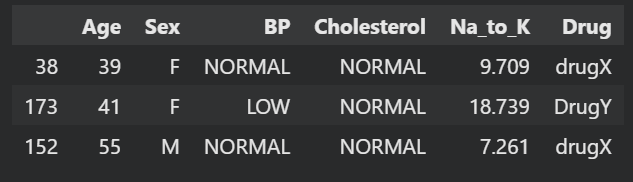
Buat variabel dependen dan independen. Lalu bagi menjadi set pelatihan dan pengujian. Ini akan membantu Anda mengevaluasi kinerja model.
from sklearn.model_selection import train_test_split

X = drug_df.drop("Drug", axis=1).values
y = drug_df.Drug.values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=125
)Kita akan membangun pipeline pemrosesan menggunakan ColumnTransformer, yang akan mengonversi nilai kategorikal menjadi angka, mengisi nilai yang hilang, dan menstandarkan kolom numerik.
Setelah itu, kita akan membuat pipeline pelatihan yang akan mengambil data yang telah ditransformasi dan melatih pengklasifikasi random forest.
Terakhir, kita akan melatih modelnya.
Dengan menggunakan pipeline, kita dapat memastikan reprodusibilitas, modularitas, dan kejelasan dalam kode kita.
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OrdinalEncoder, StandardScaler

cat_col = [1,2,3]
num_col = [0,4]

transform = ColumnTransformer(
    [
        ("encoder", OrdinalEncoder(), cat_col),
        ("num_imputer", SimpleImputer(strategy="median"), num_col),
        ("num_scaler", StandardScaler(), num_col),
    ]
)
pipe = Pipeline(
    steps=[
        ("preprocessing", transform),
        ("model", RandomForestClassifier(n_estimators=100, random_state=125)),
    ]
)
pipe.fit(X_train, y_train)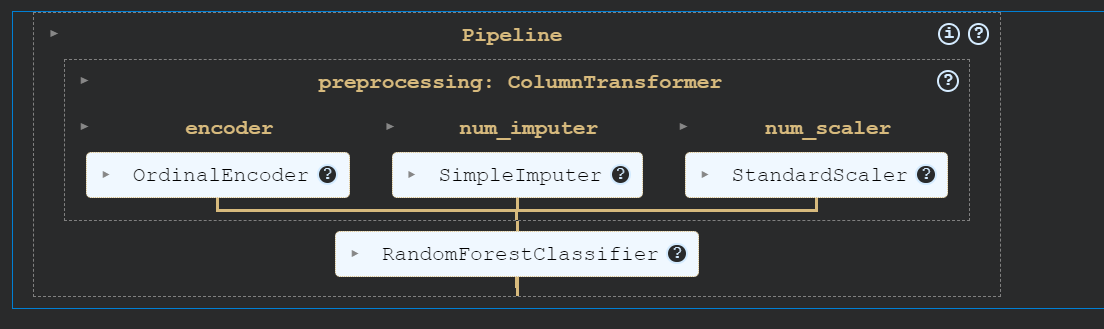
Evaluasi kinerja model dengan menghitung akurasi dan skor F1.
from sklearn.metrics import accuracy_score, f1_score

predictions = pipe.predict(X_test)
accuracy = accuracy_score(y_test, predictions)
f1 = f1_score(y_test, predictions, average="macro")

print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))
Model kita menunjukkan kinerja yang sangat baik.
Accuracy: 95.0% F1: 0.91Buat file metrik dan simpan ke folder Results.
with open("Results/metrics.txt", "w") as outfile:
    outfile.write(f"\nAccuracy = {accuracy.round(2)}, F1 Score = {f1.round(2)}.")
Kemudian kita akan membuat confusion matrix dan menyimpan file gambarnya ke folder Results.
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix

cm = confusion_matrix(y_test, predictions, labels=pipe.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=pipe.classes_)
disp.plot()
plt.savefig("Results/model_results.png", dpi=120)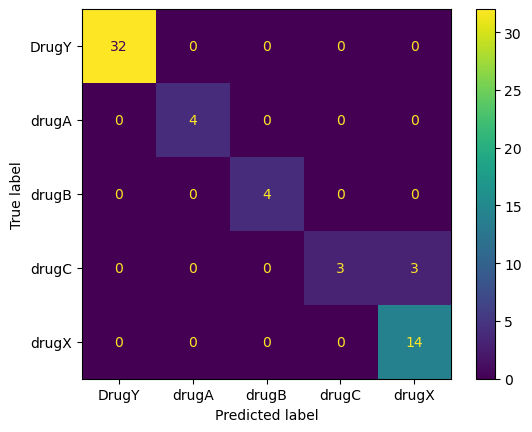
Sekarang kita akan menyimpan model menggunakan paket Python skops. Ini akan membantu kita menyimpan pipeline dan model scikit-learn.
import skops.io as sio

sio.dump(pipe, "Model/drug_pipeline.skops")
Anda dapat memuat seluruh pipeline, dan ini akan langsung berfungsi tanpa perlu memproses data atau mengedit kode.
sio.load("Model/drug_pipeline.skops", trusted=True)
Salin dan tempel seluruh kode ke file 'train.py'. Ini akan menjadi skrip pelatihan standar yang akan berjalan dalam workflow CI setiap kali ada perubahan pada data atau kode.
Sebelum memulai karier Anda di bidang rekayasa MLOps, baca MLOps Roadmap: A Complete Career Guide.
Di bagian ini, kita akan membahas CML, Makefile, dan penyiapan workflow GitHub Actions untuk mengotomatiskan pelatihan, evaluasi, dan versi proyek kita.
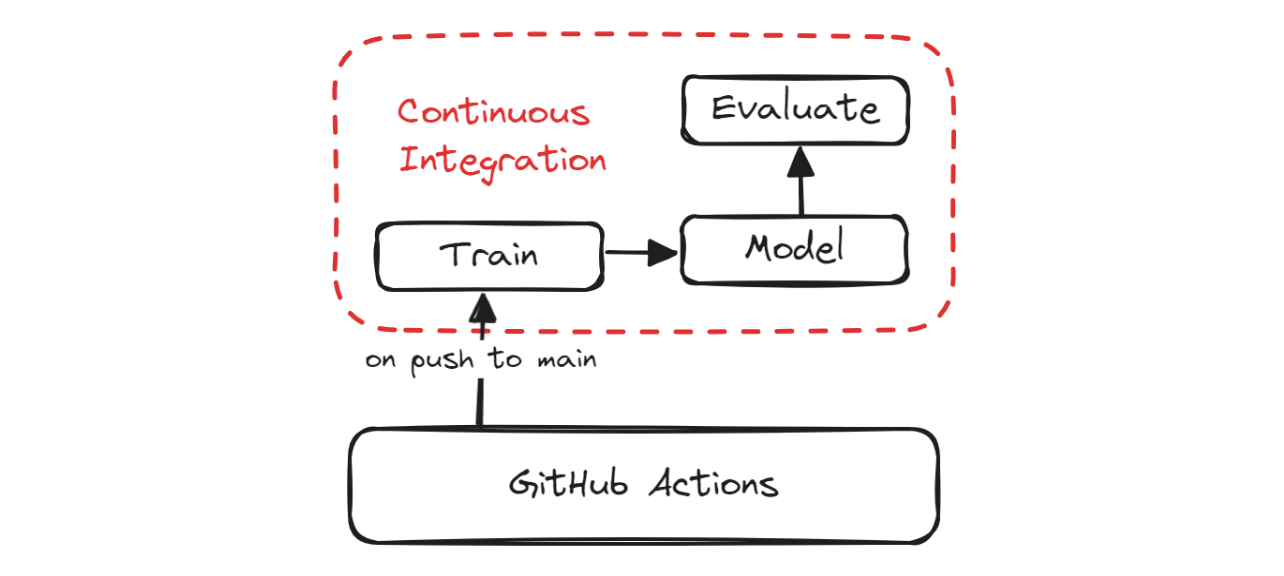
CI Pipeline
Continuous Machine Learning (CML) adalah pustaka open-source yang memungkinkan Anda menerapkan continuous integration dalam proyek machine learning. Kita akan menggunakan GitHub Action "iterative/setup-cml" yang memanfaatkan fungsi CML dalam workflow untuk mengotomatiskan pembuatan laporan evaluasi model.
Apa artinya ini? Setiap kali Anda mendorong perubahan ke GitHub, akan dihasilkan laporan di bawah commit dan Anda akan menerima email berisi metrik kinerja serta confusion matrix.
Makefile adalah file yang berisi serangkaian instruksi yang digunakan oleh perintah make untuk mengotomatiskan berbagai tugas, seperti mengompilasi kode, menjalankan pengujian, menyiapkan lingkungan, pra-pemrosesan data, melatih dan mengevaluasi model, serta mendeploy model.
Kita dapat menggunakan perintah make untuk menjalankan beberapa skrip agar file workflow CI tetap bersih dan sederhana. Makefile berisi nama himpunan perintah dan skrip untuk menjalankannya.
Berikut Makefile kita:
install:
pip install --upgrade pip &&\
pip install -r requirements.txt
format:
black *.py
train:
python train.py
eval:
echo "## Model Metrics" > report.md
cat ./Results/metrics.txt >> report.md
echo '\n## Confusion Matrix Plot' >> report.md
echo '' >> report.md
cml comment create report.mdKita memiliki perintah untuk menginstal paket Python (install), memformat kode (format), menjalankan skrip pelatihan (train), dan menghasilkan laporan CML (eval).
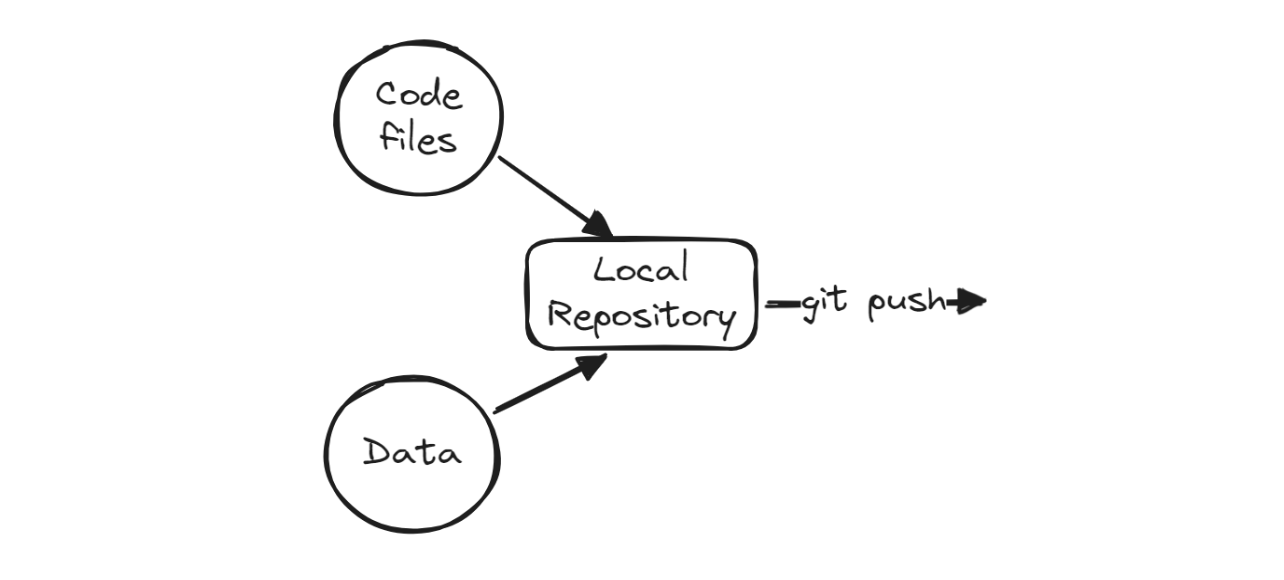
Setelah itu, kita akan menambahkan perubahan, membuat commit, dan mendorong perubahan ke server remote GitHub.
git commit -am "new changes"
git push origin mainUntuk mengotomatiskan pelatihan dan evaluasi, kita perlu membuat workflow GitHub Action. Untuk melakukannya, buka tab “Actions” pada repositori kingabzpro/CICD-for-Machine-Learning dan klik teks biru “set up a workflow yourself.”
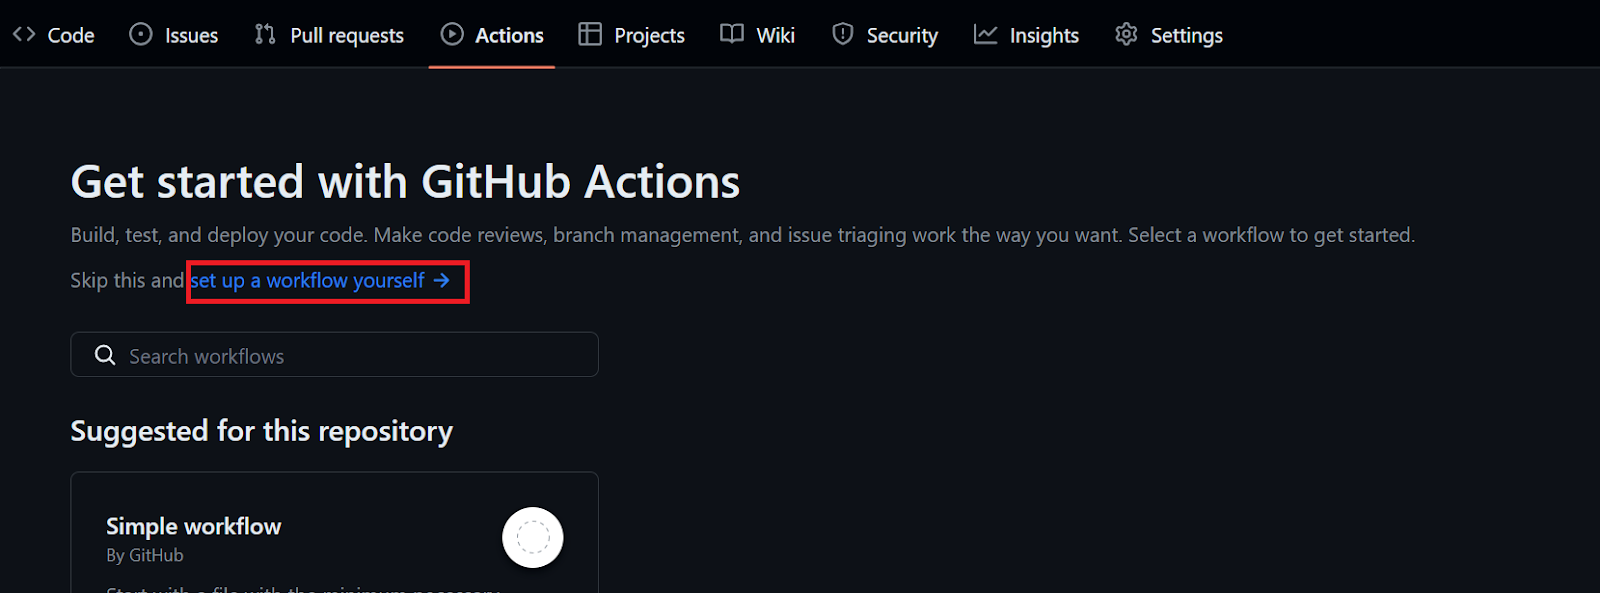
Ganti nama file .yml menjadi “ci” dan mulai tambahkan perintah GitHub Action.
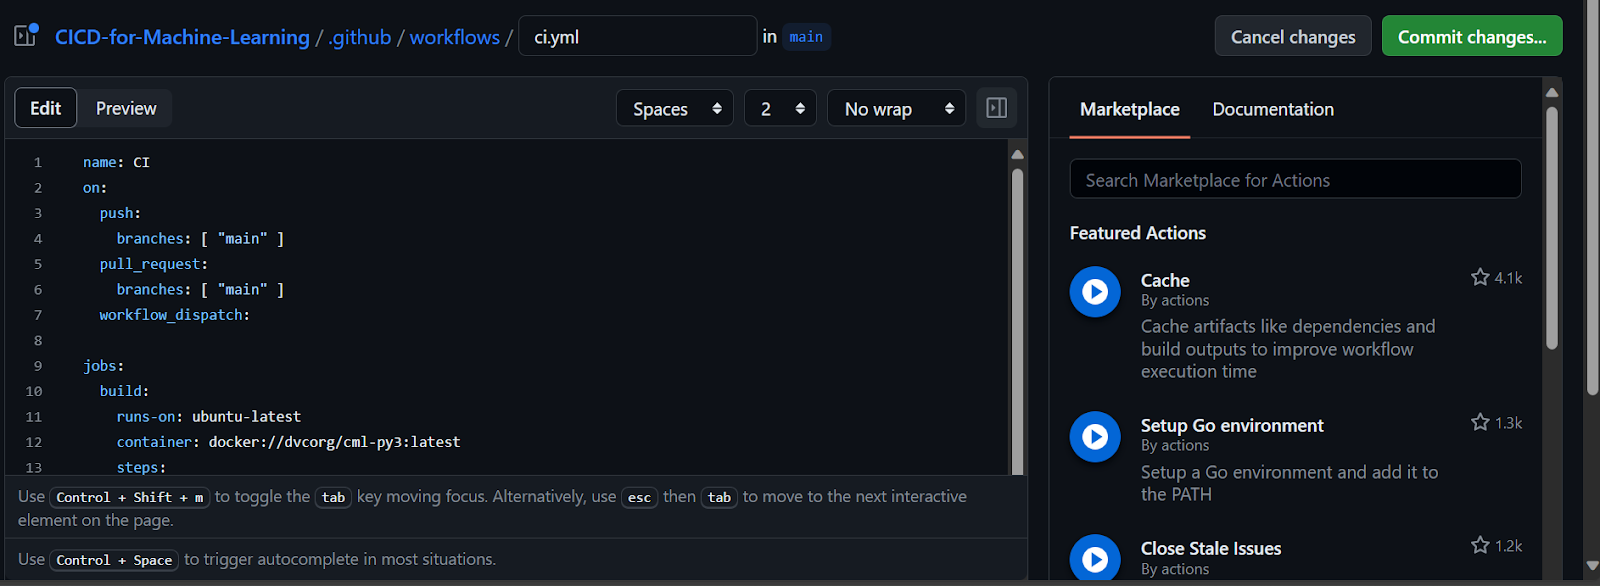
Anda akan menemui kegagalan saat mencari tahu kesalahan dan sintaks, itulah sebabnya penting untuk membaca Workflow syntax for GitHub Actions sebelum mulai menggunakan GitHub Action.
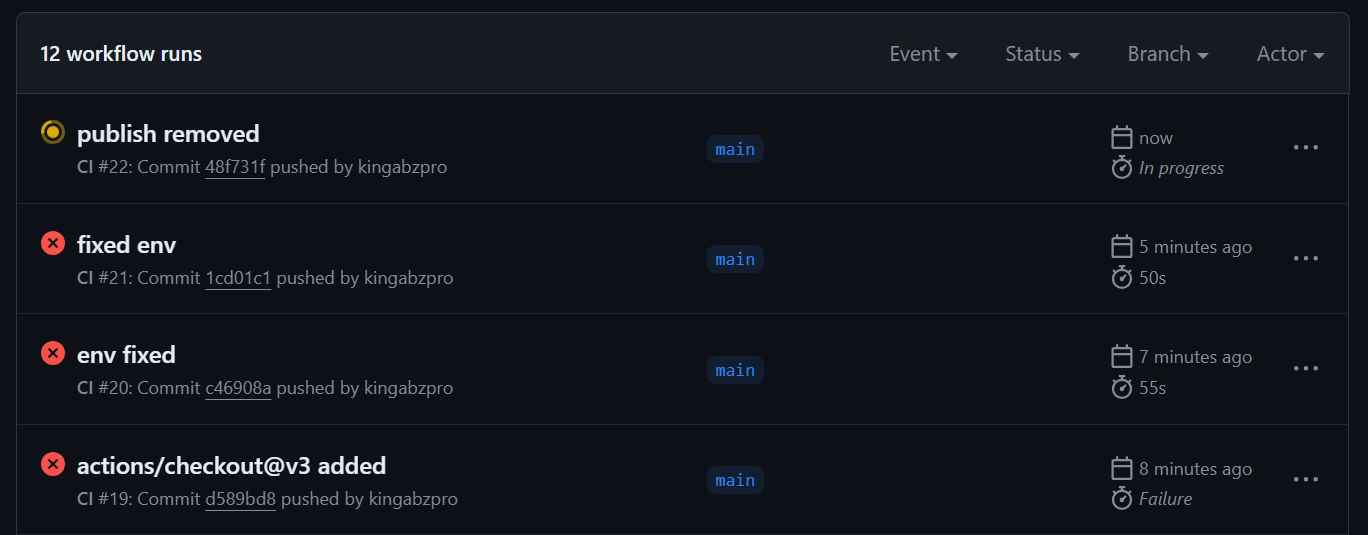
Kami telah berhasil memperbaiki semua error dan masalah dalam workflow, dan kini kami memiliki versi final file `ci.yml` yang berjalan mulus.
Seperti yang Anda lihat, workflow akan terlebih dahulu menyiapkan lingkungan dan memuat action yang diperlukan. Lalu, kita menjalankan setiap langkah satu per satu menggunakan perintah make, yang memanggil berbagai skrip Python dan Bash di backend.
Namun, ada dua hal penting yang perlu diingat saat bekerja dengan CML actions. Pertama, kita perlu menetapkan izin tulis di awal. Kedua, sediakan token GitHub untuk job CML, yang dapat kita akses menggunakan secrets.
name: Continuous Integration
on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]
  workflow_dispatch:

permissions: write-all
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v2
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Train
        run: make train
      - name: Evaluation
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
        run: make eval
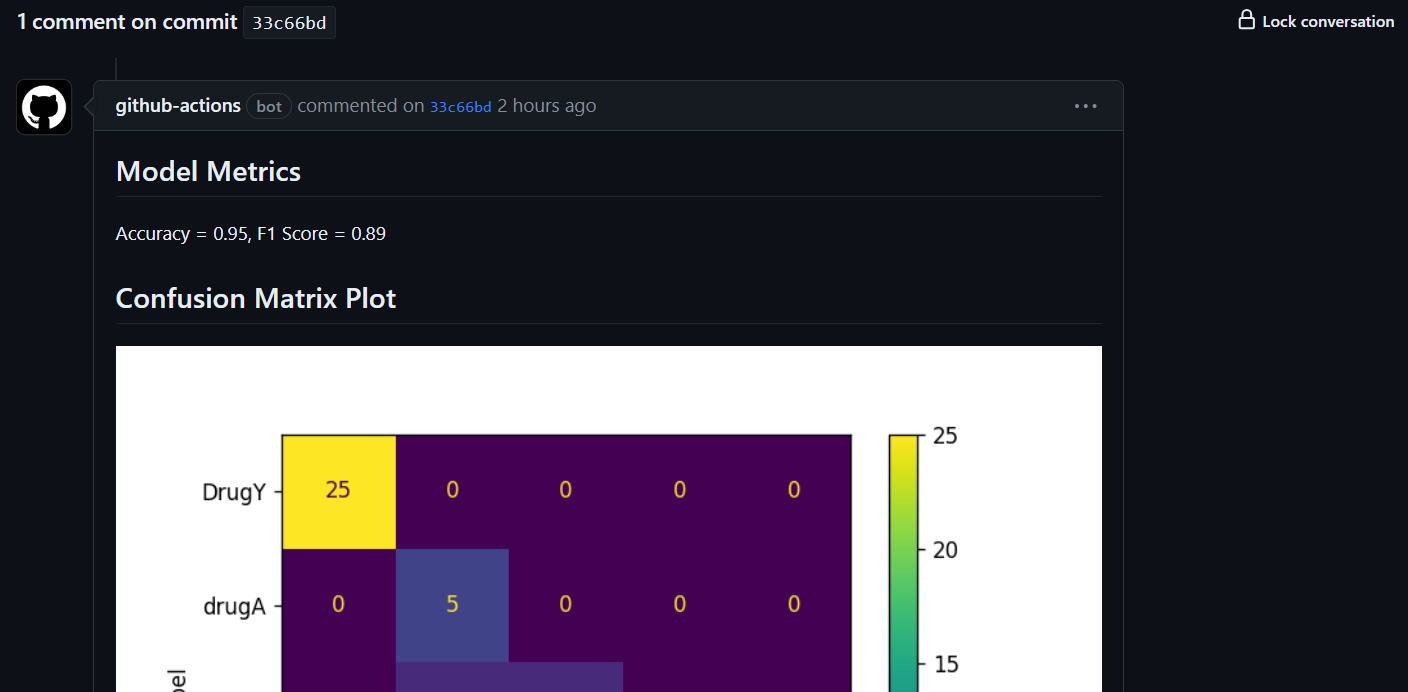
Metrik dan hasil ditampilkan di bawah pesan commit.
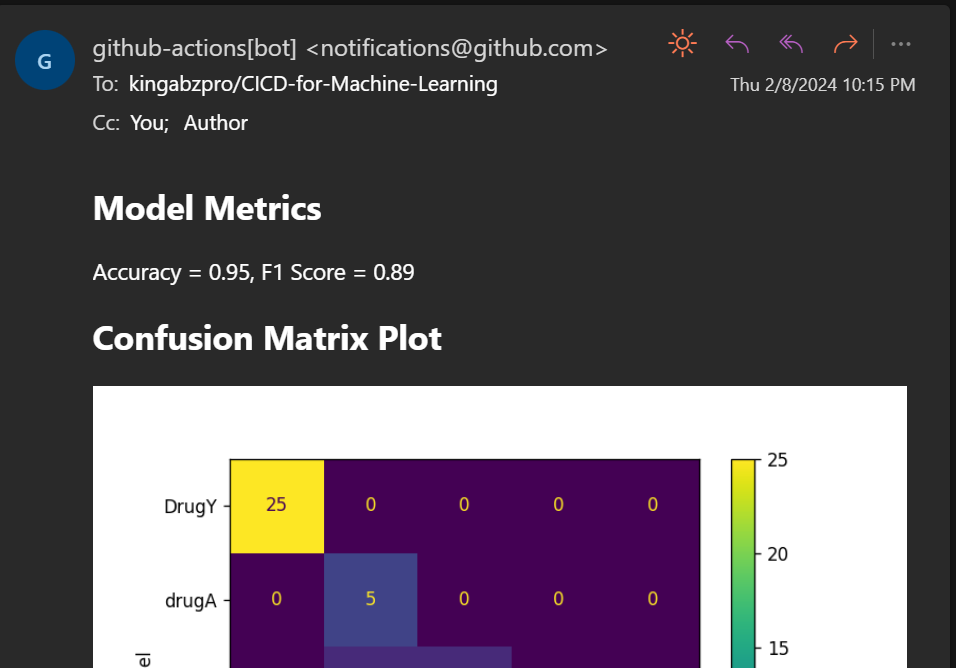
Anda juga akan menerima email berisi hasilnya.
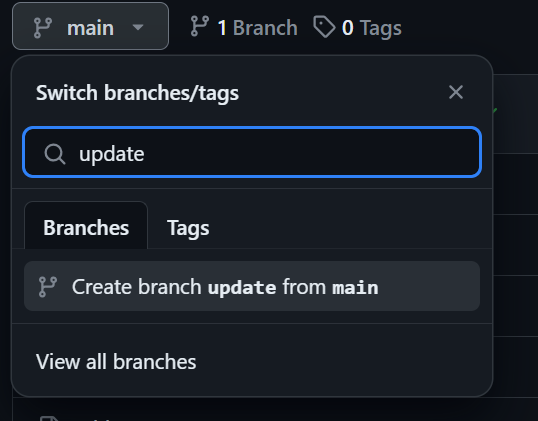
Kita menghasilkan laporan evaluasi, tetapi belum melakukan versioning model dan hasil. Untuk menyimpan perubahan, kita akan membuat branch baru bernama "update" dan mendorong model serta hasil yang diperbarui ke sana.
Buat branch "update" dengan mengklik tombol branch main, ketik "update" sebagai nama branch, lalu pilih "create branch update from main".
Untuk melakukan commit dan push perubahan menggunakan perintah Git, kita perlu memberikan username dan email. Anda dapat menambahkannya langsung, tetapi menggunakan GitHub secrets adalah opsi yang lebih baik. Ikuti langkah-langkah berikut:
Selesai!
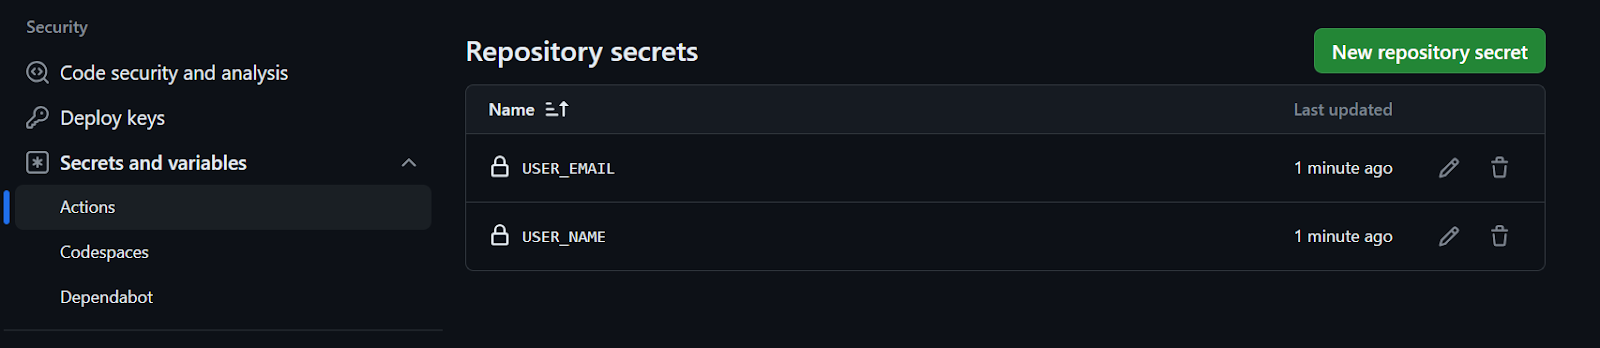
Untuk mengotomatiskan penyimpanan perubahan ke branch baru, kita harus memperbarui Makefile dan ci.yml.
Makefile:
Kita mengonfigurasi username dan email, melakukan commit perubahan, dan menyimpannya ke branch update.
update-branch:
	git config --global user.name $(USER_NAME)
	git config --global user.email $(USER_EMAIL)
	git commit -am "Update with new results"
	git push --force origin HEAD:update
ci.yml:
Makefile menggunakan variabel lingkungan untuk menjalankan skrip. Untuk itu, kita harus terlebih dahulu mengambil nilai variabel lingkungan dari secrets, lalu menetapkan variabel lingkungan di akhir perintah make.
    - name: Update Branch
        env:
          NAME: ${{ secrets.USER_NAME }}
          EMAIL: ${{ secrets.USER_EMAIL }}
        run: make update-branch USER_NAME=$NAME USER_EMAIL=$EMAIL
Setelah Anda memperbarui file dan mendorong perubahan ke branch main, Anda akan melihat proses otomatis berlangsung secara real-time. Laporan analitis akan dihasilkan, bersama model yang diperbarui yang dapat dideploy ke Hugging Face pada bagian continuous deployment.
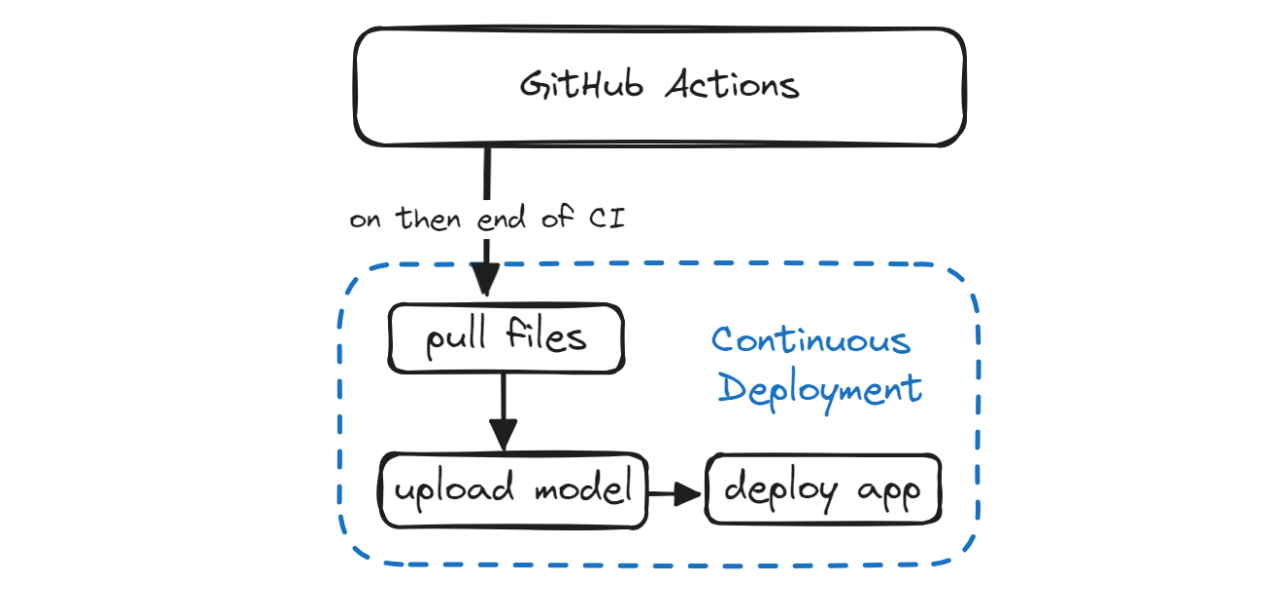
Pada bagian Continuous Deployment, kita akan mempelajari cara mengotomatiskan proses deployment model dan aplikasi. Ini mencakup menarik (pull) model dan file aplikasi yang diperbarui dari branch `update`, masuk ke Hugging Face CLI menggunakan token, mendorong file model dan aplikasi, lalu mendeploy aplikasi.
Agar dapat mendeploy model dan mengaksesnya, kita perlu membuat aplikasi Gradio. Aplikasi ini akan mencakup:
Interface Gradio dan menjalankannya.import gradio as gr
import skops.io as sio
pipe = sio.load("./Model/drug_pipeline.skops", trusted=True)
def predict_drug(age, sex, blood_pressure, cholesterol, na_to_k_ratio):
""Predict drugs based on patient features.
Args:
age (int): Age of patient
sex (str): Sex of patient
blood_pressure (str): Blood pressure level
cholesterol (str): Cholesterol level
na_to_k_ratio (float): Ratio of sodium to potassium in blood
Returns:
str: Predicted drug label
"""
features = [age, sex, blood_pressure, cholesterol, na_to_k_ratio]
predicted_drug = pipe.predict([features])[0]
label = f"Predicted Drug: {predicted_drug}"
return label
inputs = [
gr.Slider(15, 74, step=1, label="Age"),
gr.Radio(["M", "F"], label="Sex"),
gr.Radio(["HIGH", "LOW", "NORMAL"], label="Blood Pressure"),
gr.Radio(["HIGH", "NORMAL"], label="Cholesterol"),
gr.Slider(6.2, 38.2, step=0.1, label="Na_to_K"),
]
outputs = [gr.Label(num_top_classes=5)]
examples = [
[30, "M", "HIGH", "NORMAL", 15.4],
[35, "F", "LOW", "NORMAL", 8],
[50, "M", "HIGH", "HIGH", 34],
]
title = "Drug Classification"
description = "Enter the details to correctly identify Drug type?"
article = "This app is a part of the Beginner's Guide to CI/CD for Machine Learning. It teaches how to automate training, evaluation, and deployment of models to Hugging Face using GitHub Actions."
gr.Interface(
fn=predict_drug,
inputs=inputs,
outputs=outputs,
examples=examples,
title=title,
description=description,
article=article,
theme=gr.themes.Soft(),
).launch()
Buka terminal dan jalankan aplikasi secara lokal untuk memperbaiki masalah sebelum mendorong perubahan ke repositori remote.
python ./App/drug_app.py Running on local URL: http://127.0.0.1:7860
To create a public link, set `share=True` in `launch()`.Sekarang kita akan membuat token Hugging Face dan memberikannya ke skrip Makefile. Namun, kita harus memastikan token tetap rahasia dan tidak bocor ke siapa pun. Untuk mencapainya, kita akan menggunakan GitHub secrets.
Pertama, klik foto profil Hugging Face Anda dan pilih opsi settings. Selanjutnya, pilih opsi "Access Tokens" dan klik tombol "New Token" untuk membuat token. Saat membuat token, pastikan token memiliki izin tulis.
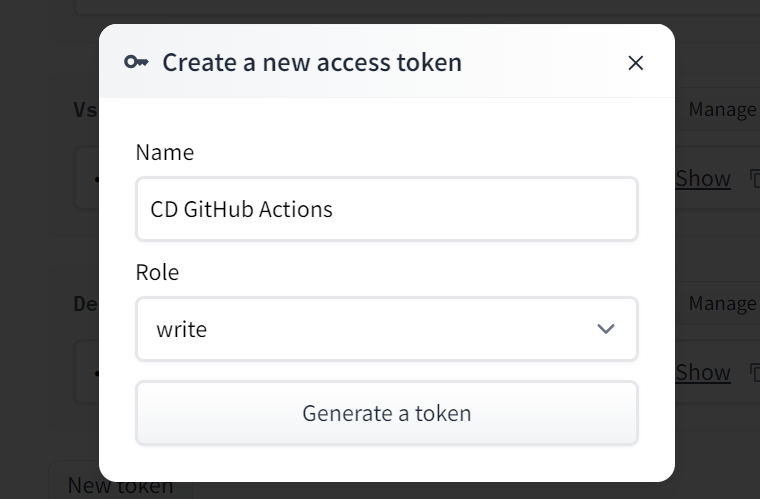
Salin tokennya dan buat Repository secret, sama seperti saat kita menambahkan nama pengguna dan email.
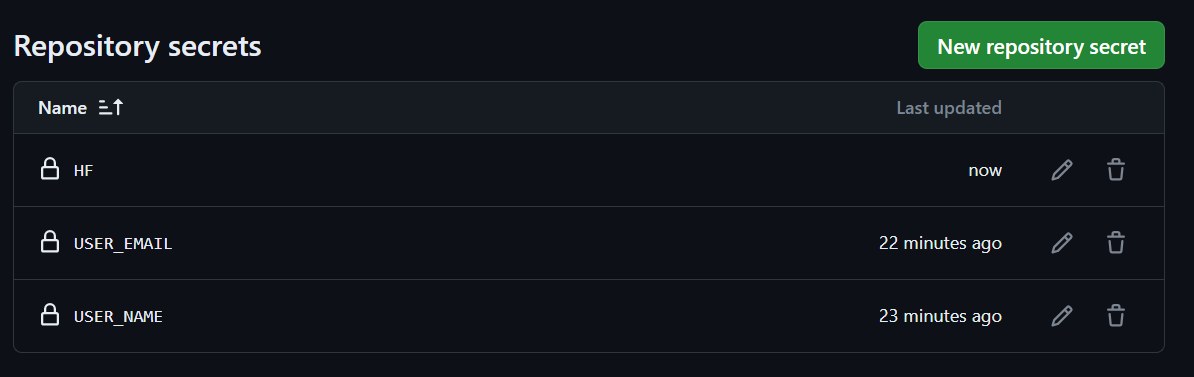
Di bagian ini, kita akan menambahkan tiga perintah baru untuk membuat file dan membuat workflow GitHub lain bernama "Continuous Deployment". Workflow ini akan membantu mengotomatiskan proses menarik dan mendeploy file.
update dan beralih ke branch update.deploy akan menjalankan hf-login terlebih dahulu lalu push-hub.hf-login:
git pull origin update
git switch update
pip install -U "huggingface_hub[cli]"
huggingface-cli login --token $(HF) --add-to-git-credential
push-hub:
huggingface-cli upload kingabzpro/Drug-Classification ./App --repo-type=space --commit-message="Sync App files"
huggingface-cli upload kingabzpro/Drug-Classification ./Model /Model --repo-type=space --commit-message="Sync Model"
huggingface-cli upload kingabzpro/Drug-Classification ./Results /Metrics --repo-type=space --commit-message="Sync Model"
deploy: hf-login push-hubAplikasi kita akan memiliki akses ke model, file aplikasi, dan hasil yang diperbarui, sehingga kita dapat melacak perubahan di Hugging Face Space.
Agar workflow kita benar-benar CI/CD, kita perlu membuat file lain bernama cd.yml yang mirip dengan file ci.yml kita. Setelah pipeline CI selesai, file ini akan memulai workflow cd.yml menggunakan argumen on dengan parameter workflow_run.
Workflow ini akan membangun lingkungan dan menjalankan perintah make deploy menggunakan token Hugging Face untuk mendeploy perubahan terbaru ke Hugging Face Hub.
name: Continuous Deployment
on:
  workflow_run:
    workflows: ["Continuous Integration"]
    types:
      - completed

  workflow_dispatch:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: Deployment To Hugging Face
        env:
          HF: ${{ secrets.HF }}
        run: make deploy HF=$HF
Saat kita mendorong perubahan ke branch main, proses akan dimulai dengan workflow CI.
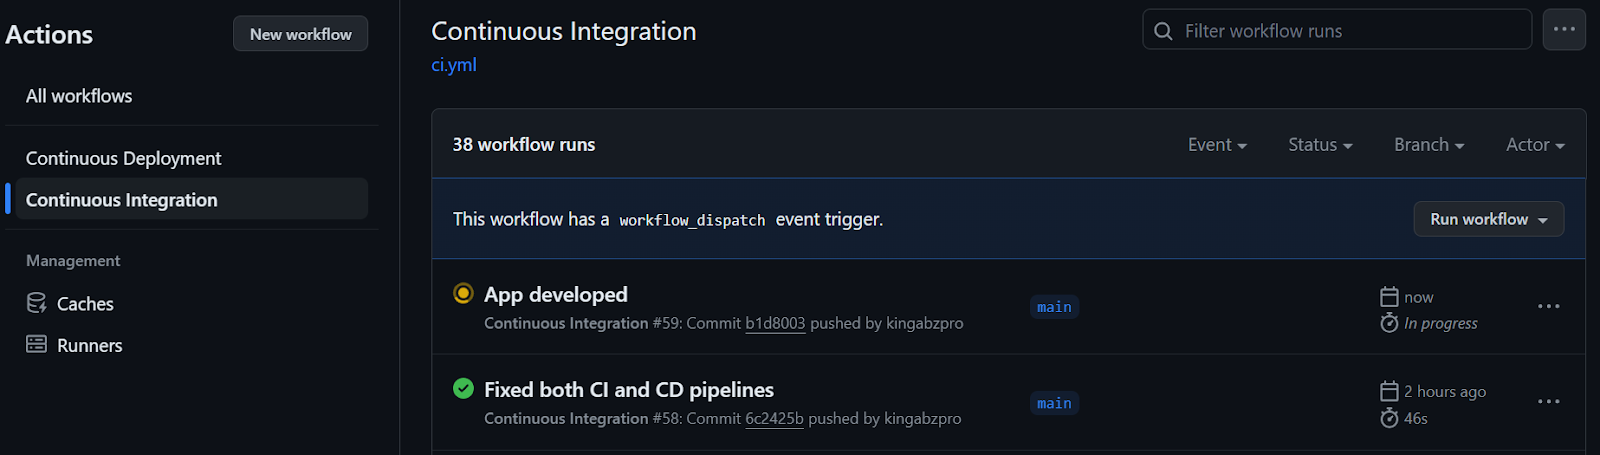
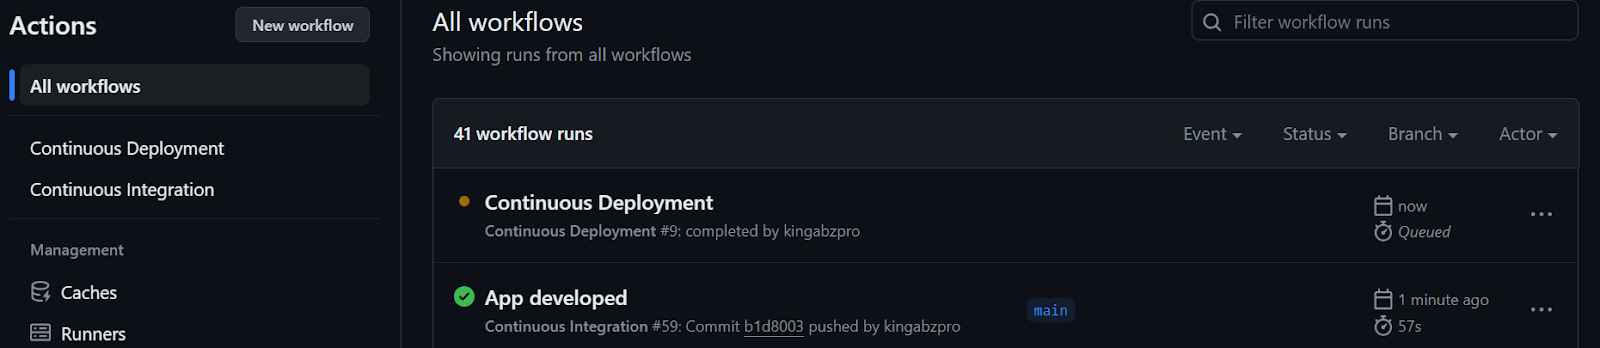
Setelah workflow CI selesai, workflow CD akan dimulai seperti di bawah ini.
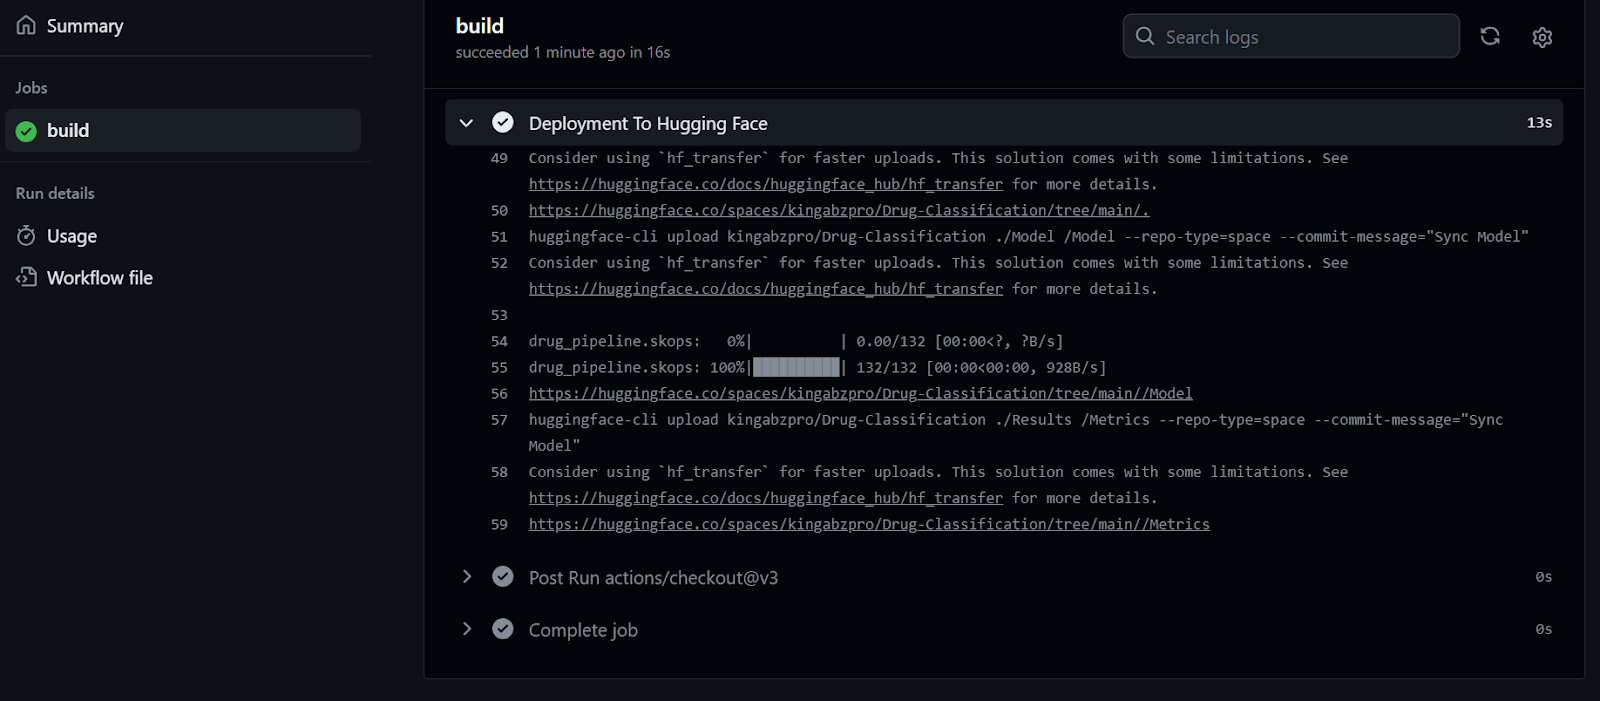
Kita dapat mengamati log langsung dari setiap fungsi dengan memilih opsi run di build workflow. File kita telah berhasil diunggah ke server Hugging Face.
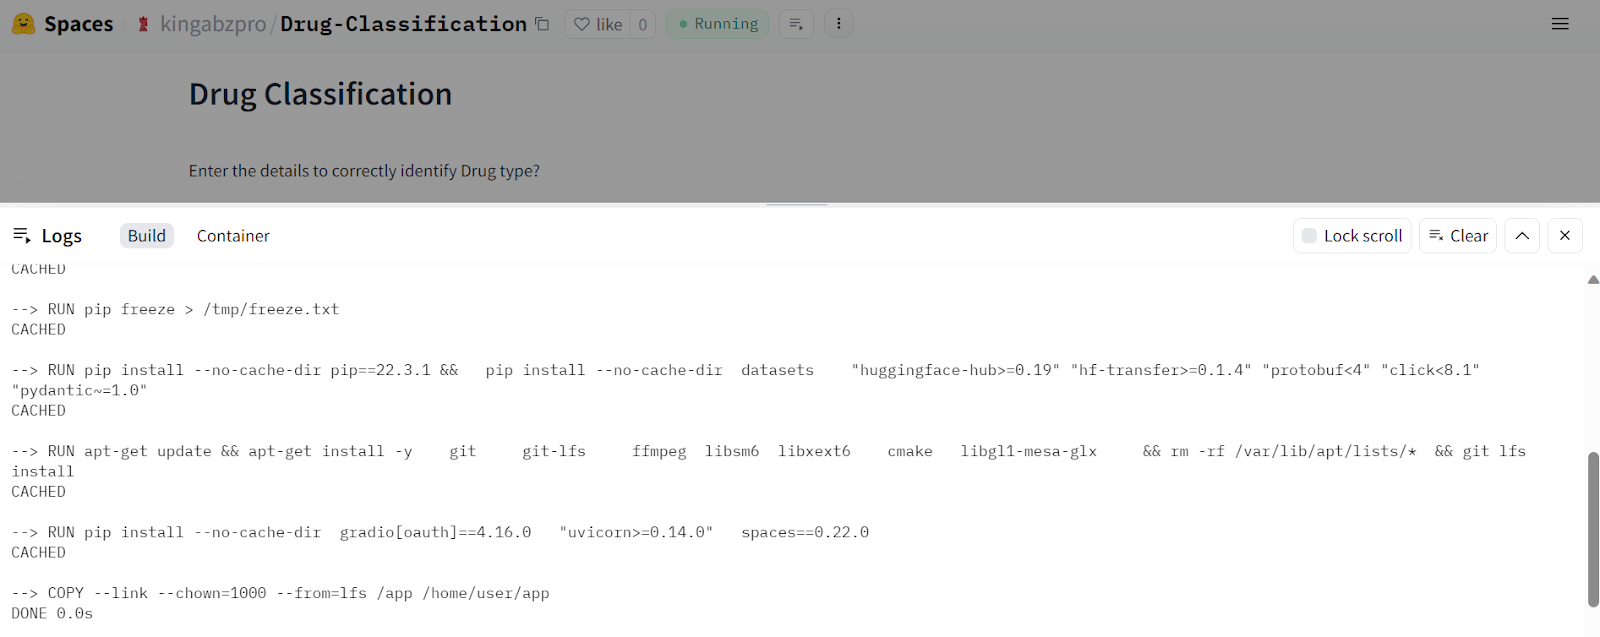
Setelah menerima file yang diperbarui, Hugging Face Space akan mulai membangun lingkungan, dan aplikasi akan berjalan dalam beberapa detik.
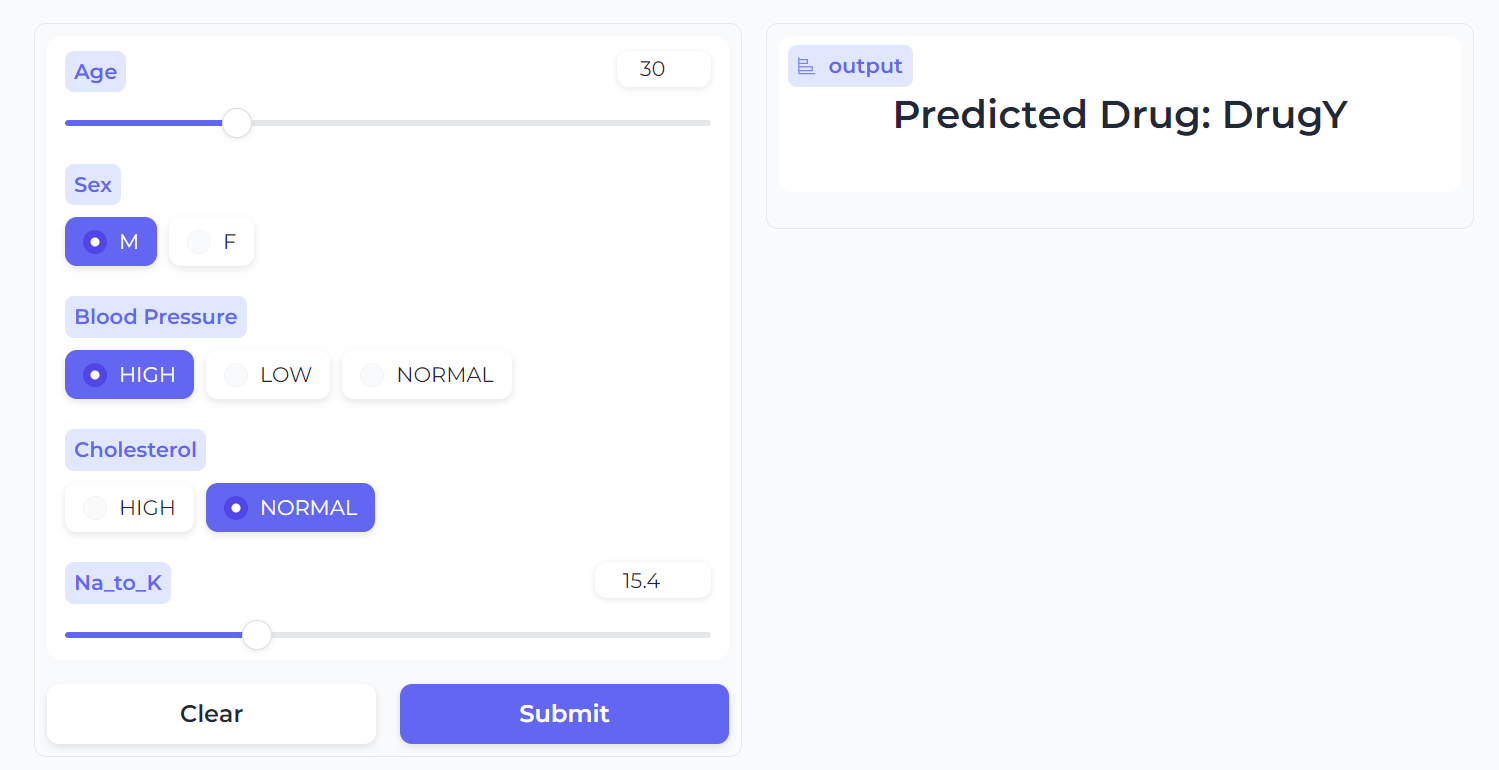
Aplikasi Drug Classification kita berjalan mulus dan memiliki antarmuka yang menarik.
Coba masukkan data yang berbeda untuk merasakan kinerja model.
Gambar Sumber
Panduan ini menguraikan bagaimana kita mengotomatiskan proses pelatihan, evaluasi, versioning, dan deployment, sehingga setiap perubahan pada data atau algoritme akan otomatis memicu proses ini tanpa error. Pendekatan ini membantu kita membangun aplikasi yang cepat, skalabel, dan siap produksi.
Harap dicatat bahwa dalam proyek dunia nyata, kita menggunakan banyak alat MLOps untuk mengorkestrasi, melakukan versioning, mendeploy, dan memantau aplikasi machine learning. Untuk mempelajari lebih lanjut tentang alat-alat ini, lihat Top MLOps Tools You Need to Know, yang menguraikan teknologi populer yang digunakan perusahaan teknologi besar untuk menyederhanakan aplikasi machine learning mereka.
Untuk mengoptimalkan pipeline CI/CD Anda, penting untuk mempelajari alat seperti Docker, Kubernetes, Azure Cloud, dan teknologi MLOps lainnya. Ikuti tutorial Machine Learning, Pipelines, Deployment, dan MLOps untuk memahami praktik standar industri dan mengerjakan proyek lanjutan.
Mulai Perjalanan Machine Learning Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt




