
Kurs
Machine Learning verstehen
2 Std.
308K
Continuous Integration (CI) und Continuous Deployment (CD) sind Praktiken aus der Softwareentwicklung, die das Integrieren von Codeänderungen, das Testen und das schnelle Ausrollen neuer Versionen automatisieren. Ursprünglich für klassische Software gedacht, sind sie inzwischen auch für Machine-Learning-(ML)-Projekte hochrelevant.
In diesem umfassenden Guide schauen wir uns CI/CD für ML an und bauen eine eigene Machine-Learning-Pipeline, die Training, Evaluation und Deployment des Modells automatisiert.
Das Beispielprojekt setzt ausschließlich auf GitHub Actions, um den gesamten Ablauf zu automatisieren. Vieles ist für ML Engineers und Data Scientists bereits vertraut. Neu ist hier vor allem der Einsatz von GitHub Actions, Makefile, CML und Hugging Face CLI.
Melde dich für den Kurs MLOps Concepts an und lerne, wie du ML-Modelle aus lokalen Notebooks in produktive Modelle überführst, die echten Business-Mehrwert liefern.
CI/CD ist ein Gamechanger, wenn es darum geht, dein Modell zu operationalisieren und in Produkte zu überführen. Ein schlanker Automatisierungsprozess sorgt für eine fehlerarme, schnelle und skalierbare Lösung für dein ML-Projekt, sodass du dich auf die Modellverbesserung statt auf Verwaltung und Deployment konzentrieren kannst.
Konkret hilft CI/CD für ML bei Folgendem:
Mit CI/CD kannst du Modelle regelmäßig und automatisch mit neuen Daten neu trainieren – deutlich effizienter, als das Retraining manuell anzustoßen.
CI-Tools führen bei jedem Commit Tests und Prüfungen aus. So findest du Bugs, Integrationsprobleme und Performanceeinbrüche des Modells frühzeitig.
CI/CD stellt sicher, dass Modelle identisch neu gebaut und trainiert werden können. Umgebungen, Modell- und Datenversionierung sowie Konfigurationen sind als Code festgehalten.
Neue Modelle lassen sich vor dem Deployment automatisiert testen. Zudem ermöglicht CI/CD durch Integration mit Monitoring-Tools ein besseres Beobachten der Modelle nach dem Ausrollen.
Neue Modellversionen oder Experimente können mit CI/CD automatisiert trainiert, getestet und deployed werden. Das beschleunigt Entwicklung und Verbesserung deiner ML-Systeme.
Wächst ein ML-Projekt in Umfang und Komplexität, wird die manuelle Verwaltung des gesamten Lifecycles unrealistisch. CI/CD-Pipelines bieten eine skalierbare Lösung für große Datenmengen, viele Modelle und heterogene Abhängigkeiten – bei hoher Effizienz und Zuverlässigkeit.
In diesem Guide richten wir Accounts und Umgebungen ein, erstellen eine CI/CD-Pipeline und optimieren den gesamten Ablauf.
Wir nutzen scikit-learn-Pipelines, um einen Random-Forest-Algorithmus zu trainieren und einen Drug-Classifier zu bauen. Nach dem Training automatisieren wir die Evaluation mit CML. Abschließend bauen und deployen wir die Web-App auf den Hugging Face Hub.
Vom Training bis zur Evaluation wird alles mit GitHub Actions automatisiert. Du musst nur den Code in dein GitHub-Repository pushen – innerhalb von zwei Minuten ist das Modell zusammen mit App, Modellartefakt und Ergebnissen auf Hugging Face aktualisiert.
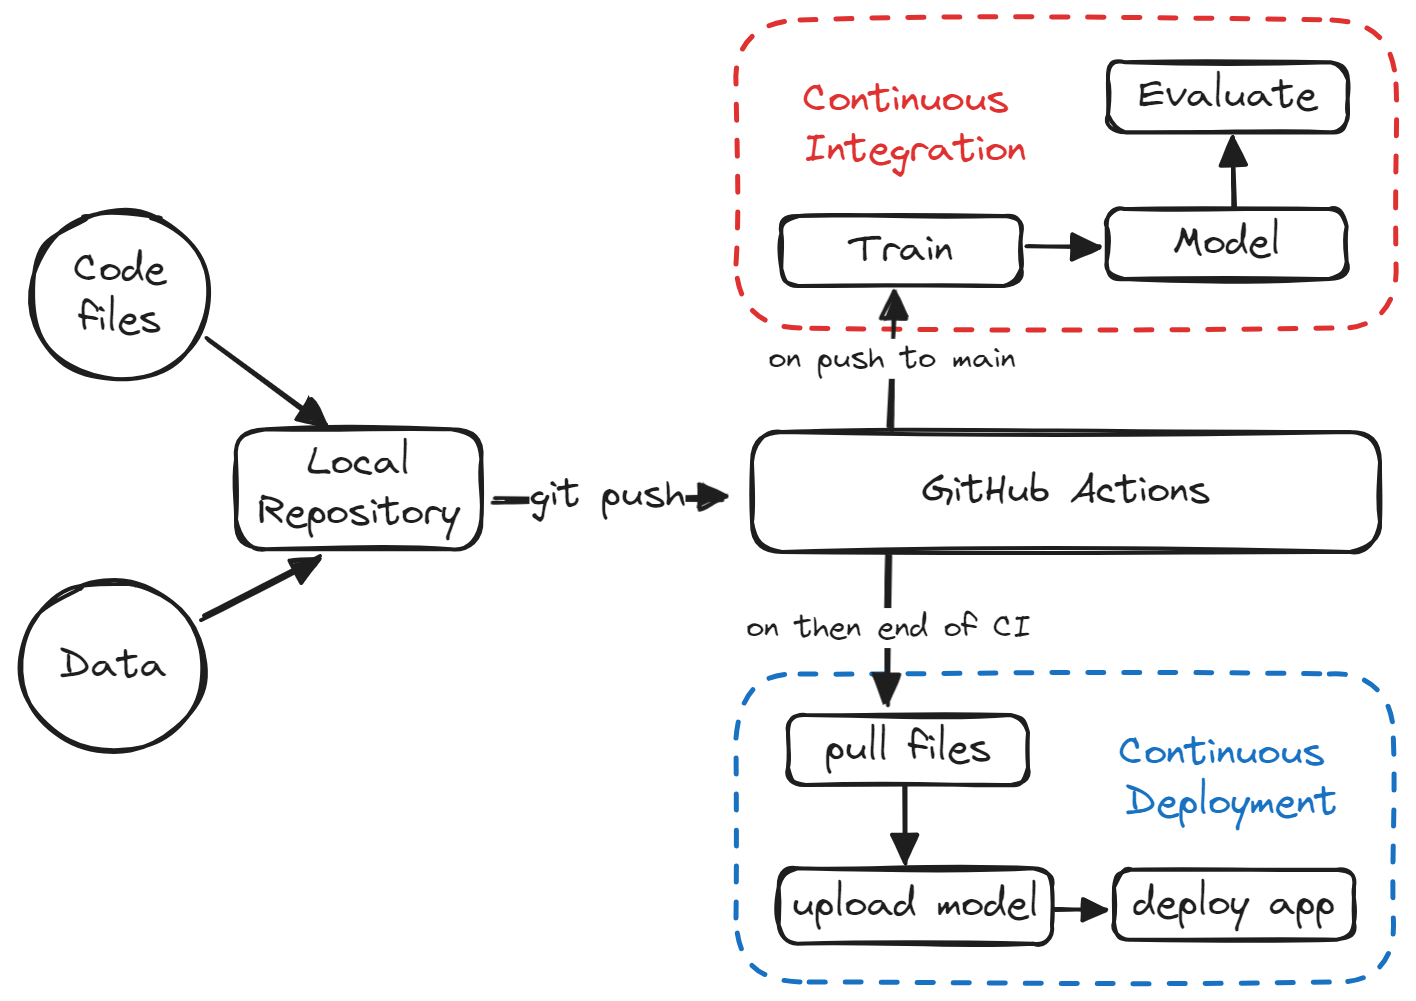
Wenn du das Ganze interaktiv üben möchtest, probiere den DataCamp-Kurs CI/CD for Machine Learning aus und bring deine ML-Entwicklung mit GitHub Actions und Datenversionierung aufs nächste Level.
In diesem Abschnitt erstellen wir ein GitHub-Repository, die benötigten Dateien und Ordner sowie einen Space in Hugging Face.
Klicke oben rechts auf GitHub auf das „+“-Symbol und wähle „New repository“.
Gib Repository-Name und Beschreibung an, aktiviere die README-Datei und setze .gitignore auf Python.
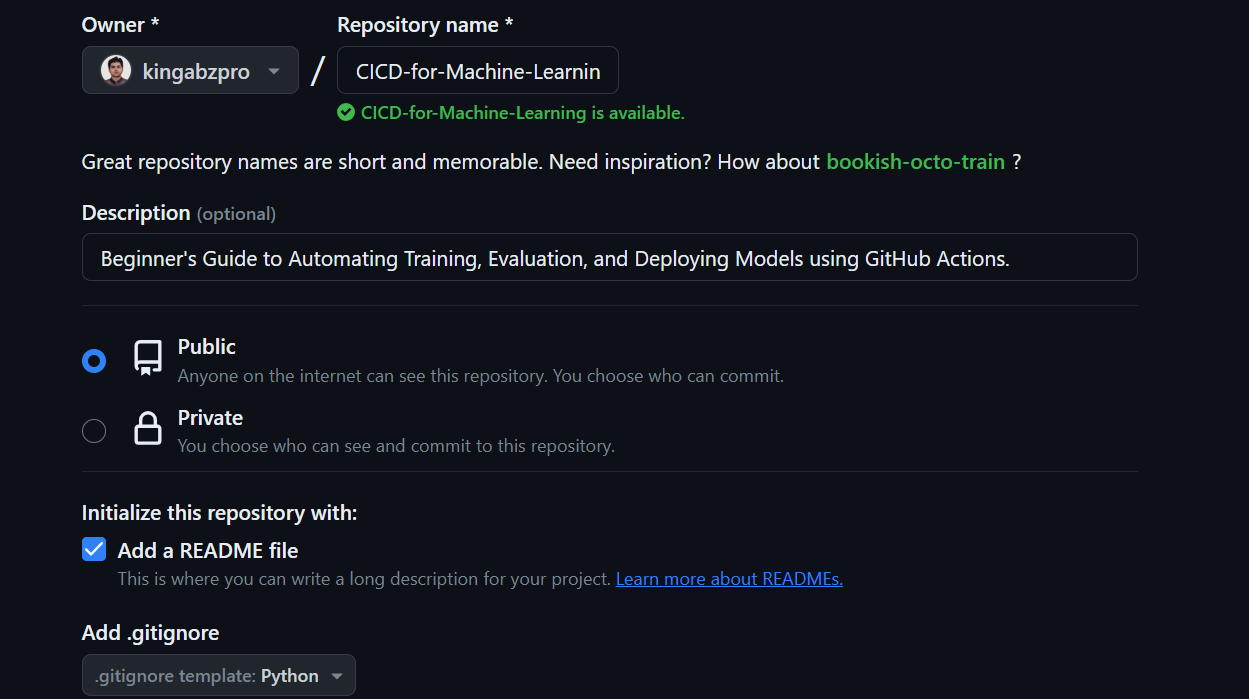
Nach dem Erstellen kopieren wir die Repo-URL. Öffne dann Terminal oder Bash und wechsle in das Verzeichnis, in dem du den Projektordner ablegen willst.
Klonen wir das Repository mit folgendem Befehl:
git clone https://github.com/kingabzpro/CICD-for-Machine-Learning.gitStarte mit deinem bevorzugten IDE und öffne das lokale Repository. Für dieses Projekt empfehlen wir VSCode. Nach dem Start siehst du einen VSCode-Workspace mit Dateien wie README und LICENSE.
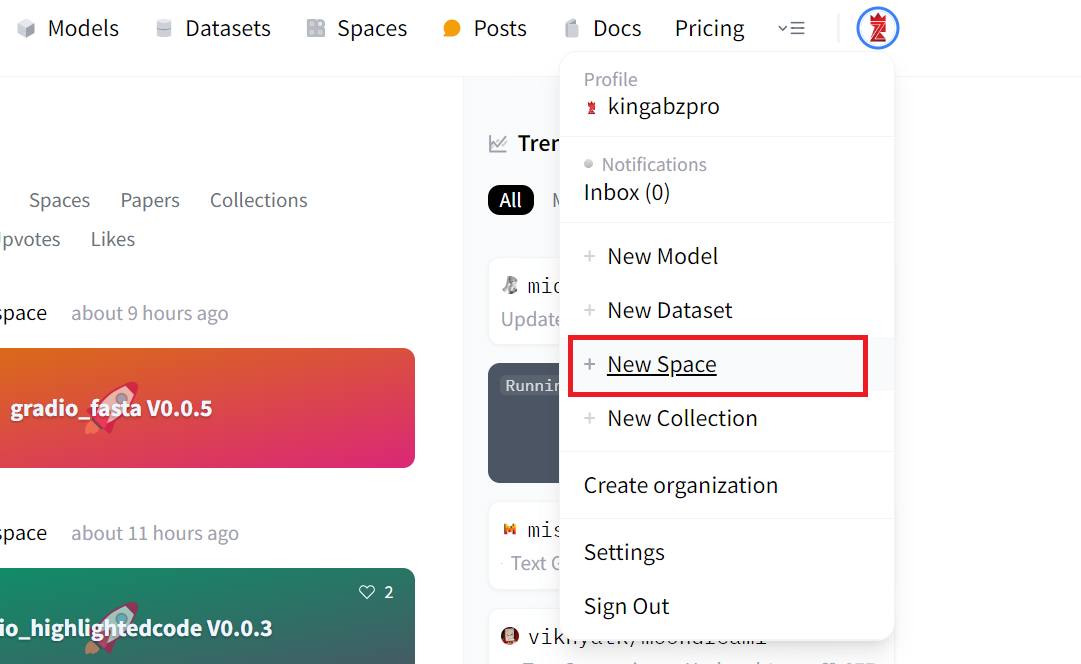
Lass uns einen Hugging Face Space erstellen, in dem wir die Anwendung samt Modelldatei deployen.
1. Klicke auf dein Profilbild und wähle "New Space".
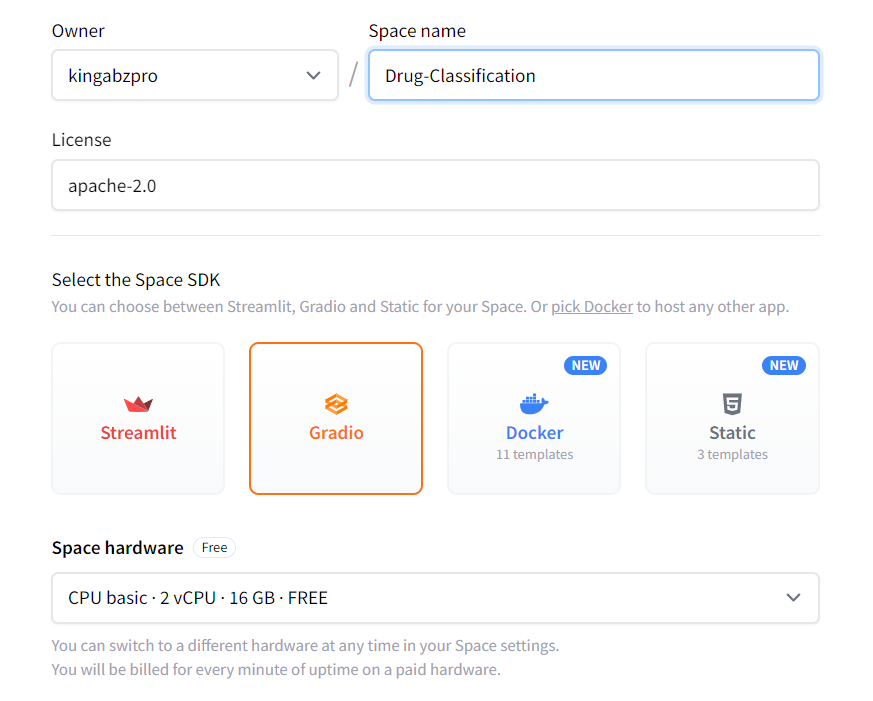
2. Vergib einen Namen für den Space, wähle eine Lizenz, lege den SDK-Typ fest und klicke auf Create Space.
3. Um die README.md zu bearbeiten, klicke oben links auf die drei Punkte, wähle Files und nimm die gewünschten Änderungen vor.
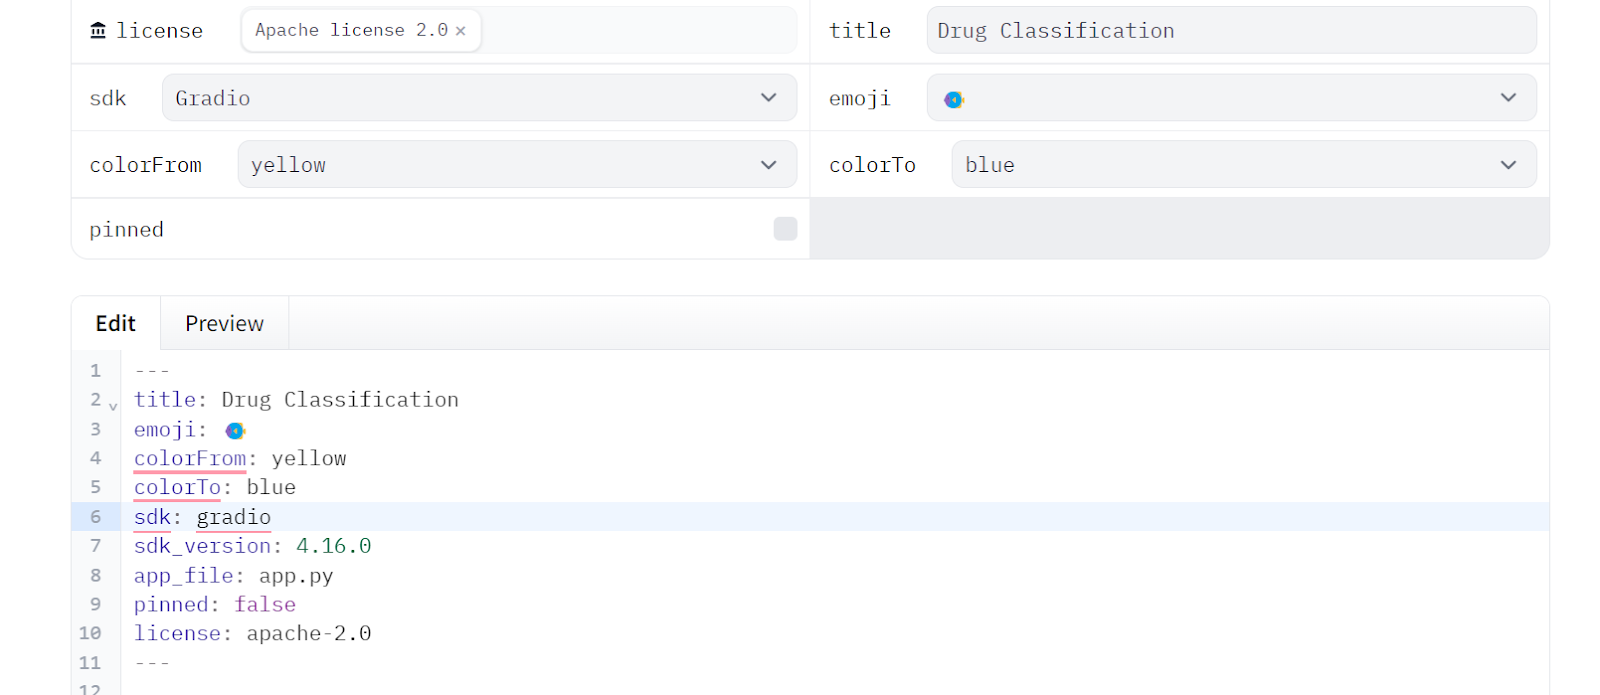
4. Kopiere die Metadaten aus der README des Space und füge sie in unsere lokale README ein, die im App-Ordner liegt.
Bevor wir mit Experimenten und dem Bau von Pipelines starten, legen wir die benötigten Ordner und Dateien an. So bleibt der Workspace langfristig aufgeräumt.
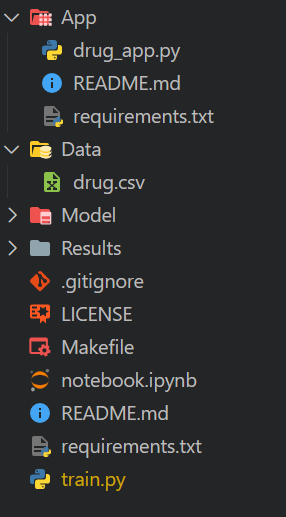
Lege eine Python-Datei namens drug_app.py an, dazu eine README.md und eine requirements.txt, und verschiebe alle drei in den App-Ordner. So strukturieren wir alles, was die App braucht.
Bearbeite anschließend die README.md im App-Ordner und passe die Metadaten-Versionierung an. So verweist du einfach auf App-Dateien, kannst Farben ändern, die SDK-Version setzen und Lizenzinfos hinterlegen.
---
title: Drug Classification
emoji: 💊
colorFrom: yellow
colorTo: red
sdk: gradio
sdk_version: 4.16.0
app_file: drug_app.py
pinned: false
license: apache-2.0
---
Bearbeite die requirement.txt im App-Ordner und trage die fehlenden Python-Pakete ein:
scikit-learn
skops
Hinweis: Die requirement- und README-Dateien unterscheiden sich zwischen GitHub-Repository und Hugging Face Space.
Lade das Drug Classification-Dataset von Kaggle herunter, entpacke die CSV und verschiebe sie in den Data-Ordner.
Die Ordner Model und Results bleiben zunächst leer und werden durch das Python-Skript befüllt.
Makefile an, um Skripte im GitHub-Actions-Workflow einfacher auszuführen.notebook.ipynb an. Darin experimentieren wir mit Algorithmen und Verarbeitungspipelines.requirements.txt an. Sie richtet die Umgebung für die CI-Jobs ein.train.py an. Darin stehen Laden und Verarbeiten der Daten sowie Training, Evaluation und Speichern von Modell und Kennzahlen.So sollte unsere Ordnerstruktur aussehen:
In diesem Abschnitt schreiben wir Python-Code, der Daten verarbeitet und mit einer scikit-learn-Pipeline ein Modell trainiert. Anschließend evaluieren wir es und speichern Ergebnisse und Modell.
Wir nutzen pandas, um die CSV zu laden, mischen die Daten mit sample und zeigen die ersten drei Zeilen an.
import pandas as pd

drug_df = pd.read_csv("Data/drug.csv")
drug_df = drug_df.sample(frac=1)
drug_df.head(3)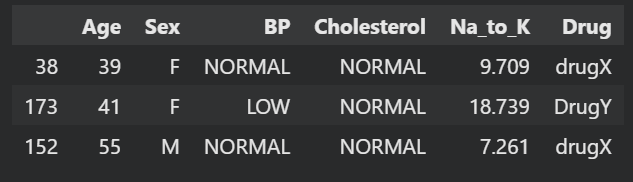
Erstelle abhängige und unabhängige Variablen und teile sie in Trainings- und Testdaten. So bewertest du die Modellleistung.
from sklearn.model_selection import train_test_split

X = drug_df.drop("Drug", axis=1).values
y = drug_df.Drug.values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=125
)Wir bauen eine Processing-Pipeline mit ColumnTransformer, die kategoriale Werte encodiert, fehlende Werte füllt und numerische Spalten skaliert.
Danach erstellen wir eine Trainingspipeline, die die transformierten Daten nutzt und einen Random-Forest-Classifier trainiert.
Zum Schluss trainieren wir das Modell.
Pipelines sorgen für Reproduzierbarkeit, Modularität und Klarheit im Code.
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OrdinalEncoder, StandardScaler

cat_col = [1,2,3]
num_col = [0,4]

transform = ColumnTransformer(
    [
        ("encoder", OrdinalEncoder(), cat_col),
        ("num_imputer", SimpleImputer(strategy="median"), num_col),
        ("num_scaler", StandardScaler(), num_col),
    ]
)
pipe = Pipeline(
    steps=[
        ("preprocessing", transform),
        ("model", RandomForestClassifier(n_estimators=100, random_state=125)),
    ]
)
pipe.fit(X_train, y_train)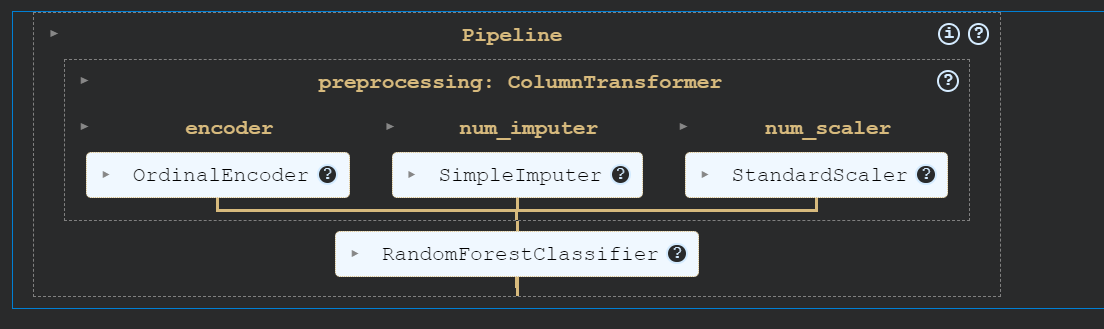
Bewerte die Modellleistung mit Accuracy und F1-Score.
from sklearn.metrics import accuracy_score, f1_score

predictions = pipe.predict(X_test)
accuracy = accuracy_score(y_test, predictions)
f1 = f1_score(y_test, predictions, average="macro")

print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))
Unser Modell hat außergewöhnlich gut abgeschnitten.
Accuracy: 95.0% F1: 0.91Erstelle die Metrikdatei und speichere sie im Results-Ordner.
with open("Results/metrics.txt", "w") as outfile:
    outfile.write(f"\nAccuracy = {accuracy.round(2)}, F1 Score = {f1.round(2)}.")
Erzeuge danach die Confusion Matrix und speichere die Grafik im Results-Ordner.
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix

cm = confusion_matrix(y_test, predictions, labels=pipe.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=pipe.classes_)
disp.plot()
plt.savefig("Results/model_results.png", dpi=120)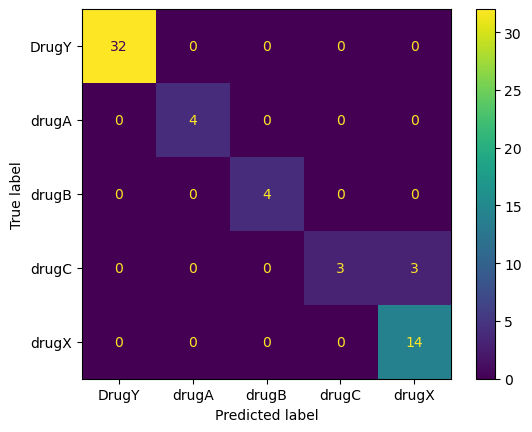
Wir speichern das Modell mit dem Python-Paket skops. So sichern wir Pipeline und Modell aus scikit-learn gemeinsam.
import skops.io as sio

sio.dump(pipe, "Model/drug_pipeline.skops")
Du kannst die gesamte Pipeline laden, ohne weitere Verarbeitungsschritte oder Codeänderungen – sie läuft direkt.
sio.load("Model/drug_pipeline.skops", trusted=True)
Kopiere den gesamten Code in die Datei „train.py“. Das ist das standardisierte Trainingsskript, das im CI-Workflow bei Änderungen an Daten oder Code läuft.
Bevor du in deine MLOps-Karriere startest, lies den MLOps Roadmap: A Complete Career Guide.
Hier behandeln wir CML, Makefile und das Einrichten von GitHub-Actions-Workflows, um Training, Evaluation und Versionierung unseres Projekts zu automatisieren.
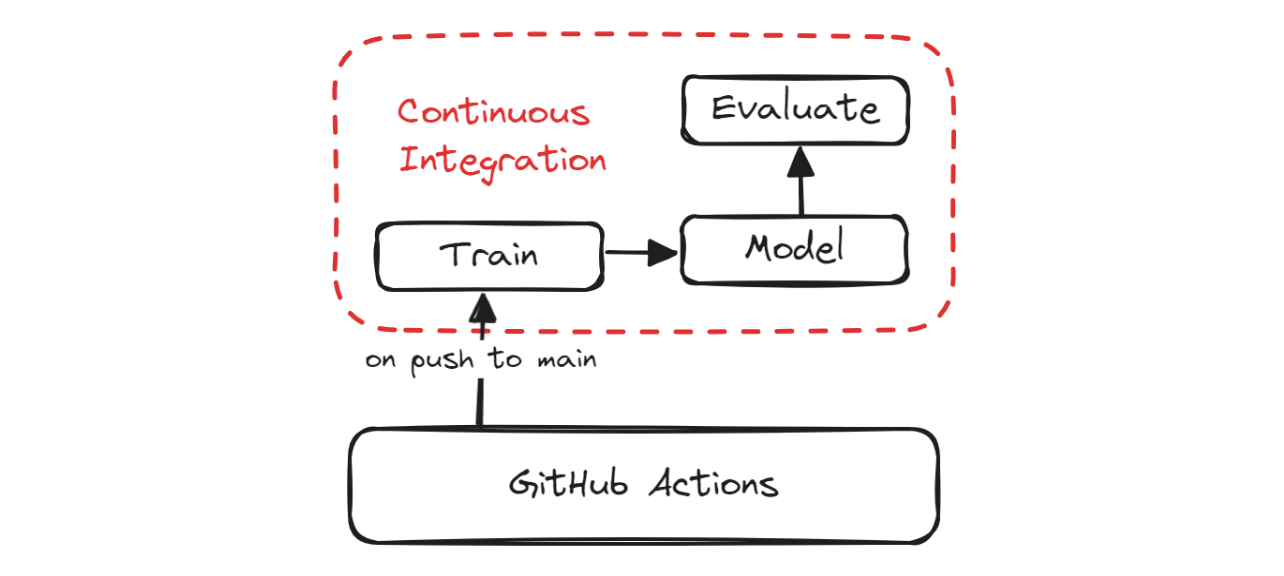
CI-Pipeline
Continuous Machine Learning (CML) ist eine Open-Source-Bibliothek, mit der du Continuous Integration in ML-Projekten umsetzen kannst. Wir verwenden die GitHub Action "iterative/setup-cml", die CML-Funktionen im Workflow nutzt, um den Modellauswertungsbericht automatisch zu erzeugen.
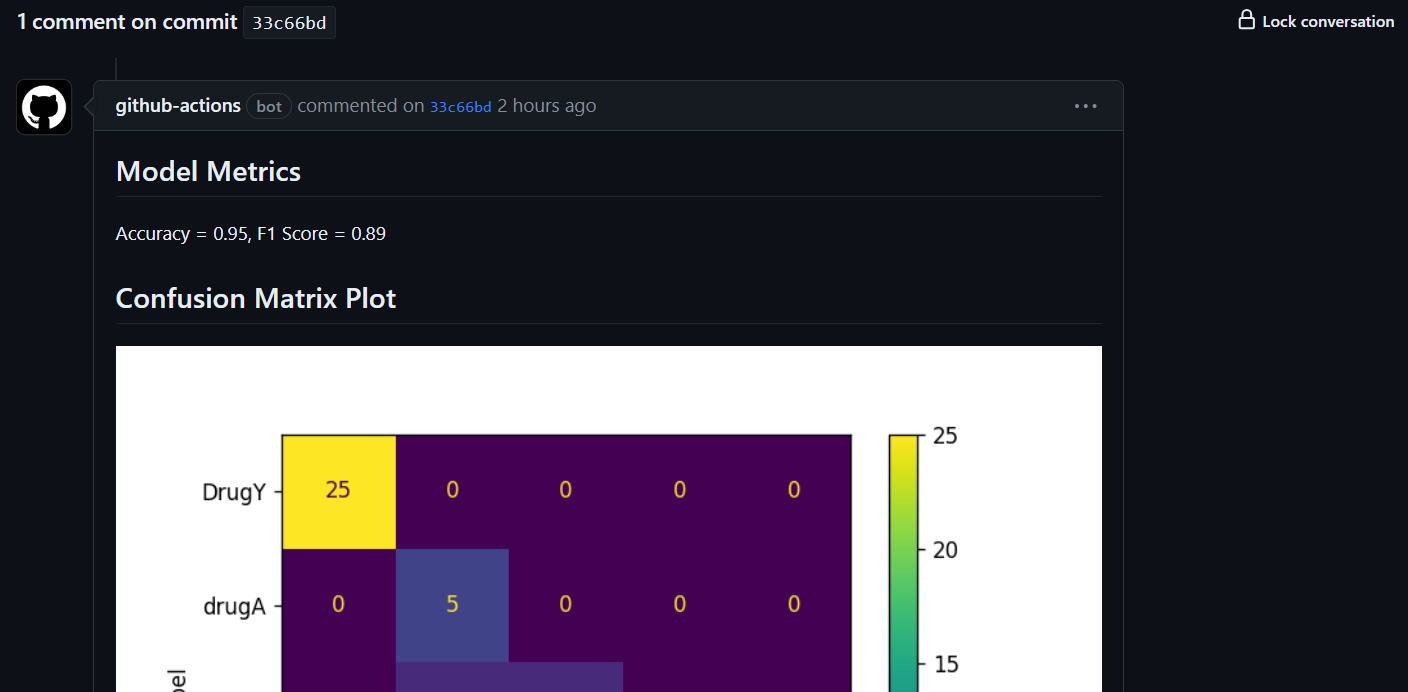
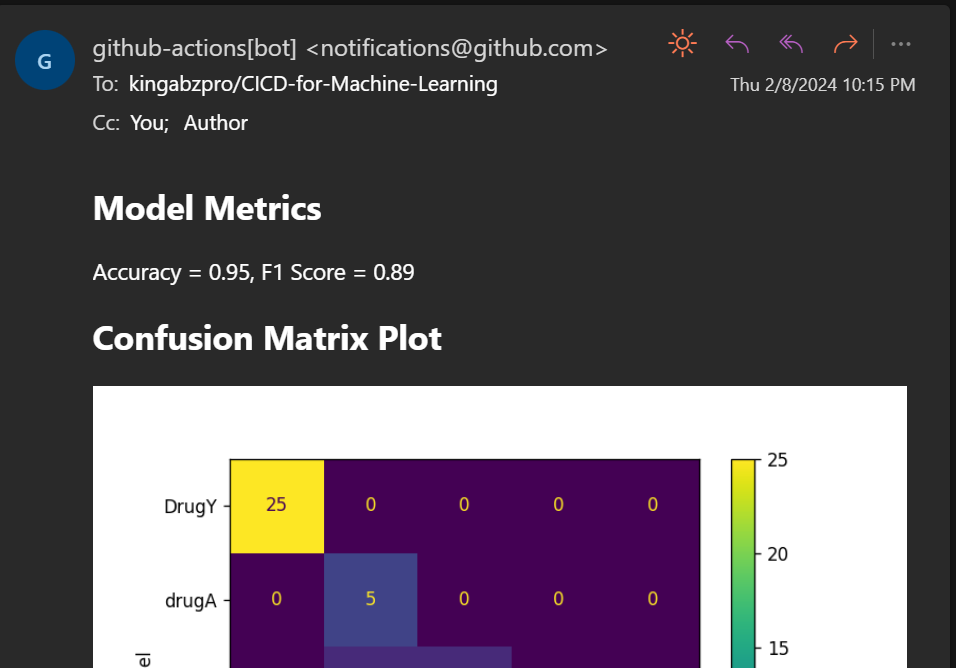
Was bedeutet das? Bei jedem Push nach GitHub wird ein Report zum Commit erzeugt und du erhältst eine E-Mail mit Performance-Kennzahlen und Confusion-Matrix.
Ein Makefile enthält Anweisungen, die der Befehl make nutzt, um Aufgaben zu automatisieren – z. B. Code kompilieren, Tests ausführen, Umgebungen einrichten, Daten vorverarbeiten, Modelle trainieren und evaluieren oder deployen.
Mit make-Kommandos lassen sich mehrere Skripte bündeln – der CI-Workflow bleibt so übersichtlich. Das Makefile enthält jeweils den Namen und die Befehle für deren Ausführung.
Hier ist unser Makefile:
install:
pip install --upgrade pip &&\
pip install -r requirements.txt
format:
black *.py
train:
python train.py
eval:
echo "## Model Metrics" > report.md
cat ./Results/metrics.txt >> report.md
echo '\n## Confusion Matrix Plot' >> report.md
echo '' >> report.md
cml comment create report.mdWir haben Kommandos, um Python-Pakete zu installieren (install), Code zu formatieren (format), Trainingsskripte auszuführen (train) und CML-Reports zu erzeugen (eval).
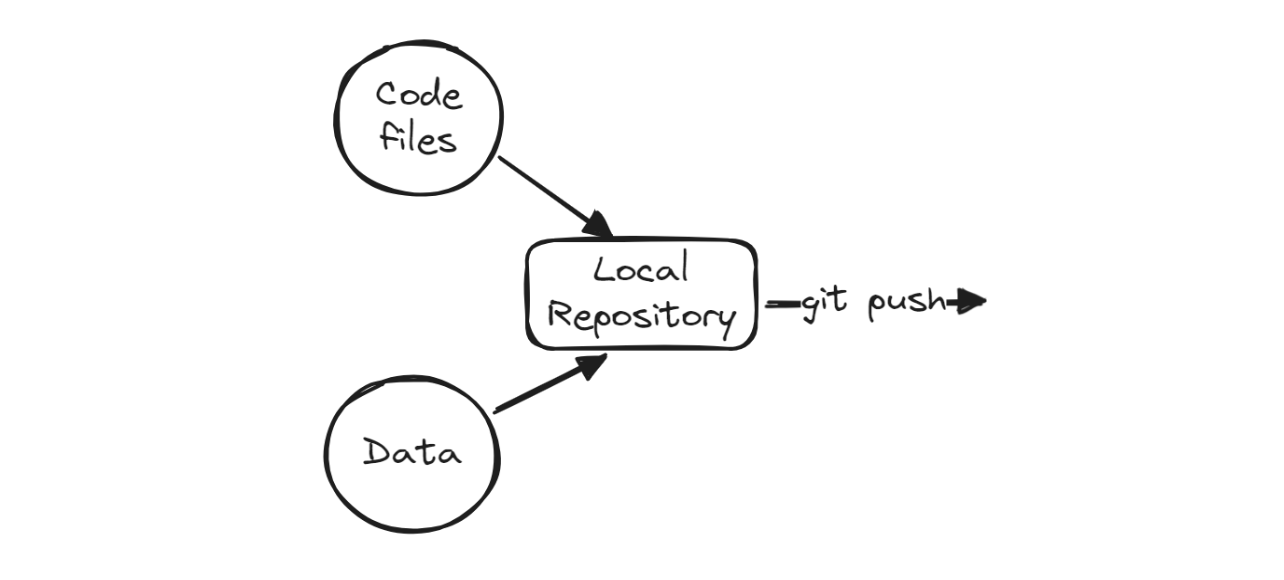
Danach fügen wir die Änderungen hinzu, erstellen einen Commit und pushen auf den GitHub-Remote.
git commit -am "new changes"
git push origin mainUm Training und Evaluation zu automatisieren, erstellen wir einen GitHub-Actions-Workflow. Gehe dazu im Repository kingabzpro/CICD-for-Machine-Learning auf den Tab „Actions“ und klicke auf den blauen Text „set up a workflow yourself.“
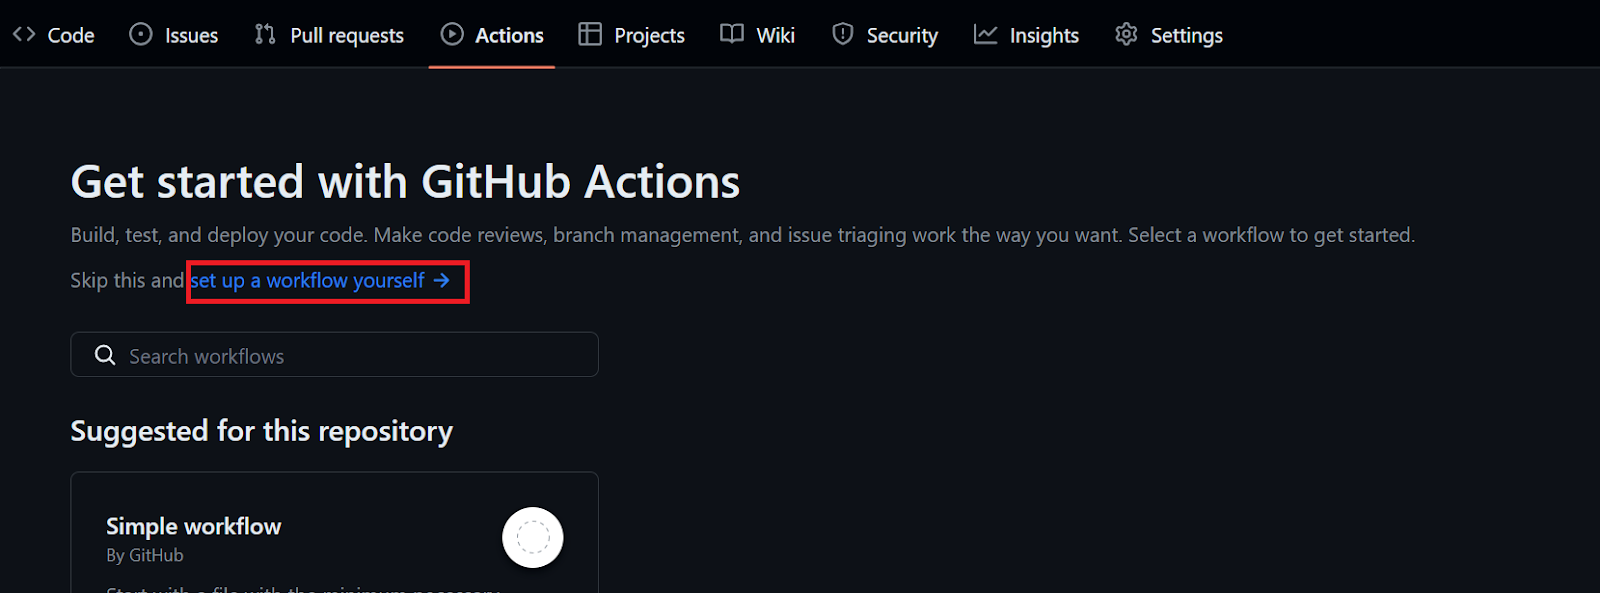
Benenne die .yml-Datei in „ci“ um und fange an, die Actions zu definieren.
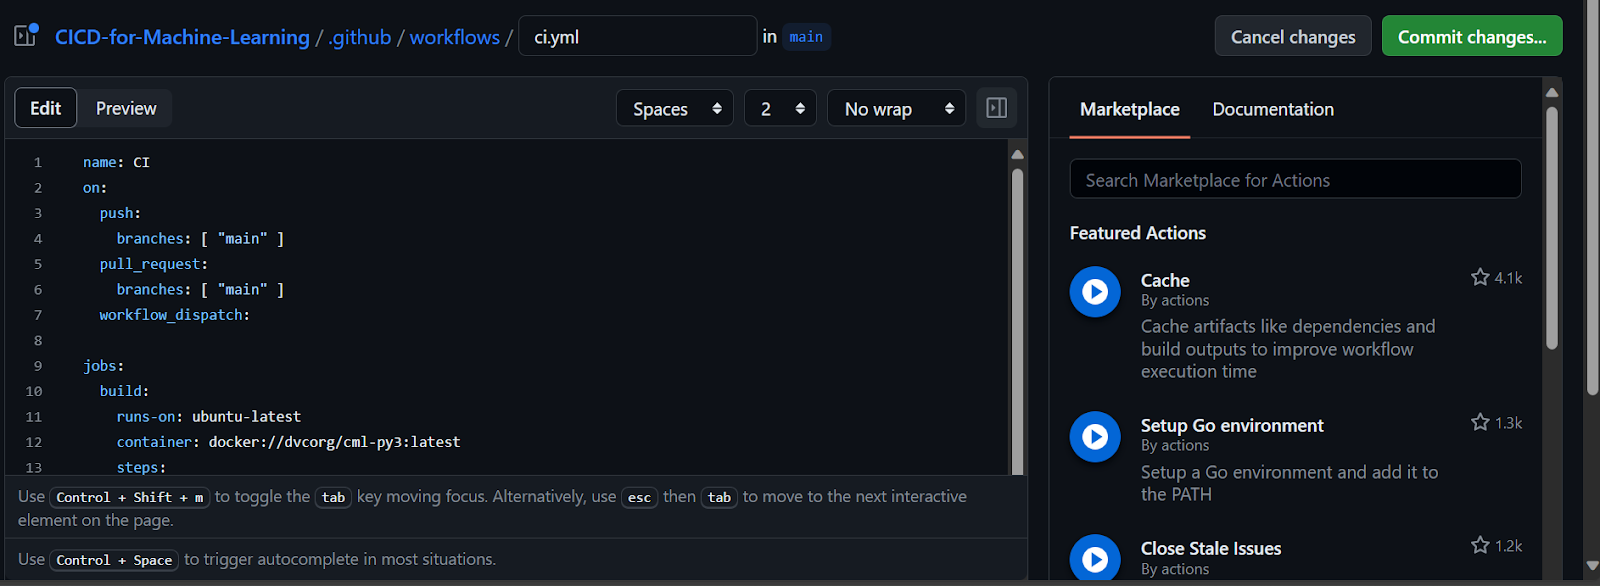
Du wirst anfangs auf Fehler und Syntaxprobleme stoßen. Deshalb lohnt sich ein Blick in die Workflow-Syntax für GitHub Actions, bevor du loslegst.
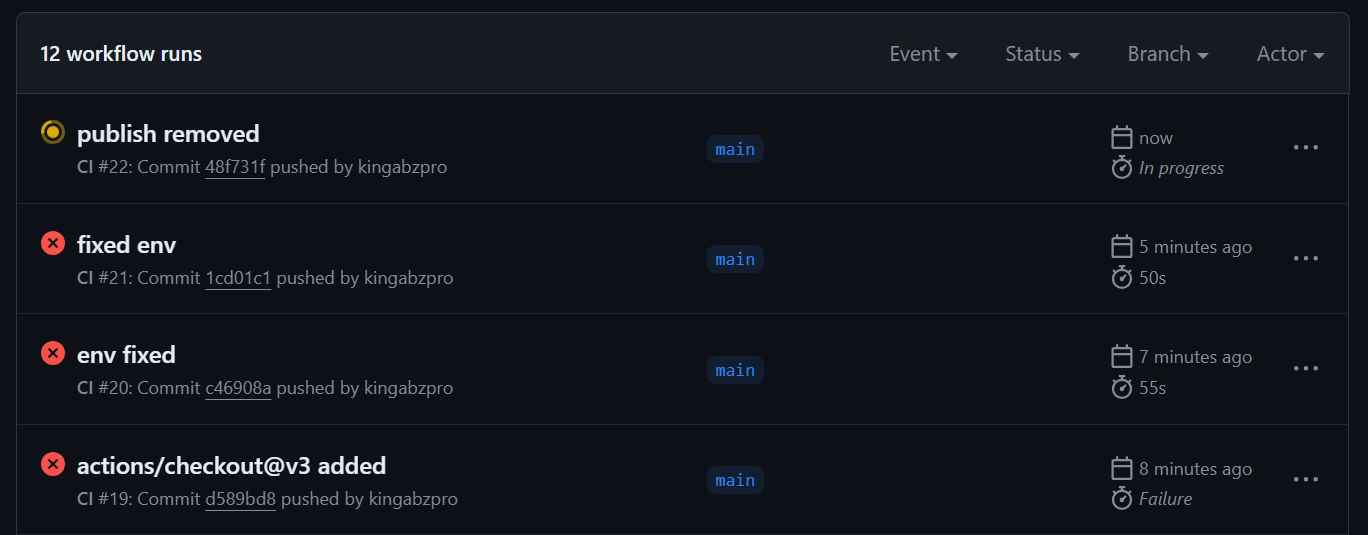
Wir haben alle Fehler im Workflow behoben und die finale Version der Datei `ci.yml`, die reibungslos läuft.
Wie du siehst, richtet der Workflow zuerst die Umgebung ein und lädt die benötigten Actions. Anschließend laufen die Schritte der Reihe nach per make-Befehl, der im Hintergrund Python- und Bash-Skripte startet.
Zwei Punkte sind bei CML-Actions wichtig: Erstens braucht es zu Beginn Schreibrechte. Zweitens muss dem CML-Job ein GitHub-Token über Secrets bereitgestellt werden.
name: Continuous Integration
on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]
  workflow_dispatch:

permissions: write-all
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v2
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Train
        run: make train
      - name: Evaluation
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
        run: make eval
Metriken und Ergebnisse erscheinen unter der Commit-Message.
Außerdem bekommst du die Ergebnisse per E-Mail.
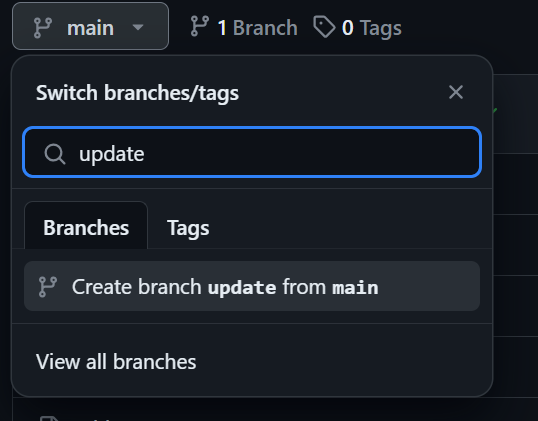
Wir erzeugen zwar den Evaluationsbericht, versionieren aber Modell und Ergebnisse noch nicht. Dafür erstellen wir einen neuen Branch namens „update“ und pushen das aktualisierte Modell und die Resultate dorthin.
Erstelle den Branch „update“, indem du auf den main-Branch klickst, „update“ als Namen eingibst und „create branch update from main“ auswählst.
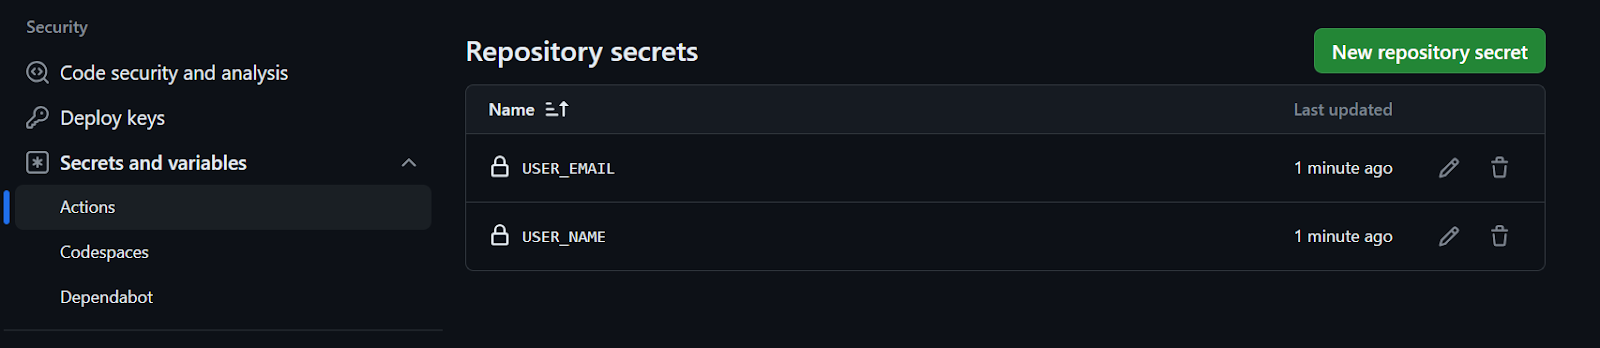
Um per Git-Command zu committen und zu pushen, benötigen wir Username und E-Mail. Du kannst sie direkt setzen, sauberer ist es aber über GitHub Secrets. So gehst du vor:
Das war's!
Um das Speichern der Änderungen im neuen Branch zu automatisieren, passen wir Makefile und ci.yml an.
Makefile:
Wir konfigurieren Username und E-Mail, committen die Änderungen und pushen sie in den Branch update.
update-branch:
	git config --global user.name $(USER_NAME)
	git config --global user.email $(USER_EMAIL)
	git commit -am "Update with new results"
	git push --force origin HEAD:update
ci.yml:
Das Makefile nutzt Umgebungsvariablen. Dafür lesen wir die Werte aus den Secrets aus und übergeben sie am Ende an den make-Befehl.
    - name: Update Branch
        env:
          NAME: ${{ secrets.USER_NAME }}
          EMAIL: ${{ secrets.USER_EMAIL }}
        run: make update-branch USER_NAME=$NAME USER_EMAIL=$EMAIL
Sobald die Dateien aktualisiert und in den main-Branch gepusht sind, siehst du die Magie in Echtzeit: Ein Analysebericht wird erzeugt und ein aktualisiertes Modell steht bereit – für das Deployment zu Hugging Face im Continuous-Deployment-Teil.
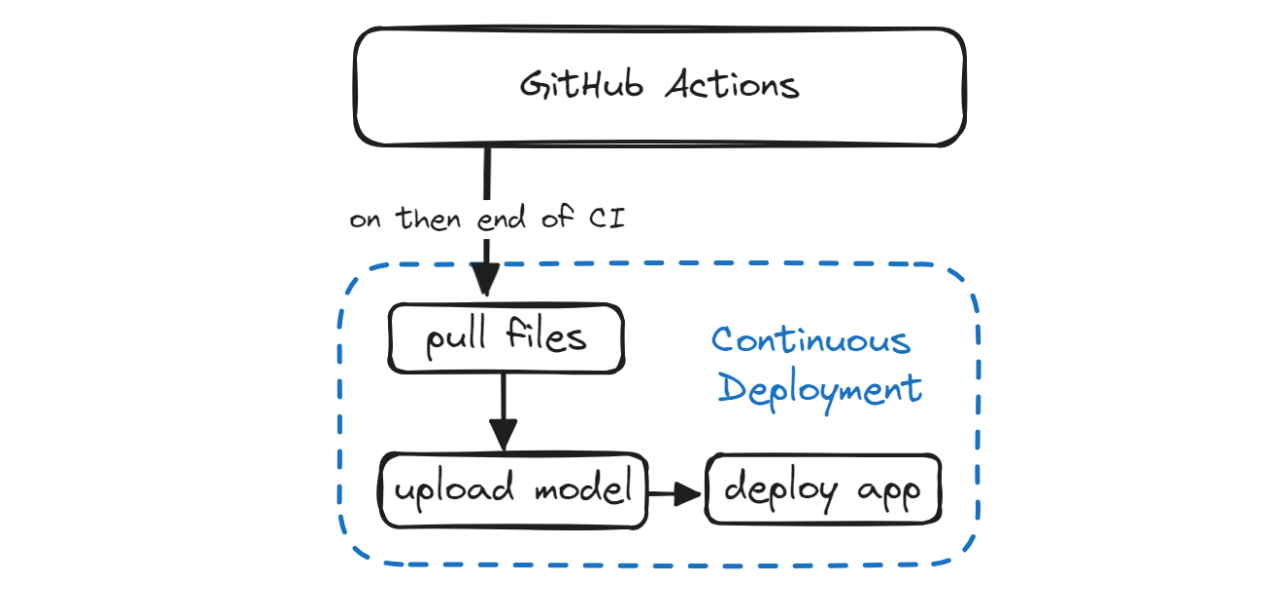
Im Abschnitt Continuous Deployment automatisieren wir das Deployment von Modell und Anwendung. Dazu ziehen wir das aktualisierte Modell und die App-Dateien aus dem Branch `update`, melden uns mit Token bei der Hugging Face CLI an, pushen Modell und App-Dateien und deployen die Anwendung.
Um das Modell zu deployen und zugänglich zu machen, erstellen wir eine Gradio-App. Diese umfasst:
Interface-Funktion und starten die App.import gradio as gr
import skops.io as sio
pipe = sio.load("./Model/drug_pipeline.skops", trusted=True)
def predict_drug(age, sex, blood_pressure, cholesterol, na_to_k_ratio):
""Predict drugs based on patient features.
Args:
age (int): Age of patient
sex (str): Sex of patient
blood_pressure (str): Blood pressure level
cholesterol (str): Cholesterol level
na_to_k_ratio (float): Ratio of sodium to potassium in blood
Returns:
str: Predicted drug label
"""
features = [age, sex, blood_pressure, cholesterol, na_to_k_ratio]
predicted_drug = pipe.predict([features])[0]
label = f"Predicted Drug: {predicted_drug}"
return label
inputs = [
gr.Slider(15, 74, step=1, label="Age"),
gr.Radio(["M", "F"], label="Sex"),
gr.Radio(["HIGH", "LOW", "NORMAL"], label="Blood Pressure"),
gr.Radio(["HIGH", "NORMAL"], label="Cholesterol"),
gr.Slider(6.2, 38.2, step=0.1, label="Na_to_K"),
]
outputs = [gr.Label(num_top_classes=5)]
examples = [
[30, "M", "HIGH", "NORMAL", 15.4],
[35, "F", "LOW", "NORMAL", 8],
[50, "M", "HIGH", "HIGH", 34],
]
title = "Drug Classification"
description = "Enter the details to correctly identify Drug type?"
article = "This app is a part of the Beginner's Guide to CI/CD for Machine Learning. It teaches how to automate training, evaluation, and deployment of models to Hugging Face using GitHub Actions."
gr.Interface(
fn=predict_drug,
inputs=inputs,
outputs=outputs,
examples=examples,
title=title,
description=description,
article=article,
theme=gr.themes.Soft(),
).launch()
Öffne das Terminal und starte die App lokal, um Probleme zu beheben, bevor du in das Remote-Repository pushst.
python ./App/drug_app.py Running on local URL: http://127.0.0.1:7860
To create a public link, set `share=True` in `launch()`.Wir generieren nun den Hugging-Face-Token und stellen ihn unserem Makefile-Skript bereit. Achte darauf, dass der Token vertraulich bleibt und nicht in falsche Hände gerät. Dafür nutzen wir GitHub Secrets.
Klicke zuerst auf dein Profilbild bei Hugging Face und wähle Settings. Gehe zu „Access Tokens“ und klicke auf „New Token“, um den Token zu erzeugen. Achte darauf, dass er Schreibrechte hat.
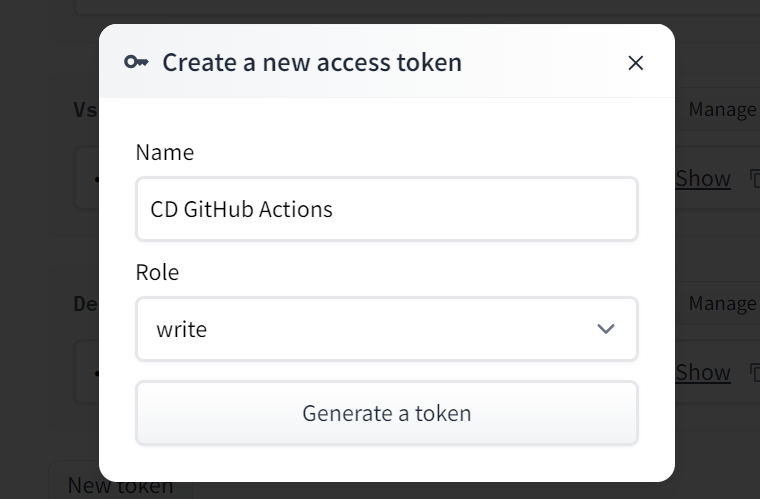
Kopiere den Token und lege – wie zuvor für Username und E-Mail – ein Repository Secret an.
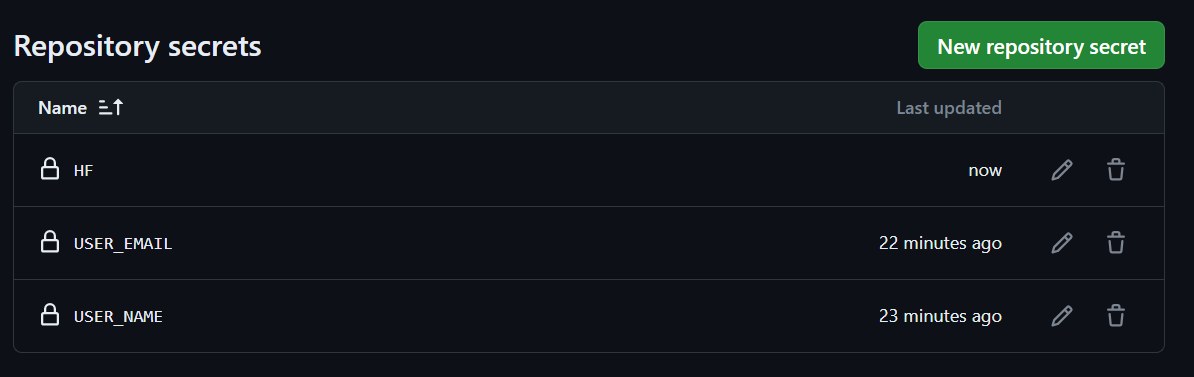
In diesem Abschnitt fügen wir drei neue Kommandos hinzu und erstellen einen weiteren GitHub-Workflow namens „Continuous Deployment“. Dieser Workflow automatisiert das Pullen und Deployen der Dateien.
update und wechsle in den update-Branch.deploy ruft zuerst hf-login und danach push-hub auf.hf-login:
git pull origin update
git switch update
pip install -U "huggingface_hub[cli]"
huggingface-cli login --token $(HF) --add-to-git-credential
push-hub:
huggingface-cli upload kingabzpro/Drug-Classification ./App --repo-type=space --commit-message="Sync App files"
huggingface-cli upload kingabzpro/Drug-Classification ./Model /Model --repo-type=space --commit-message="Sync Model"
huggingface-cli upload kingabzpro/Drug-Classification ./Results /Metrics --repo-type=space --commit-message="Sync Model"
deploy: hf-login push-hubUnsere Anwendung hat damit Zugriff auf ein aktualisiertes Modell, die App-Datei und Ergebnisse – Änderungen lassen sich im Hugging-Face-Space nachverfolgen.
Damit der Workflow wirklich CI/CD ist, erstellen wir zusätzlich eine Datei cd.yml, ähnlich zu ci.yml. Sobald die CI-Pipeline abgeschlossen ist, startet sie über das on-Argument mit workflow_run die cd.yml.
Dieser Workflow baut die Umgebung und führt per Hugging-Face-Token den Befehl make deploy aus, um die neuesten Änderungen auf den Hugging Face Hub zu deployen.
name: Continuous Deployment
on:
  workflow_run:
    workflows: ["Continuous Integration"]
    types:
      - completed

  workflow_dispatch:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: Deployment To Hugging Face
        env:
          HF: ${{ secrets.HF }}
        run: make deploy HF=$HF
Wenn wir die Änderungen in den main-Branch pushen, startet zuerst der CI-Workflow.
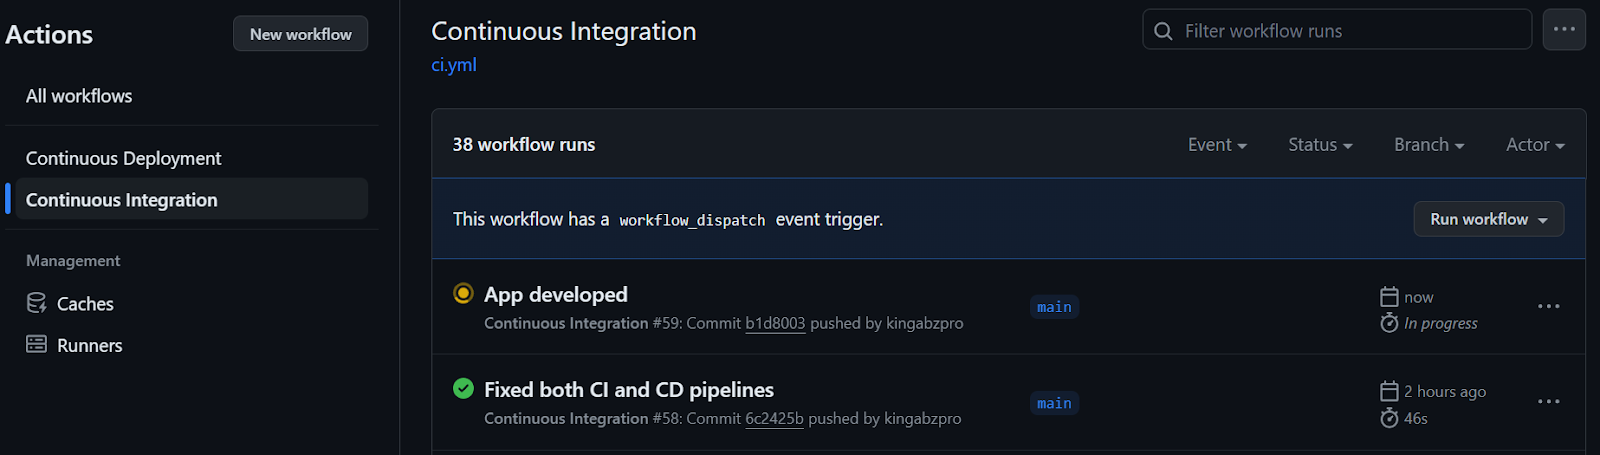
Nach Abschluss der CI-Pipeline beginnt der CD-Workflow, wie unten gezeigt.
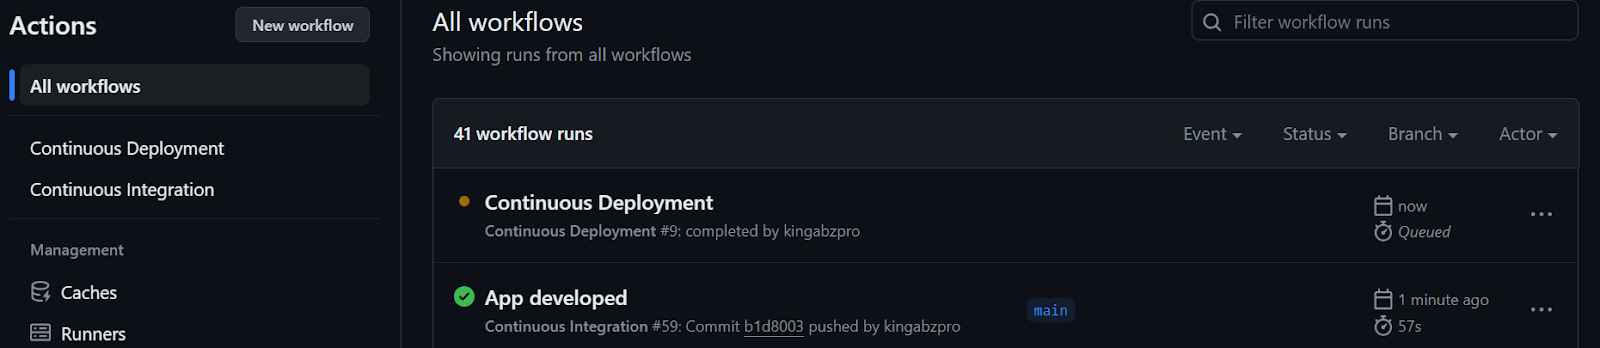
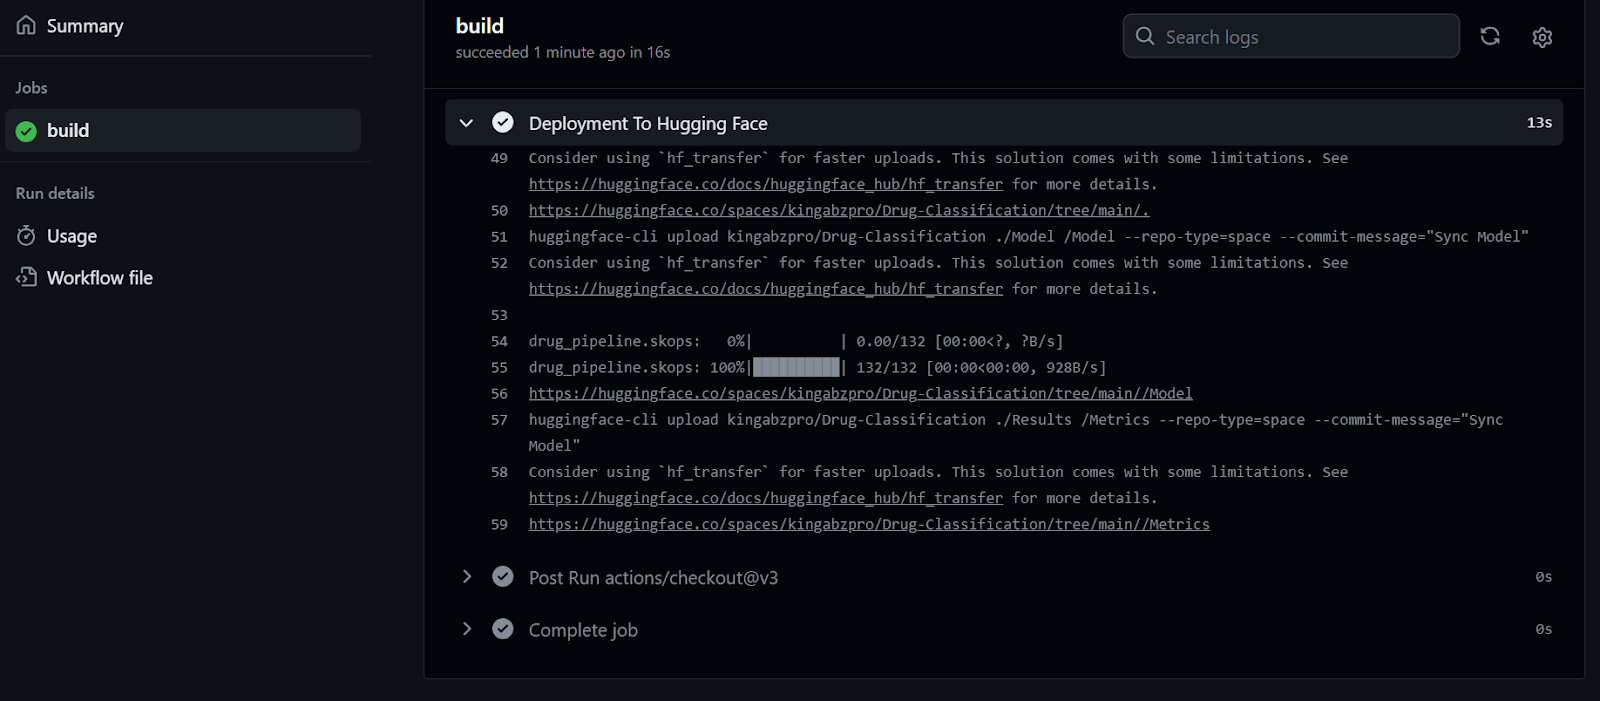
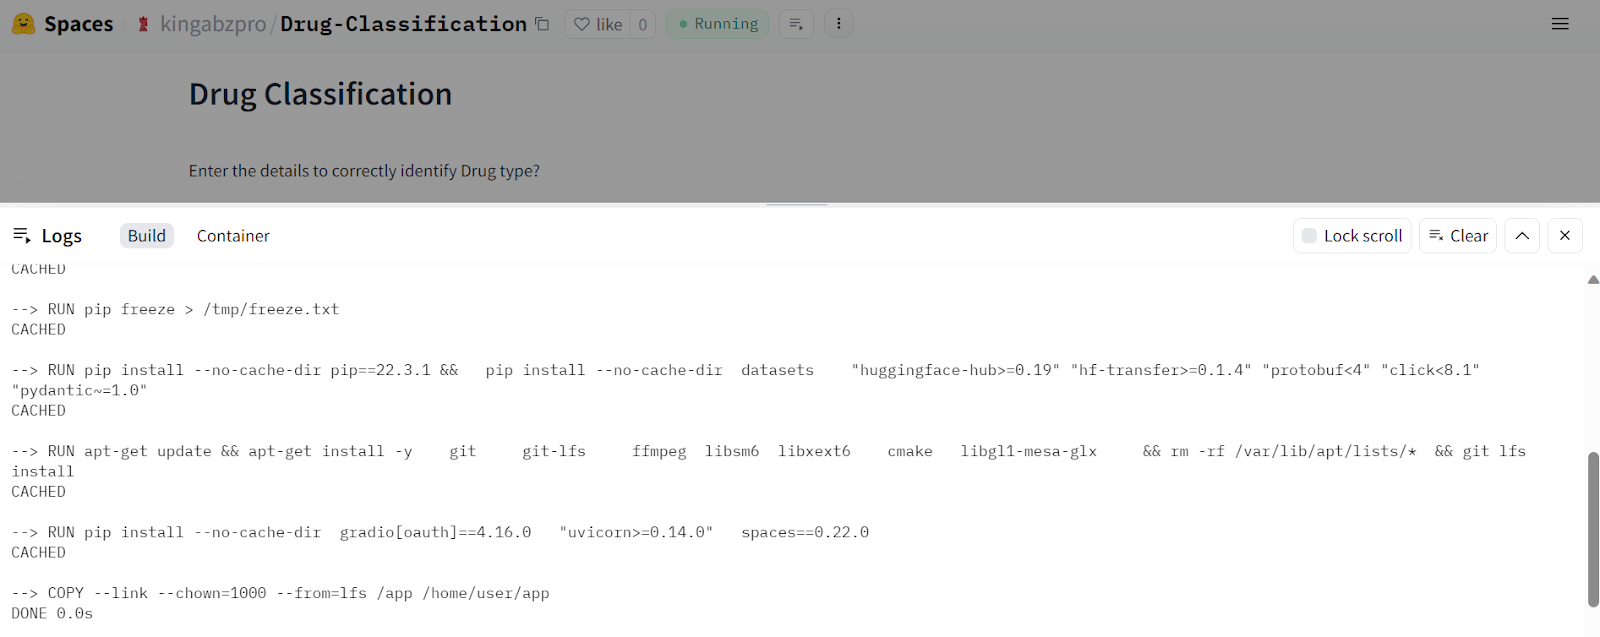
In den Live-Logs siehst du jeden Schritt der Ausführung. Unsere Dateien wurden erfolgreich auf den Hugging-Face-Server hochgeladen.
Nach Erhalt der aktualisierten Dateien baut der Hugging-Face-Space die Umgebung, und die App startet nach wenigen Sekunden.
Unsere Anwendung Drug Classification läuft nahtlos und bietet ein ansprechendes Interface.
Probiere unterschiedliche Eingaben aus und überzeuge dich von der Modellleistung.
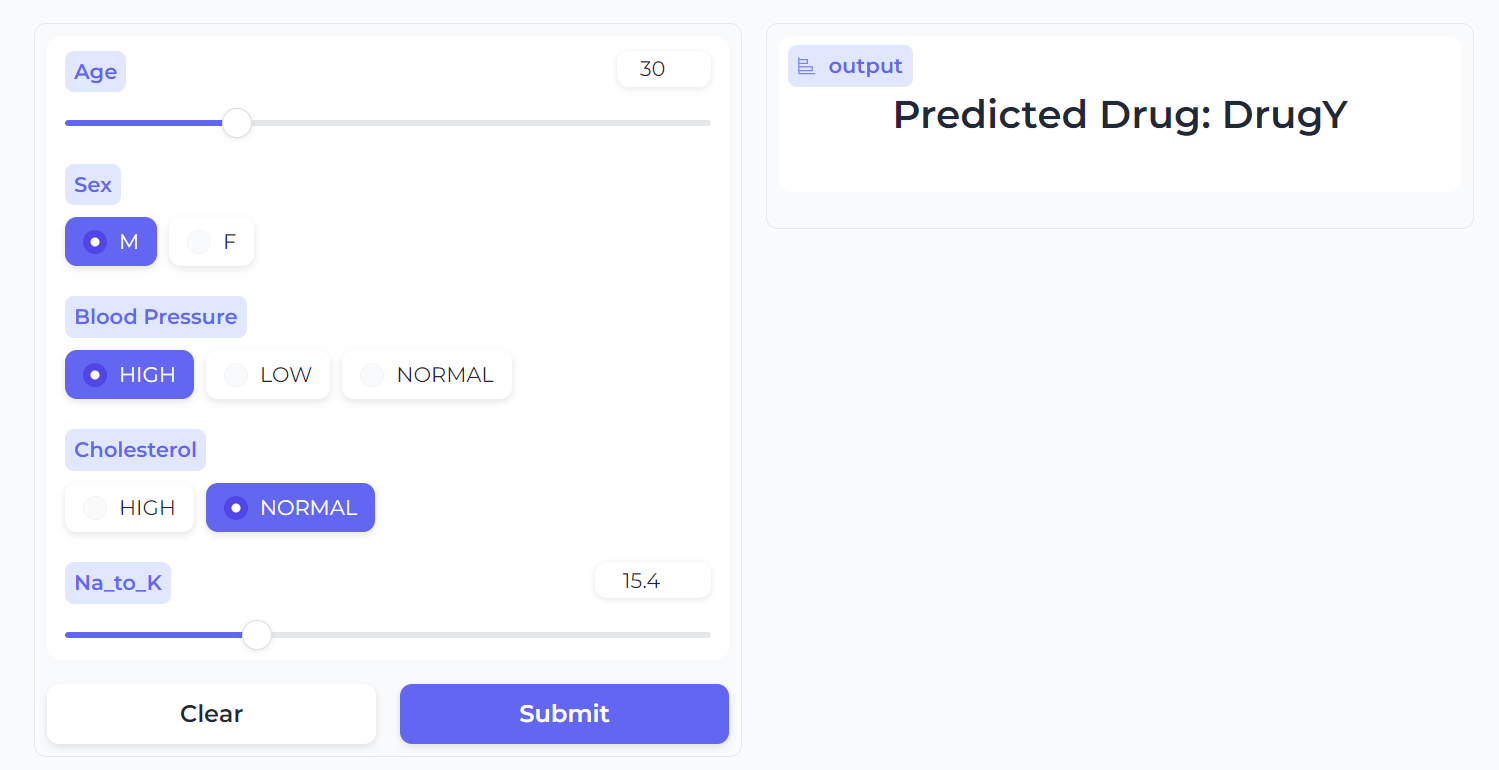
Bild Quelle
Dieser Guide zeigt, wie wir Training, Evaluation, Versionierung und Deployment automatisiert haben. Jede Änderung an Daten oder Algorithmen triggert den Prozess automatisch und fehlerfrei. So entstehen schnelle, skalierbare und produktionsreife Anwendungen.
In realen Projekten setzen wir mehrere MLOps-Tools ein, um ML-Anwendungen zu orchestrieren, zu versionieren, zu deployen und zu monitoren. Mehr dazu im Artikel Top MLOps Tools You Need to Know, der beliebte Technologien großer Tech-Unternehmen vorstellt.
Um deine CI/CD-Pipeline weiter zu optimieren, lohnt sich das Lernen von Tools wie Docker, Kubernetes, Azure Cloud und weiteren MLOps-Technologien. Folge dem Tutorial Machine Learning, Pipelines, Deployment, and MLOps, um Best Practices kennenzulernen und an fortgeschrittenen Projekten zu arbeiten.
Starte heute deine Machine-Learning-Reise!
Kurs
Kurs
Kurs
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Javier Canales Luna
11 Min.



