
कोर्स
Understanding Machine Learning
2 घंटा
311.6K
कंटीन्यूस इंटिग्रेशन (CI) और कंटीन्यूस डिप्लॉयमेंट (CD) सॉफ्टवेयर विकास में आम तौर पर उपयोग की जाने वाली प्रथाएँ हैं जो कोड परिवर्तनों के एकीकरण, उनके परीक्षण, और अद्यतन एप्लिकेशन को तेज़ी से परिनियोजित करने की प्रक्रिया को स्वचालित करती हैं। शुरुआत में, ये प्रथाएँ पारंपरिक सॉफ्टवेयर एप्लिकेशन के लिए विकसित की गई थीं, लेकिन अब ये मशीन लर्निंग (ML) प्रोजेक्ट्स में भी तेजी से प्रासंगिक हो रही हैं।
इस व्यापक गाइड में, हम ML के लिए CI/CD पर नज़र डालेंगे और यह सीखेंगे कि अपनी मशीन लर्निंग पाइपलाइन कैसे बनाएं जो मॉडल के प्रशिक्षण, मूल्यांकन, और परिनियोजन की प्रक्रिया को स्वचालित करेगी।
यह गाइड एक सरल प्रोजेक्ट प्रस्तुत करता है जो केवल GitHub Actions का उपयोग करके पूरी प्रक्रिया को स्वचालित करता है। जिन अधिकांश चीज़ों पर हम चर्चा करेंगे, वे मशीन लर्निंग इंजीनियरों और डेटा वैज्ञानिकों के लिए जानी-पहचानी हैं। यहाँ वे केवल यही सीखेंगे कि GitHub Actions, Makefile, CML, और Hugging Face CLI का उपयोग कैसे करना है।
मॉडल्स को लोकल नोटबुक्स से प्रोडक्शन तक ले जाना सीखने के लिए MLOps Concepts कोर्स में नामांकन करें, ताकि वे वास्तविक व्यावसायिक मूल्य उत्पन्न कर सकें।
अपने मॉडल को ऑपरेशनल बनाने और उससे प्रोडक्ट विकसित करने के मामले में CI/CD गेम-चेंजर है। स्वचालन प्रक्रिया को सुव्यवस्थित करने से आपके ML प्रोजेक्ट के लिए एक बग-रहित, तेज़ और स्केलेबल समाधान मिलता है, जिससे आप समाधान के प्रबंधन और परिनियोजन के बजाय मॉडल को बेहतर बनाने पर ध्यान केंद्रित कर सकते हैं।
खासतौर पर, मशीन लर्निंग के लिए CI/CD निम्नलिखित में मदद करता है:
CI/CD के साथ, आप नए डेटा पर अपने मॉडलों को एक नियमित शेड्यूल पर स्वतः पुनः-प्रशिक्षित कर सकते हैं, जिससे मैन्युअल रूप से रिट्रेनिंग ट्रिगर करने की तुलना में समय बचता है।
CI टूल्स प्रत्येक कोड कमिट पर परीक्षण और जाँच चलाते हैं, जो बग्स, इंटीग्रेशन समस्याओं और मॉडल प्रदर्शन में गिरावट का जल्दी पता लगाने में मदद करते हैं।
CI/CD यह सुनिश्चित करने में मदद करता है कि मॉडलों को बिल्कुल उसी तरह से पुनर्निर्मित और पुनः-प्रशिक्षित किया जा सके, जिससे परिणामों का पुनरुत्पादन संभव हो। एनवायरनमेंट्स, मॉडल और डेटा वर्ज़निंग, और कॉन्फ़िगरेशन को कोड के रूप में परिभाषित किया जाता है।
CI/CD परिनियोजन से पहले नए मॉडलों के स्वचालित परीक्षण की अनुमति देता है ताकि समस्याओं की जाँच हो सके। यह मॉनिटरिंग टूल्स के साथ इंटीग्रेशन के ज़रिए परिनियोजन के बाद मॉडलों की बेहतर निगरानी भी सक्षम करता है।
CI/CD के साथ नए मॉडल संस्करणों या प्रयोगों को स्वचालित रूप से तेज़ी से प्रशिक्षित, परीक्षण और परिनियोजित किया जा सकता है। यह ML सिस्टम्स के विकास और सुधार को गति देता है।
जैसे-जैसे ML प्रोजेक्ट का आकार और जटिलता बढ़ती है, पूरे लाइफसाइकल को मैन्युअल रूप से प्रबंधित करना अव्यावहारिक हो जाता है। CI/CD पाइपलाइन्स एक स्केलेबल समाधान प्रदान करती हैं जो दक्षता और विश्वसनीयता बनाए रखते हुए बड़े डेटा वॉल्यूम, अनेक मॉडलों, और विविध निर्भरताओं को संभाल सकती हैं।
इस गाइड में, हम अकाउंट्स और एनवायरनमेंट्स सेट अप करने, CI/CD पाइपलाइन बनाने, और पूरी प्रक्रिया को अनुकूलित करने की चरण-दर-चरण प्रक्रिया बताएँगे।
हम scikit-learn पाइपलाइन्स का उपयोग करके रैंडम फॉरेस्ट एल्गोरिद्म को प्रशिक्षित करेंगे और एक ड्रग क्लासिफ़ायर बनाएँगे। प्रशिक्षण के बाद, हम CML का उपयोग करके मूल्यांकन प्रक्रिया को स्वचालित करेंगे। अंत में, हम वेब एप्लिकेशन को Hugging Face Hub पर बनाएँगे और परिनियोजित करेंगे।
प्रशिक्षण से लेकर मूल्यांकन तक, पूरी प्रक्रिया GitHub Actions का उपयोग करके स्वचालित होगी। आपको बस अपना कोड GitHub रिपॉज़िटरी पर पुश करना है, और दो मिनट के भीतर, अपडेटेड ऐप, मॉडल और परिणामों के साथ मॉडल Hugging Face पर अपडेट हो जाएगा।
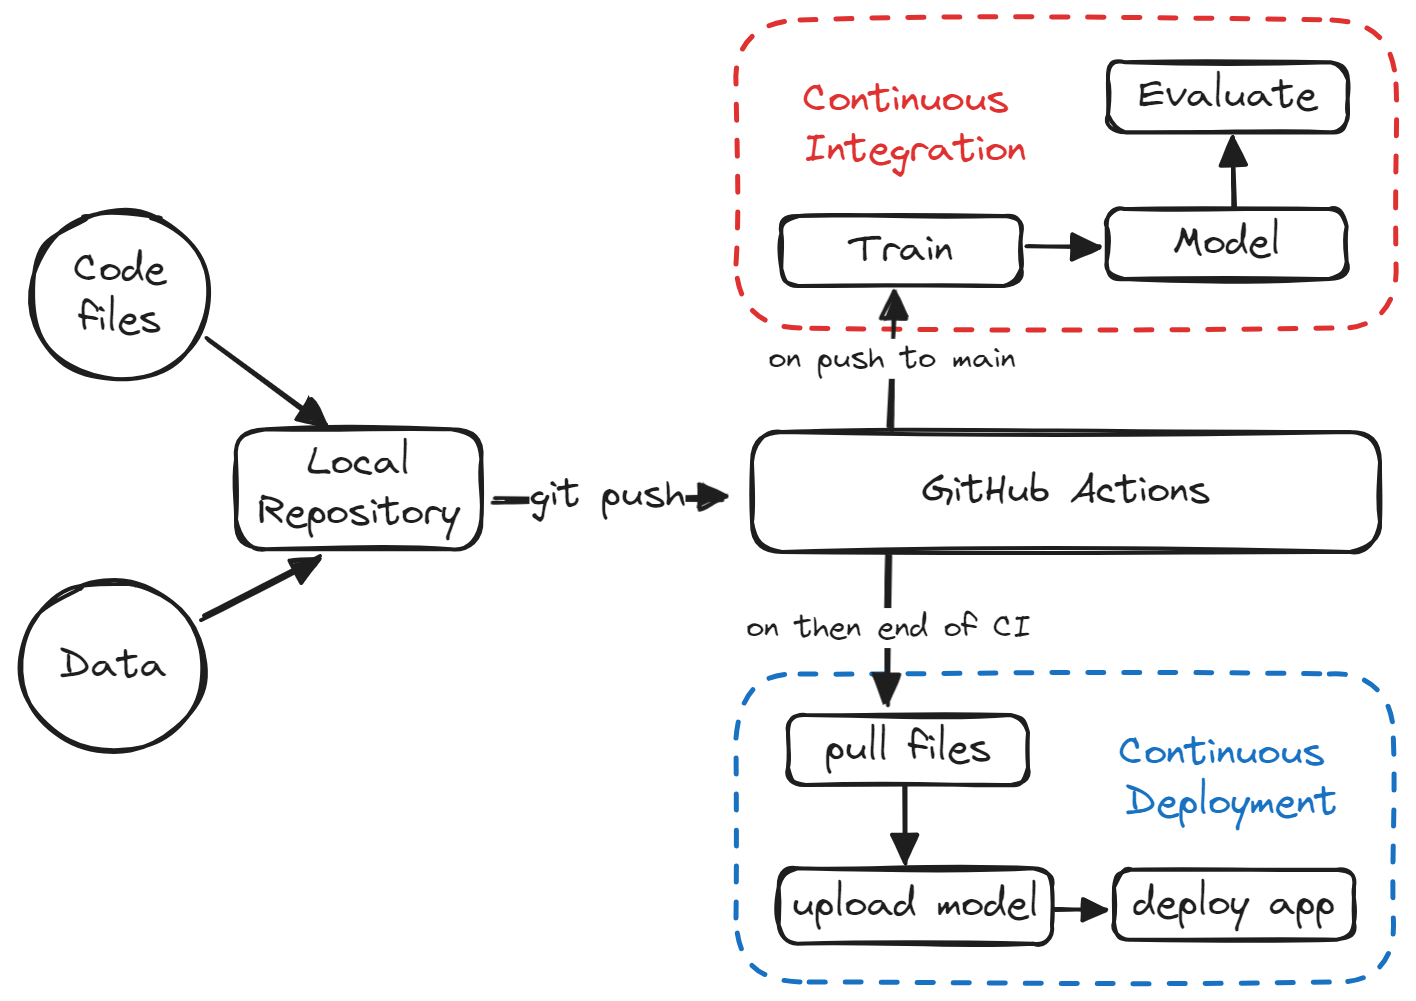
यदि आप इंटरैक्टिव अभ्यासों के साथ और अधिक सीखना चाहते हैं, तो DataCamp का CI/CD for Machine Learning कोर्स करें और GitHub Actions तथा Data Version Control के साथ अपनी मशीन लर्निंग डेवलपमेंट को ऊँचा उठाएँ।
इस सेक्शन में, हम एक GitHub रिपॉज़िटरी, आवश्यक फ़ाइलें और फ़ोल्डर्स, और Hugging Face में एक Space बनाएँगे।
GitHub के मुख्य पेज के ऊपर दाईं ओर “+” बटन पर क्लिक करें और “New repository” चुनें।
रिपॉज़िटरी का नाम और विवरण जोड़ें, README फ़ाइल को चेक करें, और .gitignore को Python पर सेट करें।
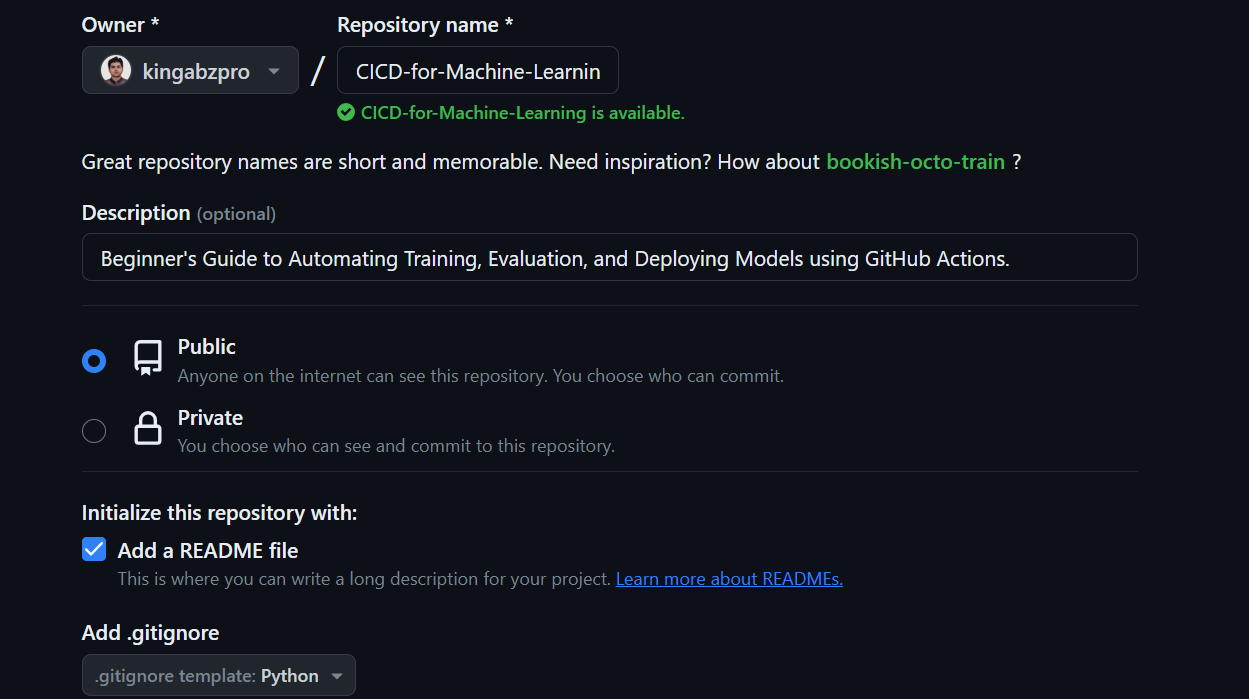
रिपॉज़िटरी बनाने के बाद, हमें उसका URL कॉपी करना होगा। फिर, टर्मिनल या bash खोलें और उस डायरेक्टरी पर जाएँ जहाँ आप प्रोजेक्ट फ़ोल्डर स्टोर करना चाहते हैं।
अंत में, निम्न कमांड चलाकर रिपॉज़िटरी क्लोन करें:
git clone https://github.com/kingabzpro/CICD-for-Machine-Learning.gitशुरू करने के लिए, अपनी पसंद के IDE का उपयोग करके लोकल रिपॉज़िटरी खोलें। हम इस प्रोजेक्ट के लिए VSCode की अनुशंसा करते हैं। IDE लॉन्च करने पर, आपको README और LICENSE जैसी फ़ाइलों वाला एक VSCode वर्कस्पेस दिखाई देगा।
आइए एक Hugging Face Space बनाते हैं जिसका उपयोग हम अपने एप्लिकेशन को मॉडल फ़ाइल के साथ परिनियोजित करने के लिए करेंगे।
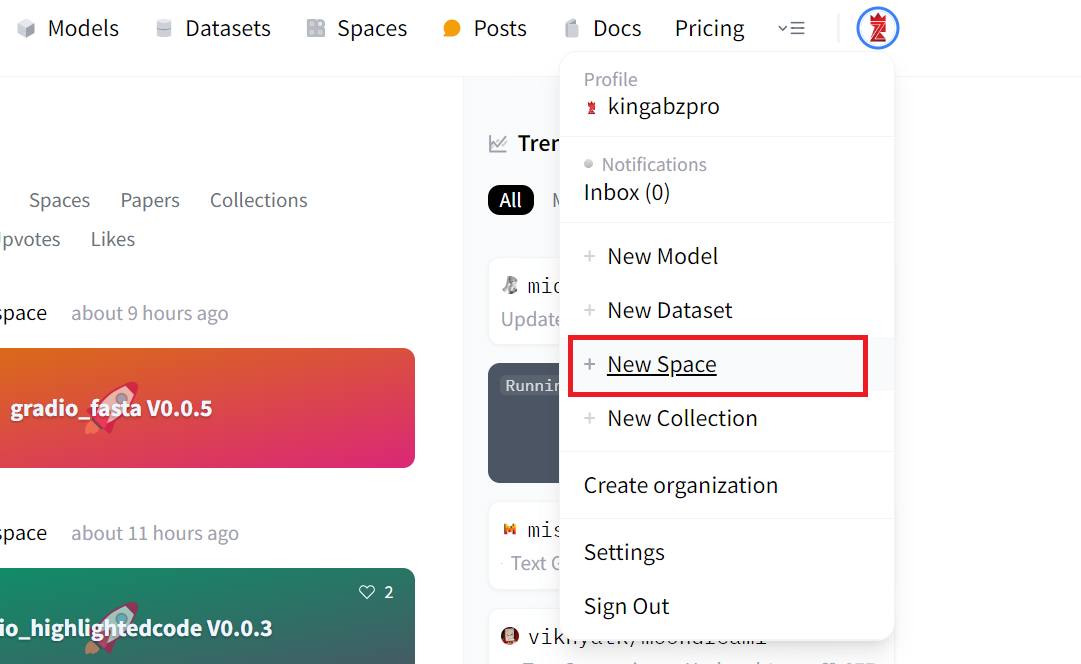
1. अपनी डिस्प्ले पिक्चर पर क्लिक करें और "New Space" चुनें।
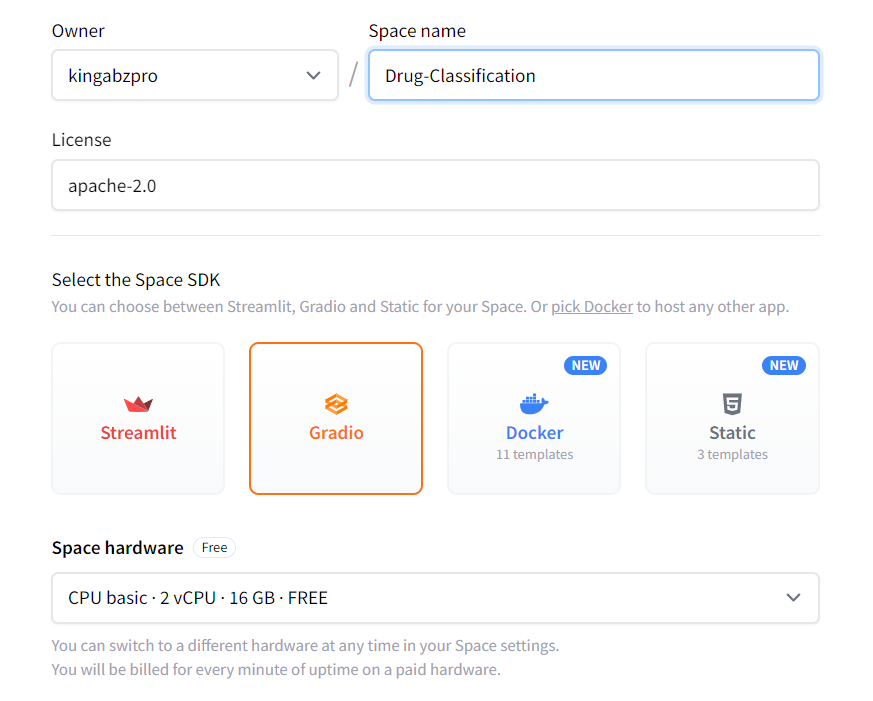
2. Spaces का नाम, लाइसेंस, SDK प्रकार जोड़ें, और Create Space पर क्लिक करें।
3. README.md फ़ाइल को संपादित करने के लिए, ऊपर बाईं ओर तीन डॉट्स पर क्लिक करें, Files चुनें, और आवश्यक परिवर्तन करें।
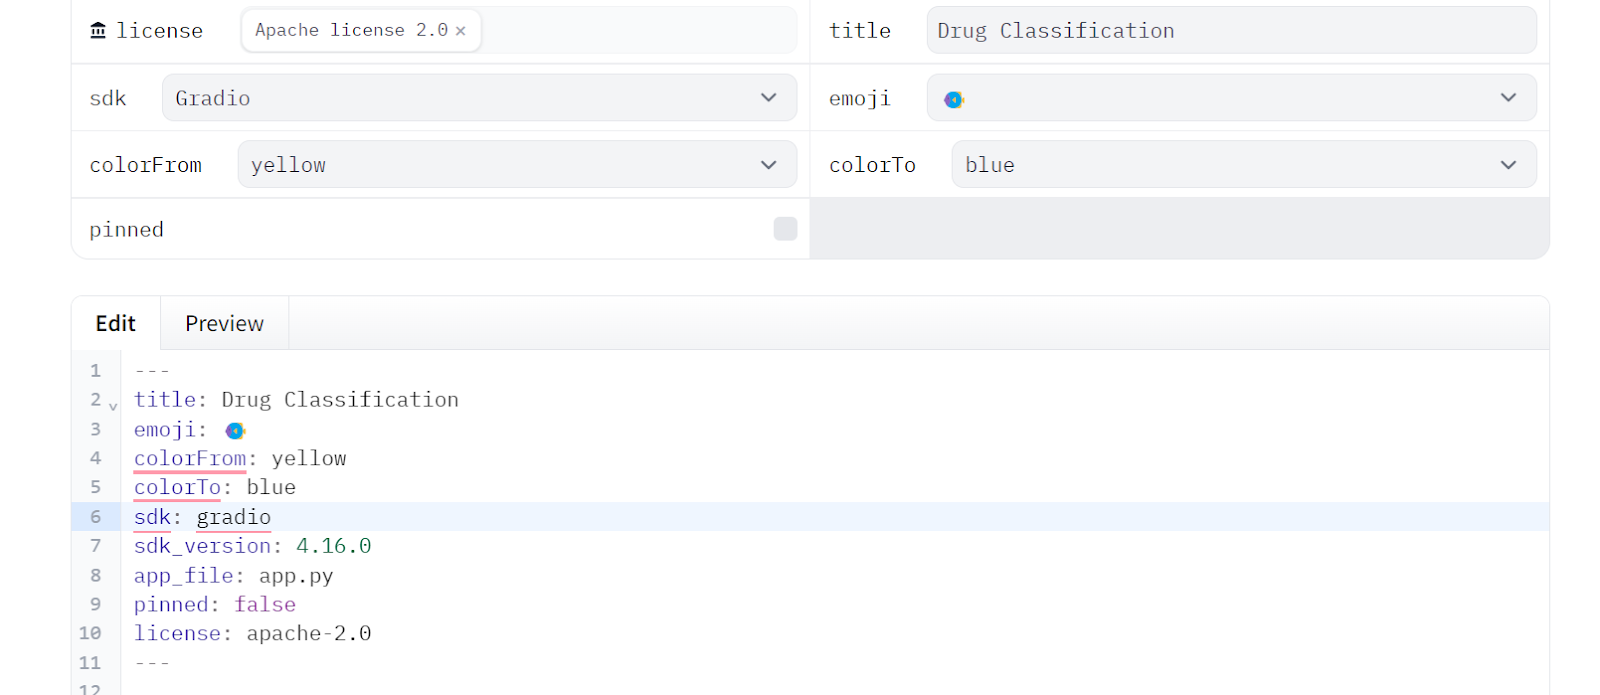
4. हम Space की README फ़ाइल से मेटाडेटा कॉपी करेंगे और उसे अपनी लोकल README फ़ाइल में पेस्ट करेंगे जो App फ़ोल्डर में रहेगी।
हमें प्रयोग शुरू करने और पाइपलाइन्स बनाने से पहले आवश्यक फ़ोल्डर और फ़ाइलें बनानी होंगी। यह लंबे समय में वर्कस्पेस को साफ रखने में मदद करेगा।
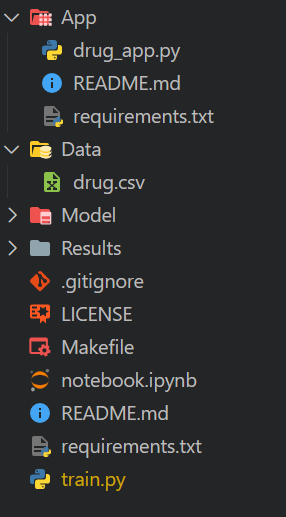
एक Python फ़ाइल drug_app.py नाम से बनाएँ, साथ ही एक README.md और requirements.txt फ़ाइल भी बनाएँ, और इन सभी फ़ाइलों को App फ़ोल्डर में ले जाएँ। इससे ऐप चलाने के लिए आवश्यक सभी फ़ाइलें बेहतर ढंग से व्यवस्थित रहेंगी।
इसके बाद, कृपया App फ़ोल्डर में README.md फ़ाइल संपादित करें और सुनिश्चित करें कि सभी मेटाडेटा वर्ज़निंग को उपयुक्त रूप से संशोधित किया गया है। इससे आप ऐप फ़ाइलों के स्थान की ओर आसानी से इशारा कर पाएँगे, रंग बदल पाएँगे, SDK संस्करण सेट कर पाएँगे, और लाइसेंसिंग जानकारी जोड़ पाएँगे।
---
title: Drug Classification
emoji: 💊
colorFrom: yellow
colorTo: red
sdk: gradio
sdk_version: 4.16.0
app_file: drug_app.py
pinned: false
license: apache-2.0
---
App फ़ोल्डर में requirement.txt फ़ाइल संपादित करें और गायब Python पैकेज जोड़ें:
scikit-learn
skops
नोट: GitHub रिपॉज़िटरी और Hugging Face Space के लिए requirement और README फ़ाइलें भिन्न होंगी।
Kaggle से Drug Classification डेटासेट डाउनलोड करें, CSV फ़ाइल निकालें, और उसे Data फ़ोल्डर में ले जाएँ।
Model और Results दोनों फ़ोल्डर अभी खाली रहेंगे क्योंकि इनमें Python स्क्रिप्ट चलने पर फ़ाइलें आएँगी।
Makefile बनाएँ।notebook.ipynb नाम का एक Jupyter Notebook बनाएँ। इसमें हम अपने एल्गोरिद्म और प्रोसेसिंग पाइपलाइन्स पर प्रयोग करेंगे।requirements.txt नाम की फ़ाइल बनाएँ। यह CI वर्कफ़्लो जॉब्स चलाते समय एनवायरनमेंट सेट करने के लिए उपयोग होगी।train.py नाम की फ़ाइल बनाएँ। इसमें डेटा लोडिंग और प्रोसेसिंग के साथ-साथ मॉडल का प्रशिक्षण, मूल्यांकन, और मॉडल व प्रदर्शन मेट्रिक्स को सहेजने का Python कोड होगा।हमारी डायरेक्टरी कुछ इस तरह दिखनी चाहिए:
इस भाग में, हम ऐसा Python कोड बनाने के प्रयोग करेंगे जो डेटा को प्रोसेस करता है और scikit-learn पाइपलाइन का उपयोग करके मॉडल को ट्रेन करता है। फिर हम इसका मूल्यांकन करेंगे और परिणामों व मॉडल को सहेजेंगे।
हम pandas का उपयोग करके अपनी CSV फ़ाइल लोड करेंगे, sample फ़ंक्शन से उसे शफ़ल करेंगे, और शीर्ष तीन पंक्तियाँ दिखाएँगे।
import pandas as pd

drug_df = pd.read_csv("Data/drug.csv")
drug_df = drug_df.sample(frac=1)
drug_df.head(3)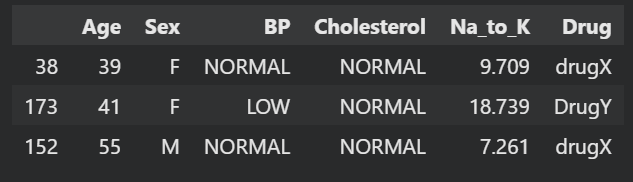
आश्रित और स्वतंत्र वेरिएबल बनाएँ। फिर उन्हें ट्रेनिंग और टेस्टिंग सेट में बाँट दें। इससे आप अपने मॉडल के प्रदर्शन का मूल्यांकन कर पाएँगे।
from sklearn.model_selection import train_test_split

X = drug_df.drop("Drug", axis=1).values
y = drug_df.Drug.values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=125
)हम ColumnTransformer का उपयोग करके एक प्रोसेसिंग पाइपलाइन बनाएँगे, जो श्रेणीगत मानों को संख्याओं में बदलेगी, मिसिंग वैल्यू भरेगी, और संख्यात्मक कॉलम्स को स्केल करेगी।
उसके बाद, हम एक ट्रेनिंग पाइपलाइन बनाएँगे जो रूपांतरित डेटा लेगी और एक रैंडम फॉरेस्ट क्लासिफ़ायर को प्रशिक्षित करेगी।
अंत में, हम मॉडल को ट्रेन करेंगे।
पाइपलाइन्स का उपयोग करके, हम अपने कोड में पुनरुत्पादनशीलता, मॉड्यूलरिटी, और स्पष्टता सुनिश्चित कर सकते हैं।
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OrdinalEncoder, StandardScaler

cat_col = [1,2,3]
num_col = [0,4]

transform = ColumnTransformer(
    [
        ("encoder", OrdinalEncoder(), cat_col),
        ("num_imputer", SimpleImputer(strategy="median"), num_col),
        ("num_scaler", StandardScaler(), num_col),
    ]
)
pipe = Pipeline(
    steps=[
        ("preprocessing", transform),
        ("model", RandomForestClassifier(n_estimators=100, random_state=125)),
    ]
)
pipe.fit(X_train, y_train)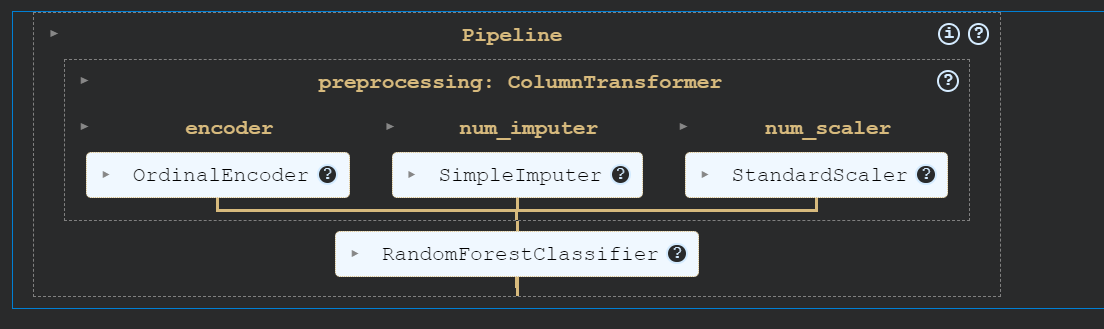
मॉडल के प्रदर्शन का मूल्यांकन सटीकता (accuracy) और F1 स्कोर दोनों की गणना करके करें।
from sklearn.metrics import accuracy_score, f1_score

predictions = pipe.predict(X_test)
accuracy = accuracy_score(y_test, predictions)
f1 = f1_score(y_test, predictions, average="macro")

print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))
हमारे मॉडल ने असाधारण प्रदर्शन किया है।
Accuracy: 95.0% F1: 0.91मेट्रिक्स फ़ाइल बनाएँ और उसे Results फ़ोल्डर में सहेजें।
with open("Results/metrics.txt", "w") as outfile:
    outfile.write(f"\nAccuracy = {accuracy.round(2)}, F1 Score = {f1.round(2)}.")
इसके बाद हम confusion matrix बनाएँगे और इमेज फ़ाइल को Results फ़ोल्डर में सहेज देंगे।
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix

cm = confusion_matrix(y_test, predictions, labels=pipe.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=pipe.classes_)
disp.plot()
plt.savefig("Results/model_results.png", dpi=120)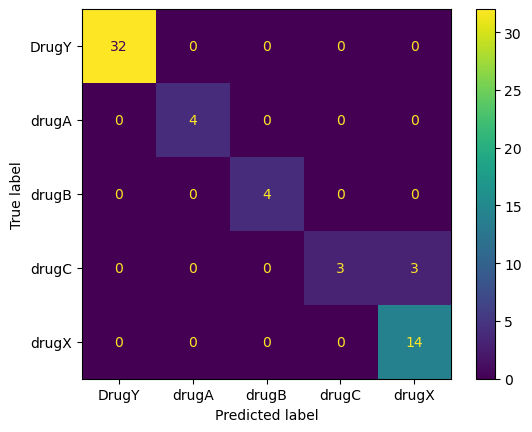
हम अब अपना मॉडल skops Python पैकेज का उपयोग करके सहेजेंगे। यह हमें scikit-learn पाइपलाइन और मॉडल दोनों सहेजने में मदद करेगा।
import skops.io as sio

sio.dump(pipe, "Model/drug_pipeline.skops")
आप पूरी पाइपलाइन को लोड कर सकते हैं, और यह बिना डेटा प्रोसेस किए या कोड में बदलाव किए सीधे काम करेगी।
sio.load("Model/drug_pipeline.skops", trusted=True)
पूरा कोड कॉपी-पेस्ट करके 'train.py' फ़ाइल में डालें। यह मानकीकृत प्रशिक्षण स्क्रिप्ट होगी जो हर बार डेटा या कोड में बदलाव होने पर CI वर्कफ़्लो में चलेगी।
अपना MLOps इंजीनियरिंग करियर शुरू करने से पहले, MLOps Roadmap: A Complete Career Guide पढ़ें।
इस सेक्शन में, हम CML, Makefile, और GitHub Action वर्कफ़्लो सेट अप करने को कवर करेंगे ताकि हमारे प्रोजेक्ट के प्रशिक्षण, मूल्यांकन, और संस्करण प्रबंधन को स्वचालित किया जा सके।
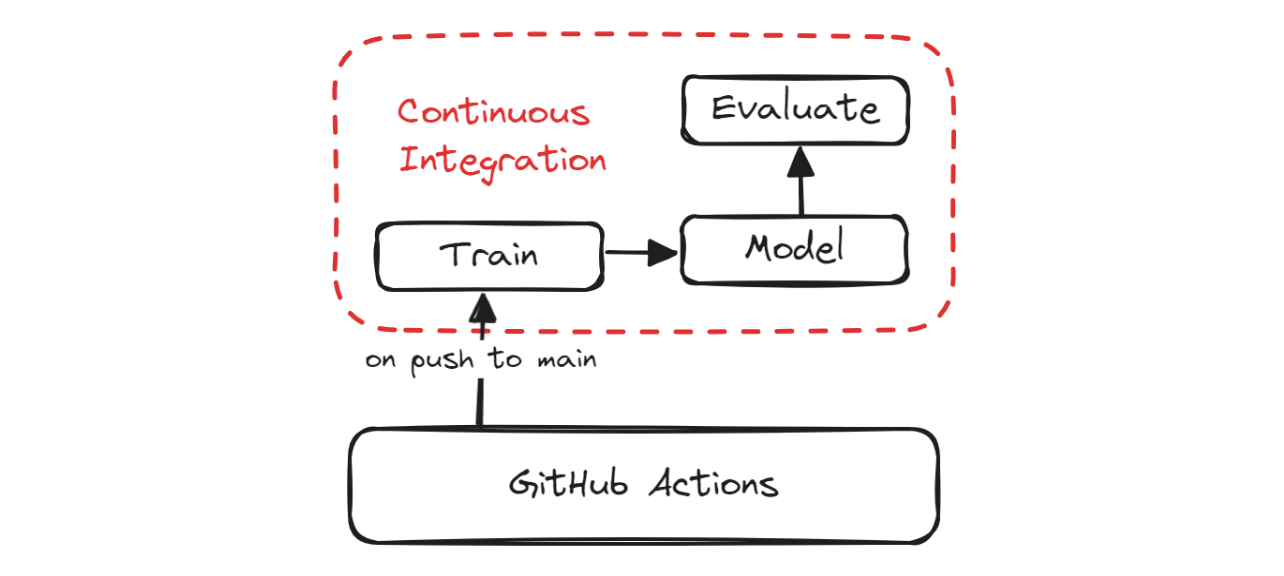
CI पाइपलाइन
कंटीन्यूस मशीन लर्निंग (CML) एक ओपन-सोर्स लाइब्रेरी है जो आपके मशीन लर्निंग प्रोजेक्ट्स में कंटीन्यूस इंटिग्रेशन लागू करने की अनुमति देती है। हम "iterative/setup-cml" GitHub Action का उपयोग करेंगे, जो वर्कफ़्लो में CML फ़ंक्शंस का इस्तेमाल करके मॉडल मूल्यांकन रिपोर्ट के जेनरेशन को स्वचालित करता है।
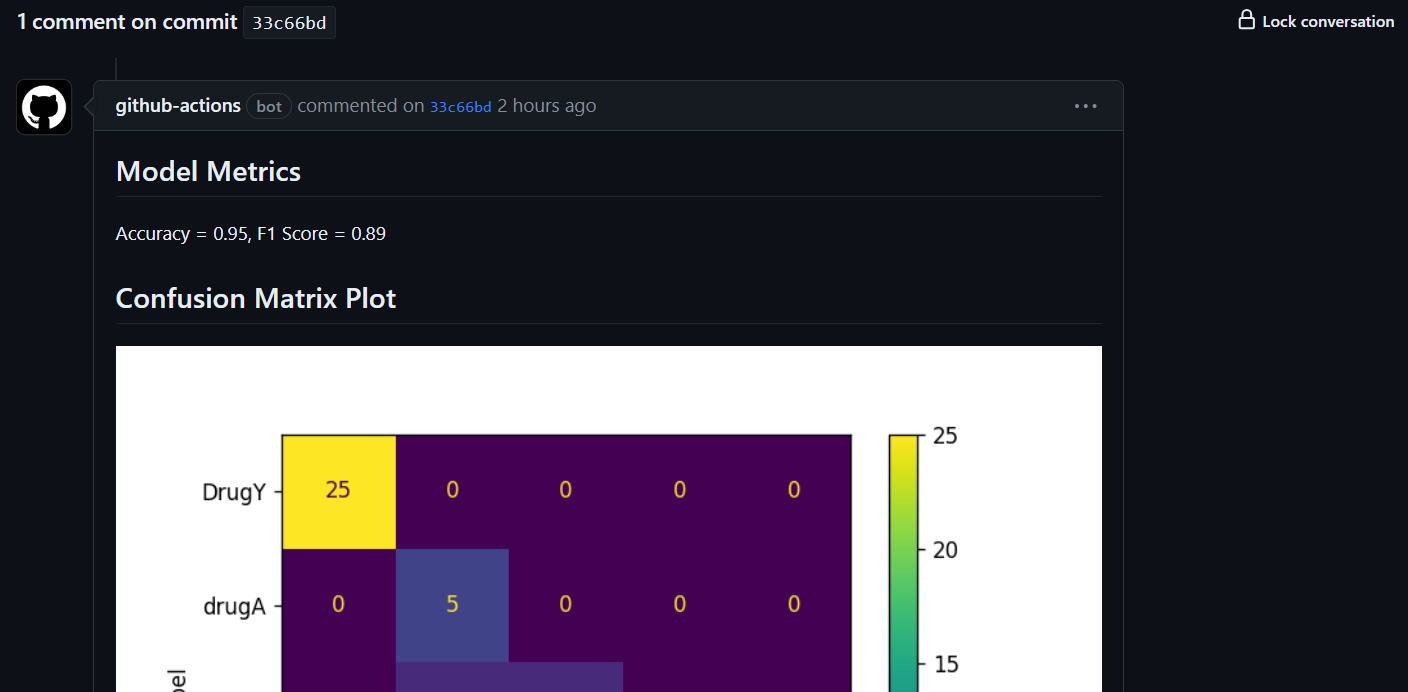
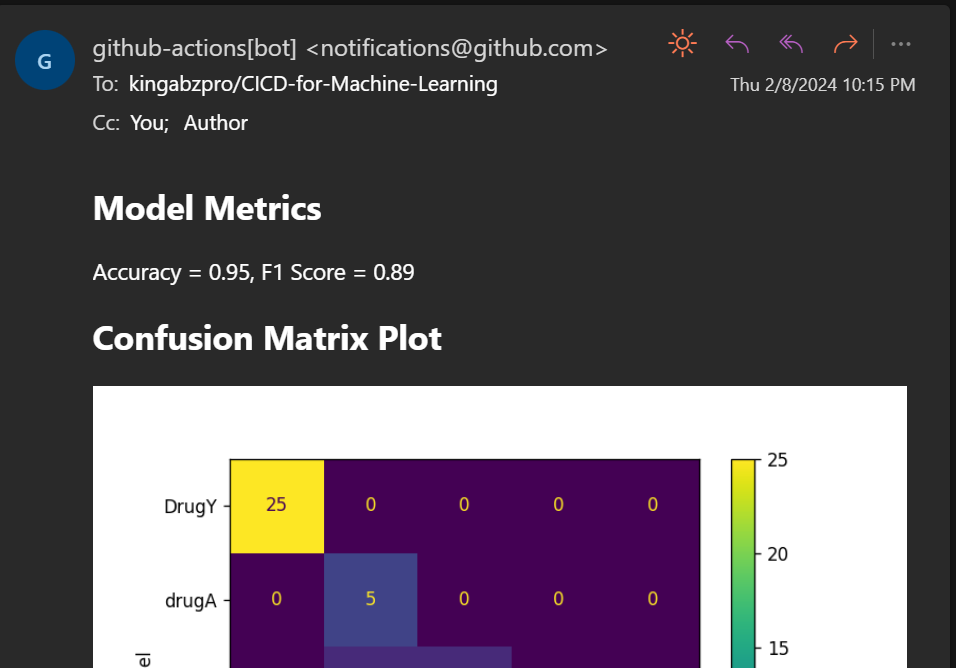
इसका क्या मतलब है? जब भी आप GitHub पर बदलाव पुश करेंगे, यह कमिट के नीचे एक रिपोर्ट जेनरेट करेगा और आपको प्रदर्शन मेट्रिक्स और कन्फ्यूज़न मैट्रिक्स के साथ ईमेल भेजेगा।
Makefile एक फ़ाइल है जिसमें make कमांड द्वारा उपयोग किए जाने वाले निर्देशों का सेट होता है, ताकि विभिन्न कार्यों जैसे कोड कंपाइल करना, परीक्षण चलाना, एनवायरनमेंट सेट करना, डेटा प्रीप्रोसेसिंग, मॉडल प्रशिक्षण और मूल्यांकन, तथा मॉडल परिनियोजन को स्वचालित किया जा सके।
हम make कमांड्स का उपयोग करके कई स्क्रिप्ट्स चला सकते हैं ताकि CI वर्कफ़्लो फ़ाइल साफ़ और सरल रहे। Makefile में कमांड सेट के नाम और उन्हें चलाने के स्क्रिप्ट्स होते हैं।
हमारा Makefile इस प्रकार है:
install:
pip install --upgrade pip &&\
pip install -r requirements.txt
format:
black *.py
train:
python train.py
eval:
echo "## Model Metrics" > report.md
cat ./Results/metrics.txt >> report.md
echo '\n## Confusion Matrix Plot' >> report.md
echo '' >> report.md
cml comment create report.mdहमारे पास Python पैकेज इंस्टॉल करने (install), कोड फ़ॉर्मैट करने (format), ट्रेनिंग स्क्रिप्ट चलाने (train), और CML रिपोर्ट जेनरेट करने (eval) के लिए कमांड्स हैं।
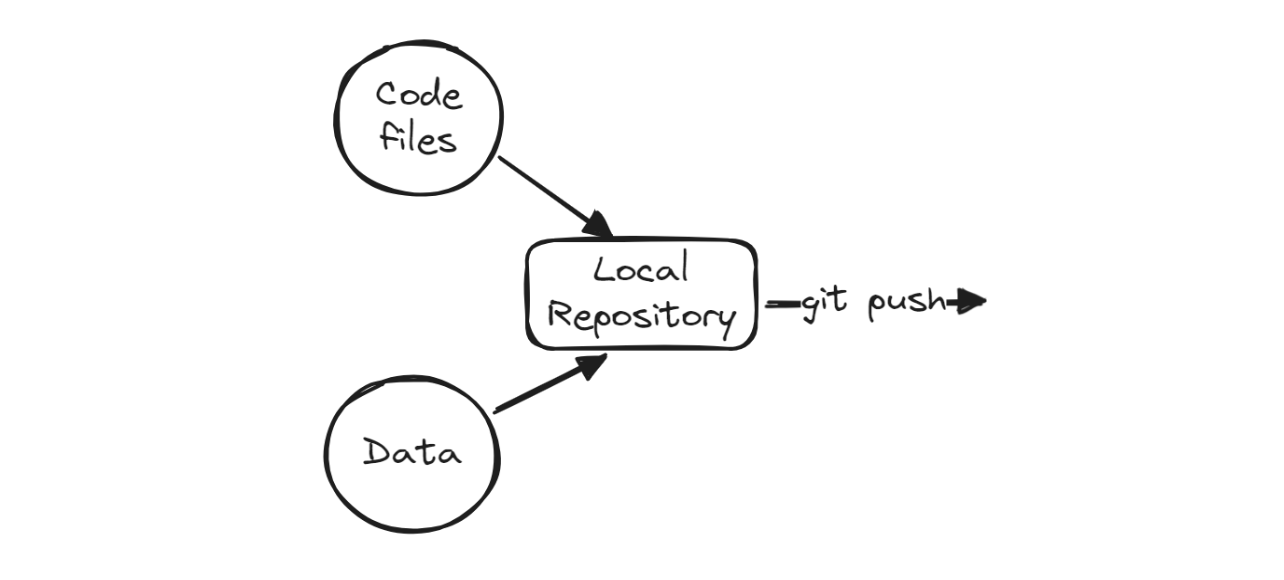
इसके बाद, हम बदलाव ऐड करेंगे, एक कमिट बनाएँगे, और बदलावों को GitHub रिमोट सर्वर पर पुश करेंगे।
git commit -am "new changes"
git push origin mainप्रशिक्षण और मूल्यांकन को स्वचालित करने के लिए, हमें एक GitHub Action वर्कफ़्लो बनाना होगा। ऐसा करने के लिए, अपनी रिपॉज़िटरी kingabzpro/CICD-for-Machine-Learning के “Actions” टैब पर जाएँ और नीले टेक्स्ट “set up a workflow yourself.” पर क्लिक करें।
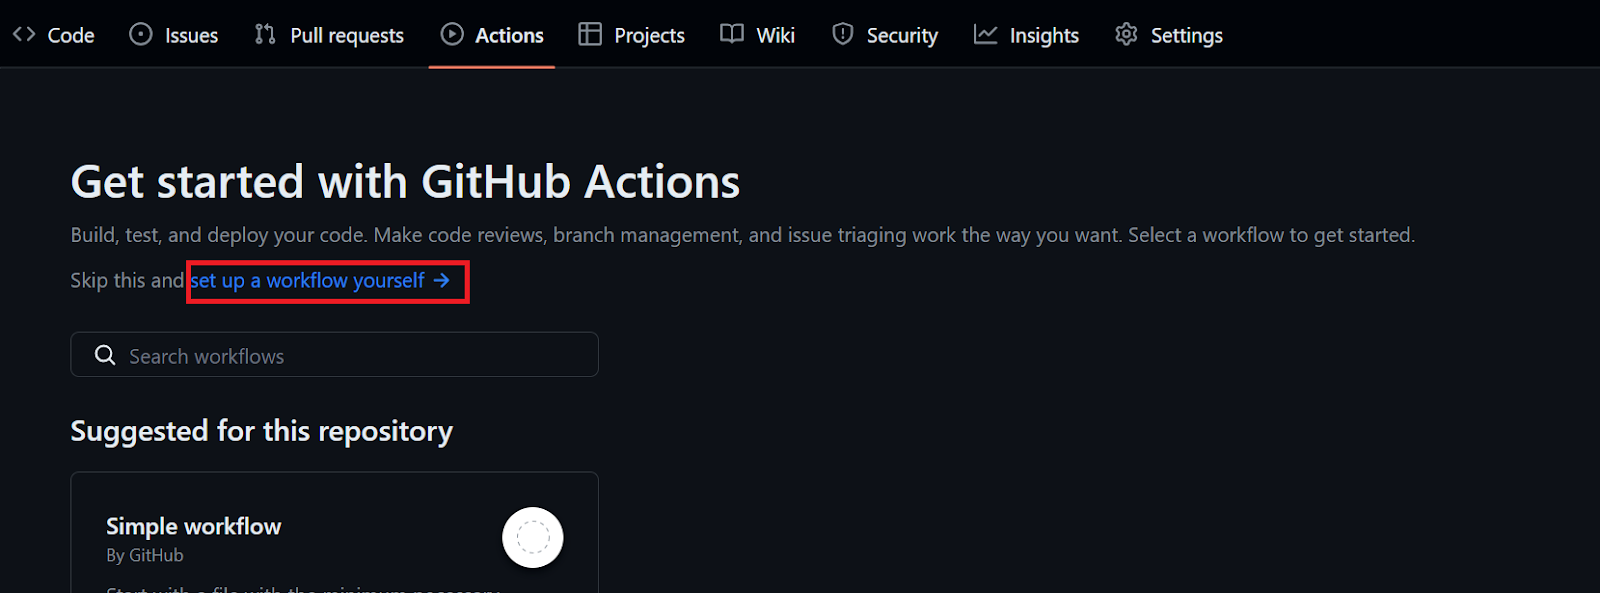
.yml फ़ाइल का नाम “ci” रखें और GitHub Action कमांड जोड़ना शुरू करें।
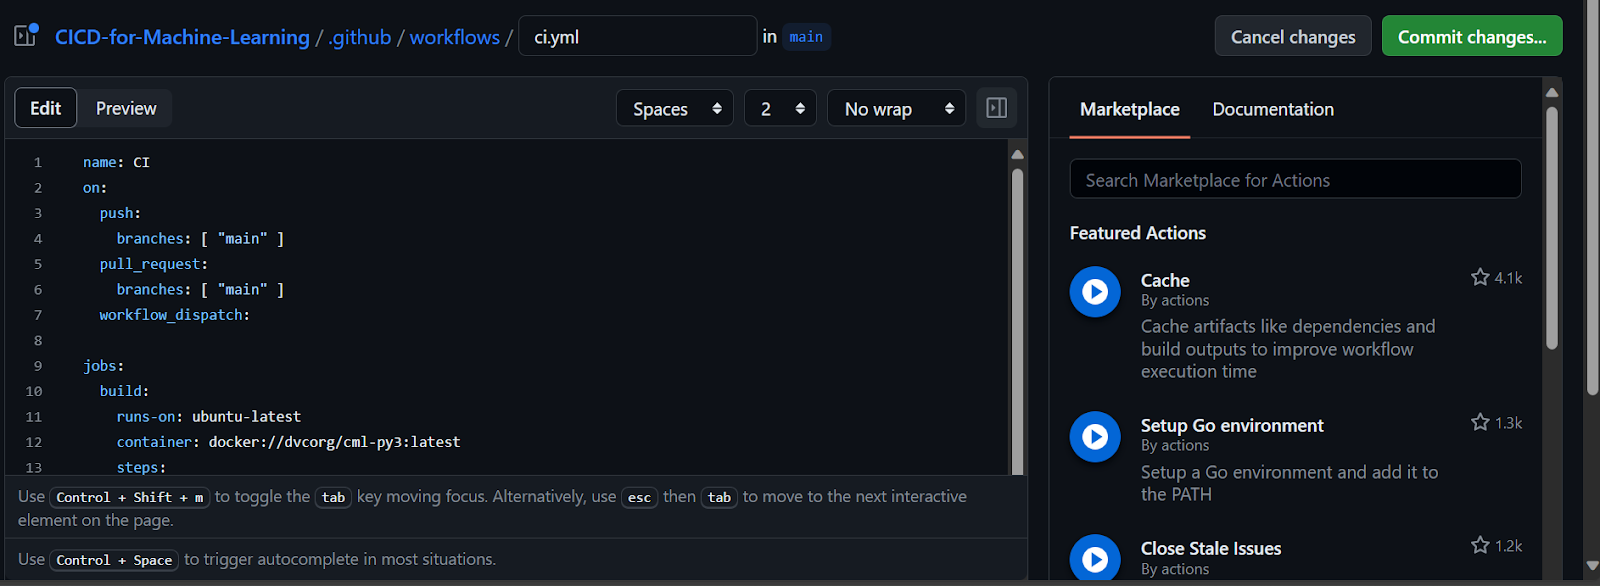
त्रुटियाँ और सिंटैक्स समझते समय फेल्योर आ सकते हैं, इसलिए GitHub Action में कूदने से पहले Workflow syntax for GitHub Actions पढ़ना महत्वपूर्ण है।
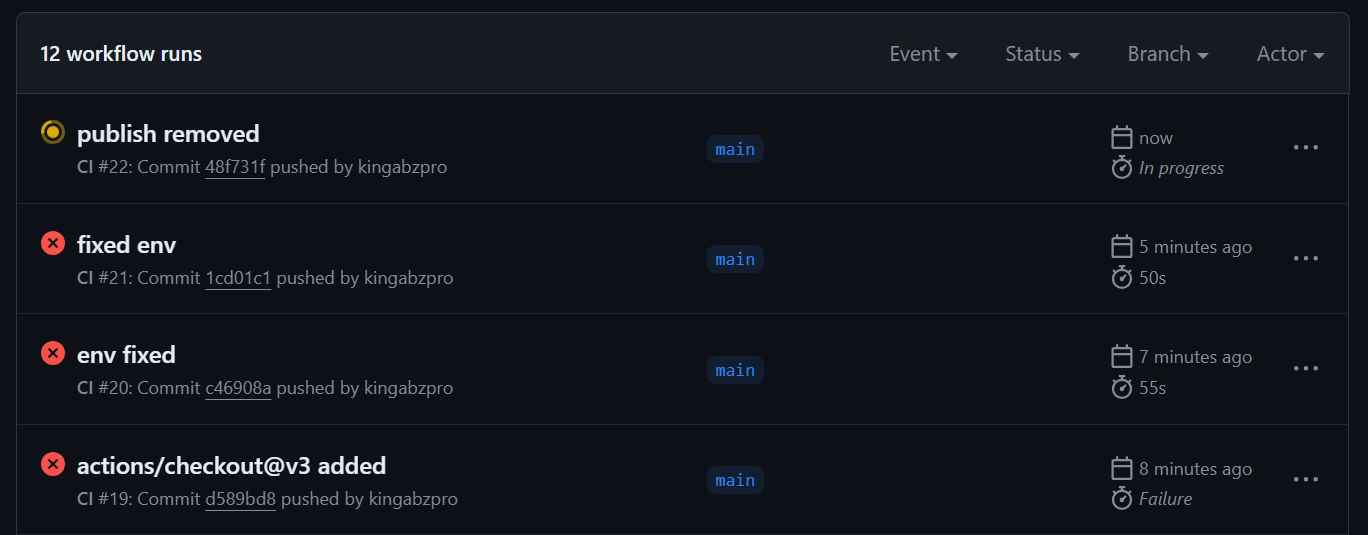
हमने सफलतापूर्वक वर्कफ़्लो की सभी त्रुटियाँ और समस्याएँ ठीक कर ली हैं, और अब हमारे पास `ci.yml` फ़ाइल का अंतिम संस्करण है जो सुचारू रूप से चलता है।
जैसा कि आप देख सकते हैं, वर्कफ़्लो पहले एनवायरनमेंट सेट करता है और आवश्यक एक्शंस को लोड करता है। फिर, हम make कमांड का उपयोग करके प्रत्येक स्टेप एक-एक करके चलाते हैं, जो बैकएंड में विभिन्न Python और Bash स्क्रिप्ट्स चलाता है।
हालाँकि, CML एक्शंस के साथ काम करते समय दो महत्वपूर्ण बातों का ध्यान रखना चाहिए। पहला, शुरुआत में write परमिशन सेट करनी होगी। दूसरा, CML जॉब को GitHub टोकन देना होगा, जिसे हम सीक्रेट्स के ज़रिए एक्सेस कर सकते हैं।
name: Continuous Integration
on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]
  workflow_dispatch:

permissions: write-all
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v2
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Train
        run: make train
      - name: Evaluation
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
        run: make eval
मेट्रिक्स और परिणाम कमिट संदेश के नीचे दिखाई देंगे।
यह आपको परिणामों के साथ ईमेल भी भेजेगा।
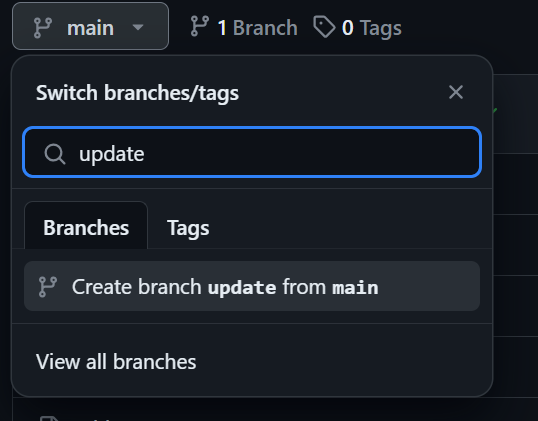
हम मूल्यांकन रिपोर्ट जेनरेट कर रहे हैं, लेकिन मॉडल और परिणामों का संस्करण प्रबंधन नहीं कर रहे हैं। बदलाव सहेजने के लिए, हम "update" नाम की नई ब्रांच बनाएँगे और अपडेटेड मॉडल व परिणाम उसमें पुश करेंगे।
मुख्य ब्रांच बटन पर क्लिक करके "update" टाइप करें, और फिर "create branch update from main" चुनें।
Git कमांड का उपयोग करके बदलावों को कमिट और पुश करने के लिए, हमें यूज़रनेम और ईमेल प्रदान करने की आवश्यकता होती है। आप इन्हें सीधे जोड़ सकते हैं, लेकिन GitHub सीक्रेट्स का उपयोग करना बेहतर विकल्प है। ये चरण अपनाएँ:
बस इतना ही!
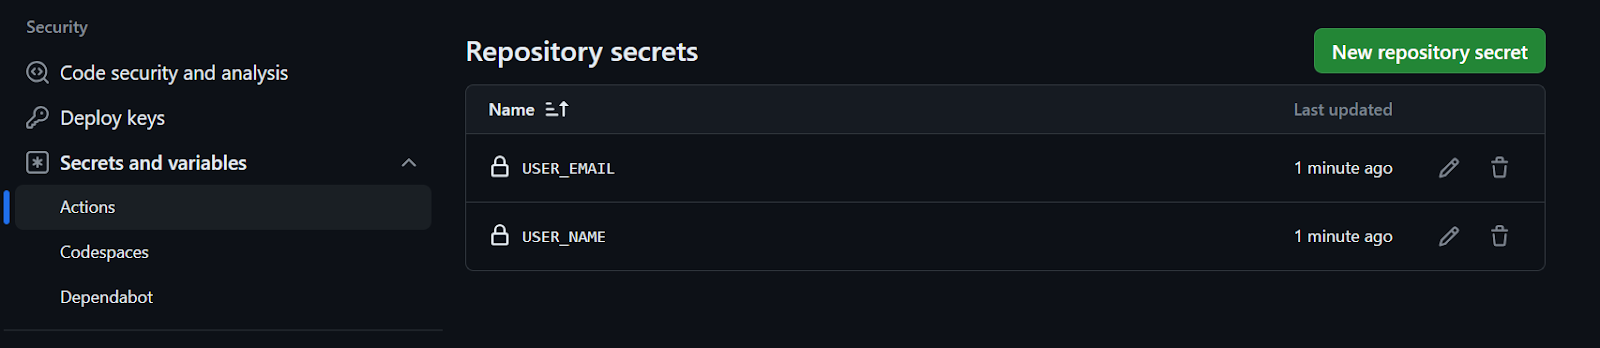
बदलावों को नई ब्रांच में स्वतः सहेजने के लिए, हमें Makefile और ci.yml अपडेट करने होंगे।
Makefile:
हम यूज़रनेम और ईमेल कॉन्फ़िगर कर रहे हैं, बदलावों को कमिट कर रहे हैं, और उन्हें update ब्रांच में सहेज रहे हैं।
update-branch:
	git config --global user.name $(USER_NAME)
	git config --global user.email $(USER_EMAIL)
	git commit -am "Update with new results"
	git push --force origin HEAD:update
ci.yml:
Makefile स्क्रिप्ट चलाने के लिए एनवायरनमेंट वेरिएबल का उपयोग कर रहा है। इसके लिए, हमें पहले सीक्रेट्स से एनवायरनमेंट वेरिएबल का मान निकालना होगा, फिर make कमांड के अंत में एनवायरनमेंट वेरिएबल सेट करना होगा।
    - name: Update Branch
        env:
          NAME: ${{ secrets.USER_NAME }}
          EMAIL: ${{ secrets.USER_EMAIL }}
        run: make update-branch USER_NAME=$NAME USER_EMAIL=$EMAIL
एक बार जब आप फ़ाइलें अपडेट कर लें और मुख्य ब्रांच पर बदलाव पुश कर दें, तो आप रियल-टाइम में जादू होते हुए देख पाएँगे। एक विश्लेषणात्मक रिपोर्ट जेनरेट होगी, साथ ही एक अपडेटेड मॉडल भी जो कंटीन्यूस डिप्लॉयमेंट भाग में Hugging Face पर परिनियोजित किया जा सकेगा।
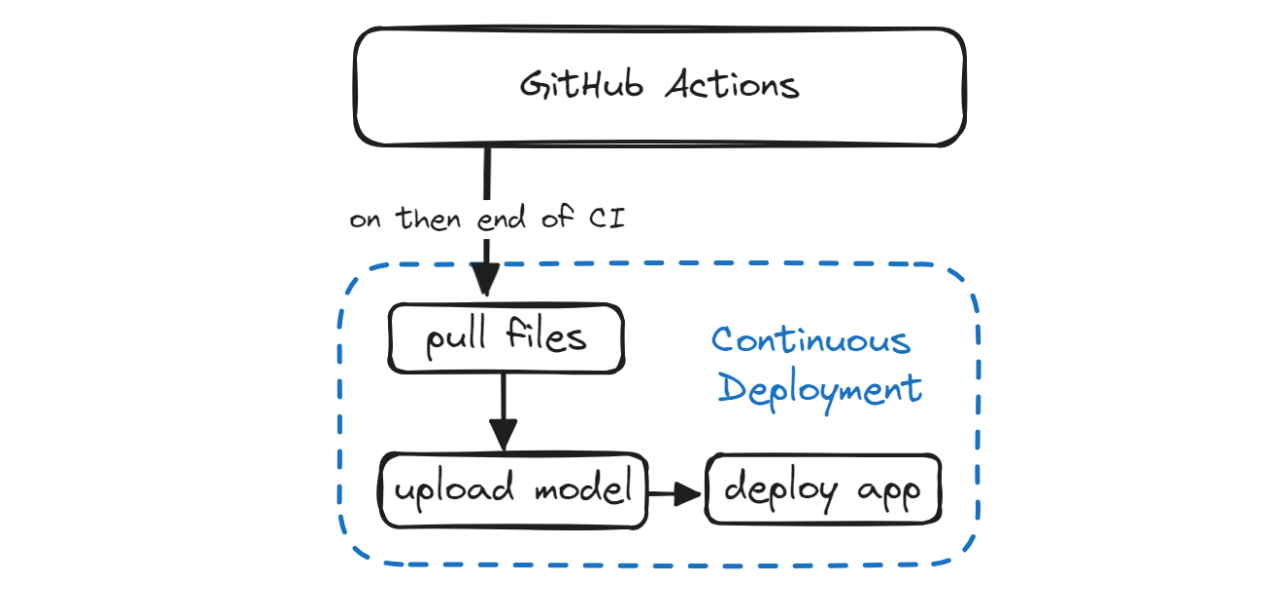
कंटीन्यूस डिप्लॉयमेंट सेक्शन में, हम यह जानेंगे कि मॉडल और एप्लिकेशन दोनों के परिनियोजन की प्रक्रिया को कैसे स्वचालित किया जाए। इसमें `update` ब्रांच से अपडेटेड मॉडल और एप्लिकेशन फ़ाइल खींचना, टोकन का उपयोग करके Hugging Face CLI में लॉग इन करना, मॉडल और एप्लिकेशन फ़ाइलों को पुश करना, और अंत में एप्लिकेशन को परिनियोजित करना शामिल है।
अपने मॉडल को परिनियोजित करने और उसे एक्सेस करने के लिए, हमें एक Gradio ऐप बनाना होगा। इस ऐप में शामिल होगा:
Interface फ़ंक्शन में देंगे और उसे लॉन्च करेंगे।import gradio as gr
import skops.io as sio
pipe = sio.load("./Model/drug_pipeline.skops", trusted=True)
def predict_drug(age, sex, blood_pressure, cholesterol, na_to_k_ratio):
""Predict drugs based on patient features.
Args:
age (int): Age of patient
sex (str): Sex of patient
blood_pressure (str): Blood pressure level
cholesterol (str): Cholesterol level
na_to_k_ratio (float): Ratio of sodium to potassium in blood
Returns:
str: Predicted drug label
"""
features = [age, sex, blood_pressure, cholesterol, na_to_k_ratio]
predicted_drug = pipe.predict([features])[0]
label = f"Predicted Drug: {predicted_drug}"
return label
inputs = [
gr.Slider(15, 74, step=1, label="Age"),
gr.Radio(["M", "F"], label="Sex"),
gr.Radio(["HIGH", "LOW", "NORMAL"], label="Blood Pressure"),
gr.Radio(["HIGH", "NORMAL"], label="Cholesterol"),
gr.Slider(6.2, 38.2, step=0.1, label="Na_to_K"),
]
outputs = [gr.Label(num_top_classes=5)]
examples = [
[30, "M", "HIGH", "NORMAL", 15.4],
[35, "F", "LOW", "NORMAL", 8],
[50, "M", "HIGH", "HIGH", 34],
]
title = "Drug Classification"
description = "Enter the details to correctly identify Drug type?"
article = "This app is a part of the Beginner's Guide to CI/CD for Machine Learning. It teaches how to automate training, evaluation, and deployment of models to Hugging Face using GitHub Actions."
gr.Interface(
fn=predict_drug,
inputs=inputs,
outputs=outputs,
examples=examples,
title=title,
description=description,
article=article,
theme=gr.themes.Soft(),
).launch()
टर्मिनल खोलें और रिमोट रिपॉज़िटरी पर बदलाव पुश करने से पहले समस्याएँ ठीक करने हेतु ऐप को लोकल रूप से चलाएँ।
python ./App/drug_app.py Running on local URL: http://127.0.0.1:7860
To create a public link, set `share=True` in `launch()`.हम अब Hugging Face टोकन जेनरेट करेंगे और उसे अपने Makefile स्क्रिप्ट को देंगे। हालाँकि, हमें यह सुनिश्चित करना होगा कि टोकन गोपनीय रहे और किसी को लीक न हो। इसे हासिल करने के लिए, हम GitHub सीक्रेट्स का उपयोग करेंगे।
सबसे पहले, अपनी Hugging Face प्रोफ़ाइल पिक्चर पर क्लिक करें और सेटिंग्स विकल्प चुनें। फिर "Access Tokens" विकल्प चुनें और टोकन जेनरेट करने के लिए "New Token" बटन पर क्लिक करें। टोकन बनाते समय, सुनिश्चित करें कि उसके पास write परमिशन हो।
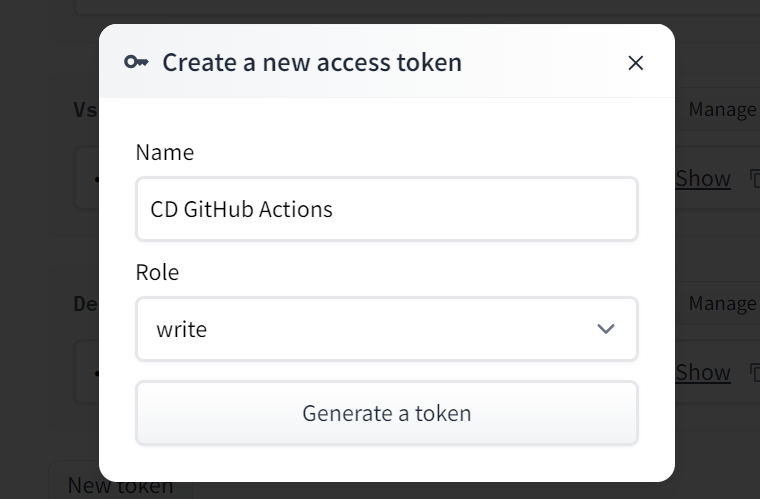
टोकन कॉपी करें और यूज़र नेम व ईमेल की तरह ही एक Repository सीक्रेट बनाएँ।
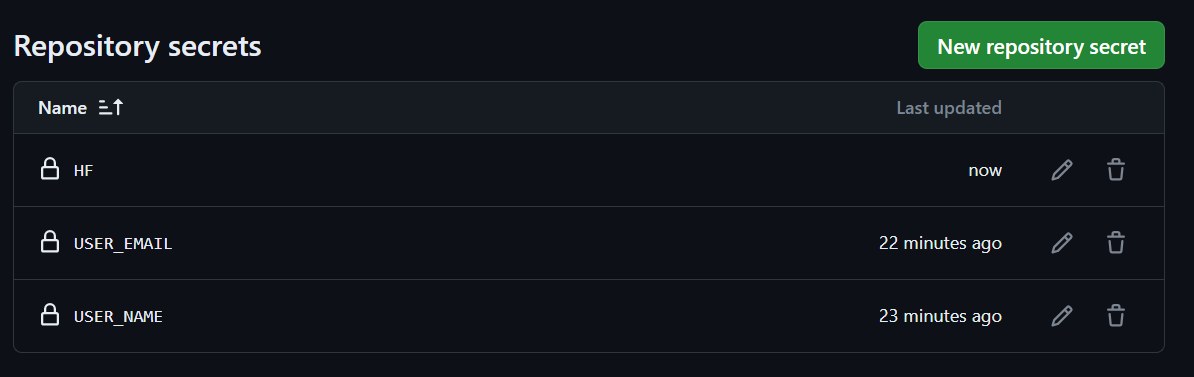
इस सेक्शन में, हम फ़ाइलें बनाने के लिए तीन नए कमांड जोड़ेंगे और "Continuous Deployment" नामक एक और GitHub वर्कफ़्लो बनाएँगे। यह वर्कफ़्लो फ़ाइलों को खींचने और परिनियोजित करने की प्रक्रिया को स्वचालित करने में मदद करेगा।
update ब्रांच से अपडेटेड मॉडल और परिणाम फ़ाइलें पुल करें और update ब्रांच पर स्विच करें।deploy कमांड पहले hf-login चलाएगा और फिर push-hub।hf-login:
git pull origin update
git switch update
pip install -U "huggingface_hub[cli]"
huggingface-cli login --token $(HF) --add-to-git-credential
push-hub:
huggingface-cli upload kingabzpro/Drug-Classification ./App --repo-type=space --commit-message="Sync App files"
huggingface-cli upload kingabzpro/Drug-Classification ./Model /Model --repo-type=space --commit-message="Sync Model"
huggingface-cli upload kingabzpro/Drug-Classification ./Results /Metrics --repo-type=space --commit-message="Sync Model"
deploy: hf-login push-hubहमारे एप्लिकेशन को अपडेटेड मॉडल, एप्लिकेशन फ़ाइल, और परिणामों तक पहुँच होगी, जिससे हम Hugging Face Space में बदलावों को ट्रैक कर सकेंगे।
अपने वर्कफ़्लो को सचमुच CI/CD बनाने के लिए, हमें ci.yml जैसी एक और फ़ाइल cd.yml बनानी होगी। एक बार CI पाइपलाइन पूरी हो जाने के बाद, यह on आर्ग्युमेंट में workflow_run पैरामीटर का उपयोग करके cd.yml वर्कफ़्लो को शुरू करेगी।
यह वर्कफ़्लो एनवायरनमेंट बनाएगा और Hugging Face टोकन का उपयोग करके नवीनतम बदलावों को Hugging Face Hub पर परिनियोजित करने के लिए make deploy कमांड चलाएगा।
name: Continuous Deployment
on:
  workflow_run:
    workflows: ["Continuous Integration"]
    types:
      - completed

  workflow_dispatch:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: Deployment To Hugging Face
        env:
          HF: ${{ secrets.HF }}
        run: make deploy HF=$HF
जब हम मुख्य ब्रांच पर बदलाव पुश करेंगे, तो यह CI वर्कफ़्लो से शुरू होगा।
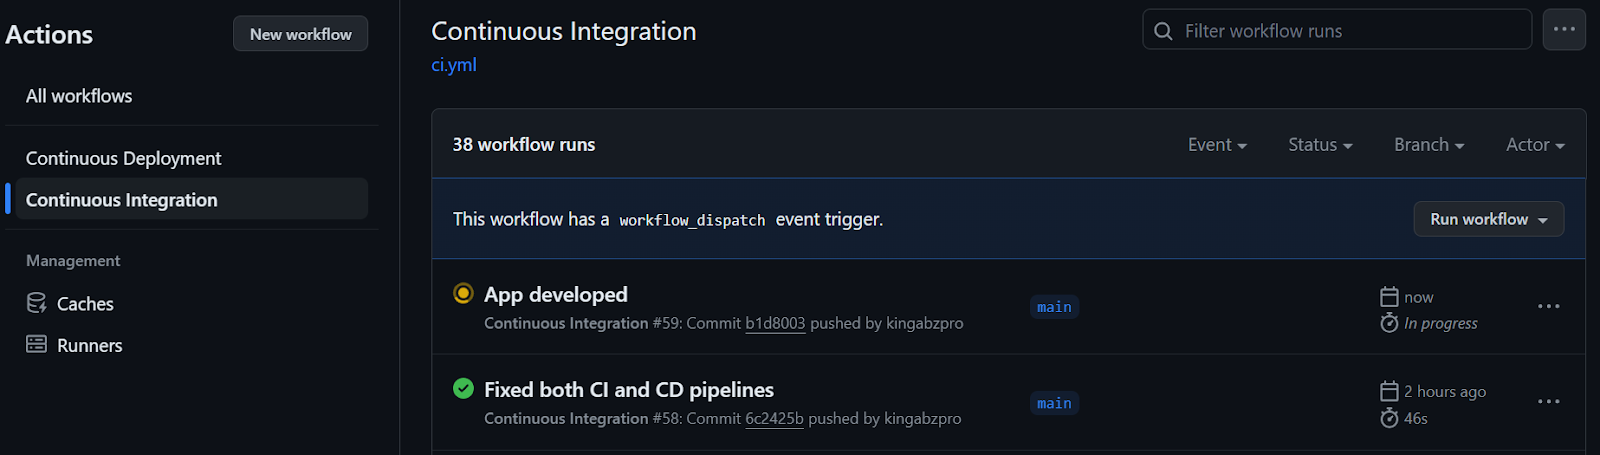
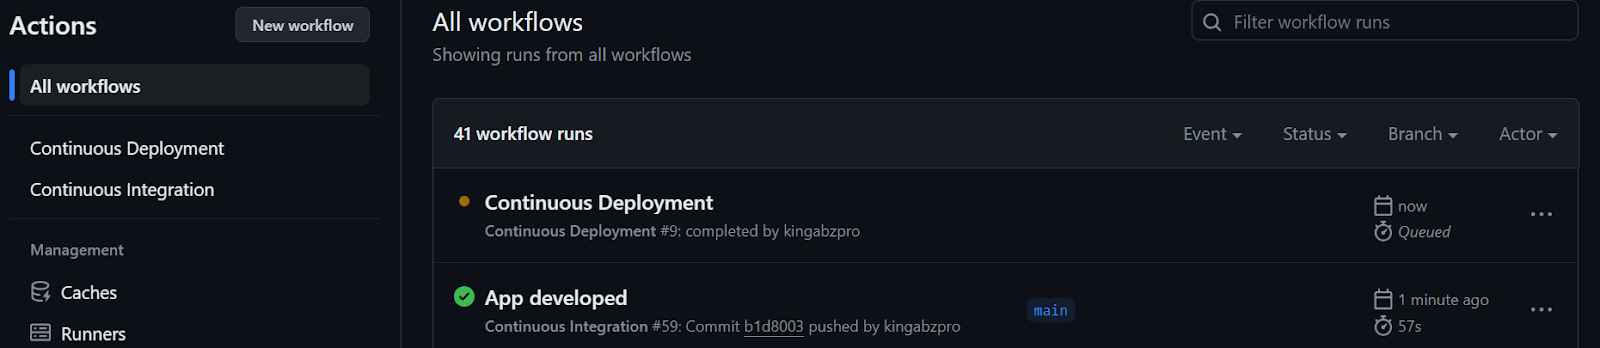
CI वर्कफ़्लो पूरा होने के बाद, नीचे दिखाए अनुसार CD वर्कफ़्लो शुरू होगा।
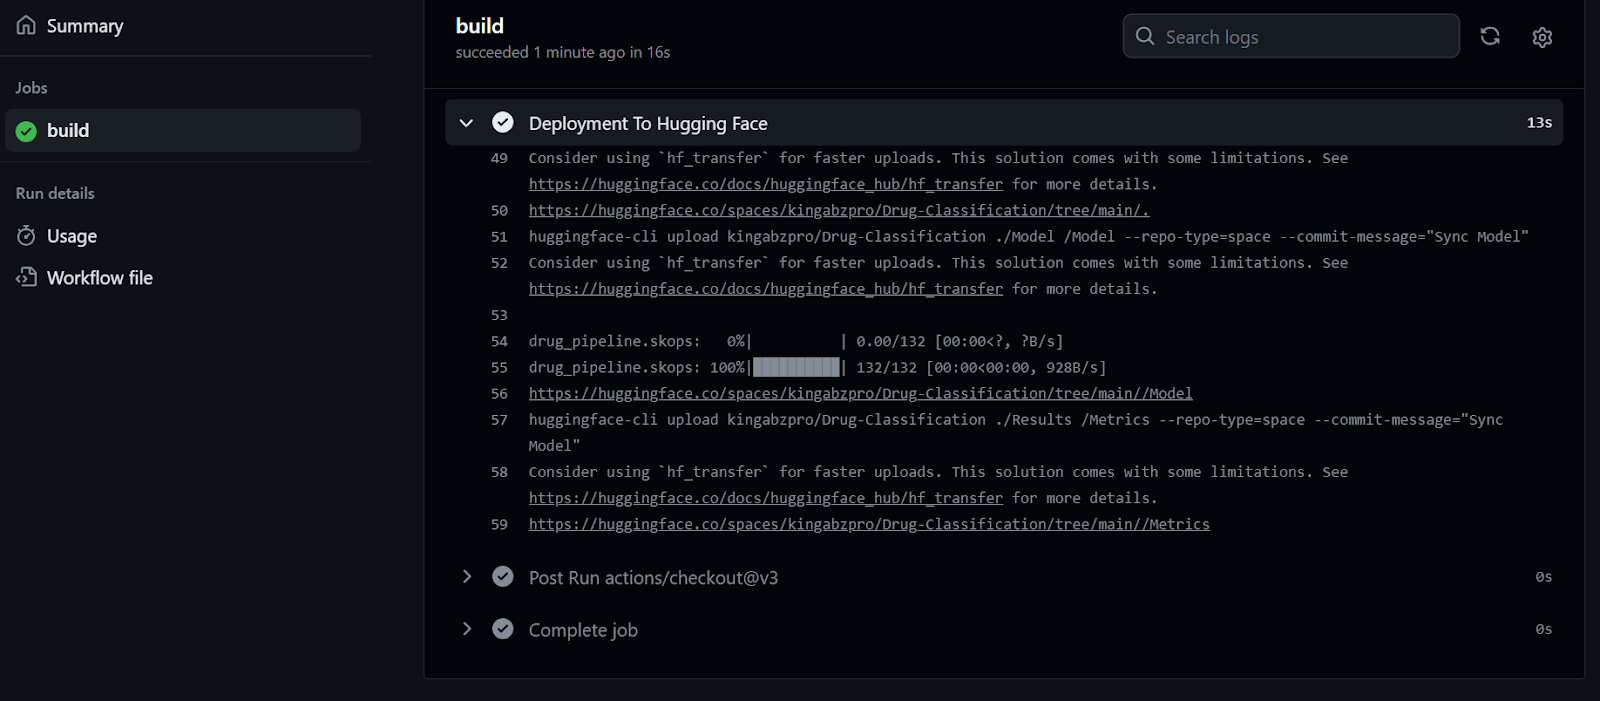
हम वर्कफ़्लो बिल्ड में रन विकल्प चुनकर प्रत्येक फ़ंक्शन के लाइव लॉग देख सकते हैं। हमारी फ़ाइलें सफलतापूर्वक Hugging Face सर्वर पर अपलोड हो गई हैं।
अपडेटेड फ़ाइल मिलने के बाद, Hugging Face Space एनवायरनमेंट बनाना शुरू करेगा, और कुछ ही सेकंड में ऐप चलने लगेगा।
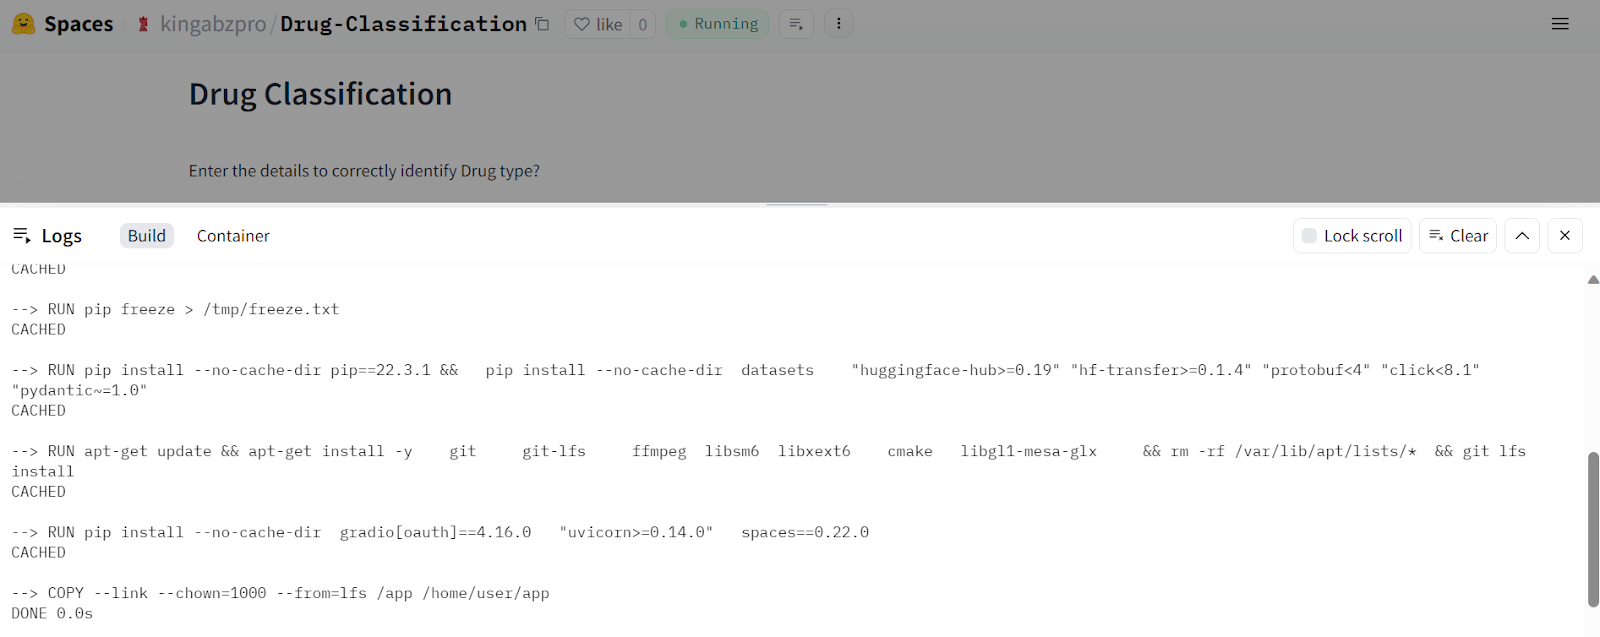
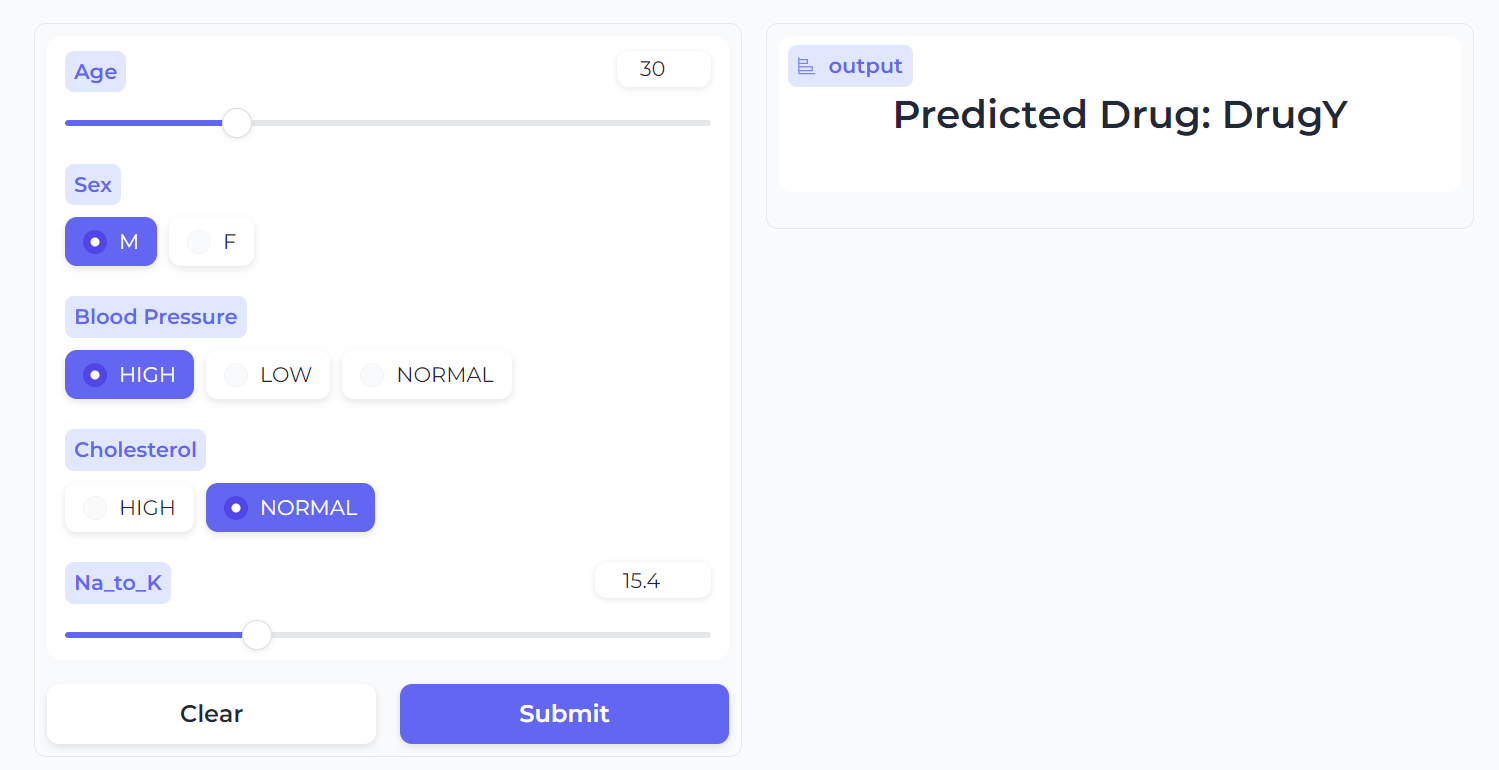
हमारा Drug Classification एप्लिकेशन बिना किसी रुकावट के काम करता है और एक सुंदर इंटरफ़ेस रखता है।
मॉडल के प्रदर्शन का अनुभव लेने के लिए अलग-अलग डेटा डालकर देखें।
छवि स्रोत
यह गाइड दर्शाता है कि हमने प्रशिक्षण, मूल्यांकन, वर्ज़निंग और परिनियोजन प्रक्रियाओं को कैसे स्वचालित किया है, ताकि डेटा या एल्गोरिद्म में किसी भी बदलाव से यह प्रक्रिया स्वतः त्रुटि-रहित रूप से ट्रिगर हो जाए। यह दृष्टिकोण हमें तेज़, स्केलेबल और प्रोडक्शन-रेडी एप्लिकेशन बनाने में मदद करता है।
कृपया ध्यान दें कि वास्तविक दुनिया के प्रोजेक्ट्स में हम मशीन लर्निंग एप्लिकेशन के ऑर्केस्ट्रेशन, वर्ज़निंग, परिनियोजन और मॉनिटरिंग के लिए कई MLOps टूल्स का उपयोग करते हैं। इन टूल्स के बारे में और जानने के लिए Top MLOps Tools You Need to Know देखें, जो बड़ी टेक कंपनियों द्वारा अपने ML एप्लिकेशन को सुव्यवस्थित करने के लिए उपयोग की जाने वाली लोकप्रिय तकनीकों को रेखांकित करता है।
अपनी CI/CD पाइपलाइन को अनुकूलित करने के लिए Docker, Kubernetes, Azure Cloud, और अन्य MLOps तकनीकों जैसे टूल्स सीखना महत्वपूर्ण है। उद्योग-मानक प्रथाओं से परिचित होने और उन्नत प्रोजेक्ट्स पर काम करने के लिए Machine Learning, Pipelines, Deployment, and MLOps ट्यूटोरियल का पालन करें।
आज ही अपनी मशीन लर्निंग यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स