
Cours
Comprendre le Machine Learning
2 h
308.2K
L’intégration continue (CI) et le déploiement continu (CD) sont des pratiques courantes en développement logiciel pour automatiser l’intégration des changements de code, leur test et le déploiement rapide des applications mises à jour. À l’origine conçues pour les applications logicielles classiques, elles deviennent désormais essentielles aussi pour les projets d’apprentissage automatique (ML).
Dans ce guide complet, nous allons découvrir le CI/CD pour le ML et apprendre à construire notre propre pipeline de machine learning qui automatisera l’entraînement, l’évaluation et le déploiement du modèle.
Ce guide présente un projet simple qui s’appuie uniquement sur GitHub Actions pour automatiser l’ensemble du processus. La plupart des éléments abordés sont familiers aux ingénieurs en machine learning et aux data scientists. La nouveauté réside ici dans l’usage de GitHub Actions, Makefile, CML et Hugging Face CLI.
Inscrivez-vous au cours MLOps Concepts pour apprendre à faire passer des modèles de machine learning de notebooks locaux à des modèles de production qui génèrent de la valeur métier.
Le CI/CD change la donne lorsqu’il s’agit d’opérationnaliser un modèle et d’en faire un produit. En industrialisant l’automatisation, vous obtenez une solution fiable, rapide et scalable pour votre projet ML, ce qui vous permet de vous concentrer sur l’amélioration du modèle plutôt que sur la gestion et le déploiement.
Concrètement, le CI/CD pour le machine learning apporte :
Avec le CI/CD, vous pouvez réentraîner automatiquement vos modèles sur de nouvelles données à intervalles réguliers, gagnant ainsi du temps par rapport à un déclenchement manuel.
Les outils de CI exécutent des tests et des vérifications à chaque commit, ce qui permet d’identifier les bugs, les problèmes d’intégration et les baisses de performance du modèle.
Le CI/CD garantit que les modèles peuvent être reconstruits et réentraînés à l’identique, assurant la reproductibilité des résultats. Les environnements, le versioning des modèles et des données, ainsi que les configurations, sont codifiés.
Le CI/CD permet de tester automatiquement les nouveaux modèles avant leur déploiement pour repérer d’éventuels problèmes. Il facilite aussi une meilleure supervision post-déploiement via l’intégration à des outils de monitoring.
De nouvelles versions de modèles ou des expérimentations peuvent être entraînées, testées et déployées rapidement de manière automatisée grâce au CI/CD. Le développement et l’amélioration des systèmes ML s’en trouvent accélérés.
À mesure que le projet ML gagne en taille et en complexité, gérer manuellement tout le cycle de vie devient irréaliste. Les pipelines CI/CD offrent une solution scalable capable de traiter de gros volumes de données, de nombreux modèles et des dépendances hétérogènes tout en préservant efficacité et fiabilité.
Dans ce guide, nous vous accompagnons pas à pas pour créer les comptes et environnements, mettre en place un pipeline CI/CD et optimiser l’ensemble du processus.
Nous utiliserons des pipelines scikit-learn pour entraîner un algorithme de forêts aléatoires et construire un classifieur de médicaments. Après l’entraînement, nous automatiserons l’évaluation avec CML. Enfin, nous construirons et déploierons l’application web sur Hugging Face Hub.
De l’entraînement à l’évaluation, l’ensemble sera automatisé avec GitHub Actions. Il vous suffira de pousser le code sur votre dépôt GitHub et, en moins de deux minutes, le modèle, l’application et les résultats seront mis à jour sur Hugging Face.
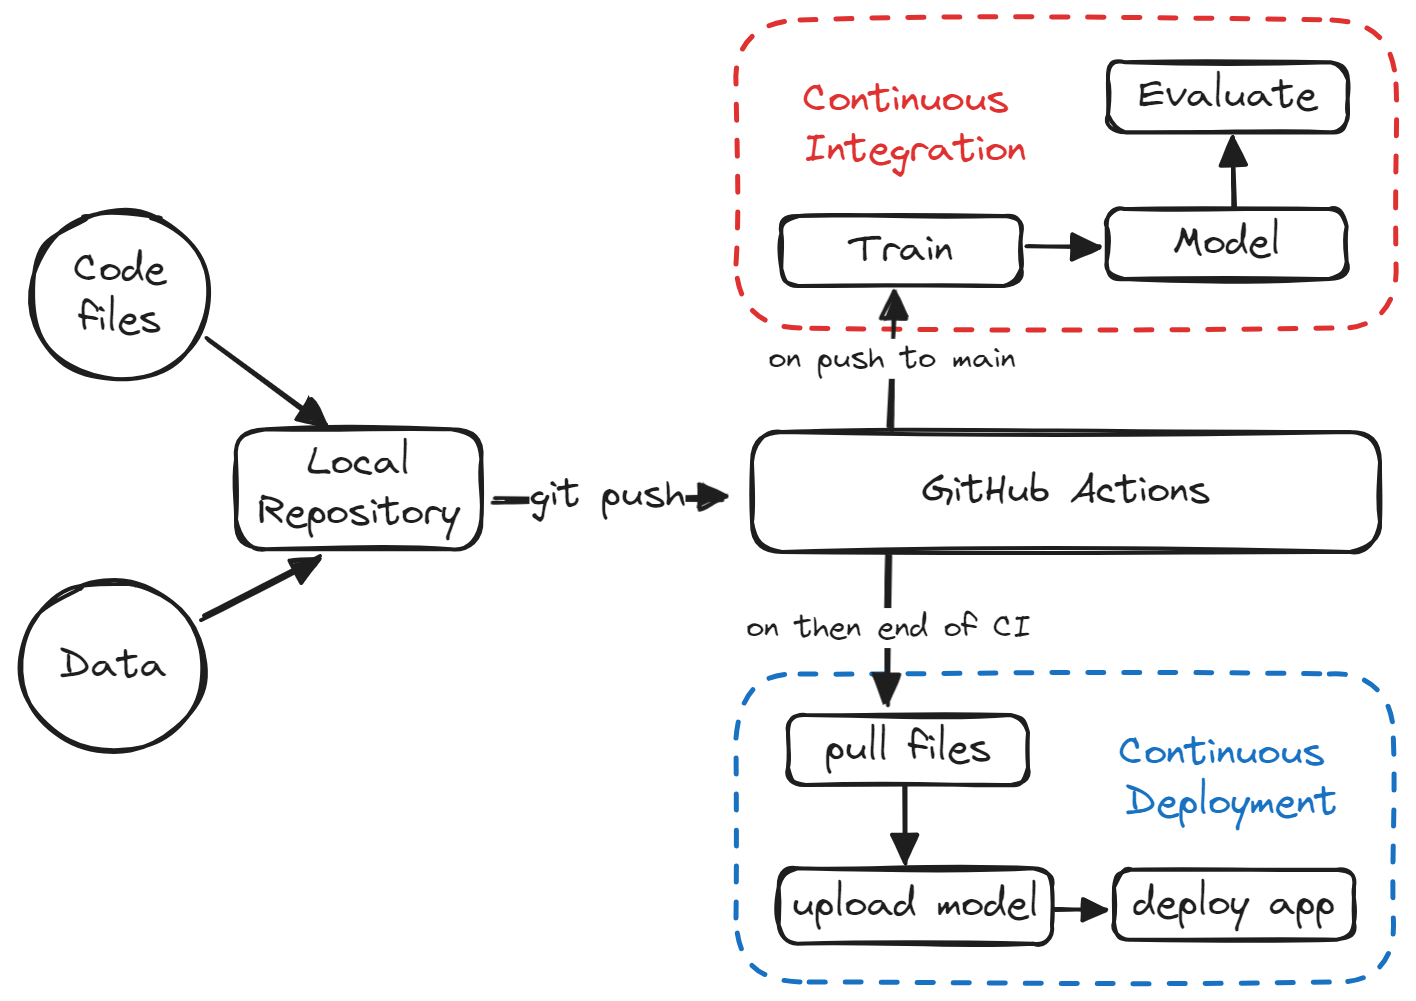
Pour aller plus loin via des exercices interactifs, suivez le cours de DataCamp CI/CD for Machine Learning et donnez un coup d’accélérateur à votre développement ML avec GitHub Actions et Data Version Control.
Dans cette section, nous allons créer un dépôt GitHub, les dossiers et fichiers nécessaires, ainsi qu’un Space sur Hugging Face.
Cliquez sur le bouton « + » en haut à droite de la page d’accueil de GitHub et sélectionnez « New repository ».
Ajoutez le nom et la description du dépôt, cochez le fichier README et définissez .gitignore sur Python.
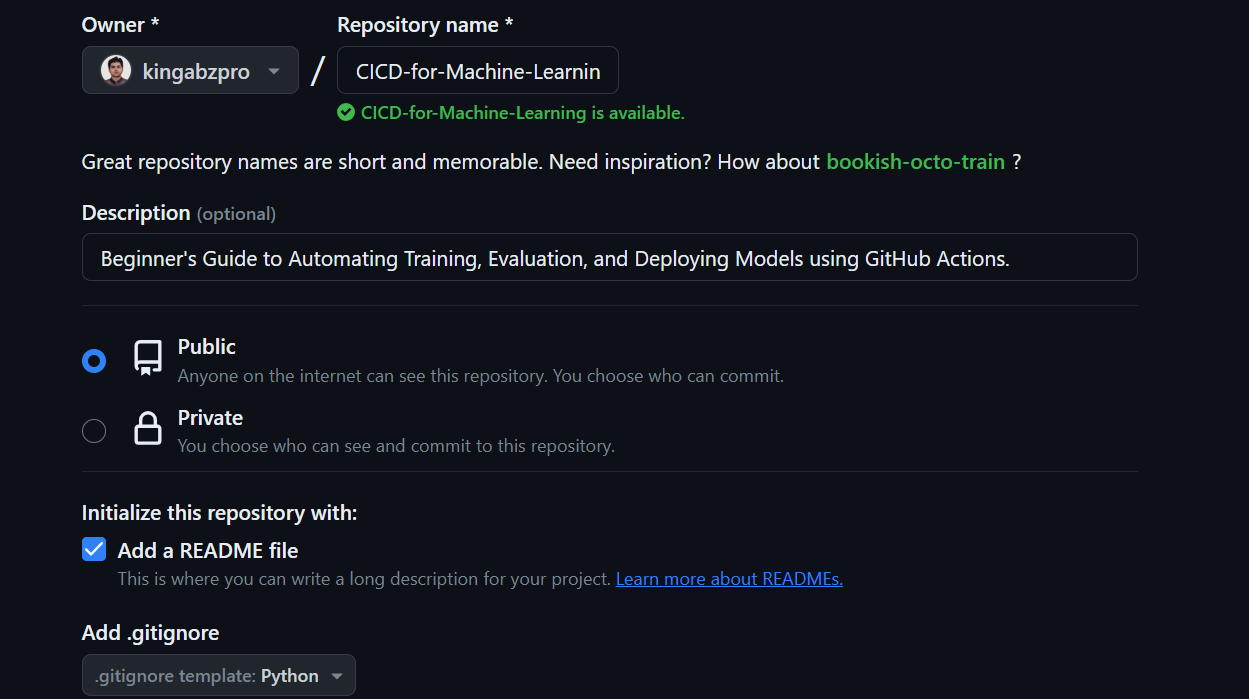
Après avoir créé le dépôt, copiez son URL. Ouvrez ensuite le terminal ou bash et rendez-vous dans le répertoire où vous souhaitez stocker le dossier du projet.
Pour finir, clonez le dépôt avec la commande suivante :
git clone https://github.com/kingabzpro/CICD-for-Machine-Learning.gitPour démarrer, ouvrez le dépôt local avec votre IDE préféré. Nous vous recommandons VSCode pour ce projet. Une fois l’IDE lancé, vous verrez un espace de travail VSCode contenant des fichiers comme README et LICENSE.
Créons un Hugging Face Space que nous utiliserons pour déployer notre application avec le fichier de modèle.
1. Cliquez sur votre photo de profil et sélectionnez « New Space ».
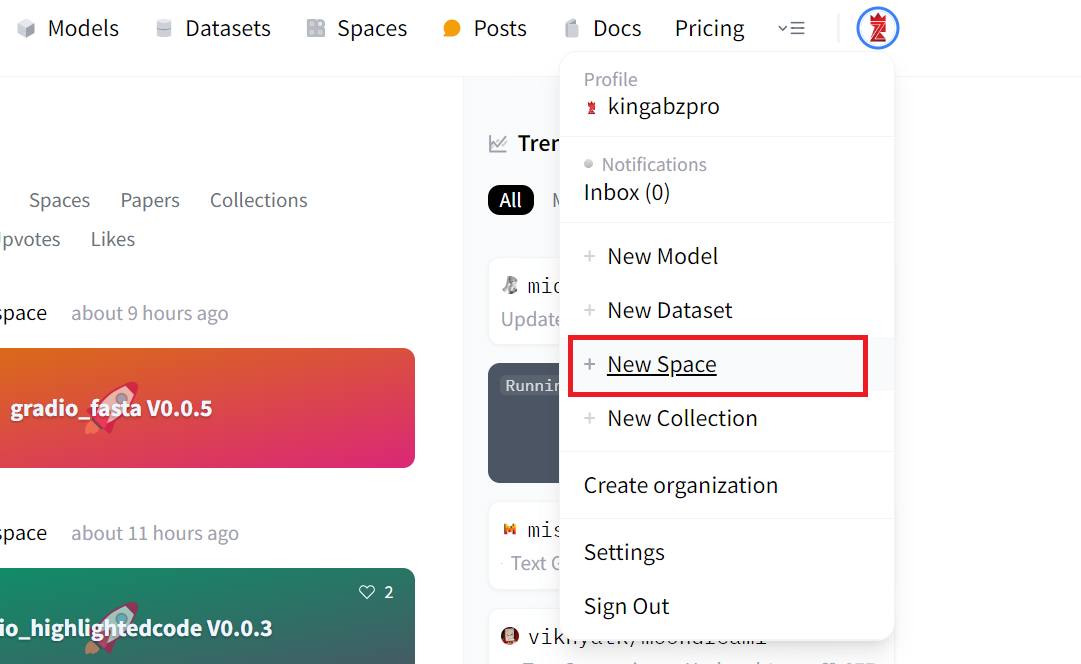
2. Ajoutez le nom du Space, la licence, le type de SDK, puis créez le Space.
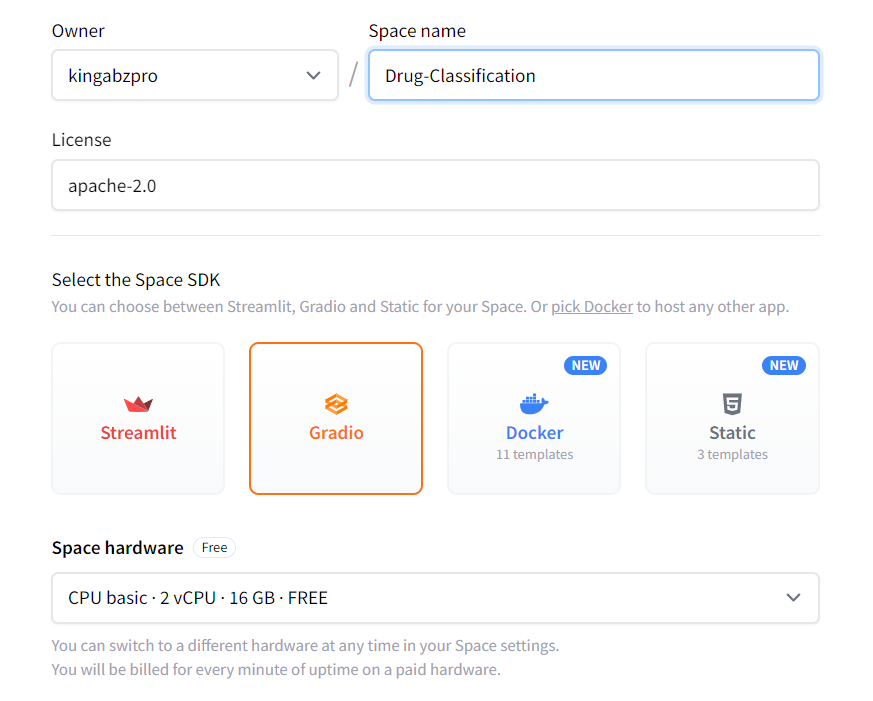
3. Pour modifier le fichier README.md, cliquez sur les trois points en haut à gauche, sélectionnez Files et effectuez les changements nécessaires.
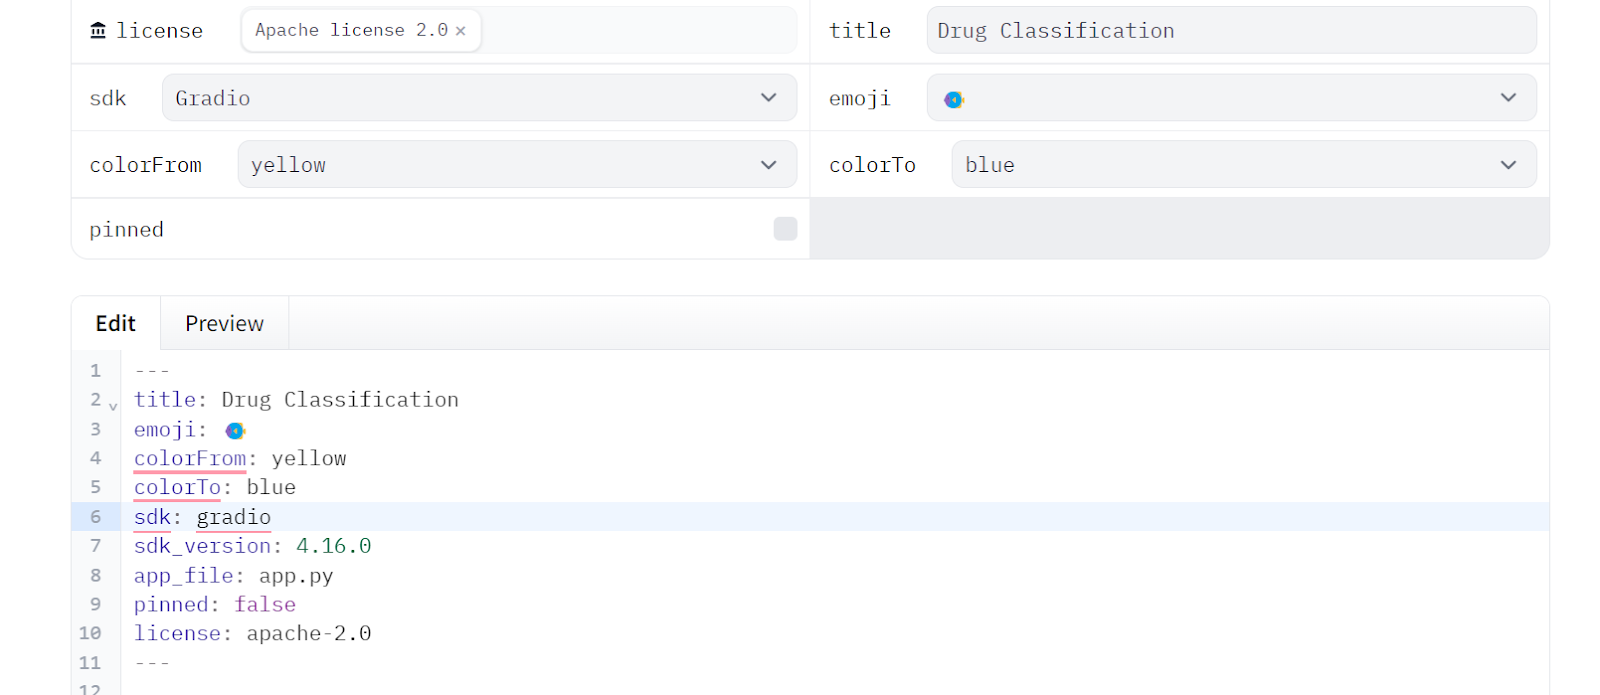
4. Copiez les métadonnées du README du Space et collez-les dans votre README local qui restera dans le dossier App.
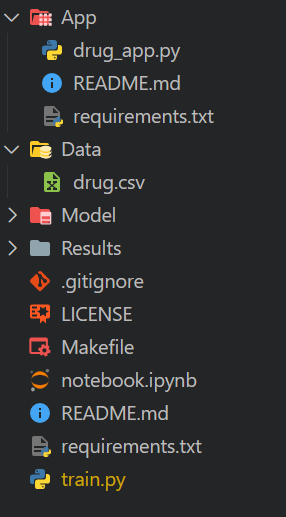
Nous devons créer les dossiers et fichiers nécessaires avant d’expérimenter et de construire les pipelines. Cela nous aidera à garder un espace de travail propre sur la durée.
Créez un fichier Python nommé drug_app.py, ainsi qu’un fichier README.md et un fichier requirements.txt, puis déplacez-les dans le dossier App. Cela facilitera l’organisation de tous les fichiers nécessaires à l’exécution de l’application.
Ensuite, modifiez le fichier README.md du dossier App et assurez-vous d’adapter les métadonnées et leur versionnage. Vous pourrez ainsi pointer facilement vers l’emplacement des fichiers de l’app, changer les couleurs, définir la version du SDK et ajouter les informations de licence.
---
title: Drug Classification
emoji: 💊
colorFrom: yellow
colorTo: red
sdk: gradio
sdk_version: 4.16.0
app_file: drug_app.py
pinned: false
license: apache-2.0
---
Modifiez le fichier requirement.txt dans le dossier App pour y ajouter les paquets Python manquants :
scikit-learn
skops
Remarque : les fichiers requirement et README diffèrent entre le dépôt GitHub et le Hugging Face Space.
Téléchargez le jeu de données Drug Classification depuis Kaggle, extrayez le fichier CSV et déplacez-le dans le dossier Data.
Les dossiers Model et Results resteront vides : ils seront alimentés par le script Python que nous exécuterons.
Makefile pour simplifier l’exécution du script dans le workflow GitHub Action.notebook.ipynb. Nous y expérimenterons nos algorithmes et pipelines de traitement.requirements.txt. Il servira à configurer l’environnement lors de l’exécution des jobs du workflow CI.train.py. Il contiendra le code Python de chargement et de préparation des données, ainsi que l’entraînement, l’évaluation et l’enregistrement du modèle et des métriques de performance.Voici à quoi devrait ressembler notre arborescence :
Dans cette partie, nous allons créer du code Python qui prépare les données et entraîne un modèle avec un pipeline scikit-learn. Nous l’évaluerons ensuite et enregistrerons les résultats et le modèle.
Nous utiliserons pandas pour charger le fichier CSV, le mélanger avec la fonction sample et afficher les trois premières lignes.
import pandas as pd

drug_df = pd.read_csv("Data/drug.csv")
drug_df = drug_df.sample(frac=1)
drug_df.head(3)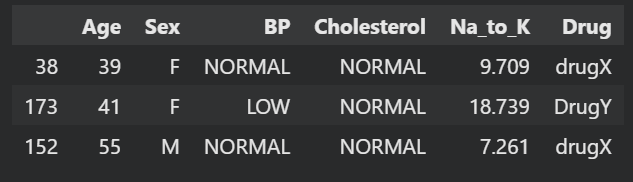
Créez la variable dépendante et les variables indépendantes, puis séparez-les en ensembles d’entraînement et de test. Cela vous aidera à évaluer les performances du modèle.
from sklearn.model_selection import train_test_split

X = drug_df.drop("Drug", axis=1).values
y = drug_df.Drug.values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=125
)Nous allons construire un pipeline de traitement avec ColumnTransformer, qui convertira les variables catégorielles en valeurs numériques, imputera les valeurs manquantes et mettra à l’échelle les colonnes numériques.
Ensuite, nous créerons un pipeline d’entraînement qui prendra les données transformées et entraînera un classifieur Random Forest.
Enfin, nous entraînerons le modèle.
L’utilisation de pipelines garantit la reproductibilité, la modularité et la clarté du code.
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OrdinalEncoder, StandardScaler

cat_col = [1,2,3]
num_col = [0,4]

transform = ColumnTransformer(
    [
        ("encoder", OrdinalEncoder(), cat_col),
        ("num_imputer", SimpleImputer(strategy="median"), num_col),
        ("num_scaler", StandardScaler(), num_col),
    ]
)
pipe = Pipeline(
    steps=[
        ("preprocessing", transform),
        ("model", RandomForestClassifier(n_estimators=100, random_state=125)),
    ]
)
pipe.fit(X_train, y_train)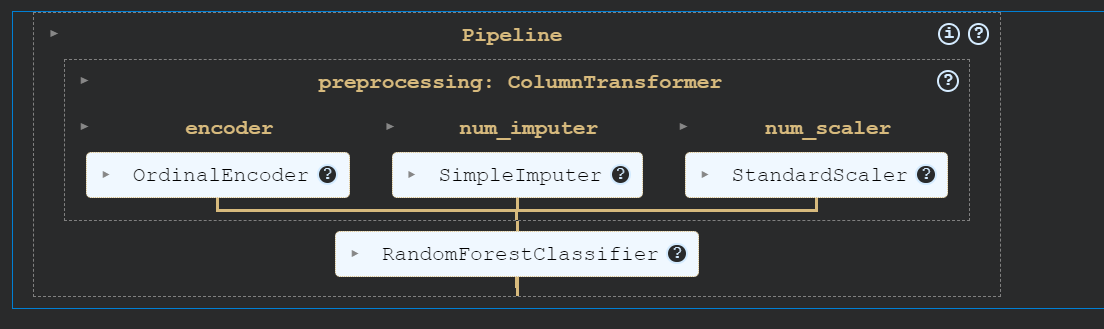
Évaluez les performances du modèle en calculant la précision (accuracy) et le score F1.
from sklearn.metrics import accuracy_score, f1_score

predictions = pipe.predict(X_test)
accuracy = accuracy_score(y_test, predictions)
f1 = f1_score(y_test, predictions, average="macro")

print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))
Notre modèle s’est montré particulièrement performant.
Accuracy: 95.0% F1: 0.91Créez le fichier de métriques et enregistrez-le dans le dossier Results.
with open("Results/metrics.txt", "w") as outfile:
    outfile.write(f"\nAccuracy = {accuracy.round(2)}, F1 Score = {f1.round(2)}.")
Nous allons ensuite créer la matrice de confusion et enregistrer l’image dans le dossier Results.
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix

cm = confusion_matrix(y_test, predictions, labels=pipe.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=pipe.classes_)
disp.plot()
plt.savefig("Results/model_results.png", dpi=120)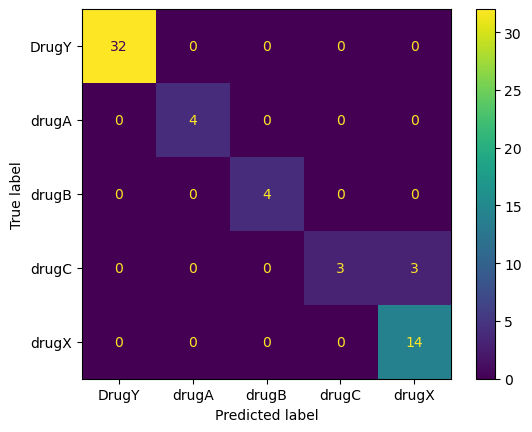
Nous allons maintenant enregistrer notre modèle à l’aide du paquet Python skops. Cela nous permet de sauvegarder à la fois le pipeline scikit-learn et le modèle.
import skops.io as sio

sio.dump(pipe, "Model/drug_pipeline.skops")
Vous pourrez charger l’ensemble du pipeline : il fonctionnera immédiatement, sans retraiter les données ni modifier le code.
sio.load("Model/drug_pipeline.skops", trusted=True)
Copiez-collez l’intégralité du code dans le fichier « train.py ». Ce sera le script d’entraînement standardisé exécuté dans le workflow CI à chaque changement de données ou de code.
Avant de vous lancer dans une carrière d’ingénieur MLOps, lisez la MLOps Roadmap : le guide carrière complet.
Dans cette section, nous allons couvrir CML, Makefile et la configuration des workflows GitHub Actions pour automatiser l’entraînement, l’évaluation et le versioning de notre projet.
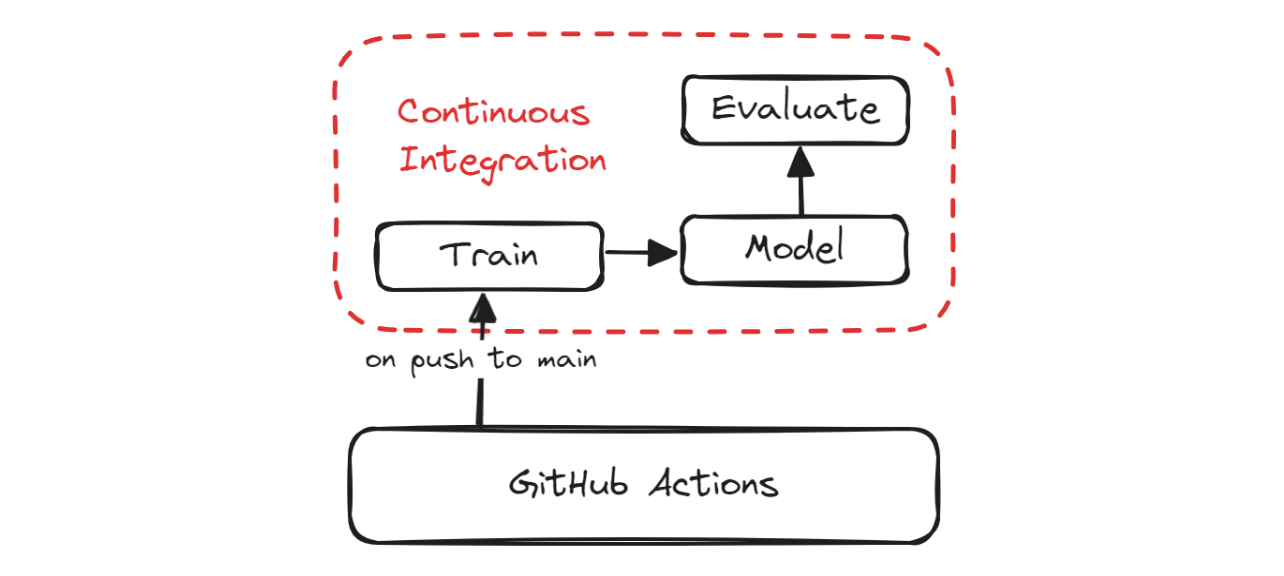
Pipeline CI
Continuous Machine Learning (CML) est une bibliothèque open source qui permet d’implémenter l’intégration continue dans vos projets de machine learning. Nous utiliserons l’action GitHub « iterative/setup-cml » qui exploite CML dans le workflow pour automatiser la génération du rapport d’évaluation du modèle.
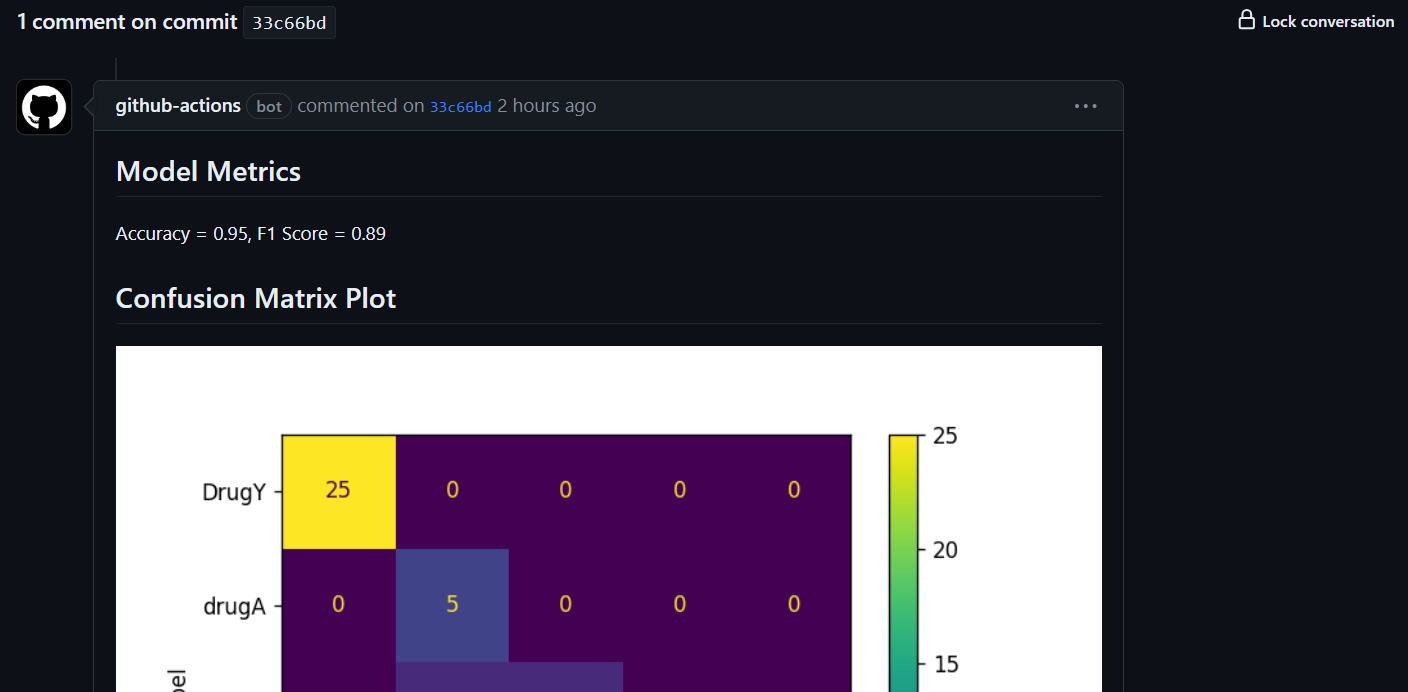
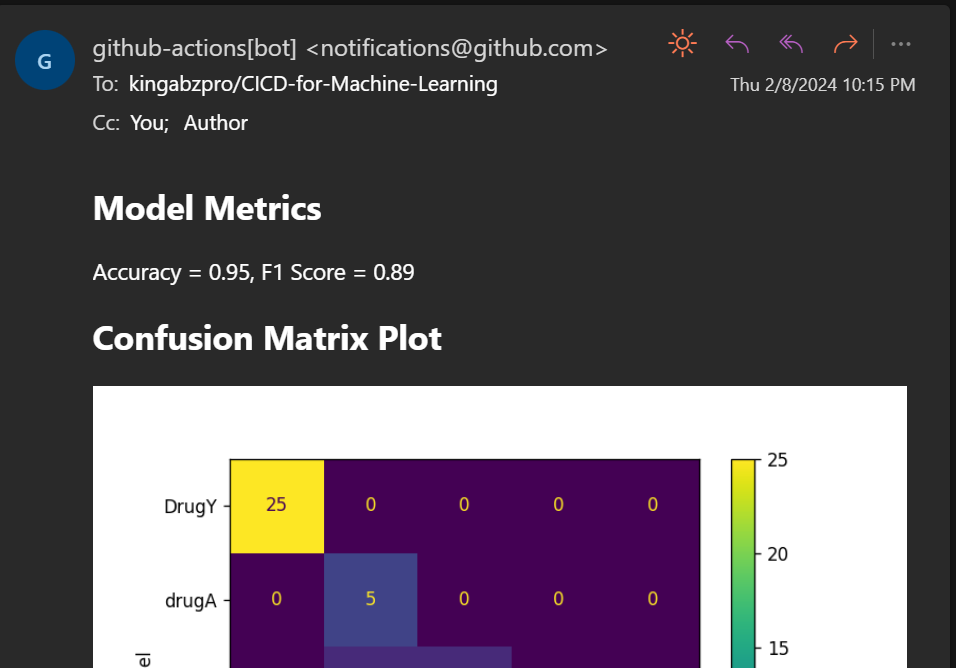
Concrètement : à chaque push sur GitHub, un rapport sera généré sous le commit et vous recevrez un e-mail avec les métriques de performance et la matrice de confusion.
Un Makefile est un fichier contenant un ensemble d’instructions utilisées par la commande make pour automatiser diverses tâches : compilation, tests, préparation d’environnements, prétraitement des données, entraînement/évaluation des modèles et déploiement.
Nous pouvons utiliser des commandes make pour exécuter plusieurs scripts et garder le fichier de workflow CI clair et simple. Le Makefile contient le nom des groupes de commandes et les scripts associés.
Voici notre Makefile :
install:
pip install --upgrade pip &&\
pip install -r requirements.txt
format:
black *.py
train:
python train.py
eval:
echo "## Model Metrics" > report.md
cat ./Results/metrics.txt >> report.md
echo '\n## Confusion Matrix Plot' >> report.md
echo '' >> report.md
cml comment create report.mdNous avons des commandes pour installer les paquets Python (install), formater le code (format), entraîner (train) et générer les rapports CML (eval).
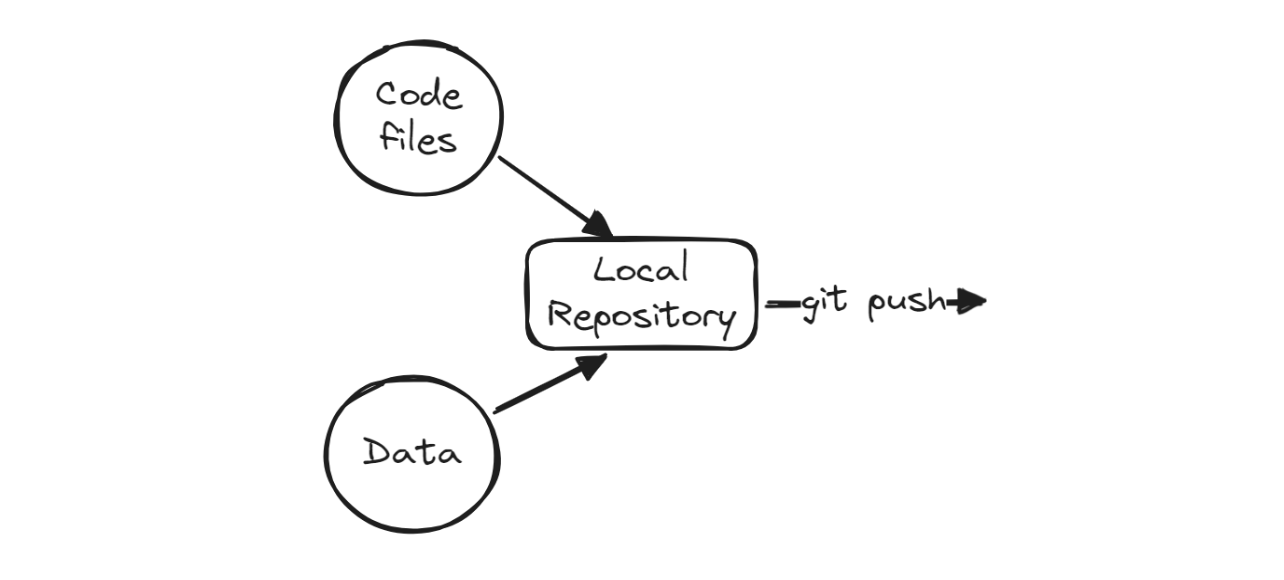
Ensuite, ajoutez les changements, créez un commit et poussez-les sur le serveur distant GitHub.
git commit -am "new changes"
git push origin mainPour automatiser l’entraînement et l’évaluation, nous devons créer un workflow GitHub Action. Pour cela, allez dans l’onglet « Actions » de notre dépôt kingabzpro/CICD-for-Machine-Learning et cliquez sur le lien bleu « set up a workflow yourself. »
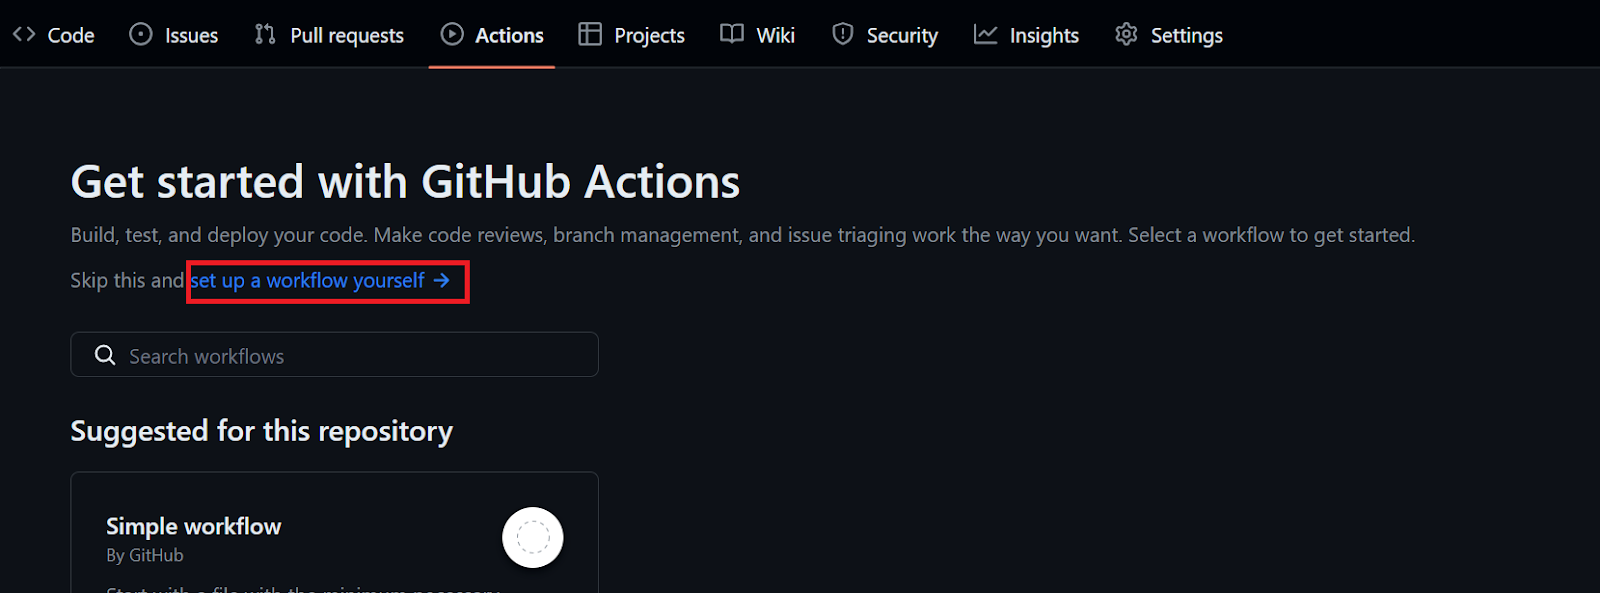
Renommez le fichier .yml en « ci » et commencez à ajouter les commandes GitHub Action.
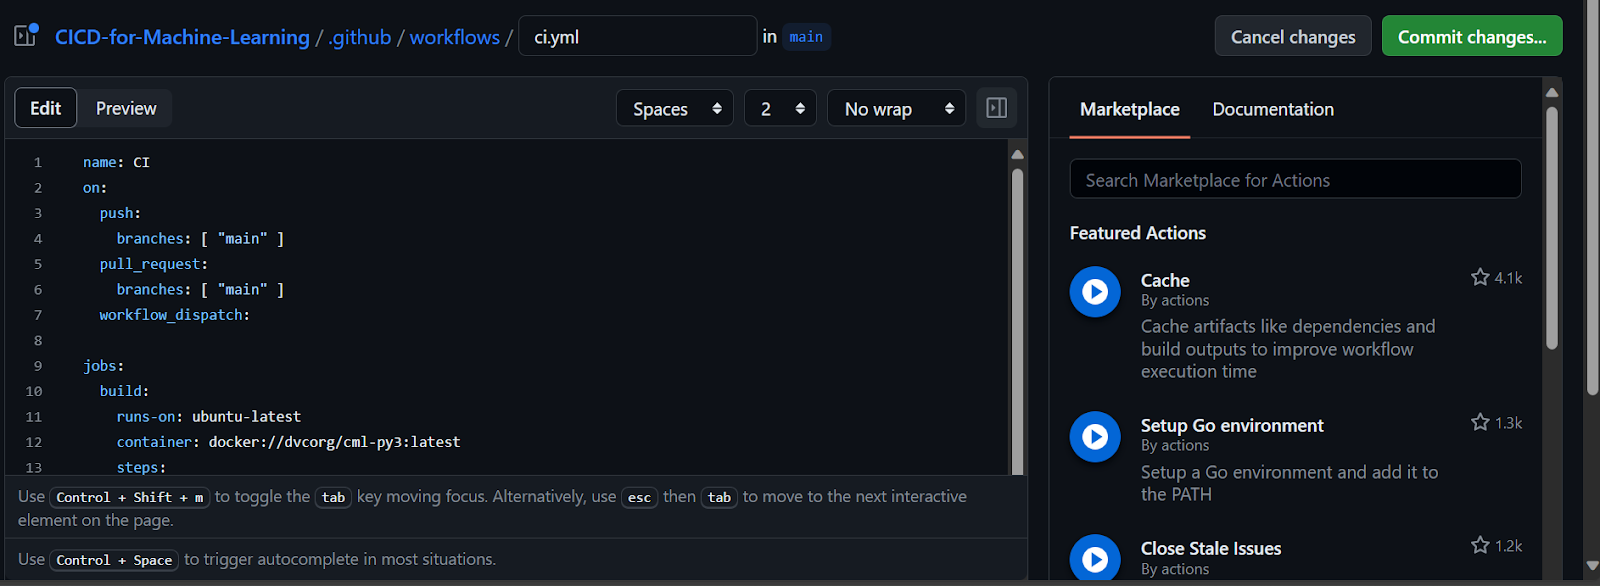
Vous rencontrerez des erreurs en apprenant la syntaxe ; c’est pourquoi il est important de lire la syntaxe des workflows GitHub Actions avant de vous lancer.
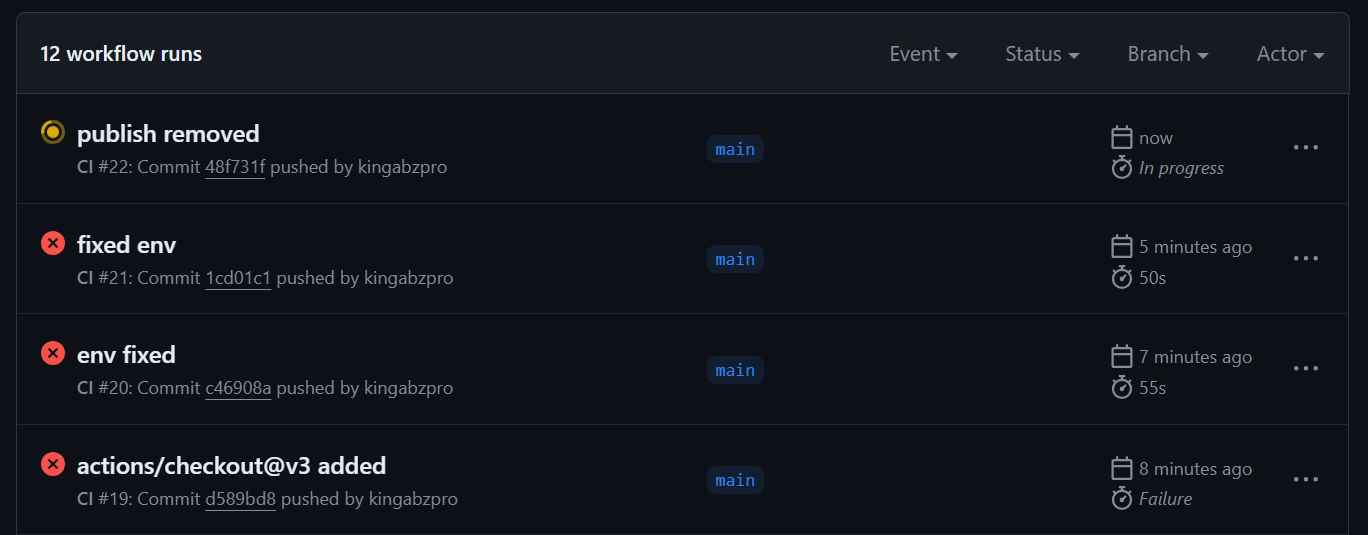
Nous avons corrigé toutes les erreurs du workflow et disposons maintenant d’une version finale de « ci.yml » qui s’exécute sans accroc.
Comme vous pouvez le constater, le workflow commence par configurer l’environnement et charger les actions nécessaires. Ensuite, chaque étape est exécutée séquentiellement via make, qui appelle en arrière-plan différents scripts Python et Bash.
Deux points importants avec les actions CML : d’abord, définir les permissions d’écriture dès le début. Ensuite, fournir un jeton GitHub au job CML, accessible via les secrets.
name: Continuous Integration
on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]
  workflow_dispatch:

permissions: write-all
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v2
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Train
        run: make train
      - name: Evaluation
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
        run: make eval
Les métriques et résultats apparaissent sous le message de commit.
Vous recevrez également un e-mail avec les résultats.
Nous générons le rapport d’évaluation, mais nous ne versionnons pas le modèle et les résultats. Pour enregistrer les changements, nous allons créer une nouvelle branche « update » et y pousser le modèle et les résultats mis à jour.
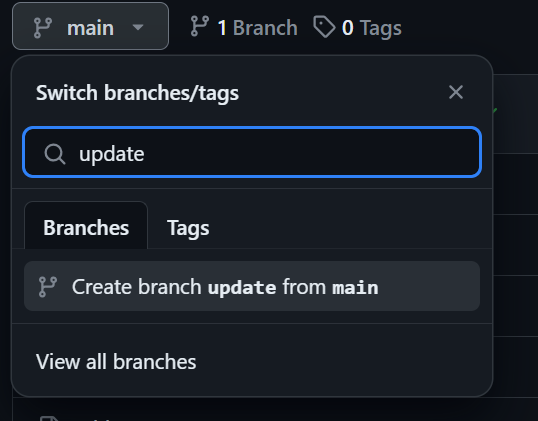
Créez la branche « update » en cliquant sur le bouton de branche principale, saisissez « update » comme nom, puis sélectionnez « create branch update from main ».
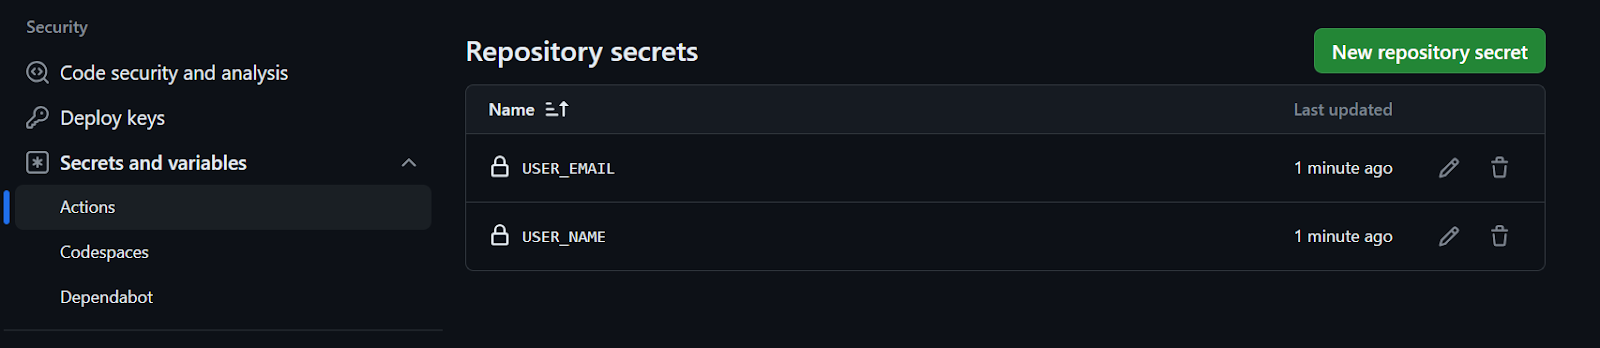
Pour committer et pousser des changements via Git, nous devons fournir un nom d’utilisateur et un e-mail. Vous pouvez les ajouter directement, mais il est préférable d’utiliser les secrets GitHub. Procédez ainsi :
Et voilà !
Pour automatiser l’enregistrement des changements dans la nouvelle branche, nous devons mettre à jour le Makefile et ci.yml.
Makefile :
Nous configurons le nom d’utilisateur et l’e-mail, créons le commit et enregistrons le tout dans la branche update.
update-branch:
	git config --global user.name $(USER_NAME)
	git config --global user.email $(USER_EMAIL)
	git commit -am "Update with new results"
	git push --force origin HEAD:update
ci.yml :
Le Makefile utilise une variable d’environnement pour exécuter le script. Il faut donc d’abord extraire la valeur depuis les secrets, puis définir la variable à la fin de la commande make.
    - name: Update Branch
        env:
          NAME: ${{ secrets.USER_NAME }}
          EMAIL: ${{ secrets.USER_EMAIL }}
        run: make update-branch USER_NAME=$NAME USER_EMAIL=$EMAIL
Une fois les fichiers mis à jour et les changements poussés sur la branche main, vous verrez la magie opérer en temps réel : un rapport analytique sera généré, ainsi qu’un modèle mis à jour prêt à être déployé sur Hugging Face lors de la phase de déploiement continu.
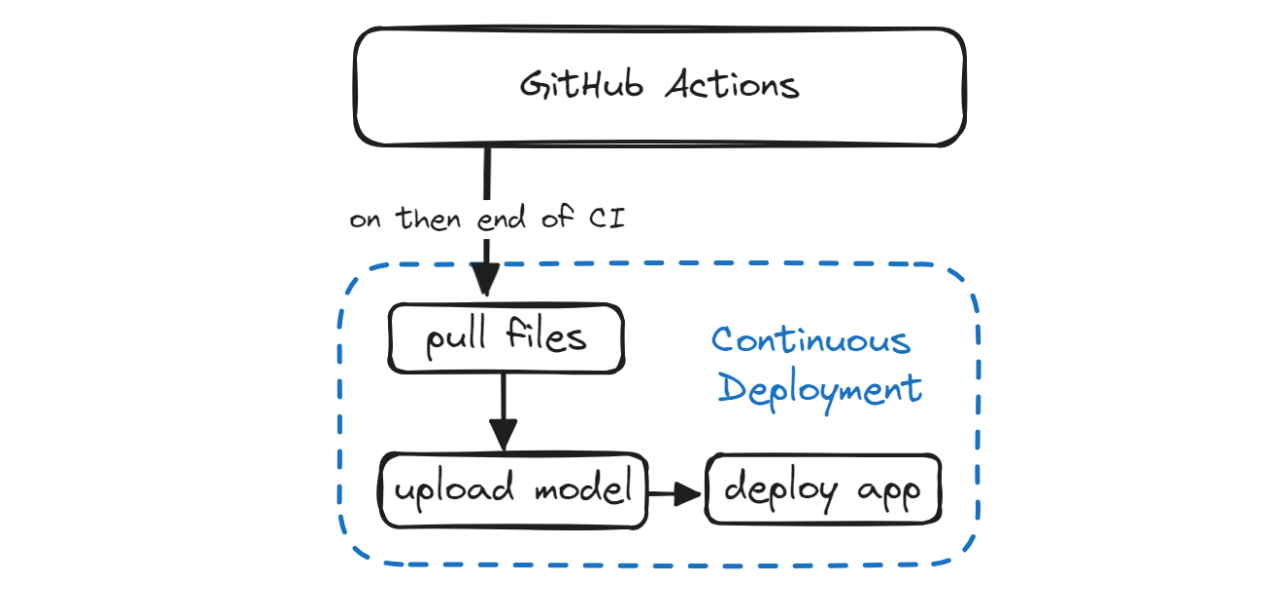
Dans la partie Déploiement continu, nous allons automatiser le déploiement du modèle et de l’application. Il s’agira de récupérer le modèle et le fichier d’application mis à jour depuis la branche update, de se connecter à Hugging Face CLI avec un jeton, de pousser les fichiers du modèle et de l’application, puis de déployer l’app.
Pour déployer notre modèle et y accéder, nous devons créer une app Gradio. Elle inclura :
Interface de Gradio et la lancerons.import gradio as gr
import skops.io as sio
pipe = sio.load("./Model/drug_pipeline.skops", trusted=True)
def predict_drug(age, sex, blood_pressure, cholesterol, na_to_k_ratio):
""Predict drugs based on patient features.
Args:
age (int): Age of patient
sex (str): Sex of patient
blood_pressure (str): Blood pressure level
cholesterol (str): Cholesterol level
na_to_k_ratio (float): Ratio of sodium to potassium in blood
Returns:
str: Predicted drug label
"""
features = [age, sex, blood_pressure, cholesterol, na_to_k_ratio]
predicted_drug = pipe.predict([features])[0]
label = f"Predicted Drug: {predicted_drug}"
return label
inputs = [
gr.Slider(15, 74, step=1, label="Age"),
gr.Radio(["M", "F"], label="Sex"),
gr.Radio(["HIGH", "LOW", "NORMAL"], label="Blood Pressure"),
gr.Radio(["HIGH", "NORMAL"], label="Cholesterol"),
gr.Slider(6.2, 38.2, step=0.1, label="Na_to_K"),
]
outputs = [gr.Label(num_top_classes=5)]
examples = [
[30, "M", "HIGH", "NORMAL", 15.4],
[35, "F", "LOW", "NORMAL", 8],
[50, "M", "HIGH", "HIGH", 34],
]
title = "Drug Classification"
description = "Enter the details to correctly identify Drug type?"
article = "This app is a part of the Beginner's Guide to CI/CD for Machine Learning. It teaches how to automate training, evaluation, and deployment of models to Hugging Face using GitHub Actions."
gr.Interface(
fn=predict_drug,
inputs=inputs,
outputs=outputs,
examples=examples,
title=title,
description=description,
article=article,
theme=gr.themes.Soft(),
).launch()
Ouvrez le terminal et exécutez l’app en local pour corriger d’éventuels problèmes avant de pousser les changements sur le dépôt distant.
python ./App/drug_app.py Running on local URL: http://127.0.0.1:7860
To create a public link, set `share=True` in `launch()`.Nous allons générer un jeton Hugging Face et l’exposer à notre script Makefile. Il est impératif de le garder confidentiel. Pour cela, nous utiliserons les secrets GitHub.
Cliquez d’abord sur votre photo de profil Hugging Face et ouvrez les paramètres. Choisissez « Access Tokens », puis « New Token » pour générer le jeton. Lors de la création, assurez-vous qu’il dispose des permissions d’écriture.
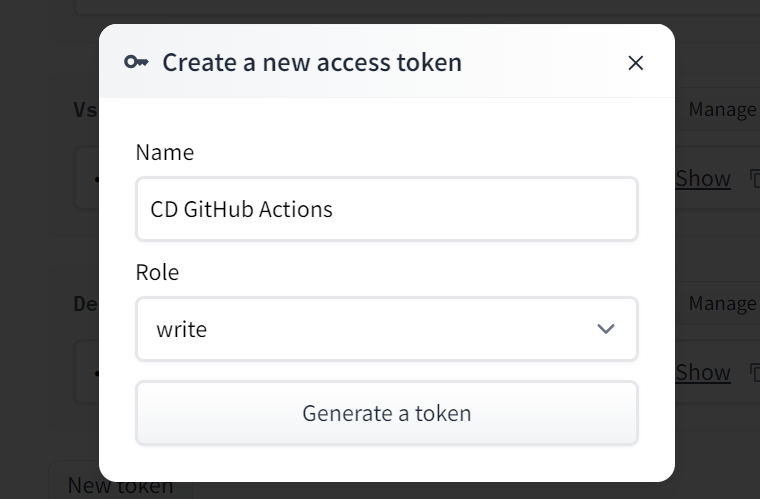
Copiez le jeton et créez un secret de dépôt, comme pour le nom d’utilisateur et l’e-mail.
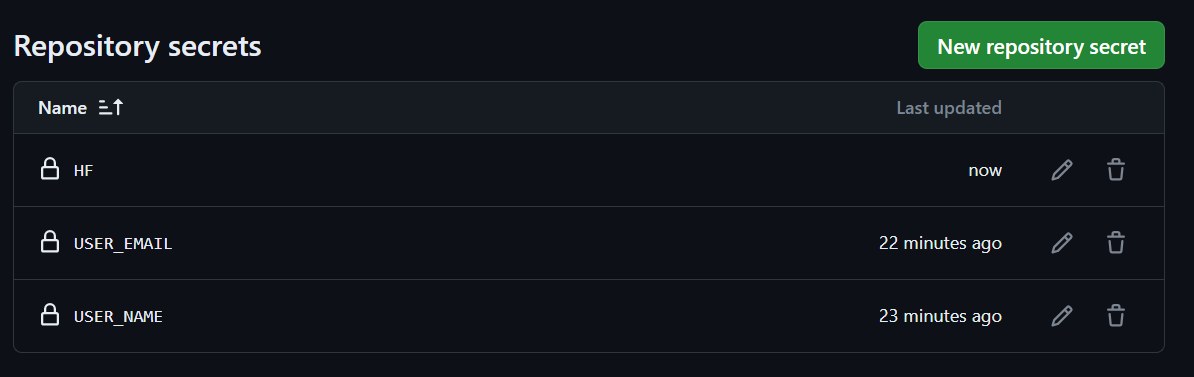
Nous allons ajouter trois nouvelles commandes pour créer les fichiers et un nouveau workflow GitHub nommé « Continuous Deployment ». Ce workflow automatisera la récupération et le déploiement des fichiers.
update et basculer sur update.deploy exécutera d’abord hf-login puis push-hub.hf-login:
git pull origin update
git switch update
pip install -U "huggingface_hub[cli]"
huggingface-cli login --token $(HF) --add-to-git-credential
push-hub:
huggingface-cli upload kingabzpro/Drug-Classification ./App --repo-type=space --commit-message="Sync App files"
huggingface-cli upload kingabzpro/Drug-Classification ./Model /Model --repo-type=space --commit-message="Sync Model"
huggingface-cli upload kingabzpro/Drug-Classification ./Results /Metrics --repo-type=space --commit-message="Sync Model"
deploy: hf-login push-hubNotre application aura ainsi accès au modèle, au fichier d’app et aux résultats mis à jour, ce qui nous permettra de suivre les changements dans le Space Hugging Face.
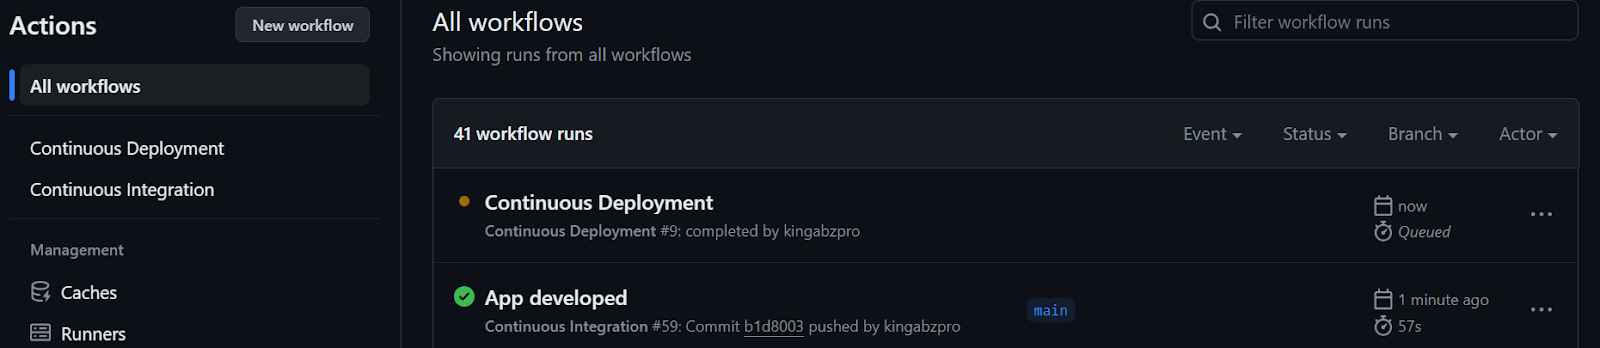
Pour rendre notre chaîne réellement CI/CD, créons un fichier cd.yml similaire à ci.yml. Une fois le pipeline CI terminé, il déclenchera le workflow cd.yml via l’argument on avec le paramètre workflow_run.
Ce workflow construira l’environnement et exécutera la commande make deploy avec le jeton Hugging Face pour déployer les dernières modifications sur Hugging Face Hub.
name: Continuous Deployment
on:
  workflow_run:
    workflows: ["Continuous Integration"]
    types:
      - completed

  workflow_dispatch:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: Deployment To Hugging Face
        env:
          HF: ${{ secrets.HF }}
        run: make deploy HF=$HF
Lorsque nous poussons des changements sur la branche main, cela démarre par le workflow CI.
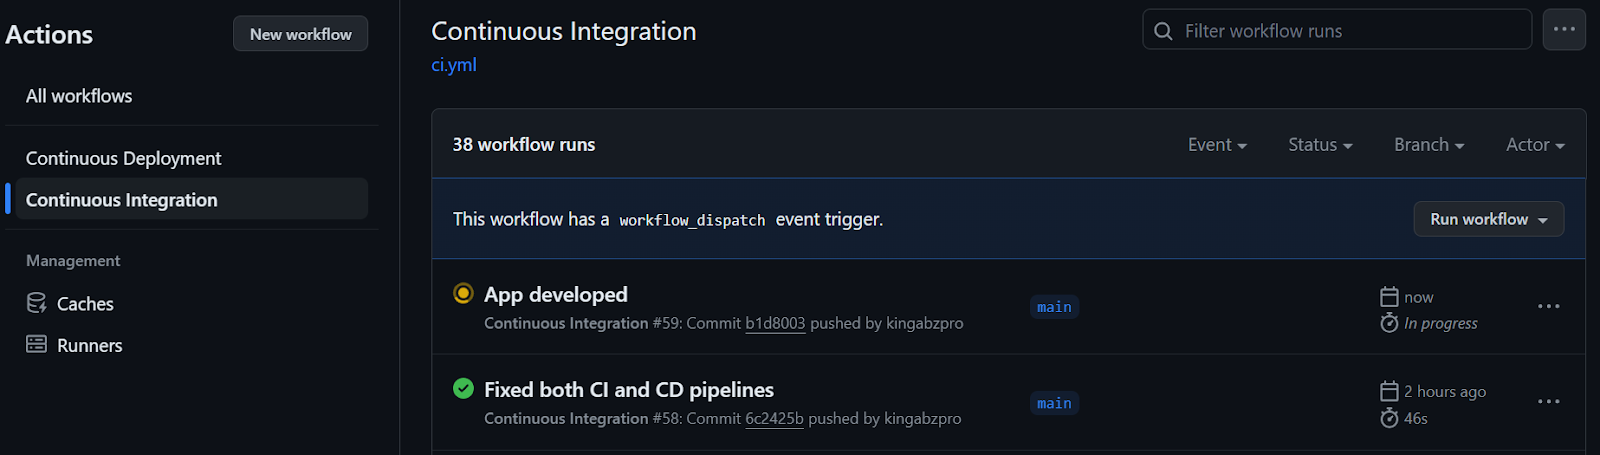
Après la fin du CI, le workflow CD prend le relais, comme ci-dessous.
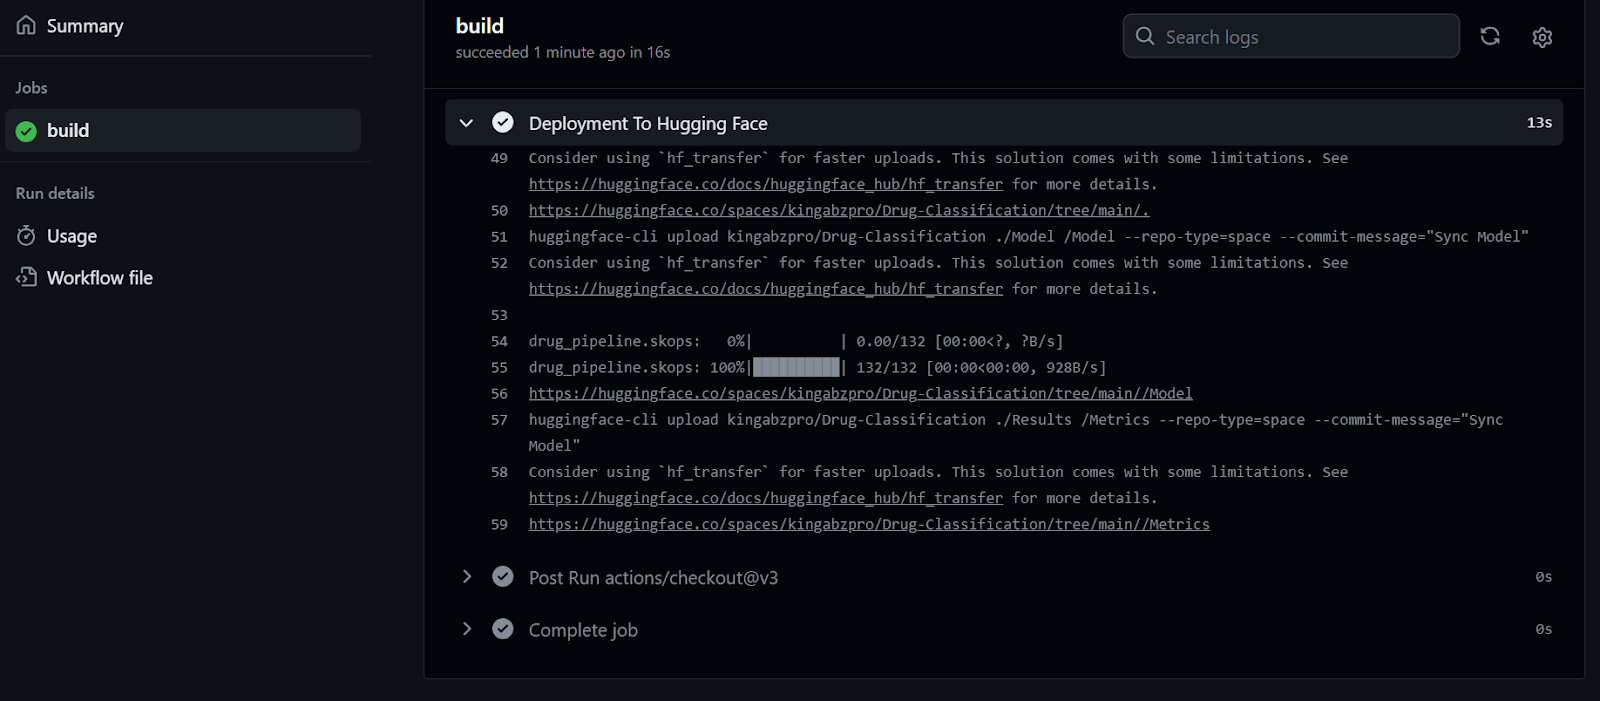
En ouvrant le détail d’un run, on peut suivre en direct les logs de chaque étape. Nos fichiers ont bien été téléversés sur le serveur Hugging Face.
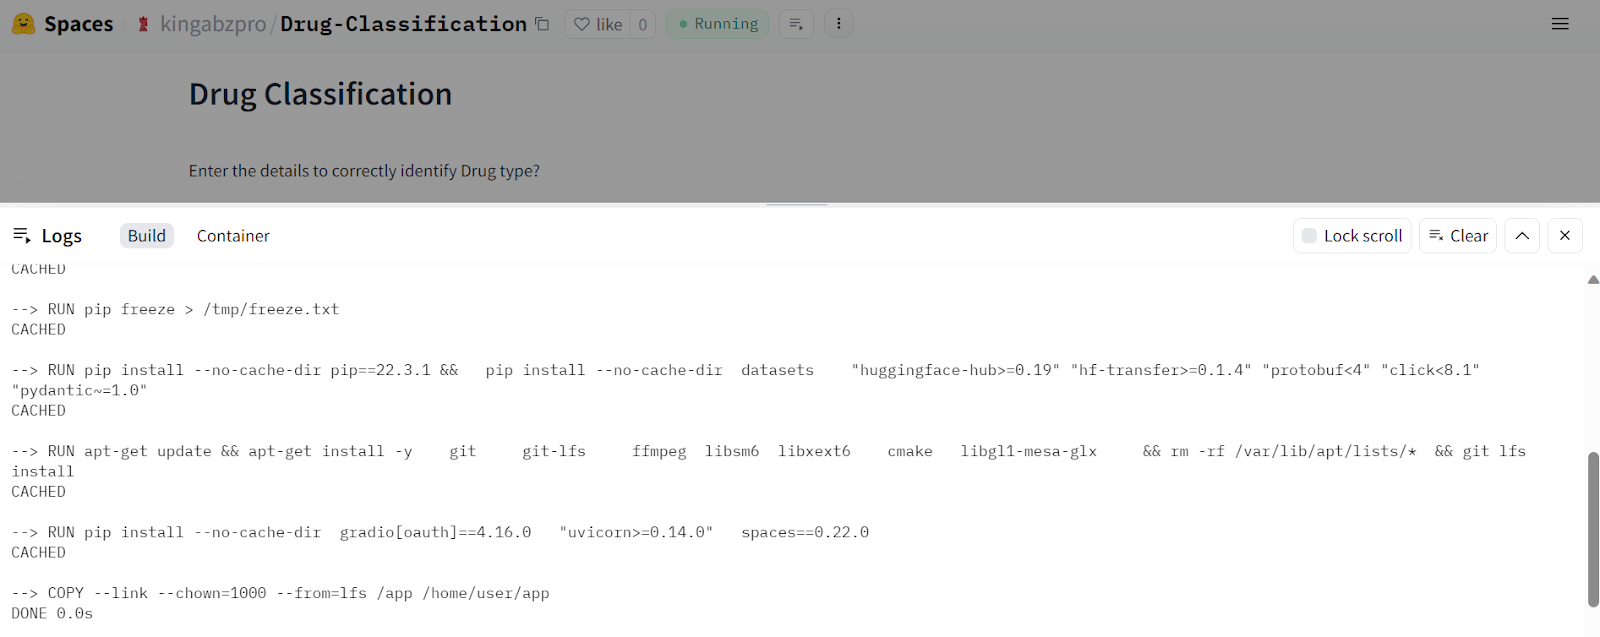
Après réception des fichiers mis à jour, le Space Hugging Face construit l’environnement et l’application démarre en quelques secondes.
Notre application Drug Classification fonctionne parfaitement et propose une interface soignée.
Testez différentes entrées pour constater les performances du modèle.
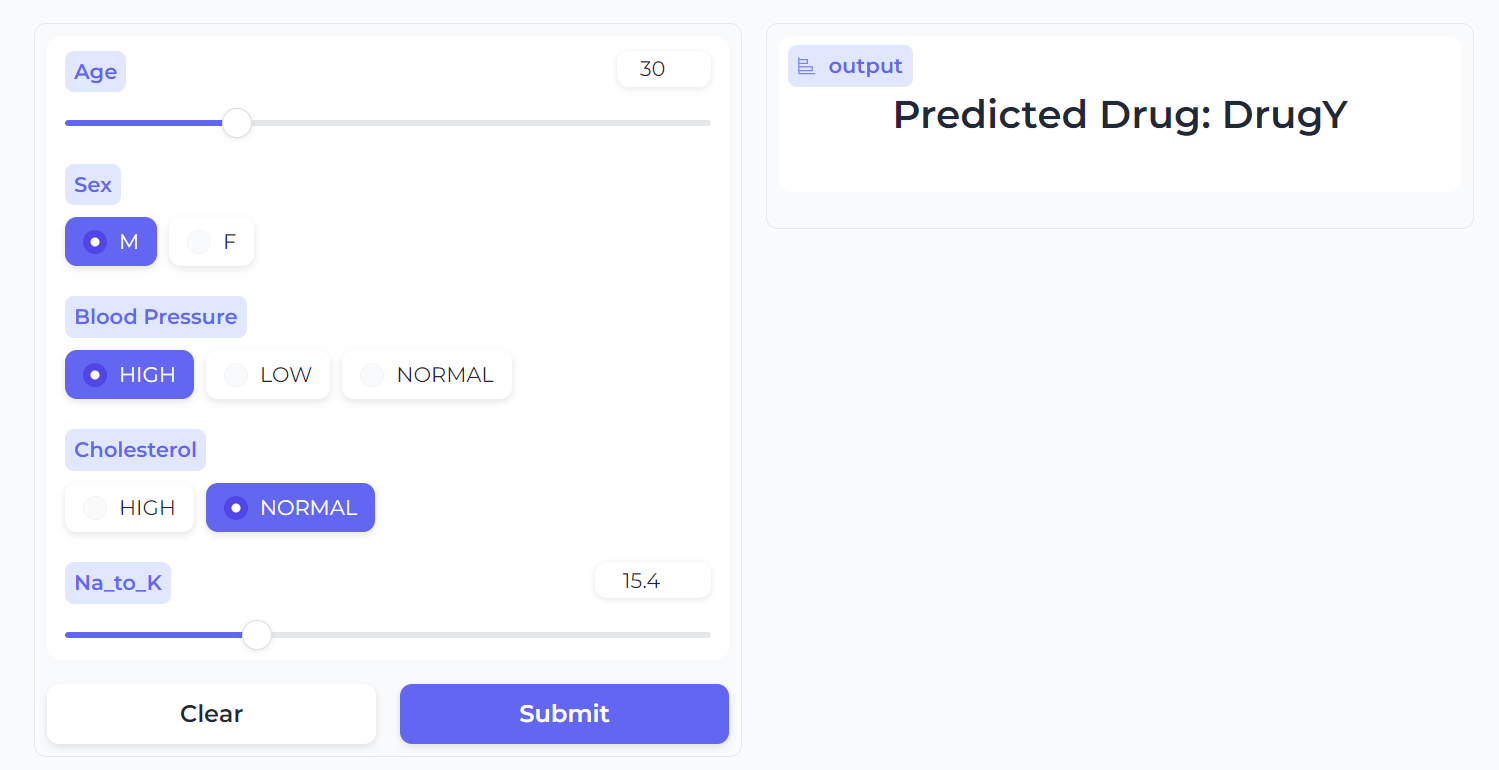
Image Source
Ce guide montre comment nous avons automatisé l’entraînement, l’évaluation, le versioning et le déploiement, de sorte que toute modification des données ou des algorithmes déclenche automatiquement le processus, sans erreur. Cette approche permet de créer des applications rapides, évolutives et prêtes pour la production.
Notez que, dans les projets réels, plusieurs outils MLOps sont utilisés pour orchestrer, versionner, déployer et surveiller les applications d’apprentissage automatique. Pour en savoir plus, consultez Top MLOps Tools You Need to Know, qui présente les technologies les plus utilisées par les grandes entreprises pour industrialiser leurs applications ML.
Pour optimiser votre pipeline CI/CD, il est crucial de maîtriser des outils comme Docker, Kubernetes, Azure Cloud et d’autres technologies MLOps. Suivez le tutoriel Machine Learning, Pipelines, Deployment, and MLOps pour vous familiariser avec les pratiques du secteur et travailler sur des projets avancés.
Commencez votre parcours en machine learning dès aujourd’hui !
Cours
Cours
Cours