Kursus
Validasi Model di Python
4 jam
31.3K
Tahun ini merupakan tahun penuh inovasi di bidang data science, dengan kecerdasan buatan dan machine learning mendominasi berita utama. Meski kemajuan pada 2023 tak terbantahkan, penting untuk diingat bahwa banyak terobosan machine learning ini hanya mungkin berkat proses evaluasi yang tepat yang dilalui model. Praktisi data bertugas memastikan evaluasi dan proses yang akurat dilakukan untuk mengukur kinerja model machine learning. Ini bukan sekadar bermanfaat — ini sangat penting.
Jika Anda ingin menguasai ilmu data, artikel ini akan memandu Anda melalui langkah-langkah penting evaluasi model menggunakan confusion matrix, alat yang relatif sederhana namun kuat dan banyak digunakan dalam evaluasi model.
Mari kita selami dan pelajari lebih lanjut tentang confusion matrix.
Confusion matrix adalah alat untuk mengevaluasi kinerja model yang direpresentasikan secara visual sebagai tabel. Ini memberi lapisan wawasan yang lebih dalam bagi praktisi data tentang performa, kesalahan, dan kelemahan model. Hal ini memungkinkan praktisi data untuk menganalisis modelnya lebih lanjut melalui penyetelan halus.
Mari pelajari struktur dasar confusion matrix, dengan contoh mengidentifikasi email sebagai spam atau bukan spam.
Untuk benar-benar memahami konsep confusion matrix, lihat visualisasi di bawah ini:
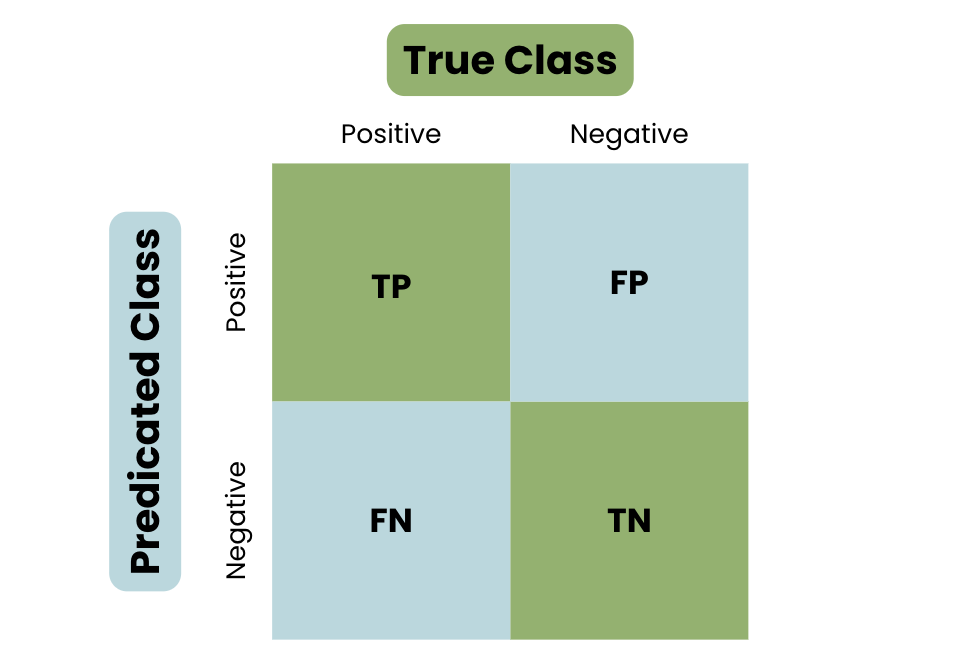
Struktur Dasar Confusion Matrix
Untuk memahami Confusion Matrix secara mendalam, penting untuk memahami metrik-metrik utama yang digunakan untuk mengukur kinerja model.
Mari kita definisikan metrik penting:
Akurasi mengukur jumlah klasifikasi yang benar dibagi dengan jumlah kasus keseluruhan.
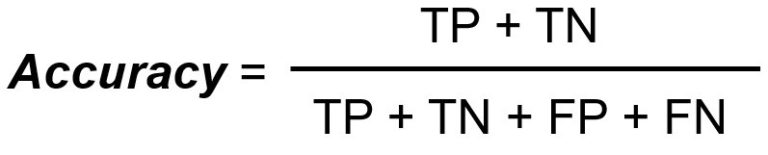
Recall/Sensitivitas mengukur jumlah true positive dibagi dengan jumlah actual positive.
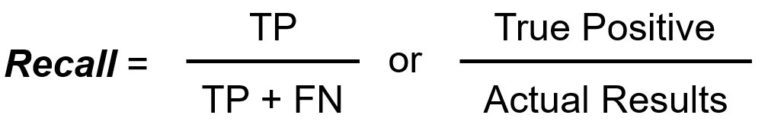
Presisi mengukur jumlah true positive dibagi dengan jumlah predicted positive.
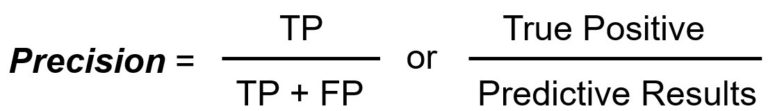
Spesifisitas mengukur jumlah true negative dibagi dengan jumlah actual negative.
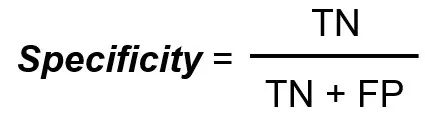
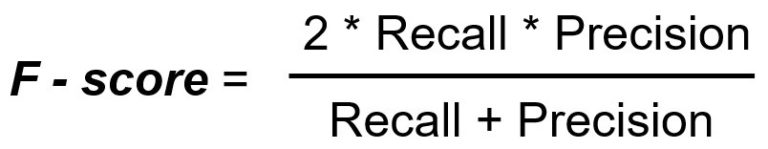
Skor F1 adalah satu metrik yang merupakan rata-rata harmonik dari presisi dan recall.
Untuk lebih memahami confusion matrix, Anda harus memahami tujuannya dan mengapa alat ini banyak digunakan.
Saat mengukur kinerja model atau apa pun secara umum, orang cenderung berfokus pada akurasi. Namun, sangat bergantung pada metrik akurasi dapat mengarah pada keputusan yang keliru. Untuk memahaminya, kita akan membahas keterbatasan penggunaan akurasi sebagai metrik tunggal.
Seperti didefinisikan di atas, akurasi mengukur jumlah klasifikasi yang benar dibagi dengan jumlah kasus keseluruhan. Namun, menggunakan metrik ini secara tunggal memiliki keterbatasan, seperti:
Melalui keterbatasan ini, confusion matrix bersama beragam metrik menawarkan wawasan lebih rinci tentang cara meningkatkan kinerja model.
Seperti terlihat pada struktur dasar confusion matrix, prediksi dipecah menjadi empat kategori: True Positive, True Negative, False Positive, dan False Negative.
Rincian ini memberikan wawasan dan solusi berharga untuk meningkatkan kinerja model:
Sekarang kita sudah memahami confusion matrix dasar, terminologi, dan kegunaannya, mari lanjut ke perhitungan confusion matrix secara manual, diikuti contoh praktis.
Berikut panduan langkah demi langkah untuk menghitung Confusion Matrix secara manual.
Langkah pertama adalah mengidentifikasi dua kemungkinan luaran dari tugas Anda: Positif atau Negatif.
Setelah kemungkinan luaran ditentukan, langkah berikutnya adalah mengumpulkan semua prediksi model, termasuk berapa kali model memprediksi setiap kelas dan kejadiannya.
Setelah semua prediksi dikumpulkan, langkah berikutnya adalah mengklasifikasikan luaran ke dalam empat kategori:
Setelah luaran diklasifikasikan, langkah berikutnya adalah menyajikannya dalam tabel matriks, untuk dianalisis lebih lanjut menggunakan berbagai metrik.
Mari telusuri contoh praktis untuk mendemonstrasikan proses ini.
Melanjutkan contoh yang sama, yaitu mengidentifikasi email sebagai spam atau bukan spam, mari buat dataset hipotetis di mana spam adalah Positif dan bukan spam adalah Negatif. Kita memiliki data berikut:
Pada titik ini, kita telah mendefinisikan luaran dan mengumpulkan data; langkah selanjutnya adalah mengklasifikasikan luaran ke dalam empat kategori:
Langkah berikutnya adalah mengubahnya menjadi Confusion Matrix:
|
Aktual / Prediksi |
Spam (Positif) |
Bukan Spam (Negatif) |
|
Spam (Positif) |
60 (TP) |
20 (FN) |
|
Bukan Spam (Negatif) |
20 (FP) |
100 (TN) |
Jadi, apa yang diberitahukan Confusion Matrix kepada kita?
Menggunakan confusion matrix ini, kita dapat menghitung metrik yang berbeda: Akurasi, Recall/Sensitivitas, Presisi, Spesifisitas, dan Skor F1.
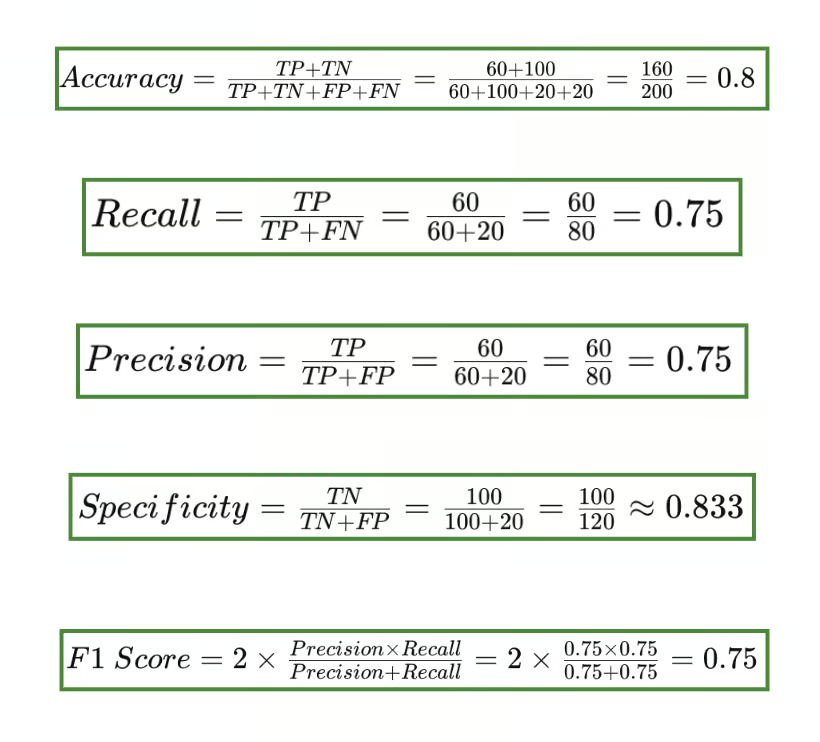
Keluaran metrik confusion matrix
Anda mungkin bertanya-tanya mengapa skor F1 mencakup presisi dan recall dalam rumusnya. Metrik skor F1 sangat penting saat menangani data tidak seimbang atau ketika Anda ingin menyeimbangkan trade-off antara presisi dan recall.
Presisi mengukur ketepatan prediksi positif. Ini menjawab pertanyaan ‘saat model memprediksi TRUE, seberapa sering itu benar?’. Presisi khususnya penting ketika biaya false positive tinggi.
Recall atau sensitivitas mengukur jumlah actual positive yang diidentifikasi dengan benar oleh model. Ini menjawab pertanyaan ‘ketika kelas sebenarnya TRUE, seberapa sering classifier benar?’.
Recall penting ketika melewatkan instance positif (FN) terbukti jauh lebih buruk daripada salah memberi label instance negatif sebagai positif.
Untuk memahaminya lebih jauh, mari buat confusion matrix menggunakan Scikit-learn di Python, dengan klasifikator Random Forest.
Langkah pertama adalah mengimpor pustaka yang diperlukan dan membangun dataset sintetis Anda.
# Import Libraries
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# Synthetic Dataset
X, y = make_classification(n_samples=1000, n_features=20,
                           n_classes=2, random_state=42)

# Split into Training and Test Sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Langkah berikutnya adalah melatih model menggunakan random forest classifier sederhana
# Train the Model
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
Seperti pada contoh praktis, kita perlu mengklasifikasikan luaran dan mengubahnya menjadi confusion matrix. Kita melakukan ini dengan terlebih dahulu melakukan prediksi pada data uji lalu menghasilkan Confusion Matrix:
# Predict on the Test Data
y_pred = model.predict(X_test)

# Generate the confusion matrix
cm = confusion_matrix(y_test, y_pred)
Sekarang kita ingin menghasilkan representasi visual dari confusion matrix:
# Create a Confusion Matrix
plt.figure(figsize=(8, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Greens')
plt.title('Confusion Matrix')
plt.ylabel('True label')
plt.xlabel('Predicted label')
plt.show()
Ini adalah keluarannya:
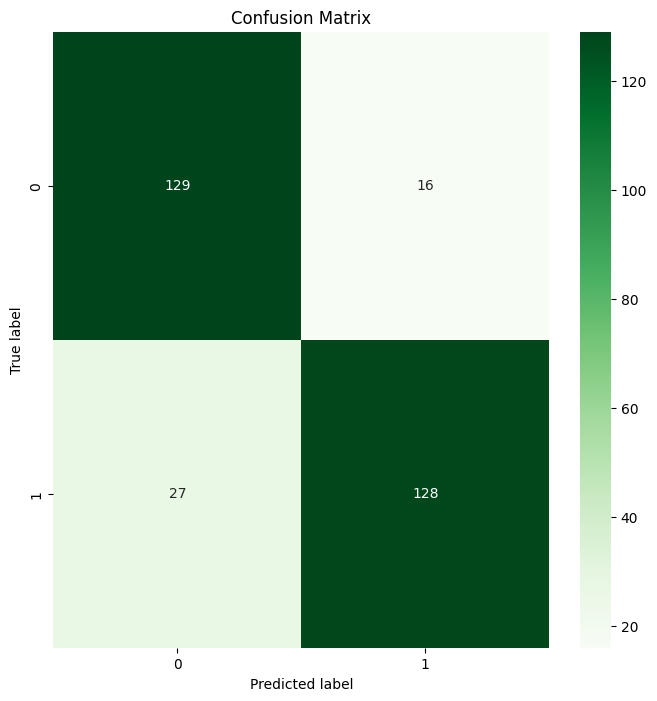
Keluaran Confusion Matrix Random Forest
Tada 🎉 Anda telah berhasil membuat Confusion Matrix pertama Anda menggunakan Scikit-learn!
Dalam artikel ini, kita telah membahas definisi Confusion Matrix, terminologi penting seputar alat evaluasi, serta keterbatasan dan pentingnya berbagai metrik. Mampu menghitung Confusion Matrix secara manual penting bagi basis pengetahuan data science Anda, begitu pula mengeksekusinya menggunakan pustaka seperti Scikit-learn.
Jika Anda ingin menyelami lebih jauh Confusion Matrix, latih confusion matrix di R dengan Understanding Confusion Matrix in R. Dalami lagi melalui kursus Model Validation in Python, di mana Anda akan mempelajari dasar-dasar validasi model, teknik validasi, dan mulai membuat model tervalidasi dan berkinerja tinggi.
Pelajari Lebih Lanjut Tentang Confusion Matrix
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



