
Last chance! 50% off DataCamp Premium
Sale ends in
Dalam lanskap AI yang berubah cepat, hadirnya model bahasa besar telah merevolusi cara kita berinteraksi dengan dan menghasilkan konten teks. Sejak rilis ChatGPT milik OpenAI pada November 2022, kita melihat gelombang baru model bahasa besar yang dirilis setiap hari.
Di antara model-model tersebut, Cohere Command menjadi pilihan utama di kalangan praktisi. Cohere menawarkan alat mutakhir untuk memberdayakan pengembang dan bisnis memanfaatkan kekuatan model dasar dalam aplikasi dan use case mereka.
Panduan pemula ini bertujuan untuk menjelaskan penawaran API Cohere, memberikan penjelasan mendalam tentang kapabilitas, keunggulan, dan strategi implementasi praktisnya.
Kita akan mulai dengan tinjauan singkat tentang model bahasa besar. Jika Anda mencari pendekatan yang lebih komprehensif, lihat kursus Large Language Models (LLMs) ini.
Large Language Models (LLM) adalah sistem AI canggih yang memahami dan menghasilkan teks mirip manusia. Model ini dilatih dengan data dalam jumlah sangat besar untuk menangkap pola kompleks, memahami nuansa bahasa, dan menghasilkan respons yang koheren.
LLM dapat melakukan berbagai tugas terkait bahasa, termasuk penerjemahan, pelengkapan teks, peringkasan, dan percakapan.
Cohere adalah pemain kunci di ruang ini, menawarkan API yang mudah digunakan yang memberi ilmuwan data akses ke kapabilitas LLM tersebut, sehingga menyederhanakan alur kerja mereka.
Didirikan pada 2019, Cohere adalah perusahaan asal Kanada yang berfokus pada pembuatan solusi kecerdasan buatan untuk bisnis. Perusahaan ini dengan cepat menjadi sosok penting di industri model bahasa besar (LLM), kerap disebut bersama pesaing seperti OpenAI GPT dan Anthropic Claude.
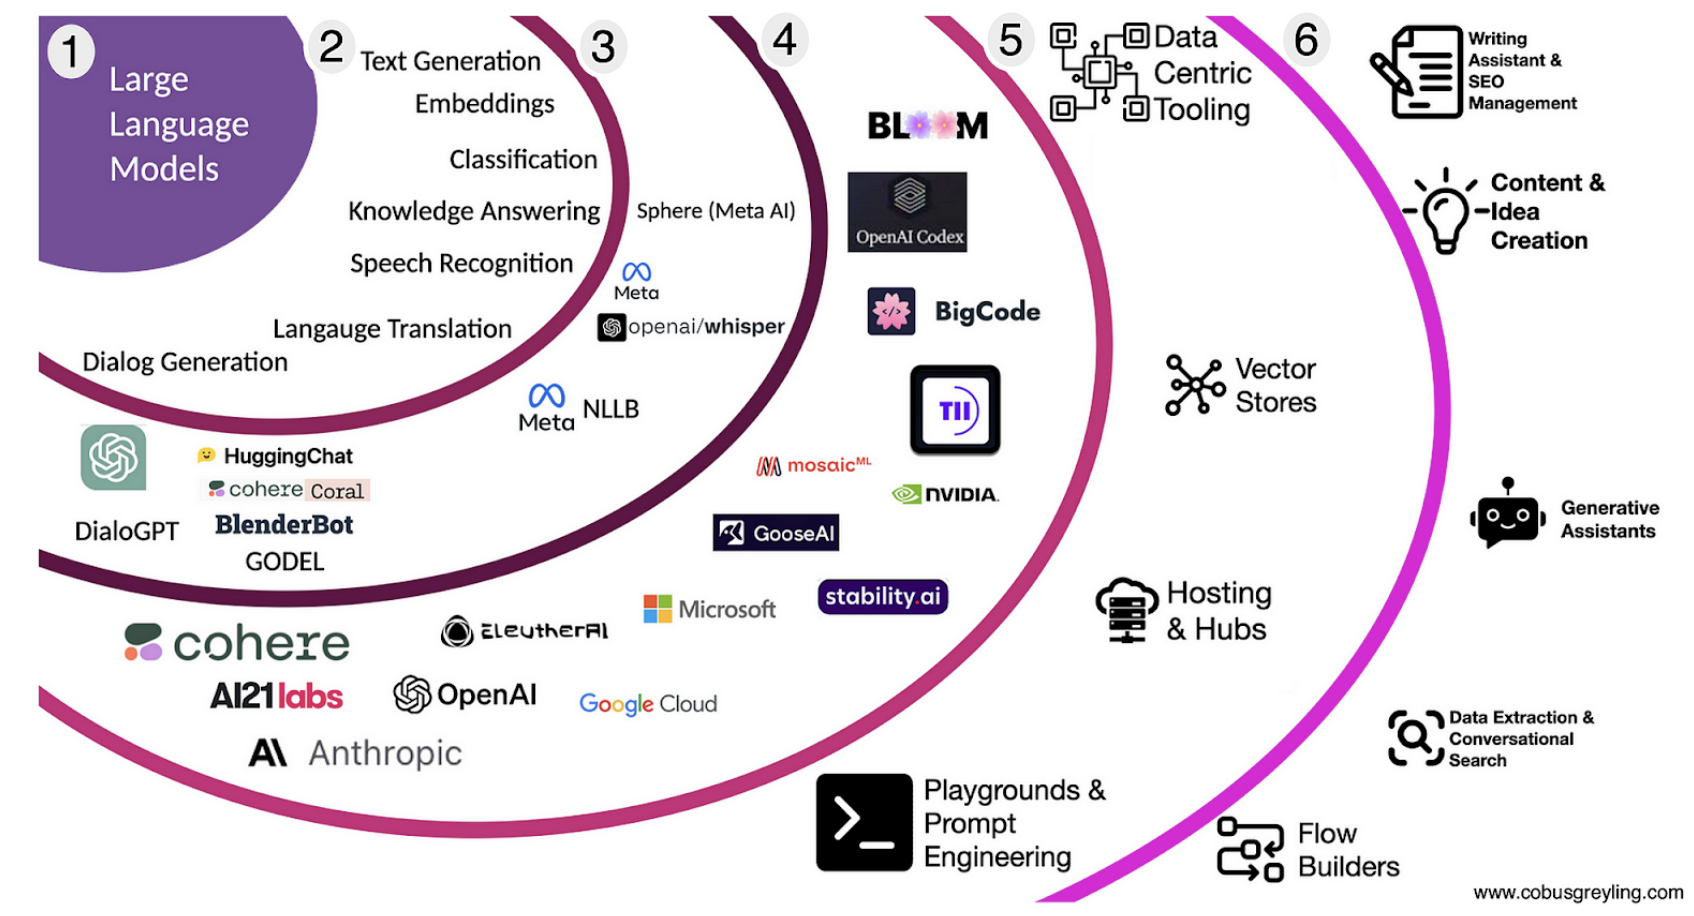
Sumber: Cobus Greyling, Large Language Model Landscape, Medium
Pada dasarnya, Cohere mengembangkan dan menyediakan model dasar untuk generasi bahasa, yang dapat diakses pengembang dan bisnis terutama melalui layanan API-nya.
Cohere terutama menawarkan tiga jenis model:
Kita dapat mengakses model Cohere dengan dua cara:
Cohere juga menawarkan antarmuka chat eksklusif mirip ChatGPT—dijalankan oleh Command R+ di balik layar.
Cohere Playground menyediakan antarmuka yang ramah pengguna untuk berinteraksi dengan Model Cohere, menawarkan pengalaman intuitif yang mirip dengan bekerja menggunakan GPT.
Pengguna dapat mengeksplorasi dan bereksperimen dengan berbagai kapabilitas model, menghasilkan teks, dan mendapatkan wawasan tentang perilakunya. Dengan desain yang ramping dan mudah diakses, Cohere Playground memungkinkan pengguna untuk cepat membuat prototipe dan menguji penawaran model Cohere.
Cohere Playground gratis untuk pengguna yang ingin menjelajah dan bereksperimen dengan model (gratis hingga Anda masuk tahap produksi).
Untuk menggunakan Cohere Playground, pertama kita perlu mendaftar di situs web Cohere.
Setelah itu, kita dapat masuk, dan kita akan diarahkan ke halaman seperti yang terlihat di bawah—cukup mirip dengan playground di platform OpenAI. Dengan menu dropdown di sisi kanan, kita dapat memilih berbagai model Cohere.
Playground memiliki antarmuka yang sedikit berbeda untuk tiap tugas. Di bagian atas, ada empat opsi yang dapat dipilih: Chat, Classify, Embed, dan Generate.
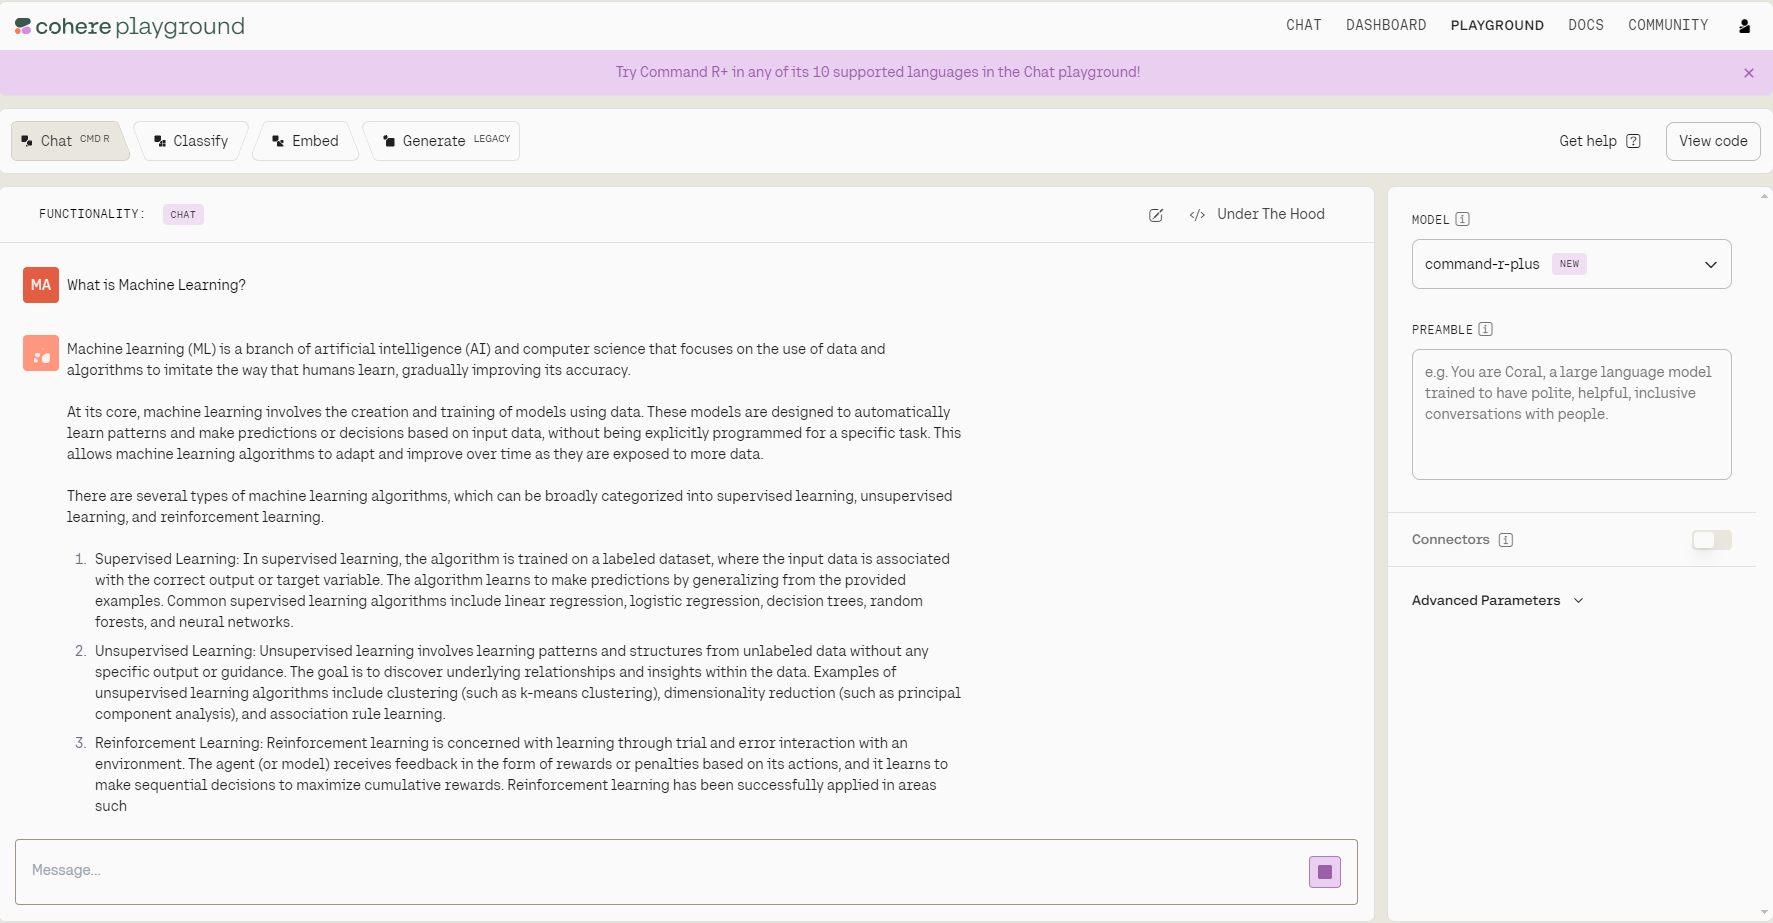
Dasbor Cohere Playground
Cohere Playground sangat baik untuk cepat menguji kapabilitas model Cohere, tetapi jika Anda membangun aplikasi atau alur kerja, Anda memerlukan cara terprogram untuk mengakses model-model ini. Di sinilah API Cohere berperan!
Mengakses API Cohere cukup mudah. Intinya, kita perlu:
Mari kita bahas langkah-langkah ini satu per satu.
Kita dapat memasang klien cohere menggunakan pip.
!pip install cohereSekarang, kita memerlukan kunci API.
Seperti terlihat pada gambar di bawah, ada dua jenis kunci API: produksi dan uji coba. Untuk keperluan tutorial ini, kita hanya memerlukan kunci uji coba. Kita dapat menyalinnya dengan mengeklik ikon salin di sebelah kunci.
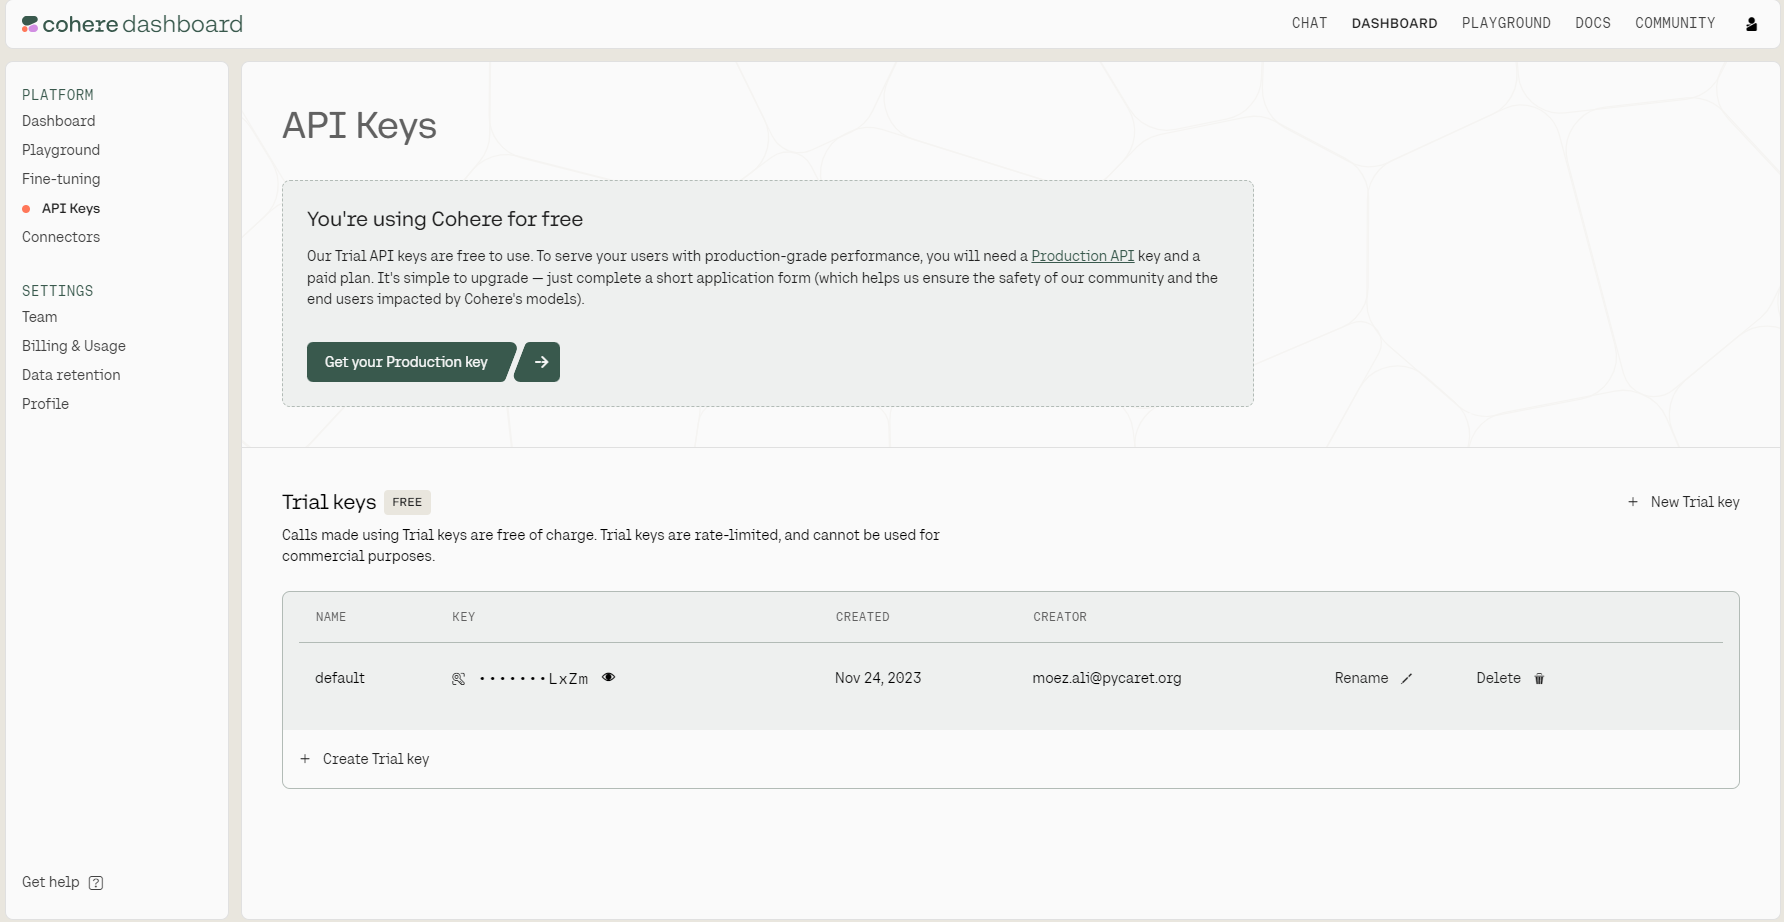
Sekarang setelah pustaka cohere terpasang dan kita memiliki kunci API, kita dapat melakukan panggilan API. Pada kode di bawah ini, kita:
cohere untuk berinteraksi dengan API mereka.Client menggunakan kunci API kita.co.chat().import cohere
co = cohere.Client('your_token_here')
message = "What is Machine Learning?"
response = co.chat(
message=message,
model="command",
temperature=0.3
)
answer = response.text
print(answer)Machine learning is a branch of computer science that focuses on developing algorithms and models that enable computers to learn and make predictions or decisions without being explicitly programmed. It is a key component of artificial intelligence (AI).
Machine Learning allows systems to identify patterns in data, uncover insights, and improve processes through iterative learning. Instead of writing explicit programs, ML enables the creation of models that can analyze data, identify patterns, and predict outcomes. These models are refined and optimized through a process known as training, which involves feeding the models annotated examples or real-world data.
(...)Sebelumnya, kita mengakses jawaban menggunakan response.text. Namun objek respons memuat lebih banyak informasi, dan kita dapat mengaksesnya menggunakan response.dict()—ini akan mengembalikan file JSON yang berisi semua metadata termasuk pesan respons:
response.dict()
{
   "text":"Machine Learning (ML) is a ....",
   "generation_id":"cebf4874-1e3d-429a-8699-8b9639b943dd",
   "finish_reason":"COMPLETE",
   "chat_history":[
      {
         "message":"What is Machine Learning?",
         "role":"USER"
      },
      {
         "message":"Machine Learning (ML) is a ....",
         "role":"CHATBOT"
      }
   ],
   "meta":{
      "api_version":{
         "version":"1"
      },
      "billed_units":{
         "input_tokens":56,
         "output_tokens":252
      },
      "tokens":{
         "input_tokens":67,
         "output_tokens":252
      }
   },
   "response_id":"df34a5f8-f1cd-407f-b1b5-5971aa12ae2a"
}
Mari kita uraikan setiap field pada objek response:
text: Berisi pesan yang dihasilkan oleh model.generation_id: Berisi ID yang terkait dengan jawaban yang dihasilkan, yang dapat digunakan dengan endpoint Feedback API untuk menandai respons yang baik dan melaporkan yang kurang baik.finish_reason: Menunjukkan alasan proses generasi berakhir dan dapat berupa salah satu dari berikut:COMPLETE: Model berhasil menyelesaikan pembuatan pesan.MAX_TOKENS: Batas konteks model tercapai sebelum proses generasi selesai.chat_history: Berisi percakapan yang disajikan dalam format log chat.meta: Berisi informasi tentang jumlah token, penagihan, dan sebagainya.response_id: Sementara generation_id berfokus pada satu percobaan generasi teks, response_id mengidentifikasi seluruh objek respons yang memuat teks yang dihasilkan dan data relevan lainnya.Bayangkan Anda mengembangkan chatbot yang dirancang untuk menjawab pertanyaan pengguna. Memiliki konteks dari percakapan sebelumnya dapat memungkinkan model bahasa memberikan jawaban yang lebih relevan.
Dalam percakapan multi-giliran, mempertahankan konteks interaksi sebelumnya sangat penting untuk menghasilkan respons yang koheren dan tepat. API Cohere memfasilitasi hal ini dengan memungkinkan kita menyertakan riwayat chat melalui parameter chat_history.
Ini membantu model memahami alur percakapan dan merespons dengan tepat berdasarkan pertukaran sebelumnya. Mari kita lihat contohnya.
message = "How is this related to Artificial Intelligence?"


response = co.chat(
  model="command-r-plus",
  chat_history=[
    {"role": "USER", "text": "What is Large Language Model?"},
    {"role": "CHATBOT", "text": "Large Language Model is a type ..."},
  ],
  message="How is this related to Artificial Intelligence?"
)


print(response.text)
Large language models (LLMs) are a key component of artificial intelligence (AI), and their development has played a significant role in advancing the field of AI. Here's how they are related:
1. Language Understanding and Generation: AI aims to create intelligent systems that can understand and respond to human language. LLMs are designed to process and generate human-like language, which is a fundamental aspect of human intelligence. By training on vast amounts of text data, LLMs learn to recognize patterns, syntax, semantics, and context, enabling them to interpret and generate language in a way that is similar to how humans do.
2. Machine Learning and Neural Networks: LLMs are typically built using machine learning techniques, particularly deep learning and neural networks. These are core areas of AI research. Neural networks, inspired by the structure of the human brain, enable LLMs to learn and make connections between different pieces of information. By training on large datasets, LLMs can identify patterns, relationships, and meanings in the data, which is a fundamental aspect of AI.
3. (...)Saat pengguna menanyakan "How is this related to Artificial Intelligence?", model memahami bahwa "this" merujuk pada large language models (LLM). Ini berkat parameter chat_history, yang menyediakan konteks yang diperlukan dari interaksi sebelumnya. Menjaga konteks dalam percakapan multi-giliran sangat penting untuk menghasilkan respons yang relevan dan koheren.
Ini bekerja dengan baik, tetapi tidak realistis untuk meneruskan chat_history ke API secara manual seperti pada contoh di atas. Alih-alih mengode keras chat_history, kita dapat membangunnya secara dinamis seiring percakapan berlangsung.
Ada beberapa cara untuk mencapai hal ini. Cara paling sederhana adalah menggunakan conversation_id di API. Mari kita lihat contohnya:
# First message
response = co.chat(
  model="command-r-plus",
  message="What is Large Language Models?",
  conversation_id='newuser1',
)

print(response.text)
Large Language Models (LLMs) are a type of artificial intelligence model specifically designed to process and generate human language. These models are typically based on deep learning and neural network architectures and are trained on vast amounts of text data. Here's an overview of LLMs and their key characteristics:
1. Definition:
- Large Language Models are machine learning models that are trained on large-scale textual data to understand, generate, and manipulate human language. They aim to capture the complexities of language, including syntax, semantics, and context.
2. Training Data:
- LLMs are trained on massive amounts of text data, often consisting of billions or even trillions of words. This training data can come from various sources such as books, articles, websites, social media, and other text-based documents.
3. (...)Sekarang mari kita berikan prompt lain ke model—perhatikan bagaimana conversation_id tetap konsisten dengan pesan pertama. Selama conversation_id dijaga konsisten, API akan otomatis menggunakan pesan-pesan sebelumnya sebagai konteks.
# Second message
response = co.chat(
  model="command-r-plus",
  message="How is it related to Artificial Intelligence?",
  conversation_id='newuser1',
)
print(response.text)
Large Language Models (LLMs) are a crucial component and a powerful manifestation of Artificial Intelligence (AI). Here's how LLMs are closely related to AI:
1. AI Foundation:
- Artificial Intelligence is a broad field that encompasses the development of computer systems capable of performing tasks typically associated with human intelligence. This includes areas like machine learning, natural language processing, computer vision, robotics, and decision-making.
- LLMs fall under the umbrella of AI as they are designed to understand, generate, and respond to human language, which is a fundamental aspect of human intelligence.
2. Machine Learning:
- Machine learning is a subset of AI that focuses on the development of algorithms and models that enable computers to learn and improve over time, based on data and experience, without being explicitly programmed.
- LLMs are built using machine learning techniques, particularly deep learning and neural networks. They are trained on large datasets to identify patterns, understand context, and generate responses, demonstrating their ability to learn and improve from data.
3. (...)Jika Anda ingin melanjutkan percakapan, kita perlu menjaga conversation_id tetap konsisten, dan API akan otomatis mengingat semua percakapan sebelumnya. conversation_id tidak boleh digunakan bersamaan dengan chat_history. Keduanya saling eksklusif.
Jika Anda ingin mempelajari lebih lanjut, lihat dokumentasi Cohere.
Mari kita lihat harga model paling canggih dari Cohere dan bandingkan dengan model bahasa kepemilikan teratas dari OpenAI dan Anthropic (kita akan fokus pada model terkuat dari masing-masing perusahaan). Per Mei 2024, harganya adalah sebagai berikut:
|
Model |
$ / satu juta token input |
$ / satu juta token output |
|
Cohere Command R+ |
$3.00 |
$15.00 |
|
Anthropic Claude Opus |
$15.00 |
$75.00 |
|
OpenAI GPT-4 Turbo |
$10.00 |
$30.00 |
Walaupun Cohere Command R+ menawarkan keunggulan biaya yang menarik, penting untuk mempertimbangkan spektrum kinerja yang lebih luas dari model-model ini. Anthropic Claude Opus dan GPT-4 Turbo secara konsisten menunjukkan kinerja yang lebih kuat dalam tolok ukur.
Baik Anda seorang pengembang yang ingin meningkatkan aplikasi maupun bisnis yang ingin mengadopsi AI mutakhir, Cohere menawarkan model besar yang kompetitif dengan model dasar lainnya seperti GPT dan Claude—namun dengan harga yang jauh lebih rendah.
Dalam blog ini, kita telah mempelajari apa itu Cohere dan cara mengaksesnya menggunakan Playground maupun API.
Jika Anda ingin mengeksplorasi topik ini lebih jauh, saya merekomendasikan code-along Using Large Language Models with the Cohere API.
Jika Anda ingin menyelam lebih dalam lagi dan mempelajari cara mengembangkan aplikasi AI end-to-end, lihat Developing LLM Applications with LangChain.
Pelajari lebih lanjut tentang API dan LLM dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



