
Kurs
Arbeiten mit der OpenAI-API
3 Std.
173.9K
In der rasant entwickelnden KI-Welt haben große Sprachmodelle revolutioniert, wie wir mit Text umgehen und Inhalte erzeugen. Seit der Veröffentlichung von OpenAI’s ChatGPT im November 2022 erscheinen nahezu täglich neue große Sprachmodelle.
Unter diesen Modellen hat sich Cohere Command zu einer Top-Wahl für Praktiker entwickelt. Cohere stellt modernste Tools bereit, mit denen Entwickler und Unternehmen die Stärke von Foundation Models in ihren Anwendungen und Use Cases nutzen können.
Dieser Einsteiger-Guide stellt die Angebote der Cohere-API vor und gibt einen tiefen Einblick in ihre Fähigkeiten, Vorteile und praktische Implementierungsstrategien.
Wir starten mit einem kurzen Überblick über große Sprachmodelle. Wenn du umfassender einsteigen möchtest, schau dir diesen Kurs zu Large Language Models (LLMs) an.
Große Sprachmodelle (LLMs) sind fortgeschrittene KI-Systeme, die menschliche Sprache verstehen und ähnliche Texte generieren. Sie werden mit riesigen Datenmengen trainiert, um komplexe Muster zu erkennen, Nuancen zu verstehen und kohärente Antworten zu erzeugen.
LLMs können eine Vielzahl sprachbezogener Aufgaben übernehmen, darunter Übersetzung, Textvervollständigung, Zusammenfassung und dialogorientierte Interaktionen.
Cohere ist in diesem Bereich ein wichtiger Player und bietet eine benutzerfreundliche API, die Data Scientists Zugriff auf diese LLM-Fähigkeiten gibt und ihre Workflows vereinfacht.
Cohere wurde 2019 gegründet und ist ein kanadisches Unternehmen, das KI-Lösungen für die Wirtschaft entwickelt. Es hat sich schnell zu einer prägenden Größe in der LLM-Branche entwickelt und wird oft in einem Atemzug mit Wettbewerbern wie OpenAI GPT und Anthropic Claude genannt.
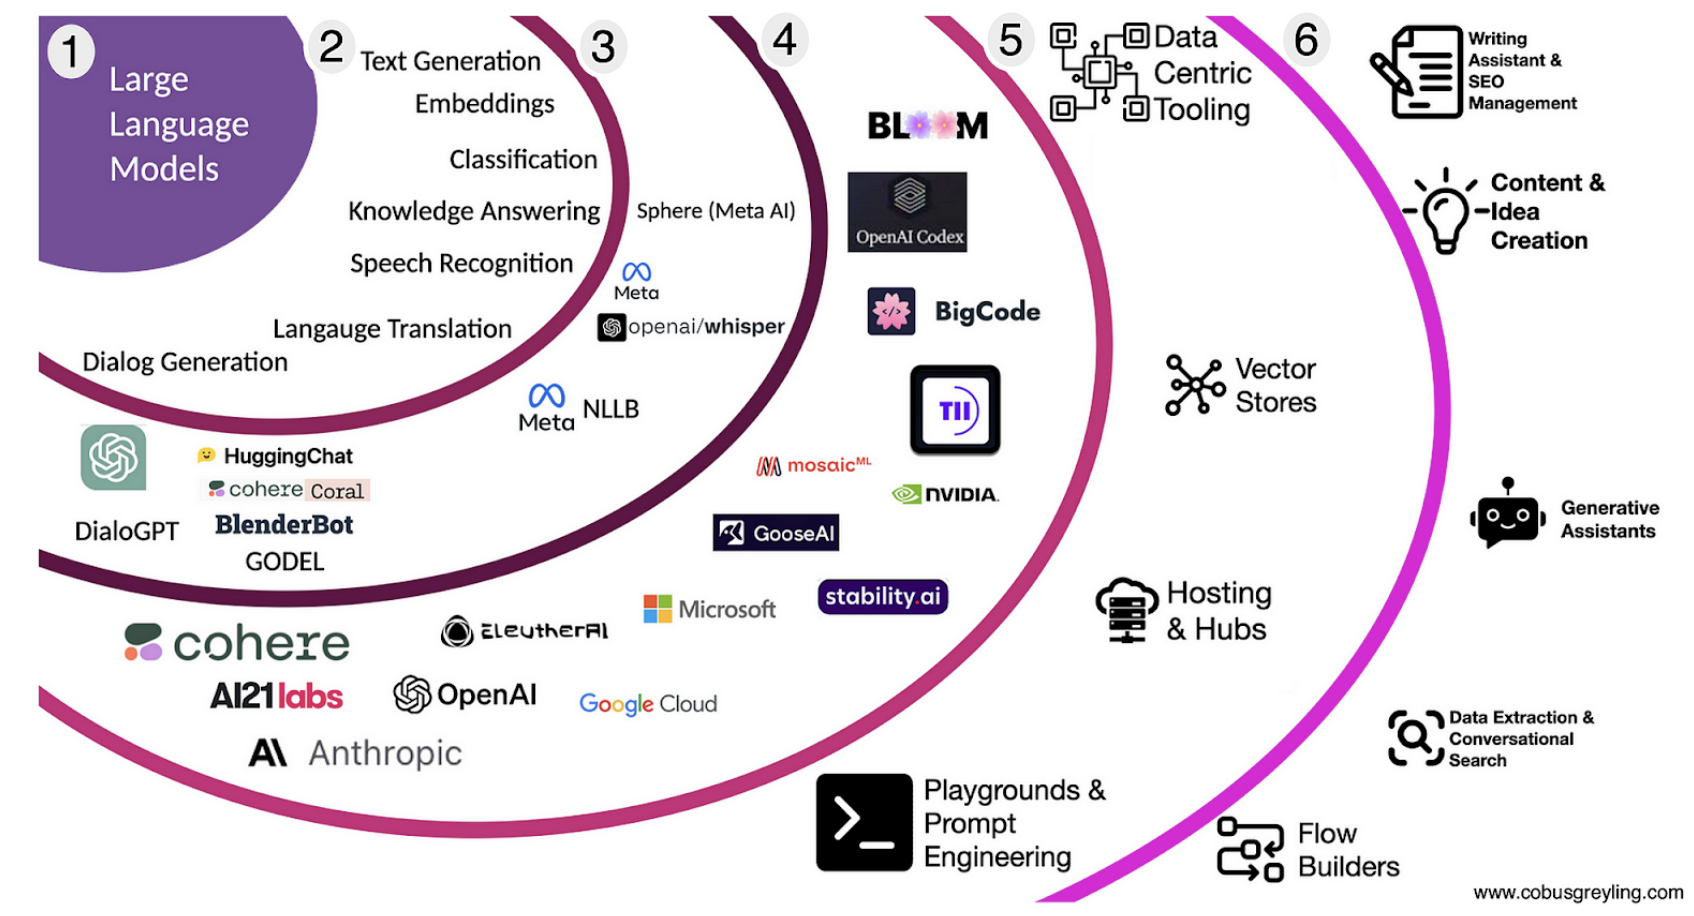
Quelle: Cobus Greyling, Large Language Model Landscape, Medium
Cohere entwickelt vor allem Foundation Models für die Sprachgenerierung und stellt sie überwiegend über seinen API-Service für Entwickler und Unternehmen bereit.
Cohere bietet im Kern drei Modelltypen an:
Wir können auf Cohere-Modelle auf zwei Arten zugreifen:
Cohere bietet außerdem ein eigenes Chat-Interface ähnlich wie ChatGPT – im Hintergrund läuft Command R+.
Das Cohere Playground bietet eine benutzerfreundliche Oberfläche für die Interaktion mit Cohere-Modellen und vermittelt ein intuitives Erlebnis ähnlich wie bei GPT.
Du kannst verschiedene Modellfähigkeiten erkunden und testen, Texte generieren und Einblicke in das Modellverhalten gewinnen. Mit seinem schlanken, zugänglichen Design ermöglicht das Cohere Playground schnelles Prototyping und Testen der Modellangebote von Cohere.
Das Cohere Playground ist kostenlos, um Modelle zu erkunden und zu experimentieren (Kosten fallen erst an, wenn du in die Produktion gehst).
Um das Cohere Playground zu nutzen, musst du dich zunächst auf Cohere’s Website registrieren.
Anschließend kannst du dich anmelden und landest auf der unten gezeigten Seite – sie erinnert stark an das Playground der OpenAI-Plattform. Über das Dropdown auf der rechten Seite wählst du unterschiedliche Cohere-Modelle aus.
Das Playground bietet je nach Aufgabe leicht unterschiedliche Oberflächen. Oben kannst du zwischen vier Optionen wählen: Chat, Classify, Embed und Generate.
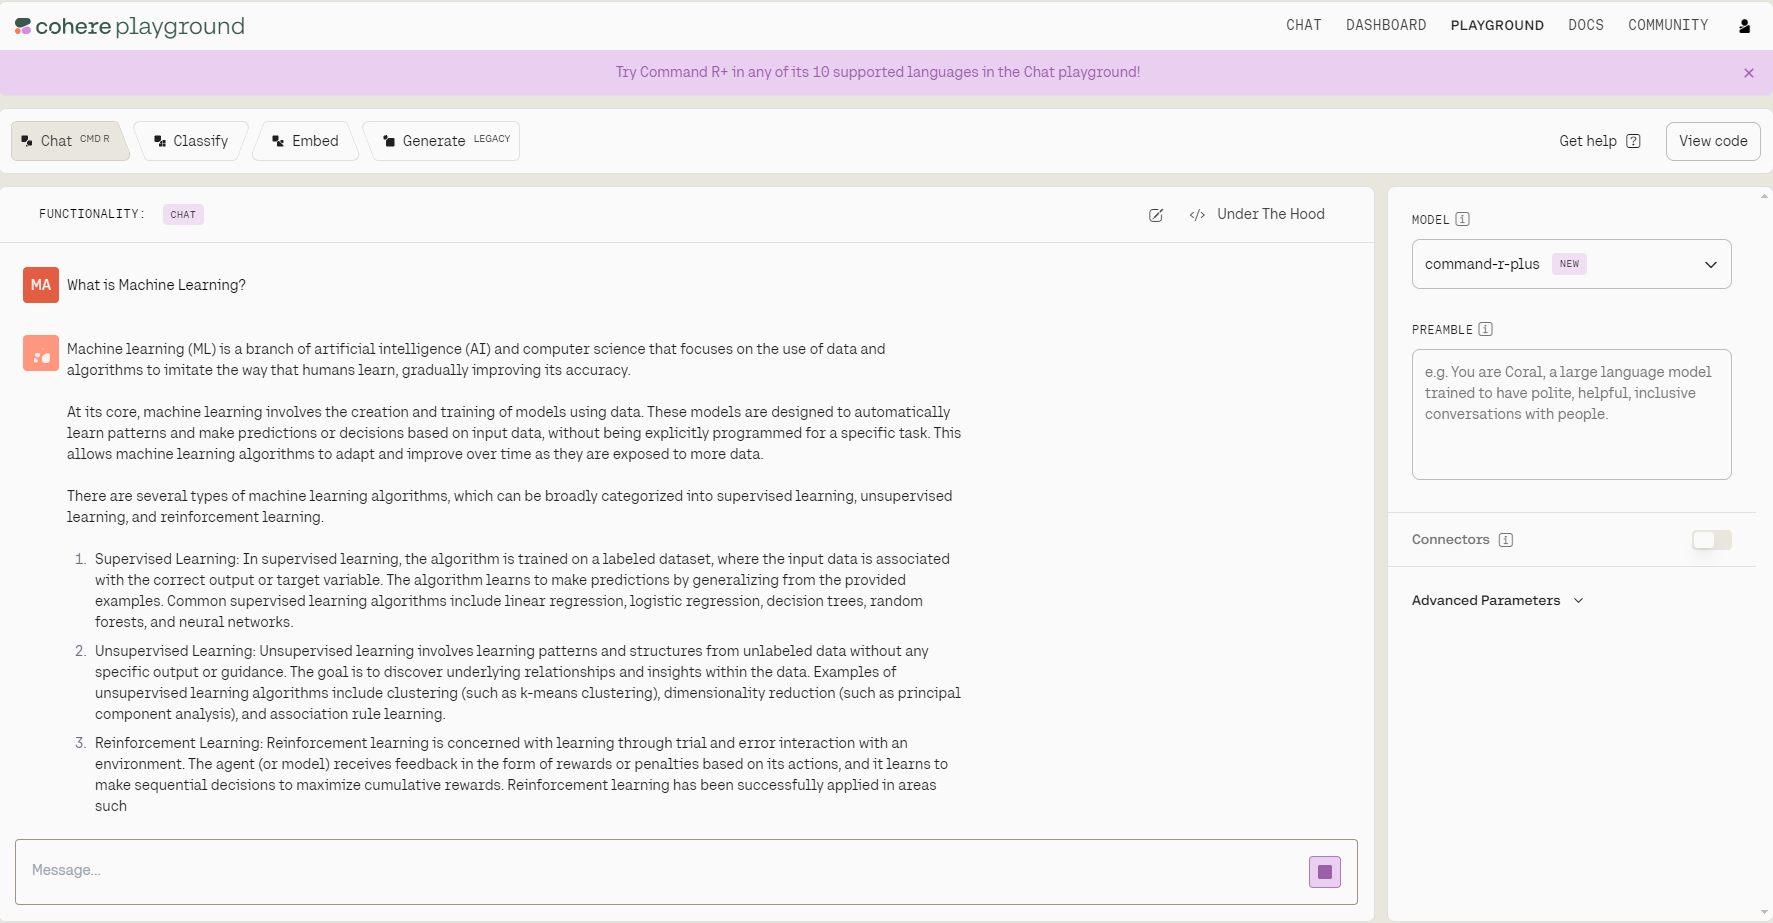
Dashboard des Cohere Playground
Das Cohere Playground ist ideal, um die Fähigkeiten der Cohere-Modelle schnell zu testen. Wenn du jedoch eine Anwendung oder einen Workflow aufbaust, brauchst du einen programmatischen Zugriff. Hier kommt die Cohere-API ins Spiel!
Der Zugriff auf die Cohere-API ist recht unkompliziert. Kurz gesagt, wir müssen:
Gehen wir die Schritte einzeln durch.
Wir können den cohere-Client mit pip installieren.
!pip install cohereJetzt brauchen wir einen API-Schlüssel.
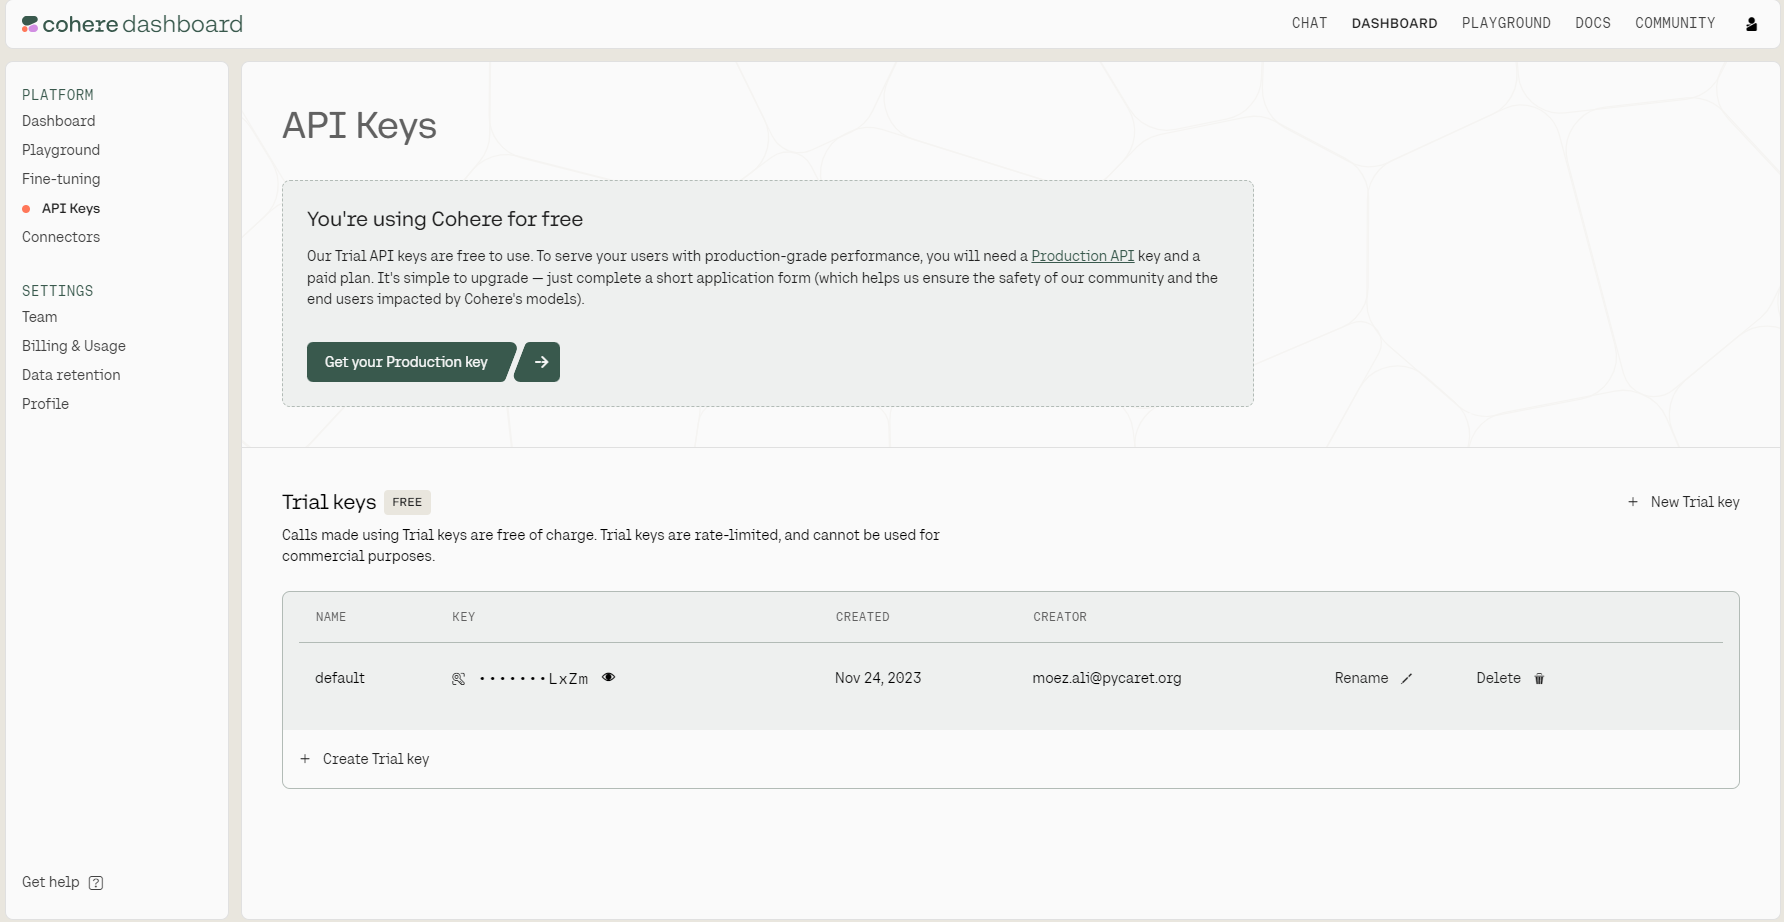
Wie im folgenden Bild zu sehen, gibt es zwei Arten von API-Schlüsseln: Produktion und Test. Für dieses Tutorial reicht ein Testschlüssel. Du kannst ihn über das Kopier-Icon neben dem Schlüssel übernehmen.
Jetzt, da die cohere-Bibliothek installiert ist und wir unseren API-Schlüssel haben, können wir einen API-Call ausführen. Im folgenden Code:
cohere-Bibliothek für den API-Zugriff.Client-Objekt mit unserem API-Schlüssel.co.chat() auf.import cohere
co = cohere.Client('your_token_here')
message = "What is Machine Learning?"
response = co.chat(
message=message,
model="command",
temperature=0.3
)
answer = response.text
print(answer)Machine learning is a branch of computer science that focuses on developing algorithms and models that enable computers to learn and make predictions or decisions without being explicitly programmed. It is a key component of artificial intelligence (AI).
Machine Learning allows systems to identify patterns in data, uncover insights, and improve processes through iterative learning. Instead of writing explicit programs, ML enables the creation of models that can analyze data, identify patterns, and predict outcomes. These models are refined and optimized through a process known as training, which involves feeding the models annotated examples or real-world data.
(...)Zuvor haben wir die Antwort über response.text abgerufen. Das Response-Objekt enthält jedoch weitere Informationen. Mit response.dict() erhalten wir eine JSON-Ausgabe mit allen Metadaten inklusive der Antwortnachricht:
response.dict()
{
   "text":"Machine Learning (ML) is a ....",
   "generation_id":"cebf4874-1e3d-429a-8699-8b9639b943dd",
   "finish_reason":"COMPLETE",
   "chat_history":[
      {
         "message":"What is Machine Learning?",
         "role":"USER"
      },
      {
         "message":"Machine Learning (ML) is a ....",
         "role":"CHATBOT"
      }
   ],
   "meta":{
      "api_version":{
         "version":"1"
      },
      "billed_units":{
         "input_tokens":56,
         "output_tokens":252
      },
      "tokens":{
         "input_tokens":67,
         "output_tokens":252
      }
   },
   "response_id":"df34a5f8-f1cd-407f-b1b5-5971aa12ae2a"
}
Im Folgenden die einzelnen Felder des response-Objekts:
text: Enthält die vom Modell generierte Nachricht.generation_id: ID der generierten Antwort, nutzbar mit dem Feedback-API-Endpunkt, um gute Antworten zu markieren und schwache zu melden.finish_reason: Grund für das Ende der Generierung, einer der folgenden:COMPLETE: Das Modell hat die Nachricht erfolgreich fertiggestellt.MAX_TOKENS: Das Kontextlimit des Modells wurde erreicht, bevor die Generierung abgeschlossen war.chat_history: Enthält die Unterhaltung im Chat-Log-Format.meta: Informationen zu Token-Zählungen, Abrechnung etc.response_id: Während sich generation_id auf einen einzelnen Generierungsversuch bezieht, identifiziert response_id das gesamte Antwortobjekt mit Text und Metadaten.Stell dir vor, du entwickelst einen Chatbot für Nutzerfragen. Kontext aus früheren Nachrichten hilft dem Sprachmodell, relevantere Antworten zu geben.
In mehrstufigen Unterhaltungen ist es entscheidend, den Kontext früherer Interaktionen zu bewahren, um kohärente und passende Antworten zu erzeugen. Die Cohere-API unterstützt das durch das Einbinden der Chat-Historie über den Parameter chat_history.
So versteht das Modell den Gesprächsfluss und antwortet basierend auf früheren Beiträgen passend. Hier ein Beispiel.
message = "How is this related to Artificial Intelligence?"


response = co.chat(
  model="command-r-plus",
  chat_history=[
    {"role": "USER", "text": "What is Large Language Model?"},
    {"role": "CHATBOT", "text": "Large Language Model is a type ..."},
  ],
  message="How is this related to Artificial Intelligence?"
)


print(response.text)
Large language models (LLMs) are a key component of artificial intelligence (AI), and their development has played a significant role in advancing the field of AI. Here's how they are related:
1. Language Understanding and Generation: AI aims to create intelligent systems that can understand and respond to human language. LLMs are designed to process and generate human-like language, which is a fundamental aspect of human intelligence. By training on vast amounts of text data, LLMs learn to recognize patterns, syntax, semantics, and context, enabling them to interpret and generate language in a way that is similar to how humans do.
2. Machine Learning and Neural Networks: LLMs are typically built using machine learning techniques, particularly deep learning and neural networks. These are core areas of AI research. Neural networks, inspired by the structure of the human brain, enable LLMs to learn and make connections between different pieces of information. By training on large datasets, LLMs can identify patterns, relationships, and meanings in the data, which is a fundamental aspect of AI.
3. (...)Als der Nutzer fragte "How is this related to Artificial Intelligence?", erkannte das Modell, dass sich "this" auf große Sprachmodelle (LLMs) bezog. Dafür sorgt der Parameter chat_history, der den benötigten Kontext aus den vorherigen Interaktionen liefert. Kontext in mehrstufigen Unterhaltungen ist entscheidend für relevante, kohärente Antworten.
Das funktioniert gut, aber es ist unpraktisch, die chat_history wie oben gezeigt manuell zu übergeben. Statt sie hart zu codieren, können wir sie während der Unterhaltung dynamisch aufbauen.
Dafür gibt es mehrere Wege. Am einfachsten ist die Nutzung von conversation_id in der API. Ein Beispiel:
# First message
response = co.chat(
  model="command-r-plus",
  message="What is Large Language Models?",
  conversation_id='newuser1',
)

print(response.text)
Large Language Models (LLMs) are a type of artificial intelligence model specifically designed to process and generate human language. These models are typically based on deep learning and neural network architectures and are trained on vast amounts of text data. Here's an overview of LLMs and their key characteristics:
1. Definition:
- Large Language Models are machine learning models that are trained on large-scale textual data to understand, generate, and manipulate human language. They aim to capture the complexities of language, including syntax, semantics, and context.
2. Training Data:
- LLMs are trained on massive amounts of text data, often consisting of billions or even trillions of words. This training data can come from various sources such as books, articles, websites, social media, and other text-based documents.
3. (...)Jetzt senden wir eine weitere Nachricht – beachte, dass conversation_id mit der ersten Nachricht identisch ist. Solange die conversation_id gleich bleibt, nutzt die API frühere Nachrichten automatisch als Kontext.
# Second message
response = co.chat(
  model="command-r-plus",
  message="How is it related to Artificial Intelligence?",
  conversation_id='newuser1',
)
print(response.text)
Large Language Models (LLMs) are a crucial component and a powerful manifestation of Artificial Intelligence (AI). Here's how LLMs are closely related to AI:
1. AI Foundation:
- Artificial Intelligence is a broad field that encompasses the development of computer systems capable of performing tasks typically associated with human intelligence. This includes areas like machine learning, natural language processing, computer vision, robotics, and decision-making.
- LLMs fall under the umbrella of AI as they are designed to understand, generate, and respond to human language, which is a fundamental aspect of human intelligence.
2. Machine Learning:
- Machine learning is a subset of AI that focuses on the development of algorithms and models that enable computers to learn and improve over time, based on data and experience, without being explicitly programmed.
- LLMs are built using machine learning techniques, particularly deep learning and neural networks. They are trained on large datasets to identify patterns, understand context, and generate responses, demonstrating their ability to learn and improve from data.
3. (...)Wenn du die Unterhaltung fortsetzen willst, halte die conversation_id konsistent – dann merkt sich die API automatisch die bisherigen Nachrichten. Die conversation_id darf nicht zusammen mit chat_history verwendet werden. Beides schließt sich gegenseitig aus.
Wenn du mehr erfahren willst, schau in Cohere’s Dokumentation.
Werfen wir einen Blick auf die Preise für Cohere’s fortschrittlichstes Modell und vergleichen sie mit den führenden proprietären Sprachmodellen von OpenAI und Anthropic (wir konzentrieren uns auf das jeweils stärkste Modell). Stand Mai 2024 gelten folgende Preise:
|
Modell |
$ / Million Input-Tokens |
$ / Million Output-Tokens |
|
Cohere Command R+ |
$3.00 |
$15.00 |
|
Anthropic Claude Opus |
$15.00 |
$75.00 |
|
OpenAI GPT-4 Turbo |
$10.00 |
$30.00 |
Auch wenn Cohere Command R+ preislich attraktiv ist, solltest du die Gesamtleistung der Modelle im Blick behalten. Anthropic Claude Opus und GPT-4 Turbo schneiden in Benchmarks konstant stärker ab.
Egal, ob du als Entwickler deine Anwendungen erweitern willst oder als Unternehmen modernste KI einbinden möchtest: Cohere bietet große Modelle, die mit anderen Foundation Models wie GPT und Claude konkurrieren – jedoch zu deutlich niedrigeren Kosten.
In diesem Blog hast du gelernt, was Cohere ist und wie du über das Playground oder die API darauf zugreifst.
Wenn du tiefer einsteigen willst, empfehle ich dieses Code-Along: Using Large Language Models with the Cohere API.
Wenn du end-to-end KI-Anwendungen entwickeln möchtest, schau dir Developing LLM Applications with LangChain an.
Vertiefe dein Wissen zu APIs und LLMs mit diesen Kursen!
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.


