
Corso
Lavorare con l'API di OpenAI
3 ore
179.8K
Nel panorama in rapida evoluzione dell’AI, l’arrivo dei modelli linguistici di grandi dimensioni ha rivoluzionato il modo in cui interagiamo e generiamo contenuti testuali. Dalla pubblicazione di ChatGPT di OpenAI a novembre 2022, abbiamo visto una nuova ondata di LLM rilasciati quotidianamente.
Tra questi modelli, Cohere Command è diventato una scelta di punta tra i professionisti. Cohere offre strumenti all’avanguardia per consentire a sviluppatori e aziende di sfruttare la potenza dei modelli fondamentali nelle proprie applicazioni e casi d’uso.
Questa guida per principianti descrive l’offerta dell’API di Cohere, fornendo un’esplorazione approfondita delle sue capacità, dei vantaggi e delle strategie pratiche di implementazione.
Inizieremo con una rapida panoramica dei modelli linguistici di grandi dimensioni; se però cerchi un approccio più completo, dai un’occhiata a questo corso su Large Language Models (LLMs).
I Large Language Models (LLM) sono sistemi di AI avanzati che comprendono e generano testo simile a quello umano. Sono addestrati su enormi quantità di dati per cogliere schemi complessi, comprendere le sfumature della lingua e generare risposte coerenti.
Gli LLM possono svolgere varie attività legate al linguaggio, tra cui traduzione, completamento del testo, sintesi e interazioni conversazionali.
Cohere è un attore chiave in questo ambito e offre un’API intuitiva che dà ai data scientist accesso a queste capacità, semplificando i flussi di lavoro.
Fondata nel 2019, Cohere è un’azienda canadese dedicata alla creazione di soluzioni di intelligenza artificiale per le imprese. È rapidamente diventata una figura di rilievo nel settore degli LLM, spesso citata accanto a concorrenti come OpenAI GPT e Anthropic Claude.
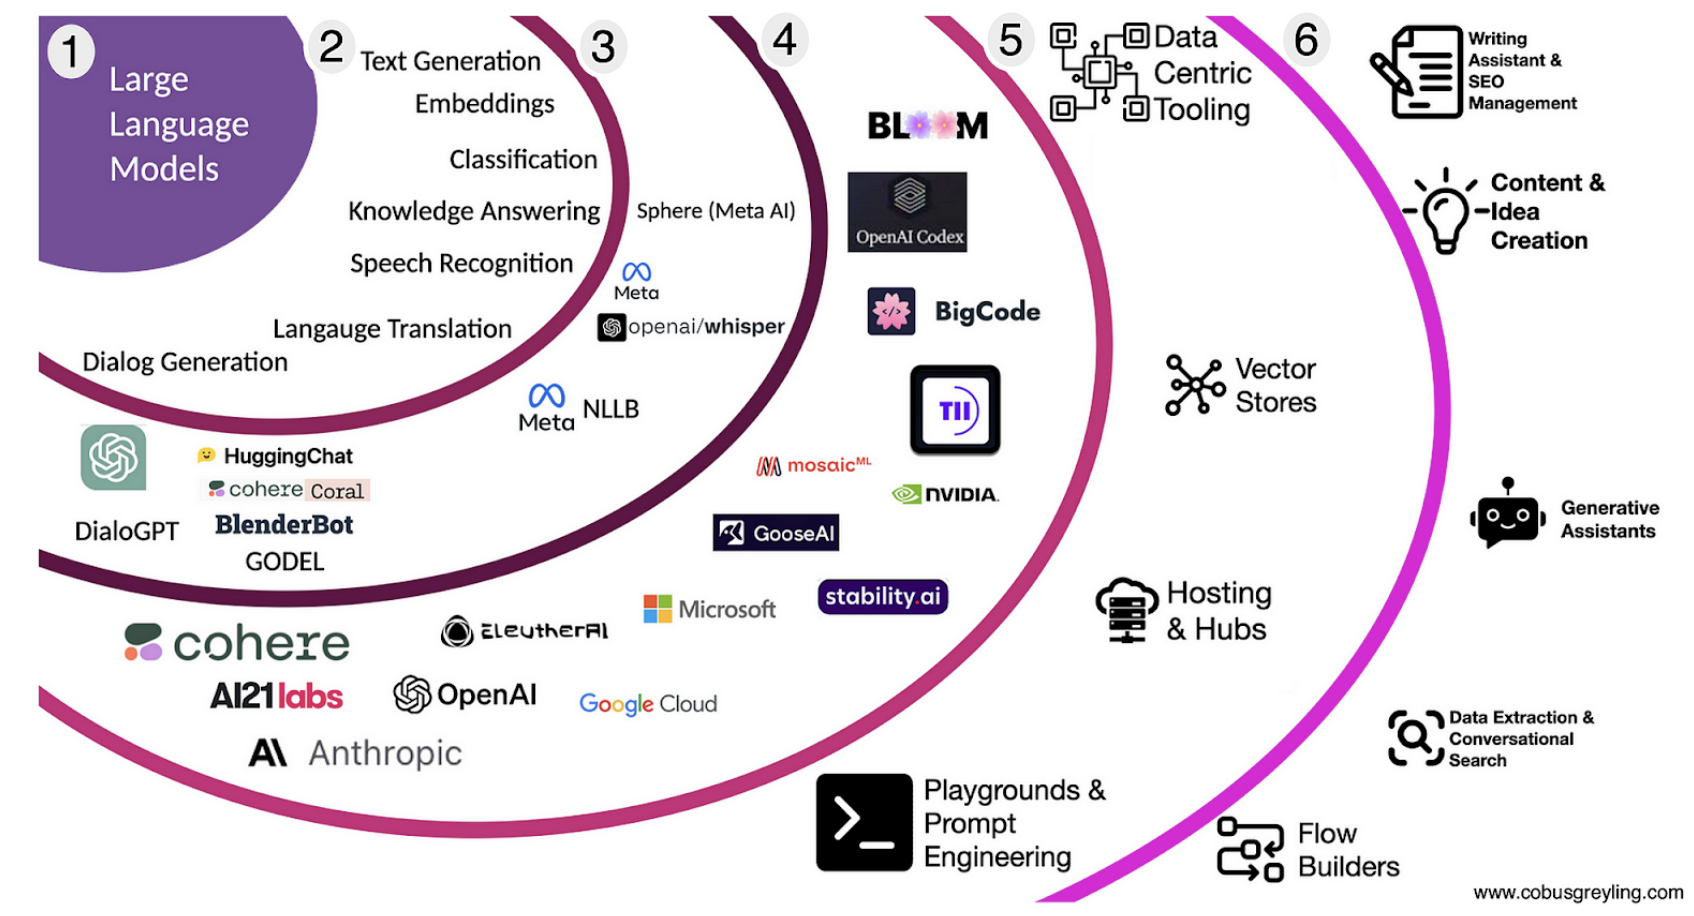
Fonte: Cobus Greyling, Large Language Model Landscape, Medium
Cohere sviluppa e fornisce principalmente modelli fondamentali per la generazione di linguaggio, accessibili a sviluppatori e aziende soprattutto tramite il servizio API.
Cohere offre principalmente tre diverse tipologie di modelli:
Possiamo accedere ai modelli Cohere in due modi:
Cohere offre anche un’interfaccia chat esclusiva simile a ChatGPT, basata su Command R+ sotto il cofano.
Cohere Playground offre un’interfaccia intuitiva per interagire con i modelli Cohere, con un’esperienza simile a quella di GPT.
Gli utenti possono esplorare e sperimentare varie capacità del modello, generare testo e ottenere insight sul suo comportamento. Con un design snello e accessibile, Cohere Playground consente di prototipare e testare rapidamente l’offerta di modelli di Cohere.
Cohere Playground è gratuito per esplorare e sperimentare con i modelli (è gratuito finché non entri in produzione).
Per usare Cohere Playground, dobbiamo prima registrarci sul sito di Cohere.
Poi possiamo accedere e arriveremo sulla pagina che vedi qui sotto, molto simile al playground sulla piattaforma OpenAI. Usando il menu a discesa sulla destra, possiamo scegliere diversi modelli Cohere.
Il Playground ha interfacce leggermente diverse a seconda del compito. In alto trovi quattro opzioni tra cui scegliere: Chat, Classify, Embed e Generate.
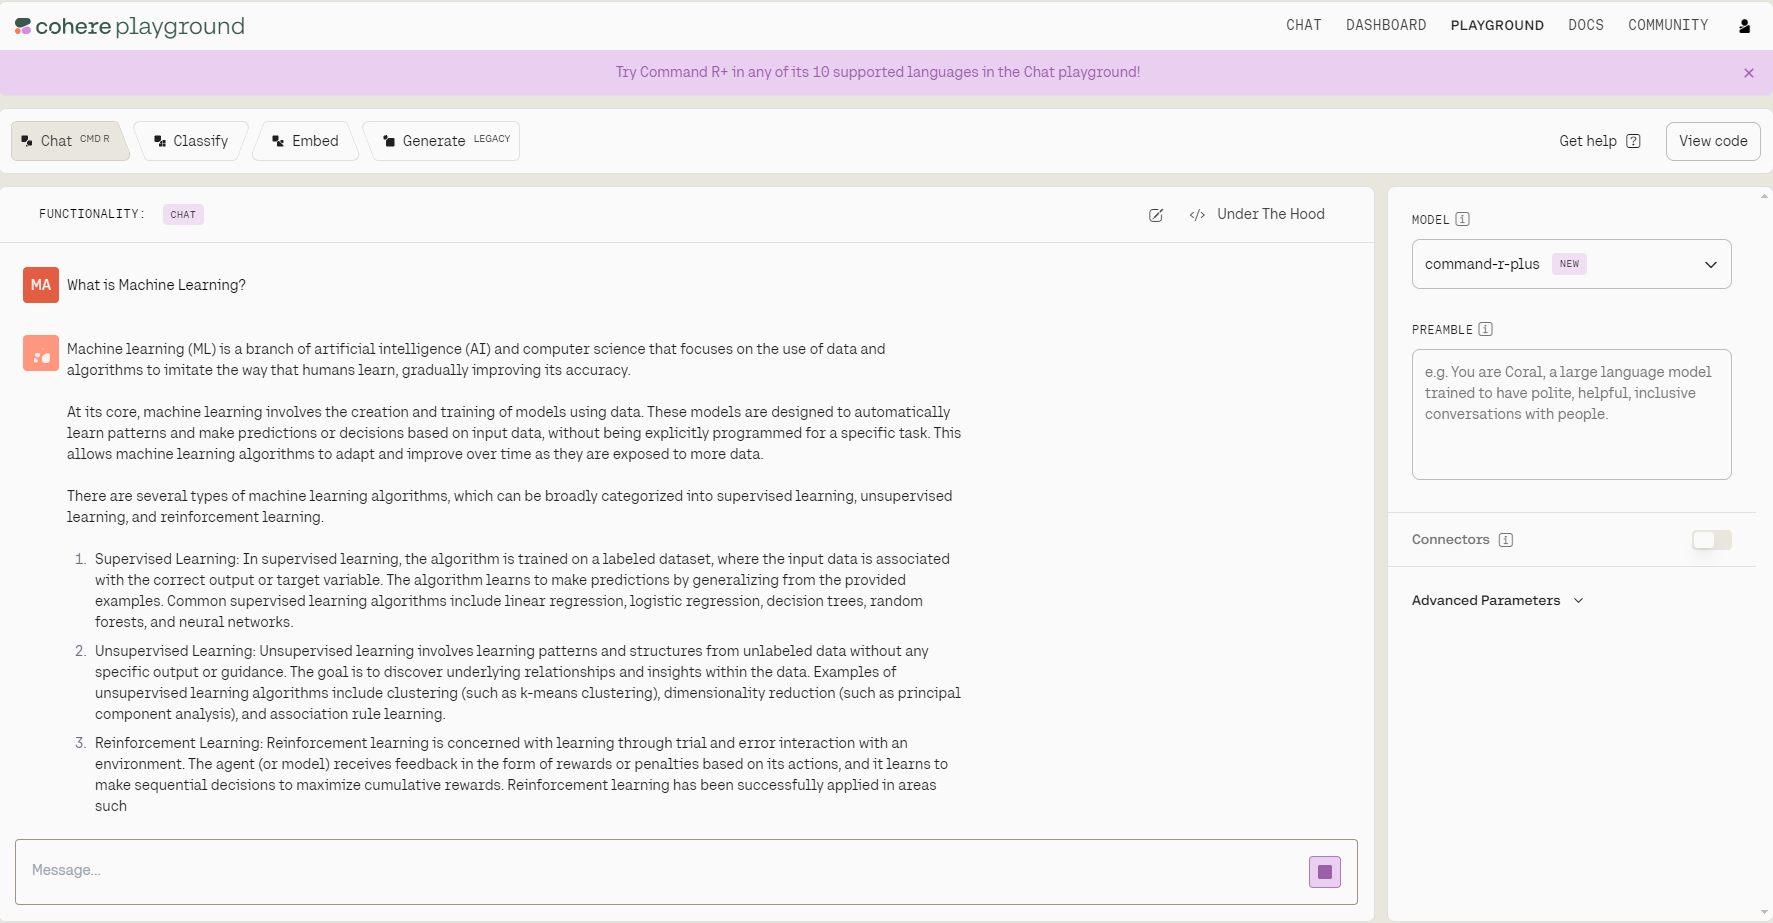
Dashboard di Cohere Playground
Cohere Playground è ottimo per testare rapidamente le capacità dei modelli Cohere, ma se stai costruendo un’applicazione o un flusso di lavoro ti serve un modo programmatico per accedere a questi modelli. È qui che entra in gioco l’API di Cohere!
Accedere all’API di Cohere è piuttosto semplice. In sintesi, dobbiamo:
Vediamo questi passaggi uno per uno.
Possiamo installare il client cohere usando pip.
!pip install cohereOra ci serve una chiave API.
Come si vede nell’immagine qui sotto, esistono due tipi di chiavi API: di produzione e di prova. Per lo scopo di questo tutorial, ci basta una chiave di prova. Possiamo copiarla cliccando sull’icona di copia accanto alla chiave.
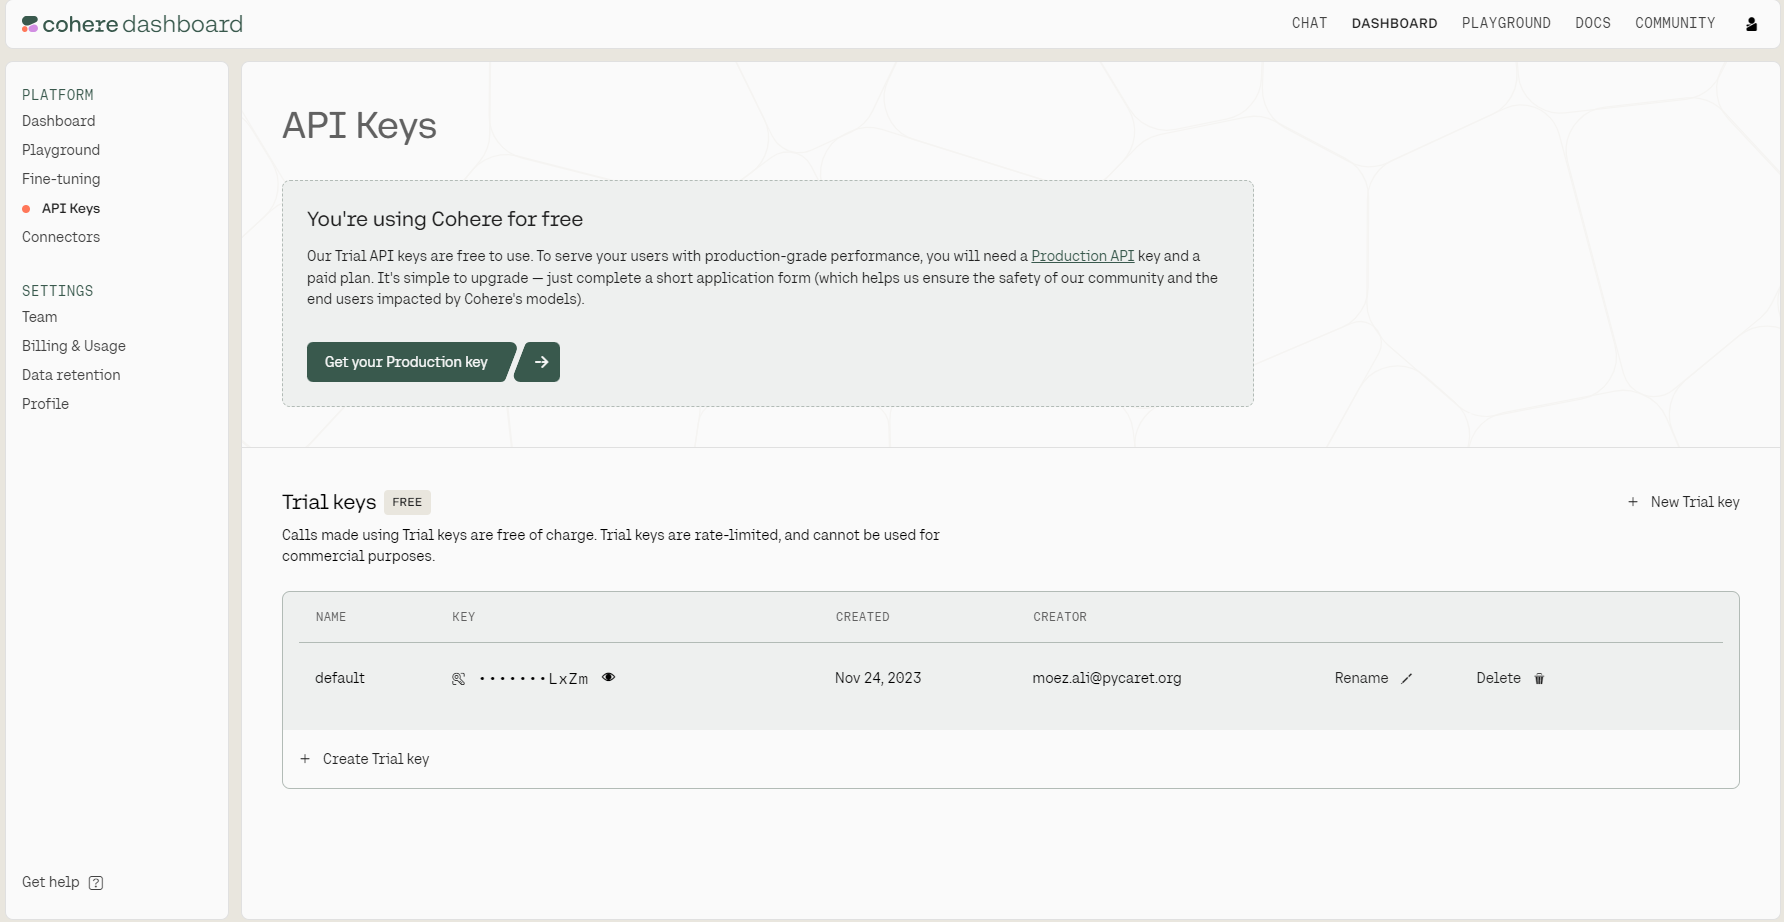
Ora che abbiamo installato la libreria cohere e abbiamo la nostra chiave API, possiamo effettuare una chiamata. Nel codice seguente, facciamo quanto segue:
cohere per interagire con la loro API.Client usando la nostra chiave API.co.chat().import cohere
co = cohere.Client('your_token_here')
message = "What is Machine Learning?"
response = co.chat(
message=message,
model="command",
temperature=0.3
)
answer = response.text
print(answer)Machine learning is a branch of computer science that focuses on developing algorithms and models that enable computers to learn and make predictions or decisions without being explicitly programmed. It is a key component of artificial intelligence (AI).
Machine Learning allows systems to identify patterns in data, uncover insights, and improve processes through iterative learning. Instead of writing explicit programs, ML enables the creation of models that can analyze data, identify patterns, and predict outcomes. These models are refined and optimized through a process known as training, which involves feeding the models annotated examples or real-world data.
(...)Prima abbiamo recuperato la risposta usando response.text. Ma l’oggetto di risposta contiene più informazioni, a cui possiamo accedere usando response.dict(): restituirà un file JSON con tutti i metadati, incluso il messaggio di risposta:
response.dict()
{
   "text":"Machine Learning (ML) is a ....",
   "generation_id":"cebf4874-1e3d-429a-8699-8b9639b943dd",
   "finish_reason":"COMPLETE",
   "chat_history":[
      {
         "message":"What is Machine Learning?",
         "role":"USER"
      },
      {
         "message":"Machine Learning (ML) is a ....",
         "role":"CHATBOT"
      }
   ],
   "meta":{
      "api_version":{
         "version":"1"
      },
      "billed_units":{
         "input_tokens":56,
         "output_tokens":252
      },
      "tokens":{
         "input_tokens":67,
         "output_tokens":252
      }
   },
   "response_id":"df34a5f8-f1cd-407f-b1b5-5971aa12ae2a"
}
Analizziamo ciascun campo dell’oggetto response:
text: contiene il messaggio generato dal modello.generation_id: contiene l’ID associato alla risposta generata, utilizzabile con l’endpoint Feedback API per segnalare buone risposte o riportare quelle scarse.finish_reason: indica perché la generazione è terminata e può essere uno dei seguenti:COMPLETE: il modello ha concluso con successo la generazione del messaggio.MAX_TOKENS: è stato raggiunto il limite di contesto del modello prima di completare la generazione.chat_history: contiene la conversazione presentata in formato registro chat.meta: contiene informazioni su conteggi di token, fatturazione, ecc.response_id: mentre generation_id riguarda un singolo tentativo di generazione del testo, response_id identifica l’intero oggetto di risposta contenente quel testo generato e altri dati pertinenti.Immagina di sviluppare un chatbot progettato per rispondere alle domande degli utenti. Avere il contesto delle conversazioni precedenti permette al modello linguistico di fornire risposte più pertinenti.
Nelle conversazioni multi-turn, mantenere il contesto delle interazioni precedenti è essenziale per generare risposte coerenti e rilevanti. L’API di Cohere facilita questo consentendoci di includere la cronologia della chat tramite il parametro chat_history.
Questo aiuta il modello a comprendere il flusso della conversazione e a rispondere in modo appropriato sulla base degli scambi precedenti. Vediamo un esempio.
message = "How is this related to Artificial Intelligence?"


response = co.chat(
  model="command-r-plus",
  chat_history=[
    {"role": "USER", "text": "What is Large Language Model?"},
    {"role": "CHATBOT", "text": "Large Language Model is a type ..."},
  ],
  message="How is this related to Artificial Intelligence?"
)


print(response.text)
Large language models (LLMs) are a key component of artificial intelligence (AI), and their development has played a significant role in advancing the field of AI. Here's how they are related:
1. Language Understanding and Generation: AI aims to create intelligent systems that can understand and respond to human language. LLMs are designed to process and generate human-like language, which is a fundamental aspect of human intelligence. By training on vast amounts of text data, LLMs learn to recognize patterns, syntax, semantics, and context, enabling them to interpret and generate language in a way that is similar to how humans do.
2. Machine Learning and Neural Networks: LLMs are typically built using machine learning techniques, particularly deep learning and neural networks. These are core areas of AI research. Neural networks, inspired by the structure of the human brain, enable LLMs to learn and make connections between different pieces of information. By training on large datasets, LLMs can identify patterns, relationships, and meanings in the data, which is a fundamental aspect of AI.
3. (...)Quando l’utente ha chiesto "How is this related to Artificial Intelligence?", il modello ha capito che "this" si riferiva ai large language models (LLM). Questo grazie al parametro chat_history, che ha fornito il contesto necessario dalle interazioni precedenti. Mantenere il contesto nelle conversazioni multi-turn è fondamentale per generare risposte pertinenti e coerenti.
Questo funziona bene, ma non è realistico passare manualmente il chat_history all’API come nell’esempio sopra. Invece di inserirlo nel codice, possiamo costruirlo dinamicamente man mano che la conversazione procede.
Ci sono diversi modi per farlo. Il più semplice è usare conversation_id nell’API. Ecco un esempio:
# First message
response = co.chat(
  model="command-r-plus",
  message="What is Large Language Models?",
  conversation_id='newuser1',
)

print(response.text)
Large Language Models (LLMs) are a type of artificial intelligence model specifically designed to process and generate human language. These models are typically based on deep learning and neural network architectures and are trained on vast amounts of text data. Here's an overview of LLMs and their key characteristics:
1. Definition:
- Large Language Models are machine learning models that are trained on large-scale textual data to understand, generate, and manipulate human language. They aim to capture the complexities of language, including syntax, semantics, and context.
2. Training Data:
- LLMs are trained on massive amounts of text data, often consisting of billions or even trillions of words. This training data can come from various sources such as books, articles, websites, social media, and other text-based documents.
3. (...)Ora inviamo al modello un altro messaggio: nota come conversation_id rimane coerente con il primo messaggio. Finché il conversation_id resta coerente, l’API userà automaticamente i messaggi precedenti come contesto.
# Second message
response = co.chat(
  model="command-r-plus",
  message="How is it related to Artificial Intelligence?",
  conversation_id='newuser1',
)
print(response.text)
Large Language Models (LLMs) are a crucial component and a powerful manifestation of Artificial Intelligence (AI). Here's how LLMs are closely related to AI:
1. AI Foundation:
- Artificial Intelligence is a broad field that encompasses the development of computer systems capable of performing tasks typically associated with human intelligence. This includes areas like machine learning, natural language processing, computer vision, robotics, and decision-making.
- LLMs fall under the umbrella of AI as they are designed to understand, generate, and respond to human language, which is a fundamental aspect of human intelligence.
2. Machine Learning:
- Machine learning is a subset of AI that focuses on the development of algorithms and models that enable computers to learn and improve over time, based on data and experience, without being explicitly programmed.
- LLMs are built using machine learning techniques, particularly deep learning and neural networks. They are trained on large datasets to identify patterns, understand context, and generate responses, demonstrating their ability to learn and improve from data.
3. (...)Se vuoi proseguire la conversazione, è necessario mantenere coerente il conversation_id, e ricorderà automaticamente tutte le conversazioni precedenti. Il conversation_id non va usato insieme a chat_history. Sono mutuamente esclusivi.
Per saperne di più, consulta la documentazione di Cohere.
Esaminiamo i prezzi del modello più avanzato di Cohere e confrontiamoli con i principali modelli linguistici proprietari di OpenAI e Anthropic (ci concentriamo sul modello più potente di ciascuna azienda). A maggio 2024, questi sono i prezzi:
|
Modello |
$ / milione token in input |
$ / milione token in output |
|
Cohere Command R+ |
$3.00 |
$15.00 |
|
Anthropic Claude Opus |
$15.00 |
$75.00 |
|
OpenAI GPT-4 Turbo |
$10.00 |
$30.00 |
Sebbene Cohere Command R+ offra un vantaggio di costo interessante, è importante considerare lo spettro di prestazioni più ampio di questi modelli. Anthropic Claude Opus e GPT-4 Turbo hanno dimostrato costantemente prestazioni superiori nei benchmark.
Che tu sia uno sviluppatore in cerca di potenziare le tue applicazioni o un’azienda che vuole integrare AI all’avanguardia, Cohere offre modelli di grandi dimensioni competitivi con altri modelli fondamentali come GPT e Claude, ma a un prezzo significativamente inferiore.
In questo blog, abbiamo visto cos’è Cohere e come accedervi usando il Playground o l’API.
Se vuoi approfondire l’argomento, ti consiglio questo code-along su Utilizzare i Large Language Models con l’API di Cohere.
Se vuoi andare ancora più a fondo e imparare a sviluppare applicazioni di AI end-to-end, dai un’occhiata a Sviluppare applicazioni LLM con LangChain.
Approfondisci API e LLM con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



