
Cursus
Werken met de OpenAI API
3 uur
179.5K
In het snel veranderende AI-landschap hebben de komst van large language models onze manier van tekstinteractie en -generatie ingrijpend veranderd. Sinds de release van OpenAI’s ChatGPT in november 2022 zien we dagelijks een nieuwe golf aan large language models verschijnen.
Onder deze modellen is Cohere Command uitgegroeid tot een favoriet onder professionals. Cohere biedt geavanceerde tools waarmee ontwikkelaars en bedrijven de kracht van foundation-modellen in hun applicaties en use-cases kunnen benutten.
Deze beginnersgids beschrijft het aanbod van Cohere’s API en verkent grondig de mogelijkheden, voordelen en praktische implementatiestrategieën.
We beginnen met een korte introductie van large language models. Wil je een uitgebreidere aanpak, bekijk dan deze cursus over Large Language Models (LLM’s).
Large Language Models (LLM’s) zijn geavanceerde AI-systemen die mensachtige tekst begrijpen en genereren. Ze worden getraind op enorme hoeveelheden data om complexe patronen te leren, taalnuances te begrijpen en samenhangende reacties te produceren.
LLM’s kunnen uiteenlopende taaltaken uitvoeren, waaronder vertalen, tekstaanvulling, samenvatten en conversatie.
Cohere is een belangrijke speler in dit domein en biedt een gebruiksvriendelijke API die data scientists toegang geeft tot deze LLM-capaciteiten en zo hun workflows stroomlijnt.
Cohere, opgericht in 2019, is een Canadees bedrijf dat AI-oplossingen voor bedrijven ontwikkelt. Het is snel uitgegroeid tot een prominente naam in de industrie van large language models (LLM’s) en wordt vaak genoemd naast concurrenten als OpenAI GPT en Anthropic Claude.
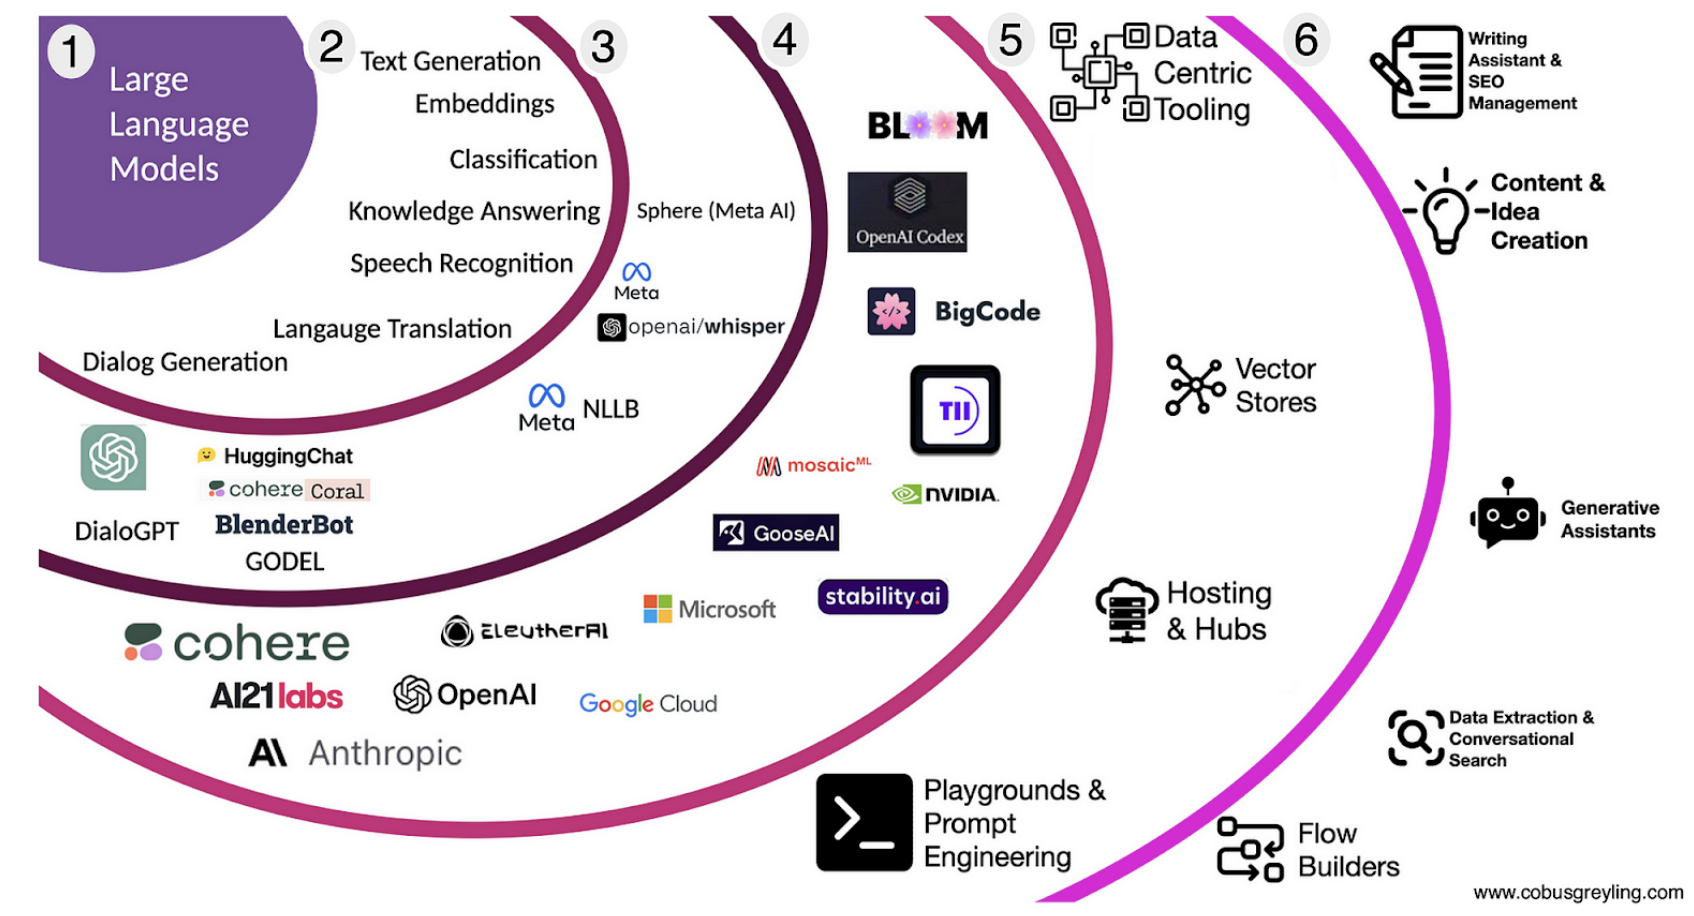
Bron: Cobus Greyling, Large Language Model Landscape, Medium
Cohere ontwikkelt en levert primair foundation-modellen voor taalgeneratie, die voornamelijk via de API-dienst toegankelijk zijn voor ontwikkelaars en bedrijven.
Cohere biedt grofweg drie typen modellen:
We kunnen Cohere-modellen op twee manieren gebruiken:
Cohere biedt ook een exclusieve chatinterface vergelijkbaar met ChatGPT—onder de motorkap aangedreven door Command R+.
Cohere Playground biedt een gebruiksvriendelijke interface om met Cohere-modellen te werken, met een intuïtieve ervaring vergelijkbaar met werken met GPT.
Gebruikers kunnen verschillende modelmogelijkheden verkennen en ermee experimenteren, tekst genereren en inzicht krijgen in het gedrag ervan. Met een strak en toegankelijk ontwerp kun je in Cohere Playground snel prototypes maken en Cohere’s modelaanbod testen.
Cohere Playground is gratis voor gebruikers om modellen te verkennen en mee te experimenteren (het is gratis totdat je naar productie gaat).
Om Cohere Playground te gebruiken, moeten we ons eerst aanmelden op Cohere’s website.
Vervolgens kunnen we inloggen en komen we op de onderstaande pagina terecht—die sterk lijkt op de playground van het OpenAI-platform. Met de dropdown aan de rechterkant kun je verschillende Cohere-modellen kiezen.
De Playground heeft licht verschillende interfaces voor verschillende taken. Bovenaan heb je vier opties om uit te kiezen: Chat, Classify, Embed en Generate.
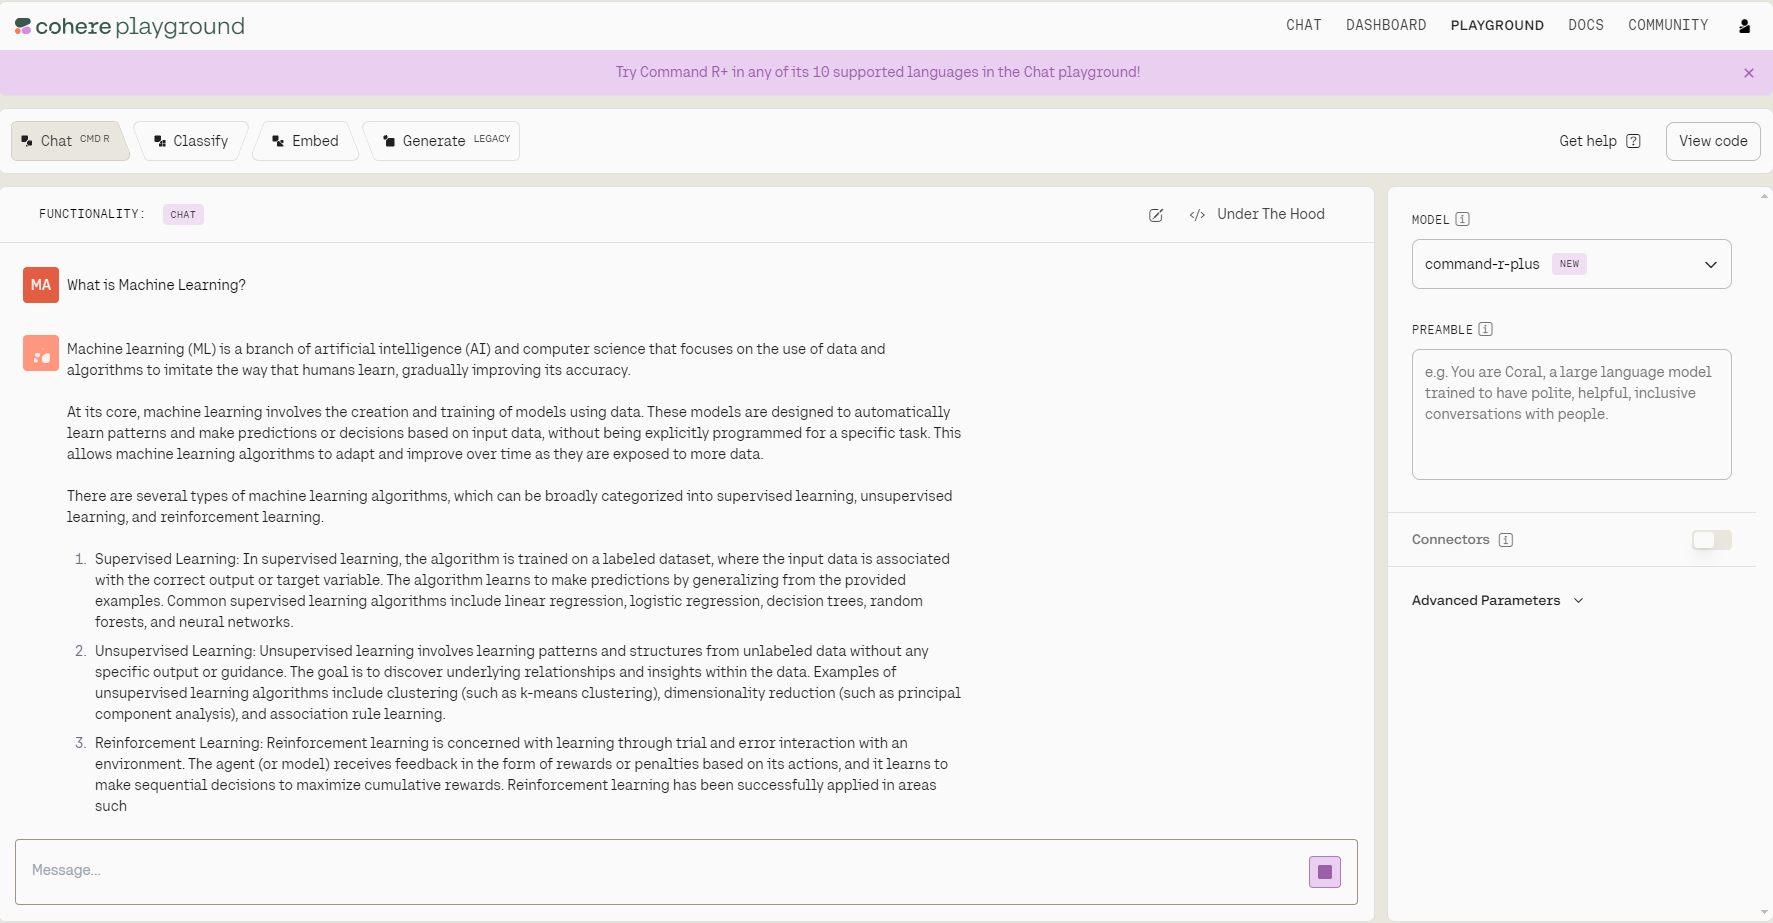
Dashboard van Cohere Playground
Cohere Playground is ideaal om snel de mogelijkheden van Cohere-modellen te testen, maar als je een applicatie of workflow bouwt, heb je een programmeerbare manier nodig om toegang te krijgen tot deze modellen. Daar komt de API van Cohere om de hoek kijken!
Toegang krijgen tot Cohere’s API is vrij eenvoudig. In een notendop moeten we:
Laten we deze stappen één voor één doornemen.
We kunnen de cohere-client installeren met pip.
!pip install cohereNu hebben we een API-sleutel nodig.
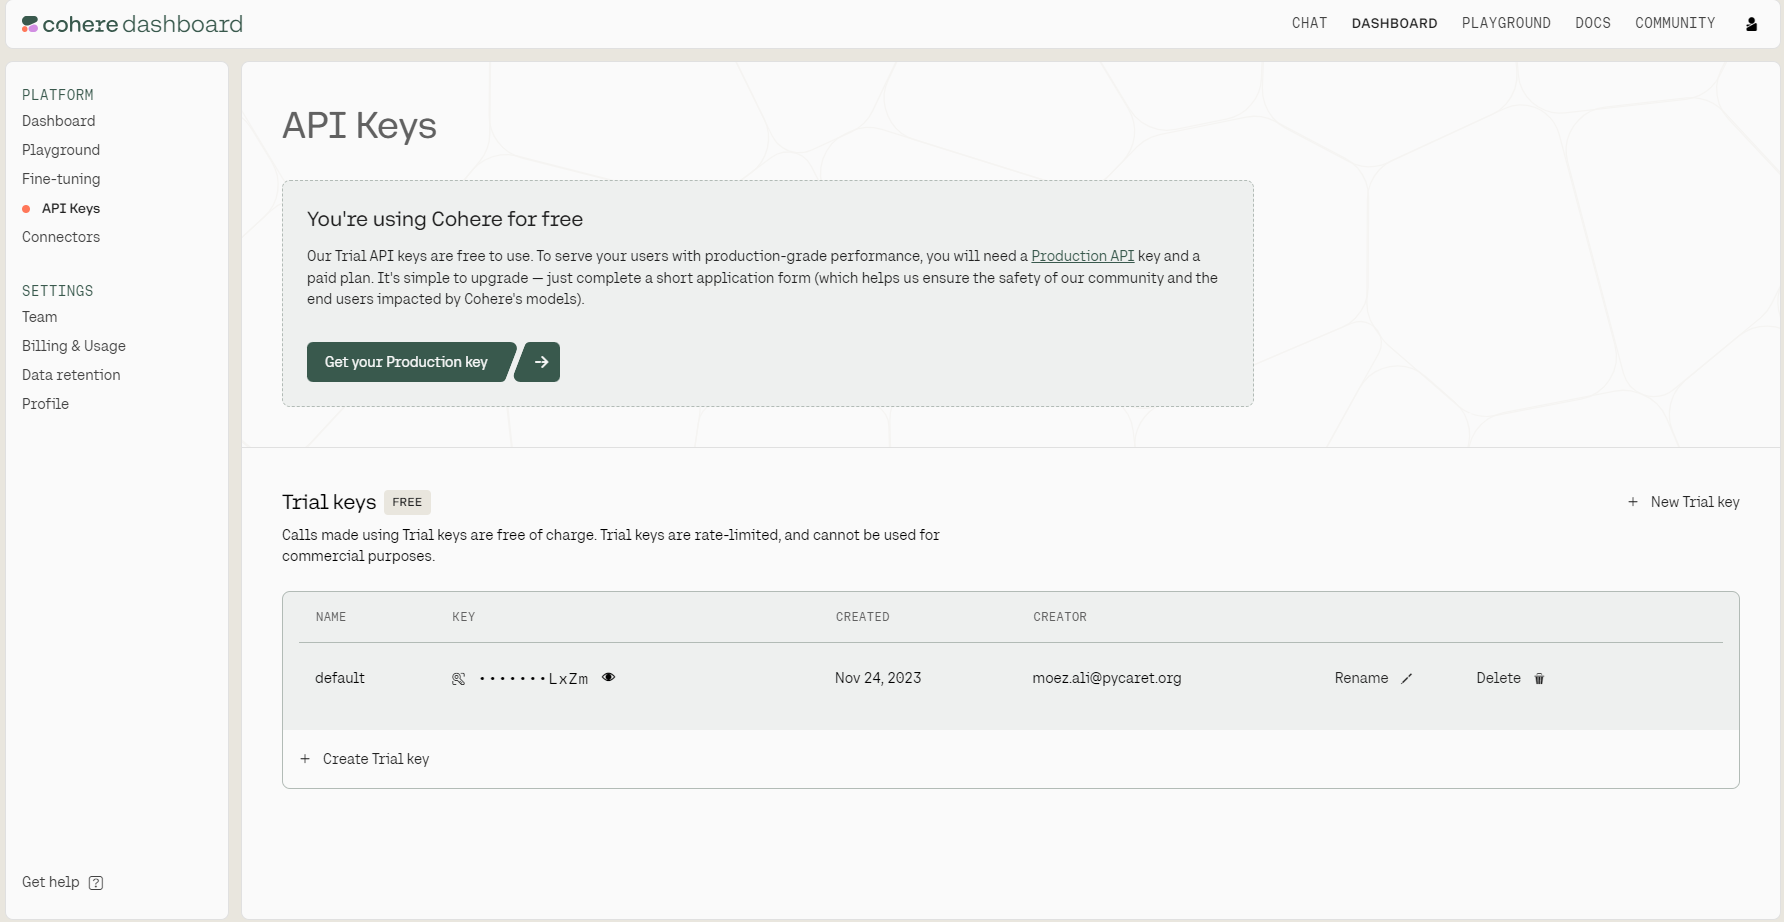
Zoals we in de onderstaande afbeelding zien, zijn er twee soorten API-sleutels: productie en proef. Voor deze tutorial hebben we alleen een proefsleutel nodig. We kunnen die kopiëren door op het kopieerpictogram naast de sleutel te klikken.
Nu we de cohere-bibliotheek geïnstalleerd hebben en onze API-sleutel hebben, kunnen we een API-aanroep doen. In de onderstaande code doen we het volgende:
cohere-bibliotheek importeren om met hun API te werken.Client-object maken met onze API-sleutel.co.chat().import cohere
co = cohere.Client('your_token_here')
message = "What is Machine Learning?"
response = co.chat(
message=message,
model="command",
temperature=0.3
)
answer = response.text
print(answer)Machine learning is a branch of computer science that focuses on developing algorithms and models that enable computers to learn and make predictions or decisions without being explicitly programmed. It is a key component of artificial intelligence (AI).
Machine Learning allows systems to identify patterns in data, uncover insights, and improve processes through iterative learning. Instead of writing explicit programs, ML enables the creation of models that can analyze data, identify patterns, and predict outcomes. These models are refined and optimized through a process known as training, which involves feeding the models annotated examples or real-world data.
(...)Eerder haalden we het antwoord op met response.text. Maar het response-object bevat meer informatie, en we kunnen die benaderen met response.dict()—dit retourneert een JSON-bestand met alle metadata, inclusief het bericht van de response:
response.dict()
{
   "text":"Machine Learning (ML) is a ....",
   "generation_id":"cebf4874-1e3d-429a-8699-8b9639b943dd",
   "finish_reason":"COMPLETE",
   "chat_history":[
      {
         "message":"What is Machine Learning?",
         "role":"USER"
      },
      {
         "message":"Machine Learning (ML) is a ....",
         "role":"CHATBOT"
      }
   ],
   "meta":{
      "api_version":{
         "version":"1"
      },
      "billed_units":{
         "input_tokens":56,
         "output_tokens":252
      },
      "tokens":{
         "input_tokens":67,
         "output_tokens":252
      }
   },
   "response_id":"df34a5f8-f1cd-407f-b1b5-5971aa12ae2a"
}
Laten we elk veld van het response-object doornemen:
text: Bevat het bericht dat door het model is gegenereerd.generation_id: Bevat de ID die hoort bij het gegenereerde antwoord; deze kan met de Feedback API-endpoint worden gebruikt om goede reacties te highlighten en slechte te rapporteren.finish_reason: Geeft aan waarom de generatie is gestopt en kan een van de volgende zijn:COMPLETE: Het model heeft het bericht succesvol gegenereerd.MAX_TOKENS: De contextlimiet van het model is bereikt voordat de generatie kon worden voltooid.chat_history: Bevat het gesprek in chatlog-indeling.meta: Bevat informatie over tokenaantallen, facturatie, enzovoort.response_id: Waar generation_id zich richt op één enkele generatiepoging, identificeert response_id het volledige response-object met de gegenereerde tekst en andere relevante data.Stel je bouwt een chatbot die gebruikersvragen moet beantwoorden. Context uit eerdere gesprekken kan het taalmodel helpen om relevantere antwoorden te geven.
In gesprekken met meerdere beurten is het essentieel om de context van eerdere interacties te behouden om samenhangende en relevante reacties te genereren. Cohere’s API faciliteert dit door ons toe te staan de chathistorie mee te geven via de parameter chat_history.
Dit helpt het model de conversatiestroom te begrijpen en passend te reageren op basis van eerdere uitwisselingen. Laten we een voorbeeld bekijken.
message = "How is this related to Artificial Intelligence?"


response = co.chat(
  model="command-r-plus",
  chat_history=[
    {"role": "USER", "text": "What is Large Language Model?"},
    {"role": "CHATBOT", "text": "Large Language Model is a type ..."},
  ],
  message="How is this related to Artificial Intelligence?"
)


print(response.text)
Large language models (LLMs) are a key component of artificial intelligence (AI), and their development has played a significant role in advancing the field of AI. Here's how they are related:
1. Language Understanding and Generation: AI aims to create intelligent systems that can understand and respond to human language. LLMs are designed to process and generate human-like language, which is a fundamental aspect of human intelligence. By training on vast amounts of text data, LLMs learn to recognize patterns, syntax, semantics, and context, enabling them to interpret and generate language in a way that is similar to how humans do.
2. Machine Learning and Neural Networks: LLMs are typically built using machine learning techniques, particularly deep learning and neural networks. These are core areas of AI research. Neural networks, inspired by the structure of the human brain, enable LLMs to learn and make connections between different pieces of information. By training on large datasets, LLMs can identify patterns, relationships, and meanings in the data, which is a fundamental aspect of AI.
3. (...)Toen de gebruiker vroeg: "How is this related to Artificial Intelligence?", begreep het model dat met "this" naar large language models (LLM’s) werd verwezen. Dat is te danken aan de parameter chat_history, die de nodige context uit eerdere interacties meegaf. Context behouden in meerbeurtengesprekken is cruciaal om relevante en samenhangende reacties te genereren.
Dit werkt prima, maar het is niet realistisch om de chat_history handmatig aan de API door te geven zoals we hierboven deden. In plaats van de chat_history hard te coderen, kunnen we die dynamisch opbouwen terwijl we het gesprek voeren.
Er zijn meerdere manieren om dit te bereiken. De eenvoudigste is het gebruik van conversation_id in de API. Laten we een voorbeeld bekijken:
# First message
response = co.chat(
  model="command-r-plus",
  message="What is Large Language Models?",
  conversation_id='newuser1',
)

print(response.text)
Large Language Models (LLMs) are a type of artificial intelligence model specifically designed to process and generate human language. These models are typically based on deep learning and neural network architectures and are trained on vast amounts of text data. Here's an overview of LLMs and their key characteristics:
1. Definition:
- Large Language Models are machine learning models that are trained on large-scale textual data to understand, generate, and manipulate human language. They aim to capture the complexities of language, including syntax, semantics, and context.
2. Training Data:
- LLMs are trained on massive amounts of text data, often consisting of billions or even trillions of words. This training data can come from various sources such as books, articles, websites, social media, and other text-based documents.
3. (...)En nu sturen we het model nog een bericht—let op dat conversation_id gelijk blijft aan het eerste bericht. Zolang conversation_id consistent blijft, gebruikt de API automatisch eerdere berichten als context.
# Second message
response = co.chat(
  model="command-r-plus",
  message="How is it related to Artificial Intelligence?",
  conversation_id='newuser1',
)
print(response.text)
Large Language Models (LLMs) are a crucial component and a powerful manifestation of Artificial Intelligence (AI). Here's how LLMs are closely related to AI:
1. AI Foundation:
- Artificial Intelligence is a broad field that encompasses the development of computer systems capable of performing tasks typically associated with human intelligence. This includes areas like machine learning, natural language processing, computer vision, robotics, and decision-making.
- LLMs fall under the umbrella of AI as they are designed to understand, generate, and respond to human language, which is a fundamental aspect of human intelligence.
2. Machine Learning:
- Machine learning is a subset of AI that focuses on the development of algorithms and models that enable computers to learn and improve over time, based on data and experience, without being explicitly programmed.
- LLMs are built using machine learning techniques, particularly deep learning and neural networks. They are trained on large datasets to identify patterns, understand context, and generate responses, demonstrating their ability to learn and improve from data.
3. (...)Als je het gesprek wilt voortzetten, moeten we de conversation_id consistent houden; dan onthoudt het systeem automatisch alle eerdere uitwisselingen. De conversation_id moet niet samen met de chat_history worden gebruikt. Ze sluiten elkaar uit.
Wil je meer weten, bekijk dan Cohere’s documentatie.
Laten we de prijs van Cohere’s meest geavanceerde model bekijken en vergelijken met de top proprietary language models van OpenAI en Anthropic (we focussen op het krachtigste model van elk bedrijf). Per mei 2024 zijn dit de prijzen:
|
Model |
$ / miljoen inputtokens |
$ / miljoen outputtokens |
|
Cohere Command R+ |
$3.00 |
$15.00 |
|
Anthropic Claude Opus |
$15.00 |
$75.00 |
|
OpenAI GPT-4 Turbo |
$10.00 |
$30.00 |
Hoewel Cohere Command R+ een aantrekkelijke kostenvoordeel biedt, is het belangrijk het bredere prestatielandschap van deze modellen mee te nemen. Anthropic Claude Opus en GPT-4 Turbo laten in benchmarks consequent sterkere prestaties zien.
Of je nu een ontwikkelaar bent die je applicaties wilt verbeteren of een bedrijf dat toonaangevende AI wil integreren: Cohere biedt grote modellen die kunnen concurreren met andere foundation-modellen, zoals GPT en Claude—maar dan tegen een aanzienlijk lagere prijs.
In deze blog hebben we geleerd wat Cohere is en hoe je er toegang toe krijgt via de Playground of de API.
Wil je dieper duiken in het onderwerp, bekijk dan deze code-along over Large Language Models gebruiken met de Cohere API.
Wil je nog verder gaan en leren hoe je end-to-end AI-applicaties ontwikkelt, bekijk dan Developing LLM Applications with LangChain.
Leer meer over API’s en LLM’s met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

