Last chance! 50% off DataCamp Premium
Sale ends in
Walaupun sistem RAG tradisional efektif, ada satu kelemahan besar: dokumen sering dipecah menjadi potongan kecil untuk memudahkan retrieval, tetapi hal ini bisa menghilangkan konteks penting.
Sebagai contoh, sebuah potongan mungkin berbunyi “Lebih dari 3,85 juta penduduknya menjadikannya kota terpadat di Uni Eropa” tanpa menyebutkan kota atau negara mana yang dimaksud. Kekurangan konteks ini dapat menghasilkan jawaban yang tidak lengkap atau tidak relevan, terutama saat detail spesifik dibutuhkan.
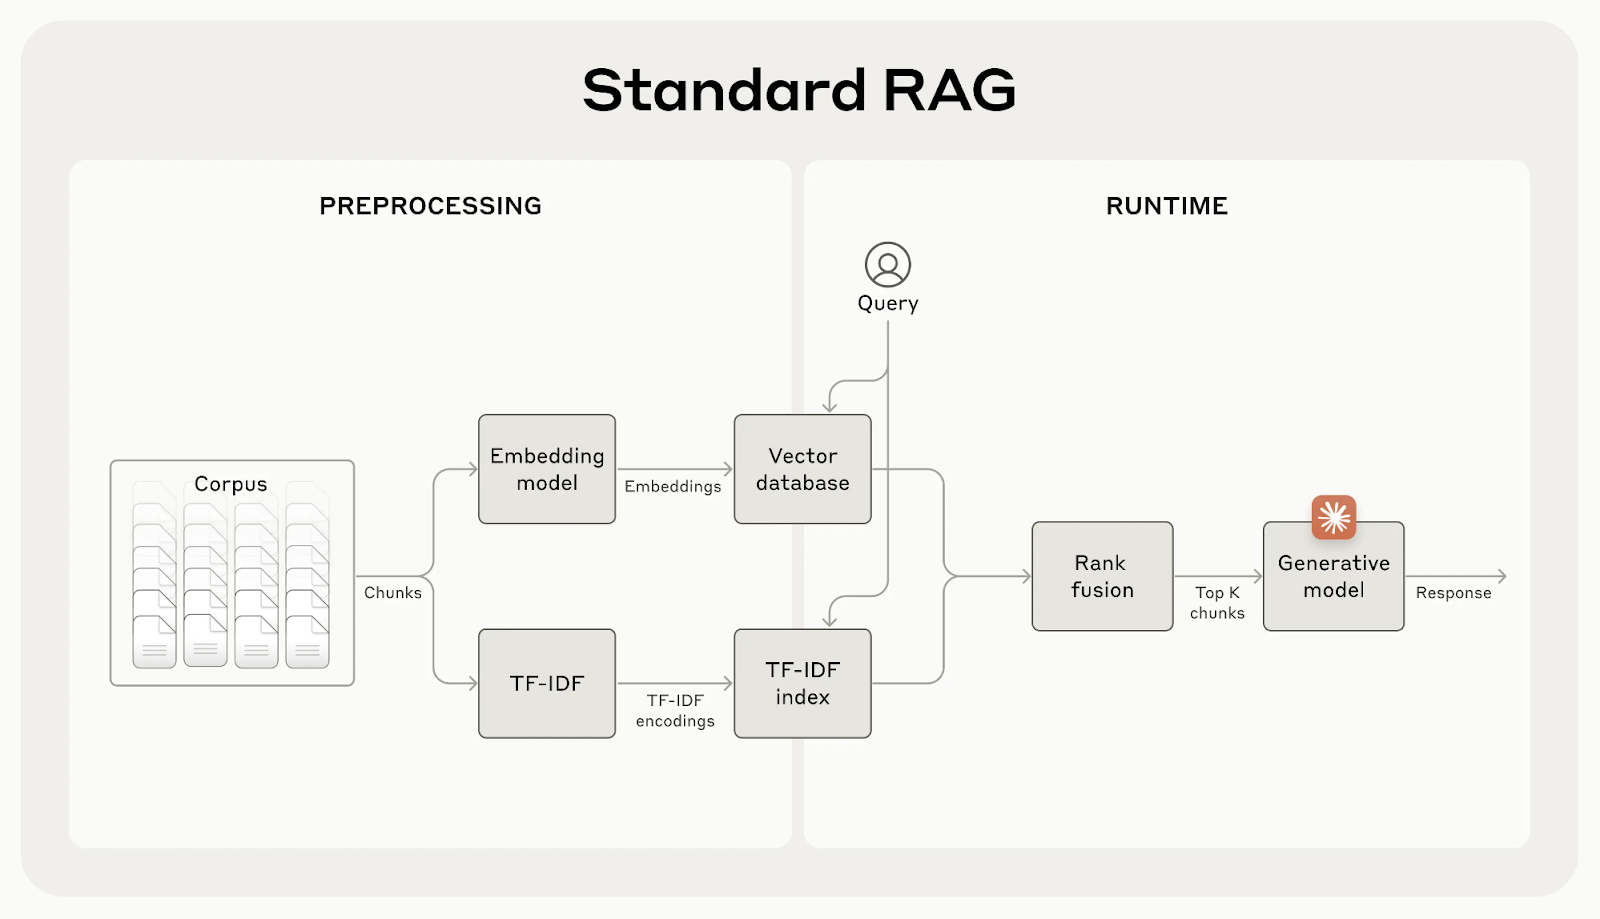
Sumber: Introducing Contextual Retrieval
Contextual retrieval mengatasi masalah ini dengan menghasilkan dan menambahkan penjelasan singkat yang spesifik konteks ke setiap potongan sebelum di-embed. Pada contoh di atas, potongan tersebut akan diubah sebagai berikut:
contextualized_chunk = """Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
"""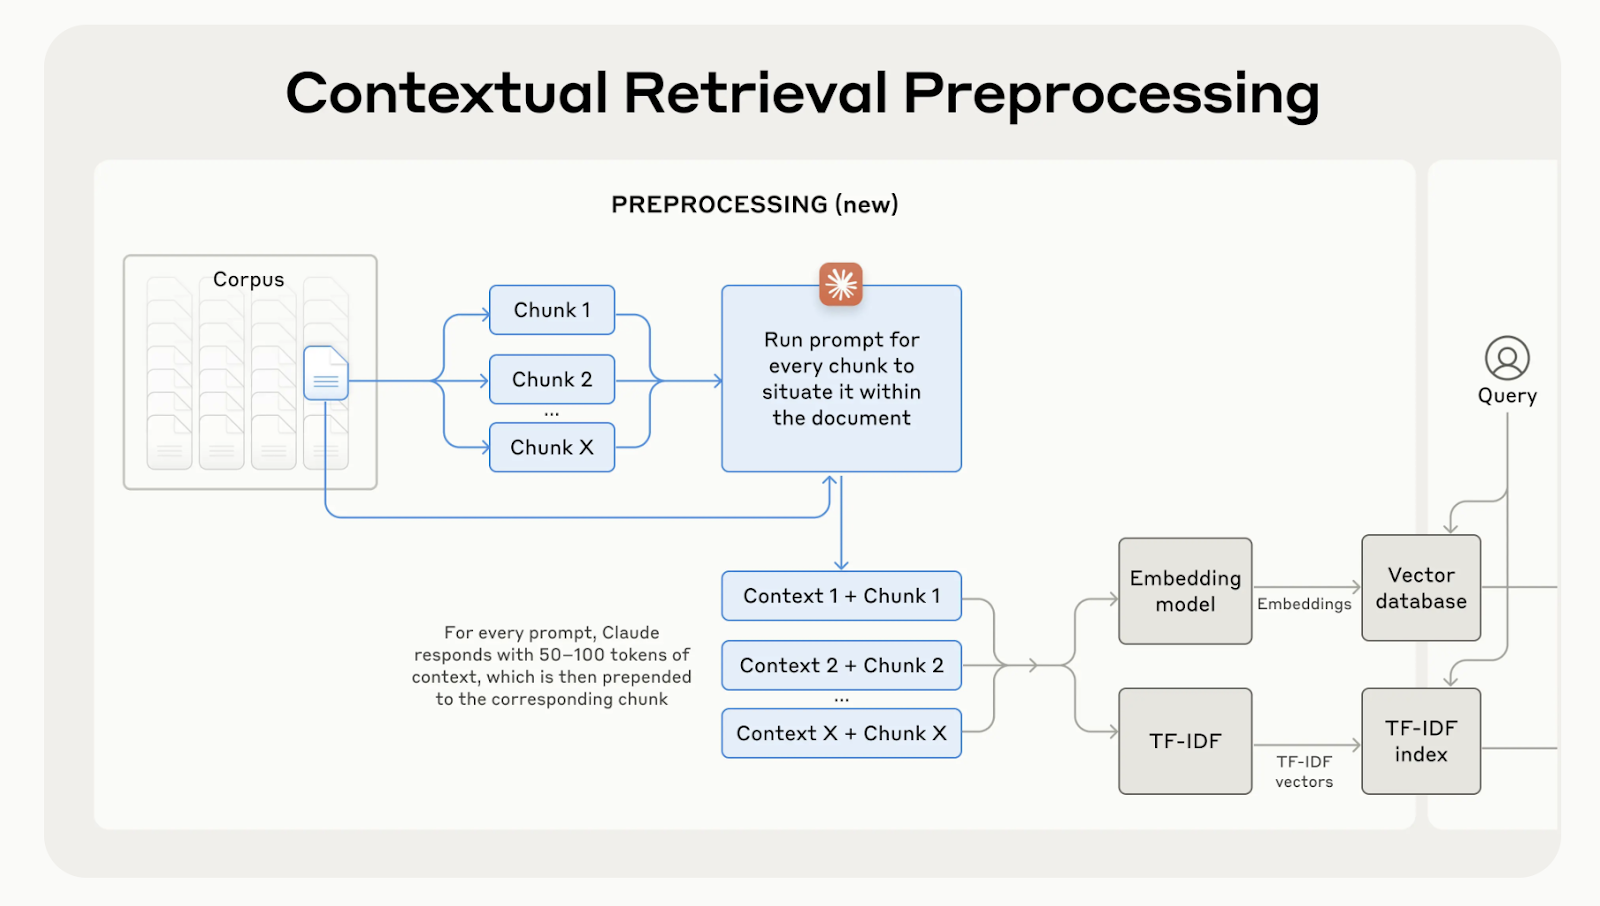
Sumber: Introducing Contextual Retrieval
Secara keseluruhan, pengujian internal Anthropic di berbagai bidang, termasuk basis kode, makalah ilmiah, dan fiksi, menunjukkan bahwa contextual retrieval mengurangi kesalahan retrieval sebesar 49% ketika digunakan dengan model contextual embedding dan Contextual BM25.
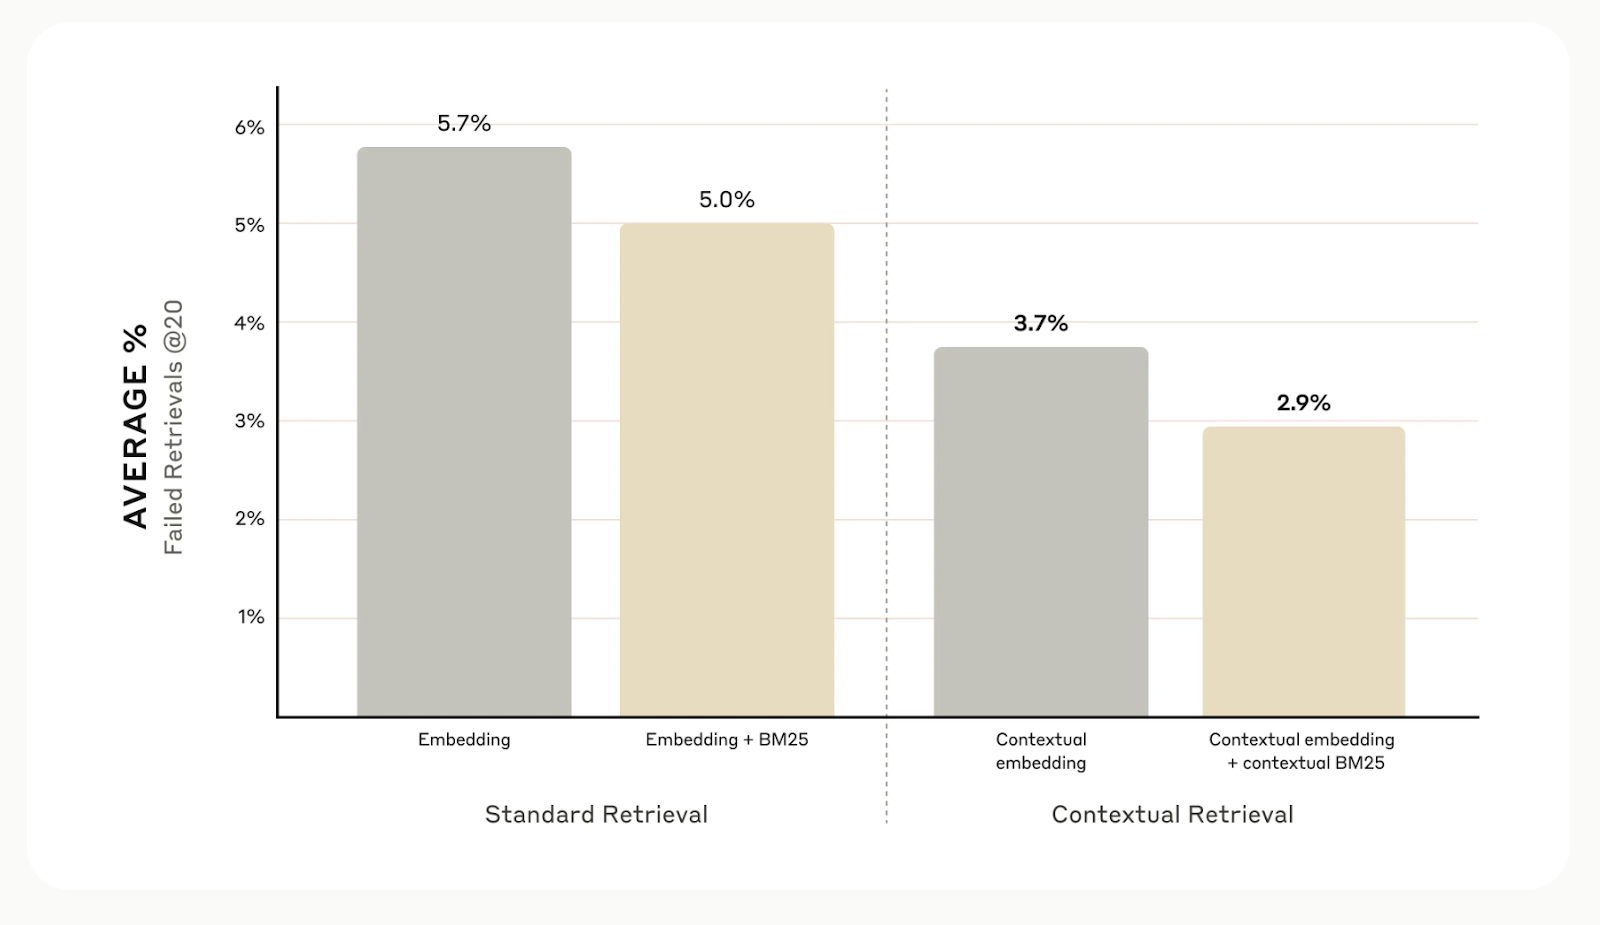
Sumber: Introducing Contextual Retrieval
Sekarang saya akan menjelaskan langkah demi langkah cara mengimplementasikan contextual retrieval. Kita akan menggunakan dokumen contoh berikut sebagai ilustrasi:
# Input text for the knowledge base
input_text = """Berlin is the capital and largest city of Germany, both by area and by population.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
The city is also one of the states of Germany and is the third smallest state in the country in terms of area.
Paris is the capital and most populous city of France.
It is situated along the Seine River in the north-central part of the country.
The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."""
Langkah pertama adalah memecah dokumen contoh menjadi potongan kecil yang berdiri sendiri. Dalam kasus ini, kita akan membaginya menjadi kalimat-kalimat individual.
# Splitting the input text into smaller chunks
test_chunks = [
    'Berlin is the capital and largest city of Germany, both by area and by population.',
    "\\n\\nIts more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.",
    '\\n\\nThe city is also one of the states of Germany and is the third smallest state in the country in terms of area.',
    '\\n\\n# Paris is the capital and most populous city of France.',
    '\\n\\n# It is situated along the Seine River in the north-central part of the country.',
    "\\n\\n# The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."
]Berikutnya, kita akan menyiapkan prompt yang akan digunakan model untuk menghasilkan konteks bagi setiap potongan. Anthropic telah menyediakan templat yang bermanfaat. Prompt ini akan menerima dua masukan: seluruh dokumen dan potongan teks spesifik yang ingin kita tempatkan dalam konteks.
from langchain.prompts import ChatPromptTemplate, PromptTemplate, HumanMessagePromptTemplate

# Define the prompt for generating contextual information
anthropic_contextual_retrieval_system_prompt = """<document>
{WHOLE_DOCUMENT}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{CHUNK_CONTENT}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else."""

# Create a PromptTemplate for WHOLE_DOCUMENT and CHUNK_CONTENT
anthropic_prompt_template = PromptTemplate(
    input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
    template=anthropic_contextual_retrieval_system_prompt
)

# Wrap the prompt in a HumanMessagePromptTemplate
human_message_prompt = HumanMessagePromptTemplate(prompt=anthropic_prompt_template)
# Create the final ChatPromptTemplate
anthropic_contextual_retrieval_final_prompt = ChatPromptTemplate(
    input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
    messages=[human_message_prompt]
)Di sini, Anda dapat memilih LLM apa pun untuk menghasilkan konteks bagi setiap potongan. Untuk contoh kita, kita akan menggunakan model GPT-4o dari OpenAI.
import os
from langchain_openai import ChatOpenAI

# Load environment variables
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

# Initialize the model instance
llm_model_instance = ChatOpenAI(
    model="gpt-4o",
)Kita akan menghubungkan templat prompt dengan model bahasa untuk membuat rantai LLM yang siap memproses potongan yang telah kita buat sebelumnya.
from langchain.output_parsers import StrOutputParser

# Chain the prompt with the model instance
contextual_chunk_creation = anthropic_contextual_retrieval_final_prompt | llm_model_instance | StrOutputParser()Sekarang kita akan melakukan loop pada potongan-potongan tersebut, menghasilkan informasi kontekstual untuk masing-masing, dan mencetak hasilnya menggunakan rantai LLM contextual_chunk_creation.
# Process each chunk and generate contextual information
for test_chunk in test_chunks:
    res = contextual_chunk_creation.invoke({
        "WHOLE_DOCUMENT": input_text,
        "CHUNK_CONTENT": test_chunk
    })
    print(res)
    print('-----')
The document compares Berlin and Paris, highlighting Berlin as Germany's capital and largest city by area and population, and noting its significance within the European Union.
-----
Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
-----
Berlin is the capital and largest city of Germany, both by area and by population.
-----
Paris, the capital of France, is a major population center in Europe with over 2.1 million residents.
-----
Paris is the capital and most populous city of France.
-----
Paris is the capital and most populous city of France, with a population of over 2.1 million residents within its administrative limits.
-----Meskipun contextual retrieval meningkatkan akurasi retrieval, Anda dapat membawanya lebih jauh dengan reranking. Teknik penyaringan ini memastikan hanya potongan yang paling relevan yang dikirim ke model, sehingga meningkatkan kualitas respons sekaligus menurunkan biaya dan waktu pemrosesan.
Reranking bekerja dengan memberi skor pada potongan yang diambil pada langkah pertama dan hanya mempertahankan yang terbaik. Dalam pengujian kami, reranking menurunkan kesalahan retrieval dari 5,7% menjadi hanya 1,9%, meningkatkan akurasi sebesar 67% dibandingkan metode tradisional.
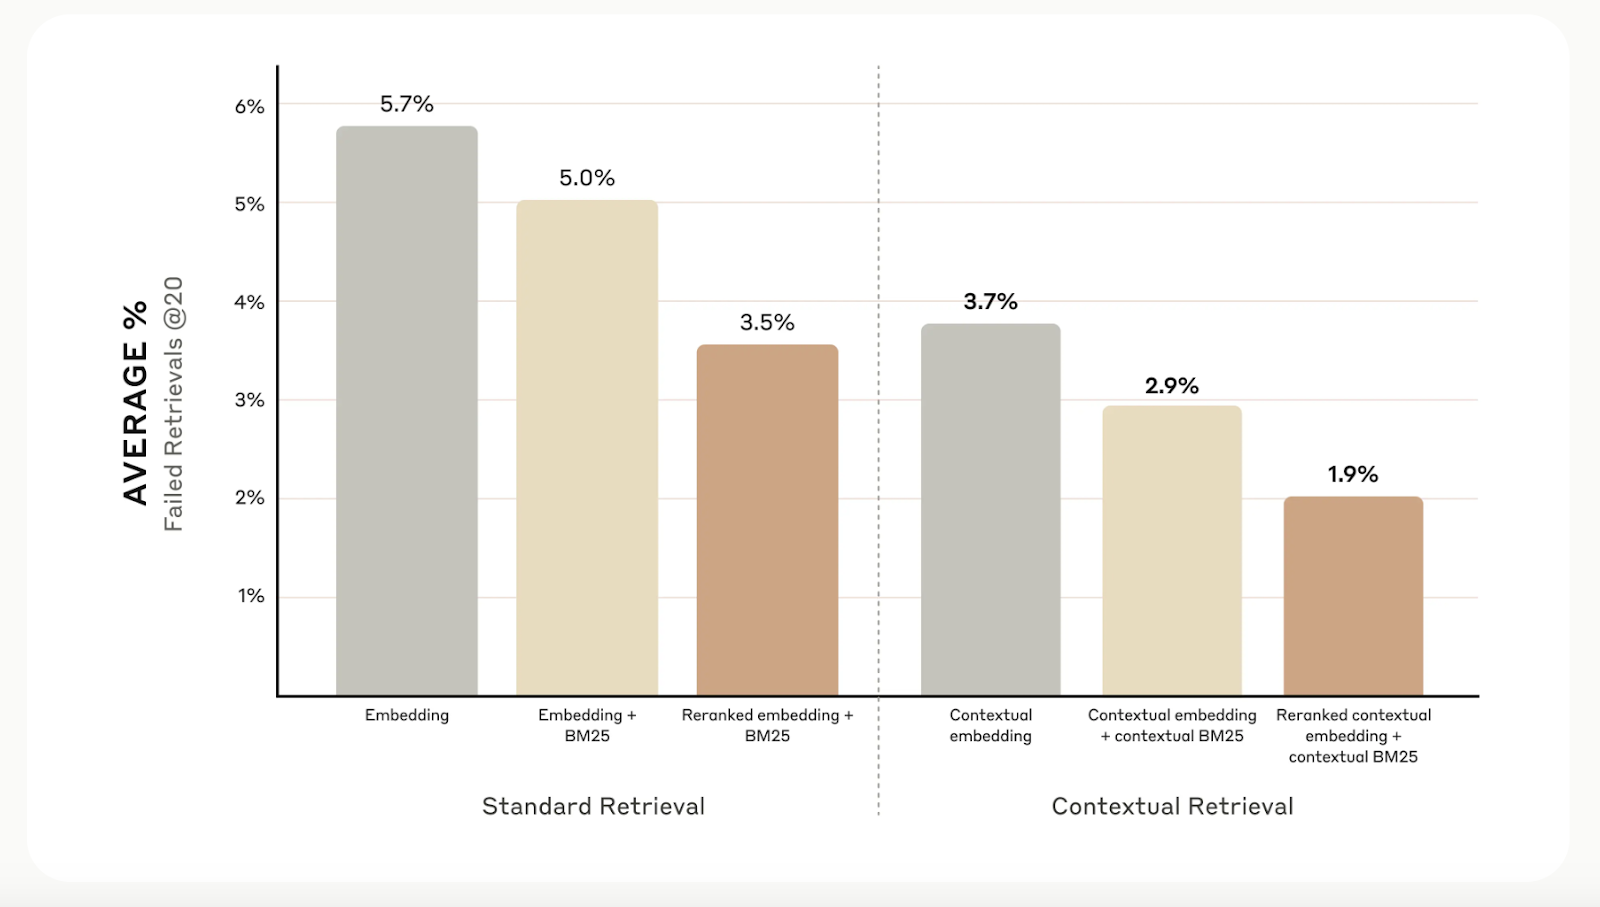
Sumber: Introducing Contextual Retrieval
Riset Anthropic menemukan bahwa tidak semua situasi memerlukan kompleksitas contextual retrieval. Untuk basis pengetahuan kecil di bawah 200.000 token (sekitar 500 halaman), opsi yang lebih baik mungkin memasukkan seluruh basis pengetahuan langsung ke dalam prompt model, sehingga tidak perlu sistem retrieval sama sekali.
Mereka juga menyarankan memanfaatkan prompt caching, fitur yang diperkenalkan untuk Claude. Dengan melakukan cache pada prompt yang sering digunakan di antara panggilan API, pengembang dapat memangkas biaya hingga 90% dan mempercepat waktu respons lebih dari dua kali. Buku resep prompt caching ini menyediakan panduan langkah demi langkah untuk mengimplementasikannya.
Contextual retrieval dari Anthropic adalah metode yang sederhana namun efektif untuk meningkatkan sistem retrieval. Menggabungkan contextual embeddings, BM25, dan reranking secara signifikan meningkatkan akurasi sistem ini.
Untuk mempelajari lebih lanjut teknik retrieval yang berbeda, saya merekomendasikan blog berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt