
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
Intinya, prompt caching bekerja dengan menyimpan prompt dan responsnya di cache. Saat prompt yang sama atau serupa dikirimkan lagi, sistem mengambil respons yang di-cache alih-alih menghasilkan yang baru. Ini menghindari komputasi berulang, mempercepat waktu respons, dan mengurangi biaya.
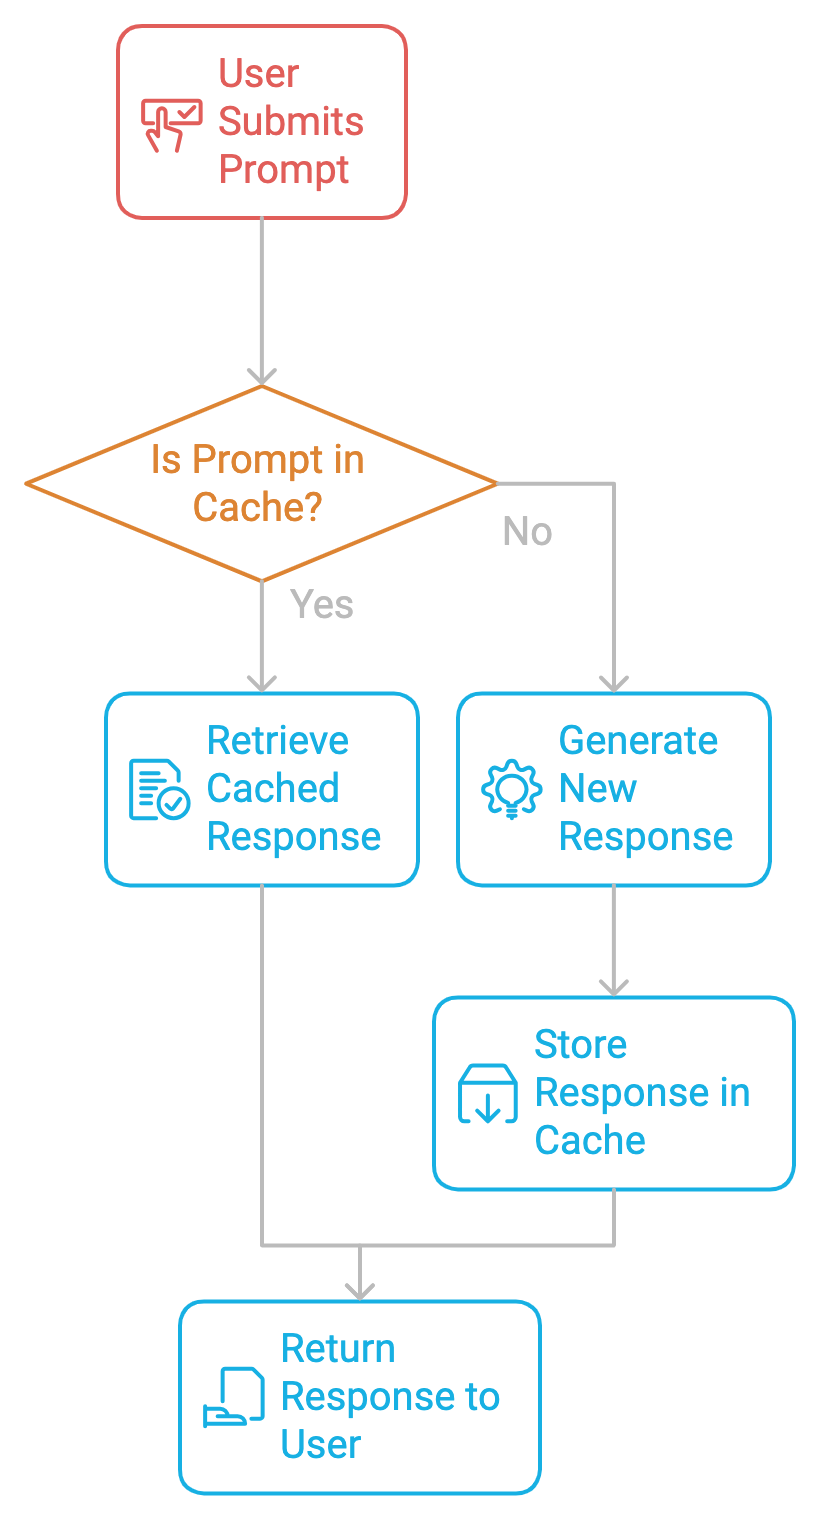
Prompt caching memiliki beberapa manfaat:
Sebelum kita menyelami lebih dalam implementasi prompt caching, kita perlu mengingat beberapa pertimbangan.
Untuk memastikan kebaruan data, setiap respons yang di-cache harus memiliki Time-to-Live (TTL) di memori. TTL menentukan berapa lama respons yang di-cache dianggap valid. Setelah TTL kedaluwarsa, entri cache dihapus atau diperbarui, dan prompt terkait dihitung ulang saat diminta berikutnya.
Mekanisme ini memastikan cache tidak menyimpan informasi usang. Untuk konten statis atau jarang diperbarui, seperti dokumen legal atau manual produk, TTL yang lebih lama dapat membantu mengurangi perhitungan ulang tanpa berisiko data basi. Karena itu, penyetelan nilai TTL yang tepat penting untuk menjaga keseimbangan antara kebaruan data dan efisiensi komputasi.
Terkadang, dua prompt serupa tetapi tidak identik. Menentukan seberapa dekat prompt baru dengan yang sudah ada di cache sangat penting untuk caching yang efektif. Penerapan kemiripan prompt memerlukan teknik seperti fuzzy matching atau pencarian semantik, di mana sistem menggunakan embedding vektor untuk merepresentasikan prompt dan membandingkan kemiripannya.
Dengan melakukan cache respons untuk prompt serupa, sistem dapat mengurangi perhitungan ulang sambil mempertahankan akurasi respons yang tinggi. Namun, ambang kemiripan yang terlalu longgar dapat menimbulkan ketidaksesuaian, sedangkan yang terlalu ketat dapat melewatkan peluang caching.
Strategi seperti Least Recently Used (LRU) membantu mengelola ukuran cache. Metode LRU menghapus data yang paling jarang diakses saat cache mencapai kapasitasnya. Strategi ini cocok untuk skenario di mana prompt tertentu lebih populer dan perlu tetap di-cache, sementara kueri yang kurang umum dapat dihapus untuk memberi ruang bagi permintaan yang lebih baru.
Mengimplementasikan prompt caching adalah proses dua langkah.
Langkah pertama dalam menerapkan prompt caching adalah mengidentifikasi prompt berulang yang sering muncul di sistem. Baik saat membangun chatbot, asisten pengodean, atau pemroses dokumen, kita perlu memantau prompt mana yang berulang. Setelah teridentifikasi, prompt tersebut dapat di-cache untuk menghindari komputasi yang berulang.
Setelah prompt diidentifikasi, responsnya disimpan di cache beserta metadata seperti time-to-live (TTL), rasio hit/miss cache, dan lainnya. Setiap kali pengguna mengirimkan prompt yang sama lagi, sistem mengambil respons yang di-cache, melewati proses generasi yang mahal.
Dengan semua pengetahuan teoretis, mari masuk ke contoh praktis menggunakan Ollama untuk melihat dampak caching dibandingkan tanpa caching di lingkungan lokal. Di sini, kami menggunakan data dari buku deep learning yang dihosting di web dan model lokal untuk meringkas beberapa halaman pertama buku. Kita akan bereksperimen dengan beberapa LLM, termasuk Gemma2, Llama2, dan Llama3, untuk membandingkan kinerjanya.
Untuk contoh praktis ini, kita akan menggunakan BeautifulSoup, paket Python yang mengurai dokumen HTML dan XML, termasuk yang memiliki markup tidak rapi. Untuk memasang BeautifulSoup, jalankan perintah berikut:
!pip install BeautifulSoupAlat lain yang akan kita gunakan adalah Ollama. Ini mempermudah pemasangan dan pengelolaan model bahasa besar di sistem lokal.
Untuk memulai, unduh Ollama dan pasang Ollama di desktop Anda. Kita dapat menyesuaikan nama model sesuai kebutuhan. Lihat pustaka model di situs resmi Ollama untuk melihat berbagai model yang didukung Ollama. Jalankan kode berikut di terminal:
ollama run llama3.1 Semua sudah siap. Mari mulai!
Kita mulai dengan impor berikut:
time untuk melacak waktu inferensi untuk kode dengan caching dan tanpa cachingrequests untuk membuat permintaan HTTP dan mengambil data dari halaman webBeautifulSoup untuk mengurai dan membersihkan konten HTMLOllama untuk menggunakan LLM secara lokalimport time
import requests
from bs4 import BeautifulSoup
import ollamaPada kode di bawah, kita mendefinisikan fungsi fetch_article_content yang mengambil dan membersihkan konten teks dari URL yang diberikan. Fungsi ini mencoba mengambil konten halaman web menggunakan pustaka requests, dengan hingga tiga kali percobaan ulang jika terjadi kegagalan seperti kesalahan jaringan atau masalah server.
Fungsi ini menggunakan BeautifulSoup untuk mengurai konten HTML dan menghapus tag <script> dan <style> yang tidak diperlukan. Teks kemudian diproses lebih lanjut dengan menghapus spasi di awal dan akhir, memisahkan baris, dan menggabungkannya kembali menjadi paragraf yang rapi. Jika batas konten ditentukan, fungsi akan memangkas teks hingga batas tersebut. Jika semua percobaan gagal, fungsi melempar pengecualian setelah jeda singkat antarpercobaan.
Berikut beberapa parameter kunci yang perlu dipahami:
BeautifulSoup untuk menghapus elemen yang tidak diperlukan seperti tag <script> dan <style>.def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingSelanjutnya, kita mengambil konten dari sebuah buku untuk inferensi. Di sini, kita menggunakan URL buku deep learning karya Ian Goodfellow, Yoshua Bengio, dan Aaron Courville menggunakan fungsi fetch_article_content untuk mengekstrak 200.000 karakter pertama. Kita mencetak 500 karakter pertama sebagai pratinjau.
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])Kini, data telah diekstrak dan dibersihkan. Selanjutnya, kita melakukan inferensi tanpa cache menggunakan Llama3 melalui Ollama. Tersedia beragam model bahasa melalui Ollama untuk bereksperimen secara lokal.
Untuk inferensi tanpa cache, kita membuat ringkasan buku tanpa caching. Kita mulai dengan menetapkan waktu mulai dan menghasilkan respons menggunakan fungsi ollama.generate(). Setelah respons dihasilkan, lalu kita gunakan fungsi response.get() untuk memeriksa respons dan mengekstrak ringkasan.
Catatan: Kita hanya mempertimbangkan waktu yang dibutuhkan untuk menghasilkan respons (yaitu, sebelum dan sesudah fungsi generate()).
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
Berikut beberapa poin kunci untuk kode di atas:
llama3) dan mendapatkan respons..get() untuk menghindari KeyError).Setelah inferensi tanpa cache, kita bereksperimen dengan inferensi ber-cache. Fungsi berikut menghasilkan ringkasan buku menggunakan hasil yang di-cache jika tersedia. Sama seperti langkah sebelumnya, kita menghasilkan respons menggunakan kode yang sama. Satu-satunya perbedaan terletak pada pemeriksaan awal untuk melihat apakah prompt sudah ada di cache. Jika ya, maka model tidak melakukan inferensi melainkan menggunakan respons yang ada di cache; jika tidak, hasilnya disimpan di cache untuk penggunaan berikutnya.
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
Berikut beberapa poin kunci dari kode di atas:
Karena semua fungsi sudah siap, berikut prompt yang akan kita gunakan. Silakan bereksperimen sesuka Anda. Prompt ini menggunakan 10.000 karakter pertama buku dan meminta model untuk membuat ringkasan.
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."Sekarang, kita melakukan kedua panggilan inferensi—tanpa cache dan dengan cache—untuk menghasilkan ringkasan dan menampilkan waktu yang dibutuhkan serta ringkasan untuk masing-masing teknik. Jika hasilnya di-cache, ia mengembalikan ringkasan yang di-cache dengan latensi nol; jika tidak, ia menyimpan hasilnya di cache untuk penggunaan berikutnya.
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
Kode ini menunjukkan bagaimana caching membantu menghindari komputasi berulang dengan menyimpan hasil untuk kueri berikutnya. Hasil yang di-cache menghasilkan latensi yang jauh lebih rendah untuk prompt berulang, yang akan kita amati di bagian berikutnya.
Dengan kode di atas, kami bereksperimen dengan empat model berbeda pada data yang telah ditentukan di atas.
|
Model |
Waktu inferensi tanpa cache |
Waktu inferensi ber-cache |
|
Llama2 |
143.98 seconds |
65.84 seconds |
|
Llama3 |
151.79 seconds |
42.48 seconds |
|
Gemma2 |
170.43 seconds |
61.84 seconds |
|
Phi3 |
239.55 seconds |
100.86 seconds |
Berdasarkan waktu inferensi dari eksperimen kami dengan keempat model tersebut, terlihat jelas bahwa inferensi ber-cache menurunkan waktu inferensi secara signifikan.
Karena caching menggunakan memori sistem Anda, penting untuk mempertimbangkan beberapa praktik yang dapat membantu mengurangi biaya dan kebutuhan memori.
Identifikasi area aplikasi di mana prompt yang sama atau serupa digunakan berulang kali. Ini dapat mencakup pertanyaan layanan pelanggan umum seperti “Bagaimana cara mengubah PIN ATM saya?”, pertanyaan pengodean yang sering seperti “Bagaimana menulis Hello World di Python?”, atau bagian dari dokumen panjang seperti “ringkas buku/makalah ini” yang sering dikunjungi. Melakukan cache respons untuk prompt tersebut akan memaksimalkan efisiensi.
Menjaga struktur yang konsisten saat mengirimkan prompt ke LLM membantu meningkatkan tingkat hit cache. Struktur format yang baik dapat berupa masukan pengguna yang ringkas diikuti contoh. Jika instruksi Anda konsisten, kemungkinan menemukan prompt yang cocok atau serupa di cache meningkat.
Cache yang terkelola dengan baik menyeimbangkan keterbatasan memori dan kebutuhan kinerja tanpa membengkakkan memori dan biaya. Bergantung pada kebutuhan aplikasi, menetapkan ukuran cache dan kebijakan penggusuran (seperti LRU) yang optimal memastikan kinerja efisien tanpa membebani penggunaan memori.
Memantau tingkat hit cache sangat penting untuk mengevaluasi efektivitas strategi caching. Jika tingkat hit rendah, pertimbangkan untuk menyesuaikan ambang kemiripan, meningkatkan ukuran cache, atau memperbaiki konsistensi prompt untuk menemukan kecocokan terbaik bagi prompt masukan.
Praktik caching di atas dipadukan dengan beberapa praktik penyimpanan terbaik untuk menjalankan aplikasi pada tingkat optimal. Selanjutnya, kita akan membahas beberapa teknik penyimpanan dan berbagi cache.
Prompt yang di-cache dapat disimpan secara lokal (pada satu mesin) atau didistribusikan di beberapa server. Cache lokal lebih sederhana dikelola tetapi mungkin kewalahan pada aplikasi skala besar. Sebaliknya, cache terdistribusi dapat melayani basis pengguna yang jauh lebih besar dan menangani beban lebih tinggi, tetapi dengan kompleksitas dan faktor biaya tambahan.
Untuk organisasi dengan banyak pengguna atau aplikasi, berbagi prompt yang di-cache di seluruh sistem dapat membantu mengurangi biaya dan meningkatkan kinerja dengan menyediakan akses terpusat di berbagai perangkat dan pengguna dengan biaya minimal. Dengan memusatkan cache, semua pengguna dapat memanfaatkan respons yang telah disimpan sebelumnya, sehingga menghindari komputasi berulang.
Privasi adalah perhatian utama saat menyimpan data yang di-cache, khususnya masukan dan respons pengguna. Data sensitif harus dienkripsi, dan kontrol akses harus diterapkan untuk memastikan hanya pengguna berwenang yang dapat mengakses cache. Berbagai algoritma enkripsi digunakan untuk menjaga keamanan data pengguna. Praktik umum lain yang belakangan ini banyak digunakan adalah melakukan komputasi pada perangkat lokal sehingga data tidak pernah meninggalkan perangkat.
Dalam lingkungan di mana prompt yang di-cache dibagikan di banyak pengguna atau aplikasi, teknik seperti pemanasan cache (cache warm-up) dan keep-alive ping membantu menjaga ketersediaan dan kebaruan data bersama, mengurangi kemungkinan cache miss dan memastikan pengalaman pengguna yang konsisten serta cepat di seluruh jaringan. Mari pahami teknik-teknik ini lebih baik.
Salah satu cara untuk memastikan cache selalu terisi data yang relevan adalah dengan “memanaskan” cache dengan pra-populasi prompt yang umum digunakan. Teknik ini berguna untuk mengurangi latensi pada beberapa interaksi pertama setelah sistem diluncurkan. Misalnya, pada chatbot e-niaga, pertanyaan yang umum seperti “Apa kebijakan pengembalian Anda?” atau “Di mana pesanan saya?” dapat di-pracache untuk memberikan respons instan sejak awal. Cache warm-up juga bermanfaat setelah sistem dimulai ulang, diperbarui, atau di-deploy, karena membantu menghindari cold start saat cache kosong yang menyebabkan respons awal lebih lambat.
Untuk mencegah entri cache kedaluwarsa karena tidak aktif, keep-alive ping berkala dapat dikirim untuk memastikan prompt yang populer tetap segar dan tersedia lebih lama. Keep-alive ping secara berkala menyegarkan entri cache tertentu, terutama yang terkait dengan prompt bernilai tinggi atau yang sering diminta, sehingga sistem memastikan entri ini tetap segar dan tersedia meski belum digunakan baru-baru ini.
Ini sangat berguna pada aplikasi dengan pola lalu lintas siklikal, seperti lonjakan musiman pada kueri e-niaga atau interaksi dukungan pelanggan pada jam sibuk.
Optimasi biaya adalah inti dari setiap aplikasi berbasis AI, mulai dari jumlah panggilan API hingga total penggunaan memori.
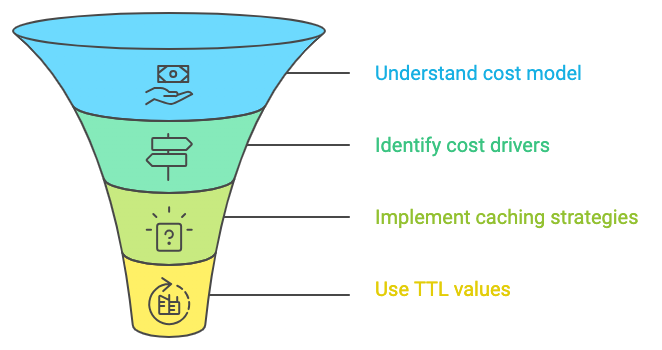
Saat bekerja dengan berbagai contoh caching, kita mungkin menemui beberapa masalah yang membutuhkan perbaikan sederhana. Beberapa di antaranya adalah:
Cache miss terjadi ketika prompt tidak ditemukan di cache. Ini dapat terjadi karena struktur prompt yang tidak konsisten atau ambang kemiripan yang terlalu ketat. Untuk memperbaikinya, kita perlu meninjau konsistensi prompt dan menyesuaikan ambang kemiripan agar mengakomodasi variasi kecil. Bayangkan chatbot layanan pelanggan yang sering menerima prompt: "What is your refund policy?" dan melakukan cache terhadap responsnya. Namun, jika pengguna bertanya, "Can you tell me about your return policy?" dan ambang kemiripan sistem terlalu ketat, sistem tidak akan mengenalinya sebagai prompt serupa, sehingga terjadi cache miss.
Invalidasi cache diperlukan ketika data dasar atau model berubah. Anda dapat menyiapkan kebijakan invalidasi otomatis untuk menyegarkan entri cache atau menerapkan invalidasi manual untuk entri tertentu bila diperlukan. Misalkan aplikasi keuangan melakukan cache terhadap respons terkait regulasi pajak. Jika undang-undang pajak berubah, respons yang sebelumnya di-cache menjadi usang. Sistem dapat disetel dengan kebijakan invalidasi otomatis, yang menyegarkan atau membersihkan cache setelah pembaruan regulasi.
Dalam artikel ini, kami membahas konsep prompt caching dan implementasinya menggunakan Ollama. Kami menunjukkan bagaimana prompt caching dapat secara signifikan mengurangi waktu inferensi dan biaya yang terkait dengan LLM.
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



