Corso
Retrieval Augmented Generation (RAG) con LangChain
3 ore
20.8K
Sebbene i sistemi RAG tradizionali siano efficaci, hanno un grande difetto: spesso dividono i documenti in piccoli chunk per facilitare il retrieval, ma questo può rimuovere contesto importante.
Per esempio, un chunk potrebbe dire “I suoi oltre 3,85 milioni di abitanti la rendono la città più popolosa dell’Unione Europea” senza menzionare di quale città o paese si stia parlando. Questa mancanza di contesto può portare a risultati incompleti o irrilevanti, soprattutto quando servono dettagli specifici.
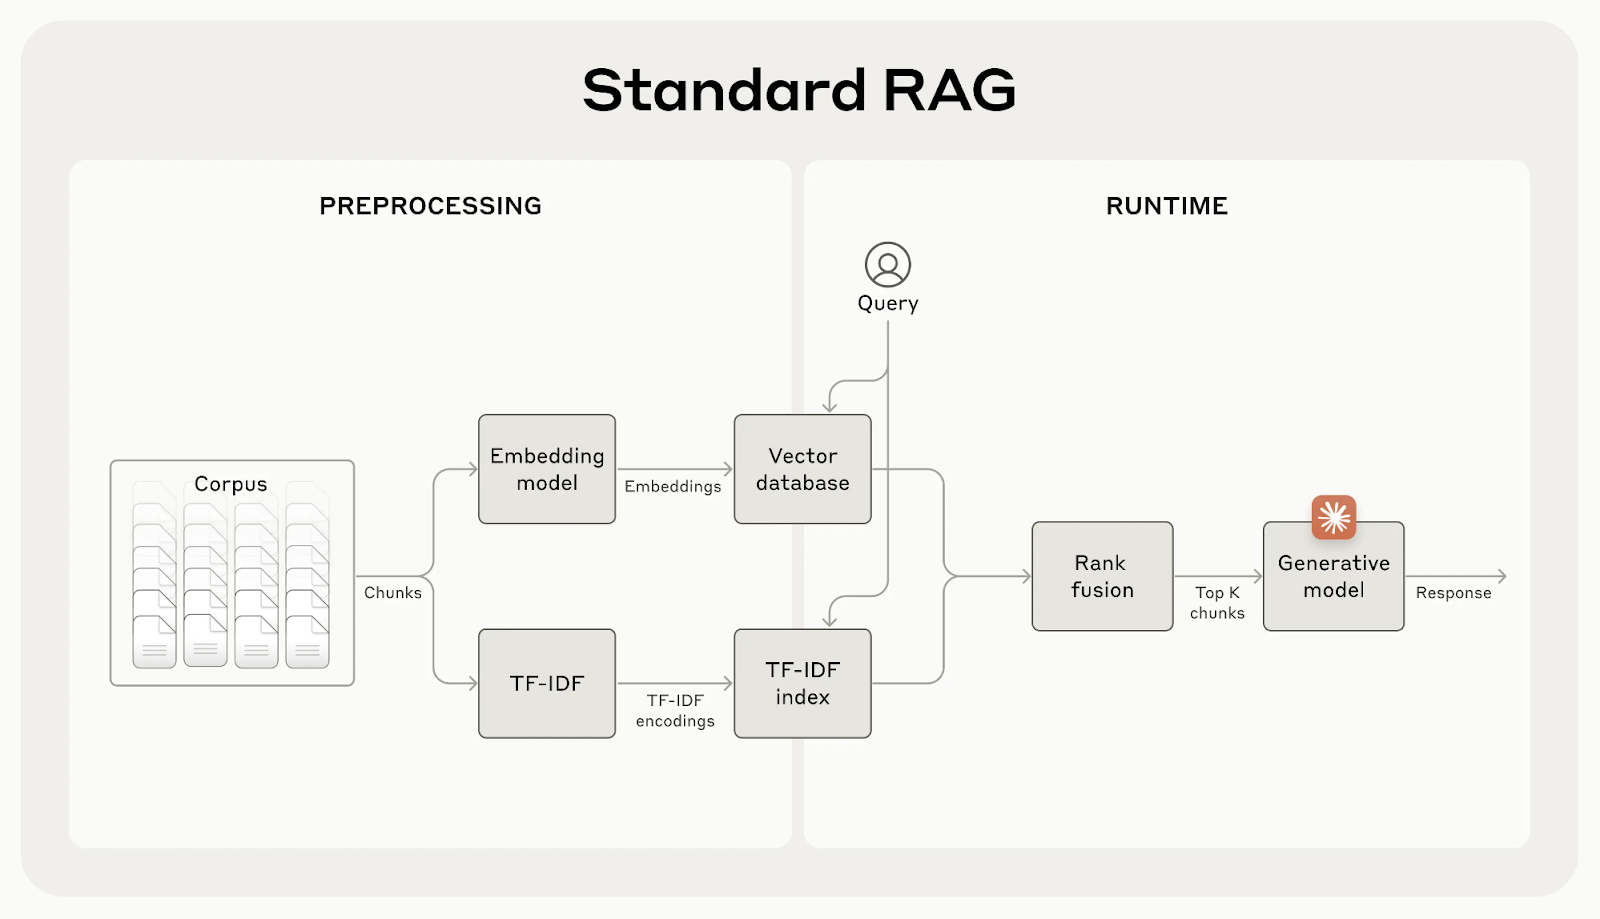
Fonte: Introducing Contextual Retrieval
Il contextual retrieval risolve questo problema generando e aggiungendo a ogni chunk una breve spiegazione specifica del contesto prima dell’embedding. Nell’esempio sopra, il chunk verrebbe trasformato come segue:
contextualized_chunk = """Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
"""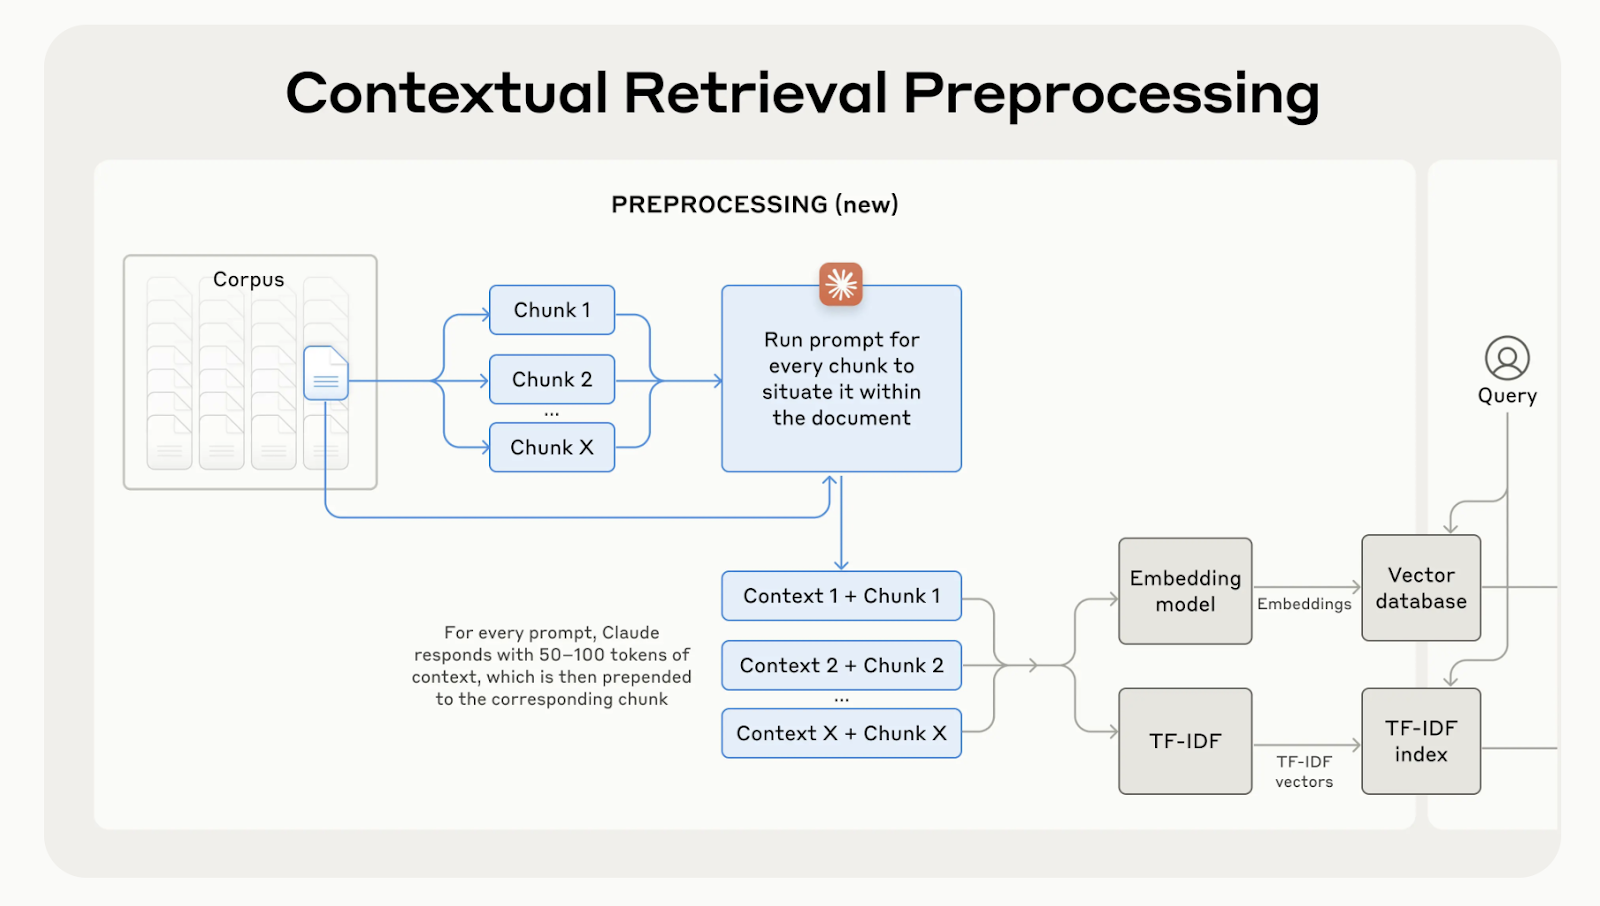
Fonte: Introducing Contextual Retrieval
Nel complesso, i test interni di Anthropic su diversi ambiti, tra cui codebase, articoli scientifici e narrativa, mostrano che il contextual retrieval riduce gli errori di retrieval del 49% se usato con modelli di contextual embedding e Contextual BM25.
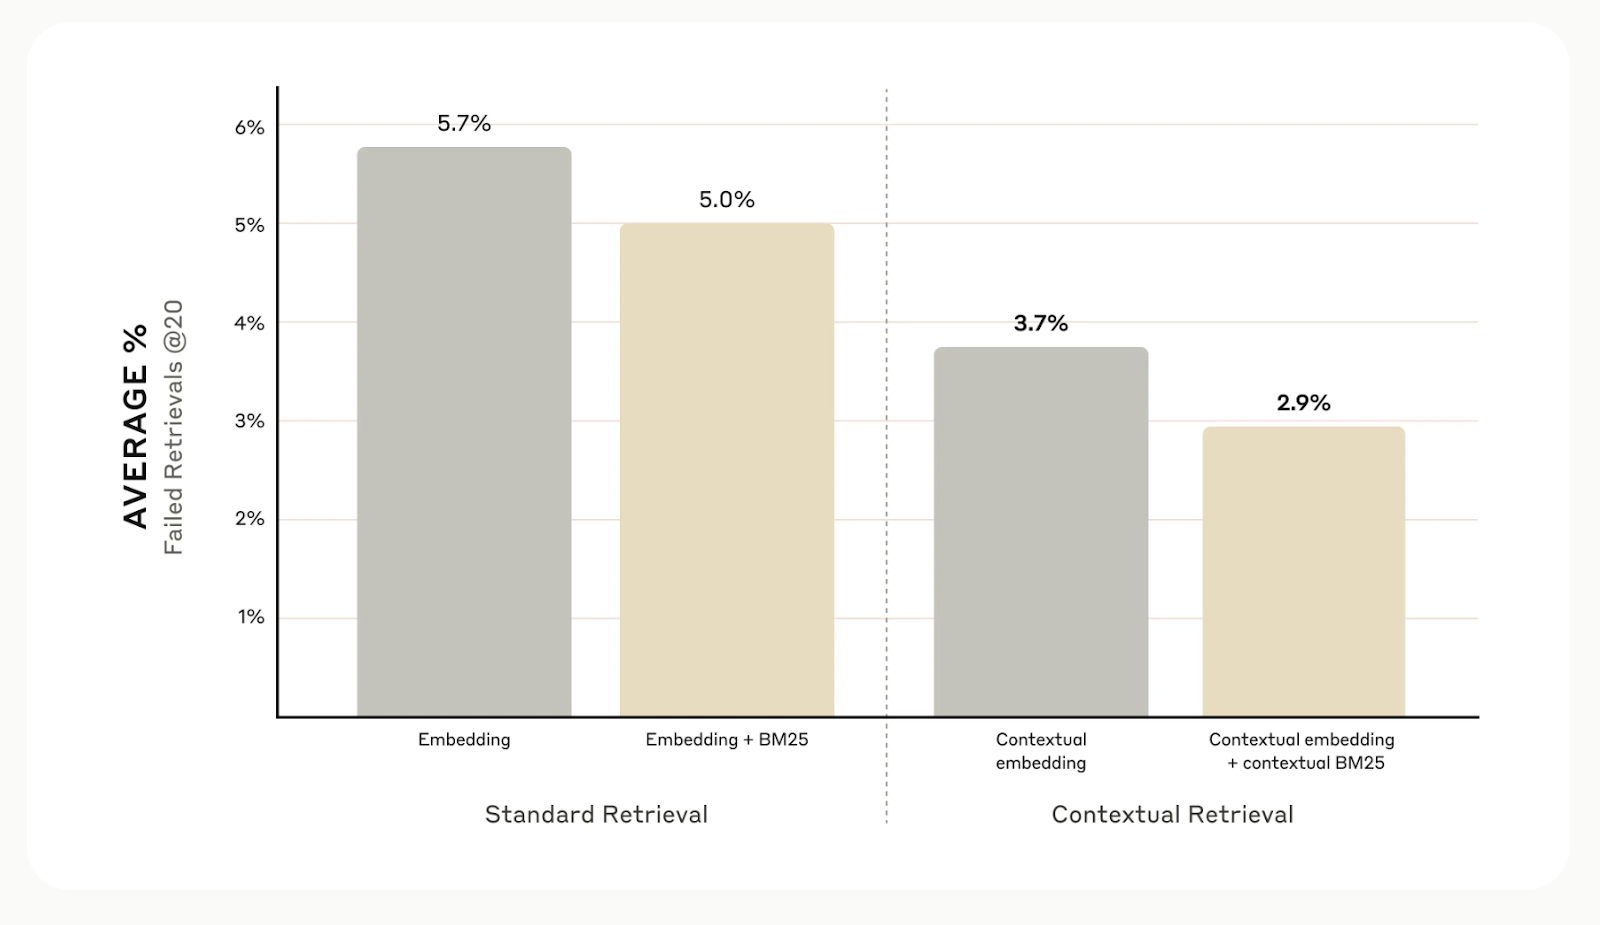
Fonte: Introducing Contextual Retrieval
Ora spiegherò passo dopo passo come implementare il contextual retrieval. Useremo il seguente documento di esempio:
# Input text for the knowledge base
input_text = """Berlin is the capital and largest city of Germany, both by area and by population.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
The city is also one of the states of Germany and is the third smallest state in the country in terms of area.
Paris is the capital and most populous city of France.
It is situated along the Seine River in the north-central part of the country.
The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."""Il primo passo è suddividere il documento di esempio in chunk più piccoli e indipendenti. In questo caso, lo divideremo in frasi singole.
# Splitting the input text into smaller chunks
test_chunks = [
    'Berlin is the capital and largest city of Germany, both by area and by population.',
    "\\n\\nIts more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.",
    '\\n\\nThe city is also one of the states of Germany and is the third smallest state in the country in terms of area.',
    '\\n\\n# Paris is the capital and most populous city of France.',
    '\\n\\n# It is situated along the Seine River in the north-central part of the country.',
    "\\n\\n# The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."
]Successivamente, imposteremo il prompt che il nostro modello userà per generare il contesto per ciascun chunk. Anthropic ha fornito un template utile a questo scopo. Il prompt accetterà due input: l’intero documento e lo specifico chunk di testo che vogliamo contestualizzare.
from langchain.prompts import ChatPromptTemplate, PromptTemplate, HumanMessagePromptTemplate

# Define the prompt for generating contextual information
anthropic_contextual_retrieval_system_prompt = """<document>
{WHOLE_DOCUMENT}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{CHUNK_CONTENT}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else."""

# Create a PromptTemplate for WHOLE_DOCUMENT and CHUNK_CONTENT
anthropic_prompt_template = PromptTemplate(
    input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
    template=anthropic_contextual_retrieval_system_prompt
)

# Wrap the prompt in a HumanMessagePromptTemplate
human_message_prompt = HumanMessagePromptTemplate(prompt=anthropic_prompt_template)
# Create the final ChatPromptTemplate
anthropic_contextual_retrieval_final_prompt = ChatPromptTemplate(
    input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
    messages=[human_message_prompt]
)Qui puoi scegliere qualsiasi LLM per generare il contesto di ciascun chunk. Nel nostro esempio useremo il modello GPT-4o di OpenAI.
import os
from langchain_openai import ChatOpenAI

# Load environment variables
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

# Initialize the model instance
llm_model_instance = ChatOpenAI(
    model="gpt-4o",
)Collegheremo il template del prompt con il modello linguistico per creare una catena LLM pronta a processare i chunk creati in precedenza.
from langchain.output_parsers import StrOutputParser

# Chain the prompt with the model instance
contextual_chunk_creation = anthropic_contextual_retrieval_final_prompt | llm_model_instance | StrOutputParser()Ora itereremo sui nostri chunk, genereremo le informazioni contestuali per ciascuno e stamperemo i risultati usando la catena LLM contextual_chunk_creation.
# Process each chunk and generate contextual information
for test_chunk in test_chunks:
    res = contextual_chunk_creation.invoke({
        "WHOLE_DOCUMENT": input_text,
        "CHUNK_CONTENT": test_chunk
    })
    print(res)
    print('-----')
The document compares Berlin and Paris, highlighting Berlin as Germany's capital and largest city by area and population, and noting its significance within the European Union.
-----
Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
-----
Berlin is the capital and largest city of Germany, both by area and by population.
-----
Paris, the capital of France, is a major population center in Europe with over 2.1 million residents.
-----
Paris is the capital and most populous city of France.
-----
Paris is the capital and most populous city of France, with a population of over 2.1 million residents within its administrative limits.
-----Sebbene il contextual retrieval aumenti l’accuratezza del retrieval, puoi spingerti oltre con il reranking. Questa tecnica di filtraggio assicura che solo i chunk più rilevanti vengano inviati al modello, migliorando la qualità delle risposte e riducendo costi e tempi di elaborazione.
Il reranking funziona assegnando un punteggio ai chunk recuperati nel primo passaggio e mantenendo solo i migliori. Nei nostri test, il reranking ha ridotto gli errori di retrieval dal 5,7% all’1,9%, migliorando l’accuratezza del 67% rispetto ai metodi tradizionali.
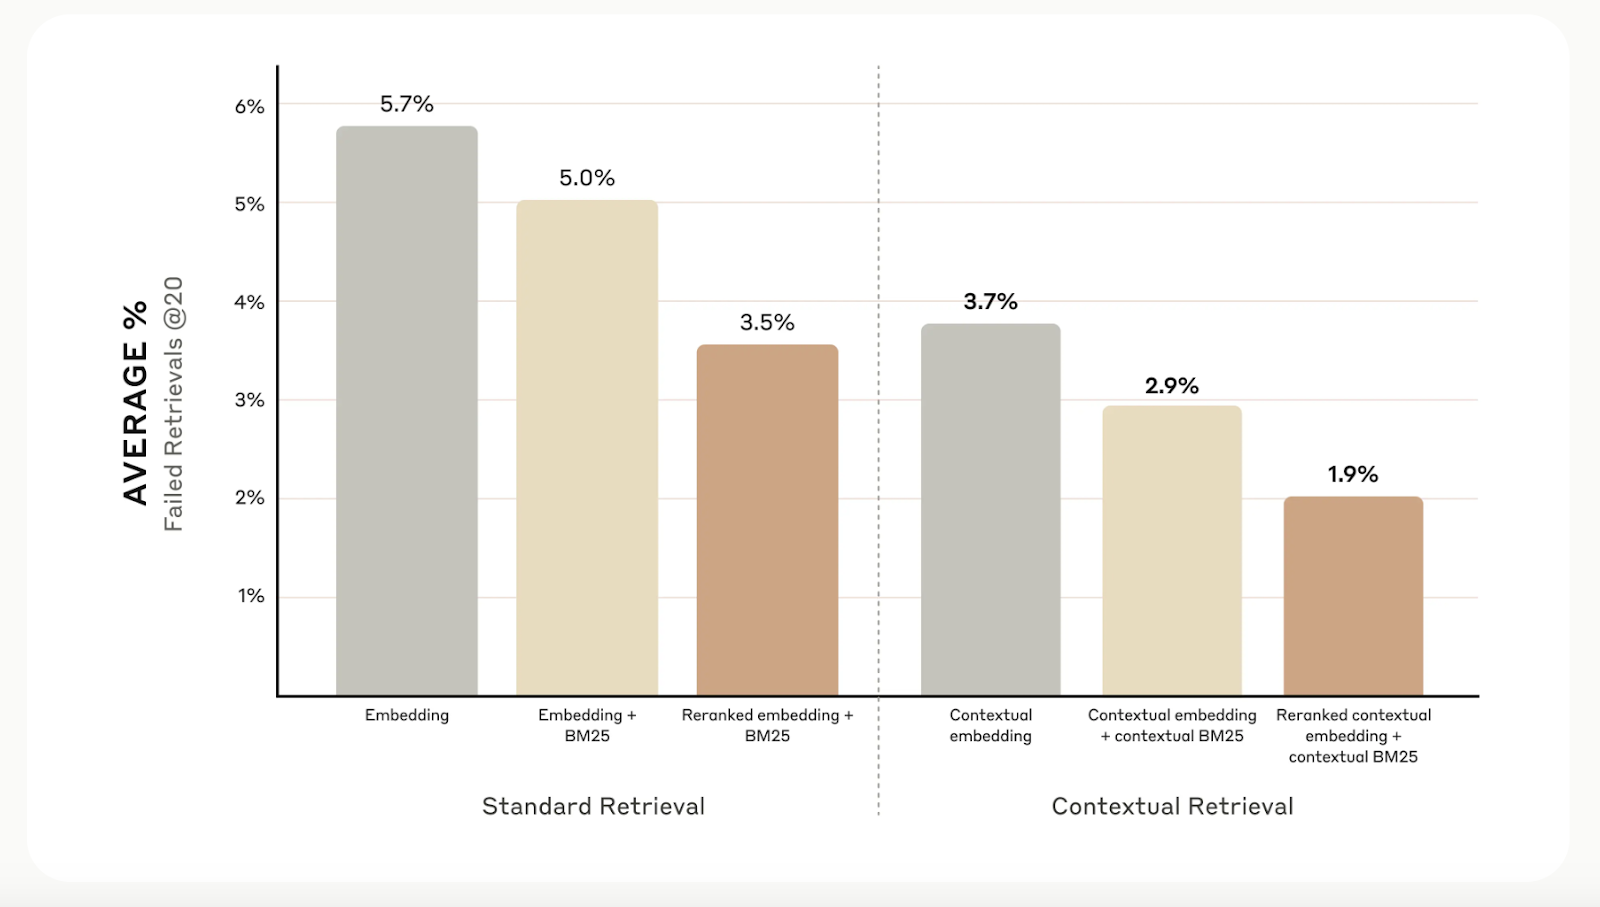
Fonte: Introducing Contextual Retrieval
Le ricerche di Anthropic hanno rilevato che non tutte le situazioni richiedono la complessità del contextual retrieval. Per knowledge base più piccole, sotto i 200.000 token (circa 500 pagine), un’opzione migliore può essere includere l’intera knowledge base direttamente nel prompt del modello, evitando del tutto i sistemi di retrieval.
Suggeriscono anche di sfruttare il prompt caching, una funzionalità introdotta per Claude. Memorizzando nella cache i prompt usati di frequente tra le chiamate API, gli sviluppatori possono ridurre i costi fino al 90% e velocizzare i tempi di risposta di oltre due volte. Questo prompt caching cookbook offre istruzioni passo passo per implementarlo.
Il contextual retrieval di Anthropic è un metodo semplice ma efficace per migliorare i sistemi di retrieval. Combinare contextual embedding, BM25 e reranking aumenta significativamente l’accuratezza di questi sistemi.
Per approfondire diverse tecniche di retrieval, ti consiglio i seguenti blog:
Impara l’AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



