

Bağlamsal Getirme Nedir?
Geleneksel RAG sistemleri etkili olsa da önemli bir kusura sahiptir: Getirmeyi kolaylaştırmak için belgeleri çoğunlukla küçük parçalara bölerler, ancak bu işlem önemli bağlamı ortadan kaldırabilir.
Örneğin, bir parça “3,85 milyonu aşkın sakiniyle Avrupa Birliği’nin şehir sınırları içindeki en kalabalık şehridir” diyebilir, ancak hangi şehirden ya da ülkeden bahsettiğini belirtmeyebilir. Bu bağlam eksikliği, özellikle belirli ayrıntılar gerektiğinde eksik veya alakasız sonuçlara yol açabilir.
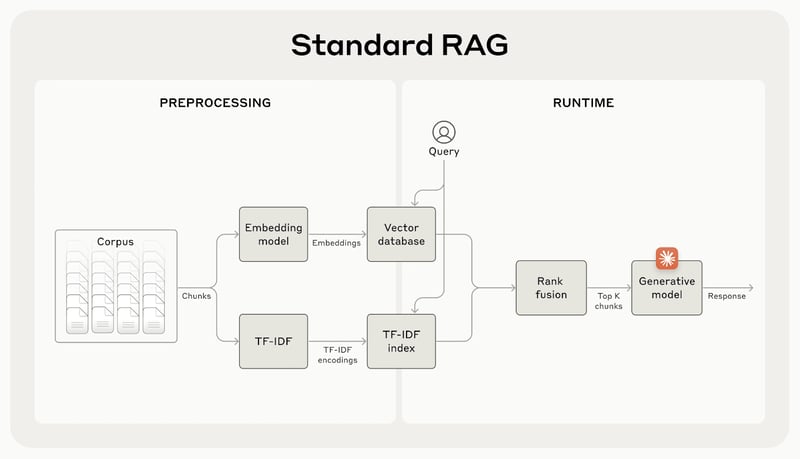
Kaynak: Contextual Retrieval Tanıtımı
Bağlamsal getirme, gömme işleminden önce her parçaya kısa ve bağlama özel bir açıklama üreterek ve ekleyerek bunu düzeltir. Yukarıdaki örnekte, parça şu şekilde dönüştürülürdü:
contextualized_chunk = """Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
"""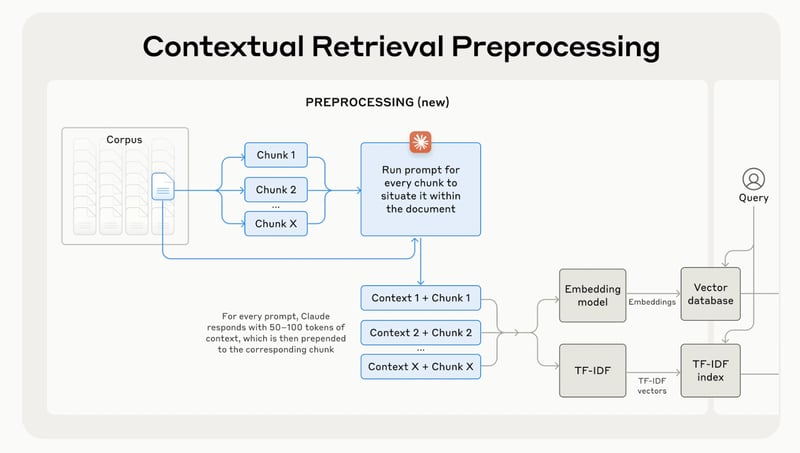
Kaynak: Contextual Retrieval Tanıtımı
Genel olarak, kod tabanları, bilimsel makaleler ve kurgu dahil farklı alanlardaki Anthropic iç testleri, bağlamsal gömme modelleri ve Contextual BM25 ile birlikte kullanıldığında bağlamsal getirmenin getirme hatalarını %49 azalttığını gösteriyor.
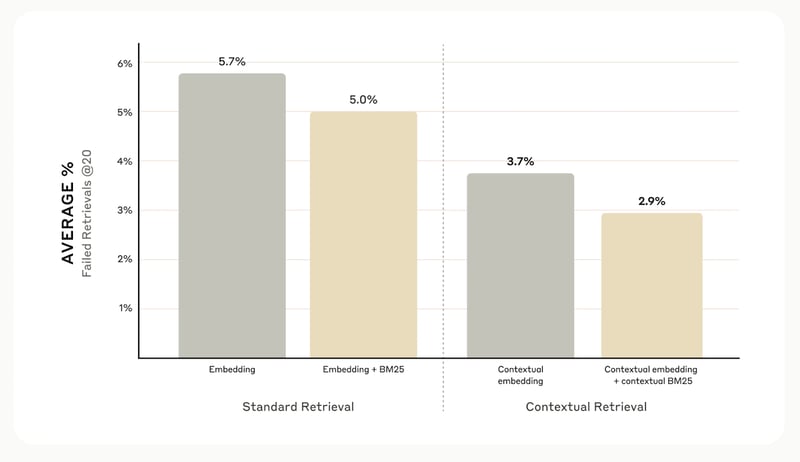
Kaynak: Contextual Retrieval Tanıtımı
Bağlamsal Getirme Uygulaması
Şimdi bağlamsal getirmenin nasıl uygulanacağını adım adım açıklayacağım. Örnek olarak aşağıdaki belgeyi kullanacağız:
# Input text for the knowledge base
input_text = """Berlin is the capital and largest city of Germany, both by area and by population.
Its more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.
The city is also one of the states of Germany and is the third smallest state in the country in terms of area.
Paris is the capital and most populous city of France.
It is situated along the Seine River in the north-central part of the country.
The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."""Adım 1: Belgeyi parçalara ayırın
İlk adım, örnek belgeyi daha küçük ve bağımsız parçalara ayırmaktır. Bu örnekte, metni tek tek cümlelere böleceğiz.
# Splitting the input text into smaller chunks
test_chunks = [
'Berlin is the capital and largest city of Germany, both by area and by population.',
"\\n\\nIts more than 3.85 million inhabitants make it the European Union's most populous city, as measured by population within city limits.",
'\\n\\nThe city is also one of the states of Germany and is the third smallest state in the country in terms of area.',
'\\n\\n# Paris is the capital and most populous city of France.',
'\\n\\n# It is situated along the Seine River in the north-central part of the country.',
"\\n\\n# The city has a population of over 2.1 million residents within its administrative limits, making it one of Europe's major population centers."
]Adım 2: İstem şablonunu tanımlayın
Sırada, modelimizin her parça için bağlam oluştururken kullanacağı istemi hazırlamak var. Anthropic bunun için kullanışlı bir şablon sunuyor. İstem iki girdi alacak: tüm belge ve bağlam içine yerleştirmek istediğimiz belirli metin parçası.
from langchain.prompts import ChatPromptTemplate, PromptTemplate, HumanMessagePromptTemplate
# Define the prompt for generating contextual information
anthropic_contextual_retrieval_system_prompt = """<document>
{WHOLE_DOCUMENT}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{CHUNK_CONTENT}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else."""
# Create a PromptTemplate for WHOLE_DOCUMENT and CHUNK_CONTENT
anthropic_prompt_template = PromptTemplate(
input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
template=anthropic_contextual_retrieval_system_prompt
)
# Wrap the prompt in a HumanMessagePromptTemplate
human_message_prompt = HumanMessagePromptTemplate(prompt=anthropic_prompt_template)
# Create the final ChatPromptTemplate
anthropic_contextual_retrieval_final_prompt = ChatPromptTemplate(
input_variables=['WHOLE_DOCUMENT', 'CHUNK_CONTENT'],
messages=[human_message_prompt]
)Adım 3: Tercih ettiğiniz dil modelini başlatın
Burada, her parça için bağlam üretmek üzere istediğiniz herhangi bir LLM’i seçebilirsiniz. Örneğimizde OpenAI’nin GPT-4o modelini kullanacağız.
import os
from langchain_openai import ChatOpenAI
# Load environment variables
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"
# Initialize the model instance
llm_model_instance = ChatOpenAI(
model="gpt-4o",
)Adım 4: Her şeyi bir araya getirin
Önceden oluşturduğumuz parçaları işlemek için istem şablonunu dil modeliyle bağlayarak hazır bir LLM zinciri oluşturacağız.
from langchain.output_parsers import StrOutputParser
# Chain the prompt with the model instance
contextual_chunk_creation = anthropic_contextual_retrieval_final_prompt | llm_model_instance | StrOutputParser()Adım 5: Her parçayı işleyin
Şimdi parçalarımız üzerinden döngü kurup, her biri için bağlamsal bilgiyi üretecek ve sonuçları contextual_chunk_creation LLM zincirini kullanarak yazdıracağız.
# Process each chunk and generate contextual information
for test_chunk in test_chunks:
res = contextual_chunk_creation.invoke({
"WHOLE_DOCUMENT": input_text,
"CHUNK_CONTENT": test_chunk
})
print(res)
print('-----')The document compares Berlin and Paris, highlighting Berlin as Germany's capital and largest city by area and population, and noting its significance within the European Union.
-----
Berlin is the capital and largest city of Germany, known for being the EU's most populous city within its limits.
-----
Berlin is the capital and largest city of Germany, both by area and by population.
-----
Paris, the capital of France, is a major population center in Europe with over 2.1 million residents.
-----
Paris is the capital and most populous city of France.
-----
Paris is the capital and most populous city of France, with a population of over 2.1 million residents within its administrative limits.
-----Yeniden Sıralama ile İyileştirme
Bağlamsal getirme, getirme doğruluğunu artırırken, bunu yeniden sıralama ile daha da ileri taşıyabilirsiniz. Bu filtreleme tekniği, yalnızca en ilgili parçaların modele gönderilmesini sağlayarak yanıt kalitesini artırır ve maliyet ile işlem süresini düşürür.
Yeniden sıralama, ilk adımda getirilen parçaları puanlayıp en iyilerini tutarak çalışır. Testlerimizde, yeniden sıralama getirme hatalarını %5,7’den yalnızca %1,9’a düşürdü; geleneksel yöntemlere kıyasla doğruluğu %67 oranında artırdı.
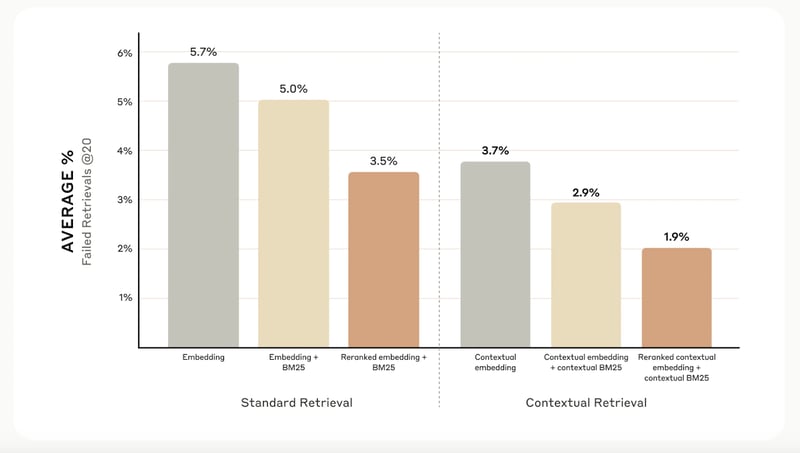
Kaynak: Contextual Retrieval Tanıtımı
Ek Hususlar
Anthropic’in araştırması, her durumda bağlamsal getirmenin karmaşıklığına gerek olmadığını gösteriyor. 200.000 tokenın (yaklaşık 500 sayfa) altındaki daha küçük bilgi tabanları için, tüm bilgi tabanını doğrudan modelin istemine eklemek ve getirme sistemlerini tamamen atlamak daha iyi bir seçenek olabilir.
Ayrıca, Claude için sunulan bir özellik olan istem önbelleklemeden yararlanmayı öneriyorlar. API çağrıları arasında sık kullanılan istemleri önbelleğe alarak geliştiriciler maliyetleri %90’a kadar azaltabilir ve yanıt sürelerini iki kattan fazla hızlandırabilir. Bu istem önbellekleme başvuru kitabı uygulama için adım adım yönergeler sunuyor.
Sonuç
Anthropic’in bağlamsal getirmesi, getirme sistemlerini iyileştirmek için basit ama etkili bir yöntemdir. Bağlamsal gömmeleri, BM25’i ve yeniden sıralamayı birleştirmek, bu sistemlerin doğruluğunu önemli ölçüde artırır.
Farklı getirme teknikleri hakkında daha fazla bilgi edinmek için aşağıdaki blogları öneririm:

Ryan, LLM'ler kullanarak yapay zeka uygulamaları geliştirme konusunda uzmanlaşmış kıdemli bir veri bilimcisidir. Imperial College London'da Doğal Dil İşleme ve Bilgi Grafiklerinde doktora adayıdır ve aynı kurumda Bilgisayar Bilimleri alanında yüksek lisansını tamamlamıştır. Veri bilimi dışında, haftalık Substack bülteni The Limitless Playbook'u yayımlar; burada dünyanın önde gelen düşünürlerinden uygulanabilir tek bir fikri paylaşır ve zaman zaman temel yapay zeka kavramları hakkında yazar.




Getirmeyle güçlendirilmiş üretim (RAG), yapay zekâ modellerinin harici kaynaklardan ek bilgi almasına yardımcı olur. Ancak bu sistemler, önemli bağlamı sıkça kaybeder ve bu da daha az doğru sonuçlara yol açabilir.
Anthropic, bilgi getirmeyi iyileştirmek için basit ama etkili bir yöntem olan bağlamsal getirme yöntemini geliştirdi. Her parça için doğru bağlamı korumak, getirme hatalarını yüzde 67’ye kadar azaltır ve aşağı akıştaki görevlerde çok daha iyi performans sağlar.
Bu yazıda, bağlamsal getirmeyi ve bunu uygulamalarınızda nasıl kullanabileceğinizi anlatacağım.