Kursus
Pengantar Deep Learning dengan Python
4 jam
264.8K
Anda mungkin sudah pernah mendengar tentang pengenalan gambar atau wajah, atau mobil tanpa pengemudi. Ini adalah implementasi nyata dari Convolutional Neural Networks (CNN). Dalam postingan blog ini, Anda akan mempelajari dan memahami cara mengimplementasikan jaringan saraf tiruan deep, feed-forward di Keras dan juga mempelajari cara mengatasi overfitting dengan teknik regularisasi yang disebut "dropout".
Lebih khusus, Anda akan membahas topik-topik berikut dalam tutorial hari ini:
Ingin mengikuti kursus Keras dan deep learning di Python? Pertimbangkan untuk mengikuti kursus Deep Learning in Python dari DataCamp!
Juga, jangan lewatkan cheat sheet Keras kami, yang menunjukkan enam langkah yang perlu Anda jalani untuk membangun neural network di Python beserta contoh kodenya!
Sampai saat ini, Anda mungkin sudah mengetahui tentang machine learning dan deep learning, cabang ilmu komputer yang mempelajari perancangan algoritma yang dapat belajar. Deep learning adalah subbidang machine learning yang terinspirasi oleh jaringan saraf tiruan, yang pada gilirannya terinspirasi oleh jaringan saraf biologis.
Salah satu jenis jaringan saraf deep tersebut adalah convolutional network, yang biasa disebut CNN atau ConvNet. Ini adalah jaringan saraf tiruan deep, feed-forward. Ingat bahwa feed-forward neural networks juga disebut multi-layer perceptrons (MLP), yang merupakan model deep learning khas. Model-model ini disebut "feed-forward" karena informasi mengalir lurus melalui model. Tidak ada koneksi umpan balik di mana output model dimasukkan kembali ke dalam dirinya sendiri.
CNN secara khusus terinspirasi oleh korteks visual biologis. Korteks memiliki wilayah kecil sel yang peka terhadap area tertentu dari medan visual. Gagasan ini dikembangkan oleh eksperimen menarik yang dilakukan oleh Hubel dan Wiesel pada tahun 1962 (jika Anda ingin tahu lebih banyak, berikut videonya). Dalam eksperimen ini, peneliti menunjukkan bahwa beberapa neuron individu di otak aktif atau menembak hanya ketika ada tepi dengan orientasi tertentu seperti tepi vertikal atau horizontal. Misalnya, beberapa neuron aktif saat terekspos sisi vertikal dan beberapa saat ditunjukkan tepi horizontal. Hubel dan Wiesel menemukan bahwa semua neuron ini tersusun rapi secara kolumnar dan bersama-sama mampu menghasilkan persepsi visual. Gagasan tentang komponen khusus di dalam suatu sistem yang memiliki tugas spesifik ini juga digunakan oleh mesin dan dapat Anda temukan kembali dalam CNN.
Convolutional neural networks telah menjadi salah satu inovasi paling berpengaruh dalam bidang computer vision. Kinerjanya jauh lebih baik daripada computer vision tradisional dan menghasilkan hasil state-of-the-art. Jaringan saraf ini terbukti sukses dalam banyak studi kasus dan aplikasi nyata yang berbeda, seperti:
Untuk memahami kesuksesan ini, Anda harus kembali ke tahun 2012, ketika Alex Krizhevsky menggunakan convolutional neural networks untuk memenangkan ImageNet Competition tahun itu, mengurangi error klasifikasi dari 26% menjadi 15%.
Catatan bahwa ImageNet Large Scale Visual Recognition Challenge (ILSVRC) yang dimulai tahun 2010 adalah kompetisi tahunan di mana tim riset menilai algoritme mereka pada data set yang diberikan dan bersaing untuk mencapai akurasi lebih tinggi pada beberapa tugas pengenalan visual.
Inilah saat ketika neural networks kembali menonjol setelah cukup lama. Ini sering disebut "gelombang ketiga neural networks". Dua gelombang lainnya terjadi pada 1940-an hingga 1960-an dan 1970-an hingga 1980-an.
Baik, Anda tahu bahwa Anda akan bekerja dengan feed-forward networks yang terinspirasi oleh korteks visual biologis, tetapi apa sebenarnya artinya?
Lihat gambar di bawah ini:
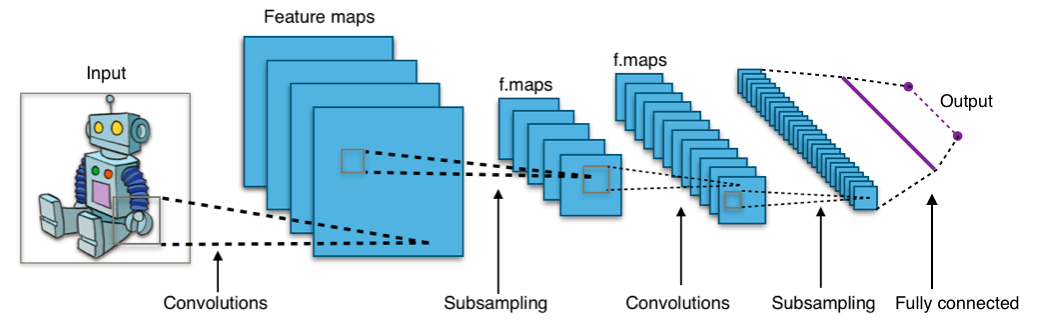
Gambar tersebut menunjukkan bahwa Anda memberikan sebuah gambar sebagai input ke jaringan, yang kemudian melewati beberapa kali konvolusi, subsampling, fully connected layer dan akhirnya menghasilkan sesuatu.
Tapi apa saja semua konsep ini?
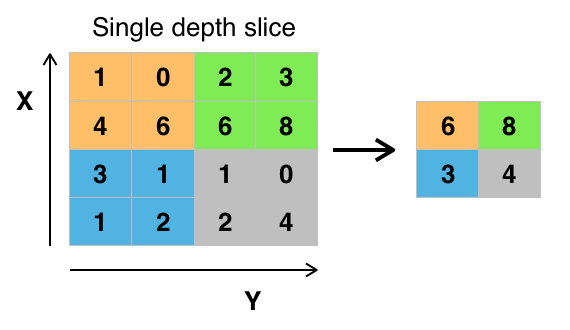
Untuk informasi lebih lanjut, Anda dapat pergi ke sini.
Sebelum Anda lanjut dan memuat data, ada baiknya melihat dulu apa yang akan Anda kerjakan! Dataset Fashion-MNIST adalah dataset gambar artikel Zalando, dengan gambar grayscale 28x28 dari 70.000 produk fesyen dari 10 kategori, dan 7.000 gambar per kategori. Set pelatihan memiliki 60.000 gambar, dan set uji memiliki 10.000 gambar. Anda dapat memeriksa ulang ini nanti saat Anda telah memuat data! ;)
Fashion-MNIST mirip dengan dataset MNIST yang mungkin sudah Anda kenal, yang Anda gunakan untuk mengklasifikasikan digit tulisan tangan. Artinya dimensi gambar, pembagian pelatihan dan uji mirip dengan dataset MNIST. Tip: jika Anda ingin mempelajari cara mengimplementasikan Multi-Layer Perceptron (MLP) untuk tugas klasifikasi dengan dataset yang terakhir ini, kunjungi tutorial deep learning dengan Keras ini.
Anda dapat menemukan dataset Fashion-MNIST di sini, tetapi Anda juga dapat memuatnya dengan bantuan modul khusus TensorFlow dan Keras. Anda akan melihat cara kerjanya di bagian berikut!
Keras dilengkapi dengan pustaka bernama datasets, yang dapat Anda gunakan untuk memuat dataset secara langsung: Anda mengunduh data dari server dan mempercepat proses karena Anda tidak lagi harus mengunduh data ke komputer Anda. Gambar train dan test beserta labelnya dimuat dan disimpan dalam variabel train_X, train_Y, test_X, test_Y secara berurutan.
from keras.datasets import fashion_mnist
(train_X,train_Y), (test_X,test_Y) = fashion_mnist.load_data()
Using TensorFlow backend.
Hebat! Itu cukup sederhana, bukan?
Anda mungkin sudah melakukan ini berkali-kali, tetapi ini selalu merupakan langkah penting untuk memulai. Sekarang Anda sepenuhnya siap untuk mulai menganalisis, memproses, dan memodelkan data Anda!
Sekarang mari analisis seperti apa gambar dalam dataset. Meskipun Anda sudah mengetahui dimensi gambarnya, tetap layak untuk menganalisisnya secara terprogram: Anda mungkin harus melakukan penskalaan ulang piksel gambar dan mengubah ukuran gambar.
import numpy as np
from keras.utils import to_categorical
import matplotlib.pyplot as plt
%matplotlib inline

print('Training data shape : ', train_X.shape, train_Y.shape)

print('Testing data shape : ', test_X.shape, test_Y.shape)
('Training data shape : ', (60000, 28, 28), (60000,))
('Testing data shape : ', (10000, 28, 28), (10000,))
Dari output di atas, Anda dapat melihat bahwa data pelatihan memiliki bentuk 60000 x 28 x 28 karena ada 60.000 sampel pelatihan masing-masing berdimensi 28 x 28. Demikian pula, data uji memiliki bentuk 10000 x 28 x 28 karena ada 10.000 sampel pengujian.
# Find the unique numbers from the train labels
classes = np.unique(train_Y)
nClasses = len(classes)
print('Total number of outputs : ', nClasses)
print('Output classes : ', classes)
('Total number of outputs : ', 10)
('Output classes : ', array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=uint8))
Ada total sepuluh kelas output yang berkisar dari 0 hingga 9.
Juga, jangan lupa untuk melihat seperti apa gambar dalam dataset Anda:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
plt.imshow(train_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(train_Y[0]))

# Display the first image in testing data
plt.subplot(122)
plt.imshow(test_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(test_Y[0]))
Text(0.5,1,u'Ground Truth : 9')
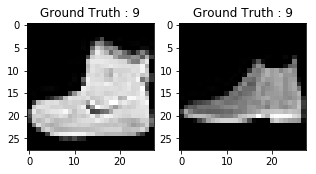
Keluaran dari dua plot di atas terlihat seperti sepatu boot pergelangan kaki, dan kelas ini diberi label kelas 9. Demikian pula, produk fesyen lainnya akan memiliki label yang berbeda, tetapi produk yang serupa akan memiliki label yang sama. Ini berarti bahwa semua 7.000 gambar sepatu boot pergelangan kaki akan memiliki label kelas 9.
Seperti yang Anda lihat pada plot di atas, gambar adalah gambar grayscale dengan nilai piksel berkisar dari 0 hingga 255. Juga, gambar ini memiliki dimensi 28 x 28. Alhasil, Anda perlu memraproses data sebelum memasukkannya ke model.
train_X = train_X.reshape(-1, 28,28, 1)
test_X = test_X.reshape(-1, 28,28, 1)
train_X.shape, test_X.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
train_X = train_X.astype('float32')
test_X = test_X.astype('float32')
train_X = train_X / 255.
test_X = test_X / 255.
Dalam one-hot encoding, Anda mengonversi data kategorikal menjadi vektor angka. Alasan Anda mengonversi data kategorikal ke one-hot encoding adalah karena algoritme machine learning tidak dapat bekerja langsung dengan data kategorikal. Anda menghasilkan satu kolom boolean untuk setiap kategori atau kelas. Hanya satu dari kolom ini yang dapat bernilai 1 untuk setiap sampel. Karena itu, istilah one-hot encoding.
Untuk pernyataan masalah Anda, one-hot encoding akan berupa vektor baris, dan untuk setiap gambar, akan berdimensi 1 x 10. Hal penting yang perlu diperhatikan di sini adalah vektor terdiri dari semua nol kecuali untuk kelas yang diwakilinya, dan untuk itu bernilai 1. Misalnya, gambar sepatu boot pergelangan kaki yang Anda plot di atas memiliki label 9, jadi untuk semua gambar sepatu boot pergelangan kaki, vektor one-hot encoding adalah [0 0 0 0 0 0 0 0 1 0].
Jadi mari konversi label pelatihan dan pengujian menjadi vektor one-hot encoding:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_Y)
test_Y_one_hot = to_categorical(test_Y)

# Display the change for category label using one-hot encoding
print('Original label:', train_Y[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([ 0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  1.]))
Cukup jelas, bukan? Catatan bahwa Anda juga dapat mencetak train_Y_one_hot, yang akan menampilkan matriks berukuran 60000 x 10 di mana setiap baris menggambarkan one-hot encoding dari sebuah gambar.
from sklearn.model_selection import train_test_split
train_X,valid_X,train_label,valid_label = train_test_split(train_X, train_Y_one_hot, test_size=0.2, random_state=13)
Untuk terakhir kalinya mari periksa bentuk set pelatihan dan validasi.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Gambar berukuran 28 x 28. Anda mengonversi matriks gambar menjadi array, melakukan penskalaan ulang antara 0 dan 1, mengubah bentuknya sehingga berukuran 28 x 28 x 1, dan memasukkannya sebagai input ke jaringan.
Anda akan menggunakan tiga convolutional layer:
Selain itu, ada tiga max-pooling layer masing-masing berukuran 2 x 2.
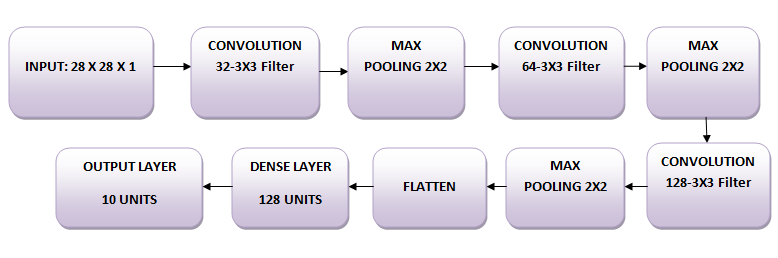
Pertama, mari impor semua modul yang diperlukan untuk melatih model.
import keras
from keras.models import Sequential,Input,Model
from keras.layers import Dense, Dropout, Flatten
from keras.layers import Conv2D, MaxPooling2D
from keras.layers.normalization import BatchNormalization
from keras.layers.advanced_activations import LeakyReLU
Anda akan menggunakan batch size 64; menggunakan batch size lebih besar 128 atau 256 juga memungkinkan—semuanya bergantung pada memori. Ini sangat berkontribusi dalam menentukan parameter pembelajaran dan memengaruhi akurasi prediksi. Anda akan melatih jaringan selama 20 epoch.
batch_size = 64
epochs = 20
num_classes = 10
Di Keras, Anda bisa menumpuk layer dengan menambahkan layer yang diinginkan satu per satu. Itu tepat yang akan Anda lakukan di sini: Anda akan terlebih dahulu menambahkan convolutional layer pertama dengan Conv2D(). Perhatikan bahwa Anda menggunakan fungsi ini karena Anda bekerja dengan gambar! Selanjutnya, Anda menambahkan fungsi aktivasi Leaky ReLU yang membantu jaringan mempelajari batas keputusan nonlinier. Karena Anda memiliki sepuluh kelas berbeda, Anda memerlukan batas keputusan nonlinier yang dapat memisahkan sepuluh kelas ini yang tidak terpisah secara linier.
Lebih khusus lagi, Anda menambahkan Leaky ReLU karena ia mencoba memperbaiki masalah "kematian" Rectified Linear Units (ReLU). Fungsi aktivasi ReLU banyak digunakan dalam arsitektur jaringan saraf dan lebih khusus lagi dalam convolutional networks, di mana ia terbukti lebih efektif daripada fungsi sigmoid logistik yang banyak digunakan. Per 2017, fungsi aktivasi ini adalah yang paling populer untuk deep neural networks. Fungsi ReLU memungkinkan aktivasi diberi ambang di nol. Namun, selama pelatihan, unit ReLU dapat "mati". Ini bisa terjadi ketika gradien besar mengalir melalui neuron ReLU: hal itu dapat menyebabkan bobot diperbarui sedemikian rupa sehingga neuron tidak akan pernah aktif lagi pada titik data mana pun. Jika ini terjadi, maka gradien yang mengalir melalui unit akan selamanya nol sejak saat itu. Leaky ReLU berupaya mengatasinya: fungsinya tidak akan nol tetapi memiliki kemiringan negatif kecil.
Berikutnya, Anda akan menambahkan max-pooling layer dengan MaxPooling2D() dan seterusnya. Layer terakhir adalah layer Dense dengan fungsi aktivasi softmax berisi 10 unit, yang diperlukan untuk masalah klasifikasi multi-kelas ini.
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',input_shape=(28,28,1),padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dense(num_classes, activation='softmax'))
Setelah model dibuat, Anda mengompilasinya menggunakan optimizer Adam, salah satu algoritme optimisasi paling populer. Anda dapat membaca lebih lanjut tentang optimizer ini di sini. Selain itu, Anda menentukan jenis loss yaitu categorical cross entropy yang digunakan untuk klasifikasi multi-kelas; Anda juga dapat menggunakan binary cross-entropy sebagai fungsi loss. Terakhir, Anda menentukan metrik sebagai akurasi yang ingin Anda analisis saat model berlatih.
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Mari visualisasikan layer yang Anda buat di langkah di atas menggunakan fungsi summary. Ini akan menampilkan beberapa parameter (bobot dan bias) di setiap layer dan juga total parameter dalam model Anda.
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_51 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_57 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_49 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_52 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_58 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_50 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_53 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_59 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_51 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
flatten_17 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_33 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_60 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dense_34 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
Akhirnya saatnya melatih model dengan fungsi fit() Keras! Model dilatih selama 20 epoch. Fungsi fit() akan mengembalikan objek history; Dengan menyimpan hasil fungsi ini dalam fashion_train, Anda dapat menggunakannya nanti untuk memplot akurasi dan loss antara pelatihan dan validasi yang akan membantu Anda menganalisis performa model secara visual.
fashion_train = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.4661 - acc: 0.8311 - val_loss: 0.3320 - val_acc: 0.8809
Epoch 2/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2874 - acc: 0.8951 - val_loss: 0.2781 - val_acc: 0.8963
Epoch 3/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2420 - acc: 0.9111 - val_loss: 0.2501 - val_acc: 0.9077
Epoch 4/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.2088 - acc: 0.9226 - val_loss: 0.2369 - val_acc: 0.9147
Epoch 5/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1838 - acc: 0.9324 - val_loss: 0.2602 - val_acc: 0.9070
Epoch 6/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1605 - acc: 0.9396 - val_loss: 0.2264 - val_acc: 0.9193
Epoch 7/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1356 - acc: 0.9488 - val_loss: 0.2566 - val_acc: 0.9180
Epoch 8/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1186 - acc: 0.9553 - val_loss: 0.2556 - val_acc: 0.9149
Epoch 9/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0985 - acc: 0.9634 - val_loss: 0.2681 - val_acc: 0.9204
Epoch 10/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0873 - acc: 0.9670 - val_loss: 0.2712 - val_acc: 0.9221
Epoch 11/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0739 - acc: 0.9721 - val_loss: 0.2757 - val_acc: 0.9202
Epoch 12/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0628 - acc: 0.9767 - val_loss: 0.3126 - val_acc: 0.9132
Epoch 13/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0569 - acc: 0.9789 - val_loss: 0.3556 - val_acc: 0.9081
Epoch 14/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0452 - acc: 0.9833 - val_loss: 0.3441 - val_acc: 0.9189
Epoch 15/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0421 - acc: 0.9847 - val_loss: 0.3400 - val_acc: 0.9165
Epoch 16/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0379 - acc: 0.9861 - val_loss: 0.3876 - val_acc: 0.9195
Epoch 17/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0405 - acc: 0.9855 - val_loss: 0.4112 - val_acc: 0.9164
Epoch 18/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0285 - acc: 0.9897 - val_loss: 0.4150 - val_acc: 0.9181
Epoch 19/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0322 - acc: 0.9877 - val_loss: 0.4584 - val_acc: 0.9196
Epoch 20/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0262 - acc: 0.9906 - val_loss: 0.4396 - val_acc: 0.9205
Akhirnya! Anda melatih model pada fashion-MNIST selama 20 epoch, dan dengan mengamati akurasi dan loss pelatihan, Anda dapat mengatakan bahwa model melakukan pekerjaan dengan baik karena setelah 20 epoch akurasi pelatihan 99% dan loss pelatihan cukup rendah.
Namun, sepertinya model mengalami overfitting, karena validation loss 0,4396 dan validation accuracy 92%. Overfitting memberi intuisi bahwa jaringan telah menghafal data pelatihan dengan sangat baik tetapi tidak dijamin bekerja pada data yang belum pernah dilihat, dan itulah mengapa ada perbedaan antara akurasi pelatihan dan validasi.
Anda mungkin perlu menangani ini. Pada bagian berikutnya, Anda akan mempelajari bagaimana membuat model Anda berkinerja lebih baik dengan menambahkan layer Dropout ke jaringan dan membiarkan semua layer lainnya tetap sama.
Tetapi pertama-tama, mari evaluasi performa model Anda pada set uji sebelum Anda menarik kesimpulan.
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.46366268818555401)
('Test accuracy:', 0.91839999999999999)
Akurasi uji terlihat mengesankan. Ternyata pengklasifikasi Anda lebih baik daripada tolok ukur yang dilaporkan di sini, yaitu pengklasifikasi SVM dengan akurasi rata-rata 0,897. Selain itu, model berkinerja baik dibandingkan beberapa model deep learning yang disebutkan pada profil GitHub para pembuat dataset fashion-MNIST.
Namun, Anda melihat bahwa model terlihat mengalami overfitting. Apakah hasil ini benar-benar sudah bagus?
Mari tempatkan evaluasi model Anda dalam perspektif dan plot akurasi serta loss antara data pelatihan dan validasi:
accuracy = fashion_train.history['acc']
val_accuracy = fashion_train.history['val_acc']
loss = fashion_train.history['loss']
val_loss = fashion_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
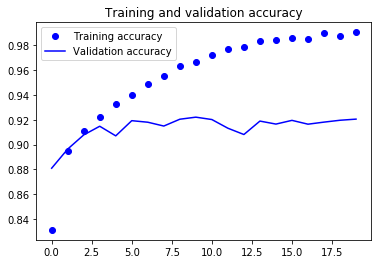
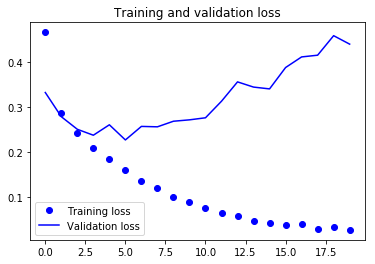
Dari dua plot di atas, Anda dapat melihat bahwa akurasi validasi hampir menjadi stagnan setelah 4-5 epoch dan jarang meningkat pada epoch tertentu. Di awal, akurasi validasi meningkat secara linier bersama loss, tetapi kemudian tidak banyak meningkat.
Loss validasi menunjukkan tanda overfitting; mirip dengan akurasi validasi, loss turun secara linier tetapi setelah 4-5 epoch, ia mulai meningkat. Ini berarti model mencoba menghafal data dan berhasil.
Dengan ini dalam pikiran, saatnya memperkenalkan dropout ke dalam model kita dan melihat apakah ini membantu mengurangi overfitting.
Anda dapat menambahkan layer dropout untuk mengatasi masalah overfitting sampai batas tertentu. Dropout secara acak mematikan sebagian neuron selama proses pelatihan, mengurangi ketergantungan pada set pelatihan dalam kadar tertentu. Berapa fraksi neuron yang ingin Anda matikan ditentukan oleh sebuah hyperparameter, yang dapat disetel sesuai kebutuhan. Dengan cara ini, mematikan beberapa neuron tidak akan memungkinkan jaringan menghafal data pelatihan karena tidak semua neuron akan aktif pada saat yang sama dan neuron yang tidak aktif tidak akan dapat mempelajari apa pun.
Jadi mari buat, kompilasi, dan latih jaringan lagi tetapi kali ini dengan dropout. Dan jalankan selama 20 epoch dengan batch size 64.
batch_size = 64
epochs = 20
num_classes = 10
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',padding='same',input_shape=(28,28,1)))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.4))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dropout(0.3))
fashion_model.add(Dense(num_classes, activation='softmax'))
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_54 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_61 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_52 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
dropout_29 (Dropout)         (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_62 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_53 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
dropout_30 (Dropout)         (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_63 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_54 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
dropout_31 (Dropout)         (None, 4, 4, 128)         0
_________________________________________________________________
flatten_18 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_35 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_64 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dropout_32 (Dropout)         (None, 128)               0
_________________________________________________________________
dense_36 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
fashion_train_dropout = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 66s 1ms/step - loss: 0.5954 - acc: 0.7789 - val_loss: 0.3788 - val_acc: 0.8586
Epoch 2/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3797 - acc: 0.8591 - val_loss: 0.3150 - val_acc: 0.8832
Epoch 3/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3302 - acc: 0.8787 - val_loss: 0.2836 - val_acc: 0.8961
Epoch 4/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3034 - acc: 0.8868 - val_loss: 0.2663 - val_acc: 0.9002
Epoch 5/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2843 - acc: 0.8936 - val_loss: 0.2481 - val_acc: 0.9083
Epoch 6/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2699 - acc: 0.9002 - val_loss: 0.2469 - val_acc: 0.9032
Epoch 7/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2561 - acc: 0.9049 - val_loss: 0.2422 - val_acc: 0.9095
Epoch 8/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2503 - acc: 0.9068 - val_loss: 0.2429 - val_acc: 0.9098
Epoch 9/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2437 - acc: 0.9096 - val_loss: 0.2230 - val_acc: 0.9173
Epoch 10/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9126 - val_loss: 0.2170 - val_acc: 0.9187
Epoch 11/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9135 - val_loss: 0.2265 - val_acc: 0.9193
Epoch 12/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2229 - acc: 0.9160 - val_loss: 0.2136 - val_acc: 0.9229
Epoch 13/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2202 - acc: 0.9162 - val_loss: 0.2173 - val_acc: 0.9187
Epoch 14/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2161 - acc: 0.9188 - val_loss: 0.2142 - val_acc: 0.9211
Epoch 15/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2119 - acc: 0.9196 - val_loss: 0.2133 - val_acc: 0.9233
Epoch 16/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2073 - acc: 0.9222 - val_loss: 0.2159 - val_acc: 0.9213
Epoch 17/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2050 - acc: 0.9231 - val_loss: 0.2123 - val_acc: 0.9233
Epoch 18/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2016 - acc: 0.9238 - val_loss: 0.2191 - val_acc: 0.9235
Epoch 19/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2001 - acc: 0.9244 - val_loss: 0.2110 - val_acc: 0.9258
Epoch 20/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.1972 - acc: 0.9255 - val_loss: 0.2092 - val_acc: 0.9269
Mari simpan model agar Anda dapat memuatnya langsung dan tidak perlu melatihnya lagi selama 20 epoch. Dengan cara ini, Anda dapat memuat model nanti jika diperlukan dan memodifikasi arsitekturnya; Atau, Anda dapat memulai proses pelatihan pada model yang disimpan ini. Selalu merupakan ide bagus untuk menyimpan model—dan bahkan bobot model!—karena ini menghemat waktu. Perhatikan bahwa Anda juga dapat menyimpan model setelah setiap epoch sehingga, jika terjadi masalah yang menghentikan pelatihan pada suatu epoch, Anda tidak perlu memulai pelatihan dari awal.
fashion_model.save("fashion_model_dropout.h5py")
Terakhir, mari juga evaluasi model baru Anda dan lihat bagaimana kinerjanya!
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=1)
10000/10000 [==============================] - 5s 461us/step
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.21460009642243386)
('Test accuracy:', 0.92300000000000004)
Wah! Sepertinya menambahkan Dropout dalam model kita berhasil, meskipun akurasi uji tidak meningkat secara signifikan tetapi loss uji menurun dibandingkan hasil sebelumnya.
Sekarang, mari plot akurasi dan loss antara data pelatihan dan validasi untuk terakhir kalinya.
accuracy = fashion_train_dropout.history['acc']
val_accuracy = fashion_train_dropout.history['val_acc']
loss = fashion_train_dropout.history['loss']
val_loss = fashion_train_dropout.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
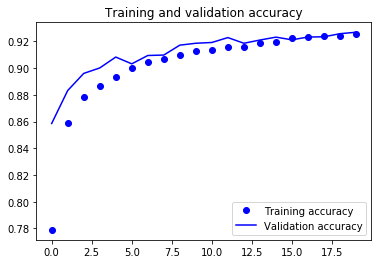
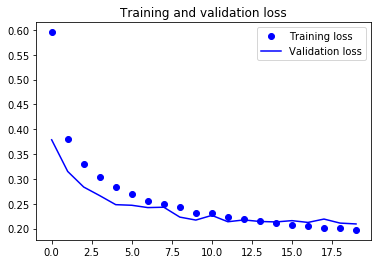
Akhirnya, Anda dapat melihat bahwa validation loss dan validation accuracy selaras dengan training loss dan training accuracy. Meskipun garis loss dan akurasi validasi tidak linier, ini menunjukkan bahwa model Anda tidak overfitting: validation loss menurun dan tidak meningkat, dan tidak ada celah besar antara akurasi pelatihan dan validasi.
Oleh karena itu, Anda dapat mengatakan bahwa kemampuan generalisasi model Anda menjadi jauh lebih baik karena loss pada set uji dan set validasi hanya sedikit lebih besar dibandingkan loss pelatihan.
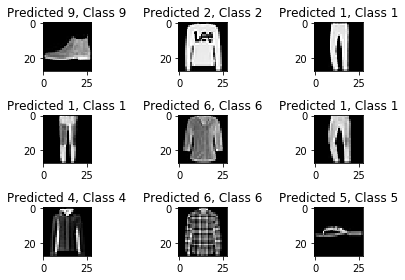
predicted_classes = fashion_model.predict(test_X)
Karena prediksi yang Anda dapatkan berupa nilai floating point, tidak akan layak untuk membandingkan label yang diprediksi dengan label uji yang sebenarnya. Jadi, Anda akan membulatkan output yang akan mengonversi nilai float menjadi bilangan bulat. Selanjutnya, Anda akan menggunakan np.argmax() untuk memilih nomor indeks yang memiliki nilai lebih tinggi dalam satu baris.
Misalnya, anggap sebuah prediksi untuk satu gambar uji adalah 0 1 0 0 0 0 0 0 0 0, maka outputnya harus berupa label kelas 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_Y.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_Y)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_Y[correct]))
    plt.tight_layout()
Found 9188 correct labels
incorrect = np.where(predicted_classes!=test_Y)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_Y[incorrect]))
    plt.tight_layout()
Found 812 incorrect labels
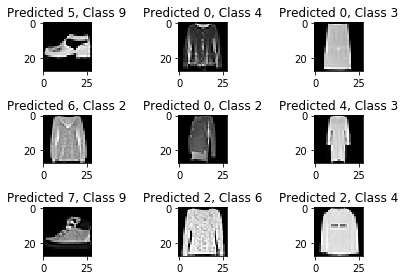
Dengan melihat beberapa gambar, Anda tidak bisa yakin mengapa model Anda tidak dapat mengklasifikasikan gambar di atas dengan benar, tetapi tampaknya beragam pola serupa yang ada pada beberapa kelas memengaruhi performa pengklasifikasi meskipun CNN adalah arsitektur yang tangguh. Misalnya, gambar 5 dan 6 keduanya termasuk kelas yang berbeda tetapi terlihat agak mirip—mungkin jaket atau kemeja lengan panjang.
Classification report akan membantu kita mengidentifikasi kelas yang salah klasifikasi secara lebih rinci. Anda akan dapat mengamati untuk kelas mana model berkinerja buruk dari sepuluh kelas yang diberikan.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_Y, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.77      0.90      0.83      1000
    Class 1       0.99      0.98      0.99      1000
    Class 2       0.88      0.88      0.88      1000
    Class 3       0.94      0.92      0.93      1000
    Class 4       0.88      0.87      0.88      1000
    Class 5       0.99      0.98      0.98      1000
    Class 6       0.82      0.72      0.77      1000
    Class 7       0.94      0.99      0.97      1000
    Class 8       0.99      0.98      0.99      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Anda dapat melihat bahwa pengklasifikasi berkinerja kurang baik untuk kelas 6 terkait precision dan recall. Untuk kelas 0 dan kelas 2, pengklasifikasi kurang dalam hal precision. Juga, untuk kelas 4, pengklasifikasi sedikit kurang dalam precision dan recall.
Lanjutkan!
Tutorial ini merupakan awal yang baik untuk convolutional neural networks di Python dengan Keras. Jika Anda dapat mengikutinya dengan mudah atau bahkan dengan sedikit usaha lebih, kerja bagus! Cobalah melakukan eksperimen mungkin dengan arsitektur model yang sama tetapi menggunakan berbagai jenis dataset publik yang tersedia.
Masih banyak yang harus dibahas, jadi mengapa tidak mengikuti kursus Deep Learning in Python dari DataCamp? Sementara itu, pastikan juga untuk memeriksa dokumentasi Keras, jika Anda belum melakukannya. Anda akan menemukan lebih banyak contoh dan informasi tentang semua fungsi, argumen, lebih banyak layer, dll. Ini pasti akan menjadi sumber yang sangat diperlukan saat Anda belajar bekerja dengan neural network di Python!
Jika Anda lebih suka membaca buku yang menjelaskan dasar-dasar deep learning (dengan Keras) beserta penggunaannya dalam praktik, Anda pasti harus membaca buku Deep Learning in Python karya François Chollet.
Pelajari lebih lanjut tentang Python dan Deep Learning
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




