Corso
Introduzione al Deep Learning in Python
4 ore
264.8K
Probabilmente hai già sentito parlare di riconoscimento di immagini o facciale, o di auto a guida autonoma. Sono implementazioni reali delle Convolutional Neural Networks (CNN). In questo post del blog, imparerai a implementare e comprendere queste reti neurali artificiali profonde feed-forward in Keras e a contrastare l’overfitting con la tecnica di regolarizzazione chiamata "dropout".
Più nello specifico, nell’articolo di oggi affronterai i seguenti argomenti:
Ti piacerebbe seguire un corso su Keras e deep learning in Python? Dai un’occhiata al corso Deep Learning in Python di DataCamp!
Inoltre, non perdere il nostro cheat sheet di Keras, che mostra i sei passaggi da seguire per costruire reti neurali in Python con esempi di codice!
A questo punto, potresti già conoscere il machine learning e il deep learning, un ramo dell’informatica che studia la progettazione di algoritmi in grado di apprendere. Il deep learning è un sottoinsieme del machine learning ispirato alle reti neurali artificiali, a loro volta ispirate alle reti neurali biologiche.
Un tipo specifico di queste reti profonde è la rete convoluzionale, comunemente chiamata CNN o ConvNet. È una rete neurale artificiale profonda e feed-forward. Ricorda che le reti neurali feed-forward sono anche chiamate perceptron multistrato (MLP), i modelli di deep learning per eccellenza. Si chiamano "feed-forward" perché l’informazione scorre in avanti attraverso il modello. Non ci sono connessioni di feedback in cui gli output del modello vengono reimmessi in esso.
Le CNN si ispirano specificamente alla corteccia visiva biologica. La corteccia ha piccole regioni di cellule sensibili ad aree specifiche del campo visivo. Questa idea è stata approfondita da un affascinante esperimento condotto da Hubel e Wiesel nel 1962 (se vuoi saperne di più, ecco un video). In questo esperimento, i ricercatori mostrarono che alcuni neuroni nel cervello si attivavano o "sparavano" solo in presenza di bordi con una particolare orientazione, come bordi verticali o orizzontali. Per esempio, alcuni neuroni si attivavano con lati verticali e altri con un bordo orizzontale. Hubel e Wiesel scoprirono che tutti questi neuroni erano ben ordinati in colonne e che insieme erano in grado di produrre la percezione visiva. Questa idea di componenti specializzati all’interno di un sistema, ciascuno con compiti specifici, è adottata anche dalle macchine e la ritrovi nelle CNN.
Le reti neurali convoluzionali sono state una delle innovazioni più influenti nel campo della computer vision. Hanno avuto prestazioni molto migliori dei metodi tradizionali e prodotto risultati all’avanguardia. Queste reti hanno avuto successo in molti casi d’uso e applicazioni reali, come:
Per capire questo successo, bisogna tornare al 2012, l’anno in cui Alex Krizhevsky usò le reti neurali convoluzionali per vincere l’ImageNet Competition di quell’anno, riducendo l’errore di classificazione dal 26% al 15%.
Nota: l’ImageNet Large Scale Visual Recognition Challenge (ILSVRC), iniziata nel 2010, è una competizione annuale in cui i gruppi di ricerca valutano i propri algoritmi sul dataset fornito e competono per ottenere la massima accuratezza in vari compiti di riconoscimento visivo.
Fu allora che le reti neurali riconquistarono la ribalta dopo parecchio tempo. Spesso si parla della "terza ondata delle reti neurali". Le altre due ondate furono tra gli anni ’40 e ’60 e tra gli anni ’70 e ’80.
Bene, sai che lavorerai con reti feed-forward ispirate alla corteccia visiva biologica, ma cosa significa concretamente?
Guarda l’immagine qui sotto:
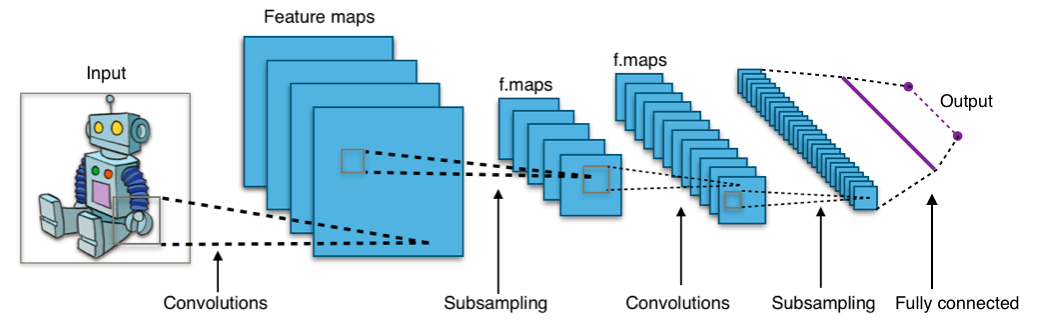
L’immagine mostra che fornisci un’immagine in input alla rete, che attraversa più convoluzioni, sottocampionamento, uno strato completamente connesso e infine produce un output.
Ma cosa sono tutti questi concetti?
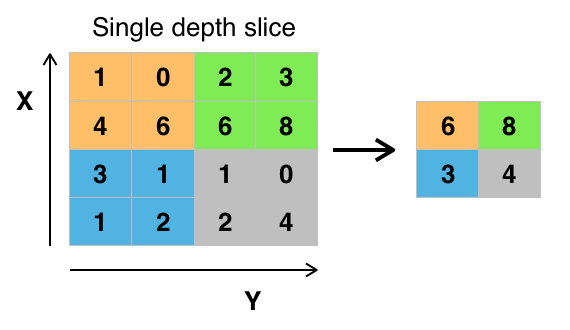
Per maggiori informazioni, puoi andare qui.
Prima di caricare i dati, è utile capire con cosa lavorerai esattamente! Il dataset Fashion-MNIST è un insieme di immagini di articoli di Zalando, con immagini in scala di grigi 28x28 di 70.000 prodotti fashion di 10 categorie e 7.000 immagini per categoria. Il set di training ha 60.000 immagini e il set di test 10.000 immagini. Potrai verificarlo più avanti quando avrai caricato i dati! ;)
Fashion-MNIST è simile al dataset MNIST che potresti già conoscere, usato per classificare cifre scritte a mano. Ciò significa che dimensioni delle immagini, suddivisioni in training e test sono simili a quelle di MNIST. Tip: se vuoi imparare a implementare un Multi-Layer Perceptron (MLP) per compiti di classificazione con quest’ultimo dataset, vai a questo tutorial su Keras.
Puoi trovare il dataset Fashion-MNIST qui, ma puoi anche caricarlo con l’aiuto di moduli specifici di TensorFlow e Keras. Vedrai come funziona nella prossima sezione!
Keras include una libreria chiamata datasets, che ti permette di caricare i dataset pronti all’uso: scarichi i dati dal server e velocizzi il processo, senza doverli scaricare sul tuo computer. Le immagini di train e test con le relative etichette vengono caricate e memorizzate rispettivamente nelle variabili train_X, train_Y, test_X, test_Y.
from keras.datasets import fashion_mnist
(train_X,train_Y), (test_X,test_Y) = fashion_mnist.load_data()
Using TensorFlow backend.
Ottimo! È stato piuttosto semplice, vero?
Probabilmente l’hai già fatto mille volte, ma è sempre un passaggio essenziale per iniziare. Ora sei completamente pronto per analizzare, processare e modellare i tuoi dati!
Ora analizziamo l’aspetto delle immagini nel dataset. Anche se ormai conosci le dimensioni delle immagini, vale la pena analizzarle in modo programmatico: potresti dover riportare in scala i pixel e ridimensionare le immagini.
import numpy as np
from keras.utils import to_categorical
import matplotlib.pyplot as plt
%matplotlib inline

print('Training data shape : ', train_X.shape, train_Y.shape)

print('Testing data shape : ', test_X.shape, test_Y.shape)
('Training data shape : ', (60000, 28, 28), (60000,))
('Testing data shape : ', (10000, 28, 28), (10000,))
Dall’output qui sopra, puoi vedere che i dati di training hanno forma 60000 x 28 x 28 poiché ci sono 60.000 campioni di training ognuno di dimensione 28 x 28. Analogamente, i dati di test hanno forma 10000 x 28 x 28 poiché ci sono 10.000 campioni di test.
# Find the unique numbers from the train labels
classes = np.unique(train_Y)
nClasses = len(classes)
print('Total number of outputs : ', nClasses)
print('Output classes : ', classes)
('Total number of outputs : ', 10)
('Output classes : ', array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=uint8))
C’è anche un totale di dieci classi di output che vanno da 0 a 9.
Inoltre, non dimenticare di dare un’occhiata alle immagini del tuo dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
plt.imshow(train_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(train_Y[0]))

# Display the first image in testing data
plt.subplot(122)
plt.imshow(test_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(test_Y[0]))
Text(0.5,1,u'Ground Truth : 9')
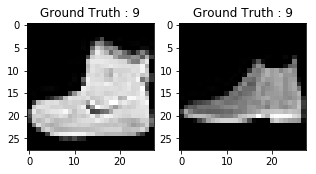
L’output dei due grafici sopra sembra uno stivaletto alla caviglia, e a questa classe è assegnata l’etichetta 9. Allo stesso modo, altri prodotti avranno etichette diverse, ma i prodotti simili avranno la stessa etichetta. Ciò significa che tutte le 7.000 immagini di stivaletti alla caviglia avranno l’etichetta di classe 9.
Come hai visto nel grafico precedente, le immagini sono in scala di grigi e hanno valori di pixel che vanno da 0 a 255. Inoltre, hanno dimensione 28 x 28. Di conseguenza, dovrai fare il preprocessing dei dati prima di passarli al modello.
train_X = train_X.reshape(-1, 28,28, 1)
test_X = test_X.reshape(-1, 28,28, 1)
train_X.shape, test_X.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
train_X = train_X.astype('float32')
test_X = test_X.astype('float32')
train_X = train_X / 255.
test_X = test_X / 255.
Nella one-hot encoding, converti i dati categorici in un vettore di numeri. Il motivo è che gli algoritmi di machine learning non possono lavorare direttamente con dati categorici. Generi una colonna booleana per ogni categoria o classe. Per ciascun campione, solo una di queste colonne può assumere il valore 1. Da qui il termine one-hot encoding.
Per il tuo problema, la one-hot encoding sarà un vettore riga e, per ogni immagine, avrà dimensione 1 x 10. La cosa importante da notare è che il vettore è composto da tutti zeri tranne che per la classe che rappresenta, per la quale vale 1. Per esempio, l’immagine di stivaletto che hai tracciato sopra ha etichetta 9, quindi per tutte le immagini di stivaletti il vettore one-hot sarà [0 0 0 0 0 0 0 0 1 0].
Convertiamo quindi le etichette di training e di test in vettori one-hot:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_Y)
test_Y_one_hot = to_categorical(test_Y)

# Display the change for category label using one-hot encoding
print('Original label:', train_Y[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([ 0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  1.]))
Abbastanza chiaro, no? Nota che puoi anche stampare train_Y_one_hot, che mostrerà una matrice 60000 x 10 in cui ogni riga rappresenta la one-hot encoding di un’immagine.
from sklearn.model_selection import train_test_split
train_X,valid_X,train_label,valid_label = train_test_split(train_X, train_Y_one_hot, test_size=0.2, random_state=13)
Per un’ultima volta, controlliamo la forma dei set di training e validazione.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Le immagini sono di dimensione 28 x 28. Converti la matrice dell’immagine in un array, la riporti in scala tra 0 e 1, la rimodelli a 28 x 28 x 1 e la passi come input alla rete.
Userai tre livelli convoluzionali:
Inoltre, ci sono tre livelli di max pooling, ciascuno di dimensione 2 x 2.
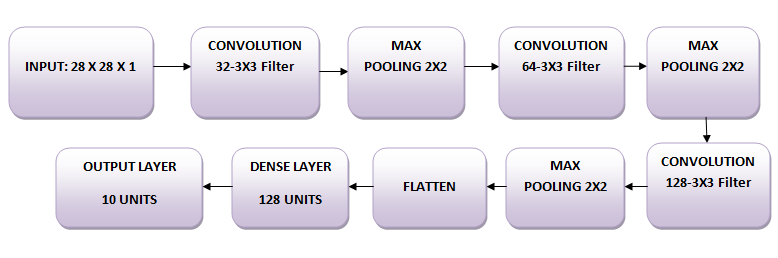
Per prima cosa, importiamo tutti i moduli necessari per addestrare il modello.
import keras
from keras.models import Sequential,Input,Model
from keras.layers import Dense, Dropout, Flatten
from keras.layers import Conv2D, MaxPooling2D
from keras.layers.normalization import BatchNormalization
from keras.layers.advanced_activations import LeakyReLU
Userai una batch size di 64; anche una batch size più alta di 128 o 256 è preferibile, dipende tutta dalla memoria. Influisce molto sulla determinazione dei parametri di apprendimento e sull’accuratezza di previsione. Allenerai la rete per 20 epoche.
batch_size = 64
epochs = 20
num_classes = 10
In Keras, puoi impilare i layer aggiungendo uno alla volta quello desiderato. È esattamente ciò che farai qui: aggiungerai prima un livello convoluzionale con Conv2D(). Nota che usi questa funzione perché stai lavorando con immagini! Poi aggiungi la funzione di attivazione Leaky ReLU, che aiuta la rete a imparare confini di decisione non lineari. Poiché hai dieci classi diverse, ti serve un confine di decisione non lineare che possa separare queste dieci classi che non sono linearmente separabili.
Più specificamente, aggiungi le Leaky ReLU perché cercano di risolvere il problema delle Rectified Linear Unit (ReLU) "morte". La funzione di attivazione ReLU è molto usata nelle architetture di reti neurali e in particolare nelle reti convoluzionali, dove si è dimostrata più efficace della diffusa funzione sigmoide logistica. Dal 2017, è la funzione di attivazione più popolare per le reti neurali profonde. La ReLU consente di sogliare l’attivazione a zero. Tuttavia, durante l’addestramento, le unità ReLU possono "morire". Ciò può accadere quando un grande gradiente attraversa un neurone ReLU: può causare un aggiornamento dei pesi tale che il neurone non si attiverà più su nessun punto dati. Se succede, da quel momento in poi il gradiente che attraversa l’unità sarà sempre zero. Le Leaky ReLU cercano di risolvere questo problema: la funzione non sarà zero ma avrà una piccola pendenza negativa.
Successivamente, aggiungerai il livello di max pooling con MaxPooling2D() e così via. L’ultimo livello è un Dense con funzione di attivazione softmax e 10 unità, necessario per questo problema di classificazione multiclasse.
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',input_shape=(28,28,1),padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dense(num_classes, activation='softmax'))
Dopo aver creato il modello, lo compili usando l’ottimizzatore Adam, uno degli algoritmi di ottimizzazione più popolari. Puoi leggere di più su questo ottimizzatore qui. Inoltre, specifichi il tipo di loss, che è la categorical cross entropy usata per la classificazione multiclasse; puoi anche usare la binary cross-entropy come funzione di perdita. Infine, specifichi come metrica l’accuratezza, che vuoi analizzare durante l’addestramento del modello.
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Visualizziamo i layer che hai creato sopra usando la funzione di riepilogo. Mostrerà alcuni parametri (pesi e bias) in ciascun layer e anche il totale dei parametri nel modello.
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_51 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_57 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_49 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_52 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_58 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_50 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_53 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_59 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_51 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
flatten_17 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_33 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_60 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dense_34 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello si allena per 20 epoche. La funzione fit() restituirà un oggetto history; Memorizzando il risultato in fashion_train, potrai usarlo dopo per tracciare i grafici di accuratezza e perdita tra training e validazione, cosa che ti aiuterà ad analizzare visivamente le prestazioni del modello.
fashion_train = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.4661 - acc: 0.8311 - val_loss: 0.3320 - val_acc: 0.8809
Epoch 2/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2874 - acc: 0.8951 - val_loss: 0.2781 - val_acc: 0.8963
Epoch 3/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2420 - acc: 0.9111 - val_loss: 0.2501 - val_acc: 0.9077
Epoch 4/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.2088 - acc: 0.9226 - val_loss: 0.2369 - val_acc: 0.9147
Epoch 5/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1838 - acc: 0.9324 - val_loss: 0.2602 - val_acc: 0.9070
Epoch 6/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1605 - acc: 0.9396 - val_loss: 0.2264 - val_acc: 0.9193
Epoch 7/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1356 - acc: 0.9488 - val_loss: 0.2566 - val_acc: 0.9180
Epoch 8/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1186 - acc: 0.9553 - val_loss: 0.2556 - val_acc: 0.9149
Epoch 9/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0985 - acc: 0.9634 - val_loss: 0.2681 - val_acc: 0.9204
Epoch 10/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0873 - acc: 0.9670 - val_loss: 0.2712 - val_acc: 0.9221
Epoch 11/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0739 - acc: 0.9721 - val_loss: 0.2757 - val_acc: 0.9202
Epoch 12/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0628 - acc: 0.9767 - val_loss: 0.3126 - val_acc: 0.9132
Epoch 13/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0569 - acc: 0.9789 - val_loss: 0.3556 - val_acc: 0.9081
Epoch 14/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0452 - acc: 0.9833 - val_loss: 0.3441 - val_acc: 0.9189
Epoch 15/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0421 - acc: 0.9847 - val_loss: 0.3400 - val_acc: 0.9165
Epoch 16/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0379 - acc: 0.9861 - val_loss: 0.3876 - val_acc: 0.9195
Epoch 17/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0405 - acc: 0.9855 - val_loss: 0.4112 - val_acc: 0.9164
Epoch 18/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0285 - acc: 0.9897 - val_loss: 0.4150 - val_acc: 0.9181
Epoch 19/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0322 - acc: 0.9877 - val_loss: 0.4584 - val_acc: 0.9196
Epoch 20/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0262 - acc: 0.9906 - val_loss: 0.4396 - val_acc: 0.9205
Finalmente! Hai addestrato il modello su Fashion-MNIST per 20 epoche e, osservando accuratezza e perdita di training, puoi dire che il modello ha fatto un buon lavoro: dopo 20 epoche l’accuratezza di training è al 99% e la perdita è piuttosto bassa.
Tuttavia, sembra che il modello stia facendo overfitting, dato che la perdita di validazione è 0,4396 e l’accuratezza di validazione è 92%. L’overfitting suggerisce che la rete ha memorizzato molto bene i dati di training ma non è garantito che funzioni su dati mai visti, ed è per questo che c’è una differenza tra accuratezza di training e di validazione.
Probabilmente serve gestire la cosa. Nelle prossime sezioni, imparerai come migliorare le prestazioni aggiungendo un livello di Dropout nella rete e mantenendo invariati gli altri layer.
Ma prima, valutiamo le prestazioni del modello sul set di test prima di trarre conclusioni.
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.46366268818555401)
('Test accuracy:', 0.91839999999999999)
L’accuratezza sul test è notevole. A quanto pare, il tuo classificatore fa meglio del benchmark riportato qui, ovvero un classificatore SVM con accuratezza media di 0,897. Inoltre, il modello si comporta bene rispetto ad alcuni modelli di deep learning menzionati nel profilo GitHub dei creatori del dataset Fashion-MNIST.
Tuttavia, hai visto che il modello sembrava in overfitting. Questi risultati sono davvero così buoni?
Mettiamo in prospettiva la valutazione del modello e tracciamo i grafici di accuratezza e perdita tra dati di training e validazione:
accuracy = fashion_train.history['acc']
val_accuracy = fashion_train.history['val_acc']
loss = fashion_train.history['loss']
val_loss = fashion_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
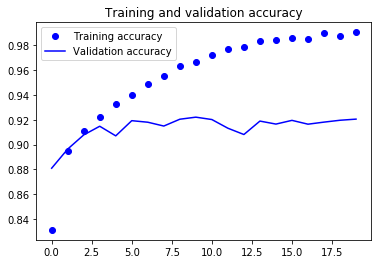
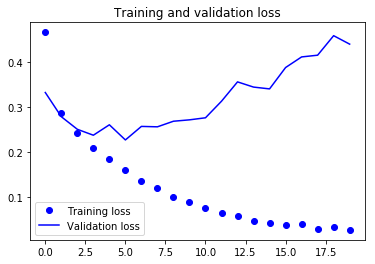
Dai due grafici qui sopra, puoi vedere che l’accuratezza di validazione è diventata quasi stagnante dopo 4-5 epoche e raramente è aumentata in certe epoche. All’inizio cresceva linearmente con la perdita, ma poi non è aumentata molto.
La perdita di validazione mostra segni di overfitting; in modo simile all’accuratezza di validazione, è diminuita linearmente ma dopo 4-5 epoche ha iniziato ad aumentare. Questo significa che il modello ha cercato di memorizzare i dati e ci è riuscito.
Con questo in mente, è il momento di introdurre un po’ di dropout nel nostro modello e vedere se aiuta a ridurre l’overfitting.
Puoi aggiungere un livello di dropout per mitigare in parte il problema dell’overfitting. Il dropout disattiva casualmente una frazione di neuroni durante l’addestramento, riducendo la dipendenza dal set di training. La quantità di neuroni da disattivare è decisa da un iperparametro, che può essere regolato. In questo modo, spegnere alcuni neuroni non permetterà alla rete di memorizzare i dati di training, poiché non tutti i neuroni saranno attivi allo stesso tempo e quelli inattivi non potranno apprendere nulla.
Creiamo quindi di nuovo la rete, compiliamola e alleniamola, questa volta con il dropout. E facciamola girare per 20 epoche con batch size di 64.
batch_size = 64
epochs = 20
num_classes = 10
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',padding='same',input_shape=(28,28,1)))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.4))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dropout(0.3))
fashion_model.add(Dense(num_classes, activation='softmax'))
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_54 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_61 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_52 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
dropout_29 (Dropout)         (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_62 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_53 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
dropout_30 (Dropout)         (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_63 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_54 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
dropout_31 (Dropout)         (None, 4, 4, 128)         0
_________________________________________________________________
flatten_18 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_35 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_64 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dropout_32 (Dropout)         (None, 128)               0
_________________________________________________________________
dense_36 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
fashion_train_dropout = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 66s 1ms/step - loss: 0.5954 - acc: 0.7789 - val_loss: 0.3788 - val_acc: 0.8586
Epoch 2/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3797 - acc: 0.8591 - val_loss: 0.3150 - val_acc: 0.8832
Epoch 3/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3302 - acc: 0.8787 - val_loss: 0.2836 - val_acc: 0.8961
Epoch 4/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3034 - acc: 0.8868 - val_loss: 0.2663 - val_acc: 0.9002
Epoch 5/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2843 - acc: 0.8936 - val_loss: 0.2481 - val_acc: 0.9083
Epoch 6/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2699 - acc: 0.9002 - val_loss: 0.2469 - val_acc: 0.9032
Epoch 7/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2561 - acc: 0.9049 - val_loss: 0.2422 - val_acc: 0.9095
Epoch 8/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2503 - acc: 0.9068 - val_loss: 0.2429 - val_acc: 0.9098
Epoch 9/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2437 - acc: 0.9096 - val_loss: 0.2230 - val_acc: 0.9173
Epoch 10/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9126 - val_loss: 0.2170 - val_acc: 0.9187
Epoch 11/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9135 - val_loss: 0.2265 - val_acc: 0.9193
Epoch 12/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2229 - acc: 0.9160 - val_loss: 0.2136 - val_acc: 0.9229
Epoch 13/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2202 - acc: 0.9162 - val_loss: 0.2173 - val_acc: 0.9187
Epoch 14/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2161 - acc: 0.9188 - val_loss: 0.2142 - val_acc: 0.9211
Epoch 15/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2119 - acc: 0.9196 - val_loss: 0.2133 - val_acc: 0.9233
Epoch 16/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2073 - acc: 0.9222 - val_loss: 0.2159 - val_acc: 0.9213
Epoch 17/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2050 - acc: 0.9231 - val_loss: 0.2123 - val_acc: 0.9233
Epoch 18/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2016 - acc: 0.9238 - val_loss: 0.2191 - val_acc: 0.9235
Epoch 19/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2001 - acc: 0.9244 - val_loss: 0.2110 - val_acc: 0.9258
Epoch 20/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.1972 - acc: 0.9255 - val_loss: 0.2092 - val_acc: 0.9269
Salviamo il modello in modo da poterlo caricare direttamente senza doverlo riaddestrare per 20 epoche. Così potrai caricarlo in seguito, se necessario, e modificare l’architettura; in alternativa, puoi riprendere l’addestramento da questo modello salvato. È sempre una buona idea salvare il modello —e persino i pesi!— perché fa risparmiare tempo. Nota che puoi anche salvare il modello dopo ogni epoca, così, se dovesse verificarsi un problema che interrompe l’addestramento a un’epoca, non dovrai ricominciare dall’inizio.
fashion_model.save("fashion_model_dropout.h5py")
Infine, valutiamo anche il nuovo modello e vediamo come si comporta!
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=1)
10000/10000 [==============================] - 5s 461us/step
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.21460009642243386)
('Test accuracy:', 0.92300000000000004)
Wow! Sembra che aggiungere il Dropout al nostro modello abbia funzionato, anche se l’accuratezza di test non è migliorata in modo significativo, la perdita sul test è diminuita rispetto ai risultati precedenti.
Ora tracciamo per l’ultima volta i grafici di accuratezza e perdita tra training e validazione.
accuracy = fashion_train_dropout.history['acc']
val_accuracy = fashion_train_dropout.history['val_acc']
loss = fashion_train_dropout.history['loss']
val_loss = fashion_train_dropout.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
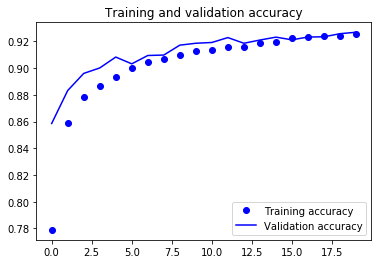
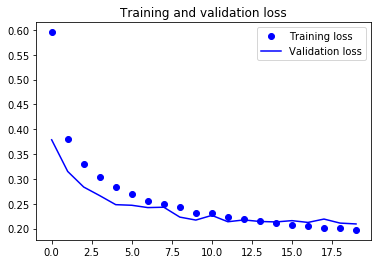
Infine, puoi vedere che perdita e accuratezza di validazione sono entrambe in linea con perdita e accuratezza di training. Anche se le curve di perdita e accuratezza di validazione non sono lineari, mostrano che il modello non sta facendo overfitting: la perdita di validazione diminuisce e non aumenta, e non c’è un grande divario tra accuratezza di training e di validazione.
Pertanto, puoi dire che la capacità di generalizzazione del modello è migliorata molto, dato che la perdita sia sul set di test sia su quello di validazione è stata solo leggermente superiore rispetto alla perdita di training.
predicted_classes = fashion_model.predict(test_X)
Dato che le previsioni che ottieni sono valori in virgola mobile, non è pratico confrontare le etichette previste con quelle reali. Quindi, arrotonderai l’output, che convertirà i valori float in interi. Inoltre, userai np.argmax() per selezionare l’indice con valore più alto in una riga.
Per esempio, supponiamo che una previsione per un’immagine di test sia 0 1 0 0 0 0 0 0 0 0, l’output dovrebbe essere l’etichetta di classe 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_Y.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_Y)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_Y[correct]))
    plt.tight_layout()
Found 9188 correct labels
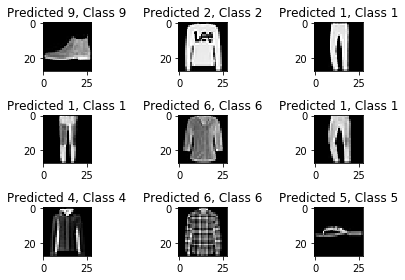
incorrect = np.where(predicted_classes!=test_Y)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_Y[incorrect]))
    plt.tight_layout()
Found 812 incorrect labels
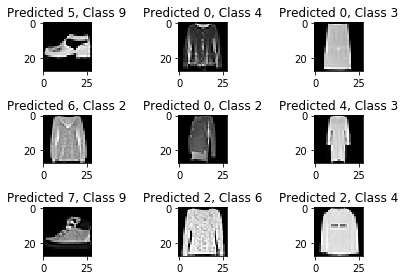
Osservando qualche immagine, non puoi essere certo del perché il modello non riesca a classificarle correttamente, ma sembra che una varietà di pattern simili presenti in più classi influisca sulle prestazioni del classificatore, sebbene la CNN sia un’architettura robusta. Per esempio, le immagini 5 e 6 appartengono a classi diverse ma sembrano simili, forse una giacca o magari una maglia a maniche lunghe.
Il classification report aiuta a identificare nel dettaglio le classi classificate in modo errato. Potrai osservare per quali classi il modello ha avuto performance peggiori tra le dieci fornite.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_Y, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.77      0.90      0.83      1000
    Class 1       0.99      0.98      0.99      1000
    Class 2       0.88      0.88      0.88      1000
    Class 3       0.94      0.92      0.93      1000
    Class 4       0.88      0.87      0.88      1000
    Class 5       0.99      0.98      0.98      1000
    Class 6       0.82      0.72      0.77      1000
    Class 7       0.94      0.99      0.97      1000
    Class 8       0.99      0.98      0.99      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Puoi vedere che il classificatore è carente per la classe 6 in termini sia di precision sia di recall. Per la classe 0 e la classe 2, al classificatore manca precision. Anche per la classe 4 il classificatore è leggermente carente sia in precision che in recall.
Vai oltre!
Questo tutorial è stato un buon inizio sulle reti neurali convoluzionali in Python con Keras. Se sei riuscito a seguirlo facilmente o anche con un po’ di impegno in più, ben fatto! Prova a fare qualche esperimento, magari con la stessa architettura ma usando diversi dataset pubblici disponibili.
C’è ancora molto da coprire, quindi perché non seguire il corso Deep Learning in Python di DataCamp? Nel frattempo, assicurati anche di consultare la documentazione di Keras, se non l’hai già fatto. Troverai più esempi e informazioni su tutte le funzioni, gli argomenti, ulteriori layer, ecc. Sarà senza dubbio una risorsa indispensabile mentre impari a lavorare con le reti neurali in Python!
Se preferisci leggere un libro che spiega i fondamenti del deep learning (con Keras) insieme al suo uso pratico, dovresti assolutamente leggere il libro di François Chollet Deep Learning in Python.
Scopri di più su Python e Deep Learning
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



