Cursus
Introductie tot Deep Learning in Python
4 uur
264.8K
Misschien heb je al gehoord van beeld- of gezichtsherkenning of zelfrijdende auto’s. Dit zijn real-life toepassingen van Convolutional Neural Networks (CNN’s). In deze blogpost leer en begrijp je hoe je deze diepe, feedforward kunstmatige neurale netwerken in Keras implementeert en leer je ook hoe je overfitting tegengaat met de regularisatietechniek die "dropout" heet.
Concreet pak je in deze tutorial de volgende onderwerpen aan:
Wil je een cursus volgen over Keras en deep learning in Python? Overweeg dan DataCamp’s Deep Learning in Python-cursus!
Mis ook zeker onze Keras-cheat sheet niet, waarin de zes stappen staan die je moet doorlopen om neurale netwerken in Python te bouwen, met codevoorbeelden!
Intussen weet je vast al iets over machine learning en deep learning, een tak van de informatica die de ontwikkeling bestudeert van algoritmes die kunnen leren. Deep learning is een subveld van machine learning dat geïnspireerd is op kunstmatige neurale netwerken, die op hun beurt geïnspireerd zijn op biologische neurale netwerken.
Een specifiek soort van zo’n diep neuraal netwerk is het convolutionele netwerk, vaak afgekort tot CNN of ConvNet. Het is een diep, feedforward kunstmatig neuraal netwerk. Onthoud dat feedforward-neurale netwerken ook wel multilayer perceptrons (MLP’s) worden genoemd, de schoolvoorbeelden van deep-learningmodellen. De modellen heten "feedforward" omdat informatie door het model heen stroomt. Er zijn geen feedbackverbindingen waarbij outputs van het model terug het model in gaan.
CNN’s zijn specifiek geïnspireerd op de biologische visuele cortex. De cortex heeft kleine celgebieden die gevoelig zijn voor specifieke delen van het gezichtsveld. Dit idee werd uitgediept door een boeiend experiment van Hubel en Wiesel in 1962 (als je meer wilt weten, hier is een video). In dit experiment toonden de onderzoekers aan dat sommige individuele neuronen in de hersenen alleen activeerden of "vuurden" in aanwezigheid van randen met een bepaalde oriëntatie, zoals verticale of horizontale randen. Zo vuurden sommige neuronen bij verticale randen en sommige bij een horizontale rand. Hubel en Wiesel ontdekten dat al deze neuronen netjes in kolommen geordend waren en samen visuele perceptie konden produceren. Dit idee van gespecialiseerde componenten binnen een systeem met specifieke taken wordt ook door machines gebruikt en vind je ook terug in CNN’s.
Convolutionele neurale netwerken zijn een van de meest invloedrijke innovaties geweest in computervisie. Ze presteren veel beter dan traditionele computervisie en leveren state-of-the-art resultaten. Deze neurale netwerken bleken succesvol in tal van real-life casestudy’s en toepassingen, zoals:
Om dit succes te begrijpen, moet je terug naar 2012, het jaar waarin Alex Krizhevsky convolutionele neurale netwerken gebruikte om die editie van de ImageNet Competition te winnen, waarbij hij de classificatiefout verlaagde van 26% naar 15%.
Let op: de ImageNet Large Scale Visual Recognition Challenge (ILSVRC) begon in 2010 en is een jaarlijkse competitie waarin onderzoeksteams hun algoritmes beoordelen op de gegeven dataset en strijden om hogere nauwkeurigheid op verschillende visuele herkenningstaken te behalen.
Dit was het moment waarop neurale netwerken na geruime tijd weer aan belangrijkheid wonnen. Dit wordt vaak de "derde golf van neurale netwerken" genoemd. De andere twee golven waren in de jaren 40 tot 60 en in de jaren 70 tot 80.
Oké, je weet dat je met feedforward-netwerken werkt die geïnspireerd zijn op de biologische visuele cortex, maar wat betekent dat precies?
Kijk naar de afbeelding hieronder:
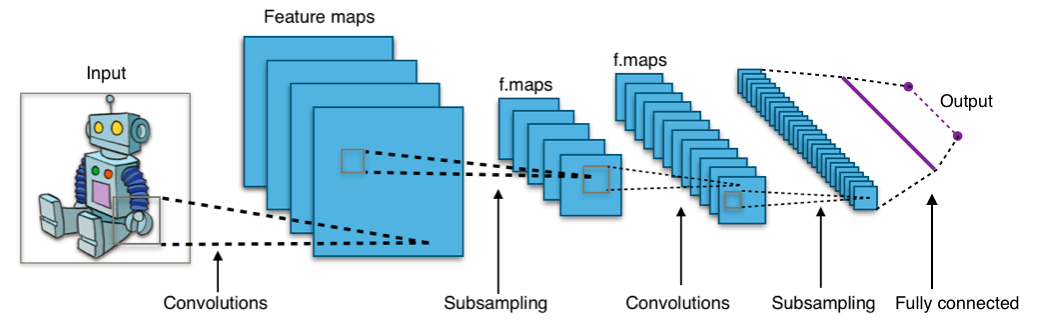
De afbeelding laat zien dat je een afbeelding als input aan het netwerk geeft, die door meerdere convoluties, subsampling, een volledig verbonden laag gaat en uiteindelijk iets uitput.
Maar wat zijn al deze concepten?
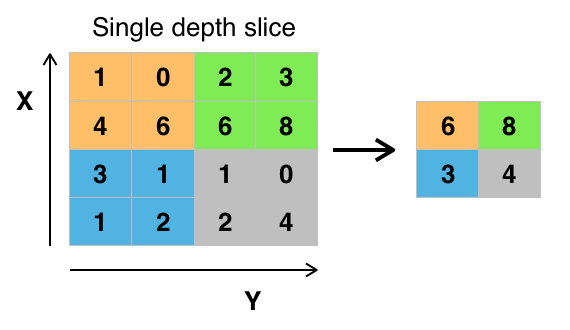
Voor meer informatie kun je hier terecht.
Voordat je de data gaat laden, is het goed om te kijken waarmee je precies aan de slag gaat! De Fashion-MNIST-dataset is een dataset met Zalando’s artikelafbeeldingen, met 28x28-grijswaardenafbeeldingen van 70.000 modeproducten uit 10 categorieën, en 7.000 afbeeldingen per categorie. De trainingsset bevat 60.000 afbeeldingen en de testset 10.000 afbeeldingen. Je kunt dit later nog eens dubbelchecken zodra je je data hebt geladen! ;)
Fashion-MNIST lijkt op de MNIST-dataset die je misschien al kent, die je gebruikt om handgeschreven cijfers te classificeren. Dat betekent dat de afbeeldingsafmetingen en de splitsing van train en test vergelijkbaar zijn met de MNIST-dataset. Tip: als je wilt leren hoe je een Multi-Layer Perceptron (MLP) implementeert voor classificatietaken met die laatste dataset, ga dan naar deze deep-learningtutorial met Keras.
Je vindt de Fashion-MNIST-dataset hier, maar je kunt ’m ook laden met behulp van specifieke TensorFlow- en Keras-modules. In de volgende sectie zie je hoe dat werkt!
Keras wordt geleverd met een library genaamd datasets, die je kunt gebruiken om kant-en-klare datasets te laden: je downloadt de data van de server en versnelt het proces omdat je de data niet meer lokaal hoeft te downloaden. De train- en testafbeeldingen samen met de labels worden geladen en opgeslagen in respectievelijk de variabelen train_X, train_Y, test_X, test_Y.
from keras.datasets import fashion_mnist
(train_X,train_Y), (test_X,test_Y) = fashion_mnist.load_data()
Using TensorFlow backend.
Mooi! Dat was vrij eenvoudig, toch?
Dit heb je waarschijnlijk al honderd keer gedaan, maar het blijft een essentiële eerste stap. Nu ben je er helemaal klaar voor om je data te gaan analyseren, verwerken en modelleren!
Laten we nu analyseren hoe de afbeeldingen in de dataset eruitzien. Ook al ken je inmiddels de afmetingen van de afbeeldingen, het is toch de moeite waard om dit programmatisch te bekijken: mogelijk moet je de pixelwaarden rescalen en de afbeeldingen resizen.
import numpy as np
from keras.utils import to_categorical
import matplotlib.pyplot as plt
%matplotlib inline

print('Training data shape : ', train_X.shape, train_Y.shape)

print('Testing data shape : ', test_X.shape, test_Y.shape)
('Training data shape : ', (60000, 28, 28), (60000,))
('Testing data shape : ', (10000, 28, 28), (10000,))
Uit de bovenstaande output zie je dat de trainingsdata een vorm hebben van 60000 x 28 x 28, aangezien er 60.000 trainingsvoorbeelden zijn met elk een afmeting van 28 x 28. Op dezelfde manier heeft de testdata een vorm van 10000 x 28 x 28 omdat er 10.000 testvoorbeelden zijn.
# Find the unique numbers from the train labels
classes = np.unique(train_Y)
nClasses = len(classes)
print('Total number of outputs : ', nClasses)
print('Output classes : ', classes)
('Total number of outputs : ', 10)
('Output classes : ', array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=uint8))
Er zijn ook in totaal tien outputklassen die lopen van 0 tot 9.
Vergeet ook niet te kijken naar hoe de afbeeldingen in je dataset eruitzien:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
plt.imshow(train_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(train_Y[0]))

# Display the first image in testing data
plt.subplot(122)
plt.imshow(test_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(test_Y[0]))
Text(0.5,1,u'Ground Truth : 9')
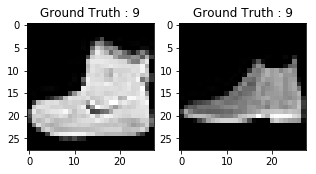
De output van bovenstaande twee plots lijkt op een enkelboot, en deze klasse heeft het label 9. Op dezelfde manier hebben andere modeproducten verschillende labels, maar vergelijkbare producten hebben hetzelfde label. Dit betekent dat alle 7.000 afbeeldingen van enkelboots het klasselabel 9 hebben.
Zoals je in de bovenstaande plot kon zien, zijn het grijswaardenafbeeldingen met pixelwaarden die variëren van 0 tot 255. Ook hebben deze afbeeldingen een afmeting van 28 x 28. Daarom moet je de data preprocessen voordat je die aan het model voert.
train_X = train_X.reshape(-1, 28,28, 1)
test_X = test_X.reshape(-1, 28,28, 1)
train_X.shape, test_X.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
train_X = train_X.astype('float32')
test_X = test_X.astype('float32')
train_X = train_X / 255.
test_X = test_X / 255.
Bij one-hot encoding zet je categorische data om in een vector met getallen. De reden dat je categorische data omzet naar one-hot encoding is dat machinelearningalgoritmes niet direct met categorische data kunnen werken. Je genereert één booleankolom voor elke categorie of klasse. Slechts één van deze kolommen kan voor elk voorbeeld de waarde 1 aannemen. Vandaar de term one-hot encoding.
Voor jouw probleem is de one-hot encoding een rijvector, en voor elke afbeelding heeft die een afmeting van 1 x 10. Belangrijk om op te merken is dat de vector alleen nullen bevat, behalve voor de klasse die hij vertegenwoordigt; daarvoor is de waarde 1. Bijvoorbeeld: de enkelbootafbeelding die je hierboven hebt geplot heeft label 9, dus voor alle enkelbootafbeeldingen zou de one-hot-encodingvector [0 0 0 0 0 0 0 0 1 0] zijn.
Laten we de train- en testlabels omzetten naar one-hot-encodingvectoren:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_Y)
test_Y_one_hot = to_categorical(test_Y)

# Display the change for category label using one-hot encoding
print('Original label:', train_Y[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([ 0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  1.]))
Dat is behoorlijk duidelijk, toch? Let op dat je ook train_Y_one_hot kunt printen; dat geeft een matrix van 60000 x 10 weer waarin elke rij de one-hot encoding van een afbeelding is.
from sklearn.model_selection import train_test_split
train_X,valid_X,train_label,valid_label = train_test_split(train_X, train_Y_one_hot, test_size=0.2, random_state=13)
Controleer voor de zekerheid nog één keer de vorm van de train- en validatieset.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
De afbeeldingen zijn 28 x 28. Je zet de afbeeldingsmatrix om naar een array, rescalet die tussen 0 en 1, reshaped naar 28 x 28 x 1 en voert dit als input aan het netwerk.
Je gebruikt drie convolutielagen:
Daarnaast zijn er drie max-poolinglagen, elk van formaat 2 x 2.
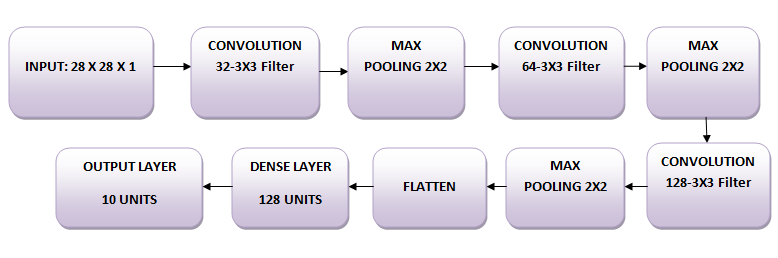
Laten we eerst alle benodigde modules importeren die nodig zijn om het model te trainen.
import keras
from keras.models import Sequential,Input,Model
from keras.layers import Dense, Dropout, Flatten
from keras.layers import Conv2D, MaxPooling2D
from keras.layers.normalization import BatchNormalization
from keras.layers.advanced_activations import LeakyReLU
Je gebruikt een batchgrootte van 64; een hogere batchgrootte van 128 of 256 is ook prima, het hangt allemaal af van het geheugen. Dit draagt sterk bij aan het bepalen van de leerparameters en beïnvloedt de predictienauwkeurigheid. Je traint het netwerk 20 epochs lang.
batch_size = 64
epochs = 20
num_classes = 10
In Keras kun je simpelweg lagen stapelen door de gewenste laag één voor één toe te voegen. Dat is precies wat je hier doet: je voegt eerst een eerste convolutielaag toe met Conv2D(). Merk op dat je deze functie gebruikt omdat je met afbeeldingen werkt! Vervolgens voeg je de Leaky ReLU-activatiefunctie toe, die het netwerk helpt niet-lineaire beslissingsgrenzen te leren. Omdat je tien verschillende klassen hebt, heb je een niet-lineaire beslissingsgrens nodig die deze tien klassen, die niet lineair scheidbaar zijn, kan scheiden.
Specifieker: je voegt Leaky ReLU’s toe omdat ze proberen het probleem van stervende ReLU’s op te lossen. De ReLU-activatiefunctie wordt veel gebruikt in neurale netwerkarchitecturen en meer specifiek in convolutionele netwerken, waar ze effectiever bleek dan de veelgebruikte logistische sigmoidfunctie. Vanaf 2017 is deze activatiefunctie de populairste voor diepe neurale netwerken. De ReLU-functie zorgt ervoor dat de activatie wordt afgekapt op nul. Tijdens het trainen kunnen ReLU-units echter "sterven". Dit kan gebeuren wanneer een grote gradiënt door een ReLU-neuron stroomt: de gewichten kunnen dan zo worden geüpdatet dat het neuron nooit meer activeert op welk datapunt dan ook. Als dat gebeurt, blijft de gradiënt door die unit vanaf dat moment altijd nul. Leaky ReLU’s proberen dit op te lossen: de functie wordt niet nul maar krijgt een kleine negatieve helling.
Vervolgens voeg je de max-poolinglaag toe met MaxPooling2D() enzovoort. De laatste laag is een Dense-laag met een softmax-activatiefunctie met 10 units, wat nodig is voor dit multiclass-classificatieprobleem.
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',input_shape=(28,28,1),padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dense(num_classes, activation='softmax'))
Nadat het model is aangemaakt, compileer je het met de Adam-optimizer, een van de populairste optimalisatiealgoritmes. Je kunt meer over deze optimizer lezen hier. Daarnaast specificeer je het type verliesfunctie, namelijk categorische cross-entropy, die wordt gebruikt voor multiclass-classificatie; je kunt ook binaire cross-entropy gebruiken als verliesfunctie. Tot slot geef je de metric accuracy op, die je tijdens het trainen wilt analyseren.
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Laten we de lagen die je hierboven hebt gemaakt visualiseren met de summary-functie. Dit toont enkele parameters (gewichten en biases) in elke laag en ook het totaal aantal parameters in je model.
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_51 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_57 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_49 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_52 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_58 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_50 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_53 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_59 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_51 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
flatten_17 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_33 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_60 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dense_34 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
Het is eindelijk tijd om het model te trainen met de fit()-functie van Keras! Het model traint 20 epochs. De fit()-functie retourneert een history-object; Door het resultaat van deze functie op te slaan in fashion_train, kun je het later gebruiken om de nauwkeurigheids- en verliescurves tussen training en validatie te plotten, wat je helpt de prestaties van je model visueel te analyseren.
fashion_train = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.4661 - acc: 0.8311 - val_loss: 0.3320 - val_acc: 0.8809
Epoch 2/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2874 - acc: 0.8951 - val_loss: 0.2781 - val_acc: 0.8963
Epoch 3/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2420 - acc: 0.9111 - val_loss: 0.2501 - val_acc: 0.9077
Epoch 4/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.2088 - acc: 0.9226 - val_loss: 0.2369 - val_acc: 0.9147
Epoch 5/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1838 - acc: 0.9324 - val_loss: 0.2602 - val_acc: 0.9070
Epoch 6/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1605 - acc: 0.9396 - val_loss: 0.2264 - val_acc: 0.9193
Epoch 7/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1356 - acc: 0.9488 - val_loss: 0.2566 - val_acc: 0.9180
Epoch 8/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1186 - acc: 0.9553 - val_loss: 0.2556 - val_acc: 0.9149
Epoch 9/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0985 - acc: 0.9634 - val_loss: 0.2681 - val_acc: 0.9204
Epoch 10/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0873 - acc: 0.9670 - val_loss: 0.2712 - val_acc: 0.9221
Epoch 11/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0739 - acc: 0.9721 - val_loss: 0.2757 - val_acc: 0.9202
Epoch 12/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0628 - acc: 0.9767 - val_loss: 0.3126 - val_acc: 0.9132
Epoch 13/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0569 - acc: 0.9789 - val_loss: 0.3556 - val_acc: 0.9081
Epoch 14/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0452 - acc: 0.9833 - val_loss: 0.3441 - val_acc: 0.9189
Epoch 15/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0421 - acc: 0.9847 - val_loss: 0.3400 - val_acc: 0.9165
Epoch 16/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0379 - acc: 0.9861 - val_loss: 0.3876 - val_acc: 0.9195
Epoch 17/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0405 - acc: 0.9855 - val_loss: 0.4112 - val_acc: 0.9164
Epoch 18/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0285 - acc: 0.9897 - val_loss: 0.4150 - val_acc: 0.9181
Epoch 19/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0322 - acc: 0.9877 - val_loss: 0.4584 - val_acc: 0.9196
Epoch 20/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0262 - acc: 0.9906 - val_loss: 0.4396 - val_acc: 0.9205
Eindelijk! Je hebt het model 20 epochs getraind op Fashion-MNIST en aan de hand van de training accuracy en loss kun je zeggen dat het model het goed deed, want na 20 epochs is de training accuracy 99% en is de training loss behoorlijk laag.
Het lijkt er echter op dat het model overfit, aangezien de validatieverlies 0,4396 is en de validatienauwkeurigheid 92%. Overfitting suggereert dat het netwerk de trainingsdata heel goed heeft gememoriseerd, maar niet gegarandeerd goed werkt op onzichtbare data; daarom is er een verschil tussen training- en validatienauwkeurigheid.
Dit moet je waarschijnlijk aanpakken. In de volgende secties leer je hoe je je model veel beter kunt laten presteren door een Dropout-laag aan het netwerk toe te voegen en alle andere lagen ongewijzigd te laten.
Maar eerst evalueren we de prestaties van je model op de testset voordat we conclusies trekken.
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.46366268818555401)
('Test accuracy:', 0.91839999999999999)
De testnauwkeurigheid ziet er indrukwekkend uit. Het blijkt dat je classifier beter presteert dan de benchmark die hier werd gerapporteerd, namelijk een SVM-classifier met een gemiddelde nauwkeurigheid van 0,897. Ook doet het model het goed vergeleken met sommige deep-learningmodellen die genoemd worden op het GitHub-profiel van de makers van de Fashion-MNIST-dataset.
Je zag echter dat het model tekenen van overfitting vertoonde. Zijn deze resultaten dan wel zo goed?
Laten we je modelevaluatie in perspectief plaatsen en de nauwkeurigheids- en verliescurves tussen training en validatie plotten:
accuracy = fashion_train.history['acc']
val_accuracy = fashion_train.history['val_acc']
loss = fashion_train.history['loss']
val_loss = fashion_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
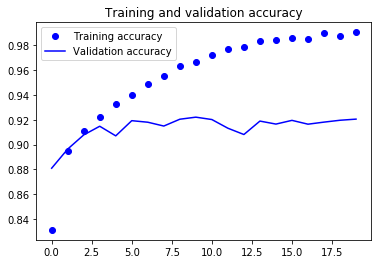
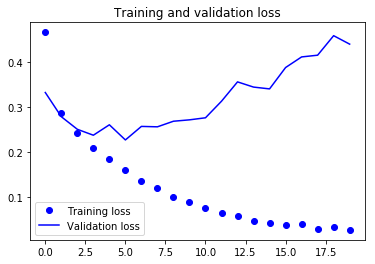
Uit de bovenstaande twee plots zie je dat de validatienauwkeurigheid na 4-5 epochs vrijwel stagneerde en slechts zelden toenam bij bepaalde epochs. In het begin steeg de validatienauwkeurigheid lineair met het verlies, maar daarna nam die niet veel meer toe.
Het validatieverlies laat zien dat dit een teken van overfitting is; net als de validatienauwkeurigheid daalde het lineair, maar na 4-5 epochs begon het te stijgen. Dit betekent dat het model heeft geprobeerd de data te memoriseren, en daarin is geslaagd.
Met dit in het achterhoofd is het tijd om wat dropout aan ons model toe te voegen en te kijken of dat helpt om overfitting te verminderen.
Je kunt een dropoutlaag toevoegen om het probleem van overfitting tot op zekere hoogte te verhelpen. Dropout schakelt tijdens het trainen willekeurig een fractie van de neuronen uit, waardoor de afhankelijkheid van de trainingsset enigszins afneemt. Hoeveel neuronen je wilt uitschakelen, wordt bepaald door een hyperparameter die je kunt afstemmen. Door sommige neuronen uit te schakelen, kan het netwerk de trainingsdata niet memoriseren, omdat niet alle neuronen tegelijk actief zijn en de inactieve neuronen niets kunnen leren.
Laten we het netwerk dus opnieuw aanmaken, compileren en trainen, maar deze keer met dropout. En voer het 20 epochs uit met een batchgrootte van 64.
batch_size = 64
epochs = 20
num_classes = 10
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',padding='same',input_shape=(28,28,1)))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.4))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dropout(0.3))
fashion_model.add(Dense(num_classes, activation='softmax'))
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_54 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_61 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_52 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
dropout_29 (Dropout)         (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_62 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_53 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
dropout_30 (Dropout)         (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_63 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_54 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
dropout_31 (Dropout)         (None, 4, 4, 128)         0
_________________________________________________________________
flatten_18 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_35 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_64 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dropout_32 (Dropout)         (None, 128)               0
_________________________________________________________________
dense_36 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
fashion_train_dropout = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 66s 1ms/step - loss: 0.5954 - acc: 0.7789 - val_loss: 0.3788 - val_acc: 0.8586
Epoch 2/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3797 - acc: 0.8591 - val_loss: 0.3150 - val_acc: 0.8832
Epoch 3/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3302 - acc: 0.8787 - val_loss: 0.2836 - val_acc: 0.8961
Epoch 4/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3034 - acc: 0.8868 - val_loss: 0.2663 - val_acc: 0.9002
Epoch 5/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2843 - acc: 0.8936 - val_loss: 0.2481 - val_acc: 0.9083
Epoch 6/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2699 - acc: 0.9002 - val_loss: 0.2469 - val_acc: 0.9032
Epoch 7/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2561 - acc: 0.9049 - val_loss: 0.2422 - val_acc: 0.9095
Epoch 8/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2503 - acc: 0.9068 - val_loss: 0.2429 - val_acc: 0.9098
Epoch 9/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2437 - acc: 0.9096 - val_loss: 0.2230 - val_acc: 0.9173
Epoch 10/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9126 - val_loss: 0.2170 - val_acc: 0.9187
Epoch 11/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9135 - val_loss: 0.2265 - val_acc: 0.9193
Epoch 12/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2229 - acc: 0.9160 - val_loss: 0.2136 - val_acc: 0.9229
Epoch 13/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2202 - acc: 0.9162 - val_loss: 0.2173 - val_acc: 0.9187
Epoch 14/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2161 - acc: 0.9188 - val_loss: 0.2142 - val_acc: 0.9211
Epoch 15/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2119 - acc: 0.9196 - val_loss: 0.2133 - val_acc: 0.9233
Epoch 16/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2073 - acc: 0.9222 - val_loss: 0.2159 - val_acc: 0.9213
Epoch 17/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2050 - acc: 0.9231 - val_loss: 0.2123 - val_acc: 0.9233
Epoch 18/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2016 - acc: 0.9238 - val_loss: 0.2191 - val_acc: 0.9235
Epoch 19/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2001 - acc: 0.9244 - val_loss: 0.2110 - val_acc: 0.9258
Epoch 20/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.1972 - acc: 0.9255 - val_loss: 0.2092 - val_acc: 0.9269
Laten we het model opslaan zodat je het later direct kunt laden en niet opnieuw 20 epochs hoeft te trainen. Zo kun je het model later laden als je het nodig hebt en de architectuur aanpassen; of je kunt het trainingsproces voortzetten op dit opgeslagen model. Het is altijd een goed idee om het model – en zelfs de gewichten! – op te slaan, want dat bespaart tijd. Let op: je kunt het model ook na elke epoch opslaan, zodat je, als er iets misgaat waardoor de training bij een epoch stopt, niet helemaal opnieuw hoeft te beginnen.
fashion_model.save("fashion_model_dropout.h5py")
Laten we tot slot ook je nieuwe model evalueren en zien hoe het presteert!
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=1)
10000/10000 [==============================] - 5s 461us/step
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.21460009642243386)
('Test accuracy:', 0.92300000000000004)
Wauw! Het lijkt erop dat het toevoegen van Dropout in ons model heeft gewerkt, ook al is de testnauwkeurigheid niet significant verbeterd, maar de testverlies is wel gedaald ten opzichte van de eerdere resultaten.
Laten we nu voor de laatste keer de nauwkeurigheids- en verliescurves tussen training en validatie plotten.
accuracy = fashion_train_dropout.history['acc']
val_accuracy = fashion_train_dropout.history['val_acc']
loss = fashion_train_dropout.history['loss']
val_loss = fashion_train_dropout.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
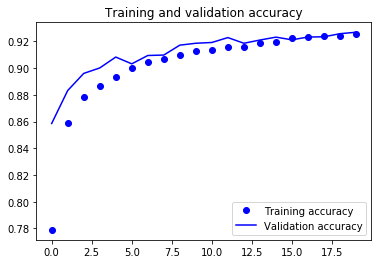
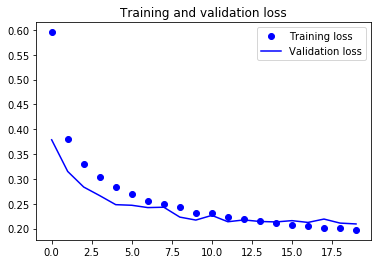
Uiteindelijk zie je dat het validatieverlies en de validatienauwkeurigheid in de pas lopen met respectievelijk het trainingsverlies en de trainingsnauwkeurigheid. Ook al zijn de lijnen voor validatieverlies en nauwkeurigheid niet lineair, ze laten zien dat je model niet overfit: het validatieverlies daalt en stijgt niet, en er is niet veel verschil tussen training- en validatienauwkeurigheid.
Daarom kun je stellen dat het generaliserend vermogen van je model veel beter is geworden, omdat het verlies op zowel de testset als de validatieset slechts iets hoger was dan het trainingsverlies.
predicted_classes = fashion_model.predict(test_X)
Aangezien de voorspellingen die je krijgt zwevende-kommagetallen zijn, is het niet praktisch om de voorspelde labels te vergelijken met de echte testlabels. Daarom rond je de output af, waardoor de floatwaarden worden omgezet naar een integer. Vervolgens gebruik je np.argmax() om de index te selecteren met de hoogste waarde in een rij.
Bijvoorbeeld, stel dat een voorspelling voor één testafbeelding 0 1 0 0 0 0 0 0 0 0 is; de output hiervoor moet dan het klasselabel 1 zijn.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_Y.shape
((10000,), (10000,))
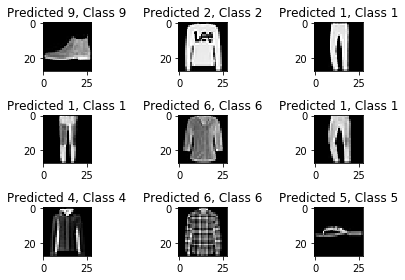
correct = np.where(predicted_classes==test_Y)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_Y[correct]))
    plt.tight_layout()
Found 9188 correct labels
incorrect = np.where(predicted_classes!=test_Y)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_Y[incorrect]))
    plt.tight_layout()
Found 812 incorrect labels
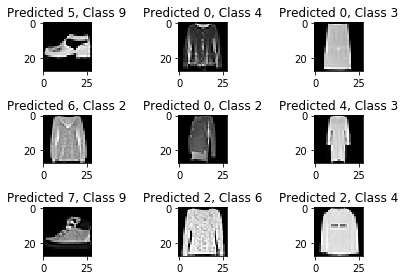
Op basis van een paar afbeeldingen kun je niet met zekerheid zeggen waarom je model de bovenstaande afbeeldingen niet correct kan classificeren, maar het lijkt erop dat een verscheidenheid aan vergelijkbare patronen die in meerdere klassen voorkomen, de prestaties van de classifier beïnvloeden, hoewel een CNN robuust is. Afbeeldingen 5 en 6 behoren bijvoorbeeld tot verschillende klassen maar lijken enigszins op elkaar: misschien een jas of een longsleeve.
Het classificatierapport helpt ons om de verkeerd geclassificeerde klassen in meer detail te identificeren. Je kunt zien voor welke klasse het model slecht presteerde van de tien gegeven klassen.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_Y, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.77      0.90      0.83      1000
    Class 1       0.99      0.98      0.99      1000
    Class 2       0.88      0.88      0.88      1000
    Class 3       0.94      0.92      0.93      1000
    Class 4       0.88      0.87      0.88      1000
    Class 5       0.99      0.98      0.98      1000
    Class 6       0.82      0.72      0.77      1000
    Class 7       0.94      0.99      0.97      1000
    Class 8       0.99      0.98      0.99      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Je ziet dat de classifier ondermaats presteert voor klasse 6, zowel qua precision als recall. Voor klasse 0 en klasse 2 schiet de classifier tekort op precision. Ook voor klasse 4 schiet de classifier licht tekort op zowel precision als recall.
Ga verder!
Deze tutorial was een goed begin met convolutionele neurale netwerken in Python met Keras. Als je dit gemakkelijk kon volgen, of met een beetje extra inzet, goed gedaan! Probeer eens wat experimenten te doen, misschien met dezelfde modelarchitectuur maar met verschillende soorten openbare datasets.
Er is nog veel meer te behandelen, dus waarom zou je niet DataCamp’s Deep Learning in Python-cursus volgen? Zorg intussen ook dat je de Keras-documentatie bekijkt, als je dat nog niet hebt gedaan. Je vindt er meer voorbeelden en informatie over alle functies, argumenten, extra lagen, enzovoort. Het zal ongetwijfeld een onmisbare bron zijn wanneer je leert werken met neurale netwerken in Python!
Als je liever een boek leest dat de basis van deep learning (met Keras) uitlegt samen met hoe het in de praktijk wordt gebruikt, moet je zeker François Chollet’s boek Deep Learning in Python lezen.
Leer meer over Python en Deep Learning
Cursus
Cursus
blog
Adel Nehme
15 min

