Khóa học
Nhập môn Deep Learning với Python
4 giờ
264.8K
Có thể bạn đã từng nghe về nhận dạng hình ảnh hoặc khuôn mặt, hay xe tự lái. Đây là những ứng dụng thực tế của Convolutional Neural Networks (CNN). Trong bài đăng này, bạn sẽ học và hiểu cách triển khai các mạng nơ-ron nhân tạo sâu, truyền thẳng này trong Keras và cũng học cách khắc phục hiện tượng quá khớp (overfitting) bằng kỹ thuật regularization gọi là "dropout".
Cụ thể hơn, trong bài hướng dẫn hôm nay bạn sẽ tìm hiểu các chủ đề sau:
Bạn muốn học một khóa về Keras và học sâu trong Python? Hãy cân nhắc tham gia khóa Deep Learning in Python của DataCamp!
Đừng bỏ lỡ Keras cheat sheet của chúng tôi, trình bày sáu bước bạn cần thực hiện để xây dựng mạng nơ-ron trong Python kèm ví dụ mã!
Đến giờ, có lẽ bạn đã biết về machine learning và deep learning, một nhánh của khoa học máy tính nghiên cứu thiết kế các thuật toán có khả năng học. Học sâu là một lĩnh vực con của học máy lấy cảm hứng từ mạng nơ-ron nhân tạo, vốn lại được lấy cảm hứng từ mạng nơ-ron sinh học.
Một dạng cụ thể của mạng nơ-ron sâu là mạng tích chập, thường được gọi là CNN hoặc ConvNet. Đây là một mạng nơ-ron nhân tạo sâu, truyền thẳng. Nhớ rằng mạng nơ-ron truyền thẳng còn được gọi là multi-layer perceptrons (MLPs), là những mô hình điển hình của học sâu. Các mô hình được gọi là "truyền thẳng" vì thông tin đi xuyên suốt mô hình. Không có kết nối hồi tiếp trong đó đầu ra của mô hình được đưa lại vào chính nó.
CNN đặc biệt lấy cảm hứng từ vỏ não thị giác sinh học. Vỏ não có các vùng nhỏ của tế bào nhạy với những khu vực cụ thể của trường thị giác. Ý tưởng này được mở rộng bởi một thí nghiệm hấp dẫn do Hubel và Wiesel thực hiện năm 1962 (nếu bạn muốn biết thêm, đây là video). Trong thí nghiệm này, các nhà nghiên cứu cho thấy một số nơ-ron riêng lẻ trong não chỉ kích hoạt khi có các cạnh với một định hướng cụ thể như cạnh dọc hoặc ngang. Ví dụ, một số nơ-ron kích hoạt khi tiếp xúc với cạnh dọc và một số khi nhìn thấy cạnh ngang. Hubel và Wiesel phát hiện tất cả các nơ-ron này được sắp xếp tốt theo cột và cùng nhau tạo ra nhận thức thị giác. Ý tưởng về các thành phần chuyên biệt bên trong một hệ thống đảm nhiệm các nhiệm vụ cụ thể cũng là điều mà máy móc sử dụng và bạn có thể thấy lại trong CNN.
Mạng nơ-ron tích chập là một trong những đổi mới có ảnh hưởng nhất trong thị giác máy tính. Chúng hoạt động tốt hơn nhiều so với các phương pháp thị giác máy tính truyền thống và đạt kết quả tiên tiến. Những mạng này đã chứng minh thành công trong nhiều nghiên cứu và ứng dụng thực tế khác nhau, như:
Để hiểu thành công này, bạn phải quay lại năm 2012, khi Alex Krizhevsky sử dụng CNN để thắng Cuộc thi ImageNet năm đó, giảm lỗi phân loại từ 26% xuống 15%.
Lưu ý ImageNet Large Scale Visual Recognition Challenge (ILSVRC) bắt đầu năm 2010 là cuộc thi thường niên nơi các nhóm nghiên cứu đánh giá thuật toán của họ trên tập dữ liệu cho sẵn và cạnh tranh để đạt độ chính xác cao hơn trên nhiều tác vụ nhận dạng thị giác.
Đây là thời điểm mạng nơ-ron lấy lại vị thế sau một thời gian dài. Điều này thường được gọi là "làn sóng thứ ba của mạng nơ-ron". Hai làn sóng còn lại là từ thập niên 1940 đến 1960 và từ thập niên 1970 đến 1980.
Được rồi, bạn biết rằng bạn sẽ làm việc với các mạng truyền thẳng lấy cảm hứng từ vỏ não thị giác sinh học, nhưng điều đó thực sự có nghĩa là gì?
Hãy nhìn vào hình dưới:
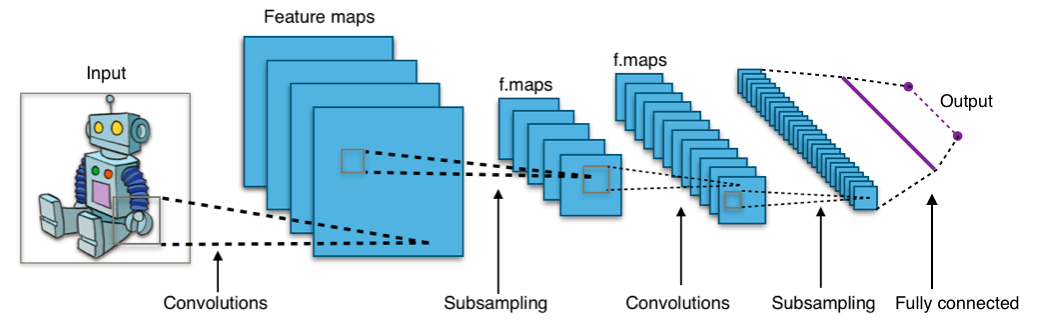
Hình cho thấy bạn đưa một ảnh làm đầu vào cho mạng, ảnh đi qua nhiều lớp tích chập, lấy mẫu con, một lớp kết nối đầy đủ và cuối cùng cho ra đầu ra.
Nhưng tất cả những khái niệm này là gì?
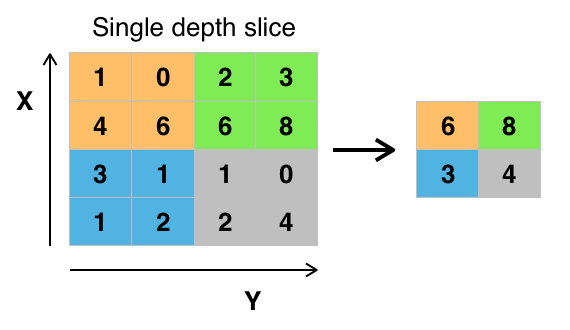
Để biết thêm thông tin, bạn có thể xem tại đây.
Trước khi tiếp tục và tải dữ liệu, sẽ tốt hơn nếu bạn nhìn qua xem chính xác bạn sẽ làm việc với gì! Bộ dữ liệu Fashion-MNIST là tập ảnh các sản phẩm của Zalando, gồm các ảnh thang xám 28x28 của 70.000 sản phẩm thời trang thuộc 10 danh mục, và 7.000 ảnh mỗi danh mục. Tập huấn luyện có 60.000 ảnh, và tập kiểm tra có 10.000 ảnh. Bạn có thể kiểm tra lại điều này sau khi đã tải dữ liệu! ;)
Fashion-MNIST tương tự bộ MNIST mà có thể bạn đã biết, dùng để phân loại chữ số viết tay. Điều đó nghĩa là kích thước ảnh, cách chia tập huấn luyện và kiểm tra tương tự như MNIST. Mẹo: nếu bạn muốn học cách triển khai Multi-Layer Perceptron (MLP) cho bài toán phân loại với bộ dữ liệu sau này, hãy xem hướng dẫn deep learning với Keras này.
Bạn có thể tìm bộ dữ liệu Fashion-MNIST tại đây, nhưng bạn cũng có thể tải bằng các mô-đun cụ thể của TensorFlow và Keras. Bạn sẽ thấy cách thực hiện ở phần tiếp theo!
Keras đi kèm thư viện datasets, bạn có thể dùng để tải sẵn các tập dữ liệu: bạn tải dữ liệu từ máy chủ và tăng tốc quá trình vì không còn phải tải về máy tính của bạn. Ảnh huấn luyện và kiểm tra cùng với nhãn sẽ được tải và lưu vào các biến train_X, train_Y, test_X, test_Y tương ứng.
from keras.datasets import fashion_mnist
(train_X,train_Y), (test_X,test_Y) = fashion_mnist.load_data()
Using TensorFlow backend.
Tuyệt! Khá đơn giản, phải không?
Có lẽ đến giờ bạn đã làm điều này cả triệu lần, nhưng đây luôn là bước cần thiết để bắt đầu. Giờ thì bạn đã sẵn sàng để bắt đầu phân tích, xử lý và mô hình hóa dữ liệu!
Giờ hãy phân tích xem những ảnh trong bộ dữ liệu trông như thế nào. Dù bạn đã biết kích thước ảnh, vẫn đáng để phân tích bằng chương trình: bạn có thể cần chuẩn hóa điểm ảnh và thay đổi kích thước ảnh.
import numpy as np
from keras.utils import to_categorical
import matplotlib.pyplot as plt
%matplotlib inline

print('Training data shape : ', train_X.shape, train_Y.shape)

print('Testing data shape : ', test_X.shape, test_Y.shape)
('Training data shape : ', (60000, 28, 28), (60000,))
('Testing data shape : ', (10000, 28, 28), (10000,))
Từ đầu ra trên, bạn thấy dữ liệu huấn luyện có kích thước 60000 x 28 x 28 vì có 60.000 mẫu huấn luyện, mỗi mẫu kích thước 28 x 28. Tương tự, dữ liệu kiểm tra có kích thước 10000 x 28 x 28 vì có 10.000 mẫu kiểm tra.
# Find the unique numbers from the train labels
classes = np.unique(train_Y)
nClasses = len(classes)
print('Total number of outputs : ', nClasses)
print('Output classes : ', classes)
('Total number of outputs : ', 10)
('Output classes : ', array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=uint8))
Cũng có tổng cộng mười lớp đầu ra từ 0 đến 9.
Đồng thời, đừng quên xem các ảnh trong bộ dữ liệu của bạn:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
plt.imshow(train_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(train_Y[0]))

# Display the first image in testing data
plt.subplot(122)
plt.imshow(test_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(test_Y[0]))
Text(0.5,1,u'Ground Truth : 9')
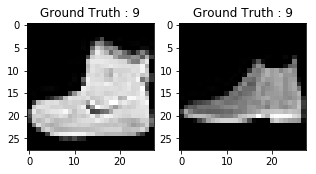
Đầu ra của hai biểu đồ trên trông giống một đôi bốt cổ chân, và lớp này được gán nhãn lớp 9. Tương tự, các sản phẩm thời trang khác sẽ có nhãn khác nhau, nhưng các sản phẩm tương tự sẽ có cùng nhãn. Điều này có nghĩa toàn bộ 7.000 ảnh bốt cổ chân sẽ có nhãn lớp 9.
Như bạn có thể thấy ở biểu đồ trên, các ảnh là ảnh thang xám với giá trị điểm ảnh từ 0 đến 255. Đồng thời, các ảnh này có kích thước 28 x 28. Do đó, bạn sẽ cần tiền xử lý dữ liệu trước khi đưa vào mô hình.
train_X = train_X.reshape(-1, 28,28, 1)
test_X = test_X.reshape(-1, 28,28, 1)
train_X.shape, test_X.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
train_X = train_X.astype('float32')
test_X = test_X.astype('float32')
train_X = train_X / 255.
test_X = test_X / 255.
Trong one-hot encoding, bạn chuyển dữ liệu phân loại thành một vector số. Lý do bạn chuyển dữ liệu phân loại sang one-hot là vì các thuật toán học máy không thể làm việc trực tiếp với dữ liệu phân loại. Bạn tạo một cột boolean cho mỗi danh mục hoặc lớp. Chỉ một trong các cột này có thể nhận giá trị 1 cho mỗi mẫu. Vì vậy mới gọi là one-hot encoding.
Với bài toán của bạn, one-hot encoding sẽ là một vector hàng, và với mỗi ảnh, nó có kích thước 1 x 10. Điều quan trọng cần lưu ý là vector gồm toàn số 0 ngoại trừ lớp mà nó đại diện, với giá trị là 1. Ví dụ, ảnh bốt cổ chân mà bạn đã vẽ ở trên có nhãn 9, nên với tất cả ảnh bốt cổ chân, vector one-hot sẽ là [0 0 0 0 0 0 0 0 1 0].
Vậy hãy chuyển nhãn huấn luyện và kiểm tra sang vector one-hot encoding:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_Y)
test_Y_one_hot = to_categorical(test_Y)

# Display the change for category label using one-hot encoding
print('Original label:', train_Y[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([ 0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  1.]))
Khá rõ ràng, đúng không? Lưu ý bạn cũng có thể in train_Y_one_hot, sẽ hiển thị một ma trận kích thước 60000 x 10 trong đó mỗi hàng biểu diễn one-hot encoding của một ảnh.
from sklearn.model_selection import train_test_split
train_X,valid_X,train_label,valid_label = train_test_split(train_X, train_Y_one_hot, test_size=0.2, random_state=13)
Một lần nữa hãy kiểm tra kích thước của tập huấn luyện và xác thực.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Các ảnh có kích thước 28 x 28. Bạn chuyển ma trận ảnh thành mảng, chuẩn hóa về khoảng 0 đến 1, reshape để có kích thước 28 x 28 x 1, và đưa vào mạng.
Bạn sẽ dùng ba lớp tích chập:
Thêm vào đó, có ba lớp max-pooling mỗi lớp kích thước 2 x 2.
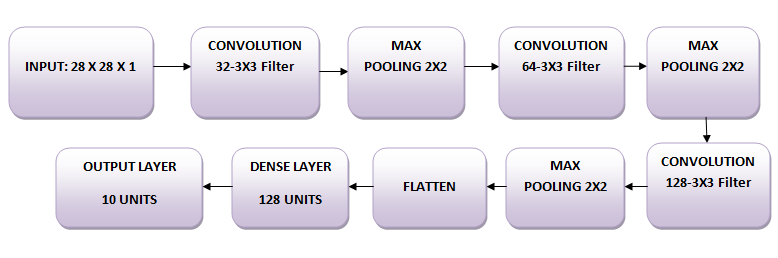
Đầu tiên, hãy import tất cả các mô-đun cần thiết để huấn luyện mô hình.
import keras
from keras.models import Sequential,Input,Model
from keras.layers import Dense, Dropout, Flatten
from keras.layers import Conv2D, MaxPooling2D
from keras.layers.normalization import BatchNormalization
from keras.layers.advanced_activations import LeakyReLU
Bạn sẽ dùng batch size là 64; dùng batch lớn hơn 128 hoặc 256 cũng có thể, tùy bộ nhớ. Nó góp phần lớn vào việc quyết định các tham số học và ảnh hưởng đến độ chính xác dự đoán. Bạn sẽ huấn luyện mạng trong 20 epoch.
batch_size = 64
epochs = 20
num_classes = 10
Trong Keras, bạn có thể xếp chồng các lớp bằng cách thêm lần lượt các lớp mong muốn. Đó chính xác là điều bạn sẽ làm ở đây: trước tiên bạn thêm lớp tích chập đầu tiên với Conv2D(). Lưu ý bạn dùng hàm này vì bạn đang làm việc với ảnh! Tiếp theo, bạn thêm hàm kích hoạt Leaky ReLU giúp mạng học các biên quyết định phi tuyến. Vì bạn có mười lớp khác nhau, bạn sẽ cần một biên quyết định phi tuyến có thể tách mười lớp này vốn không tách tuyến tính được.
Cụ thể hơn, bạn thêm Leaky ReLU vì chúng cố gắng khắc phục vấn đề "ReLU chết". Hàm kích hoạt ReLU được dùng rất nhiều trong các kiến trúc mạng nơ-ron và đặc biệt trong mạng tích chập, nơi nó tỏ ra hiệu quả hơn hàm sigmoid logistic từng được dùng rộng rãi. Tính đến năm 2017, đây là hàm kích hoạt phổ biến nhất cho mạng nơ-ron sâu. Hàm ReLU cho phép kích hoạt được ngưỡng tại 0. Tuy nhiên, trong quá trình huấn luyện, các đơn vị ReLU có thể "chết". Điều này có thể xảy ra khi một gradient lớn đi qua một nơ-ron ReLU: nó có thể khiến trọng số được cập nhật theo cách mà nơ-ron sẽ không bao giờ kích hoạt trên bất kỳ điểm dữ liệu nào nữa. Nếu điều này xảy ra, gradient đi qua đơn vị đó sẽ mãi là 0. Leaky ReLU cố gắng giải quyết điều này: hàm sẽ không bằng 0 mà có một độ dốc âm nhỏ.
Tiếp theo, bạn sẽ thêm lớp max-pooling với MaxPooling2D() và cứ thế. Lớp cuối là lớp Dense có hàm kích hoạt softmax với 10 đơn vị, cần thiết cho bài toán phân loại đa lớp này.
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',input_shape=(28,28,1),padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dense(num_classes, activation='softmax'))
Sau khi tạo mô hình, bạn biên dịch nó bằng bộ tối ưu Adam, một trong những thuật toán tối ưu phổ biến nhất. Bạn có thể đọc thêm về bộ tối ưu này tại đây. Ngoài ra, bạn chỉ định loại loss là categorical cross entropy dùng cho phân loại đa lớp; bạn cũng có thể dùng binary cross-entropy làm hàm mất mát. Cuối cùng, bạn chỉ định metrics là accuracy để phân tích trong khi mô hình đang huấn luyện.
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Hãy trực quan hóa các lớp bạn đã tạo ở bước trên bằng hàm summary. Điều này sẽ hiển thị một số tham số (trọng số và độ lệch) ở mỗi lớp và cả tổng tham số trong mô hình.
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_51 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_57 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_49 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_52 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_58 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_50 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_53 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_59 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_51 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
flatten_17 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_33 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_60 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dense_34 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
Cuối cùng cũng đến lúc huấn luyện mô hình với hàm fit() của Keras! Mô hình được huấn luyện trong 20 epoch. Hàm fit() sẽ trả về một đối tượng history; Bằng cách lưu kết quả hàm này vào fashion_train, bạn có thể dùng nó sau để vẽ các đồ thị độ chính xác và mất mát giữa huấn luyện và xác thực, giúp bạn phân tích trực quan hiệu năng mô hình.
fashion_train = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.4661 - acc: 0.8311 - val_loss: 0.3320 - val_acc: 0.8809
Epoch 2/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2874 - acc: 0.8951 - val_loss: 0.2781 - val_acc: 0.8963
Epoch 3/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2420 - acc: 0.9111 - val_loss: 0.2501 - val_acc: 0.9077
Epoch 4/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.2088 - acc: 0.9226 - val_loss: 0.2369 - val_acc: 0.9147
Epoch 5/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1838 - acc: 0.9324 - val_loss: 0.2602 - val_acc: 0.9070
Epoch 6/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1605 - acc: 0.9396 - val_loss: 0.2264 - val_acc: 0.9193
Epoch 7/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1356 - acc: 0.9488 - val_loss: 0.2566 - val_acc: 0.9180
Epoch 8/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1186 - acc: 0.9553 - val_loss: 0.2556 - val_acc: 0.9149
Epoch 9/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0985 - acc: 0.9634 - val_loss: 0.2681 - val_acc: 0.9204
Epoch 10/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0873 - acc: 0.9670 - val_loss: 0.2712 - val_acc: 0.9221
Epoch 11/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0739 - acc: 0.9721 - val_loss: 0.2757 - val_acc: 0.9202
Epoch 12/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0628 - acc: 0.9767 - val_loss: 0.3126 - val_acc: 0.9132
Epoch 13/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0569 - acc: 0.9789 - val_loss: 0.3556 - val_acc: 0.9081
Epoch 14/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0452 - acc: 0.9833 - val_loss: 0.3441 - val_acc: 0.9189
Epoch 15/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0421 - acc: 0.9847 - val_loss: 0.3400 - val_acc: 0.9165
Epoch 16/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0379 - acc: 0.9861 - val_loss: 0.3876 - val_acc: 0.9195
Epoch 17/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0405 - acc: 0.9855 - val_loss: 0.4112 - val_acc: 0.9164
Epoch 18/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0285 - acc: 0.9897 - val_loss: 0.4150 - val_acc: 0.9181
Epoch 19/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0322 - acc: 0.9877 - val_loss: 0.4584 - val_acc: 0.9196
Epoch 20/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0262 - acc: 0.9906 - val_loss: 0.4396 - val_acc: 0.9205
Cuối cùng! Bạn đã huấn luyện mô hình trên fashion-MNIST trong 20 epoch, và quan sát độ chính xác cùng mất mát huấn luyện, bạn có thể nói mô hình làm tốt vì sau 20 epoch độ chính xác huấn luyện đạt 99% và mất mát khá thấp.
Tuy nhiên, có vẻ mô hình đang quá khớp, khi mất mát xác thực là 0.4396 và độ chính xác xác thực là 92%. Quá khớp cho thấy mạng đã ghi nhớ dữ liệu huấn luyện rất tốt nhưng không đảm bảo hoạt động trên dữ liệu chưa thấy, đó là lý do có sự chênh lệch giữa độ chính xác huấn luyện và xác thực.
Bạn có lẽ cần xử lý điều này. Ở các phần tiếp theo, bạn sẽ học cách giúp mô hình hoạt động tốt hơn bằng cách thêm một lớp Dropout vào mạng và giữ nguyên các lớp khác.
Nhưng trước hết, hãy đánh giá hiệu năng mô hình trên tập kiểm tra trước khi đưa ra kết luận.
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.46366268818555401)
('Test accuracy:', 0.91839999999999999)
Độ chính xác trên tập kiểm tra trông ấn tượng. Hóa ra bộ phân loại của bạn làm tốt hơn mốc tham chiếu được báo cáo tại đây, là một bộ phân loại SVM với độ chính xác trung bình 0.897. Ngoài ra, mô hình cũng làm tốt so với một số mô hình học sâu được đề cập trên GitHub của những người tạo ra bộ dữ liệu fashion-MNIST.
Tuy nhiên, bạn đã thấy mô hình có vẻ quá khớp. Liệu những kết quả này có thực sự tốt đến vậy?
Hãy đặt việc đánh giá mô hình vào bối cảnh và vẽ các đồ thị độ chính xác và mất mát giữa dữ liệu huấn luyện và xác thực:
accuracy = fashion_train.history['acc']
val_accuracy = fashion_train.history['val_acc']
loss = fashion_train.history['loss']
val_loss = fashion_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
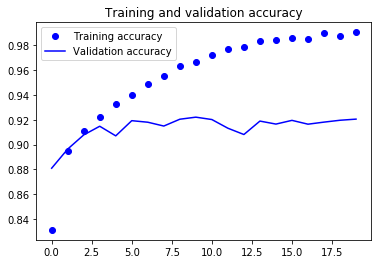
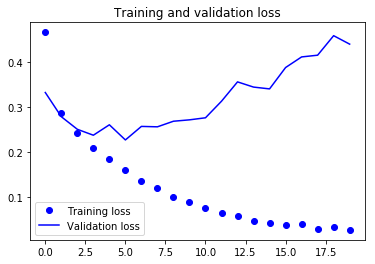
Từ hai biểu đồ trên, bạn thấy độ chính xác xác thực gần như chững lại sau 4-5 epoch và hiếm khi tăng ở một số epoch. Ban đầu, độ chính xác xác thực tăng tuyến tính với mất mát, nhưng sau đó không tăng nhiều.
Đường mất mát xác thực cho thấy dấu hiệu quá khớp, tương tự độ chính xác xác thực: nó giảm tuyến tính nhưng sau 4-5 epoch thì bắt đầu tăng. Điều này nghĩa là mô hình cố gắng ghi nhớ dữ liệu và đã thành công.
Với điều này trong đầu, đã đến lúc đưa dropout vào mô hình và xem liệu nó giúp giảm quá khớp không.
Bạn có thể thêm một lớp dropout để khắc phục phần nào vấn đề quá khớp. Dropout ngẫu nhiên tắt một phần nơ-ron trong quá trình huấn luyện, giảm phụ thuộc vào tập huấn luyện ở một mức nào đó. Tỷ lệ nơ-ron muốn tắt do một siêu tham số quyết định, có thể tinh chỉnh tương ứng. Bằng cách này, việc tắt một số nơ-ron sẽ không cho phép mạng ghi nhớ dữ liệu huấn luyện vì không phải tất cả nơ-ron đều hoạt động cùng lúc và các nơ-ron không hoạt động sẽ không học được gì.
Vậy hãy tạo, biên dịch và huấn luyện lại mạng nhưng lần này có dropout. Và chạy 20 epoch với batch size 64.
batch_size = 64
epochs = 20
num_classes = 10
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',padding='same',input_shape=(28,28,1)))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.4))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dropout(0.3))
fashion_model.add(Dense(num_classes, activation='softmax'))
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_54 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_61 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_52 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
dropout_29 (Dropout)         (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_62 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_53 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
dropout_30 (Dropout)         (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_63 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_54 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
dropout_31 (Dropout)         (None, 4, 4, 128)         0
_________________________________________________________________
flatten_18 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_35 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_64 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dropout_32 (Dropout)         (None, 128)               0
_________________________________________________________________
dense_36 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
fashion_train_dropout = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 66s 1ms/step - loss: 0.5954 - acc: 0.7789 - val_loss: 0.3788 - val_acc: 0.8586
Epoch 2/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3797 - acc: 0.8591 - val_loss: 0.3150 - val_acc: 0.8832
Epoch 3/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3302 - acc: 0.8787 - val_loss: 0.2836 - val_acc: 0.8961
Epoch 4/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3034 - acc: 0.8868 - val_loss: 0.2663 - val_acc: 0.9002
Epoch 5/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2843 - acc: 0.8936 - val_loss: 0.2481 - val_acc: 0.9083
Epoch 6/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2699 - acc: 0.9002 - val_loss: 0.2469 - val_acc: 0.9032
Epoch 7/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2561 - acc: 0.9049 - val_loss: 0.2422 - val_acc: 0.9095
Epoch 8/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2503 - acc: 0.9068 - val_loss: 0.2429 - val_acc: 0.9098
Epoch 9/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2437 - acc: 0.9096 - val_loss: 0.2230 - val_acc: 0.9173
Epoch 10/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9126 - val_loss: 0.2170 - val_acc: 0.9187
Epoch 11/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9135 - val_loss: 0.2265 - val_acc: 0.9193
Epoch 12/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2229 - acc: 0.9160 - val_loss: 0.2136 - val_acc: 0.9229
Epoch 13/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2202 - acc: 0.9162 - val_loss: 0.2173 - val_acc: 0.9187
Epoch 14/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2161 - acc: 0.9188 - val_loss: 0.2142 - val_acc: 0.9211
Epoch 15/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2119 - acc: 0.9196 - val_loss: 0.2133 - val_acc: 0.9233
Epoch 16/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2073 - acc: 0.9222 - val_loss: 0.2159 - val_acc: 0.9213
Epoch 17/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2050 - acc: 0.9231 - val_loss: 0.2123 - val_acc: 0.9233
Epoch 18/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2016 - acc: 0.9238 - val_loss: 0.2191 - val_acc: 0.9235
Epoch 19/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2001 - acc: 0.9244 - val_loss: 0.2110 - val_acc: 0.9258
Epoch 20/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.1972 - acc: 0.9255 - val_loss: 0.2092 - val_acc: 0.9269
Hãy lưu mô hình để bạn có thể tải trực tiếp và không phải huấn luyện lại 20 epoch. Bằng cách này, bạn có thể tải mô hình sau này nếu cần và chỉnh sửa kiến trúc; Hoặc bạn có thể bắt đầu quá trình huấn luyện từ mô hình đã lưu này. Luôn là ý tưởng hay khi lưu mô hình -và cả trọng số!- vì nó tiết kiệm thời gian. Lưu ý bạn cũng có thể lưu mô hình sau mỗi epoch để nếu có sự cố làm dừng huấn luyện ở một epoch, bạn sẽ không phải bắt đầu lại từ đầu.
fashion_model.save("fashion_model_dropout.h5py")
Cuối cùng, hãy đánh giá cả mô hình mới của bạn và xem nó hoạt động ra sao!
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=1)
10000/10000 [==============================] - 5s 461us/step
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.21460009642243386)
('Test accuracy:', 0.92300000000000004)
Wow! Có vẻ như thêm Dropout vào mô hình đã phát huy tác dụng, dù độ chính xác kiểm tra không cải thiện đáng kể nhưng mất mát kiểm tra đã giảm so với kết quả trước đó.
Giờ hãy vẽ đồ thị độ chính xác và mất mát giữa dữ liệu huấn luyện và xác thực lần cuối.
accuracy = fashion_train_dropout.history['acc']
val_accuracy = fashion_train_dropout.history['val_acc']
loss = fashion_train_dropout.history['loss']
val_loss = fashion_train_dropout.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
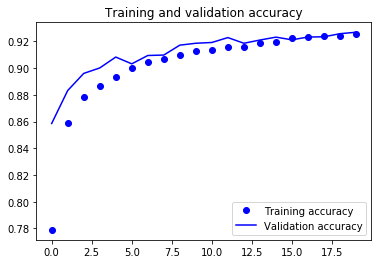
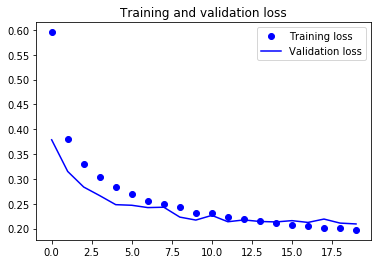
Cuối cùng, bạn có thể thấy mất mát xác thực và độ chính xác xác thực đều đồng bộ với mất mát và độ chính xác huấn luyện. Dù đường mất mát và độ chính xác xác thực không tuyến tính, nhưng nó cho thấy mô hình của bạn không còn quá khớp: mất mát xác thực đang giảm chứ không tăng, và không có khoảng cách lớn giữa độ chính xác huấn luyện và xác thực.
Vì vậy, bạn có thể nói khả năng khái quát hóa của mô hình đã tốt hơn nhiều vì mất mát trên cả tập kiểm tra và xác thực chỉ nhỉnh hơn một chút so với mất mát huấn luyện.
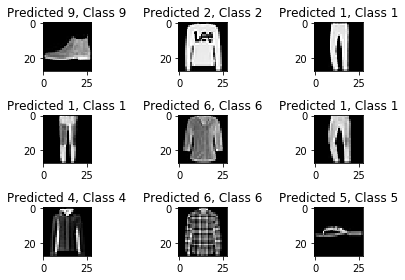
predicted_classes = fashion_model.predict(test_X)
Vì các dự đoán bạn nhận được là giá trị số thực, sẽ không khả thi để so sánh nhãn dự đoán với nhãn kiểm tra thật. Do đó, bạn sẽ làm tròn đầu ra để chuyển giá trị float thành số nguyên. Tiếp nữa, bạn sẽ dùng np.argmax() để chọn chỉ số có giá trị lớn hơn trong một hàng.
Ví dụ, giả sử dự đoán cho một ảnh kiểm tra là 0 1 0 0 0 0 0 0 0 0, đầu ra cho ảnh này sẽ là nhãn lớp 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_Y.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_Y)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_Y[correct]))
    plt.tight_layout()
Found 9188 correct labels
incorrect = np.where(predicted_classes!=test_Y)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_Y[incorrect]))
    plt.tight_layout()
Found 812 incorrect labels
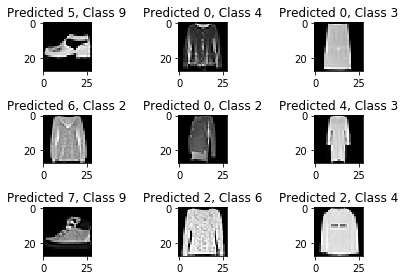
Chỉ nhìn một vài ảnh, bạn không thể chắc chắn vì sao mô hình không phân loại đúng các ảnh trên, nhưng có vẻ như sự đa dạng của các mẫu tương tự xuất hiện ở nhiều lớp ảnh hưởng đến hiệu năng của bộ phân loại mặc dù CNN là một kiến trúc vững chắc. Ví dụ, ảnh 5 và 6 đều thuộc lớp khác nhau nhưng trông khá giống nhau, có thể là áo khoác hoặc áo dài tay.
Báo cáo phân loại sẽ giúp chúng ta xác định chi tiết hơn các lớp bị phân loại sai. Bạn sẽ có thể quan sát xem với lớp nào mô hình hoạt động kém trong số mười lớp cho trước.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_Y, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.77      0.90      0.83      1000
    Class 1       0.99      0.98      0.99      1000
    Class 2       0.88      0.88      0.88      1000
    Class 3       0.94      0.92      0.93      1000
    Class 4       0.88      0.87      0.88      1000
    Class 5       0.99      0.98      0.98      1000
    Class 6       0.82      0.72      0.77      1000
    Class 7       0.94      0.99      0.97      1000
    Class 8       0.99      0.98      0.99      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Bạn có thể thấy bộ phân loại hoạt động kém với lớp 6 cả về precision và recall. Với lớp 0 và lớp 2, bộ phân loại thiếu precision. Ngoài ra, với lớp 4, bộ phân loại hơi thiếu cả precision lẫn recall.
Tiến xa hơn!
Hướng dẫn này là điểm khởi đầu tốt để tìm hiểu mạng nơ-ron tích chập trong Python với Keras. Nếu bạn theo kịp một cách dễ dàng hoặc dù phải cố gắng đôi chút, rất đáng khen! Hãy thử làm vài thí nghiệm, có thể với cùng kiến trúc mô hình nhưng sử dụng các bộ dữ liệu công khai khác nhau.
Vẫn còn rất nhiều điều để khám phá, vậy tại sao không tham gia khóa Deep Learning in Python của DataCamp? Trong lúc chờ đợi, nhớ xem tài liệu Keras nếu bạn chưa làm. Bạn sẽ tìm thấy nhiều ví dụ và thông tin về tất cả hàm, tham số, nhiều lớp hơn, v.v. Đây chắc chắn sẽ là nguồn tài nguyên không thể thiếu khi bạn học cách làm việc với mạng nơ-ron trong Python!
Nếu bạn muốn đọc một cuốn sách giải thích các nền tảng của học sâu (với Keras) cùng cách áp dụng trong thực tế, bạn nhất định nên đọc cuốn Deep Learning in Python của François Chollet.
Tìm hiểu thêm về Python và Học sâu
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
