Kurs
Python ile Deep Learning'e Giriş
4 sa
264.8K
Görüntü veya yüz tanıma ya da otonom araçlar hakkında çoktan duymuş olabilirsiniz. Bunlar, Evrişimli Sinir Ağları’nın (CNN) gerçek hayattaki uygulamalarıdır. Bu blog yazısında, bu derin, ileri beslemeli yapay sinir ağlarının Keras ile nasıl uygulanacağını anlayacak ve ayrıca "dropout" adı verilen düzenlileştirme tekniğiyle aşırı öğrenmenin (overfitting) nasıl önüne geçileceğini öğreneceksiniz.
Daha özel olarak, bugünkü eğitimde aşağıdaki konulara değineceksiniz:
Python’da Keras ve derin öğrenme üzerine bir kurs almak ister misiniz? DataCamp’in Python ile Derin Öğrenme kursuna göz atın!
Ayrıca, Python’da kod örnekleriyle sinir ağı kurmanın geçmeniz gereken altı adımını gösteren Keras cheat sheet’imizi de kaçırmayın!
Şu ana kadar, öğrenebilen algoritmaların tasarımını inceleyen bilgisayar bilimi dalı olan makine öğrenmesi ve derin öğrenme hakkında bilgi sahibi olmuş olabilirsiniz. Derin öğrenme, esin kaynağını biyolojik sinir ağlarından alan yapay sinir ağlarından esinlenen makine öğrenmesinin bir alt alanıdır.
Bu tür derin sinir ağlarının özel bir türü, yaygın olarak CNN veya ConvNet diye anılan evrişimli ağdır. Bu, derin, ileri beslemeli bir yapay sinir ağıdır. Unutmayın, ileri beslemeli sinir ağları, temel derin öğrenme modelleri olan çok katmanlı algılayıcılar (MLP’ler) olarak da adlandırılır. Bu modellere "ileri beslemeli" denir çünkü bilgi model boyunca ileri yönde akar. Model çıktılarının tekrar modele beslendiği geri besleme bağlantıları yoktur.
CNN’ler özellikle biyolojik görsel korteksten esinlenmiştir. Kortekste, görsel alanın belirli bölgelerine duyarlı küçük hücre bölgeleri bulunur. Bu fikir, 1962’de Hubel ve Wiesel’in yaptığı etkileyici bir deneyle genişletildi (daha fazlasını isterseniz şurada bir video var). Bu deneyde araştırmacılar, beyindeki bazı tekil nöronların yalnızca belirli yönlerdeki kenarlar (dikey veya yatay kenarlar gibi) varlığında etkinleştiğini gösterdiler. Örneğin bazı nöronlar dikey kenarlara, bazıları ise yatay kenarlara maruz kaldığında ateşliyordu. Hubel ve Wiesel bu nöronların sütunlar halinde düzenli olduğunu ve birlikte görsel algıyı oluşturabildiklerini buldular. Bir sistem içindeki özelleşmiş bileşenlerin belirli görevleri olması fikri, makinelerin de benimsediği bir fikirdir ve CNN’lerde de karşınıza çıkar.
Evrişimli sinir ağları, bilgisayarlı görü alanındaki en etkili yeniliklerden biri olmuştur. Geleneksel yöntemlerden çok daha iyi performans göstererek son teknoloji sonuçlar üretmişlerdir. Bu ağlar, şu gibi birçok gerçek hayat vakasında ve uygulamada başarılı olduklarını kanıtlamıştır:
Bu başarının nedenini anlamak için 2012 yılına, Alex Krizhevsky’nin o yılki ImageNet Yarışması’nı evrişimli sinir ağlarını kullanarak, sınıflandırma hatasını %26’dan %15’e düşürerek kazandığı yıla dönmelisiniz.
Not: 2010’da başlayan ImageNet Büyük Ölçekli Görsel Tanıma Yarışması (ILSVRC), araştırma ekiplerinin algoritmalarını verilen veri kümesi üzerinde değerlendirerek çeşitli görsel tanıma görevlerinde daha yüksek doğruluk için yarıştıkları yıllık bir yarışmadır.
Bu dönem, sinir ağlarının bir süre sonra yeniden öne çıktığı zamandır. Bu sıklıkla "sinir ağlarının üçüncü dalgası" olarak adlandırılır. Diğer iki dalga 1940’lardan 1960’lara ve 1970’lerden 1980’lere kadardı.
Pekâlâ, biyolojik görsel korteksten esinlenen ileri beslemeli ağlarla çalışacağınızı biliyorsunuz; ama bu tam olarak ne anlama geliyor?
Aşağıdaki resme bir göz atın:
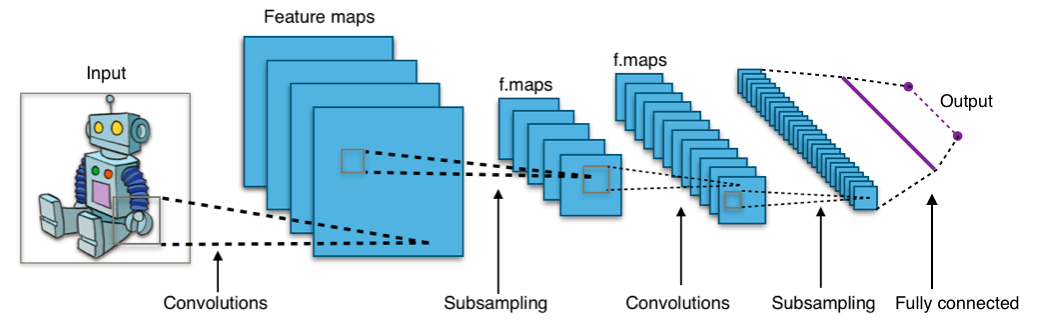
Görüntünün, ağa girdi olarak verildiğini; çoklu evrimler, alt örnekleme, tam bağlantılı bir katman aşamalarından geçerek sonunda bir çıktı ürettiğini görüyorsunuz.
Peki tüm bu kavramlar nedir?
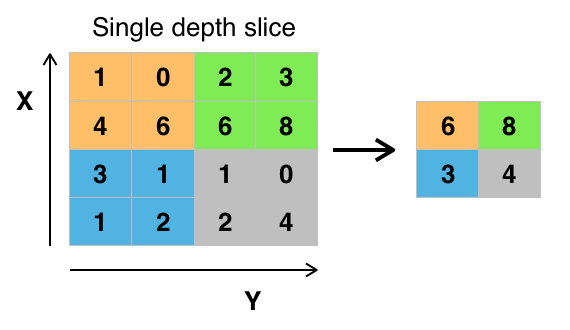
Daha fazla bilgi için buraya gidebilirsiniz.
Veriyi yüklemeye geçmeden önce, tam olarak neyle çalışacağımıza bakmak iyi olur! Fashion-MNIST, Zalando’nun ürün görüntülerinden oluşan bir veri kümesidir; 10 kategoriden 70.000 moda ürününe ait 28x28 gri tonlamalı görüntü içerir ve kategori başına 7.000 görüntü vardır. Eğitim setinde 60.000, test setinde 10.000 görüntü bulunur. Bunu veriyi yükledikten sonra tekrar kontrol edebilirsiniz! ;)
Fashion-MNIST, el yazısı rakamları sınıflandırmak için kullandığınız MNIST veri kümesine benzer. Bu, görüntü boyutlarının, eğitim ve test bölünmelerinin MNIST ile benzer olduğu anlamına gelir. İpucu: Bu ikinci veri kümesiyle sınıflandırma görevleri için Çok Katmanlı Algılayıcıyı (MLP) nasıl uygularsınız öğrenmek isterseniz, bu Keras ile derin öğrenme eğitimine gidin.
Fashion-MNIST’i burada bulabilirsiniz; ancak belirli TensorFlow ve Keras modülleri yardımıyla da yükleyebilirsiniz. Bir sonraki bölümde bunun nasıl çalıştığını göreceksiniz!
Keras, kutudan çıktığı gibi veri kümelerini yüklemek için kullanabileceğiniz bir datasets kütüphanesiyle birlikte gelir: veriyi sunucudan indirirsiniz ve artık veriyi bilgisayarınıza indirmenize gerek kalmadığı için süreç hızlanır. Eğitim ve test görüntüleri ile etiketleri sırasıyla train_X, train_Y, test_X, test_Y değişkenlerine yüklenip kaydedilir.
from keras.datasets import fashion_mnist
(train_X,train_Y), (test_X,test_Y) = fashion_mnist.load_data()
Using TensorFlow backend.
Harika! Oldukça basitti, değil mi?
Muhtemelen bunu şimdiye kadar defalarca yaptınız; ama başlamak için her zaman temel bir adımdır. Artık verinizi analiz etmeye, işlemeye ve modellemeye tamamen hazırsınız!
Şimdi veri kümesindeki görüntülerin nasıl göründüğünü analiz edelim. Görüntülerin boyutlarını artık biliyor olsanız da, bunu programatik olarak analiz etmek hâlâ değerlidir: piksel değerlerini yeniden ölçeklendirmeniz ve görüntüleri yeniden boyutlandırmanız gerekebilir.
import numpy as np
from keras.utils import to_categorical
import matplotlib.pyplot as plt
%matplotlib inline

print('Training data shape : ', train_X.shape, train_Y.shape)

print('Testing data shape : ', test_X.shape, test_Y.shape)
('Training data shape : ', (60000, 28, 28), (60000,))
('Testing data shape : ', (10000, 28, 28), (10000,))
Yukarıdaki çıktıya göre, 60.000 adet 28 x 28 boyutunda eğitim örneği olduğundan, eğitim verisinin şekli 60000 x 28 x 28’dir. Benzer şekilde, test verisinin şekli de 10000 x 28 x 28’dir çünkü 10.000 test örneği vardır.
# Find the unique numbers from the train labels
classes = np.unique(train_Y)
nClasses = len(classes)
print('Total number of outputs : ', nClasses)
print('Output classes : ', classes)
('Total number of outputs : ', 10)
('Output classes : ', array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9], dtype=uint8))
Ayrıca 0’dan 9’a kadar toplam on çıktı sınıfı vardır.
Ayrıca, veri kümenizden görüntülerin nasıl göründüğüne bakmayı unutmayın:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
plt.imshow(train_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(train_Y[0]))

# Display the first image in testing data
plt.subplot(122)
plt.imshow(test_X[0,:,:], cmap='gray')
plt.title("Ground Truth : {}".format(test_Y[0]))
Text(0.5,1,u'Ground Truth : 9')
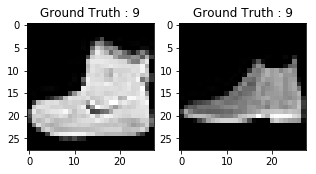
Yukarıdaki iki grafiğin çıktısı bir bilek botunu andırıyor ve bu sınıfa 9 etiketinin atandığını görüyorsunuz. Benzer şekilde, diğer moda ürünlerinin farklı etiketleri olacaktır; ancak benzer ürünler aynı etiketlere sahip olacaktır. Bu, 7.000 bilek botu görüntüsünün tümünün 9 sınıf etiketine sahip olacağı anlamına gelir.
Yukarıdaki grafikte gördüğünüz gibi, görüntüler gri tonlamalıdır ve pikseller 0 ile 255 arasında değer alır. Ayrıca bu görüntüler 28 x 28 boyutundadır. Sonuç olarak, veriyi modele beslemeden önce önişlemden geçirmeniz gerekir.
train_X = train_X.reshape(-1, 28,28, 1)
test_X = test_X.reshape(-1, 28,28, 1)
train_X.shape, test_X.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
train_X = train_X.astype('float32')
test_X = test_X.astype('float32')
train_X = train_X / 255.
test_X = test_X / 255.
One-hot kodlamada, kategorik veriyi bir sayı vektörüne dönüştürürsünüz. Bunu yapmanızın nedeni, makine öğrenmesi algoritmalarının kategorik verilerle doğrudan çalışamamasıdır. Her bir kategori veya sınıf için birer boole sütun üretirsiniz. Her örnek için bu sütunlardan yalnızca biri 1 değerini alabilir. Bu nedenle adı one-hot kodlamadır.
Bu problemde one-hot kodlama bir satır vektörü olacaktır ve her görüntü için boyutu 1 x 10’dur. Burada önemli olan, vektörün temsil ettiği sınıf dışında tüm elemanlarının sıfır olması; temsil edilen sınıf için 1 olmasıdır. Örneğin yukarıda çizdirdiğiniz bilek botu görüntüsünün etiketi 9 olduğundan, tüm bilek botu görüntüleri için one-hot vektörü [0 0 0 0 0 0 0 0 1 0] olacaktır.
Şimdi eğitim ve test etiketlerini one-hot vektörlerine dönüştürelim:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_Y)
test_Y_one_hot = to_categorical(test_Y)

# Display the change for category label using one-hot encoding
print('Original label:', train_Y[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([ 0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  0.,  1.]))
Gayet net, değil mi? Not: train_Y_one_hot’u da yazdırabilirsiniz; bu, her satırı bir görüntünün one-hot kodlamasını gösteren 60000 x 10 boyutunda bir matrisi görüntüler.
from sklearn.model_selection import train_test_split
train_X,valid_X,train_label,valid_label = train_test_split(train_X, train_Y_one_hot, test_size=0.2, random_state=13)
Son bir kez, eğitim ve doğrulama setlerinin şekillerini kontrol edelim.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Görüntüler 28 x 28 boyutundadır. Görüntü matrisini bir diziye dönüştürür, 0 ile 1 arasına yeniden ölçeklendirir, 28 x 28 x 1 boyutuna yeniden şekillendirir ve bunu ağa girdi olarak verirsiniz.
Üç evrişim katmanı kullanacaksınız:
Ek olarak, her biri 2 x 2 boyutunda üç maksimum havuzlama katmanı vardır.
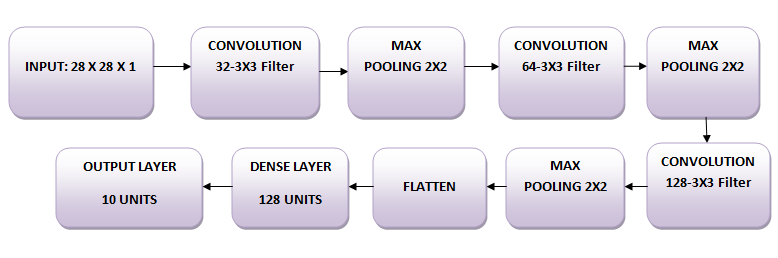
Öncelikle, modeli eğitmek için gerekli tüm modülleri içe aktaralım.
import keras
from keras.models import Sequential,Input,Model
from keras.layers import Dense, Dropout, Flatten
from keras.layers import Conv2D, MaxPooling2D
from keras.layers.normalization import BatchNormalization
from keras.layers.advanced_activations import LeakyReLU
64’lük bir yığın (batch) boyutu kullanacaksınız; belleğe bağlı olarak 128 veya 256 gibi daha yüksek boyutlar da tercih edilebilir. Bu, öğrenme parametrelerinin belirlenmesine ciddi katkıda bulunur ve tahmin doğruluğunu etkiler. Ağı 20 epoch boyunca eğiteceksiniz.
batch_size = 64
epochs = 20
num_classes = 10
Keras’ta, istediğiniz katmanı tek tek ekleyerek katmanları üst üste yığabilirsiniz. Burada tam olarak bunu yapacaksınız: önce Conv2D() ile birinci evrişim katmanını ekleyeceksiniz. Görüntülerle çalıştığınız için bu fonksiyonu kullandığınıza dikkat edin! Ardından, ağın doğrusal olmayan karar sınırlarını öğrenmesine yardımcı olan Leaky ReLU aktivasyon fonksiyonunu eklersiniz. On farklı sınıfınız olduğundan, doğrusal olarak ayrıştırılamayan bu on sınıfı ayırabilecek doğrusal olmayan bir karar sınırına ihtiyaç duyarsınız.
Daha özel olarak, Leaky ReLU’ları, ölüleşen Düzeltmeli Doğrusal Birimler (ReLU) sorununa çözüm getirdiği için eklersiniz. ReLU aktivasyon fonksiyonu, sinir ağı mimarilerinde ve özellikle evrişimli ağlarda yaygın olarak kullanılır; geniş ölçüde kullanılan lojistik sigmoid fonksiyonuna göre daha etkili olduğu kanıtlanmıştır. 2017 itibarıyla bu aktivasyon fonksiyonu derin sinir ağları için en popüler olanıdır. ReLU, aktivasyonun sıfırda eşiklenmesine izin verir. Ancak eğitim sırasında ReLU birimleri "öl"ebilir. ReLU nöronundan büyük bir gradyan geçtiğinde, ağırlıklar öyle güncellenebilir ki nöron bir daha hiçbir veri noktasında etkinleşmez. Bu olursa, o noktadan sonra birimden geçen gradyan sonsuza kadar sıfır olur. Leaky ReLU’lar bunu çözmeye çalışır: fonksiyon sıfır olmaz, küçük bir negatif eğime sahip olur.
Sonraki adımda, MaxPooling2D() ile maksimum havuzlama katmanını ekleyeceksiniz ve böyle devam edeceksiniz. Son katman, bu çok sınıflı sınıflandırma problemi için gereken, 10 birimli ve softmax aktivasyonlu bir Dense katmandır.
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',input_shape=(28,28,1),padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dense(num_classes, activation='softmax'))
Model oluşturulduktan sonra, en popüler optimizasyon algoritmalarından biri olan Adam ile derlersiniz. Bu iyileştirici hakkında daha fazla bilgiyi burada okuyabilirsiniz. Ayrıca, çok sınıflı sınıflandırma için kullanılan kayıp türünü (kategorik çapraz entropi) belirtirsiniz; kayıp fonksiyonu olarak ikili çapraz entropiyi de kullanabilirsiniz. Son olarak, model eğitim alırken analiz etmek istediğiniz metrik olarak doğruluğu (accuracy) belirlersiniz.
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Yukarıda oluşturduğunuz katmanları özet fonksiyonu ile görselleştirelim. Bu, her katmandaki bazı parametreleri (ağırlık ve biaslar) ve modelinizdeki toplam parametre sayısını gösterir.
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_51 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_57 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_49 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_52 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_58 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_50 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_53 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_59 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_51 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
flatten_17 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_33 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_60 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dense_34 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
Sonunda modeli Keras’ın fit() fonksiyonu ile eğitme zamanı! Model 20 epoch eğitilir. fit() fonksiyonu bir history nesnesi döndürür; bu fonksiyonun sonucunu fashion_train içine kaydederek daha sonra eğitim ve doğrulama arasındaki doğruluk ve kayıp grafikleri çizmek için kullanabilirsiniz; bu, modelinizin performansını görsel olarak analiz etmenize yardımcı olur.
fashion_train = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.4661 - acc: 0.8311 - val_loss: 0.3320 - val_acc: 0.8809
Epoch 2/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2874 - acc: 0.8951 - val_loss: 0.2781 - val_acc: 0.8963
Epoch 3/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.2420 - acc: 0.9111 - val_loss: 0.2501 - val_acc: 0.9077
Epoch 4/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.2088 - acc: 0.9226 - val_loss: 0.2369 - val_acc: 0.9147
Epoch 5/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1838 - acc: 0.9324 - val_loss: 0.2602 - val_acc: 0.9070
Epoch 6/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1605 - acc: 0.9396 - val_loss: 0.2264 - val_acc: 0.9193
Epoch 7/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1356 - acc: 0.9488 - val_loss: 0.2566 - val_acc: 0.9180
Epoch 8/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.1186 - acc: 0.9553 - val_loss: 0.2556 - val_acc: 0.9149
Epoch 9/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0985 - acc: 0.9634 - val_loss: 0.2681 - val_acc: 0.9204
Epoch 10/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0873 - acc: 0.9670 - val_loss: 0.2712 - val_acc: 0.9221
Epoch 11/20
48000/48000 [==============================] - 59s 1ms/step - loss: 0.0739 - acc: 0.9721 - val_loss: 0.2757 - val_acc: 0.9202
Epoch 12/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0628 - acc: 0.9767 - val_loss: 0.3126 - val_acc: 0.9132
Epoch 13/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0569 - acc: 0.9789 - val_loss: 0.3556 - val_acc: 0.9081
Epoch 14/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0452 - acc: 0.9833 - val_loss: 0.3441 - val_acc: 0.9189
Epoch 15/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0421 - acc: 0.9847 - val_loss: 0.3400 - val_acc: 0.9165
Epoch 16/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0379 - acc: 0.9861 - val_loss: 0.3876 - val_acc: 0.9195
Epoch 17/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0405 - acc: 0.9855 - val_loss: 0.4112 - val_acc: 0.9164
Epoch 18/20
48000/48000 [==============================] - 60s 1ms/step - loss: 0.0285 - acc: 0.9897 - val_loss: 0.4150 - val_acc: 0.9181
Epoch 19/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0322 - acc: 0.9877 - val_loss: 0.4584 - val_acc: 0.9196
Epoch 20/20
48000/48000 [==============================] - 61s 1ms/step - loss: 0.0262 - acc: 0.9906 - val_loss: 0.4396 - val_acc: 0.9205
Nihayet! Modeli Fashion-MNIST üzerinde 20 epoch eğittiniz ve eğitim doğruluğu ile kayba bakarak, 20 epoch sonunda eğitim doğruluğu %99 ve eğitim kaybı oldukça düşük olduğundan modelin iyi iş çıkardığını söyleyebilirsiniz.
Ancak, doğrulama kaybı 0,4396 ve doğrulama doğruluğu %92 olduğundan model aşırı öğreniyor gibi görünüyor. Aşırı öğrenme, ağın eğitim verisini çok iyi ezberlediğine fakat görülmemiş veride çalışacağının garanti olmadığına işaret eder; bu yüzden eğitim ve doğrulama doğruluğu arasında fark vardır.
Muhtemelen bunu ele almanız gerekiyor. Sonraki bölümlerde, ağa bir Dropout katmanı ekleyerek diğer katmanları değiştirmeden modelinizi nasıl daha iyi performans gösterecek hâle getirebileceğinizi öğreneceksiniz.
Ancak bir sonuca varmadan önce, modelinizin test setindeki performansını değerlendirelim.
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.46366268818555401)
('Test accuracy:', 0.91839999999999999)
Test doğruluğu etkileyici görünüyor. Sınıflandırıcınızın, burada bildirilen kıyas değeri olan ortalama doğruluğu 0,897 olan bir SVM sınıflandırıcısından daha iyi performans gösterdiği ortaya çıkıyor. Ayrıca model, Fashion-MNIST veri kümesinin oluşturucularının GitHub profilinde bahsedilen bazı derin öğrenme modellerine kıyasla da iyi iş çıkarıyor.
Yine de modelin aşırı öğrendiğini görmüştünüz. Bu sonuçlar gerçekten o kadar iyi mi?
Model değerlendirmemizi bağlama oturtalım ve eğitim ile doğrulama verisi arasındaki doğruluk ve kayıp grafiklerini çizelim:
accuracy = fashion_train.history['acc']
val_accuracy = fashion_train.history['val_acc']
loss = fashion_train.history['loss']
val_loss = fashion_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
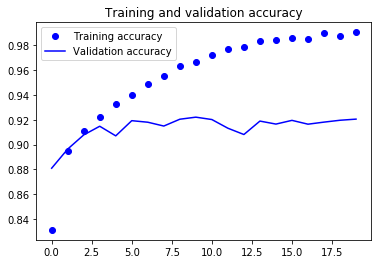
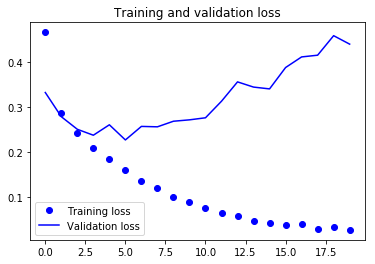
Yukarıdaki iki grafikten, doğrulama doğruluğunun 4-5 epoch sonra neredeyse durgunlaştığını ve bazı epoch’larda nadiren arttığını görebilirsiniz. Başlangıçta doğrulama doğruluğu kayıpla beraber doğrusal olarak artıyordu; sonrasında pek artmadı.
Doğrulama kaybı, bu durumun aşırı öğrenme işareti olduğunu gösteriyor; doğrulama doğruluğuna benzer şekilde doğrusal olarak azaldı ama 4-5 epoch sonra artmaya başladı. Bu, modelin veriyi ezberlemeye çalıştığı ve bunda başarılı olduğu anlamına gelir.
Bunu akılda tutarak, modelimize biraz dropout eklemenin aşırı öğrenmeyi azaltmaya yardımcı olup olmayacağını görelim.
Aşırı öğrenme sorununu bir dereceye kadar aşmak için bir dropout katmanı ekleyebilirsiniz. Dropout, eğitim sürecinde nöronların bir kısmını rastgele kapatarak, eğitim setine olan bağımlılığı bir miktar azaltır. Kaç nöronu kapatmak istediğiniz, buna göre ayarlanabilen bir hiperparametre ile belirlenir. Bu sayede bazı nöronları devre dışı bırakmak, ağın eğitim verisini ezberlemesine izin vermez; çünkü nöronların tümü aynı anda etkin olmayacak ve etkin olmayan nöronlar hiçbir şey öğrenemeyecektir.
Öyleyse ağı yeniden oluşturup derleyip eğitelim; ama bu kez dropout ile. 64’lük yığın boyutu ile 20 epoch çalıştıralım.
batch_size = 64
epochs = 20
num_classes = 10
fashion_model = Sequential()
fashion_model.add(Conv2D(32, kernel_size=(3, 3),activation='linear',padding='same',input_shape=(28,28,1)))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D((2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(64, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.25))
fashion_model.add(Conv2D(128, (3, 3), activation='linear',padding='same'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(MaxPooling2D(pool_size=(2, 2),padding='same'))
fashion_model.add(Dropout(0.4))
fashion_model.add(Flatten())
fashion_model.add(Dense(128, activation='linear'))
fashion_model.add(LeakyReLU(alpha=0.1))
fashion_model.add(Dropout(0.3))
fashion_model.add(Dense(num_classes, activation='softmax'))
fashion_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
conv2d_54 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
leaky_re_lu_61 (LeakyReLU)   (None, 28, 28, 32)        0
_________________________________________________________________
max_pooling2d_52 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
dropout_29 (Dropout)         (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
leaky_re_lu_62 (LeakyReLU)   (None, 14, 14, 64)        0
_________________________________________________________________
max_pooling2d_53 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
dropout_30 (Dropout)         (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
leaky_re_lu_63 (LeakyReLU)   (None, 7, 7, 128)         0
_________________________________________________________________
max_pooling2d_54 (MaxPooling (None, 4, 4, 128)         0
_________________________________________________________________
dropout_31 (Dropout)         (None, 4, 4, 128)         0
_________________________________________________________________
flatten_18 (Flatten)         (None, 2048)              0
_________________________________________________________________
dense_35 (Dense)             (None, 128)               262272
_________________________________________________________________
leaky_re_lu_64 (LeakyReLU)   (None, 128)               0
_________________________________________________________________
dropout_32 (Dropout)         (None, 128)               0
_________________________________________________________________
dense_36 (Dense)             (None, 10)                1290
=================================================================
Total params: 356,234
Trainable params: 356,234
Non-trainable params: 0
_________________________________________________________________
fashion_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
fashion_train_dropout = fashion_model.fit(train_X, train_label, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 66s 1ms/step - loss: 0.5954 - acc: 0.7789 - val_loss: 0.3788 - val_acc: 0.8586
Epoch 2/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3797 - acc: 0.8591 - val_loss: 0.3150 - val_acc: 0.8832
Epoch 3/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3302 - acc: 0.8787 - val_loss: 0.2836 - val_acc: 0.8961
Epoch 4/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.3034 - acc: 0.8868 - val_loss: 0.2663 - val_acc: 0.9002
Epoch 5/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2843 - acc: 0.8936 - val_loss: 0.2481 - val_acc: 0.9083
Epoch 6/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2699 - acc: 0.9002 - val_loss: 0.2469 - val_acc: 0.9032
Epoch 7/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2561 - acc: 0.9049 - val_loss: 0.2422 - val_acc: 0.9095
Epoch 8/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2503 - acc: 0.9068 - val_loss: 0.2429 - val_acc: 0.9098
Epoch 9/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2437 - acc: 0.9096 - val_loss: 0.2230 - val_acc: 0.9173
Epoch 10/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9126 - val_loss: 0.2170 - val_acc: 0.9187
Epoch 11/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2307 - acc: 0.9135 - val_loss: 0.2265 - val_acc: 0.9193
Epoch 12/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2229 - acc: 0.9160 - val_loss: 0.2136 - val_acc: 0.9229
Epoch 13/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2202 - acc: 0.9162 - val_loss: 0.2173 - val_acc: 0.9187
Epoch 14/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2161 - acc: 0.9188 - val_loss: 0.2142 - val_acc: 0.9211
Epoch 15/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2119 - acc: 0.9196 - val_loss: 0.2133 - val_acc: 0.9233
Epoch 16/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2073 - acc: 0.9222 - val_loss: 0.2159 - val_acc: 0.9213
Epoch 17/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2050 - acc: 0.9231 - val_loss: 0.2123 - val_acc: 0.9233
Epoch 18/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.2016 - acc: 0.9238 - val_loss: 0.2191 - val_acc: 0.9235
Epoch 19/20
48000/48000 [==============================] - 65s 1ms/step - loss: 0.2001 - acc: 0.9244 - val_loss: 0.2110 - val_acc: 0.9258
Epoch 20/20
48000/48000 [==============================] - 64s 1ms/step - loss: 0.1972 - acc: 0.9255 - val_loss: 0.2092 - val_acc: 0.9269
Modeli kaydedelim ki daha sonra doğrudan yükleyip 20 epoch boyunca yeniden eğitmek zorunda kalmayın. Böylece modele daha sonra ihtiyaç duyarsanız yükleyebilir ve mimariyi değiştirebilirsiniz; alternatif olarak, bu kaydedilmiş model üzerinde eğitim sürecini başlatabilirsiniz. Modeli —ve hatta modelin ağırlıklarını!— kaydetmek her zaman iyi bir fikirdir, çünkü zaman kazandırır. Ayrıca modeli her epoch sonunda da kaydedebilirsiniz; böylece eğitimi durduran bir sorun yaşanırsa, en baştan başlamak zorunda kalmazsınız.
fashion_model.save("fashion_model_dropout.h5py")
Son olarak yeni modelinizi de değerlendirelim ve nasıl performans gösterdiğine bakalım!
test_eval = fashion_model.evaluate(test_X, test_Y_one_hot, verbose=1)
10000/10000 [==============================] - 5s 461us/step
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.21460009642243386)
('Test accuracy:', 0.92300000000000004)
Vay canına! Görünüşe göre modelimize Dropout eklemek işe yaradı; test doğruluğu belirgin ölçüde artmamış olsa da test kaybı önceki sonuçlara kıyasla azaldı.
Şimdi, son bir kez eğitim ve doğrulama verileri arasındaki doğruluk ve kayıp grafiklerini çizelim.
accuracy = fashion_train_dropout.history['acc']
val_accuracy = fashion_train_dropout.history['val_acc']
loss = fashion_train_dropout.history['loss']
val_loss = fashion_train_dropout.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
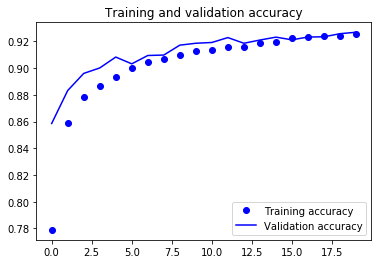
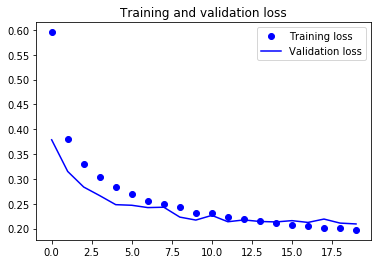
Sonuçta, doğrulama kaybı ve doğrulama doğruluğunun, eğitim kaybı ve eğitim doğruluğuyla uyumlu olduğunu görebilirsiniz. Doğrulama kaybı ve doğruluğu çizgileri tam doğrusal olmasa da modelinizin aşırı öğrenmediğini gösteriyor: doğrulama kaybı artmıyor, azalıyor ve eğitim ile doğrulama doğruluğu arasında büyük bir uçurum yok.
Dolayısıyla, test seti ve doğrulama setindeki kaybın eğitim kaybına kıyasla yalnızca biraz daha fazla olduğunu göz önüne alırsak, modelinizin genelleme yeteneğinin çok daha iyi hâle geldiğini söyleyebilirsiniz.
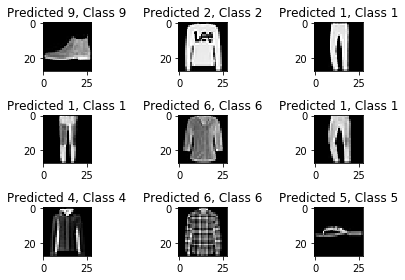
predicted_classes = fashion_model.predict(test_X)
Elde ettiğiniz tahminler kayan noktalı değerler olduğu için, tahmin edilen etiketlerle gerçek test etiketlerini karşılaştırmak uygun olmayacaktır. Bu nedenle, çıktıyı yuvarlayarak float değerleri tamsayıya dönüştüreceksiniz. Ayrıca, bir satırda daha yüksek değere sahip olan indeks numarasını seçmek için np.argmax() kullanacaksınız.
Örneğin, bir test görüntüsü için tahminin 0 1 0 0 0 0 0 0 0 0 olduğunu varsayalım; bunun çıktısı sınıf etiketi 1 olmalıdır.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_Y.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_Y)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_Y[correct]))
    plt.tight_layout()
Found 9188 correct labels
incorrect = np.where(predicted_classes!=test_Y)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_X[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_Y[incorrect]))
    plt.tight_layout()
Found 812 incorrect labels
Yalnızca birkaç görüntüye bakarak modelinizin neden yukarıdaki görüntüleri doğru sınıflandıramadığından emin olamazsınız; ancak CNN sağlam bir mimari olmasına rağmen, birden fazla sınıfta bulunan benzer desen çeşitliliğinin sınıflandırıcının performansını etkilediği anlaşılıyor. Örneğin 5 ve 6. görüntüler farklı sınıflara ait olsalar da birbirlerine benziyorlar; belki ceket veya uzun kollu bir gömlek.
Sınıflandırma raporu, yanlış sınıflandırılan sınıfları daha ayrıntılı belirlememize yardımcı olur. Verilen on sınıftan hangisinde modelin kötü performans gösterdiğini gözlemleyebileceksiniz.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_Y, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.77      0.90      0.83      1000
    Class 1       0.99      0.98      0.99      1000
    Class 2       0.88      0.88      0.88      1000
    Class 3       0.94      0.92      0.93      1000
    Class 4       0.88      0.87      0.88      1000
    Class 5       0.99      0.98      0.98      1000
    Class 6       0.82      0.72      0.77      1000
    Class 7       0.94      0.99      0.97      1000
    Class 8       0.99      0.98      0.99      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Görüldüğü gibi sınıflandırıcı, 6. sınıf için hem kesinlik (precision) hem de duyarlılık (recall) açısından düşük performans gösteriyor. 0 ve 2. sınıflar için sınıflandırıcının kesinliği düşük. Ayrıca 4. sınıfta da kesinlik ve duyarlılıkta hafif bir düşüş var.
Daha da İleri Gidin!
Bu eğitim, Keras ile Python’da evrişimli sinir ağlarına iyi bir başlangıç oldu. Kolaylıkla ya da biraz daha fazla çabayla takip edebildiyseniz, tebrikler! Belki aynı model mimarisiyle fakat farklı türdeki herkese açık veri kümeleri üzerinde bazı deneyler yapmayı deneyin.
Hâlâ kapsanacak çok şey var; neden DataCamp’in Python ile Derin Öğrenme kursunu almıyorsunuz? Bu arada, henüz bakmadıysanız Keras dokümantasyonunu da mutlaka inceleyin. Tüm fonksiyonlar, argümanlar, daha fazla katman vb. hakkında daha fazla örnek ve bilgi bulacaksınız. Python’da sinir ağlarıyla çalışmayı öğrenirken şüphesiz vazgeçilmez bir kaynak olacaktır!
Eğer Keras ile derin öğrenmenin temellerini ve pratikte nasıl kullanıldığını anlatan bir kitap okumayı tercih ediyorsanız, François Chollet’nin Python ile Derin Öğrenme kitabını mutlaka okuyun.
Python ve Derin Öğrenme hakkında daha fazlasını öğrenin
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




